Decision-1とは|Jevと同じAPIで何が違う

「Microsoft が出した Decision-1 は、Jev と何が違うのか。乗り換える意味はあるのか」——判定専用のAIを業務に組み込もうとしている人なら、2026年10月9日の発表を見てまずこう思ったはずです。
結論から言うと、Decision-1 は Jev とほぼ同じ形の問いを受け取り、同じ値段(入力100万トークンあたり0.042ドル・出力は無料)で、Azure の中から呼べる判定モデルです。違いはモデルの中身よりも「どこで動き、どの契約と権限の下に置けるか」にあります。一方で、Microsoft が掲げる「36のベンチマークで最高精度」は試験の名前も正解率も公開されておらず、日本語での実力も公式には書かれていません。
株式会社Fyveは、Jev を日本語の問い合わせ振り分けで実測し、同じ問いを構造化出力のLLMと並べて比べてきました。この記事では、公式ドキュメントと発表文で確かめた事実を正として押さえたうえで、その実測から「判定モデルを選ぶときに本当に差が出るところ」と、Decision-1 を自社で試す前に確かめるべきことをまとめます。
Decision-1とは——文章を書かずに「判定」だけを返すモデル
Decision-1(正式名 Microsoft-Decision-1)は、Microsoft の CTO 室が2026年10月9日に発表した判定専用のモデルです。発表文は用途を、振り分け・分類・優先順位づけ・検証・業務の流れの制御と説明しています。
Microsoft Foundry の公式ドキュメントは、普通のLLMとの違いをこう書いています。「生成型の大規模言語モデルとは違い、自由な文章や理由の説明は生成しない。テキストまたはJSONについて焦点を絞った判断をし、型の決まった数値の判定を返す」。
つまり「この問い合わせはどの担当か」と聞くと、文章で答えるのではなく、選んだ選択肢と、選択肢ごとの確率が返ってきます。返ってくる形が決まっているので、プログラムはその値でそのまま分岐できます。
発表の要点(2026年10月12日時点)
項目 | 内容 | 出どころ |
|---|---|---|
発表日 | 2026年10月9日 | Microsoft の発表文 |
元になったモデル | Alibaba の Qwen3.5-9B を追加学習(発表文は「1回の処理で判定を出すために追加学習した」と説明) | 発表文 |
料金 | 入力100万トークンあたり0.042ドル。出力は無料 | 発表文 |
提供先 | Microsoft Foundry と OpenRouter | 発表文 |
問いの種類 |
| Foundry 公式ドキュメント |
デプロイの種類 |
| Foundry 公式ドキュメント |
今後 | MAI(Microsoft AI)や OpenAI のモデルを土台にした版も予定 | 発表文 |
料金はドル建て・税別の公式発表値です。契約前に必ず Microsoft Foundry の最新の価格表で確認してください。
Jevと何が同じで、何が違うのか
判定専用のモデルとして先に使われ始めていたのが、TypeSafe の Jev です(私たちの使い方の記事は Jevの使い方|Vercel経由で5分・3つの型と確信度の実測)。並べてみると、同じところのほうがずっと多いのが分かります。
同じところ——問いの書き方と料金
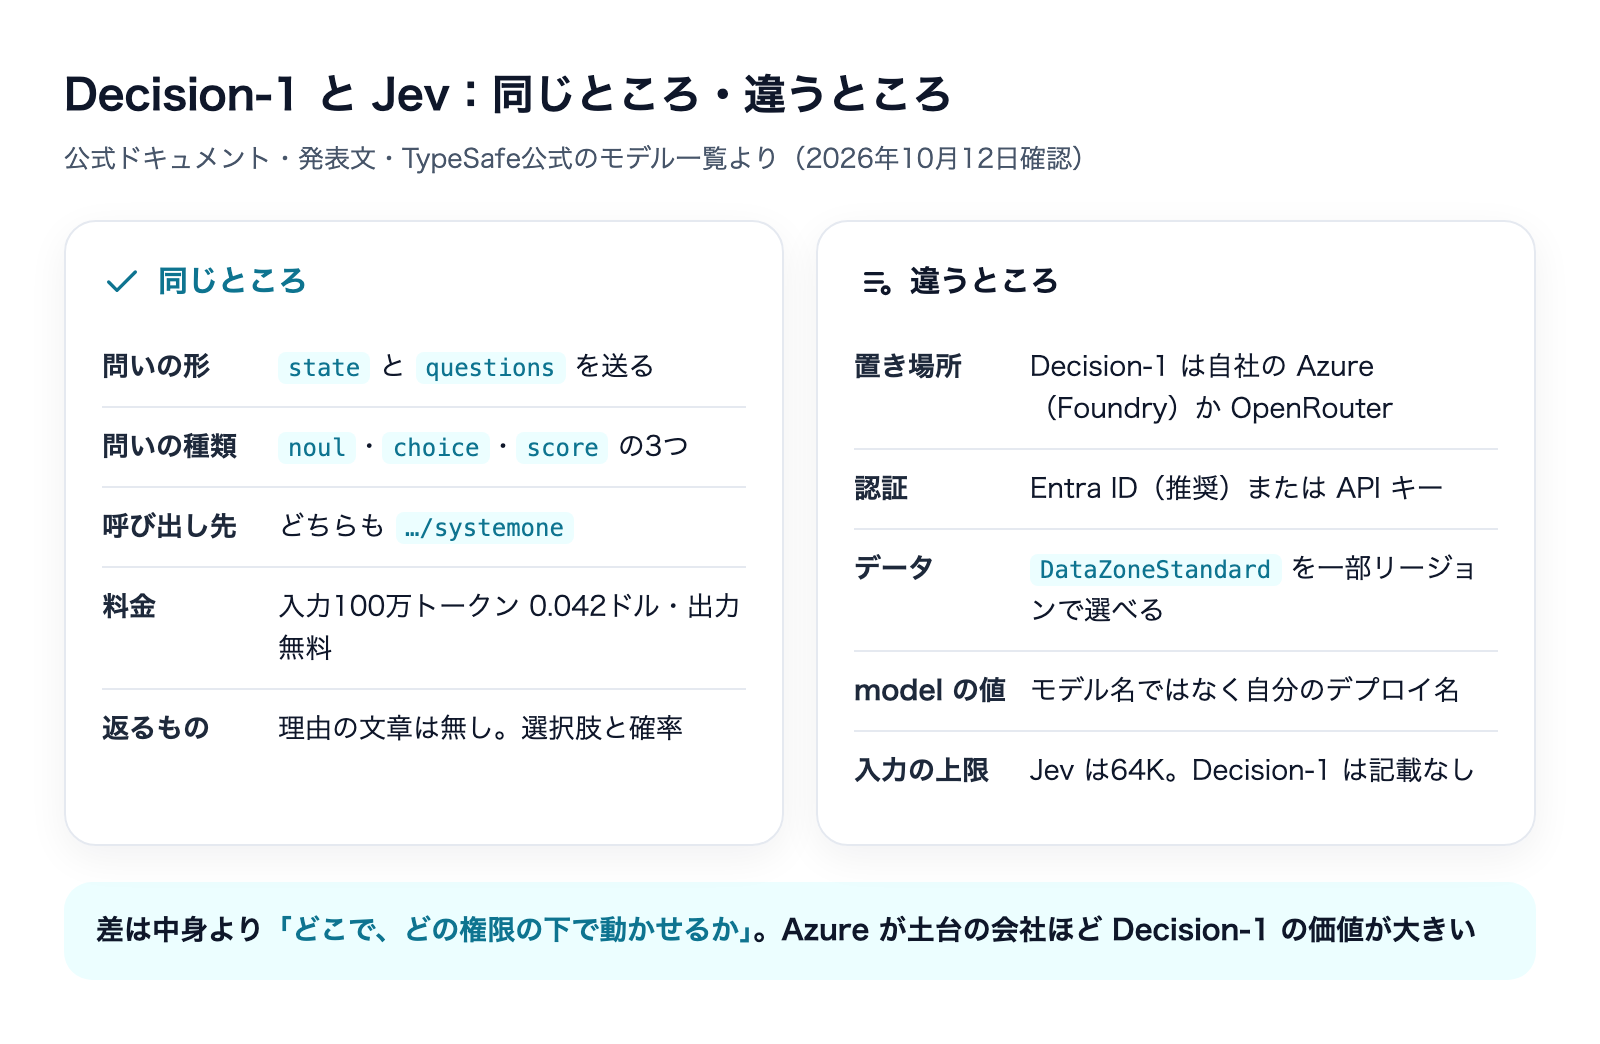
Foundry の公式ドキュメント自身が「リクエストの形は system-one API と似ている」と書いており、呼び出し先の名前も /providers/microsoft/v1/systemone です。Jev の公式APIの呼び出し先は /v1/systemone です。
中身も揃っています。判定したい対象を state に入れ、聞きたいことを questions に名前付きで並べ、それぞれに type・instructions・criteria を書きます。はい/いいえの問いの型名が noul である点まで、Jev の公式APIと同じです。私たちは Jev の検証用に問いの定義を書いてきましたが、その定義はほぼそのまま Decision-1 の書式に当てはまります。
料金も同じ水準です。TypeSafe の公式のモデル一覧では、Jev 1.13 は入力100万トークンあたり0.042ドル・出力は無料(2026年10月12日確認)。Decision-1 の発表値と同じです。
違うところ——置き場所・権限・入力の上限
Jev(TypeSafe) | Decision-1(Microsoft) | |
|---|---|---|
呼ぶ場所 | TypeSafe の公式API(他の経路もあり) | 自社の Azure 上の Foundry リソース、または OpenRouter |
認証 | TypeSafe の API キー | Microsoft Entra ID(公式推奨)または API キー |
準備 | キーを発行するだけ | Azure サブスクリプション・Foundry プロジェクト・デプロイ権限(Cognitive Services Contributor)が要る |
処理の場所 | 公式の記載なし |
|
| モデル名(例: | 自分で付けたデプロイ名(モデル名ではない) |
入力の上限 | 1回64Kトークン(state と最長の問いで32K) | 公式ドキュメント・発表文ともに記載なし |
要するに、Decision-1 は「Jev と同じ判定を、Azure の契約・権限管理・データの置き場所のルールの中で使える」ことに価値がある、というのが私の読みです。すでに Microsoft 365 や Azure を会社の土台にしていて、外部のAPIキーを新しく増やすこと自体が社内で通りにくい会社には、ここが大きく効きます。逆に、そうした縛りがない個人や小さなチームが、Jev から乗り換える理由は今のところ見当たりません。
なお、DataZoneStandard がどのリージョンで使えるかは、Decision-1 については公式に明示されていません。データの置き場所が導入の条件なら、自社のリージョンで選べるかをデプロイ画面で先に確かめてください。
「36のベンチマークで最高精度」をどう読むか
発表文は、Decision-1 が「36のベンチマーク比較で最高の精度」を出し、その試験は「学習に使っていない、約15万問」にわたると書いています。速さも「次点の H2O-Lightning-4B v1.1 より2.5倍、GPT-6 Sol より35倍速い」としています。
ただ、この数字は鵜呑みにしないほうがよいと私は考えています。理由は3つです。
- 試験の名前と正解率が出ていない:海外の技術メディア beri.net(2026年10月11日時点の比較)は、発表文がベンチマークの名前を挙げず、正解率の数字も1つも載せていないと指摘しています。何で測ったか分からない「最高」は、自社の業務に当てはまるかを判断できません
- Jev との比較が本文に見当たらない:発表文の末尾には「Jev の精度と較正のベンチマークを加えるために更新した」という編集注があります。しかし同じ beri.net の記事は、本文に Jev の数字が見当たらないと書いています。一番比べたい相手との数字が、まだ読める形になっていません
- 「較正されている」の測定が公開されていない:発表文は「90%の予測は、代表的な場面で10回中9回ほど当たるはずだ」と書きます。一方で Foundry の公式ドキュメントは score について「絶対的な較正済みの評価としてではなく、相対的な順序づけやしきい値として使うことを勧める」とし、既知の制約にも「較正は、なじみのある種類の課題でいちばん強い」と書いています
3つ目は特に大事です。発表文の「90%なら9割当たる」と、ドキュメントの「絶対値として信じすぎるな」は、同じ会社の中でも温度が違います。私はドキュメントの慎重な書き方のほうを前提に置くのが安全だと考えます。
一方で、公開されている数字の中に、素直に評価できるものもあります。発表文によると、Decision-1 は問いの言い換えなど8種類の揺さぶりに対して、判定が変わったのは平均1.3%でした。判定モデルは「同じ意味の問いなのに、言い回しで答えが変わる」のが一番困る壊れ方なので、ここを測って出しているのは誠実です。
判定モデルの価値は「確信度で人に回せるか」で決まる——自社の実測
ここからは、私たちが Jev と構造化出力のLLMを同じ条件で比べた実測をもとに、Decision-1 を評価するときの物差しを示します。Decision-1 そのものはまだ測っていません。ただ、何を測れば差が分かるかは、この実測ではっきりしました。
同じ25件を、Jevと構造化出力のLLMで比べた
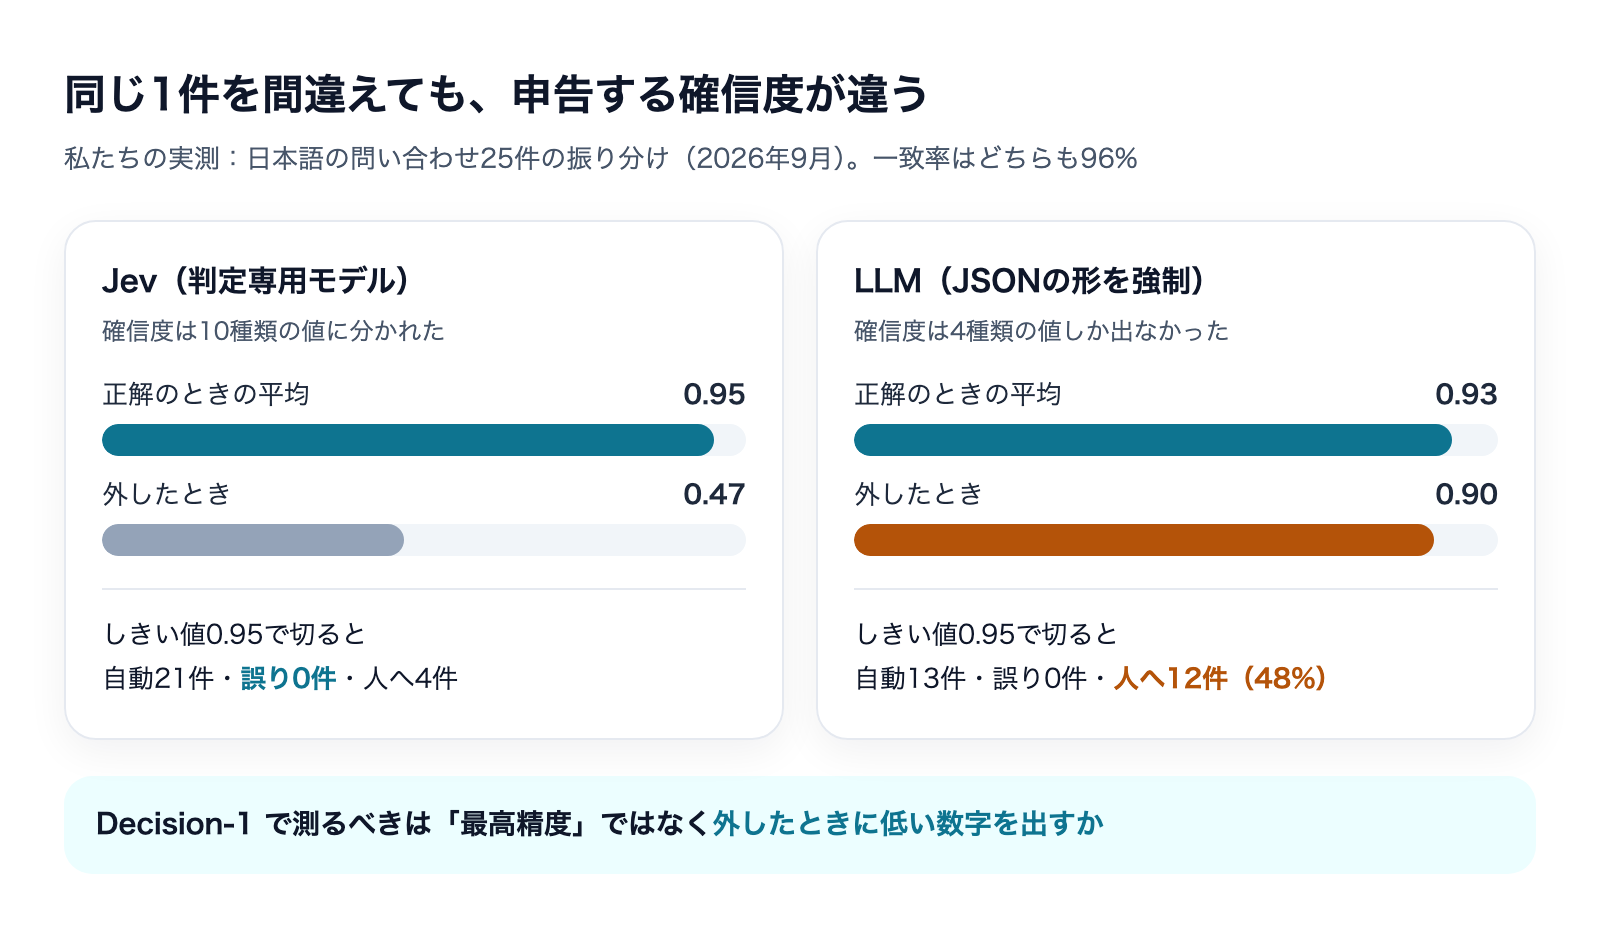
2026年9月21日〜23日に、日本語の問い合わせ25件を「どの担当に回すか」で振り分けさせました。比べたのは Jev と、軽量LLM(qwen3.7-flash)に JSON の形を強制させたもの(json_schema の strict)です。基準の文言・ゲートウェイ・再試行なしの条件はすべて揃えています。
Jev | LLM(json_schema strict) | |
|---|---|---|
JSONが壊れた件数 | —(形が壊れない作り) | 0 / 25 |
選択肢の外の値 | 出ない作り | 0 / 25 |
振り分けの一致率 | 96% | 96% |
確信度(正解のとき/外したとき) | 0.95 / 0.47 | 0.93 / 0.90 |
確信度が取った値の種類 | 10種類(0.44〜1.00) | 4種類 |
応答時間の中央値 | 456ミリ秒 | 15,413ミリ秒 |
正直に言うと、始める前の予想は外れました。「形が壊れない」でも「精度」でも差はつきませんでした。選択肢を閉じた形で渡せば、安いLLMでも25件中1件も壊れず、一致率も同じ96%でした。
差がついたのは確信度です。同じ1件(「カード情報を更新したい」という問い合わせ)を両方とも間違えましたが、Jev は確信度0.47で「迷っている」と申告し、LLM は0.90で「自信がある」と答えました。LLM は確信度を計算しているのではなく、それらしい数字を書いているので、0.9や0.95のようなキリのいい値しか出てこなかったのです。
しきい値で切ると、差は「人に回る件数」に出る
しきい値 | Jev | LLM(json_schema strict) |
|---|---|---|
0.6 | 自動23件・誤り0件・人へ2件(8%) | 自動25件・誤り1件・人へ0件 |
0.95 | 自動21件・誤り0件・人へ4件 | 自動13件・誤り0件・人へ12件(48%) |
LLM 側で誤りをゼロにしようとすると、半分を人に回すことになります。それでは自動化の意味がありません。判定モデルを業務に載せられるかどうかは、正解率よりも「迷ったときに低い数字を出してくれるか」で決まる、というのがこの実測の結論です。
同じ形は、ブラウザ操作の「次にどこを押すか」の判定(20件)でも再現しました。一致率は Jev もLLMも95%で同じ、外した件の確信度は Jev が0.28、LLM が1.00でした。
ただし、どちらの実測も件数は20〜25件で、Jev も完全ではありません。正解なのに0.44が出た件があり、外した0.47と重なっています。「外れだけが低く出る」のではなく「迷う文が低く出る」が正確な言い方です。また、上位のLLM(GPT-5.6 Sol)で同じ25件を測り直すと、外した件の確信度は0.78まで下がり、正解と分かれました。確信度が使えるかどうかは、モデルと課題によって変わります。詳しい経緯は JevはなぜLLMより速く安いのか|仕組みと9つの苦手 にまとめています。
Decision-1を自社で試す前に確かめる5つのこと
以上を踏まえると、Decision-1 を検討するときに見るべきなのは発表文の「最高精度」ではなく、次の5つです。
1. 日本語の自社データで、確信度が正解と外れで分かれるか
発表文は評価に「多言語」の課題を含むと書いていますが、日本語の結果は示していません。自社の過去データから20〜50件に正解のラベルを付け、外した件の確信度が、正解の件より低く出るかを確かめてください。正解率だけを見て決めると、上の実測のように「自信満々で間違える」相手を選ぶことになります。
2. しきい値ごとに「自動・誤り・人へ」の件数を数える
0.6・0.8・0.9・0.95 のように線を何本か引き、それぞれで「自動で処理した件数」「その中の誤り」「人に回った件数」を表にします。誤りを許せない業務なら、誤りゼロになる線で人に回る割合が現実的かを見ます。Foundry のドキュメントも「誤検知と見逃しのコストからしきい値を決める」ことを勧めています。
3. 選択肢の並び順と言い回しを変えて、答えが動くか
公式ドキュメントは既知の制約として「問いや選択肢の言い回し・順番で、スコアが変わりうる」と書き、選択肢の順番を入れ替えて試すことを勧めています。発表文の1.3%という数字は Microsoft 側の試験の結果です。自社の問いでも、選択肢の順番を入れ替えた版を1回流してみてください。
4. 「判断できない」の選択肢を入れておく
公式ドキュメントは、無理に選ばせたくない場面では cannot tell(判断できない)のような逃げ道の選択肢を入れるよう勧めています。問い合わせの振り分けなら「どれにも当てはまらない」を1つ足しておくと、低い確信度と合わせて人に回す入口が2つになります。
5. Jev と同じ問いで並べる
問いの書き方がほぼ同じなので、同じ問い・同じデータで Jev と Decision-1 を並べて測るのが一番早い比べ方です。形の上では、宛先・認証の書き方・model の値(Decision-1 はデプロイ名)の3つを差し替えれば同じ問いを投げられます。ただし応答の細かい項目名までは私はまだ確かめていないので、最初の1件は返ってきた中身を目で見てから集計を組んでください。
最初の1回を呼ぶまでの手順
Foundry の公式ドキュメントの手順を、流れが分かるように短くまとめます。
- Foundry ポータルでプロジェクトを開き、モデルカタログで
Microsoft-Decision-1を探して「Deploy」を選ぶ - デプロイの種類を選ぶ(データの置き場所に条件があれば、使えるなら
DataZoneStandard) - デプロイの詳細画面から、リソースのエンドポイント・デプロイ名・API キーを控える
<エンドポイント>/providers/microsoft/v1/systemoneに、model(デプロイ名)・state・questionsを送る
問い合わせを担当に振り分ける問いは、たとえば次のように書きます(公式ドキュメントの例を日本語に置き換えたもの)。
{
  "model": "<デプロイ名>",
  "state": "請求書の金額が先月と違います。",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "この問い合わせはどの担当が対応すべきか。",
      "criteria": {
        "billing": "請求・支払い・返金",
        "engineering": "不具合・エラー・障害",
        "support": "使い方・アカウントの質問",
        "unknown": "どれにも当てはまらない"
      }
    }
  }
}
同じ state に対する問いは、1回のリクエストにまとめられます。公式ドキュメントの例では、担当の振り分け(choice)・深刻度(score)・再問い合わせかどうか(noul)を1回で聞いています。
うまく動かないときは、公式ドキュメントの表が手がかりになります。404 はエンドポイントかパスの誤り、422 は model の値(デプロイ名になっているか)か問いの定義の誤り、429 は呼び出し回数の上限です。429 に備えて、待ち時間を伸ばしながら再試行する処理は最初から入れておくべきです。
Jev・Decision-1・Decisions APIの選び方
判定専用のAPIは、2026年10月時点で少なくとも3つの選択肢があります。OpenAI の Decisions API については Decisions APIとは|確信度を自分で測る手順 で詳しく書いています。私の判断の目安は次のとおりです。
こういう会社なら | まず試すもの | 理由 |
|---|---|---|
Azure・Microsoft 365 が土台で、外部のAPIキーを増やしにくい | Decision-1 | Entra ID と Azure の権限管理の中で使え、データゾーンの選択肢もある |
契約や権限の縛りがなく、すぐ試したい | Jev | キー発行だけで始められ、公開されている実測や作例が多い |
判定に画像も使いたい | Decisions API | 画像を判断の材料に渡せる(別記事参照) |
どれを選ぶにしても、最後に決めるのは自社のデータで測った確信度の分かれ方です。値段が同じで、問いの形もほぼ同じなら、比べるのは難しくありません。
使ってはいけない場面——公式が書いている制約
Foundry の公式ドキュメントは、既知の制約と注意点をはっきり書いています。導入前に必ず目を通してください。
- 人についての重い判断に単独で使わない:与信・採用・住まい・医療・法律のように人に関わる判断では、人の確認を挟んだ「判断の補助」として使い、唯一の決め手にしない
- 偏りの可能性:元のモデルや学習データの偏りを反映しうる。個人についての判断の唯一の根拠にしない
- 理由が出ない:判定の理由を書かない。人に説明が必要な判定には、別の仕組みと組み合わせる
- 有害な内容の見落とし:安全のフィルターとして使うと、微妙な有害表現を見逃したり、無害なものを引っかけたりしうる
- 知識が古い場合がある:最新の出来事を知っている前提の判定には向かない
文章を作る・要約する・説明するといった仕事は、そもそも Decision-1 の役目ではありません。公式ドキュメントも、Decision-1 で振り分けや関門を担わせ、通ったものだけを生成型のLLMに渡す組み合わせ方を示しています。私たちも Jev を使うときは同じ分担にしています。
よくある質問
Decision-1 は日本語で使えますか?
公式ドキュメントにも発表文にも、日本語への対応は明記されていません。発表文は評価に「多言語」の課題を含むとだけ書いています。日本語で使うなら、自社のデータで正解率と確信度の分かれ方を必ず測ってください。
Decision-1 はオープンソースですか?
元になった Qwen3.5-9B は Apache 2.0 で公開されているモデルです。ただ、Decision-1 自体のライセンスは公開されておらず、提供は Foundry と OpenRouter 経由です。自分の環境に重みを置いて動かす形ではありません。
Jev から乗り換えるべきですか?
Azure の中で使うこと自体に価値がある会社でなければ、急いで乗り換える理由はないと私は考えます。値段は同じで、Decision-1 の精度と較正の比較はまだ読める形で出ていません。同じ問いで並べて測ってから決めるのが確実です。
入力はどれくらいの長さまで渡せますか?
Decision-1 の入力の上限は、2026年10月12日時点で公式ドキュメント・発表文のどちらにも書かれていません。長い文書を判定させる予定なら、デプロイ後に実際の長さで試してください。
まとめ
- Decision-1 は、Jev とほぼ同じ形の問い(state と questions、noul・choice・score)を受け取る判定専用モデル。料金も入力100万トークンあたり0.042ドル・出力無料で同じ水準
- 違いは中身より置き場所。Azure の権限管理・Entra ID・データゾーンの中で使えることが一番の価値
- 「36のベンチマークで最高精度」は試験の名前も正解率も公開されておらず、Jev との数字もまだ読めない。公式ドキュメントも確信度を絶対値として信じすぎないよう書いている
- 私たちの実測では、判定モデルの差は形の保証や正解率ではなく「外したときに低い確信度を出せるか」に出た。Decision-1 もそこを自社の日本語データで測ってから選ぶ
判定モデルは、業務の自動化で「どこまでAIに任せ、どこから人に回すか」の線を引くための道具です。株式会社Fyveでは、この線引きを含めたAIの組み込み方を、実際の業務データで確かめながら設計しています。
Jevで得する仕事、損する仕事
Claude・GPTとの使い分けは3つの質問で決まる(全11ページ)
Jevは、渡した候補から選ぶことだけをするAIです。同じ判断をJev・Claude・GPTなど5つのAIにさせて測ると、正解率は88〜100%で並びました。差が出たのは速さと回数で、Jevは1回0.5秒と他の3〜5倍速く、1回の費用はGPT-5.6 Solの85分の1。だから任せるのは「選ぶだけの判断を、何度も・急いで回す仕事」です。書く・考える・説明する仕事はClaude・GPTに残します。
- 5つのAIに同じ判断をさせた実測(正解率・速さ・費用・外したときの自信)
- Jevに任せる仕事/Claude・GPTに残す仕事の一覧を、根拠つきで
- 候補を書けるか・何度も回すか・理由を見せるか——3つの質問で決める
- Claude Codeへの頼み方と、判断基準の書き方
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。