Decisions APIとは|確信度を自分で測る手順

「AIに判断を任せたいが、どこまで任せてよいか分からない」——問い合わせの振り分けや一次判定を自動化しようとすると、必ずここで止まります。
結論から言うと、判断を任せられるかどうかは正解率ではなく「外したときに、AIの自信の数字が下がるか」で決まります。ここが分かれていないと、しきい値で「自動」と「人手」を切り分ける設計そのものが成り立ちません。
株式会社Fyveは中小企業のAI活用を月額で伴走しています。私たちは2026年9月に同じ25件の判定を複数の形で流して確信度を実測しました。本記事では、2026年9月29日に発表されたOpenAIの「Decisions API」を題材に、公式がどこまで言っているかを一次で確かめたうえで、新しい判断APIが出たときに何を測れば導入を判断できるのかを書きます。
Decisions APIとは何か——公式が言っていること
Decisions APIは、2026年9月29日のDevDay 2026で発表されたAPIです。OpenAI自身の告知には、次のように書かれています。
Decisions API is in limited preview. It uses Luna to classify inputs, route requests, or choose an action from predefined answers.
もう1か所では、こうも書かれています。
Enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers.
整理すると、Decisions APIの特徴は次の3点です。
- 自由な文章を生成しない。開発者があらかじめ決めた選択肢の中から1つを返す
- 用途は分類・振り分け・エージェントの次の一手の選択
- GPT-6 Lunaの専用版で動く。文脈はテキストだけでなく画像でも渡せる
独立の報道によれば、OpenAIは「通常のAPI経由のLunaが約1.6秒かかるところを約150ミリ秒で返す」と説明しています。この数字の読み方は後半で扱います。
まだ限定プレビューで、仕様書そのものが読めない
ここが実務では一番効きます。告知に「limited preview」と書かれているとおり、誰でも叩ける状態ではありません。
私は仕様を確かめようとして公式のAPIドキュメントに当たりましたが、該当するガイドのページはHTTP 404を返しました(2026年10月1日時点)。旧ドメインからのリダイレクト先も同じです。つまり現時点では、リクエストとレスポンスの形すら公開されていないということになります。
「使えるかどうか」を判断する前に、「仕様が読めるかどうか」を先に確認する。限定プレビューの機能では、この順番を守らないと、読んだ気になっただけで設計に入ってしまいます。
「確信度が返る」は、まだ公式が言っていない
Decisions APIの解説記事をいくつか読むと、判で押したように同じ一文が出てきます。
It returns one answer from your list plus a confidence score.
「あなたが並べた選択肢から1つと、確信度を返す」。もしこれが本当なら、これは非常に大きな話です。後で書くとおり、確信度こそが「どこから先を人に回すか」を決める道具だからです。
そこで私は、出所を3つの経路で当たりました。結果は次のとおりです。
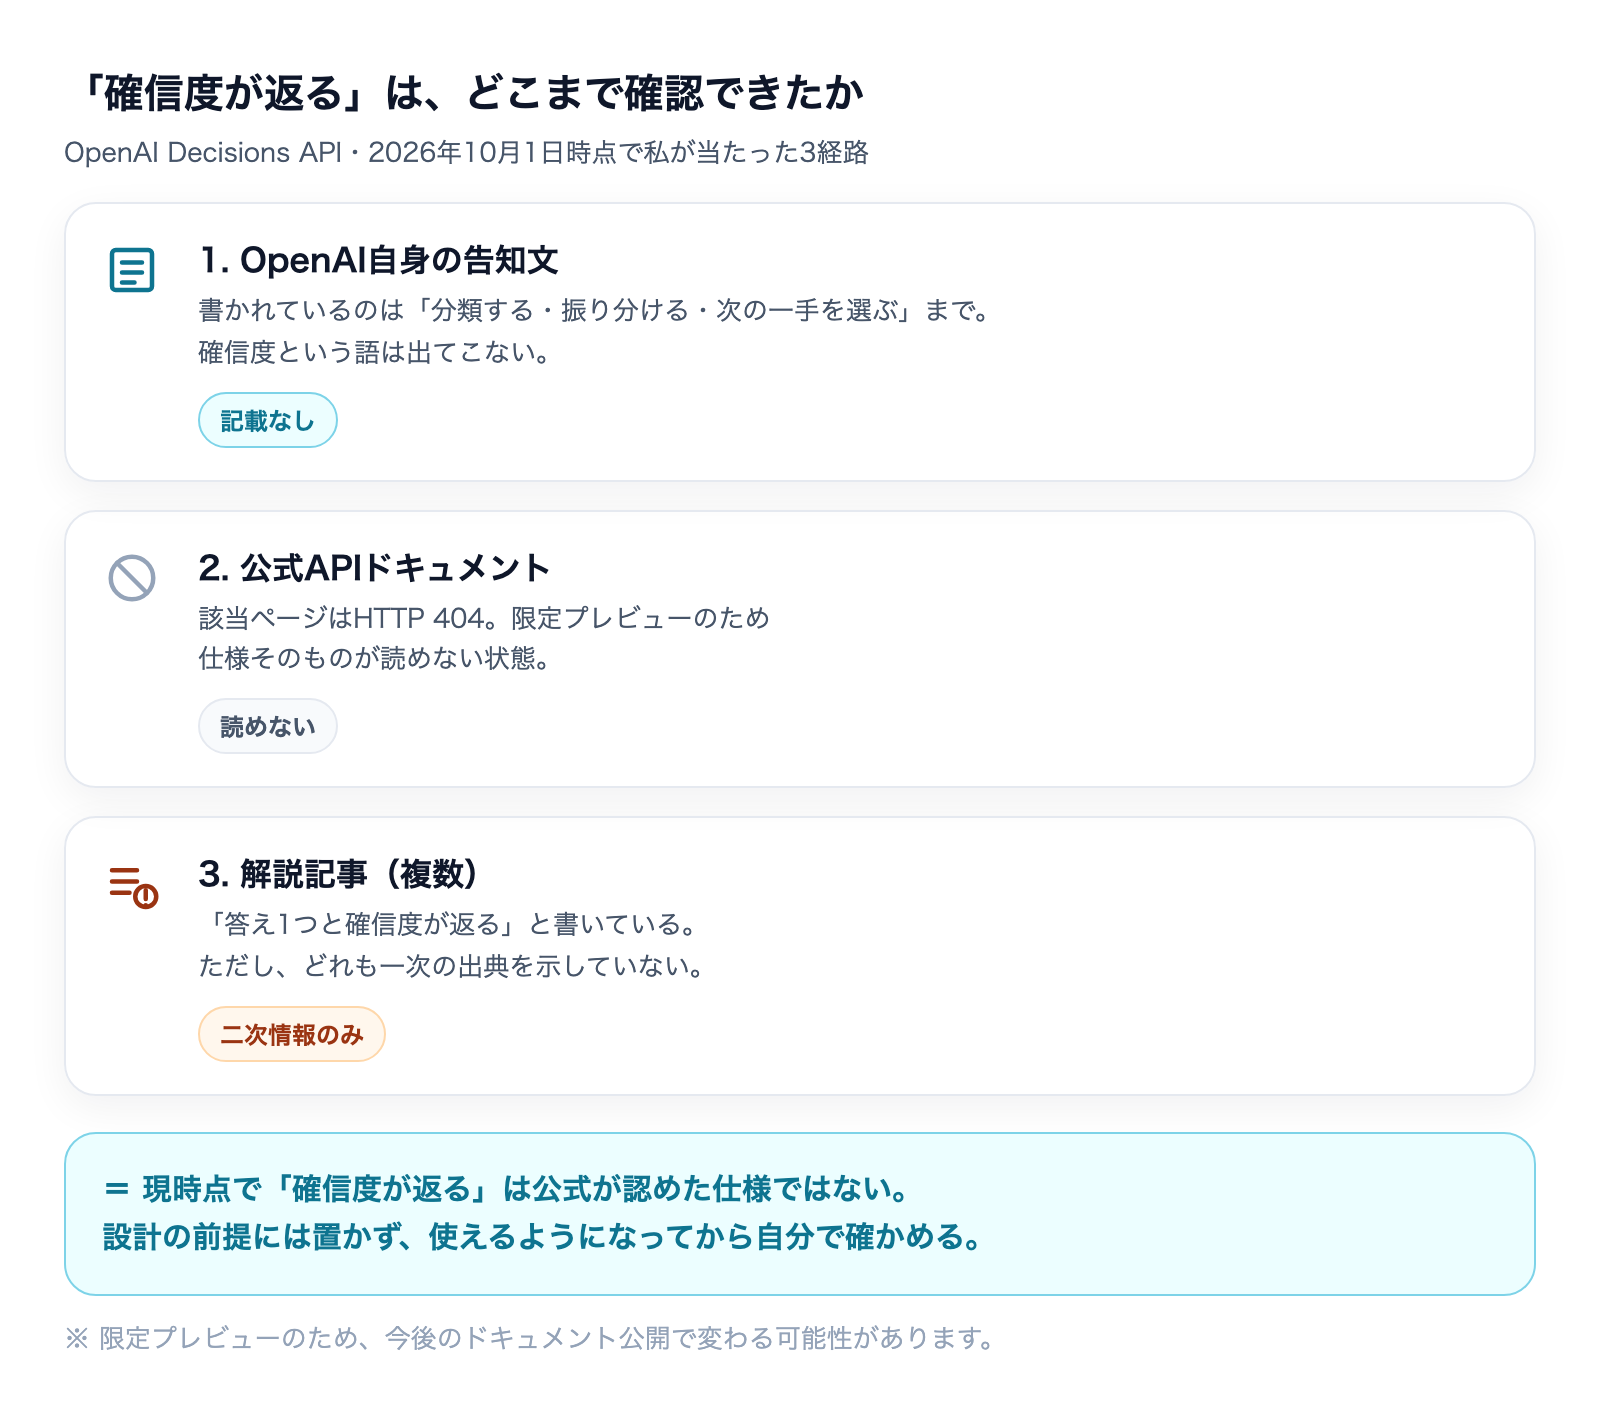
- OpenAI自身の告知文: 書かれているのは「分類する・振り分ける・次の一手を選ぶ」までで、確信度にあたる語は出てきません
- 公式APIドキュメント: 前述のとおり404で読めません
- 解説記事(複数): 「確信度が返る」と書いていますが、どれもOpenAIの文書や発言を出典として示していません。レスポンスの例やフィールド名も載っていません
したがって現時点で言えるのは、「確信度が返る」は公式が認めた仕様ではないということだけです。返らないと断定することもできません。分かっているのは「確かめられていない」という状態そのものです。
私たちはこれを「書かない」ではなく「前提に置かない」と処理しています。記事では紹介しますが、設計の土台にはしません。限定プレビューの機能なので、ドキュメントが公開されれば数日で答えが出る話でもあります。
なぜ、この1語にここまで拘るのか
細かい話に見えるかもしれません。しかし、確信度が返るかどうかで導入の設計が丸ごと変わります。
確信度が返らないAPIは「当たるか外れるかのどちらか」しか教えてくれません。この場合、導入の条件は「正解率が業務で許容できる水準に達しているか」の一点になり、届かなければ使えません。
一方、確信度が返り、それが信用できるなら、正解率が完璧でなくても業務に載せられます。自信のある件だけ自動で流し、自信のない件は人に回せばよいからです。この差は、導入できるかできないかの差になります。
確信度は「どこから先を人に回すか」の線を引く道具
中小企業のAI活用で私たちがよく受ける相談は「AIの精度は何%なら使えますか」です。この問いの立て方自体が、実はあまり役に立ちません。
業務に載るかどうかを決めているのは、平均の正解率ではなく「間違えた件を、事前に拾い出せるか」だからです。正解率95%でも、外した5%がどれか分からなければ全件を人が点検することになり、自動化の意味が消えます。逆に正解率が90%でも、怪しい10%に印が付くなら、その10%だけ人が見れば済みます。
その印になるのが確信度です。だから新しい判断APIを評価するとき、最初に見るべきは速さでも安さでもなく、「外したときに数字が下がるか」になります。
同じ25件を、2つの形で測った
では、実際に測るとどうなるのか。私たちは2026年9月に、自作した日本語の問い合わせ25件を使って比較しました。条件は揃えています——同じ25件・同じ基準の文言・同じ経路・再試行なし。
比べたのは次の2つです。
- 型付きの値を返すモデル(文章を生成せず、決められた型の値だけを返す種類のモデル)
- 汎用モデルの構造化出力(いわゆるJSONモードで、決まった形で答えさせる設定)
形の保証と正解率では、差がつかなかった
測る前、私は「汎用モデルの構造化出力はJSONが壊れる件が出るだろう」「選択肢の外の値を返すだろう」と予想していました。両方とも外れました。
25件のうちJSONとして壊れたものは0件。選択肢の外の値が出たものも0件です。さらに、形をより厳密に固定する設定にすると振り分けの一致率は96%で、型付きモデルと同率になりました。
これは実務的には良い知らせです。「選択肢を閉じた集合で渡す」という設計の効果は、特別なモデルを買わなくても、今使っている契約のまま得られるということだからです。
差がついたのは、確信度だけだった
では何が違ったのか。確信度です。
測った軸 | 型付きの値を返すモデル | 汎用モデルの構造化出力 |
|---|---|---|
JSONとして壊れた件数 | 構造上出ない | 0 / 25 |
選択肢の外の値 | 出ない | 0 / 25 |
振り分けの一致率 | 96% | 96%(形を厳密に固定した場合) |
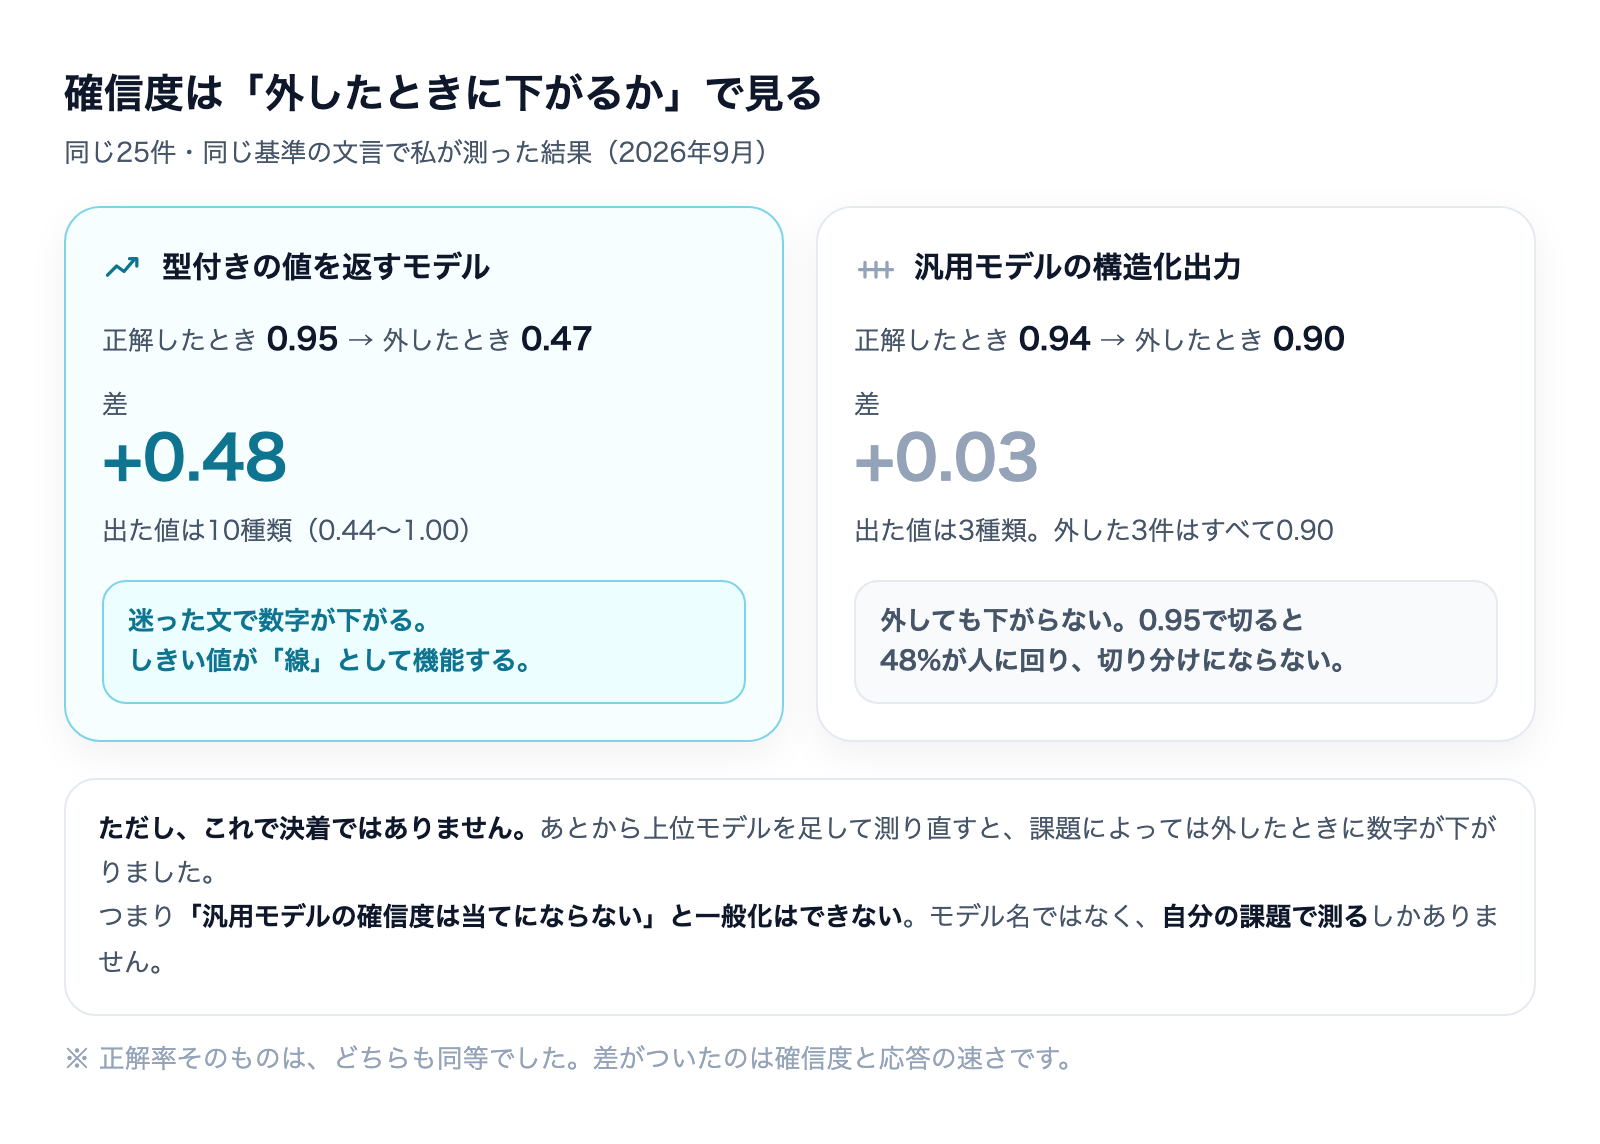
確信度:正解時/外したとき | 0.95 / 0.47 | 0.94 / 0.90 |
確信度が取った値の種類 | 10種類(0.44〜1.00) | 3種類 |
往復時間(中央値) | 508ミリ秒 | 15,351ミリ秒 |
数字を読むときに見てほしいのは、平均値そのものではなく差です。
型付きモデルは、正解したとき0.95・外したとき0.47で、差が0.48あります。対して汎用モデルの構造化出力は0.94と0.90で、差は0.03しかありません。しかも出てきた値は3種類だけで、外した3件はすべて0.90でした。
つまり、自信たっぷりに間違えていたということです。同じ1件を両方が間違えた場面では、片方は0.47と申告し、もう片方は0.90と答えました。
しきい値0.95で切ると、48%が人に回る
この差がそのまま設計に効きます。「確信度0.95以上なら自動、それ未満は人へ」という線を引いたとします。
差が0.48ある側では、迷った件だけが下に落ちるので、人が見るのはごく一部で済みます。一方、差が0.03しかない側で同じ線を引くと、25件のうち48%が人に回りました。半分近くを人が見るなら、それは切り分けになっていません。
確信度の数字が出ていることと、その数字が使えることは別物だ、というのがここでの学びです。
しきい値の具体的な引き方——取り返しのつく操作と、つかない操作で線を変える設計——は、別の記事で実装まで書いています。
同じ形が、まったく別の領域でも再現した
25件の問い合わせ振り分けだけでは、たまたまかもしれません。そこで私たちは、性質のまったく違う課題でも同じ比較をしました。画面上の要素一覧を渡して「次にどれを、どう操作するか」を選ばせる、という判断です。件数は20件です。
結果は次のとおりでした。
測った軸 | 型付きの値を返すモデル | 汎用モデル(同じ選択肢・形を厳密に固定) |
|---|---|---|
存在しない要素を返した件数 | 0 / 20 | 0 / 20 |
操作と対象がともに正解 | 95% | 95% |
確信度:正解時/外したとき | 0.857 / 0.28 | 0.995 / 1.00 |
確信度が取った値の種類 | 17種類(0.28〜1.00) | 2種類 |
読み取れることは2つあります。
1つは、「選択肢を閉じた集合で渡す」という設計の効果は、特定のモデル固有のものではないということ。存在しない要素を返した件数はどちらも0で、正解率も同率でした。ここは今の契約のままでも得られます。
もう1つは、外したときの確信度の振る舞いが、別の領域でも同じ形で出たということです。外した件で、片方は0.28まで下げ、もう片方は1.00——満点の自信で間違えました。値の種類も17対2です。
課題の中身がまったく違うのに同じ形が出たことで、「確信度の分離を見る」という評価軸自体は課題をまたいで使えると判断しました。
ただし、これで決着ではない
ここは正直に書きます。上の結果を出した数日後、私たちは上位モデルを追加して測り直しました。すると、課題によっては汎用モデルでも外したときに確信度が下がりました。
したがって「汎用モデルの確信度は当てにならない」という一般化は成り立ちません。最初の結果は、軽量な1モデルについて言えたことでした。
言い換えると、確信度が使えるかどうかは、モデル名では決まらないということです。どのモデルかではなく、どの課題を、どの基準の文言で、どう渡したかで変わります。だから、カタログを読んで決めることはできません。
「較正されている」というラベルも、そのまま信じない
Decisions APIをめぐる解説の中には、「OpenAIの確信度はモデルの自己申告で較正されていない。対して競合の型付きモデルは較正済みだ」という対比で書かれているものもあります。
較正とは「自信が高いほど実際によく当たる」という性質のことです。ただ、この対比もラベルとして受け取らないほうがいいと考えています。
理由は2つあります。1つは、OpenAI側については前述のとおりそもそも公式が確信度について何も言っていないので、較正されているかいないか以前の段階だということ。もう1つは、私たち自身の測定で、同じモデルでも課題を変えると確信度の振る舞いが変わったからです。
較正は集団としての性質であって、目の前の1件が当たっている保証ではありません。「較正されているから安心」ではなく、「較正されているなら、しきい値で切り分ける設計が成り立つ」——この読み方が正確です。そして、その前提が自分の業務で成り立つかは、自分のデータで確かめるしかありません。
速さの数字は「公式の説明値」として読む
Decisions APIの紹介で必ず出てくるのが「150ミリ秒」「通常の1.6秒に対して約10倍速い」という数字です。
この数字は、報道がOpenAIの説明として伝えているものです。第三者が独立に計測した値ではありません。私自身も限定プレビューに申し込んでいないため、1件も測っていません。
速さの数字を見るときは、次の3点を分けて読むと間違えません。
- 誰が測ったか(提供元の説明か、独立の計測か)
- どこからどこまでの時間か(モデルの推論時間か、自分の環境からの往復時間か)
- 比較相手は何か(同じ条件の別モデルか、自社の通常経路か)
参考までに、私たちの実測では日本から叩いた往復時間の中央値が508ミリ秒でした。これは推論時間ではなく往復時間なので、提供元が出す推論時間とは測っている区間が違います。同じ「ミリ秒」でも並べて比べられません。
なお、同じDevDayでは速度そのものを追加料金で買う推論モードも発表されており、報道では「最大6倍速くなるが、費用も標準の6倍」と伝えられています。速度と費用が1対1で交換される値札が出たと読むと、判断材料としては分かりやすくなります。
Decisions APIが本当に新しい点——画像を文脈として渡せる
ここまで慎重な書き方を続けましたが、確実に新しいと言える点もあります。文脈として画像を渡せることです。
私たちが比較に使っていた型付きモデルは、入力がテキストだけで、画像を文脈として渡すことができませんでした。つまり「写真を見て、決められた選択肢から1つ選ぶ」という仕事は、これまで型付き側では組めなかったということです。
この差は実務で効きます。たとえば、送られてきた画像が何の書類かを判定して担当部署へ振り分ける、といった業務です。これまでは画像を文字に起こす工程を前段に置く必要がありました。
今わかっていること・わかっていないことを分けて並べる
「既存の型付きモデルとどちらを選ぶか」を検討したい方向けに、現時点の状態を表にします。空欄を埋めないことが、この表の役目です。
項目 | Decisions API | 既存の型付きモデル |
|---|---|---|
やること | 決められた選択肢から1つ返す | 決められた型の値を返す |
画像を文脈に渡せるか | 渡せる | 渡せない(テキストのみ) |
確信度が返るか | 公式に記載なし(未確認) | 返る |
レスポンスの形 | ドキュメント未公開 | 公開済み |
料金 | 未公表 | 公開済み |
使えるか | 限定プレビュー(申請が要る) | 一般提供 |
速さ | 提供元の説明値のみ | 自分で測れる |
太字にした4項目が、今日の時点では比較のしようがない部分です。ここを埋めずに「どちらが良いか」を決めることはできません。
逆に言えば、はっきりしている違いは「画像を渡せるかどうか」の1点だけです。画像を起点にした判定が業務にあるなら、Decisions APIは待つ価値があります。無いのであれば、今すぐ手元で動かせる手段で先に物差しを作ったほうが早い、というのが私たちの判断です。
新しい判断APIが出たとき、何を測れば判断できるか
ここが本記事でいちばん保存する価値のある部分だと思います。Decisions APIに限らず、この種のAPIが出たときの評価手順です。5手で済みます。
手順1: 自分の業務から25件だけ取り出す
実際の問い合わせや書類から25件ほど選びます。多すぎると始まりません。境界にある件(人が読んでも迷う件)を必ず数件混ぜるのが肝です。全部が明らかな件だと、どのモデルでも満点になって差が見えません。
手順2: 人の正解を先に付ける
AIに渡す前に、人の手で正解を付けます。これが物差しになります。後から付けると、AIの答えに引きずられます。
手順3: 同じ25件を、複数の形で流す
最低でも「今使っている汎用モデルに、形を固定して答えさせたもの」と「新しいAPI」の2つを比べます。基準の文言・選択肢・渡し方は完全に揃えます。ここが揃っていないと、モデルの差ではなく自分の書き方の差を測ることになります。
手順4: 正解率ではなく、確信度の分離を見る
見る数字は次の3つです。
- 正解したときの確信度の平均
- 外したときの確信度の平均
- 確信度が取った値の種類の数(3種類しか出ないなら、それはしきい値の材料になりません)
差が0.4以上あれば、しきい値での切り分けが設計として成立します。差が0.05に届かないなら、そのモデルでは自動と人手の線が引けないと判断してよいと考えています。
手順5: 線を引いて、人に回る件数を数える
最後に、しきい値を仮に決めて「自動で処理した件数」「そのうちの誤り」「人に回った件数」を数えます。人に回る割合が業務で許容できる範囲に収まって初めて、導入の判断ができます。
この5手は、半日あれば終わります。ベンダーの資料を読み比べる時間より短く、得られる答えは確実です。
今日の時点で、何をすればよいか
Decisions APIは限定プレビューで、仕様書も公開されていません。ですから今日できるのは、使えるようになった日に即座に判断できる準備をしておくことです。
具体的には、手順1と手順2——自分の業務から25件を選び、人の正解を付けておく——をやっておきます。この25件は、Decisions APIに限らず、今後出てくるどの判断APIにもそのまま使えます。物差しは一度作れば使い回せます。
逆に、今日やってはいけないのは、解説記事の「確信度が返る」を前提に設計を始めてしまうことです。前提が崩れたときに、設計ごと作り直しになります。
よくある質問
Q. Decisions APIは今すぐ使えますか
2026年10月1日時点では限定プレビューで、誰でも叩ける状態ではありません。広い提供は「数日内」と報じられていますが、これは提供元の説明を報道が伝えたもので、確定した日付ではありません。公開日を前提にした計画は立てないほうが安全です。
Q. 確信度が返らなかった場合、この記事の話は無駄になりますか
なりません。確信度が返らないと分かれば、それは「自動と人手をしきい値で切り分ける設計は使えない」という結論が早く出たということです。その場合は、同じ入力を複数回投げて答えが一致した割合を確信度の代わりに使う方法があります。処理の回数は増えるので、重い判断にだけ使うのが現実的です。
Q. 今使っているモデルのまま、精度を上げる方法はありますか
あります。私たちの実測で効果がはっきり出たのは「答えの候補を先に書いて、閉じた集合として渡す」ことです。自由に答えさせるのをやめて選択肢を固定しただけで、振り分けの一致率が88%から96%に上がりました。新しいAPIを待たずに、今日から試せます。
Q. 25件では少なすぎませんか
導入の可否を決めるには十分だと考えています。25件で確信度の差が0.03しか出ないなら、件数を増やしても線は引けません。逆に差がはっきり出たなら、そこから件数を増やして精度を詰めていけばよい話です。最初の関門を通すための道具と考えてください。ただし、25件は集団としての傾向を見るものであって、目の前の1件の正しさを保証するものではありません。
Q. 社内に開発者がいなくても取り組めますか
手順1と手順2——業務から25件を選び、人の正解を付ける——は業務を分かっている方の仕事で、開発の知識は要りません。むしろここは、現場を知っている人でないと作れません。手順3以降で技術的な手当てが必要になりますが、物差しを先に作っておくと、その後の見積もりが具体的になります。
まとめ
- Decisions APIは2026年9月29日に発表された、文章を生成せず決められた選択肢から1つを返すAPI。現在は限定プレビューで、公式のドキュメントは読めない状態
- 「確信度が返る」と書いているのは解説記事だけで、OpenAI自身の告知にその記載はない。返らないとも断定できないが、設計の前提には置かない
- 判断を任せられるかは正解率ではなく「外したときに確信度が下がるか」で決まる。私たちの25件では、差が0.48ある側と0.03しかない側で結論が割れた
- ただし、これはモデル名で決まる話ではない。課題を変えると振る舞いが変わったため、自分の業務で測るしかない
- やることは5手。境界の件を混ぜた25件を作り、人の正解を先に付け、同条件で流し、確信度の分離を見て、人に回る件数を数える
株式会社Fyveでは、この「25件の物差しを作る」ところから中小企業のAI活用を一緒に設計しています。新しいAPIが出るたびに振り回されないために、自社の物差しを先に持っておくことをおすすめします。
Jevで得する仕事、損する仕事
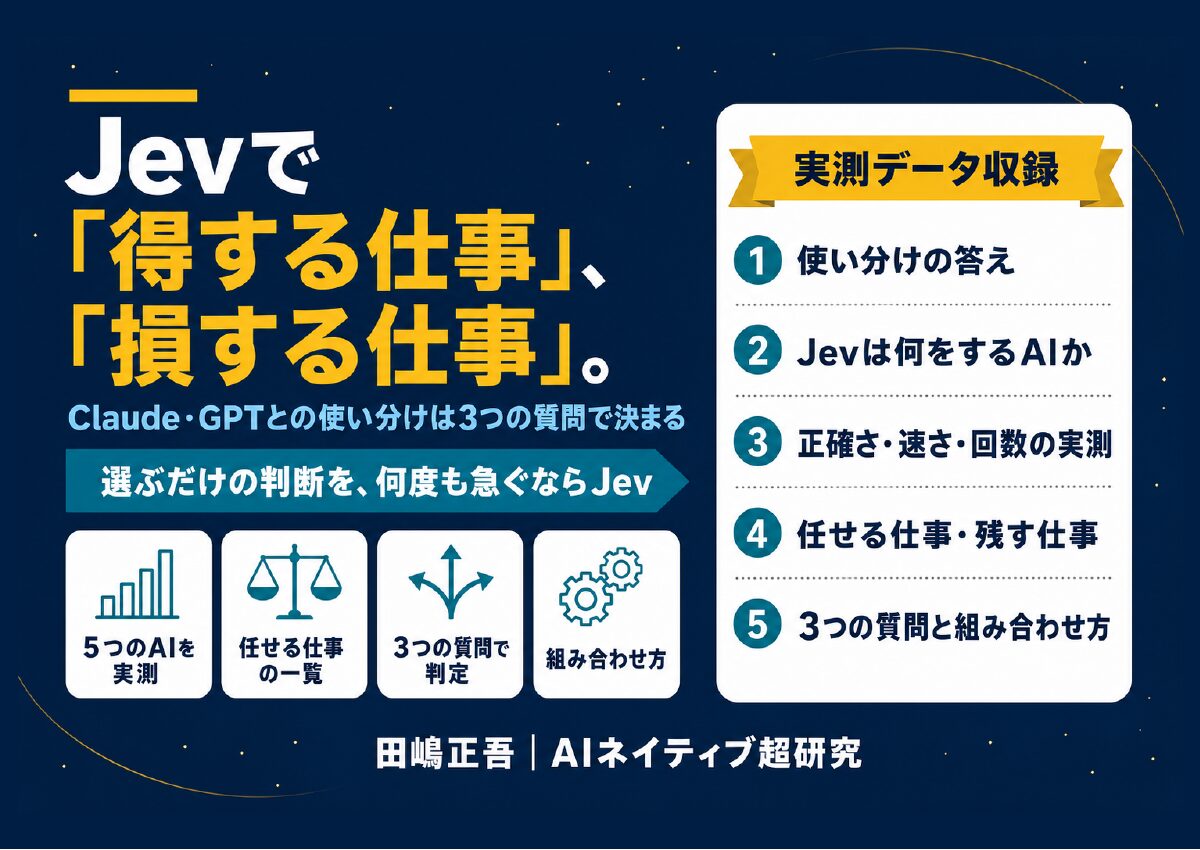
Claude・GPTとの使い分けは3つの質問で決まる(全11ページ)
Jevは、渡した候補から選ぶことだけをするAIです。同じ判断をJev・Claude・GPTなど5つのAIにさせて測ると、正解率は88〜100%で並びました。差が出たのは速さと回数で、Jevは1回0.5秒と他の3〜5倍速く、1回の費用はGPT-5.6 Solの85分の1。だから任せるのは「選ぶだけの判断を、何度も・急いで回す仕事」です。書く・考える・説明する仕事はClaude・GPTに残します。
- 5つのAIに同じ判断をさせた実測(正解率・速さ・費用・外したときの自信)
- Jevに任せる仕事/Claude・GPTに残す仕事の一覧を、根拠つきで
- 候補を書けるか・何度も回すか・理由を見せるか——3つの質問で決める
- Claude Codeへの頼み方と、判断基準の書き方
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。