JevはなぜLLMより速く安いのか|仕組みと9つの苦手

「本当にLLMの200倍も速いのか」「安いのは分かったが、精度は落ちないのか」——Jevの数字を見て、まずここを疑うのが健全な反応だと思います。
結論から言うと、速さと安さには構造的な理由があり、それは誇張ではありません。ただし同じ構造から、はっきりした苦手も生まれます。しかも苦手のほうは、公式が専用のページを作って自ら列挙しています。読まずに使えば事故る類の内容です。
株式会社Fyveは中小企業のAI導入を支援しています。この記事では、2026年9月20日時点の公式ドキュメントをもとに、なぜ速いのか・なぜ安いのか・何が苦手なのかを順に整理します。数字の出所も、条件つきのものは条件ごと書きます。
なぜ速いのか——文章を書かないから
Jev(ジェブ)の速さは、賢さの結果ではありません。やることを減らした結果です。
ChatGPTやClaudeのような文章を書くモデルは、1文字ずつ(正確にはトークンずつ)順番に生成します。次の1文字を決めるために、直前までの全部を見直す。この繰り返しなので、答えが長くなるほど時間がかかります。「よく考えて答えて」と指示すると遅くなるのは、考えている過程そのものを文字として書き出しているからです。
Jevはこれをやりません。返すのは、こちらが用意した選択肢に対する確率だけです。文章を書かないので、順番に生成する必要がなく、複数の問いをまとめて投げても一度に処理できます。
ここが実務で効いてきます。公式は「すべての問いが並列で評価されるので、問いを増やしても応答時間にはほとんど影響しない」と書いています。つまり1つ聞くのも10個聞くのも、かかる時間はほぼ同じです。
従来のモデルで10個の判断をさせようとすると、1つのプロンプトに詰め込んで長い答えを書かせるか、10回に分けて呼ぶかのどちらかになります。前者は答えが長くなるぶん遅く、後者は10倍の往復が発生します。この選択を迫られないのが、Jevの構造的な利点です。
公表されている応答時間は70〜500ミリ秒(2026年9月20日時点の公式記載)。国内の開発者が公開した実測では、サーバーからの往復で中央値387ミリ秒という報告がありました。日本からアメリカのサーバーまでの通信時間が乗ることを考えると、整合する範囲です。
なぜ安いのか——出力が無料になる理由
料金は入力100万トークンあたり0.042ドル、出力は無料です(いずれも米ドル・税別/2026年9月20日時点の公式記載。最新の条件はtypesafe.aiでご確認ください)。出力側の料金について同社は「計測するには安すぎる」という言い方をしています。
この構造も、文章を書かないことから来ています。通常のモデルでは、出力トークンの単価は入力の5倍程度に設定されているのが一般的です。1文字ずつ順番に生成する処理が重いからです。
Jevの出力は、選択肢ごとの確率が数個並ぶだけです。課金する対象としての量がそもそも存在しません。だから無料にできる。値引きではなく、構造上そうなるという話です。
ただし、この価格が続くかどうかは別の問題です。同社自身が、価格の持続可能性については「長期で示すしかない」と述べています。早期アクセス期の価格をそのまま年間予算の前提に置くのは、時期尚早だと見ています。
「較正されている」とは何を指すのか
Jevの説明でいちばん分かりにくいのが、この「較正(キャリブレーション)」という言葉です。ここを誤読すると、確信度の使い方を間違えます。
公式ドキュメントの説明はこうです。「System Oneモデルは較正された判断のために訓練されている。その確率は、不確かさを反映するよう、結果に対して最適化されている」という趣旨の記述です。
噛み砕くと、「確率0.8と答えたものは、実際に8割くらい当たる」という状態を目指して訓練されているということです。
これがなぜ重要か。従来のモデルに「あなたの自信は何%ですか」と聞いても、返ってくる数字はあてになりません。だいたい高めに出ますし、同じ質問でも揺れます。公式ドキュメントの比較表も、既存のモデルの確信度について「過信しがちで不安定」と書いています。自信の数字が信用できないと、「自信があるものは自動、無いものは人へ」という切り分けが成立しません。
ここで止めずに、公式が同時に書いている但し書きまで読む必要があります。「較正は、個々の答えが正しいことを保証しない」という一文です。
較正が保証するのは集団としての性質です。確率0.8のものを100件集めれば概ね80件当たる、という話であって、目の前の1件が当たっているかは別です。「較正されているから安心」ではなく「較正されているから、しきい値で切り分ける設計が成り立つ」——この読み方が正確です。
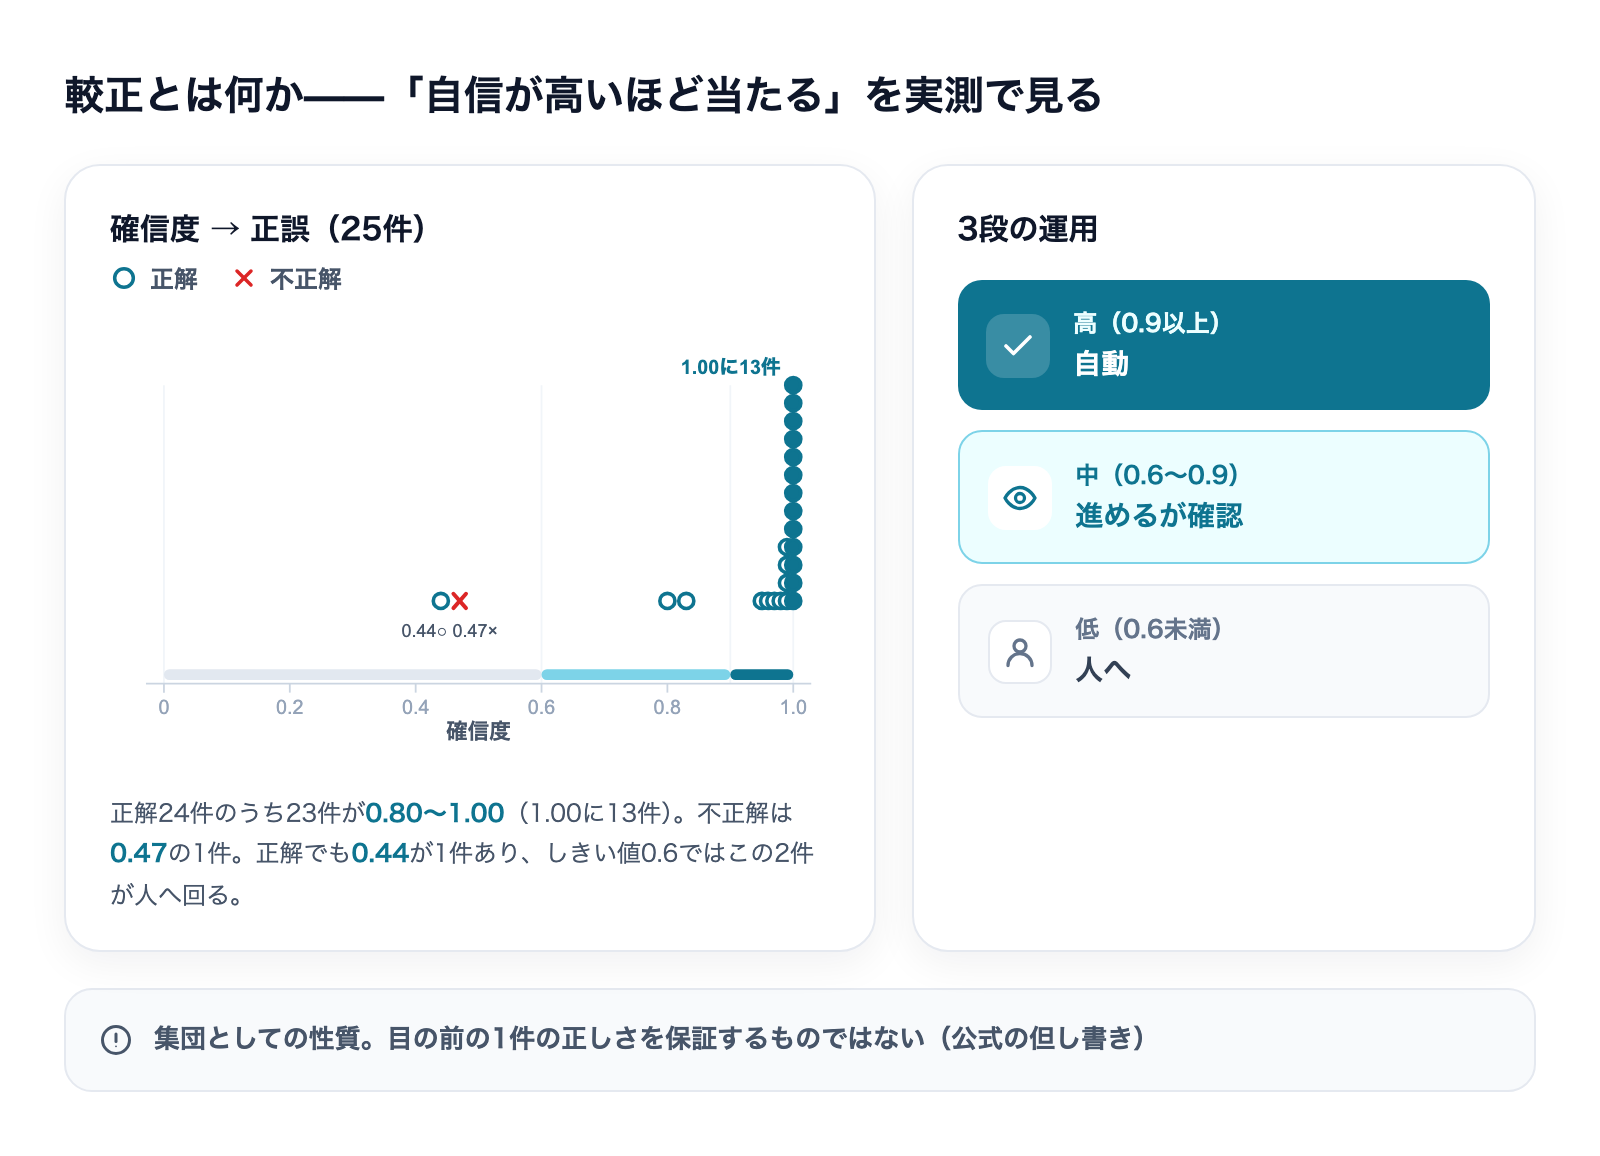
「較正されている」は本当か——自分で測った
同社の検証(4種類の業務ワークフロー)では、Jevの平均正解率は67.8%、1件あたり0.0004ドル・0.4秒と公表されています。数字の読み方や但し書きは別記事で扱ったので、ここでは較正の主張が実際に成り立っているかを自分で確かめた結果を書きます。
2026年9月21日、自作した日本語の問い合わせ25件をJevに振り分けさせ、人手の正解と突き合わせました。一致率は96%。ここで見たいのは正解率ではなく、正解したときと外したときで確信度に差があるかです。
日本語 | 英語(同じ25件の英訳) | |
|---|---|---|
確信度の平均:正解したとき | 0.95 | 0.98 |
確信度の平均:外したとき | 0.47 | 0.58 |
確信度0.9未満の件数 | 4件(誤り1件を含む) | 2件(誤り1件を含む) |
差は明確でした。外した文は日英とも「請求か契約か」の境界にある文で、外したときの確信度は日本語0.47・英語0.58でした。較正とは「自信が高いほど当たる」という性質のことで、この25件ではそのとおりに振る舞いました。しきい値0.6で切ると、日本語では25件中23件を自動処理して誤りゼロ、人が見るのは2件でした。
一方で、これは25件の話です。較正は集団としての性質であって、目の前の1件が当たっている保証ではありません。公式自身がそう書いています。「較正されているから安心」ではなく「較正されているから、しきい値で切り分ける設計が成り立つ」——この読み方が正確です。
基準の文言が、そのまま仕様になる——実測で踏んだ
3種類の問いの仕様は別記事に譲り、ここでは実測で分かった「仕組み上の性質」を1つ書きます。Jevは基準を字義通りに読みます。公式の限界ページに「字義通りに読む。否定・限定・暗黙の条件に弱い」とありますが、これは弱点であると同時に、使う側が握れる仕様でもあります。
緊急度の3段階採点で、最上段の基準を「すぐ対応が要る」から「業務が止まっている。すぐ対応が要る」へ書き換えて試しました。それだけで、同じ「先月分の請求が二重に引き落とされている」という文のスコアが1.99から1.4前後(3回の実行で1.37〜1.43)に動きました。二重引き落としは急ぐが業務は止まっていない——変えた後の基準に照らせば、Jevの読みのほうが正確です。
私はこの文に「最上段」の正解ラベルを付けていました。自分で書いた基準と照らすと、ラベルのほうが間違っていたわけです。同じ理由で25件のうち3件のラベルを直しました。外れたのはモデルではなく設計のほう、という実例です。
この性質は、9つの苦手のうち「指示と基準の不整合」「字義通りに読む」の2つと直結します。対処も同じで、含みのない平坦な文で、本当に判定したい条件をそのまま書く。「適切に判断して」は通りません。逆に言えば、基準を1行変えるだけで挙動を調整できる道具でもあります。
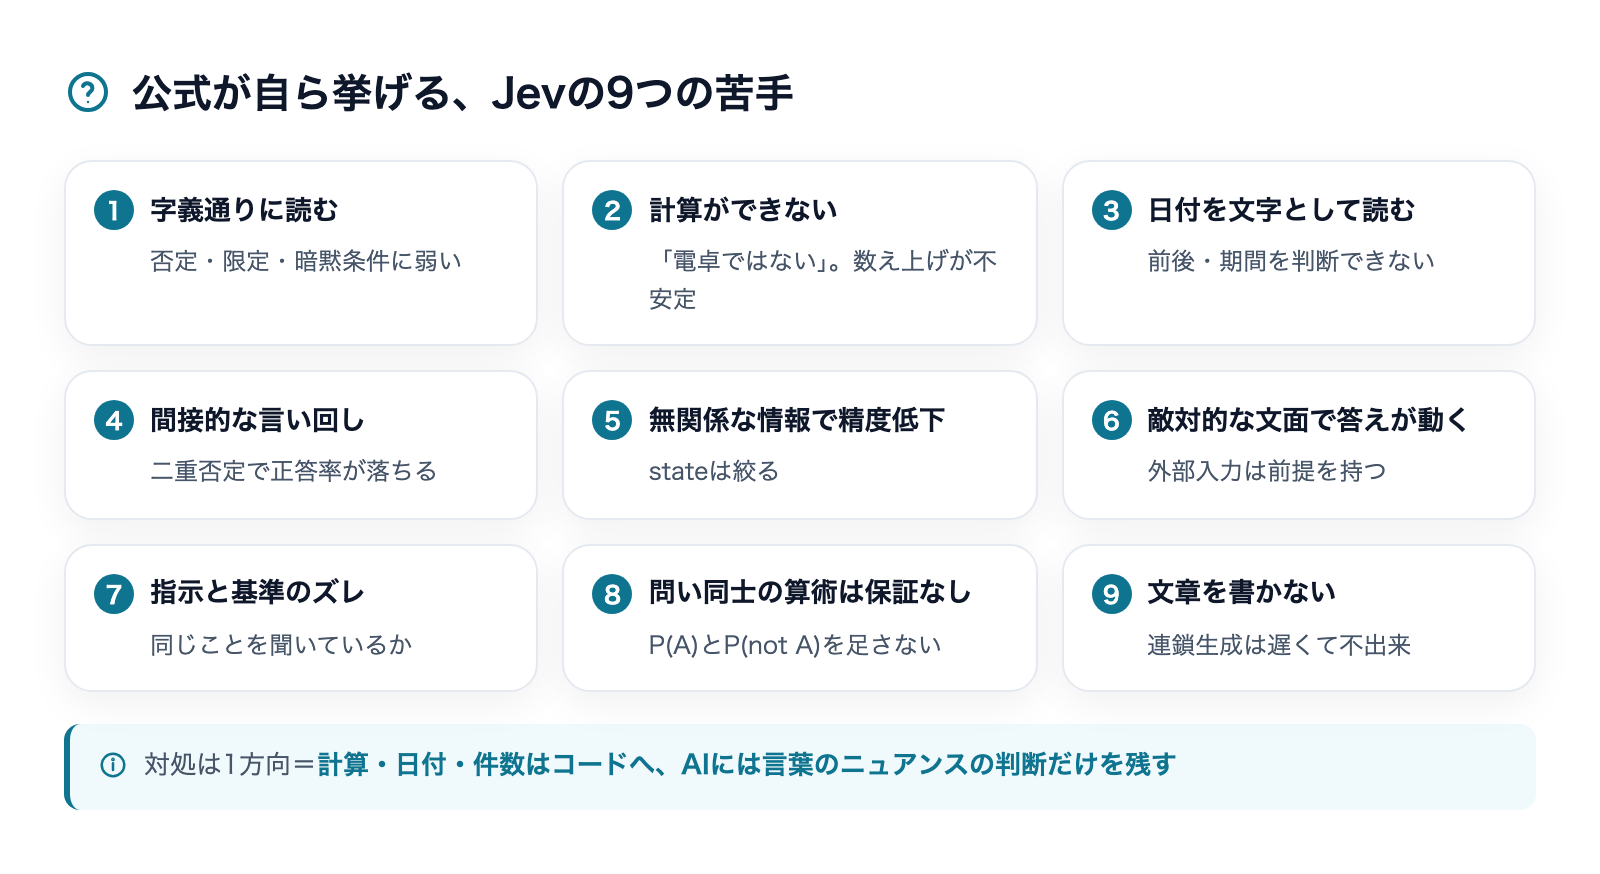
公式が自ら挙げる、9つの苦手
ここが本題です。同社は「モデルの苦手」を説明する専用ページを公開しており、9つの失敗パターンを列挙しています。国内の解説記事ではほとんど触れられていないので、要点を整理します。
1. 指示を字義通りに読む
否定、「〜を除く」といった限定、言外の条件に弱いと明記されています。「至急のもの以外を振り分けて」のような書き方は、意図通りに解釈されないことがあります。含みのない平坦な文で書くのが前提です。
2. 計算ができない
公式の表現は「Jevは電卓ではない」です。特に数え上げが不安定で、単語の文字数・ある語が何回出たか・長いリストの件数、いずれも信頼できないとされています。
3. 日付を日付として扱えない
日付を順序のある量ではなく、文字として読みます。どちらが先か、何日空いているかを正しく判断できません。形式が混在していたり「来週」のような相対表現が入ると、さらに悪化します。
4. 間接的な言い回しに弱い
二重否定や、何段か挟んだ言い方は正答率が落ちます。
5. 関係のない情報が混ざると精度が落ちる
渡すデータが大きくなり、判断に関係のない内容が増えるほど正解率が下がると明記されています。「とりあえず全部渡す」は逆効果です。
6. 敵対的な文面で答えが動く
モデルを誘導する目的で書かれた文面に対して、無条件に頑健ではありません。外部から来る文章を判定させる用途では、この前提を持っておく必要があります。
7. 指示と選択肢がずれていると混乱する
質問文と、選択肢の定義が別のことを聞いている状態です。書いた本人は気づきにくい類の不整合です。
8. 別々の問いのあいだに算術的な整合性はない
「Aである確率」と「Aでない確率」を別々の問いとして聞いたとき、その2つを足して1になる保証はありません。公式は「別々の問いのあいだで算術の恒等式を期待するな」と書いています。片方の答えからもう片方を計算で導く設計は避けてください。
9. 文章を書かない
仕様どおりですが、念のため。つなげて生成させようとしても「うまくいかず、非常に遅い」と公式が明記しています。
対処は1つの方向に集約される
公式が挙げている対処法を並べると、結論はほぼ1つです。計算・日付・件数の処理はコードに戻し、AIに残すのは言葉のニュアンスを読む判断だけにする。加えて、渡すデータを絞る、広い問いを小さく割る、自由記述ではなく有限の選択肢に落とす、指示と選択肢の表現を揃える。
もう1点、運用上の注意として「確信度のしきい値を調整したら、モデル名を別名ではなくバージョン番号で固定せよ」という案内があります。既定の jev-latest は最新版を指すため、モデルが更新されると、せっかく調整したしきい値の意味が変わってしまうからです。
投入前に自分で確かめる5項目
9つの苦手を、導入前の確認項目に落とすと次の5つになります。私が実測の前後で実際に使った順です。
- 問いの中に数える・計算する・日付を比べる要素が混じっていないか。混じっていたら、その部分だけコードに切り出す
- 基準の文に否定・「〜を除く」・二重否定がないか。あれば肯定形に書き直す
- 指示文と基準が同じことを聞いているか。指示は「緊急度」、基準は「重要度」のようなズレがないか
- stateに判定と無関係な項目が入っていないか。入っていたら落とす
- 同じ入力を10回流して答えが割れる回数を数え、割れた文の基準を見直す
この5つを通してから測ると、外れた件の多くが「モデルの限界」ではなく「基準の書き方」に分類されます。私の25件でも、外した1件と確信度が0.9を切った3件は、いずれも「請求か契約か」のように選択肢の境界が曖昧な文に集中していました。
日本語で使うときに知っておくこと
日本の業務で使う場合、避けて通れない記載があります。公式ドキュメントは、英語が主であり、日本語を含むCJK(中国語・日本語・韓国語)では精度が落ちると明記しています。そのうえで「非英語で運用する前に自分でテストすること」と書かれています。
これは「日本語では使えない」という意味ではありません。「英語ほどの精度は出ないので、投入前に自分のデータで測れ」という指示です。
国内の検証報告も出始めていますが、まだ小規模な試行の段階です。他人の数字は参考にはなっても、自社の文面で測った数字の代わりにはなりません。
私の25件では日英で正解率が同じ96%で、判定が割れたのも同じ2件(どちらも請求か契約かの境界)でした。少なくとも問い合わせ文の振り分けでは、言語より基準の曖昧さのほうが効いていました。ただし25件は25件です。業種の用語や社内の言い回しが入れば結果は変わります。
もう1つ、実務で当たる制約があります。50件を順番に流しただけで、混雑を示す429応答が計44回返ってきました。公表の上限(毎分1,200リクエスト)よりはるかに少ない量でこれです。指数バックオフの再試行で全件通りましたが、まとめて処理するなら最初から入れておく前提です。
あわせて、扱えるのはテキストだけです。画像・音声・動画は対象外だと公式に明記されています。1回のリクエストは64,000トークンまで(うち評価対象のデータ部分は32,000トークンまで)という上限もあります。
自社で検証するなら、何を測るか
公式の数字も、他社の検証も、最後は自社のデータで確かめるしかありません。特に日本語の業務文書では、公式自身がテストを求めています。測る項目を4つに絞ると次のようになります。
- 一致率: 代表的な入力を20〜30件選び、人が付けた正解と突き合わせます。数件で判断すると、たまたま当たった・外れたに振り回されます。件数が確保できないなら、その旨を添えて社内に出してください
- 答えの揺れ: 同じ入力を10回流して、答えが割れた回数を数えます。体感ではなく回数で見ます
- 確信度の分布: 正解したものと外したもので、確信度に差が出ているかを見ます。ここが本当の合否です。外したものの確信度が低ければ、しきい値で切り分ける設計が機能します。逆に外したものが高い確信度で返ってくるなら、その問いの立て方自体を見直す必要があります
- 往復時間: 日本からの実測値を取ります。公式の70〜500ミリ秒はモデル側の処理時間であり、通信時間は含まれません
3つ目について補足します。正解率が7割でも、外した3割が低い確信度に集まっていれば実務では使えます。低い側を人に回せばよいからです。逆に正解率が8割でも、外した2割が自信満々で返ってくるなら、切り分けが効かないので全件を人が見ることになります。見るべきは平均正解率ではなく、確信度と正誤の関係です。
あわせて、外した事例は必ず原文ごと残してください。多くの場合、原因はモデルではなく問いの立て方や選択肢の定義の曖昧さにあります。9つの苦手のうち「指示と選択肢がずれている」「字義通りに読む」は、この見直しで直せる範囲です。
「安い」を実測で確かめる
費用についても、公表値ではなく実測を載せておきます。50件のレスポンスに記録されていた定価換算の費用は、1件あたり約0.00002ドル(日本語0.0000272ドル・英語0.0000211ドル)でした。1ドル150円で0.003円強。月に10万件処理しても300〜400円という桁です。
同社の検証で大型モデルが1件0.1〜0.2ドルだったことと並べると、桁が4つ違います。「444.6倍安い」という看板の数字は再現できませんでしたが、桁で見れば誇張ではない、というのが実測の感触です。
なお実際の課金は50件すべてで0でした。定価換算だけが記録されている状態で、無料枠かローンチ時の扱いかは断定できません。
費用の見え方も、ゲートウェイ経由なら1件ごとにレスポンスの中で確認できます。月次の請求書を待たずに、試した当日に桁を把握できるのは実務上ありがたい点です。
速度の外れ値も1件記録しておきます。50件中1件だけ応答に約20秒かかりました。残りは0.38〜0.65秒の範囲にすべて収まっており、この1件だけは原因を特定できていません。ゲートウェイを経由する構成では、こうした外れ値をどう扱うか(タイムアウトと再試行)を先に決めておく必要があります。1件の遅延で全体を止めない作りにしておけば、実害は出ません。
結論——置き換えではなく、分担
ここまでを整理すると、Jevと従来のLLMの関係ははっきりします。競合ではなく、担当が違います。
- Jevが向く: 答えの候補が決まっている判定を、大量に・速く・安くこなす。しかも自信の度合いつきで返してほしい
- 従来のLLMが向く: 文章を書く、コードを書く、理由を説明する、答えの形が事前に決まらない仕事
- コードが向く: 計算、日付の比較、件数の集計、確定的なルール
国内の開発者からは、冷静な声も出ています。「正解を出すモデルではないし、日本語は苦手で、深く考える機能も無い。公式ドキュメントの最初のほうに書いてある」という趣旨の指摘や、「概念が単純なので、いずれChatGPTやClaudeに同じ機能が組み込まれるのでは」という見方です。どちらも当たっていると思います。それでも今、判断の工程を切り出して安く速く回せる道具として実在している、というのがこの記事の立場です。
そして、この分担の考え方自体はJevを使わなくても今日から適用できます。公式の検証には「4つの課題で平均したところ、どのモデルも、同じ方針を1つのプロンプトで渡したときより、独立した問いに割って渡したときのほうが精度が高く・安く・速かった」という趣旨の記載があります。比較対象の各社モデルでも改善している、という点がここでの要点です。
よくある疑問
Q. 正解率67.8%では業務に使えないのではないですか
全件を自動処理する前提なら、そのとおりです。この数字は確信度による切り分けとセットで使うことを前提にしています。私の25件では、しきい値0.6で切るだけで自動処理分の誤りはゼロになり、人が見るのは2件でした。全件を人が処理している業務に対しては、これで十分な改善になります。
Q. 日本語で本当に使えますか
公式は「英語が主で、日本語を含むCJKは精度が落ちる」と明記しています。一方、私の25件(問い合わせ文の振り分け)では日英とも96%で差が出ませんでした。両方とも本当です。公式の記述は一般論、私の数字は1つの題材での一例です。業種の用語や長文の書類では結果が変わりえます。「使えるか」は自社の文面を10〜30件流して確信度の分布を見れば判断できます。
Q. レート制限に当たったらどうすればよいですか
429か529が返ったら、1秒→2秒→4秒と間隔を倍にしながら再試行してください。公式SDKは自動でやります。私は自前のHTTPで日英50件を流して44回当たりましたが、この方式で全件通りました。まとめて流すなら、最初から再試行を入れておくことが前提です。
まとめ
Jevが速く安いのは、文章を書かないという構造の帰結です。順番に生成しないので問いを並列に処理でき、出力の量がほぼ無いので出力を無料にできる。誇張ではなく、設計からそうなります。
一方、同じ構造から苦手も生まれます。計算ができない、日付を扱えない、字義通りに読む、関係ない情報に弱い——公式が9つ挙げているこれらは、使う前に知っておかないと事故につながります。日本語の精度低下も公式が明記しています。
公式の検証での正解率は平均67.8%。最上位の大型モデルには5ポイント届いていませんが、同じ精度帯のモデルと比べれば費用は約290分の1です。数字の読み方としては、「賢さで勝つ」ではなく「同じ精度をはるかに安く速く」が正確です。
株式会社Fyveでは、どの判断をAIに任せ、どこをコードに戻し、どこで人に渡すかという線引きを、実際の業務フローに沿って整理する支援を行っています。
Jevの読み方・3つの型・登録手順・料金・制限をまとめたピラー記事です。
本記事の実測をどう取ったか、curlから確信度の分岐までの手順です。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。