Jevの使い方|Vercel経由で5分・3つの型と確信度の実測

「Jevを試したいが、順番待ちで止まっている」「ドキュメントは読んだが、最初の1回をどう叩けばいいのか分からない」——公開から1週間、この2つで止まっている人が多いように見えます。
結論から言うと、順番待ちを通らずに5分で最初の1回を叩く手順があり、その先は3種類の問いと1つの数字(確信度)を覚えれば動きます。この記事は、私が2026年9月21日に実際に通した手順をそのまま書いたものです。
株式会社Fyveは中小企業のAI導入を支援しています。以下、鍵の取得から、3つの型の投げ方、応答の読み方、確信度での分岐、レート制限の扱いまで、コードと実際の応答を載せて進めます。Jevとは何かの説明は別記事に譲り、ここでは手を動かす部分だけ扱います。
使い始める3つの経路——最短はVercel
2026年9月21日時点で、Jev(ジェブ)を呼ぶ経路は3つあります。
- 公式(TypeSafe直): 招待制。順番待ちリストに登録し、招待を受けてからコンソールでキーを発行。所要時間は人によって「即日」から「数日待ち」まで幅があります
- Vercel AI Gateway: 順番待ち不要。Vercelアカウントがあればコマンド1つでキーが出ます。料金は公式と同じで上乗せなし
- OpenRouter: 順番待ち不要。ただしアカウント作成と前払いが要ります
私はVercelを選びました。順番待ちの登録は済ませてありますが、招待を待つ時間がもったいなかったからです。理由はもう2つあり、既にVercelのアカウントを持っていたことと、ゲートウェイ側のHTTP APIが公開されていて、SDKを入れなくてもcurl1発で試せることです。以下はこの経路で書きます。公式SDKへの移し方は後半で触れます。
手順1: キーを発行する(所要2分)
Vercel CLIが入っていれば、次の2行で終わります。
vercel login(ブラウザで認証)vercel ai-gateway api-keys create --name jev-test
2行目の出力がそのままキーです(vck_ で始まる60文字)。ここで1つ注意があります。キーは画面に表示せず、環境変数か .env ファイルに直接流し込んでください。私は最初、表示してから手で写すつもりで画面に出してしまい、即座に失効させて作り直す羽目になりました。vercel ai-gateway api-keys create --name jev-test | tr -d '\n' | sed 's/^/AI_GATEWAY_API_KEY=/' >> .env のように、出力を直接ファイルへ流すのが安全です。
発行したキーは、ダッシュボードの AI Gateway → API Keys でいつでも失効できます。
手順2: 最初の1回を叩く(curl)
キーを環境変数 AI_GATEWAY_API_KEY に入れたら、次を実行します。
curl https://ai-gateway.vercel.sh/v1/evaluate -H "Authorization: Bearer $AI_GATEWAY_API_KEY" -H "Content-Type: application/json" -d '{"model":"typesafe-ai/jev","state":"先月分の請求が二重に引き落とされています。","questions":{"refund":{"type":"boolean","instructions":"これは返金を求める内容か。"}}}'
返ってくるのは、おおよそ次の形です(私の実行結果から要点だけ抜粋)。
{"model":"typesafe-ai/jev","answers":{"refund":{"type":"boolean","probability":0.97}},"usage":{"inputTokens":272,"outputTokens":20},"providerMetadata":{"gateway":{"cost":"0","marketCost":"0.000011424"}}}
見るべき場所は3つです。answers.refund.probability が「はい」の確率、usage が消費トークン、providerMetadata.gateway.cost が実際の課金額です。私の環境では課金が0で、定価換算(marketCost)だけが記録されていました。無料枠なのかローンチ時の扱いなのかは断定できませんが、50回叩いて請求はゼロでした。
この1回が通れば、あとは questions の中身を変えるだけです。
手順3: 3種類の問いを使い分ける
Jevに投げられる問いは3種類だけです。それぞれ、投げ方と返り方を実際の応答で示します。
はい/いいえ(boolean)
確率が1つ返ります。criteria で「はい」と「いいえ」の意味を定義しておくと、境界がはっきりします。
"is_sales":{"type":"boolean","instructions":"これは当社への売り込みか。","criteria":{"true":"サービスや商品を売り込んでいる。","false":"顧客からの問い合わせ・依頼である。"}}
返り: {"type":"boolean","probability":0.94}
🔴 この型には確信度が付きません。確率そのものが不確かさを表すので、0.95なら確信して「はい」、0.52なら実質コイン投げ、と読みます。
選択肢から1つ(choice)
criteria に選択肢の名前と説明を並べます。選択肢は255個まで。
"route":{"type":"choice","instructions":"この問い合わせをどの担当に振り分けるべきか。","criteria":{"billing":"請求・支払い・領収書・料金に関するもの。","technical":"動作しない・エラー・使い方など技術的なもの。","contract":"契約・解約・更新・登録情報の変更。","sales":"こちらへの売り込み。","other":"上のいずれにも当てはまらないもの。"}}
返り: {"type":"choice","choice":"billing","probabilities":{"billing":1,"technical":0,"contract":0,"sales":0,"other":0},"confidence":1}
選ばれた1つ(choice)、全選択肢の確率(probabilities)、そして確信度(confidence)が返ります。
段階で採点(score)
criteria に段階を低い順の配列で並べます。2〜10段。
"urgency":{"type":"score","instructions":"この問い合わせの緊急度はどの程度か。","criteria":["急がない。通常対応でよい。","今週中には対応したい。","業務が止まっている。すぐ対応が要る。"]}
返り(ある1回の実行): {"type":"score","score":1.42,"probabilities":{"0":0.01,"1":0.56,"2":0.43},"confidence":0.56}
スコアは段と段の間の値で返ります(この例では1.42)。「2以上なら緊急」としきい値を引くと1.9が漏れるので、段階を設計する時点で線の位置を決めておいてください。
手順4: 複数の問いを1回で投げる
3種類の問いは、1つの state に対して同時に投げられます。上の3つをまとめると次の形です。
{"model":"typesafe-ai/jev","state":"カード情報を更新したいのですが、どこから操作しますか。","questions":{"route":{...},"urgency":{...},"is_sales":{...}}}
1往復で3つの答えが返ります。問いを増やしても応答時間はほとんど変わりません。私の実測では、問い1つでも3つでも往復は400〜500ミリ秒台でした。公式もこの性質を前提に「関係あるか分からない問いも先に全部投げて、コード側で要るものだけ使う」という設計を勧めています。
stateに何を渡すか——文字列・オブジェクト・配列
state は判定させる材料です。3つの形が使えます。
- 文字列: 問い合わせ文1本をそのまま。上の例はすべてこれです
- オブジェクト:
{"message":"…","order_id":"A-104","customer_tier":"enterprise"}のように、関連する項目を名前付きで。問いの側からcustomer_tierを参照して「上位顧客なら緊急度を上げる」といった判定ができます - 配列: メッセージのやり取りや複数レコードを順番に
公式は「ほとんどの用途ではオブジェクトを勧める」としています。どの値がどの項目かがはっきりするからです。
逆に、やってはいけないことが1つあります。判定に関係のない情報を混ぜないこと。公式の限界ページに「関係のない内容が増えるほど精度が落ちる」と明記されています。「とりあえず顧客情報を全部渡す」は逆効果で、その判定に要る項目だけを渡します。1リクエストの上限は64,000トークン(うちstateは32,000)ですが、上限まで詰めるのではなく、絞るほど当たります。
Vercel経由の場合、providerOptions に {"gateway":{"zeroDataRetention":true}} を付けると、データを保持しない提供先にだけ流す指定ができます。顧客の文面を扱うなら検討に値しますが、Vercelの有料プラン(Pro以上)限定です。
手順5: 確信度で処理を分ける——実測で見えた線の引き方
ここが、Jevを業務に載せるときの肝です。正解率だけ見ても設計はできません。外したときに確信度が低くなっているかどうかで、設計が成立するかが決まります。
2026年9月21日に、自作した日本語の問い合わせ25件を上の3つの問いで流した結果です。
項目 | 結果 |
|---|---|
振り分けの一致率(5分類) | 96%(24/25) |
確信度の平均:正解したとき | 0.95 |
確信度の平均:外したとき | 0.47 |
外した1件は「カード情報を更新したい」という文で、正解は請求、Jevは契約を選びました。人が読んでも迷う境界です。そのときの確信度は0.47でした。迷うべきところで迷っている、ということです。
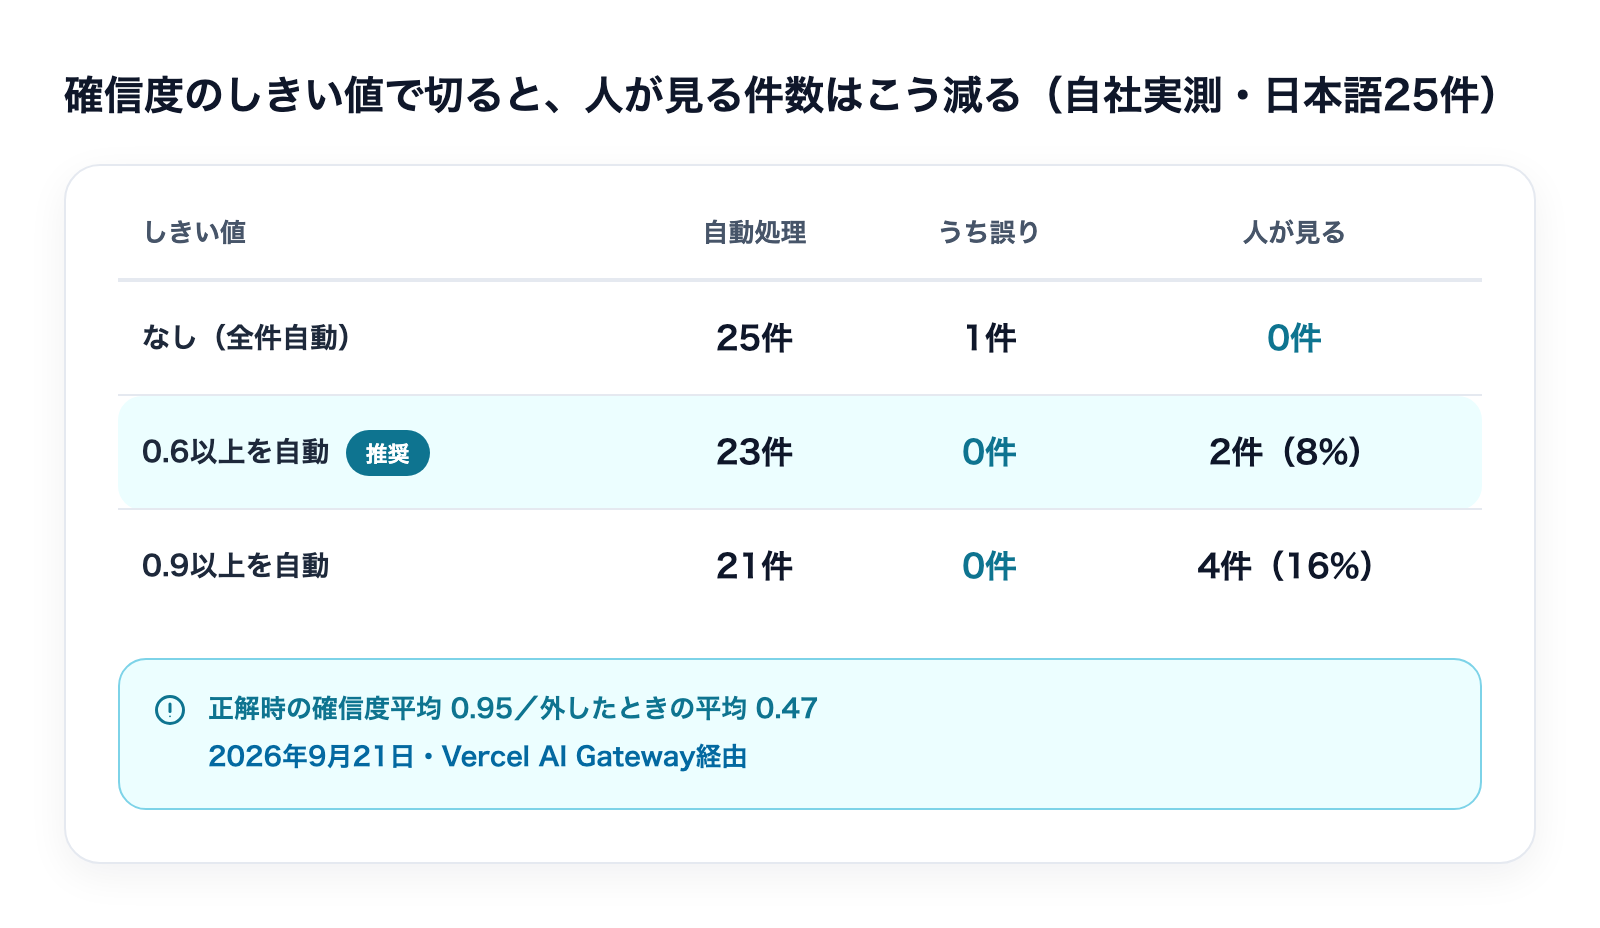
この差があるので、しきい値で切り分けられます。同じ25件で、しきい値ごとに「自動で処理した件数」「その中の誤り」「人に回る件数」を数えると次のようになりました。
しきい値 | 自動処理 | うち誤り | 人が見る |
|---|---|---|---|
なし(全件自動) | 25件 | 1件 | 0件 |
0.6以上を自動 | 23件 | 0件 | 2件(8%) |
0.9以上を自動 | 21件 | 0件 | 4件(16%) |
0.6を境にするだけで、自動処理分の誤りはゼロ、人の手に残るのは8%になりました。全件を人が振り分けていた業務なら、これで十分な改善です。実装は単純で、次の3行に集約されます。
confidence < 0.6→ 人へ回すconfidence >= 0.6かつ結果が取り返しのつく操作 → 自動で進める- 取り返しのつかない操作(送金・削除など)は
0.9以上を要求する
公式ドキュメントも「しきい値は1つではなく、間違えたときの結果の重さに応じて行動ごとに変える」と書いています。上の3行はその最小構成です。
手順6: 基準の文言が仕様になる——実測で踏んだこと
実測で、モデルの問題ではなくこちらの設計の問題で外した例があったので書いておきます。
緊急度の3段階の最上段を、最初は「すぐ対応が要る」としていました。これを「業務が止まっている。すぐ対応が要る」に変えたところ、同じ「二重引き落とし」の文に対するスコアが1.99から1.4前後(3回の実行で1.37〜1.43)に下がりました。二重引き落としは急ぐが、業務は止まっていない——Jevはそう読んだわけで、変えた後の基準に照らせば正しい判断です。
私はこの入力に「2」の正解ラベルを付けていましたが、自分で書いた基準と照らすとラベルのほうが間違っていました。同じ理由で、25件のうち3件のラベルを直すことになりました。
ここから言えることは1つです。Jevは基準を字義通りに読みます。「至急」と書かれていても、基準に「業務が止まっている」とあればそちらを見ます。基準は、含みのない平坦な日本語で、自分が本当に判定したい条件をそのまま書いてください。「適切に判断して」は通りません。
手順7: レート制限と再試行——必ず入れる
50件を順番に流しただけで、「上流が混雑している」という429応答が計44回返ってきました。公表されている上限は毎分1,200リクエストですが、実際にはそれよりはるかに少ない量で当たります。早期アクセス中の混雑だと思われますが、時期に関わらず再試行は最初から入れてください。
公式の案内は「429または529が返ったら指数バックオフで再試行」です。私は1秒→2秒→4秒→8秒→16秒の5回で組み、44回すべて再試行で通りました。公式SDKはこれを自動でやります。curlや自前のHTTPで叩く場合は自分で書く必要があります。
あわせて、往復時間の実測も載せておきます。日本からVercel経由で、中央値456ミリ秒、上位5%で522ミリ秒でした。公式の「70〜500ミリ秒」はモデル側の処理時間なので、通信を含めるとこの程度になります。画面の操作に合わせて動かす用途では、この往復を見込んで設計してください。英語側の1件だけ約20秒かかった外れ値があり、原因は特定できていません。
うまく動かないときの確認順
私が実際に当たったものと、公式のエラー一覧から、上から順に見る項目です。
- 401: キーが通っていない。
Authorization: Bearerの形と、環境変数が空でないかを確認。キーを失効させた直後は当然これになります - 422: 問いの形が違う。
criteriaの型を確認——booleanは{"true":"…","false":"…"}、choiceは名前と説明の対、scoreは配列。scoreに対を渡すとここで落ちます - 429 / 529: 混雑。再試行を入れる(手順7)。キーの問題ではありません
- 通るが確信度が全体的に低い: モデルではなく基準を疑う。選択肢どうしの境界が曖昧か、指示と基準が別のことを言っていないか(手順6)。私の実測で確信度が低かったのは、すべて「請求か契約か」の境界の文でした
- 通るが同じ入力で答えが揺れる: 同じ入力を10回流して割れた回数を数える。公式は「別々の問いのあいだで算術の整合は保証しない」としているので、「Aである確率」と「Aでない確率」を別の問いで聞いて足し算する設計は避けてください
もう1つ。Vercelのドキュメントに載っている応答例には confidence が出てきませんが、実際のAPIは返します。非公式SDKを作った開発者が「ドキュメントと実際のAPIで食い違う箇所を19件記録した」と書いていましたが、私も1件目をここで踏みました。ドキュメントの例より、実際に返ってきたJSONを信じてください。
費用の目安——1件0.003円、実際はゼロだった
50件の実測で、レスポンスに記録された定価換算の費用は1件あたり約0.00002ドル(日本語で0.0000272ドル、英語で0.0000211ドル)でした。1ドル150円で0.003〜0.004円です。月に1万件流しても30〜40円、10万件で300〜400円という桁になります。
そして実際の課金(cost)は50件すべてで0でした。定価換算(marketCost)だけが記録されている状態です。無料枠の扱いなのか、ローンチ時の措置なのかは公式に確認できていないので、「今は無料」と断定はしません。ただ、試すぶんには入金前に結果が見られる、というのが2026年9月21日時点の実態でした。料金は変わりうるので、契約前に公式とVercelの価格ページを確認してください。
費用の桁がこれなので、「まず10件流して確信度の分布を見る」は、稟議を通す前に自分の裁量でできる範囲です。判断材料を先に取ってから社内に出せます。
公式SDKに移す場合
curlで動きを確かめたら、SDKに移すのが楽です。PythonとJavaScriptが公式にあります。
- Python:
pip install typesafe-sdk(3.10以上)。from typesafe_sdk import Choice, Score, Noul, TypeSafeClientで、上と同じ3つの型を関数として書けます - JavaScript:
npm install @typesafe-ai/sdk(Node 20以上)。choice()score()noul()の3関数です - Vercel経由のまま使う場合: AI SDK 7(7.0.105以降)の
experimental_evaluateを使います。モデル名はtypesafe-ai/jev、質問の書き方は上のHTTPと同じです
SDKの利点は、再試行が自動で入ることと、型の補完が効くことです。公式SDKはTypeSafe直のキーを前提にしていますが、ゲートウェイ経由で使う場合はベースURLを差し替えられます。Vercelのドキュメントに「TypeSafe互換API」として手順が載っています。
1点だけ注意があります。既定のモデル名 jev-latest は最新版を指す別名です。しきい値を自社データで調整したら、jev-1.13.0 のようにバージョンで固定してください。モデルが更新されると、調整した数字の意味が変わります。
Claude CodeやCodexから使う
手で書かずにAIコーディングツールに書かせる場合、公式が「スキル」を配布しています。
- Claude Code:
claude plugin marketplace add typesafe-ai/skills→claude plugin install typesafe@typesafe-ai - Codexなど:
npx skills add typesafe-ai/skills --skill typesafe-ai
入れると、ツール側が3つの型と設計パターンを把握した状態でコードを書きます。加えてVercelは vercel ai-gateway setup というコマンドで、Claude Code自身の通信をAI Gateway経由にする設定を用意しています。キーはmacOSのKeychainに保存され、設定ファイルに平文で書かれません。Claude Codeとの組み合わせ方は別の記事で詳しく扱います。
まとめ
- 最短経路はVercel AI Gateway。順番待ち不要、コマンド2行でキーが出て、curl1発で最初の応答が返る
- 問いはboolean・choice・scoreの3種類。1回の呼び出しに複数まとめて投げられ、応答時間はほぼ変わらない
- 確信度で切り分ける。実測では0.6を境にするだけで誤りゼロ・人が見るのは8%だった
- 基準の文言がそのまま仕様になる。外れたら、モデルより先に自分の基準を疑う
- 再試行は必須。50件で44回のレート制限。指数バックオフで全件通った
キーを発行してから最初の応答が返るまで、実際にかかったのは5分でした。株式会社Fyveでは、こうした道具を実機で確かめたうえで、どの業務のどの判断に載せるかを一緒に決めています。まずは自社の問い合わせ文を10件、上のcurlに流してみてください。確信度の分布を見れば、使えるかどうかは判断できます。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。