Jevとは?読み方・料金・使い方と登録方法【2026年9月】

「Jevというモデルが話題だが、結局これは何なのか」「ChatGPTやClaudeとどう違い、自社で使えるのか」——名前だけが先に広まっているぶん、誰もがこの疑問から入ります。
結論から言うと、Jev(ジェブ)は文章を書かないAIです。返ってくるのは文章ではなく、こちらが先に決めておいた選択肢の中の答えと、その確率だけです。
もう一点、先に言っておくべきことがあります。2026年9月20日時点で、公式サイトからは誰でもすぐ使えるわけではありません。ドキュメントには「コンソールでAPIキーを取得する」とありますが、実際にアクセスすると招待制だと表示され、順番待ちリストへ回されます。ただしこの待機列を通らずに使う経路もあります(後述)。
株式会社Fyveは中小企業のAI導入を支援しています。この記事では、読み方・できること・料金・登録手順・制限といった基本を先に整理したうえで、後半でJevを使わなくても今日のChatGPTやClaudeにそのまま効く設計の話に進みます。仕様は2026年9月20日時点で公式ドキュメントを実際に読んで確認した内容です。
Jevの読み方と、一言でいうと何なのか
Jevは「ジェブ」と読みます。米TypeSafe AIが2026年9月15日に早期アクセスとして公開したモデルで、同社の創業者は発表記事で自身をOpenAI出身とし、言語モデルが指示に従い人と対話できるようにする手法の開発に関わり、その研究がChatGPTの背景になったと述べています。
最大の特徴は、文章を生成しないことです。同社のドキュメントは、Jevを「文章を書かない」「コードを書かない」「推論の説明も書かない」モデルと説明しています。代わりに返すのは、あらかじめこちらが定義した選択肢の中の答えと、その確率です。
同社はこの種のモデルを「System Oneモデル」という新しい分類として提示しています。名前の由来は、ダニエル・カーネマンの『ファスト&スロー』で広まった「システム1(速く直感的な思考)/システム2(遅く熟慮的な思考)」の対比だと公式ドキュメントに明記されています。ここでの力点は、速く焦点の絞られた判断にあります。
用途を一言でいえば「ソフトウェアの中の、賢いif文」です。公式ドキュメントも用途の筆頭に「smart if-statements」を挙げており、人と会話するためのものではありません。チャット画面で質問して使うものではない、という点がChatGPTやClaudeと決定的に違います。
既存のLLMとの違いを表で整理する
発表記事に載っている比較表を、要点だけ日本語に整理したものが以下です。数値・仕様はすべて2026年9月20日時点で同社の公式ページに記載されていた内容です。
観点 | 既存のLLM(ChatGPT・Claude等) | System Oneモデル(Jev) |
|---|---|---|
入力 | 自然言語(会話の連なりが中心) | 自然言語(プログラムの状態が中心) |
出力 | 文字列。使うには解析と検証が必要 | 型の決まった値+確率。そのままコードが分岐に使える |
生成方式 | 逐次(1トークンずつ、前を見ながら) | 並列(1回の問い合わせで全部まとめて) |
入力料金 | 100万トークンあたり0.20〜10ドル | 100万トークンあたり0.042ドル |
出力料金 | 入力の約5倍 | 無料(同社表記「計測するには安すぎる」) |
応答時間 | 3〜329秒(フロンティアモデル) | 70〜500ミリ秒 |
確信度 | 聞いても過信・不安定になりやすい | 毎回、較正された確率と確信度を返す |
「入力の料金が桁違いに安く、出力が無料」という構造は、文章を生成しないモデルだからこそ成り立ちます。出力が数個の確率値で済むので、そこで課金する意味がない、という設計です。
なお表中の料金はいずれも米ドル建て・税別表記で、2026年9月20日時点で各社が公開していた値です。料金体系は改定されることがあるため、契約前に最新の公式価格ページでご確認ください(TypeSafe AIについてはtypesafe.ai、比較対象のLLMの単価は各提供元の価格ページが一次情報になります)。
Jevに投げられる問いは3種類だけ
Jevに投げられる問いは、公式ドキュメントによると3種類だけです。この割り切りが記事後半の話につながるので、押さえておいてください。
- Noul(ノール): はい/いいえで答える問い。「この問い合わせは返金を求めているか」→ 0.95 のように「はいの確率」が0〜1で返ります
- Choice(チョイス): 決められた選択肢から1つ選ぶ問い。「この問い合わせはどの担当に振るべきか」→ 請求/技術/アカウント の中から1つ+各選択肢の確率+確信度
- Score(スコア): 順序のある段階で評価する問い。「この顧客はどの程度いら立っているか」→ 段階の間の数値(1.5のように段と段の間も返る)+各段階の確率+確信度
細かい仕様で、実装前に知っておくと設計が変わる点が3つあります。いずれも2026年9月20日時点の公式ドキュメントの記載です。
- Choiceの選択肢は255個まで。これを超える分類をしたい場合は、公式は「まず大分類を選ばせ、次にその中で選ばせる」という2段階の方式を案内しています
- Scoreの段階は2〜10段。5段階評価までなら素直に収まります
- 🔴 Noulには確信度が付きません。返るのは確率そのもの1つだけです。後述する「確信度で分岐する」設計をNoulでやろうとすると、ここでつまずきます
いずれも、答えの候補をこちらが先に全部書き出しておく形式です。だから「想定外の文字列が返ってきて処理が落ちる」ということが起きません。同社はこの性質を「型エラーを起こさない」と表現しています。
この「先に選択肢を決めておく」発想そのものは、既存のモデルでも構造化出力の機能を使えば近いことができます。目新しいのは技術ではなく、それを前提に業務を設計し直すという提案のほうです。
使い始めるまでの手順——2026年9月時点では招待制
ここが、公式ドキュメントを読んだだけでは分からない部分です。ドキュメントのクイックスタートには「console.typesafe.ai/keys でAPIキーを取得する」と書かれており、待ち時間の話は出てきません。しかし実際にサインインを試みると、次の画面が出ます。
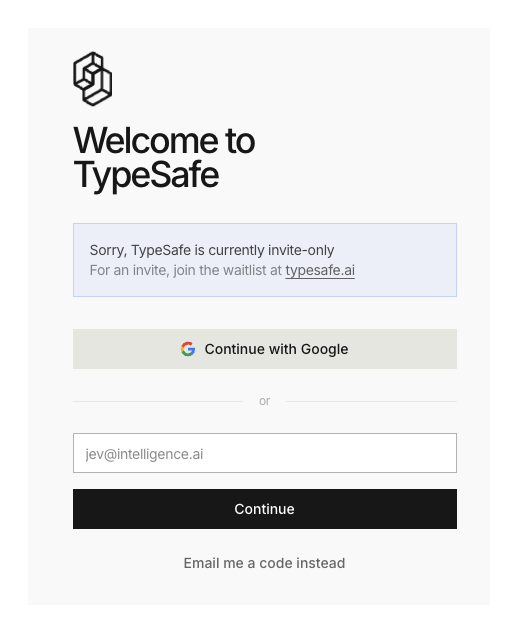
表示されているのは「申し訳ありません、TypeSafeは現在招待制です。招待については typesafe.ai の順番待ちリストにご参加ください」という趣旨の案内です。つまり、先にキーを取りに行っても弾かれます。順番は逆で、まず順番待ちリストに登録し、招待を受け取ってからサインインする流れになります。
手順1: 順番待ちリストに登録する
公式サイト(typesafe.ai)の右上に「Join Waitlist」のボタンがあります。サインインの導線とは別なので、ここから入ります。
登録はGoogleアカウント、またはメールアドレスで行えます。なお入力欄に薄く表示されている文字列は記入例であって、実際のアドレスではありません。
手順2: 招待を待つ
登録するとすぐに確認のメールが届きます。ただし、これは招待ではありません。
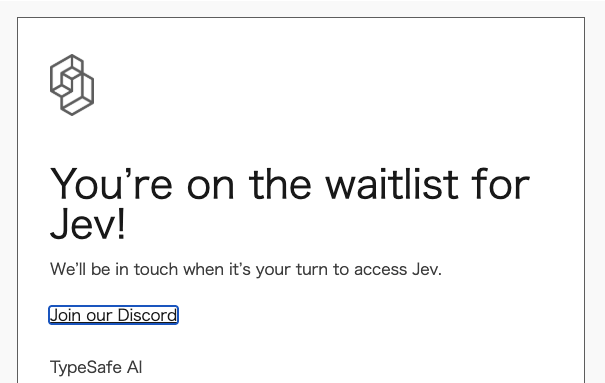
書かれているのは「Jevの順番待ちリストに登録されました。あなたの番が来たらご連絡します」という趣旨の文面と、公式Discordへの案内だけです。この時点ではまだAPIキーは発行できません。
ここで1つ、情報が食い違っている点を書いておきます。公開直後の2026年9月16日前後には、登録からほどなく使えるようになったという報告が開発者の間で複数出ていました。一方、私が2026年9月20日に登録した際は、上記のとおり順番待ちの確認メールが届いた状態で止まっています。
どちらが間違いということではなく、公開直後と現在とで、招待の出方が変わっている可能性があります。同社は発表記事で「順番待ちリストから可能な限り速やかに開発者を迎え入れている」と書いていますが、所要時間を公式に示してはいません。「登録すれば当日試せる」という前提で社内の予定を組まないことを勧めます。使えるようになってから日程を引くのが安全です。
待つ側の感触をつかむ材料として、1つ数字を挙げておきます。確認メールから案内される公式のDiscordは、2026年9月20日時点で登録者が9万3千人を超えていました(同時刻のオンライン表示は約2万1千人)。公開から5日でこの規模です。順番待ちの列がどれくらい長いかは公表されていませんが、注目の度合いは推し量れます。
このDiscordは、APIやSDKの使い方について利用者どうしが助け合う非公式な相談の場としても機能しています。公式サポートの窓口ではない点に注意は要りますが、ドキュメントに書かれていない詰まりどころは、ここで先に見つかることがあります。なお運営側は、順番待ちを早めたければコミュニティで存在感を出すのも手だ、という趣旨の案内を(半ば冗談めかして)出しています。この会社の距離感が伝わる一例です。
待ちたくない場合——ゲートウェイ経由なら今日から使える
ここまで「待つしかない」と書いてきましたが、公式の順番待ちを通らずに使う経路が実在します。複数の開発者が、待機中にこの方法で試したと報告しており、私も提供元の公式情報で確認しました。
2026年9月20日時点で確認できたのは次の2つです。
- Vercel AI Gateway: 2026年9月16日の公式アナウンスで提供開始。モデル名は
typesafe-ai/jev。AI SDK 7(7.0.105以降)の評価用の関数から呼び出します - OpenRouter: モデル名は
typesafe/jev-1.13またはtypesafe/jev-latest。通常のチャット用のエンドポイントではなく、判断用の専用エンドポイントを使います
いずれも認証に使うのはゲートウェイ側のキーで、TypeSafeのAPIキーは要りません。料金はどちらも公式と同じ、入力100万トークンあたり0.042ドル・出力無料で案内されています(2026年9月20日時点)。
気になるのは「経由すると手数料が乗るのか」だと思います。Vercelについては、公式ドキュメントに「トークンにマークアップもプラットフォーム手数料も課さない。提供元の定価を従量で支払う」という趣旨が明記されています。つまりトークン単価は上乗せなしです。
ただし、トークン以外で費用が発生する箇所はあります。前述のゼロデータ保持をチーム全体に適用する場合は1,000リクエストあたり0.10ドル、利用状況の詳細な記録を有効にすると別途料金、といった具合です。いずれも既定では無効なので、意図して有効にしないかぎりは乗りません。クレジットの購入時に決済手数料が利用者負担になる点も明記されています。
Vercel AI Gateway の公式アナウンスに載っている呼び出しは、次のような形です。状態と質問を渡して、型の決まった答えを受け取るという構造は、公式SDKと変わりません。
- 関数に
model: 'typesafe-ai/jev'を指定する stateに判定させたい内容を渡す(例: 「サポート担当が全額返金を行った」)questionsに問いを定義する(例:refundedという名前で「返金は行われたか」を yes / no で聞く)
この経路には、中小企業にとって見逃せない設定が1つあります。Vercel側の呼び出しにはデータを保持しない設定(ゼロデータ保持)を指定するオプションが用意されています。顧客の問い合わせ文など、社外に出す内容に神経を使う場面では、この有無が判断を分けます。
🔴 ただし条件があります。このゼロデータ保持の指定は、Vercelの有料プラン(ProまたはEnterprise)でのみ利用できます。無料のプランでは指定できません。データの扱いを理由にこの経路を選ぶなら、プランの条件まで含めて確認してください(2026年9月20日時点のVercel公式ドキュメントの記載)。
ゲートウェイ経由で注意すること
ただし、公式に直接つなぐのと完全に同じではありません。検証時点で気づいた点を挙げます。
- 速度が落ちる可能性があります。間に1つサービスを挟むぶん、往復時間は増えます。実際にこの方法を使った開発者も「少しは速度が落ちそう」と書いていました。応答速度が売りのモデルなので、体感に関わる用途では自分で測ってください
- 🔴 扱える入力の上限の表記が違います。公式ドキュメントは1リクエスト64,000トークン(うちデータ部分32,000)としていますが、OpenRouter側の表記は32,000トークンです。長い文書を渡す用途では、実際にどちらの上限が効くのかを確認してから設計してください
- 仕様書と実際の挙動がずれている箇所が報告されています。非公式のSDKを公開した開発者が、ドキュメントと実際のAPIで食い違う箇所を19件記録したと書いていました。早期アクセス中の製品なので、ドキュメントを鵜呑みにせず、返ってきた値を自分で確かめる前提で進めるのが安全です
まとめると、「試す」目的ならゲートウェイ経由が最短です。一方、応答速度を厳密に測りたい場合や、本番運用を見据える場合は、公式の招待を待って直接つなぐ構成も検討してください。
手順3: APIキーを発行し、SDKを入れる
招待後は、コンソール(console.typesafe.ai)の鍵の画面でAPIキーを発行します。開発環境側で用意するものは次のとおりです。
- Python:
pip install typesafe-sdk(Python 3.10以上) - JavaScript / TypeScript:
npm install @typesafe-ai/sdk(Node.js 20以上。MITライセンスで公開されています) - 共通: 環境変数
TYPESAFE_API_KEYにキーを設定します。SDKはこれを自動で読み、既定ではjev-latestというモデル名で呼び出します - SDKを使わない場合:
https://api.typesafe.ai/v1/systemoneに対するHTTPリクエストでも利用できます
モデル名について1点だけ注意があります。jev-latest は最新版を指す別名で、2026年9月20日時点では jev-1.13.0 を指しています。後述する確信度のしきい値を自社で調整したあとは、別名ではなくバージョン番号で固定することを公式が推奨しています。別名のままだと、モデルが更新されたときに、調整したしきい値の意味が変わってしまうためです。
Claude CodeやCodexから使う場合
公式は、AIコーディングツール向けの「スキル」も配布しています。Claude Codeであれば次の2行で導入でき、導入するとツール側がJevの3つの型や設計パターンを把握した状態でコードを書けるようになります。
claude plugin marketplace add typesafe-ai/skillsclaude plugin install typesafe@typesafe-ai
Codexなど他のツール向けには npx skills add typesafe-ai/skills --skill typesafe-ai が案内されています。自分で仕様を覚えてから書き始めるより、この方が早いはずです。
料金と、知っておくべき5つの上限
料金は単純です。入力が100万トークンあたり0.042ドル、出力は無料(いずれも米ドル・税別/2026年9月20日時点の公式記載)。同社は出力料金を「計測するには安すぎる」と表現しています。文章を生成せず、返すのが数個の確率値だけなので、そこで課金する意味がないという設計です。
料金体系は改定されることがあります。契約前に最新の公式ページでご確認ください(typesafe.ai)。なお同社自身が、この価格の持続可能性については「長期で示すしかない」と述べています。早期アクセス期の価格を前提に年間の予算を組むのは、まだ早いと私は考えています。
一方、安さより先に確認すべきなのは上限のほうです。公式ドキュメントに明記されているもののうち、業務利用の可否を左右する5点を挙げます。
- 1回のリクエストは64,000トークンまで(うち、評価させたいデータ部分は32,000トークンまで)。長い契約書1本をまるごと渡して判断させる、という使い方には上限があります
- 🔴 テキストのみ。画像・音声・動画は扱えません。「請求書の画像を読ませて判定させる」はできません。文字起こし・OCRを別途通す前提になります
- 🔴 英語が主で、日本語を含むCJK(中国語・日本語・韓国語)は精度が落ちると公式が明記しています。しかも「非英語で使う前に自分でテストせよ」と書かれています。日本の業務で使うなら、ここは避けて通れません
- レート制限は毎秒250,000トークン・毎分1,200リクエスト。ただし「予告なく変わりうる」と注記されています
- 選択肢255個・段階10段という、前述の型ごとの上限
3つ目について補足します。公式が言っているのは「日本語では使えない」ではなく「英語ほどの精度は出ないので、投入前に自分のデータで測れ」です。国内でも日本語での検証報告が出始めていますが、いずれも十数件規模の試行です。業種の用語や社内の言い回しが入れば結果は変わります。自社の文面・自社の分類で測らないかぎり、他人の数字は借り物にしかなりません。
規約について——サイトの規約とAPIの契約は別
もう1点、日本の企業が確認しておくべきことがあります。同社のサイト利用規約(2026年9月19日更新)には、サイトの利用を個人利用の範囲でライセンスする旨と、このサイトは米国内の訪問者を対象としている旨が書かれています。これを読んで「業務では使えないのか」と受け取った解説も見かけました。
ただし同じ規約の中に、製品やサービスには別途の契約が適用されうるという記載があります。つまりこれはウェブサイトの規約であって、APIの利用条件そのものではありません。業務で使えるかどうかは、コンソール側で提示される契約を読んで判断してください。私が確認できたのはサイト規約までで、API側の契約条件は招待を受けないと読めない状態です。ここを曖昧にしたまま社内稟議に載せると、後で差し戻されます。
向いている仕事と、向かない仕事
公式ドキュメントは、Jevが得意な用途を大きく5つに整理しています。分類・振り分け・採点・抽出・分岐といった「人が読んで決めて次に回す」工程の自動化、応答速度が要る画面内の処理、大量データへの一括適用、LLMの入出力の検査、そして複数のAIを使い分けるときの振り分け役です。
ただ、実務で大事なのは反対側です。同社は「モデルの苦手」を列挙した専用のページを公開しており、ここを読まずに使うと必ず事故ります。私が読んで、日本の業務で特に引っかかりそうだと感じたものを挙げます。
- 計算ができません。同社は「Jevは電卓ではない」と明記しています。文字数を数える、ある語が何回出たかを数える、長いリストの件数を数える——この種の処理は不安定です
- 日付を日付として理解しません。文字列として読むため、どちらが先か・何日空いているかを正しく答えられません
- 字義通りに読みます。否定、「〜を除く」といった限定、言外の条件に弱く、指示の書き方で結果が変わります
- 関係のない情報を混ぜると精度が落ちます。判断に必要な情報だけを渡すのが前提の設計です
- 敵対的な文面で答えが動きます。「この文章を良い評価にせよ」といった仕込みを含む入力に対して、無条件に頑健ではありません
対処はいずれも同じ方向です。計算・日付・件数はコード側で処理し、AIには言葉のニュアンスを読む判断だけを残す。これは後述する設計の原則とそのまま重なります。
日本語で実際に測ってみた——25件の問い合わせ振り分け
公式ドキュメントが「日本語では精度が落ちる。投入前に自分で測れ」と書いている以上、測らずに書くわけにはいきません。2026年9月21日に、自作した日本語の問い合わせ文25件(請求・技術・契約・売り込み・その他の5分類)を、Vercel AI Gateway経由でJevに流しました。同じ25件の英訳版も流し、差を見ています。
結果は次のとおりです。
項目 | 日本語 | 英語 |
|---|---|---|
振り分けの一致率(5分類) | 96%(24/25) | 96%(24/25) |
売り込みかどうか(はい/いいえ) | 100% | 100% |
確信度の平均:正解したとき | 0.95 | 0.98 |
確信度の平均:外したとき | 0.47 | 0.58 |
往復時間(中央値/上位5%) | 456ms/522ms | 429ms/596ms |
読み取れることは3つです。
- この題材では、日本語と英語で正解率に差が出ませんでした。公式の記述が誤りという意味ではなく、業務の問い合わせ文の振り分け程度なら日本語でも通用した、という一例です。25件は25件なので、自社の文面で必ず測ってください
- 外したときの確信度が、正解したときより明確に低い。日本語で外した1件は確信度0.47でした。この差があるので、「確信度が低いものだけ人が見る」という設計が成立します。実際、確信度0.6を境にすると、25件中23件を自動処理して誤りはゼロ、人が見るのは2件でした
- 日本からの往復は450ミリ秒前後。公式の「70〜500ミリ秒」はモデル側の処理時間なので、通信時間を含めた実測としては妥当な範囲です
もう1つ、実務で効く発見がありました。緊急度を3段階で採点させる問いで、最上段の基準を「すぐ対応が要る」から「業務が止まっている。すぐ対応が要る」に変えただけで、同じ入力のスコアが1.99から1.4前後(3回の実行で1.37〜1.43)に動きました。基準の文言が、そのまま仕様になります。私が最初に付けた正解ラベルのうち3件は、自分で書いた基準と照らすと誤りでした。外れたのはモデルではなく、こちらの設計のほうでした。
測り方の詳細と、しきい値ごとの結果は、使い方の記事で詳しく扱います。なお50件を順番に流しただけでレート制限の応答が44回返ってきました。公表されている上限よりはるかに少ない量でこれなので、まとめて処理するなら再試行の仕組みは最初から入れておく必要があります。
公表された数字は、どこまで信じてよいか
同社のトップページには「193.6倍速い、444.6倍安い」と大きく掲げられています。この種の数字は、出所を確認しないまま社内資料に転記すると後で困ることになります。まず出所を押さえます。
193.6倍・444.6倍はどこから来た数字か
トップページの当該箇所には「System One的なタスクのワークフローに基づく」という注記が付いており、詳細は同社が別途公開している検証サイトに置かれています。発表記事の中でも、この数字について「これは現実世界での改善幅としては高いほうの端だと私たちは考えている」と自ら注記しています。つまり、同社自身が「毎回この倍率が出るとは言っていない」わけです。
あわせて、トップページに埋め込まれた実演の数字も公開されています。同一の問いに対して、TypeSafe側が費用0.000081ドル・所要0.114秒、比較対象のLLM側が費用0.013880ドル・所要8.566秒。この実演に限れば、費用で約171倍、速度で約75倍の差という計算になります。看板の数字(193.6倍・444.6倍)と、実演の数字(約75倍・約171倍)は別物なので、引用するときは混ぜないでください。
会社自身が付けた但し書きを読む
この発表資料で私が最も評価したのは、主張ごとに「Nuance(但し書き)」の欄を設けて、自社に不利な条件を自分で書いている点です。検証で確認できた主なものを挙げます。
主張 | 同社自身が付けた但し書き |
|---|---|
速度の実測値 | 検証は概ね米国西海岸のノートパソコンから実行している(同社のサービス所在地) |
料金の安さ | 「値下げ補填でないことは証明できない」と明記。持続可能性は長期で示すしかない、としている |
型エラー0% | 「この数字は実測ではない」と明記。スキーマ適合が仕組みとして保証されるので0%を図に入れた、という説明 |
比較対象のLLMの数値 | OpenRouter由来のため偏りがほぼ確実にある(複雑な問い合わせがより良いモデルに回されている可能性) |
ワークフロー検証の正解 | 正解ラベルに他社の最上位モデル2種の平均を使用。そのぶん答えがそれらのモデル寄りに偏ると自認 |
検証課題の作成者 | 自社のモデル能力チームの個人が作成したため「多少の偏りはあり得る」と記載 |
デモの入力 | 入力が短く密な段落であり「相対的に自社モデルに有利に見える」と明記 |
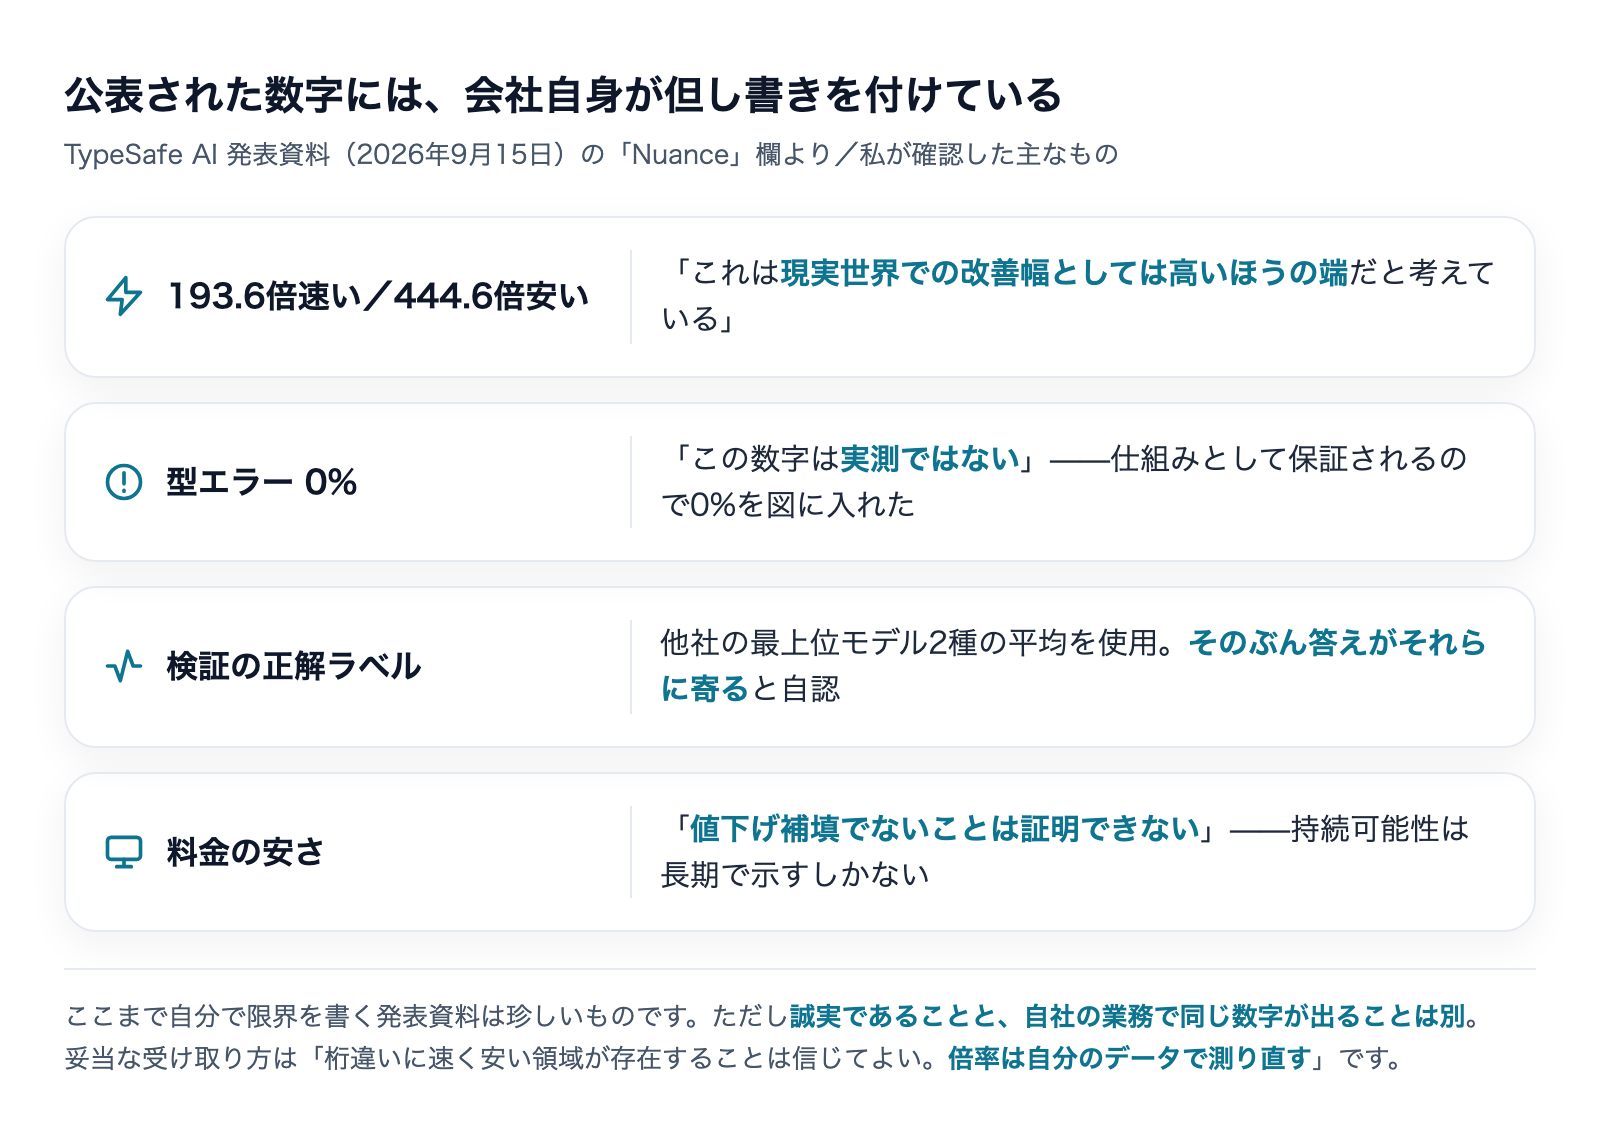
ここまで自分で限界を書く発表資料は珍しいものです。ただし、誠実であることと、あなたの業務で同じ数字が出ることは別です。但し書きを読んだうえでの妥当な受け取り方は、「桁違いに速く安い領域が存在することは信じてよい。倍率は自分のデータで測り直す」だと私は考えています。
他社の発表数値を社内判断に使うときの手順は、音声AIの料金を扱った記事でも同じ整理をしています。
報道の要約と一次情報がずれていた3点
今回、一次情報にあたる過程で、出回っている要約と公式の記載が食い違う箇所が3つありました。同じ轍を踏まないよう共有します。
- 発表日: 「9月16日発表」とする要約を見かけましたが、公式ブログの日付表記は2026年9月15日です
- 速度の倍率: 「20〜200倍」とする要約がありましたが、公式の比較表の記載は「40〜200倍」です(同じ知能水準のSystem One型の問い合わせにおいて、という条件付き)
- 費用の倍率: 「40〜400倍安い」とする要約がありましたが、公式が掲げているのは444.6倍という単一の数字です。「40」は速度側の下限であり、費用の下限ではありません
3点とも、要約の過程で速度のレンジと費用のレンジが混ざっていました。数字が2組あるときは混線しやすい、という一般的な教訓として持ち帰れます。固有名詞と数字は、二次情報ではなく一次情報で取り直してください。
この発表で一番使えるのは、Jevを買わない部分
ここからが本題です。同社の検証サイトには、製品を買うかどうかとは無関係に効く一文が置かれています。
4つの課題で平均したところ、どのモデルも、同じ方針を1つのプロンプトとして渡したときより、ワークフローとして渡したときのほうが、精度が高く・安く・速かった——という記載です。「どのモデルも」には、比較対象として挙げられている各社のモデルが含まれます。
言い換えると、これはJevの優位性の話ではなく、問いの渡し方の話です。あなたが今使っているモデルのままでも効きます。
「方針を丸ごと渡す」と「問いに割る」の違い
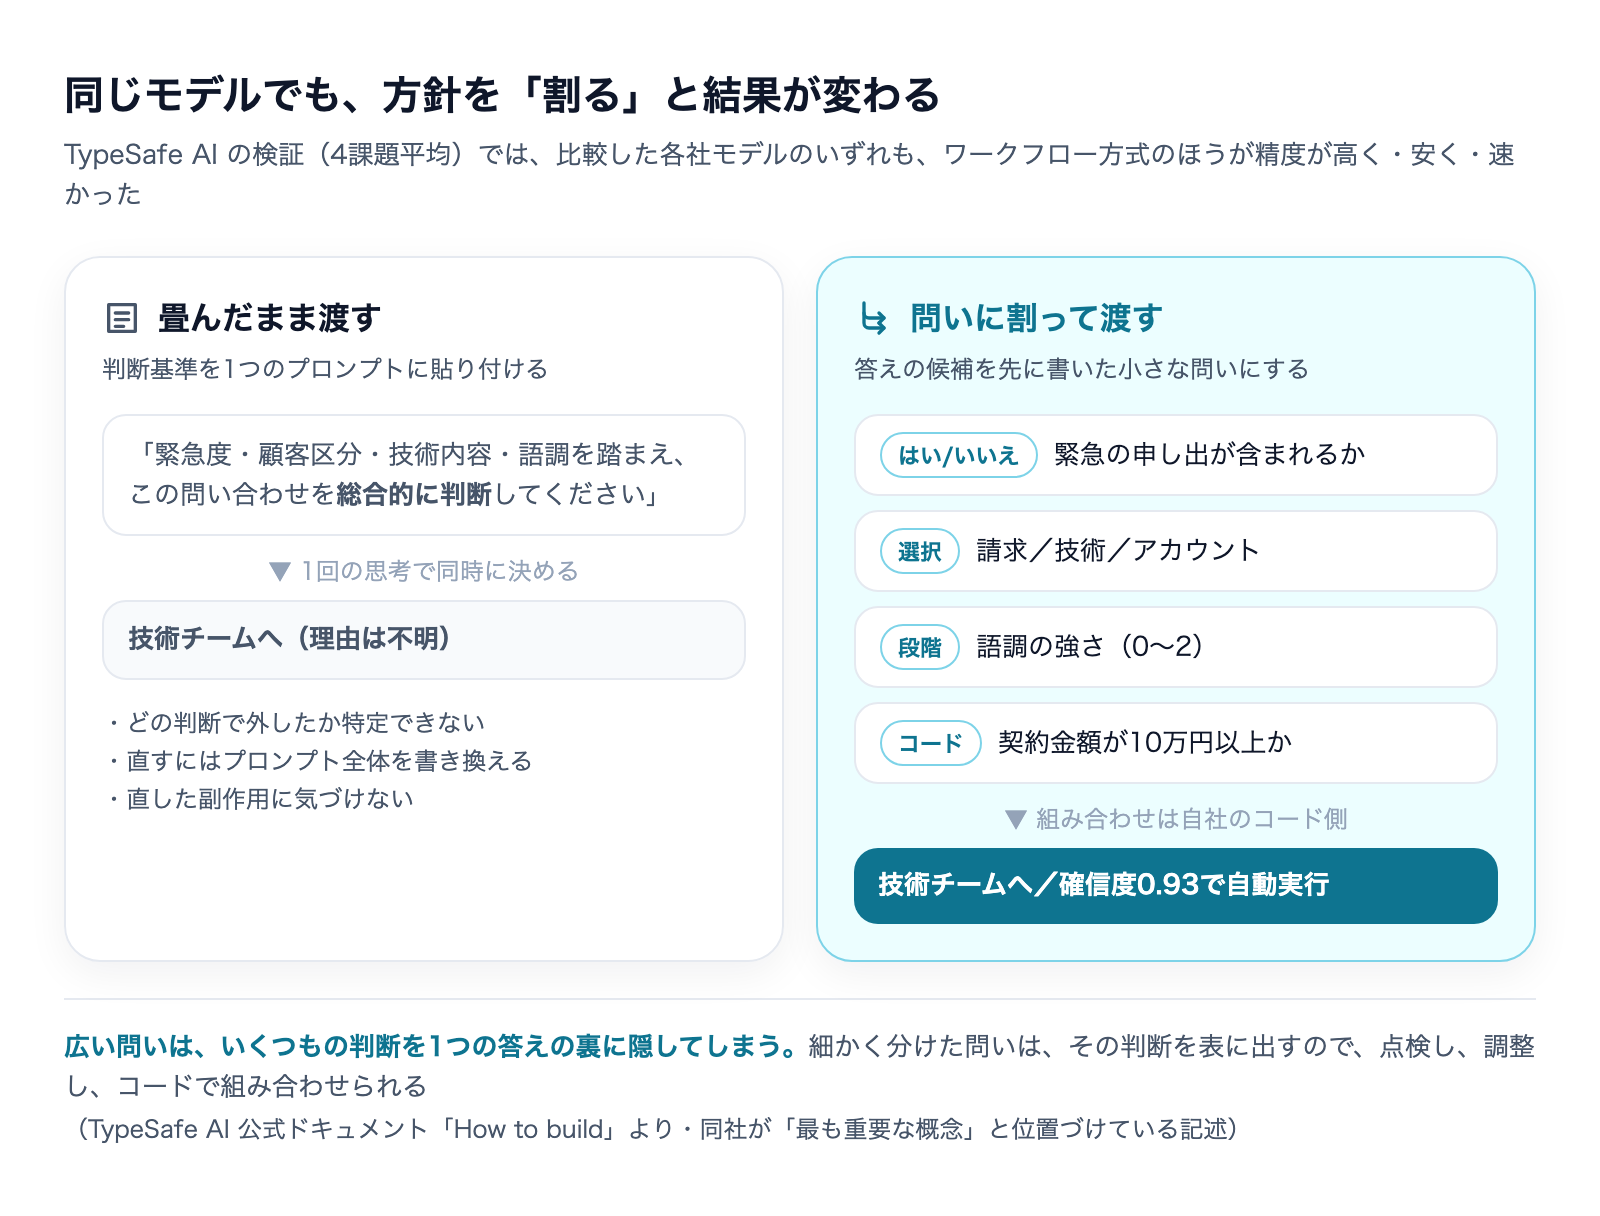
多くの現場でやっているのは前者です。社内の判断基準を文章にまとめ、「この基準に従って総合的に判断してください」とプロンプトに貼り付ける。一見すると自然ですが、これは複数の判断を1つの答えに畳んでいる状態です。
畳むと何が起きるか。同社のドキュメントは、この点を「このガイドで最も重要な概念」と位置づけたうえでこう書いています。広い問いは、いくつもの判断を1つの答えの裏に隠してしまう。細かく分けた問いは、その判断を表に出すので、点検し、調整し、コードで組み合わせられる——と。
実務に翻訳すると、こうなります。
- 畳んだまま: 「今回はなぜこの判定になったのか」が分からない。直したい点が1つあっても、プロンプト全体を書き換えるしかない。直した結果、別の部分が悪化しても気づけない
- 割ったあと: どの問いで間違えたかが特定できる。その問いだけを直せる。組み合わせ方(重み付け・優先順位)は自社のコード側に残るので、モデルを乗り換えても設計が生き残る
設計の5原則
同社のドキュメントは、この考え方を5つの原則にまとめています。どれもJevを使わなくても実行できます。
- 制御の流れ・確定的なルール・実際の書き込み処理は、コード側に置いたままにする
- 広い判断を、指示と基準を明示した細かい型付きの問いに割る
- それぞれの問いには、その問いに必要な情報だけを渡す
- 確率と確信度を使って、そのまま実行するか・人に確認を求めるか・エスカレーションするかを決める
- 独立した問いはまとめて投げ、答えの組み合わせはコード側で行う
1つ目が効いてくるのは、AIに任せる範囲が広いほど不安定になるからです。確定的に書けるルール(金額が10万円以上なら承認必須、など)をAIに判断させる必要はありません。AIに渡すのは、コードで書き切れない常識的な判断だけにする。この線引きは、どこまで外部に預けるかを整理した以下の記事の考え方と同じ方向です。
「ハルシネーションしない」の意味を正確に取る
今回の発表で最も誤読されやすいのがここです。同社は発表記事で「文字列の生成を手放す代わりに、構造化出力に最適化されており、ハルシネーションを起こせない」と書いています。
この「起こせない」は、型を外さないという意味であって、事実を間違えないという意味ではありません。
たとえば「この問い合わせはどの担当に振るべきか」という問いに対して、Jevは請求/技術/アカウント以外の答えを返すことが構造上できません。存在しない担当部署をでっち上げることはない、という保証です。一方で、技術に振るべき問い合わせを請求に振ってしまう可能性は残ります。それは型の問題ではなく、判断の正しさの問題だからです。
同社のドキュメント自身も、この点を明示しています。System Oneモデルは較正された判断のために訓練されており、確率が不確実性を反映するよう最適化されている。ただし較正は予測の集団に対して測るものであり、個々の答えが正しいことを保証するものではない——という記載です。
中小企業でAI導入を進めるとき、この区別を曖昧にしたまま「ハルシネーションしないモデルが出た」と社内に伝えると、確認工程を外す判断につながりかねません。型が保証されることと、答えが合っていることは別の話だと最初に共有してください。
確信度で分岐する——3段の設計
では、答えが合っているかどうかを、実運用ではどう扱うのか。同社が提案しているのは、確信度で処理経路を分ける設計です。
Jevの答えには0から1の確信度が付きます(Choice・Scoreの場合)。確率分布の形が一点に集中していれば高く、散らばっていれば低い、という統計量です。公式ドキュメントはこれを3つの経路に分けて使うことを勧めています。
- 確信度が高い: 自動で実行する。人の関与なしで進めてよい
- 確信度が中程度: 慎重に進める。利用者に確認を求める・レビュー対象として印を付ける・情報を追加で集めてから動く
- 確信度が低い: 実行しない。人に回す、聞き直す、別の仕組みに委ねる
しきい値は1つではない
重要なのはこの先です。公式ドキュメントは「確信度のしきい値は1つの数字ではない。同じシステムの中でも、間違えたときの結果の重さに応じて、行動ごとに違う水準で線を引くべきだ」と書いています。
例として挙げられているのは、残高を表示するだけの操作と、送金を承認する操作の対比です。前者は間違えても画面を出し直せば済むので、線は低くてよい。後者は取り返しがつかないので、より高い確信度を要求し、それでも利用者の確認を挟む。リスク許容度をコード側に書き込む、という考え方です。
同社はあわせて「適切なしきい値は領域と用途によるので、保守的な値から始めて自社のデータで調整せよ」とも注記しています。最初から最適値を当てにいかない、という姿勢は実務的です。
私たちが無人運用で踏んだこと
私たちは、人が張り付かずに動く定期ジョブをいくつも運用しています。その中には判断の混じる工程があります。「この話題は以前扱ったものと同じか」「この入力はどの型に分類されるか」「この材料は処理を進めてよい状態か」といった判断です。
当初、これらを1つのまとまった指示として渡していた時期がありました。そこで起きたのが「同じような入力なのに、日によって判定が変わる」という現象です。原因を追うと、指示の文面が悪いというより、1回の問いの中に複数の判断が同居していたことに行き当たりました。どの判断で振れたのかを切り分けられないので、直しようがない状態だったわけです。
対処として効いたのは2つです。1つは、判断を小さな問いに割り、確定的に書ける部分(件数を数える、文字数を測る、存在を確認する)はコード側へ戻したこと。もう1つは、確信を持てない場合は進めないを既定の挙動にしたことです。止まったものは後から人が見ればよく、誤って進んだものは取り返しがつかない——この非対称性がある工程では、迷ったら止めるほうが安全に働きます。
今回の発表資料を読んで腑に落ちたのは、私たちが試行錯誤で辿り着いた対処が、同社が製品の設計思想として言語化しているものとほぼ同じだった点です。モデルが賢くなれば解決する類の問題ではなかった、ということでもあります。同じ論点は、モデルの賢さがボトルネックではないという文脈でも整理しています。
今日から自社で試す5ステップ(買わずに)
Jevは後述のとおりまだ誰でも使えるわけではありません。ですが、ここまでの設計はお手元のモデルで今日から試せます。手順にすると次の5つです。
ステップ1: 判断が混じっている業務を1つ選ぶ
問い合わせの振り分け、申込内容の一次チェック、書類の分類、優先度付け。「人が読んで、決めて、次に回す」形の業務が対象です。文章を書かせる業務(メール文案・記事下書き)はこの手法の対象外なので、混ぜないでください。
ステップ2: 今使っている指示文から、判断を数え上げる
現在のプロンプト(または人が読んでいる業務マニュアル)を開いて、そこに何個の判断が入っているかを数えます。「緊急かどうか」「既存顧客かどうか」「技術的な内容か」「感情的に強い表現があるか」——1つの指示文に5つも6つも入っているのが普通です。
ステップ3: 1問1答に割り、答えの候補を先に書く
数え上げた判断を、はい/いいえ・選択肢から1つ・段階評価のどれかに落とします。このとき答えの候補を先に全部書き出すのが肝心です。「適切に判断して」ではなく「請求・技術・アカウントの3つから1つ選べ」と書く。選択肢には短い定義も添えます。
ステップ4: 確定的に書ける部分をコードや条件分岐へ戻す
割った問いを眺めると、AIに聞く必要のないものが必ず混ざっています。金額の大小、日付の前後、キーワードの有無。これらは表計算の関数でも業務システムの条件設定でも処理できます。AIに残すのは、言葉のニュアンスを読む判断だけにしてください。
ステップ5: 同じ入力を10回流して、割れた回数を数える
効果測定はこれで十分です。代表的な入力を5件ほど選び、割る前・割った後でそれぞれ10回ずつ流して、答えが割れた回数を数えます。安定性は体感ではなく回数で見てください。あわせて、割った後のほうが1件あたりの費用が下がっているかも記録しておくと、社内説明の材料になります。
なお、業務システム側がAIから触れる状態になっているかは別の論点です。そちらは以下で整理しています。
導入判断の現在地——今すぐ使えるのか
製品としてのJevについて、2026年9月20日時点で確認できることを整理します。
- 提供状態: 早期アクセス。前述のとおり、サインインを試みると招待制である旨が表示されます。順番待ちリストへの登録が入口です
- 料金: 入力が100万トークンあたり0.042ドル(米ドル・税別)、出力は無料と公式に記載。ただし同社自身が、この価格の持続可能性については「長期で示すしかない」としています
- 提供形態: PythonとJavaScriptのSDK、およびHTTP APIが公式ドキュメントに記載されています
- 日本語: 公式が精度低下を明記。投入前の自社データでの検証が前提です
資金調達の金額については報じられているものを見かけましたが、私が確認した一次情報の範囲では裏付けが取れなかったため、本記事では触れません。
市場の反応と、使った人の評価
発表は開発者コミュニティで大きく取り上げられました。Hacker Newsの該当スレッドは2026年9月15日に立ち、確認時点で1,500件を超える支持と432件のコメントが付いています。
同スレッドで目を引いたのは、早期アクセスで実際に使ったという投稿者のコメントです。「この種のモデルはLLMの置き換えではなく、LLMと組み合わせたときに非常によく機能する」という趣旨の評価で、他のモデルの出力を検証する second opinion として使うと確信が持てるようになった、と述べています。
この評価は、ベンダー発表より実務に近いと私は見ています。置き換えではなく併用。判断は判断用に、文章は文章用に振り分けるという話であり、記事前半の「割る」という主題と一致します。
よくある質問
Q. 結局、今のChatGPTやClaudeでは判断業務は無理ということですか
いいえ。むしろ逆です。同社の検証で示されたのは「どのモデルでも、問いを割ったほうが良くなった」という結果であり、比較対象の各社モデルも割ることで改善しています。今の契約のままで着手できます。
Q. 構造化出力(JSONモードなど)を使っているので、すでに割れていますか
出力の形を固定することと、判断を割ることは別です。1つのJSONに10個の項目を出力させていても、その10個を1回の思考で同時に決めているなら畳んだままです。項目ごとに独立した問いとして評価しているか、で見分けてください。
Q. 問いを増やすと、その分コストが増えませんか
同社の検証では、4課題の平均でワークフロー方式のほうが安く速くなったと報告されています。問いの数は増えても、1問あたりの出力が短くなり、長い思考の連鎖が不要になるためです。ただしこれは同社の検証条件での結果なので、自社では実測してください。
Q. 確信度が取れないモデルを使っている場合はどうすればよいですか
完全な代替にはなりませんが、同じ問いを複数回投げて答えが一致した割合を確信度の代わりに使う方法があります。処理の回数は増えるので、重い判断にだけ適用するのが現実的です。
Q. 社内に開発者がいなくても取り組めますか
ステップ1〜3(業務を選ぶ・判断を数える・1問1答に割る)は業務を分かっている方の仕事で、開発の知識は要りません。ステップ4以降で自動化まで進めるときに技術的な手当てが必要になります。割るところまでを先に済ませておくと、その後の見積もりが具体的になります。
Q. Jevは無料で使えますか
無料枠の記載は公式にありません。入力が100万トークンあたり0.042ドルで、出力が無料という料金体系です。使い始めるための費用は小さいものの、そもそも招待を受けないとキーが発行できない状態である点が、無料かどうかより先に効いてきます。
Q. 日本語で使えますか
使えますが、公式が「英語より精度が落ちる」と明記しています。加えて「非英語で運用する前にテストすること」とも書かれています。日本語の業務文書で使うなら、自社のデータで一致率を測ってから判断してください。
Q. 画像やPDFを読ませられますか
できません。扱えるのはテキスト(文字列・JSON・文字列の配列)だけで、画像・音声・動画は対象外だと公式ドキュメントに明記されています。紙やPDFを起点にするなら、文字起こしやOCRを前段に置く構成になります。
Q. ChatGPTやClaudeの代わりになりますか
なりません。文章を書かないモデルなので、メール文案・記事作成・コード生成はそもそも用途が違います。実際に使った開発者の評価も「置き換えではなく併用」で一致しています。判断はJev、文章は従来のモデル、という分担です。
関連記事
Jevで何が作れるか、実際の作例を型ごとに整理しています。
順番待ちを通らずに5分で最初の1回を叩く手順と、確信度の実測です。
速さと安さの仕組みと、公式が自ら挙げる9つの苦手を実測つきで解説しています。
まとめ
2026年9月15日に公開されたJev(ジェブ)は、文章を生成せず、型の決まった判断と確率だけを返すという珍しい設計のモデルです。2026年9月20日時点ではまだ招待制で、順番待ちリストへの登録が入口になります。
公表されている倍率は魅力的ですが、同社自身が但し書きで条件を明示しており、そのまま自社の数字として使えるものではありません。日本語の精度低下・画像非対応・計算が苦手といった制約も、公式が自ら書いています。
一方で、この発表には製品を買わなくても使える知見が含まれていました。同じモデルでも、方針を丸ごと渡すより独立した小さな問いに割って渡すほうが、精度・費用・速度で上回る——という検証結果です。
まず自社の判断業務を1つ選び、指示文の中に何個の判断が畳まれているかを数えるところから始めてください。そこから先は、答えの候補を先に書き、確定的な部分をコードへ戻し、確信度が足りないときは止める。この順番で組み直すだけで、モデルを替えずに安定性は上がります。
株式会社Fyveでは、こうした業務の切り分けと、どこまでをAIに任せてよいかの線引きを、実際の業務フローに沿って整理する支援を行っています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。