AI動画の正体はコード生成|手直しが1行で済む頼み方

「AIが動画を作れるようになったらしい」「同じように頼んだのに、ぱっとしないものしか出てこない」——タイムラインに流れてくる滑らかなモーショングラフィックを見て、こう思った方は多いはずです。
結論から言うと、話題になっている作例は「AIが動画を生成した」ものではありません。AIが書いたのは動画ではなくプログラムで、絵は手元のパソコンが1コマずつ計算しています。この違いは技術的な細かい話ではなく、手直しの方法・必要な設備・次の案件で使い回せるかが、そこで全部変わります。
株式会社Fyveは中小企業のAI導入を月額で伴走しており、この記事の図解も毎日コードで生成しています。ここでは作者本人が公開した工程と、英語圏の独立した技術解説を突き合わせて、「できたものを受け取る」のと「作り方を受け取る」のが実務でどう違うのかを整理します。
結論:あれは「動画の生成」ではなく「動画を作るプログラムの生成」
拡散している作例を見て、多くの人が「動画生成AIがここまで来た」と受け取りました。しかし作者が公開した工程を読むと、動画生成AIは1つも使われていません。
起きていたのはこうです。AIはPythonのプログラムを書き、そのプログラムが1コマずつ絵を計算し、最後に動画へ書き出す道具がコマをつなげてMP4にしている。絵を作ったのはAIではなく、手元のマシンで走ったコードです。
公式の発表があったわけではない
先に整理しておくと、これは新機能の発表で起きた話題ではありません。本稿の執筆時点(2026年9月27日)で公式の更新履歴を確認しましたが、最新のエントリは2026年9月25日のもので、そこから新しい告知は出ていません。
つまり発信元は公式ではなく現場です。誰かが作例を出し、それが驚きとともに広がり、数日のうちに「どうやって作ったのか」へ関心が移った——その流れの中で、作者本人が工程を全部開示しました。
「AIが描いた」と「AIがコードを書いた」は別物
この2つは、できあがった動画を見ただけでは区別できません。だから「AIが動画を作った」という言い方で混ざってしまいます。
しかし中身は正反対です。前者はAIの内部で絵が決まるので、こちらから触れるのは頼み方(プロンプト)だけ。後者は絵の決まり方がコードとして手元にあるので、気になった箇所だけを直せます。同じ「AIで作った」でも、次の一手が変わります。
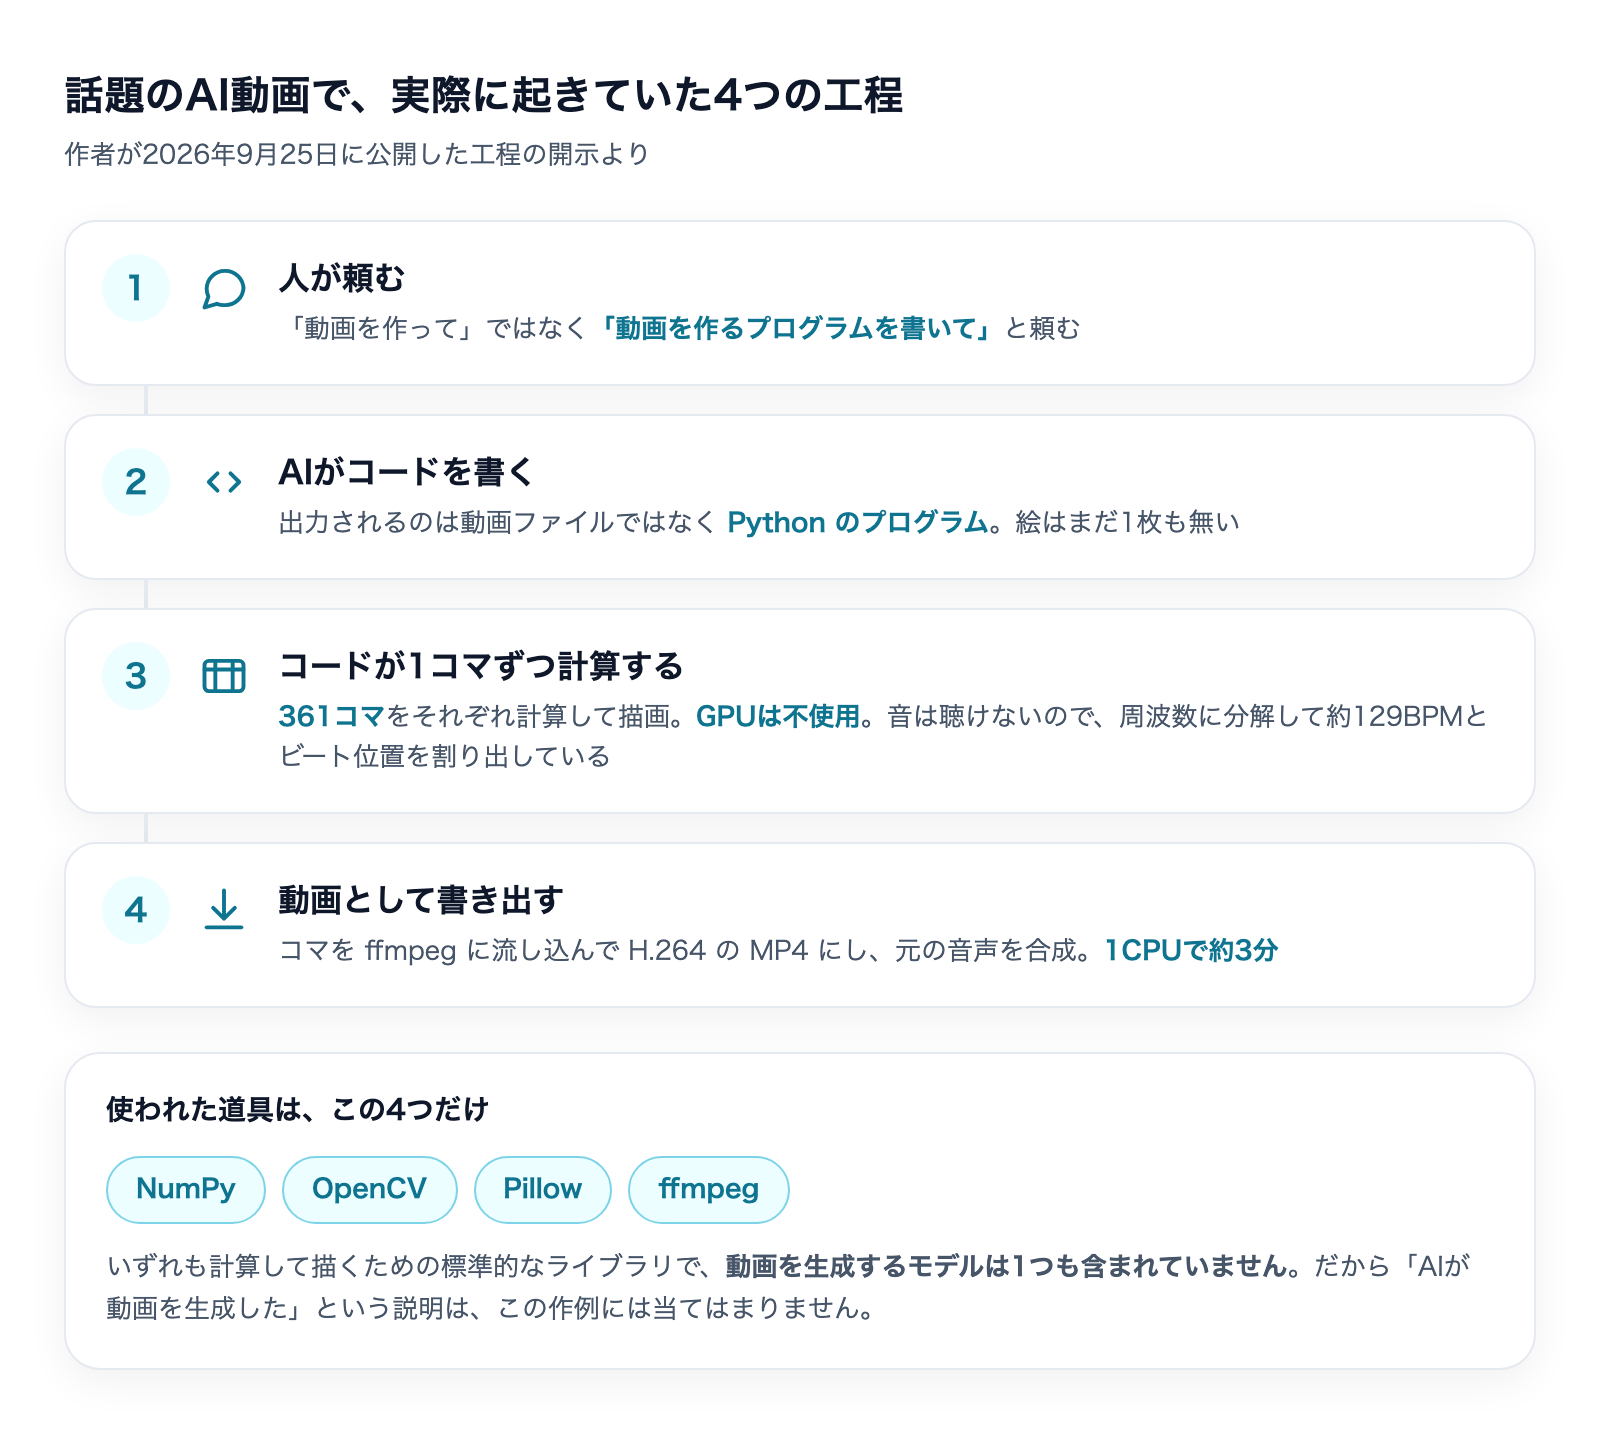
作者が開示した工程——道具は4つだけ
2026年9月25日、話題になった作例の作者がX上で制作工程を公開しました。冒頭にはっきりこう書かれています——生成AIは一切使っておらず、すべてPythonのプログラムで1コマずつ絵を計算して作っている、と。
使われた4つの道具
開示された道具は次の4つです。いずれも画像・動画処理の分野で長く使われてきた、ごく標準的なライブラリです。
道具 | 担っている役割 |
|---|---|
NumPy | 画像を数値の配列として扱い、レイヤーの合成などの計算をする |
OpenCV | 拡大・回転・移動の変形や、フチ取りのための膨張処理 |
Pillow | 文字の描画(作者はNoto Sans CJK Blackを指定) |
ffmpeg | 動画の読み込み・書き出しと、音声の合成 |
注目したいのは、この4つに「動画を生成するモデル」が含まれていないことです。文字を置くのはPillow、動きを付けるのはOpenCVの変形、最後にコマを束ねるのはffmpeg。どれも「計算して描く」道具で、「学習した内容から絵を作り出す」道具ではありません。
361コマを1コマずつ計算している
開示のなかに、361コマ分の切り抜き結果をディスクに保存している、という記述があります。これは動画制作の考え方としては当たり前のことですが、AI任せの感覚からは一番遠い部分です。
動画は静止画の連続です。1秒24コマなら、15秒で360コマ。その1枚ずつについて「何がどこにどの大きさで写るか」を計算で決めているということは、逆に言えば任意の1コマの見た目に理由があるということです。
理由がある絵は直せます。「3秒目のロゴが少し大きい」と思ったら、そのタイミングの倍率を決めている箇所を変えるだけで済みます。
音は聴けない。だから周波数に分解している
いちばん実務的で示唆に富むのがこの部分です。作者はこう書いています——音を聴けないので、音声を周波数に分解して音が鳴り始める瞬間を検出し、その周期性から約129BPMとビートの位置を割り出した。そして、すべての演出のタイミングをこのビート表から決めている、と。
ここで起きているのは「できないことの回避」ではなく「できない形を、できる形に翻訳する」という作業です。音そのものを聴く能力はない。しかし音声ファイルは数値の列なので、数値の列としてなら扱える。だから「聴く」を「周波数に分解して立ち上がりを数える」に置き換えた。
この置き換えの発想は、動画とはまったく関係ない業務でも同じように効きます。AIが直接できないことに当たったとき、「無理だ」で止まるのか、「では何なら扱えるか」に翻訳するのかで、自動化できる範囲がまるで変わります。
GPUは使っていない。1CPUで約3分
開示には、GPUも使っていないという明記があり、書き出しについては1CPUで約3分のレンダリングだったと書かれています。完成したコマをffmpegに流し込んでH.264のMP4にし、元の音声を合わせた、という工程です。
この数字が意味するのは、設備投資が発生しないことです。動画生成AIを使う前提だと、生成1本ごとに従量課金がかかるか、高性能なGPUを用意する話になります。計算で描くやり方は、普通のノートパソコンで完結します。
英語圏の独立した技術解説も、同じ結論に着いている
ここまでは作者1人の開示です。1つの出所だけで「これが実態だ」と書くのは危ないので、別経路の記述と突き合わせました。
「ブラウザが実行した命令を書いただけで、コマを作ってはいない」
コーディングエージェントで動画を作る話題を扱った英語圏の解説記事(2026年8月11日公開・2026年9月16日更新)は、より直接的な言い方をしています。「Claudeはあなたのブラウザが実行する命令を書いた。コマを作ったのではない」。そして実際のレンダリングを行っているのはRemotionやFFmpegだと明記しています。
別の解説記事(2026年5月28日最終更新)も同じ構造で書いています。Claude Codeは動画ファイルを直接編集するのではなく、レンダラやFFmpeg、文字起こしの道具を制御するスクリプトを書いて実行する「指揮層」として振る舞う、と。さらにシーンはHTML・CSS・JavaScriptで書かれ、レンダリングのパイプラインがヘッドレスのChromeで1コマずつ取り込み、FFmpegが符号化する、と工程まで書いています。
使っている道具は違います(作者はPython、解説記事はHTMLベースのレンダラ)。しかし「モデルが動画を出力しているのではない。モデルはコードを書き、別の道具が絵と動画を作る」という骨格は完全に一致しています。
限界の記述まで一致する
より強い一致は、できることではなくできないことのほうに現れました。前述の解説記事は、Claudeには動画ファイルを聴く能力がない、と明記しています。作者が「音を聴けないので周波数に分解した」と書いていたのと、同じ限界を指しています。
対処だけが違います。作者はコードで回避し、解説記事は外部の文字起こしを通してタイムスタンプを渡す方法を挙げています。限界の所在が一致していて、対処が2通りある——これは裏取りとしてかなり強い状態です。
なぜ2経路の一致が重要なのか
新しい話題は、憶測が事実と同じ顔をして流通します。とくに今回のように「すごい作例」が先に広まった場合、説明はあとから付けられるので、それらしい解説がいくらでも生えます。
私たちが記事を書くときに置いている線は単純です。一次(作った本人の言葉)と、それとは無関係な経路の記述が、同じ結論と同じ限界に着いているか。着いていれば書く。片方しかなければ書かない。今回は着いていたので書いています。
実務で何が変わるのか——差は3つ
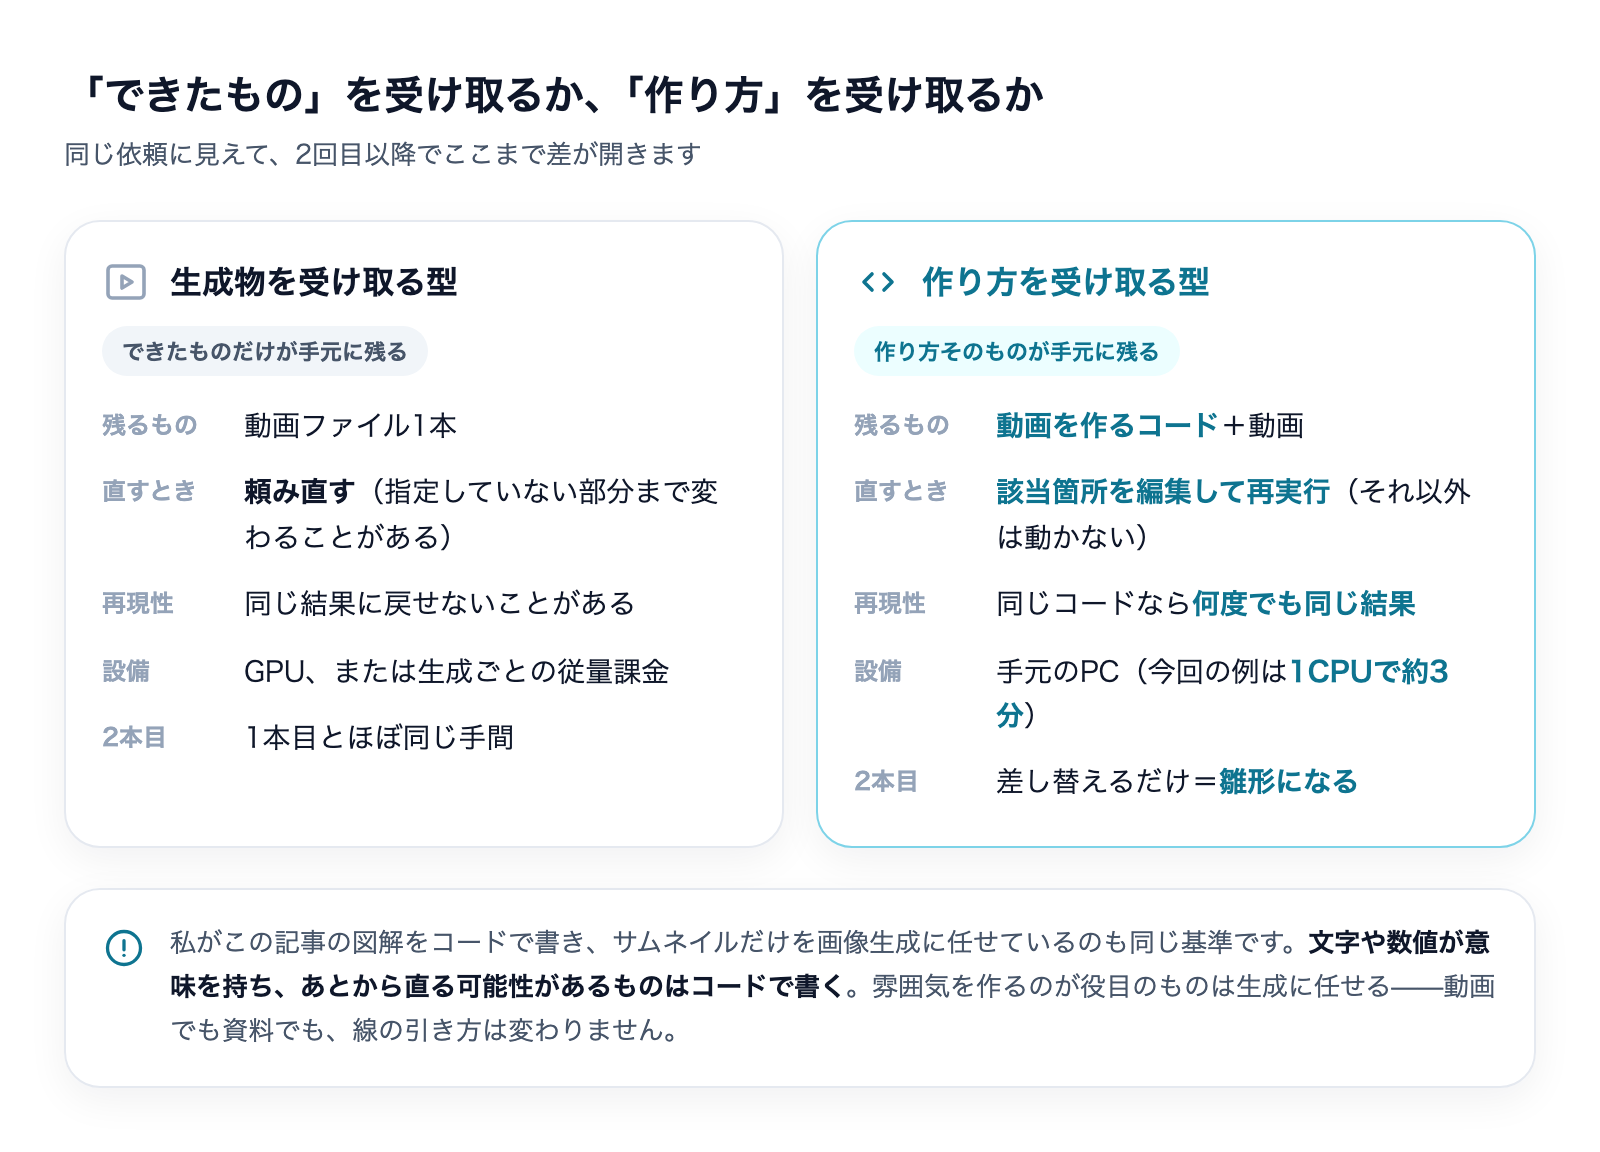
ここが本題です。「生成物を受け取る」型と「作り方を受け取る」型は、依頼した瞬間は似ていますが、2回目以降で大きく開きます。
生成物を受け取る型 | 作り方を受け取る型 | |
|---|---|---|
手元に残るもの | 動画ファイル1本 | 動画を作るコード+動画 |
直したいとき | 頼み直す(結果は毎回変わる) | 該当箇所を編集して再実行 |
同じ結果の再現 | できないことがある | 同じコードなら同じ結果 |
必要な設備 | GPU、または生成ごとの従量課金 | 手元のPC(今回の例は1CPUで約3分) |
2本目のコスト | 1本目とほぼ同じ | 差分の編集だけ |
差1: 手直しが「1行の編集」で済む
生成物だけを受け取る形でいちばん効くのは、直しの工数です。「ロゴの出るタイミングを0.5秒遅らせたい」という要望に対して、生成型は頼み直すしかありません。そして頼み直すと、指定していない部分まで変わることがあります。
これはAI画像で資料を作った経験がある方なら覚えがあるはずです。文字を1つ直したくて再生成したら、構図も色も別物になった。直しのたびにくじを引き直している状態です。
作り方を受け取っていれば、タイミングを決めている数値を変えるだけで、それ以外は一切動きません。「直せる」と「頼み直せる」は、実務ではまったく違う意味を持ちます。
差2: GPUも従量課金も要らない
今回の作例は、GPUなし・1CPUで約3分でした。動画1本あたりの変動費がほぼゼロということです。
中小企業でAI活用が止まる典型的な理由のひとつが、「試すたびにお金がかかるので試せない」です。1本作るのに課金が発生する構造だと、失敗を前提にした試行がしにくくなります。変動費がゼロなら、気に入るまで回せます。
差3: コードが残るので、次の案件の雛形になる
3つ目がもっとも金額に効きます。コードが手元にあると、2本目は「作る」ではなく「差し替える」になります。
文字と色と素材を変えれば、同じ動きの別バージョンが出てきます。商品が10個あるなら10本、店舗が5つあるなら5本。1本目で払った工数が、そのまま在庫になるわけです。
私たちが受託で「カスタムに見えて再利用可能な形」を意識しているのも同じ理由です。毎回ゼロから作る前提だと、単価は下がらず品質も揃いません。
もうひとつの差:AIの気まぐれを、設計の段階だけに閉じ込められる
3つの差の根っこには、もっと構造的な違いがあります。AIの出力が毎回変わるという性質を、どこに置くかです。
生成物を受け取る型では、この性質が最後まで残ります。納品直前に「もう1回だけ直したい」となったとき、また結果が変わります。つまり公開までの全工程に、ずっと不確実さが同居している状態です。
作り方を受け取る型では、AIが関わるのはコードを書く最初の段階だけです。コードが確定したあとは、同じコードから同じ結果が出ます。1週間後に同じファイルを走らせても、同じ動画が出てきます。
この違いは、社内で使うときに効いてきます。「担当者が変わったら同じものが作れない」という事態が起きないからです。渡すのは口頭のコツではなく、ファイルです。
私たちが記事の図解をAI画像で作らない理由
ここで自分たちの話をします。この記事に挿入されている図解は、AIの画像生成で作ったものではありません。HTMLとCSSで書いて、それをそのまま画像として書き出しています。一方でサムネイル画像のほうはAIの画像生成を使っています。
同じ「記事に載せる画像」で、なぜ作り方を分けているのか。理由は今回の話とまったく同じです。
AI画像で作ると、1文字直すために全部が変わる
図解は文字が主役です。「4つの手順」の3番目の言い回しを変えたい、数字を7から8に直したい——こうした直しが頻繁に入ります。
AIの画像生成にこれをやらせると、1文字のために画像全体を作り直すことになります。運が悪ければ、直したかった箇所以外が崩れます。文字がかすれる・詰まる・別の字になるといった問題も、完全には避けられません。
コードで書くと、ブランドの規範がそのまま効く
図解をコードで書くと、色・枠線の太さ・角丸の大きさ・フォントの太さが、指定した値でそのまま出ます。記事が何本増えても、図解の見た目がぶれません。
これは「AI画像のほうが下手」という話ではありません。決まった規範を正確に反復する仕事は、生成よりも計算のほうが得意だというだけです。作者が361コマを計算で描いたのと、同じ理屈です。
使い分けの基準は「文字が意味を持つかどうか」
私たちが使っている線引きは単純です。
- 文字や数値が意味を持ち、あとから直る可能性がある → コードで書く(図解・表・グラフ・動きのある説明)
- 雰囲気を作るのが役目で、細部が変わっても困らない → 生成に任せる(サムネイル・イメージカット・背景)
この基準は動画にもそのまま使えます。数字やテキストが入る説明動画・商品紹介はコードで書く。実写のような映像や雰囲気のカットは生成に任せる。どちらかに寄せる必要はありません。
では、どう頼むのか——6つの手順
ここまでを踏まえて、明日から踏める形に落とします。
- 「動画を作って」ではなく「動画を作るプログラムを書いて」と頼む。この一言で、返ってくるものの性質が変わります。前者は説明か、ラフな画面だけが返ることがあります
- 出てきたコードとファイル一式を手元に落とす。チャットの中に置いたままにしない。手元にないコードは資産になりません
- 1コマずつ書き出して、最後に動画へまとめる形になっているか確認する。この形になっていれば、任意のコマを検証できます
- 直したいところは、作り直させず該当箇所を編集して再実行する。ここを頼み直しで済ませると、コードを受け取った意味が消えます
- 音が絡むものは、音の情報を外から渡す。今回の作者はビートを検出するコードを書き、英語圏の解説は外部の文字起こしでタイムスタンプを渡す方法を挙げています。いずれも「モデルに聴かせる」ことはしていません
- 出来たコードを次の案件の雛形として保存する。ここまでやって初めて、1本目の工数が回収されます
手順3が地味ですが重要です。「1コマずつ書き出しているか」を確認するだけで、受け取ったものが生成物なのか作り方なのかが判別できます。
受け取ったものを見分ける3つの確認
「プログラムを書いて」と頼んだつもりでも、実際には生成物だけが返っていることがあります。見た目では区別できないので、次の3点を確認してください。
確認1:ファイル一式が手元にあるか
動画ファイルだけが手元にあり、それを作った処理が見当たらないなら、それは生成物です。コードのファイルと、使った素材、実行の手順——この3つが揃っているかを見ます。
「チャットの履歴の中にコードが貼られている」は、揃っているとは言えません。履歴は消えますし、検索もしづらい。フォルダとして手元に落ちている状態が目標です。
確認2:もう一度走らせたら、同じものが出るか
いちばん確実な確認方法がこれです。受け取ったものをそのまま2回実行して、出力が一致するかを見ます。
一致すれば、絵の決まり方はコードの中にあります。一致しないなら、どこかにAIの生成が挟まっているか、乱数が入っています。どちらが良いという話ではなく、どちらなのかを知っておくことが大事です。知らないまま案件に使うと、納品直前に別物が出てきます。
確認3:途中の1枚を取り出せるか
3つ目は、任意のコマを静止画として取り出せるかです。取り出せるなら、その1枚を見て「ここの余白が広い」と指摘でき、指摘した箇所だけを直せます。
取り出せない場合、直しの単位が動画1本になります。直しの単位が細かいほど、修正に強い成果物です。これは動画に限らず、資料でもコードでも同じことが言えます。
やりがちな3つの勘違い
勘違い1「動画生成モデルを使っている」
今回の作例では使われていません。作者が「生成AIは一切使っていない」と明記しています。完成品の見た目から逆算して道具を推測すると、ここを外します。
勘違い2「GPUが必要」
作者はGPUを使っておらず、書き出しは1CPUで約3分です。「動画だからマシンを買い替えないと」と考える必要はありません。
勘違い3「AIが音を聴いてタイミングを合わせている」
聴いていません。作者は音声を周波数に分解して音の立ち上がりを検出し、約129BPMとビート位置を割り出すコードを書いています。英語圏の解説も、モデルには動画を聴く能力がないと明記しています。
この勘違いがいちばん実害があります。「AIが音を理解している」と思い込むと、音に合わせた演出を口頭の指示だけで成立させようとして、延々うまくいきません。音の情報は外から数値で渡す——これが現状の正しい前提です。
この型が効く場面と、向かない場面
中小企業の現場で、実際にどこに使えるのかを整理します。
効く場面
- 同じ型で本数が要るもの:商品紹介、料金表の更新、キャンペーンの差し替え。1本目でコードを作れば、2本目以降は差分だけ
- 数字やテキストが主役のもの:実績の推移、手順の説明、比較の見せ方。文字が正確に出ることが最優先の領域
- あとから直る前提のもの:価格や日付のように、確定していない情報を含むもの
向かない場面
- 実写が要るもの:現実の店舗・商品・人が写る必要があるものは、撮るか、生成系の道具を使うほうが早い
- 繊細な間や呼吸で見せるもの:人の話し方の間や、編集の呼吸で成立する尺は、計算で決めるのに向きません
- 1本しか作らないもの:使い回しの予定がないなら、コードを受け取る利点は薄くなります
生成モデル側の進化も同時に進んでいます。連続した映像の長さや、開始と終了の指定など、生成型で扱える範囲は広がっています。両者は置き換え関係ではなく、使い分けの関係です。
生成型で今どこまでできるのかについては、こちらの記事で整理しています。
コードで動画を書くための道具そのものを比べたい場合は、こちらが詳しいです。
よくある質問
プログラミングができなくても使えますか
コードを書く必要はありませんが、受け取ったコードを保管し、指示して直してもらうことはできる必要があります。中身を一行一行読めなくても、「このファイルのこの部分を直して」と伝えられれば足ります。逆に、ファイルをどこに置いたか分からない状態だと、作り方を受け取った利点は消えます。
動画生成AIはもう要らないのですか
そうではありません。実写に近い映像や、被写体が現実にあるものは生成系の道具の領分です。今回の話は「文字と図形で構成された、動きのある説明」に限った話として受け取ってください。
どれくらい時間がかかりますか
今回の作例は、書き出しが1CPUで約3分と開示されています。ただしこれは最後のレンダリングだけの時間です。コードを書き、見て直し、また書き出す往復にかかる時間は別です。1本目は試行の時間を見ておいてください。
音楽や効果音はどうするのですか
音声ファイル自体は別途用意し、最後に動画へ合成します。今回の作例ではffmpegが元の音声を合わせています。タイミングを音に合わせたい場合は、前述のとおり音の情報を数値として先に取り出す必要があります。
社内で共有するときは、何を渡せばいいですか
コードのファイル一式と、素材、実行のしかたを書いた短いメモです。「どう頼んだか」ではなく「何を走らせるか」を渡すのがポイントになります。頼み方を渡すと、受け取った人がまた別の結果を引くことになります。
この記事の作例を、ご自身で再現したのですか
していません。ここに書いた工程・数値はすべて作者が公開した内容と、英語圏の独立した技術解説の記述に基づくものです。私たちが自分の手で日々やっているのは、記事の図解をコードで書いて画像として書き出す部分で、動画ではありません。自分で確かめていないことを「やってみた」として書かないのが、私たちの記事の方針です。
まとめ
話題になった作例の正体は、動画の生成ではなく動画を作るプログラムの生成でした。作者の開示では、使われた道具は4つの標準的なライブラリだけで、361コマを1コマずつ計算し、GPUなし・1CPUで約3分で書き出されています。音は聴けないので、周波数に分解してビートを割り出すコードで代替されていました。
英語圏の独立した技術解説も、モデルは動画を出力せずコードを書いているだけだという同じ結論に着いており、「音を聴けない」という限界の所在まで一致していました。
そして実務の差は3つです。手直しが1行の編集で済む・設備投資と従量課金が発生しない・コードが次の案件の雛形として残る。だから頼み方を一段だけ変える価値があります——「動画を作って」ではなく「動画を作るプログラムを書いて」と。
この線引きは動画に限りません。文字や数値が意味を持ち、あとから直る可能性があるものはコードで書く。雰囲気を作るのが役目のものは生成に任せる。株式会社Fyveがこの記事の図解とサムネイルで作り方を分けているのも、同じ基準に沿った判断です。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。