Qwen3.8-Omni-Flashとは|会議音声の料金計算

「会議の音声をAIに読ませたいが、1時間の録音を毎回投げていくらかかるのか分からない」——長尺の音声や動画をAIに任せようとすると、誰もがこの見積もりの壁にぶつかります。
結論から言うと、Qwen3.8-Omni-Flashは音声1秒=7トークンという公開された換算式を持っていて、会議の長さから料金を秒単位で逆算できます。そして重要なのは、このモデルが「AIと喋る」ためではなく「読ませて、文章で返させる」ために設計されているという点です。
株式会社Fyveは中小企業のAI導入を月額で伴走していて、打ち合わせの録音から提案書までを日常的に自動化しています。この記事では、公式ドキュメントで確認できた仕様と換算式だけを土台に実コストを計算し、私たちが実際に回している文字起こし運用のどこに入れられて、どこには入れてはいけないのかまで整理します。
結論:このモデルは「AIと喋る」ためのものではない
Qwen3.8-Omni-Flashは、2026年9月18日にAlibabaのQwenチームが公開したomni-modal(全モーダル)モデルです。名前の「Omni」から「音声で話しかけたら音声で返してくれるモデル」を想像しがちですが、実際の設計はそうではありません。
入力は4種類、出口はテキストだけ
Alibaba Cloud Model Studioの公式ドキュメント(2026年9月18日更新)は、対応表でこのモデルをこう定義しています。入力はテキスト・画像・音声・動画の4種類、そして出力はテキストのみです。
同じドキュメントの冒頭には「テキスト分析にはQwen3.8-Omni-Flashを、音声出力にはQwen3.5-Omniを選んでください」という一文が置かれています。つまりベンダー自身が、音声で返してほしい用途はこのモデルの担当ではないと最初に線を引いているわけです。
「Recommended models」のページでも同様に、音声・動画の分析とテキスト生成はQwen3.8-Omni-Flash、リアルタイムの音声・動画対話はqwen3.5-omni-plus-realtimeと、役割が明確に分けられています。
この割り切りが、実務ではむしろ都合がいい
一見すると機能を削られたように見えますが、業務での使い方を考えると逆です。会議を録って残したいのは音声ではなく、次のアクションに使えるテキストだからです。
私が日常的にやっているのは、対面の打ち合わせをAIレコーダーで録音し、テキスト化したデータをそのまま確認資料や提案資料に落とし込む流れです。Google Meetの録画も同じで、議事録という中間成果物をわざわざ作らず、テキストから直接アウトプットへ変換します。
この運用では、モデルが音声で返せるかどうかは一切効いてきません。むしろ「入力は何でも受け取るが、出口はテキストに固定されている」という設計は、そのまま既存のワークフローに刺さります。
議事録そのものの作り方を先に整理したい場合は、こちらの記事で会議の形・録音環境・出口の3点から設計する手順をまとめています。

公式ドキュメントで確認できた仕様
ここから先の数字は、すべて2026年9月20日時点でAlibaba Cloud Model Studioの公式ドキュメントに記載されていた内容です。報道側の数字と公式の数字が食い違った箇所は後述しますが、まず公式で確認できた範囲を表にします。
項目 | 内容 |
|---|---|
モデルID | qwen3.8-omni-flash |
入力モダリティ | テキスト/画像/音声/動画 |
出力モダリティ | テキストのみ |
コンテキスト長 | 1Mトークン |
呼び出し方式 | Chat Completions/Responses |
音声入力の対応言語 | 113の言語・方言(Qwen3.5-Omniと同じ) |
ツール | Function Calling対応。Responsesの組み込みツールは現時点でweb_searchのみ |
キャッシュ | 自動の暗黙キャッシュに対応。ResponsesのSessionキャッシュにも対応 |
注目したいのは、旧世代との入力上限の差です。公式ドキュメントによれば、ひとつ前のQwen3-Omni-Flashは音声・動画とも入力が150秒まででした。2分半です。この制約下では「会議を丸ごと読ませる」という発想自体が成立しません。
さらに古いQwen-Omni-Turboシリーズは「もう更新されない」と明記され、テキスト分析の移行先としてQwen3.8-Omni-Flashが指定されています。長尺を扱えるようになったこと自体が、この系列での最大の変化だと読めます。
料金は「秒」から逆算できる — 音声1秒=7トークン
ここが本題です。多くのモデルでは「音声をトークンに換算する比率」が公開されておらず、実際に投げてみるまで請求額が読めません。Qwen-Omniシリーズはこれを式で公開しています。
公式の換算式
公式ドキュメントの「Token conversion rules」には、モデル別に次の式が載っています。
モデル | 入力音声の換算 | 出力音声の換算 |
|---|---|---|
Qwen3.8-Omni-Flash | 秒数 × 7 | (音声出力なし) |
Qwen3.5-Omniシリーズ | 秒数 × 7 | 秒数 × 12.5 |
Qwen3-Omni-Flash | 秒数 × 12.5 | 秒数 × 12.5 |
Qwen-Omni-Turbo | 秒数 × 25 | 秒数 × 25 |
1秒未満の音声は1秒として数える、という但し書きも付いています。画像は32×32ピクセルあたり1トークン、1枚あたり最小24トークン・既定の上限1,280トークン(高解像度モードでは16,384トークン)です。
60分の会議を読ませるといくらか
換算式が分かれば、あとは掛け算です。以下は公式の換算式と、QwenCloudの表示価格(1Mトークンあたり入力0.15ドル)を使った私の概算で、ベンダーが公表した金額ではありません。
録音の長さ | 入力トークン(秒数×7) | 入力側の概算コスト |
|---|---|---|
15分 | 6,300 | 約0.00095ドル |
60分 | 25,200 | 約0.0038ドル |
3時間(音声の入力上限) | 75,600 | 約0.011ドル |
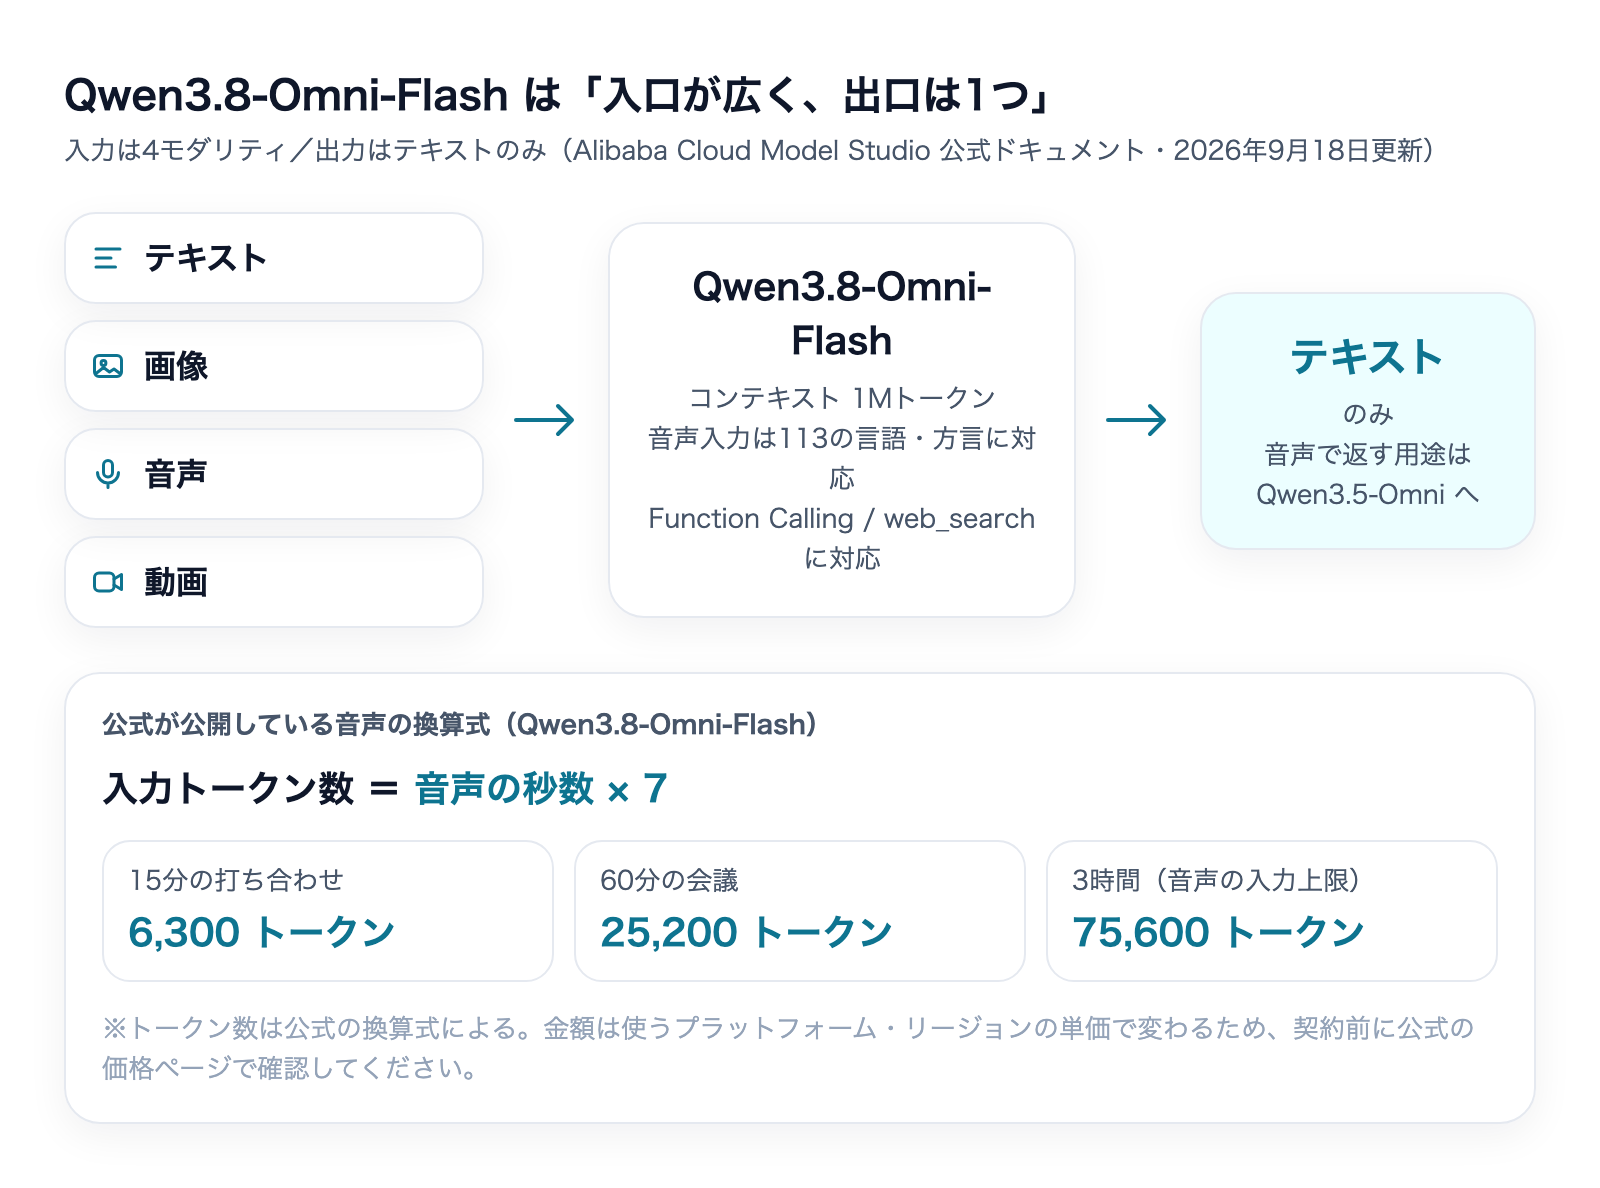
1時間の会議を読ませる入力コストが1円に届きません。営業日20日分を毎日1時間ぶん流しても、入力側は50万トークン強=十数円の規模です。
ただしこれは入力の音声部分だけです。実際には指示文のトークン、要約として返ってくる出力トークン(QwenCloud表示で1Mトークンあたり0.47ドル)、そして思考のトークンが乗ります。報道によればこのモデルは思考が既定でオンになっていて、しかも既定の強度は最も高い設定です。コスト見積もりで効いてくるのは音声よりも出力と思考の側だと考えたほうが実態に合います。
コンテキスト1Mトークンは、音声に換算すると何時間か
同じ式を逆に使うと、コンテキストの広さを時間で捉え直せます。報道が伝えるQwenCloudの最大入力は991,000トークンなので、これを7で割ると約141,000秒=およそ39時間分の音声です。
一方で公式ドキュメントが定める音声の入力上限は3時間。つまりコンテキストは音声だけでは埋まりません。余った枠は動画のフレームや、参照させたいテキスト資料に回す設計だと読むのが自然です。
動画は「秒数×解像度」で効いてくる
動画は音声ほど単純ではありません。公式ドキュメントはトークン数を推定するPythonコードを掲載していて、そこでは動画を一定のfpsでサンプリングし、リサイズ後の縦横ピクセルを32×32で割ってフレームあたりのトークンを出しています。
公式の推奨設定表には「素早く低コストで確認したい場合は60分以内・50語以内の簡潔なプロンプト・max_pixelsは230,400」とあります。この推奨値からフレーム単価を逆算すると1フレーム225トークン相当になり、コードの構造上サンプリング後のフレーム数が秒数に対応するため、60分の動画でおよそ81万トークンという桁感になります。
※この段落の数値は、公式の見積もりコードの構造と推奨パラメータから私が計算した概算で、公式が公表した数値ではありません。実際の請求はコンソールの明細で確認してください。
桁で言えば、音声だけなら1時間で2.5万トークン、映像も読ませると1時間で80万トークン規模。30倍以上の開きがあります。「動画のまま投げる」か「音声トラックだけ抜いて投げる」かは、画質の話ではなく請求額の話です。動画解析のコストをどこで削るかは、別モデルを題材にこちらの記事で整理しています。
長尺を安く読む仕組み:全部を見ないで答える
トークン単価とは別に、今回の発表で技術的に面白いのは「長い動画の読み方」そのものを変えてきた点です。コストの話と直結するので触れておきます。
頭から最後まで再生しない
従来の動画理解は、ファイルを先頭から終わりまで通して読むのが基本でした。答えが2時間のうちの3分にしかなくても、全体を読みます。当然ながら、その分のトークンを払います。
報道によれば、今回のモデルは質問のほうから出発します。何を見るべきか・何を聴くべきかをモデル自身が決め、粗く見てから細かく見る、という往復を繰り返して必要な箇所に計算を寄せる設計です。
その効果として示されているのが、OmniVideoBenchというベンチマークでの数字です。正答率が63.4から67.8に上がり、同時にトークン消費が145,736から79,117へ、約45.7%減ったと報じられています。精度とコストのどちらかを選ぶのではなく、両方が同じ方向に動いた、という主張です。
ただしこれもQwen自身が公表した数値で、独立した検証結果は公開時点では出ていないと報道側が明記しています。傾向として受け取り、実際の請求は自社の素材で測る、という距離感が適切です。
実務で効くのは「探す作業」
この読み方が刺さるのは、要約よりもむしろ検索の用途です。「あの説明をしていたのは何分頃か」「この手順を実演していた箇所を出してほしい」といった問い合わせは、社内に動画資産が溜まるほど増えていきます。
全編を読ませる前提なら、こうした質問は1回ごとに数十万トークンを消費します。必要な区間だけを取りに行けるなら、同じ質問のコストが一桁下がる可能性があります。社内の研修動画やセミナー録画を「検索できる資産」に変えたい会社にとっては、ここが本命かもしれません。
入力側の制約も押さえておく
とはいえ、何でも投げられるわけではありません。報道が公式ドキュメントから引いている制約は次のとおりです。
- 動画ファイルはURL指定で最大2時間・2GBまで
- 音声ファイルは最大3時間まで
- 音声入力は113の言語・方言に対応
- 動画は最大15fpsのサンプリングまでは安定して動作
- 提供リージョンは北京・シンガポール・香港・東京・フランクフルト・バージニアの6か所
3時間を超える録音は分割が要ります。半日の研修や終日のワークショップを扱うなら、分割して投げ、分割した要約をもう一度まとめる二段構えを前提に設計しておくほうが安全です。この手の「尺の上限」は、試作段階では気づかず本番で詰まる典型的な落とし穴です。
「音声入力98%減」の出所は単価であって、トークン数ではない
今回の発表で最も目を引く数字が「音声入力のコストが1時間あたり98%以上安くなった」という主張です。ただしこの数字は、公式ドキュメントの換算式と突き合わせると読み方が変わります。
時間あたりのトークン数は変わっていない
先ほどの表をもう一度見てください。比較対象として名前が挙がっているQwen3.5-Omniシリーズも、入力音声は秒数×7です。新旧で係数が同じということは、同じ1時間の音声を投げたときに消費される入力トークン数は変わっていません。
したがって「98%減」が事実だとすれば、その削減はトークン数ではなくトークン単価の側から来ていることになります。旧モデルの1トークンあたりの値段が、新モデルでは数十分の一になった、という話です。
なぜこの区別が実務で効くのか
単価による値下げは、ベンダーの価格改定ひとつで戻り得ます。一方、換算係数が改善された場合は仕組みとして安くなっているので、値下げが撤回されても効率は残ります。持続性が違うわけです。
だから私は、こういう発表を見たときに「何%安くなったか」ではなく「安さの出所はどこか」を先に確認します。そして見積もりは常に秒数 × 係数 × その時点の単価という形で持っておき、単価が動いたら掛け直せるようにしておきます。割引後の金額を覚えるのではなく、式を覚える。これが料金変動の速い領域での自衛策です。
数字が割れている箇所は、割れたまま扱う
今回の発表を追いかけていて、報道間で一致しない数字が複数ありました。公開前にこれを潰すのではなく、割れていること自体を書いておきます。
ベンチマークの評価本数と改善幅
TechNodeは「30の評価でQwen3.5-Omni-Plusに対し平均スコアが26%以上向上」と伝え、MarkTechPostは「29の評価で25%以上向上」と伝えています。どちらか一方が正しいはずですが、公式ドキュメント側には該当する記載が見当たりませんでした。
さらにMarkTechPostは、掲載しているベンチマーク数値について「すべてQwen発表のもので、公開時点で独立した検証結果は得られていない」と自ら断っています。ベンダー自己申告であることが明示されている数字だと理解して扱うのが妥当です。
表示価格が2系統ある
価格も1つに定まりません。MarkTechPostはQwenCloudの表示として1Mトークンあたり入力0.15ドル・出力0.47ドル・暗黙キャッシュのヒット分0.016ドルと伝えています。一方TechNodeは中国のIT Homeを引いて「API入力価格は最安で100万トークンあたり0.8元」としています。
提供面はQwenCloud、Alibaba Cloud Model Studio、Qwen Studioと複数あり、リージョンも複数あります。プラットフォームとリージョンによって単価が違うのは珍しいことではありません。2026年9月20日時点の参考値として扱い、契約前には自分が使うリージョンの公式価格ページで必ず確認してください。
私のスタンス
ベンチマークの順位表は、導入判断の材料としてはほとんど役に立ちません。効くのは「自社の音声を10本流して、どれだけ使える要約が返ってきたか」です。
とくに日本語の会議音声は、複数人が被って話す、方言が混ざる、専門用語が飛ぶ、という条件が重なります。ベンチマークのスコアと現場の使用感が一致しない典型的な領域です。対面会議で誰が話したかを分ける難しさについては、こちらで具体的に書いています。

私たちの運用にどう入れるか、どこには入れないか
ここからは、実際に文字起こしと要約を日常業務で回している側から見た評価です。
今どう回しているか
私の現在の構成は、対面の打ち合わせはAIレコーダー端末で録音し、オンラインはGoogle Meetの録画を使う、というものです。音声入力そのものは用途別に3つのツールを併用しています。速度優先のもの、整形品質優先のもの、そしてオフライン処理でプライバシーを守るものの3つです。
セミナーや会議の長尺動画については、Claude Codeを使って文字起こしから要約までをつなげています。その実装の流れはこちらにまとめました。
入れられる場所:バッチで処理する長尺
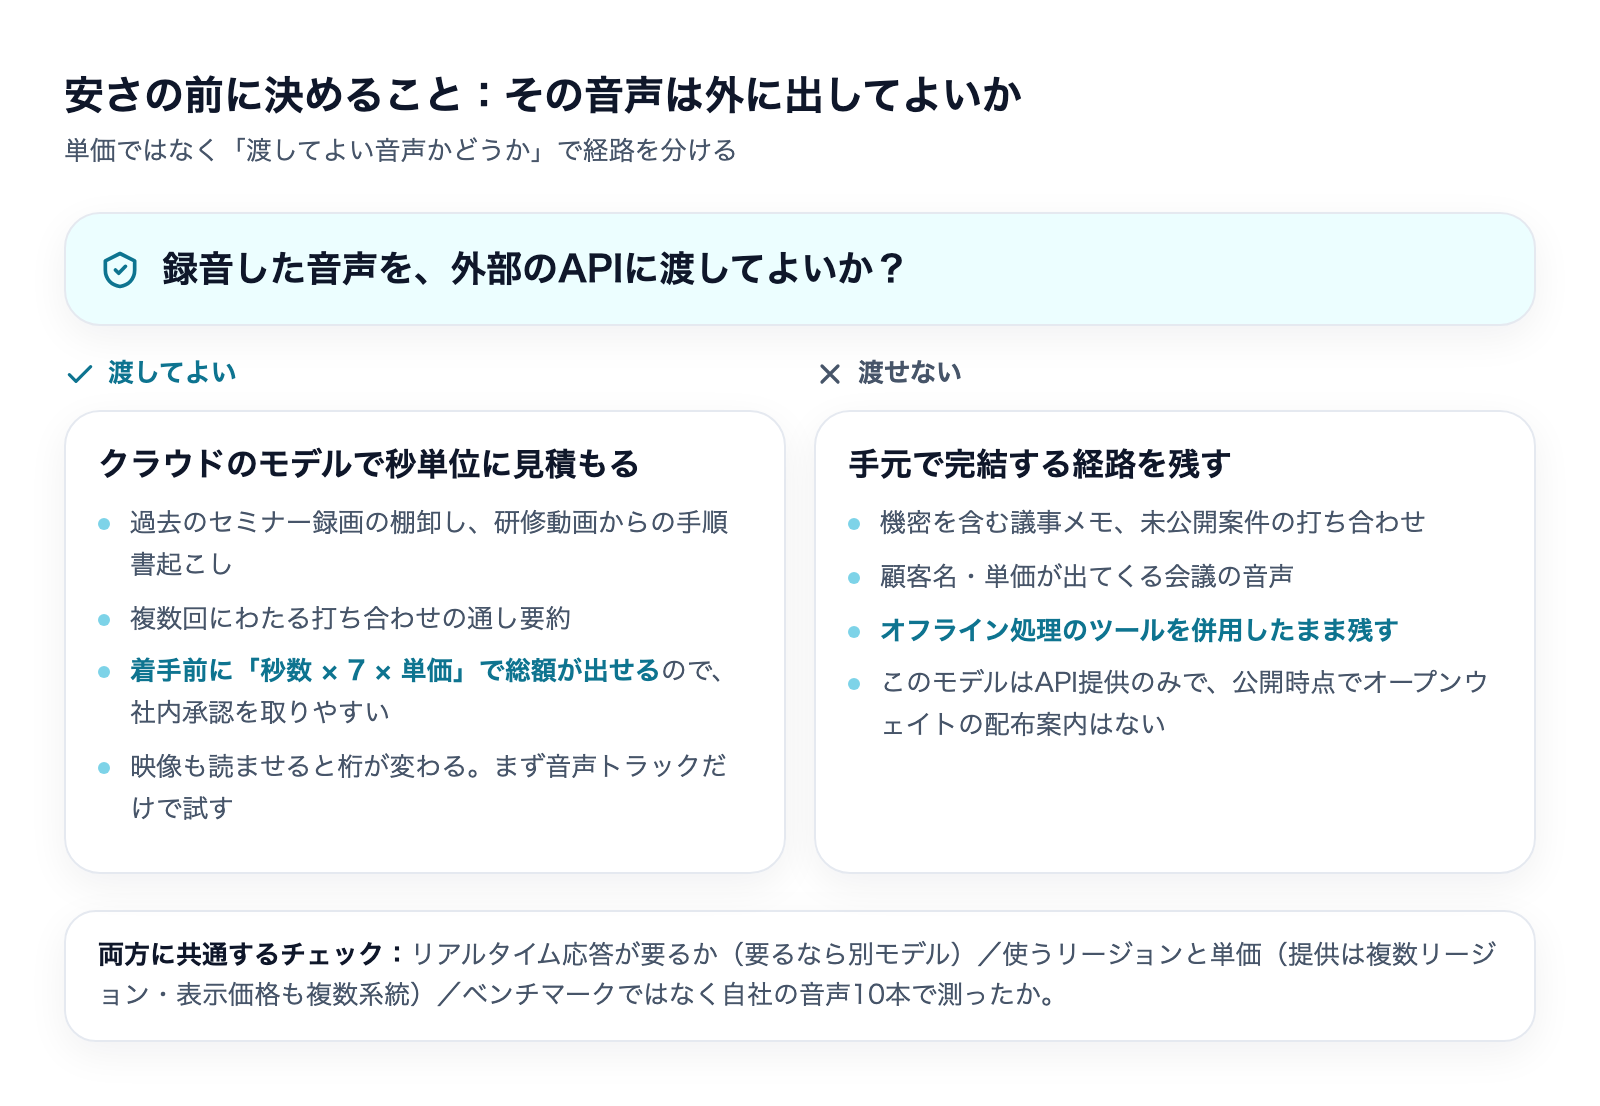
今回のモデルが効きそうなのは、リアルタイム性が要らず、まとめて処理したい長尺です。具体的には、過去に溜まったセミナー録画の棚卸し、複数回にわたる打ち合わせの通し要約、社内研修動画からの手順書起こしといった作業が該当します。
音声を秒数から見積もれるので、「この30本を流すといくらか」を着手前に机上で出せます。これは稟議を通す側にとって決定的に楽です。従量課金のAIを社内で通せない理由の多くは高いからではなく、いくらになるか説明できないからです。
入れない場所:外に出せない音声
一方で、私が併用しているツールのうちオフライン処理のものを外す気はありません。理由は精度ではなく、その音声をクラウドに渡してよいかどうかです。
機密を含む議事メモや未公開案件の打ち合わせは、そもそも外部APIに送らない前提で運用しています。今回のモデルはAPI提供のみで、公開時点でオープンウェイトの配布は案内されていません。つまり自社環境に置いて動かす選択肢がないということです。
加えて、提供リージョンには日本(東京)も含まれると報じられていますが、どのリージョンを使うかで話が変わる以上、ここは必ず契約前に確認すべき項目になります。中小企業でも、顧客名や単価が出てくる会議の音声は珍しくありません。「安いから全部これに流す」ではなく、渡してよい音声かどうかで経路を分けるのが実務の答えです。
エージェントから使うなら Qwen-MM-Plugins
今回あわせて注目されたのが、Qwen-MM-Pluginsというオープンソースのプラグイン群です。「どんなエージェントハーネスもマルチモーダル対応にする」を掲げています。
中身はSkillとMCPサーバー
GitHubのリポジトリを確認したところ、ライセンスはApache-2.0で、2026年9月20日時点のスター数は2,924でした。READMEによれば、各機能はSkillと(任意の)MCPサーバーの組み合わせとしてインストールされます。
ガイド付きインストーラーが対応するハーネスとして、Claude Code、CodeBuddy、Codex、Qoder、OpenClaw、Qwen Code、Gemini CLIが挙げられています。加えて手動セットアップの案内対象にHermes Agentなども含まれます。
Omni系の機能として用意されているのは、長尺動画の音声・映像記憶を作るomni-memory、チュートリアル動画を図入りPDFに変換するomni-video2note、デモ動画を再利用可能なSkillに変換するomni-skill-creator、動画編集系のomni-chatcutなどです。
ここは一次で確かめて修正した点
報道では、このプラグイン群がモデルと同時に公開されたかのように読めます。ただしGitHub APIでリポジトリの作成日時を取ると2026年7月29日で、モデル発表のおよそ7週間前から存在していました。正確には「既存のプラグイン基盤にOmni系の機能が加わった」です。
細かい違いに見えますが、検討する側にとっては意味があります。今日生まれたばかりの実験的リポジトリではなく、数週間の運用実績がある基盤だということだからです。
音声だけは、まだ回り道が要る
READMEには重要な但し書きがあります。「ほとんどのハーネスは、まだ音声をメインのモデルへネイティブに渡せない。当面、音声はAPI経由で処理される」という一文です。
つまり「エージェントに音声ファイルを渡せば、あとは全部やってくれる」という状態には、まだなっていません。音声はAPI呼び出しを挟む構成になります。導入検討でここを読み飛ばすと、想定した構成が組めずに手戻りします。
検討する前に決めておく5項目
ここまでを踏まえて、社内で判断するなら次の順で潰すのが早いはずです。
- その音声を外部APIに渡してよいか——ここが×なら、価格の比較に進む意味はありません。オフライン処理のツールを残す判断になります
- リアルタイムが要るか——対話しながら返事が欲しいならこのモデルの担当外です。ベンダー自身が別モデルへ誘導しています
- 音声だけで足りるか、映像も要るか——映像を含めると桁が変わります。まず音声トラックだけで試すのが定石です
- 使うリージョンと単価——プラットフォームによって表示価格が異なります。2026年9月20日時点の数字は参考値として扱い、契約前に公式の価格ページで確認してください
- 自社の音声10本で測ったか——ベンダー公表のベンチマークではなく、実際の会議音声での使用感で決めます
この5つのうち、多くの会社で最初に引っかかるのは1つ目です。そしてそれは技術の問題ではなく、社内のルールをどう作るかという問題です。
まとめ
Qwen3.8-Omni-Flashは、テキスト・画像・音声・動画を受け取ってテキストで返す、入口が広く出口が1つに絞られたモデルです。音声出力が要る用途は、ベンダー自身が別モデルへ誘導しています。
最大の実務的価値は、公式が音声1秒=7トークンという換算式を公開していることだと私は考えています。60分の会議なら25,200トークン、3時間でも75,600トークン。着手前に机上で見積もりが立つので、社内で承認を取る負荷が下がります。
一方で「音声入力98%減」という見出しの数字は、換算式を突き合わせるとトークン数ではなく単価に由来する値下げだと分かります。ベンチマークの評価本数も報道間で割れていて、しかもベンダー自己申告です。覚えるべきは割引率ではなく計算式のほうです。
そして最後に残るのは、安さより先に来る問いです。その音声は外に出してよいのか。株式会社Fyveが顧問先で最初に決めるのはいつもここで、専属AI活用顧問サービスでも、ツール選定の前に「何を渡してよいか」の線引きから一緒に作っています。式で見積もれるようになったぶん、判断が要るのはその一点に集約されてきました。
※本記事の価格・仕様は2026年9月20日時点で公式ドキュメントおよび公開情報から確認した内容です。導入前には必ず最新の公式情報をご確認ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。