Gemini 3.8 Liveとは|単価は同じ、費用は4倍

「音声AIは1分いくらで見積もればいいのか」「同じシリーズなのに、どうして片方だけ費用が跳ね上がるのか」——音声対話AIを業務に入れようとすると、最初につまずくのはここです。
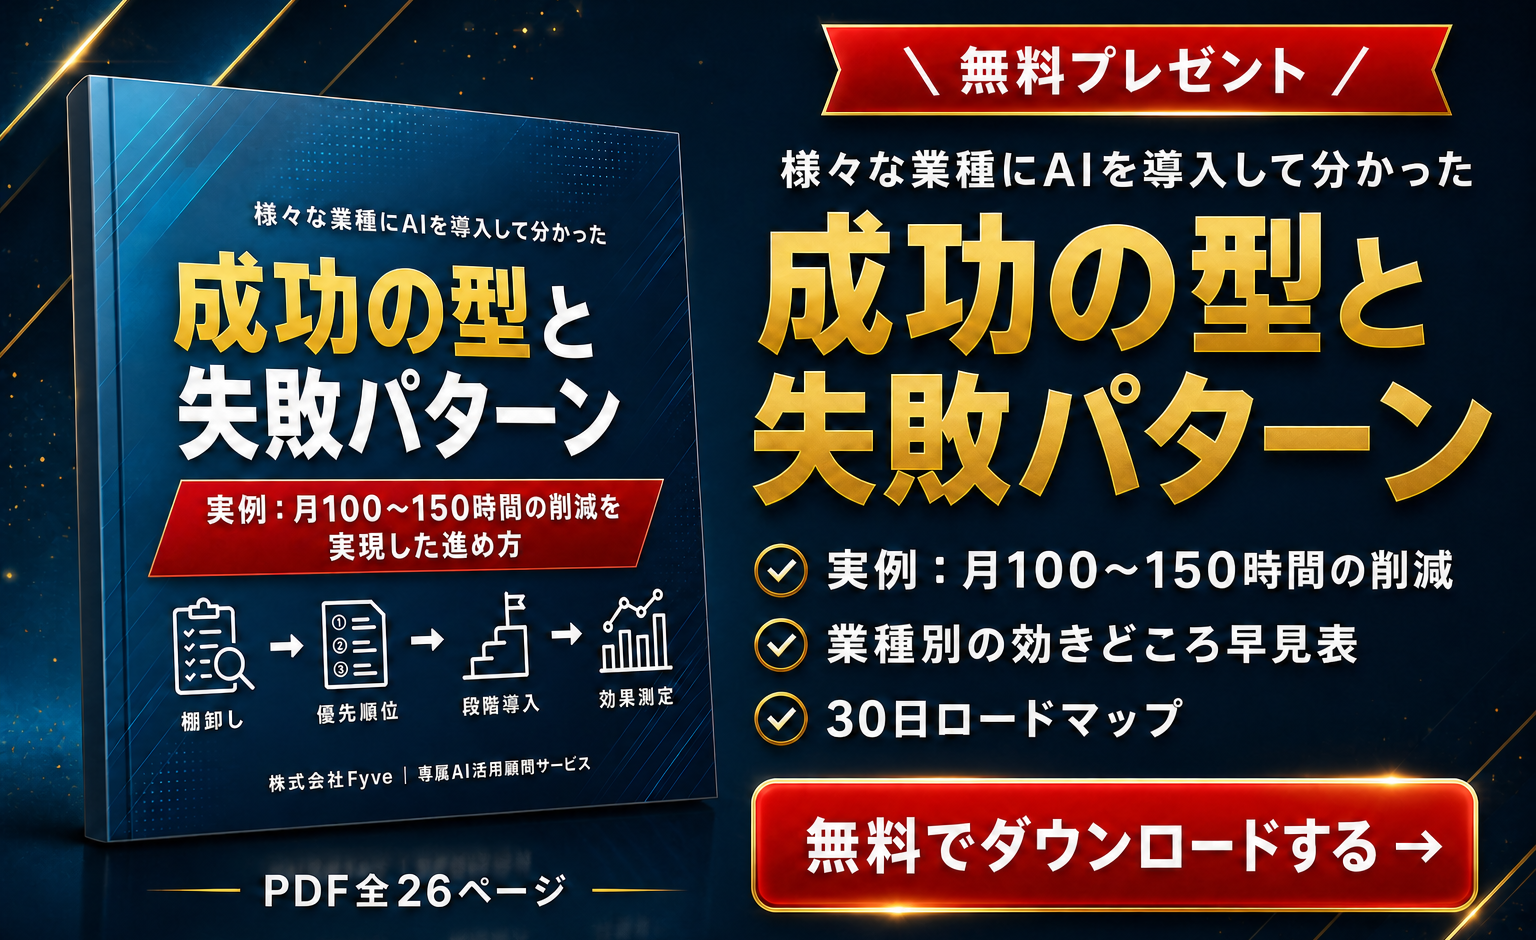
結論から言うと、Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking は公式の料金表では同じ単価です。それでも第三者の実測では時間あたりのコストが約4倍違います。差を生んでいるのは単価ではなく、モデルがどれだけ考え、どれだけ喋るかという消費量のほうです。
株式会社Fyveは、中小企業の業務にAIを組み込む仕事をしています。私たちがこれまで現場に入れてきたのは「音声入力」であって「音声対話」ではありませんでした。その線引きがどこで変わるのかという視点で、2026年9月15日に発表されたこの2モデルを読み解きます。
Gemini 3.8 Liveとは|同時に2つ出た音声対話モデル
Googleは2026年9月15日、音声対話に特化した新モデル「Gemini 3.8 Live」と「Gemini 3.8 Live Extended Thinking」の提供開始を公式ブログで発表しました。どちらも音声を受け取って音声で返す、いわゆるスピーチ・トゥ・スピーチのモデルです。
「音声認識でテキストにして、テキストで考えて、読み上げる」という従来の3段構えではありません。音声のまま処理するので、間の取り方や言い直しへの追従が自然になります。この構造自体は先行するGPT-Live 1などと同じ系統です。
2つのモデルの違いは「考えてから話すか」だけ
同時に2つ出たので混乱しやすいのですが、両者の位置づけはシンプルです。
- Gemini 3.8 Live:規模とコスト効率を優先した標準モデル。問い合わせの一次受けのように、件数が多くて1件が軽い用途向け
- Gemini 3.8 Live Extended Thinking:複雑なタスク向け。推論の深さを設定でき、考えながら同時に話す(考えている間の沈黙を作らない)
「黙って考える時間が生まれない」というのは、音声対話では見た目以上に重要です。テキストなら3秒待たされても気になりませんが、電話口で3秒黙られると相手は切ります。Extended Thinkingは推論と発話を並行させることで、この沈黙を埋める設計になっています。
発表時点で公開されている性能の数字
公式ブログおよびMarkTechPostの解説記事で示されている数字を整理します。いずれも2026年9月15日時点で公表されたものです。
指標 | Gemini 3.8 Live Extended Thinking | 比較対象 |
|---|---|---|
Artificial Analysis | 82.6(1位) | GPT-Live-1 Astra(Medium)81.5 |
τ-Voice(エージェント的タスク) | 68.6% | GPT-Live-1 Astra 67.9% |
Sierra τ-Voice-banking | 35.1% | GPT-Live-1 Astra 32.0% |
Big Bench Audio(推論) | 97.7% | — |
注目してほしいのは、品質指標のトップ争いが82.6対81.5対81.3という僅差だという点です。音声対話モデルの「賢さ」はもう横並びに近く、ここで選定の決め手を探しても差が出ません。
一方で、金融ドメインのτ-Voice-bankingが35.1%という数字には目を留めるべきです。1位のモデルでも、銀行業務を模したタスクは3回に1回しか完遂できていません。音声エージェントに業務を丸ごと任せるのは、2026年9月時点ではまだ早い——ベンチマークはそう言っています。
料金表を見ると、2つは同じ値段です
ここからが本題です。Gemini APIの公式料金ページを開くと、Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking は同じ単価の行に並んでいます(2026年9月16日時点・有料ティア)。
種別 | 入力 | 出力 |
|---|---|---|
テキスト | $0.75 / 100万トークン | $4.50 / 100万トークン |
音声 | $3.00 / 100万トークン | $12.00 / 100万トークン |
画像・動画 | $1.00 / 100万トークン | — |
音声の単価は入力$0.005/分・出力$0.018/分。この2つの数字はMarkTechPostでも同じ値が示されており、公式ページと一致しています。無料ティアも両モデルで利用可能と記載されています。
※料金は改定されます。契約前に必ず公式の価格ページで最新の条件をご確認ください。表示は米ドル・税別で、日本円換算は為替に依存します。
それでも実測コストは4倍違う
単価が同じなら、費用も同じはずです。ところが第三者の実測では違いました。
AI評価機関Artificial Analysisが、Big Bench Audioのサブセットを使って「入力音声1時間あたりのコスト」を測った結果がofficechaiの記事で報じられています。
モデル | 入力音声1時間あたりの実測コスト |
|---|---|
Gemini 3.8 Live | $0.84 |
Gemini 3.8 Live Extended Thinking | $3.50 |
Grok Voice Think Fast 2.0 | $4.80 |
GPT-Live-1 Astra | $5.83 |
同じ単価表を使っているのに、標準モデルとExtended Thinkingで約4.2倍の開きがあります。同一ベンチマーク・同一の測り方でこの差が出ているので、これは測定条件の違いではありません。
差が出ているのは単価ではなく「トークンの量」
理由ははっきりしています。Extended Thinkingは推論を深くするぶん、内部で消費するトークンが増え、話す量も増えるからです。単価が同じでも、消費量が4倍なら請求額は4倍になります。
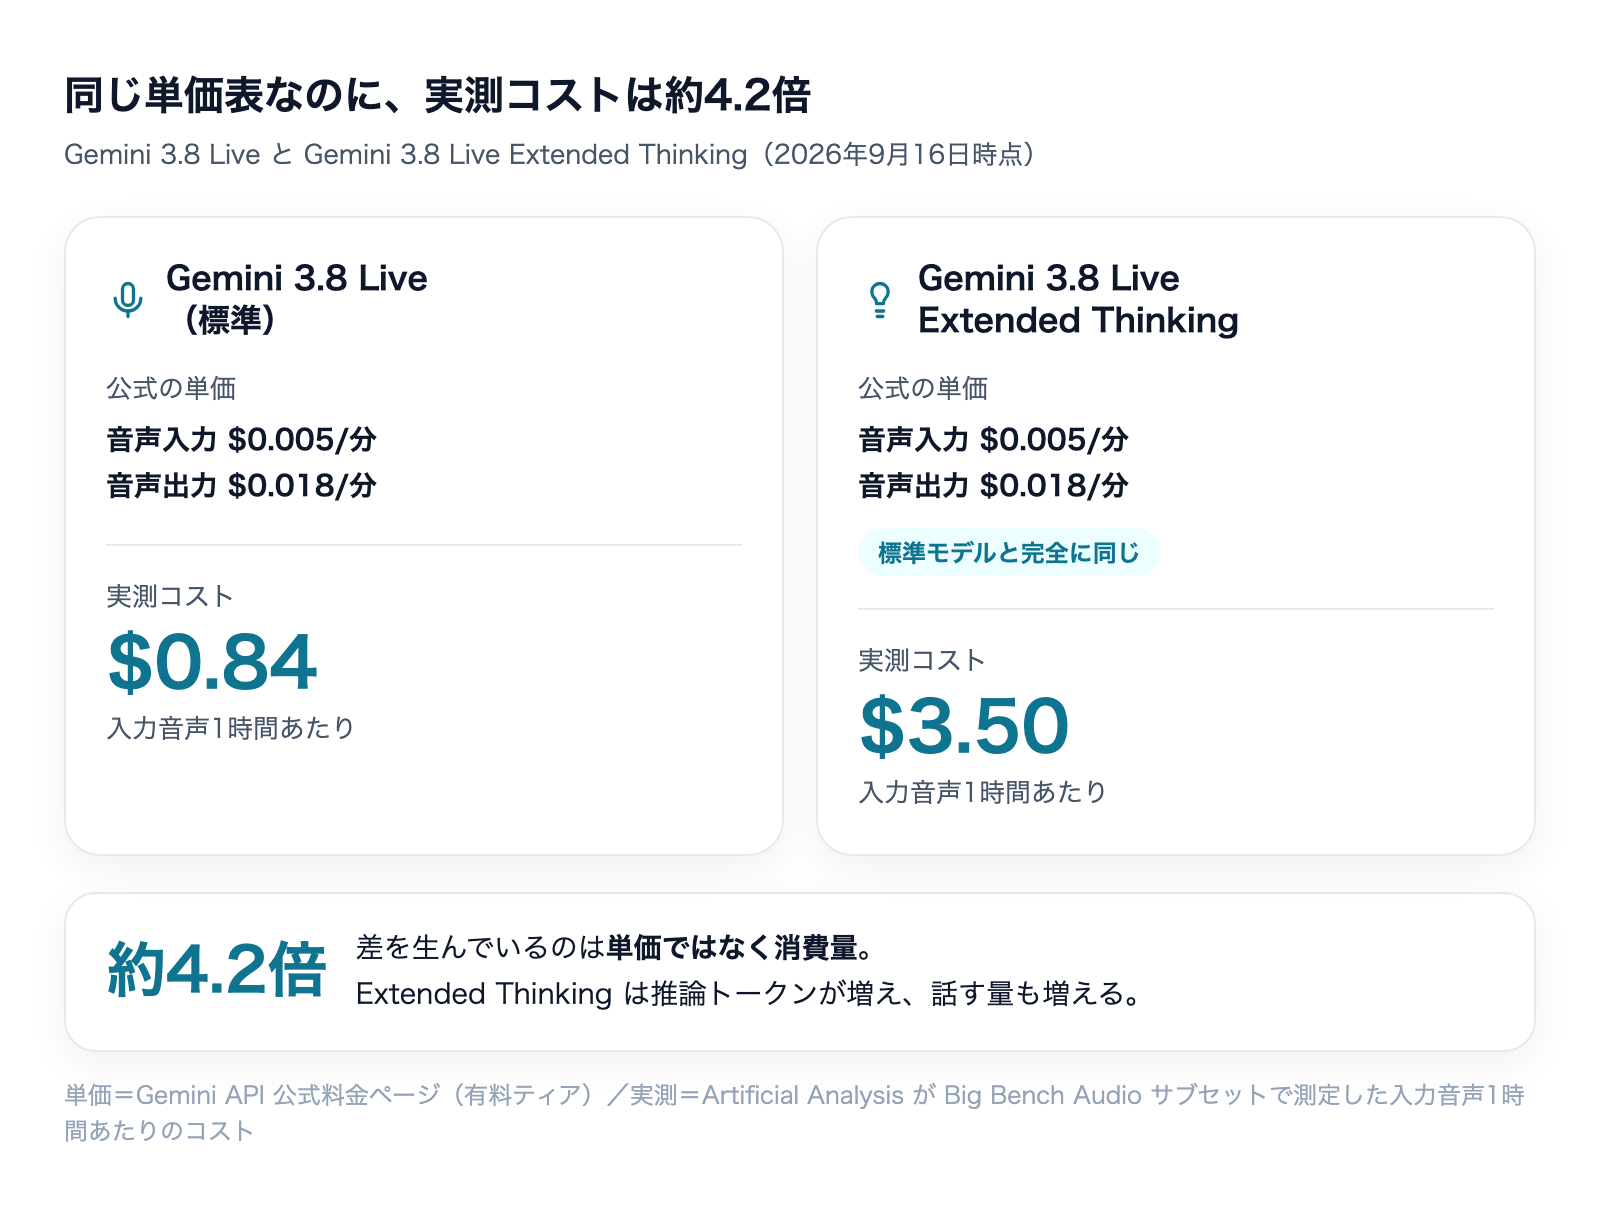
音声モデルの料金表には「$0.018/分」という分あたりの表記が併記されているので、つい「1時間喋らせたら1.08ドル」と計算したくなります。でもこの分単価が効くのは音声そのものを流している時間だけです。モデルが考えた量、ツールを呼んで返ってきたテキストを読んだ量は、この分単価の外側でトークンとして加算されていきます。
つまり、音声対話AIは「分」では見積もれません。見積もるべき単位は「1件の会話で何往復し、何を考えさせ、何を読み上げさせるか」です。
私が見積もりのときに実際に数えている4つ
私たちがクライアントに費用感を提示するとき、音声まわりでは次の4つを分けて数えます。分単価だけで話を進めると、ほぼ確実に足りなくなるからです。
- 相手が喋っている時間(=音声入力の分単価。ここは素直に読める)
- AIが喋っている時間(=音声出力の分単価。入力の3.6倍の単価なので、喋りすぎる設計はここで効いてくる)
- 考えた量(=推論トークン。Extended Thinkingを選ぶかどうかで最も動く。実測4倍差の正体)
- 裏で動いた処理(=ツール呼び出しで取ってきたデータを読み込むテキストトークン。在庫照会や顧客情報の参照を挟むほど増える)
このうち2番は設計で直接減らせます。AIの返答を「はい、確認します」と短く切る運用にするだけで、出力分単価は素直に下がります。逆に3番は、モデルの選択そのものが費用を決めます。選定の順番としては、まず標準モデルで足りるかを試し、足りないとわかってからExtended Thinkingに上げるのが正解です。最初から上位モデルを選ぶと、必要のない思考に4倍払い続けることになります。
コスト構造をどこで削るかという考え方は、同じGoogleのモデルを扱ったGemini動画解析のコストを下げる5か所でも整理しています。音声でも動画でも、効いてくるのは単価交渉ではなく「何を投げないか」の設計です。
GPT-Liveと比べるとき、単位の違う数字を引き算しない
私たちは2026年9月に、OpenAIのGPT-Live 1についてGPT-Liveとは|聞きながら話す音声AIの料金と落とし穴という記事を書きました。そこで整理した音声レイヤーの料金は1分あたり0.05ドルです。
今回のGeminiは音声入力$0.005/分・音声出力$0.018/分。単純に足せば約0.023ドル/分で、GPT-Liveの半分以下に見えます。
ただしこの引き算はやってはいけません。片方は「音声レイヤー一式」としての表記、もう片方は「入力と出力を別建てにした表記」で、含んでいる範囲が違うからです。同じ「1分いくら」という顔をしていても、中身が揃っていません。
比較したいなら、単位が揃っている数字を使います。先ほどのArtificial Analysisの実測は、同じベンチマークを同じ測り方で通した結果なので比較に耐えます。
- Gemini 3.8 Live:$0.84/時間
- Gemini 3.8 Live Extended Thinking:$3.50/時間
- Grok Voice Think Fast 2.0:$4.80/時間
- GPT-Live-1 Astra:$5.83/時間
この並びなら「Geminiの標準モデルが最も安い」と言えます。そして品質指標では82.6対81.5とほぼ差がない。性能が横並びで価格差だけが大きいとき、選定の理由は性能ではなく既存環境との相性になります。すでにGoogle Workspaceを使っている会社ならGemini、OpenAIで組んでいるならGPT-Live、という判断で構いません。
ベンチマークの順位を導入判断にそのまま使わない
もうひとつ付け加えておくと、82.6と81.5の差は、実際の業務ではまず体感できません。体感差として現れるのは、ベンチマークが測っていない部分——自社の商品名を正しく聞き取るか、方言や早口に追従するか、騒音のある現場で使えるか——のほうです。
こうした点はカタログでは判断できないので、自社の実音声で10件試すしかありません。私たちがツール選定の相談を受けたときも、必ず実データでの試行をお願いしています。
97言語を会話の途中で自動で切り替える
今回の発表で、単価や順位よりも実務に効きそうだと感じたのはこの機能です。公式ブログは「97の対応言語を会話の途中で自動検出して切り替える」と明記しています。MarkTechPostも同じ記述を伝えています。
従来の音声システムは、最初に言語を選ばせる設計が普通でした。「日本語の方は1を、English press 2」というあれです。この方式には隠れた前提があります——利用者が自分の使う言語を最初に宣言できる、という前提です。
現場ではこの前提が崩れます。日本語で話し始めたけれど専門用語だけ英語になる、途中で日本語の話せる同僚に代わる、片言の日本語と母語が混ざる。こうしたとき、言語を固定した設計は聞き取りに失敗します。
言語を「選ばせない」ことの意味
外国人スタッフが働く現場や、インバウンドの一次受けを想定すると、言語の自動切替は「対応言語が増えた」という話ではありません。入口で相手に選択を強いる工程が丸ごと消えるという話です。
私たちがこれまで音声入力を導入してきた現場でも、うまくいく仕組みには共通点がありました。利用者に何も選ばせないことです。以前、幼稚園の業務メモを音声入力に置き換えた案件では、園児の世話をしながらスマホに語りかけるだけで記録が残る形にしました。
園児の世話をしながら記録が取れる。幼稚園の業務メモを音声入力に変えた話でも書いたとおり、成果を分けたのは認識精度ではなく「手が空いていなくても操作が終わること」でした。メニューを1つ挟むだけで、現場では使われなくなります。
言語の自動判定も同じ性質の改善です。精度の話に見えて、実は操作工程を削る話です。
会話を止めずに、裏で処理を走らせる
もうひとつの機能が、非同期のツール呼び出しです。公式ブログは「会話を続けたまま、バックグラウンドでツールやAPI呼び出しを実行する」と説明しています。MarkTechPostはこれを「タスクが完了する間も音声レスポンスはユーザーに流れ続ける」と補足しています。
電話の一次受けを想像するとわかりやすいと思います。人間のオペレーターは「少々お待ちください」と言って端末を叩き、沈黙が生まれます。非同期呼び出しができるモデルは、照会をかけながら「今お調べしています、ご登録は先月でしたね」と喋り続けられます。
「裏が動いている」ことの怖さも同時に増える
ただし、これは会話を切っても裏の処理が止まるとは限らないということでもあります。利用者が電話を切った後に、予約登録や在庫引当が完走してしまう可能性がある。
ここはGPT-Liveの記事でも同じ論点を扱いました。音声対話モデルを業務に入れるとき、停止の責任はモデル側ではなくアプリ側にあります。「会話が終わったら未完了の処理をどうするか」を設計で決めておかないと、あとで帳簿が合わなくなります。
導入判断としては、こう分けるのが安全です。
- 照会だけ(読み取り):非同期呼び出しを積極的に使ってよい。失敗しても副作用がない
- 登録・変更・決済(書き込み):会話の終了と処理の確定を必ず紐づける。非同期のまま投げっぱなしにしない
英数字を正確に扱えることが地味に効く
MarkTechPostは、確認番号・請求番号・技術データといった英数字の精度が強化されていると伝えています。地味ですが、業務利用ではここが実用性を分けます。
予約番号を一桁聞き間違える音声AIは、どれだけ会話が自然でも業務には入れられません。逆にここが安定するなら、受付・照会・確認といった定型業務は現実的な適用範囲に入ってきます。
「目」が付いた|視覚入力をほぼリアルタイムで処理する
3つめは視覚です。公式ブログは、ライブの視覚入力をほぼリアルタイムで処理すると説明しています。MarkTechPostは応用例として、スケッチと音声のフィードバックからReactコンポーネントを生成するデモに触れています。
業務側で考えると、想定できるのは「現物を映しながら相談する」タイプの用途です。設備の型番を映して問い合わせる、書類を映して記入箇所を尋ねる、といった場面では、言葉で説明させるより速い。
ただし現時点では過度な期待は禁物です。視覚入力が加わるということは、画像・動画の入力トークンも加算されるということでもあります。公式料金表では画像・動画の入力が$1.00/100万トークン(または$0.002/分)で、音声より安いとはいえゼロではありません。映しっぱなしにする設計はコストに直結します。
提供形態とデータの扱いで、確認しておくべき点
どこから使えるか
2026年9月15日時点の提供状況を整理します。
- 開発者:Gemini API、Google AI Studio で即日提供
- 企業:Gemini Enterprise でプライベートプレビュー。カスタマーエクスペリエンス向けの派生は準備中
- 一般利用者:Search Live、およびPro/Ultraの契約者向けにWorkspace(Docs・Gmail・Keep)で順次展開
MarkTechPostは、これらがホスト型のみの提供でオープンウェイトの配布はないと明記しています。つまり自社サーバー内で完結させる選択肢はありません。音声を扱う以上、ここは導入前に確認が要る点です。
生成音声にはSynthIDの電子透かしが入る
生成された音声にはGoogle DeepMindの非可聴のSynthIDウォーターマークが埋め込まれる、とMarkTechPostは伝えています。AIが生成した音声であることを後から検証できる仕組みです。
これはリスクではなく、むしろ業務利用では追い風になります。「この音声はAIが作ったものだ」と機械的に判別できる根拠が残るためです。とはいえ、相手に対してAIが応対していることを明示するかどうかは、透かしとは別に運用で決める必要があります。私たちは、一次受けをAIに任せる設計では冒頭で必ず名乗らせることを勧めています。
音声対話を業務に入れる前に決める3つのこと
ここまで機能と費用を見てきましたが、実際の導入可否を決めるのは機能表ではありません。私たちが相談を受けたときに必ず確認する3点を挙げます。
① 現場が欲しいのは「聞き取り」か「会話」か
最も多い取り違えがこれです。音声対話モデルは会話をするための道具であって、記録を残すための道具ではありません。
「手が塞がっているから声で記録したい」という要望なら、必要なのは音声入力(書き起こし)です。会話は要りません。この用途なら音声入力AI比較 Typeless vs Aqua Voice vs Superwhisperで比較したような書き起こし特化のツールのほうが、速くて安くて壊れにくい。
私たちがこれまで現場に入れてきたのも、ほぼ全てこちら側でした。会話が必要なのは、相手が自社の外にいるとき——つまり問い合わせ対応・受付・予約といった、相手の言葉が予測できない場面に限られます。
② 失敗したとき、誰がどこで気づくか
音声対話は記録が残りにくい経路です。テキストのやりとりなら後から検索できますが、音声は文字起こしを保存する設計にしていないと、何が起きたか追えません。
τ-Voice-bankingの完遂率が35.1%という数字を思い出してください。3回に2回は完遂できない前提で、失敗を人間が拾う導線を先に作る必要があります。会話ログを全件保存する、確信度が低い応対は人に転送する、といった設計です。
③ 止めるボタンは誰の手元にあるか
非同期のツール呼び出しがある以上、「会話を切る」と「処理を止める」は別操作です。運用を始めてから止め方を考えると間に合いません。
この考え方は音声に限りません。AIに業務を任せる範囲を決めるときの共通の論点です。ハンズフリー運用の設計例としては、私たち自身が使っている構成をHermes Agent 音声モード設定ガイドにまとめています。
小さく試すなら、この順番で
いきなり本番の電話に繋ぐ会社が時々ありますが、おすすめしません。費用も事故も、順番を守れば避けられます。
- 無料ティアで、自社の実音声を10件通す。商品名・社名・地名が聞き取れるかだけを見る。ここで落ちるなら先はありません
- 標準のGemini 3.8 Liveだけで試す。Extended Thinkingは使わない。標準で足りない場面を具体的に洗い出すのが目的です
- 読み取り専用のツール呼び出しを1つ繋ぐ。営業時間の照会、在庫の確認など、間違っても実害がないものから
- 10時間ぶんの実測コストを出す。$0.84/時間という数字はベンチマーク上の値であって、自社の会話の長さと往復回数で変わります。必ず自分の数字を取る
- 書き込みを伴う処理は、最後に、人間の確認を挟んで繋ぐ
1から4までは、費用としては数ドルの世界です。この順番を踏んだかどうかが、半年後の運用コストを決めます。
まとめ|単価表ではなく、消費量を設計する
2026年9月15日に発表されたGemini 3.8 Live と Gemini 3.8 Live Extended Thinking について、押さえておくべき点を整理します。
- 公式料金表では2つとも同じ単価(音声入力$0.005/分・音声出力$0.018/分・2026年9月16日時点)
- それでもArtificial Analysisの実測では$0.84/時間と$3.50/時間で約4.2倍の差。差は単価ではなく推論と発話の消費量から来ている
- 品質指標は82.6対81.5とほぼ横並び。性能では選定の決め手にならず、既存環境との相性で選んでよい
- 97言語の会話中自動切替は、精度の改善ではなく入口の操作工程を消す改善
- 非同期のツール呼び出しは便利だが、停止の責任はアプリ側。読み取りから始めて書き込みは最後に繋ぐ
- 金融ドメインの完遂率は35.1%。丸ごと任せる段階ではなく、失敗を人が拾う導線が要る
音声対話AIの費用は「1分いくら」では決まりません。何を考えさせ、何を喋らせ、裏で何を読ませるか——その設計が費用そのものです。単価の比較に時間を使うより、自社の会話を10件流して実測を取るほうが、はるかに速く答えが出ます。
私たちも、新しいモデルが出るたびに性能表から入るのではなく、「自社の業務のどこに置けるか」という置き場所の側から考えるようにしています。カタログの数字ではなく、現場の1件から判断してください。
同じGeminiのエージェント基盤でも、ハーネスの版が変わると費用と移行作業の見え方が変わります。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。