Jevの活用例|公開直後に出た作例とLLMとの使い分け

「Jevが速くて安いのは分かった。それで、結局これで何を作れるのか」——公開から数日で、この疑問に答える材料が一気に増えました。
結論から言うと、実例の大半は「情報を選り分ける仕事」に集まっています。公開直後にX上へ出てきた作例を数えると、その多くがブラウザ拡張機能で、表示されたものを片端から判定して隠す・色分けする・並べ替えるという形でした。理由は単純で、1件あたりの判定が安く速いからです。
株式会社Fyveは中小企業のAI導入を支援しています。この記事では、2026年9月20日までに公開されている実際の作例と、公式ドキュメントが挙げる用途を突き合わせ、それぞれについて「なぜ従来のLLMではなくJevなのか」を1つずつ確認していきます。うまくいかなかった例も載せます。
なぜ公開直後にこれだけ作例が出たのか
前提を一言だけ。Jev(ジェブ)は文章を生成せず、こちらが用意した選択肢の中の答えと確率だけを返すモデルです。入力100万トークンあたり0.042ドル(米ドル・税別)・出力無料、応答は70〜500ミリ秒(2026年9月20日時点の公式記載・最新の条件はtypesafe.aiで)。仕組みや料金の詳細は別記事に譲ります。
この2つが揃うと、これまで割に合わなかった使い方が成立します。「画面に出ているもの全部に、いちいちAIの判断を通す」という使い方です。従来のモデルで同じことをやると、1件ごとに数秒と相応の費用がかかり、しかも返ってくるのが文章なので判定結果を取り出す処理が要ります。100件並んだ投稿を1件ずつ判定していたら、スクロールに追いつきません。ここが変わったので、作例が一斉に出たというのが私の見立てです。
公式ドキュメントも、用途の筆頭に「smart if-statements(賢いif文)」を挙げ、「150ミリ秒でのリアルタイム処理」「大量データへの一括適用」を並べています。作例の傾向は、この説明とよく一致しています。
活用例1: 見たくないものを消す——フィードの選別
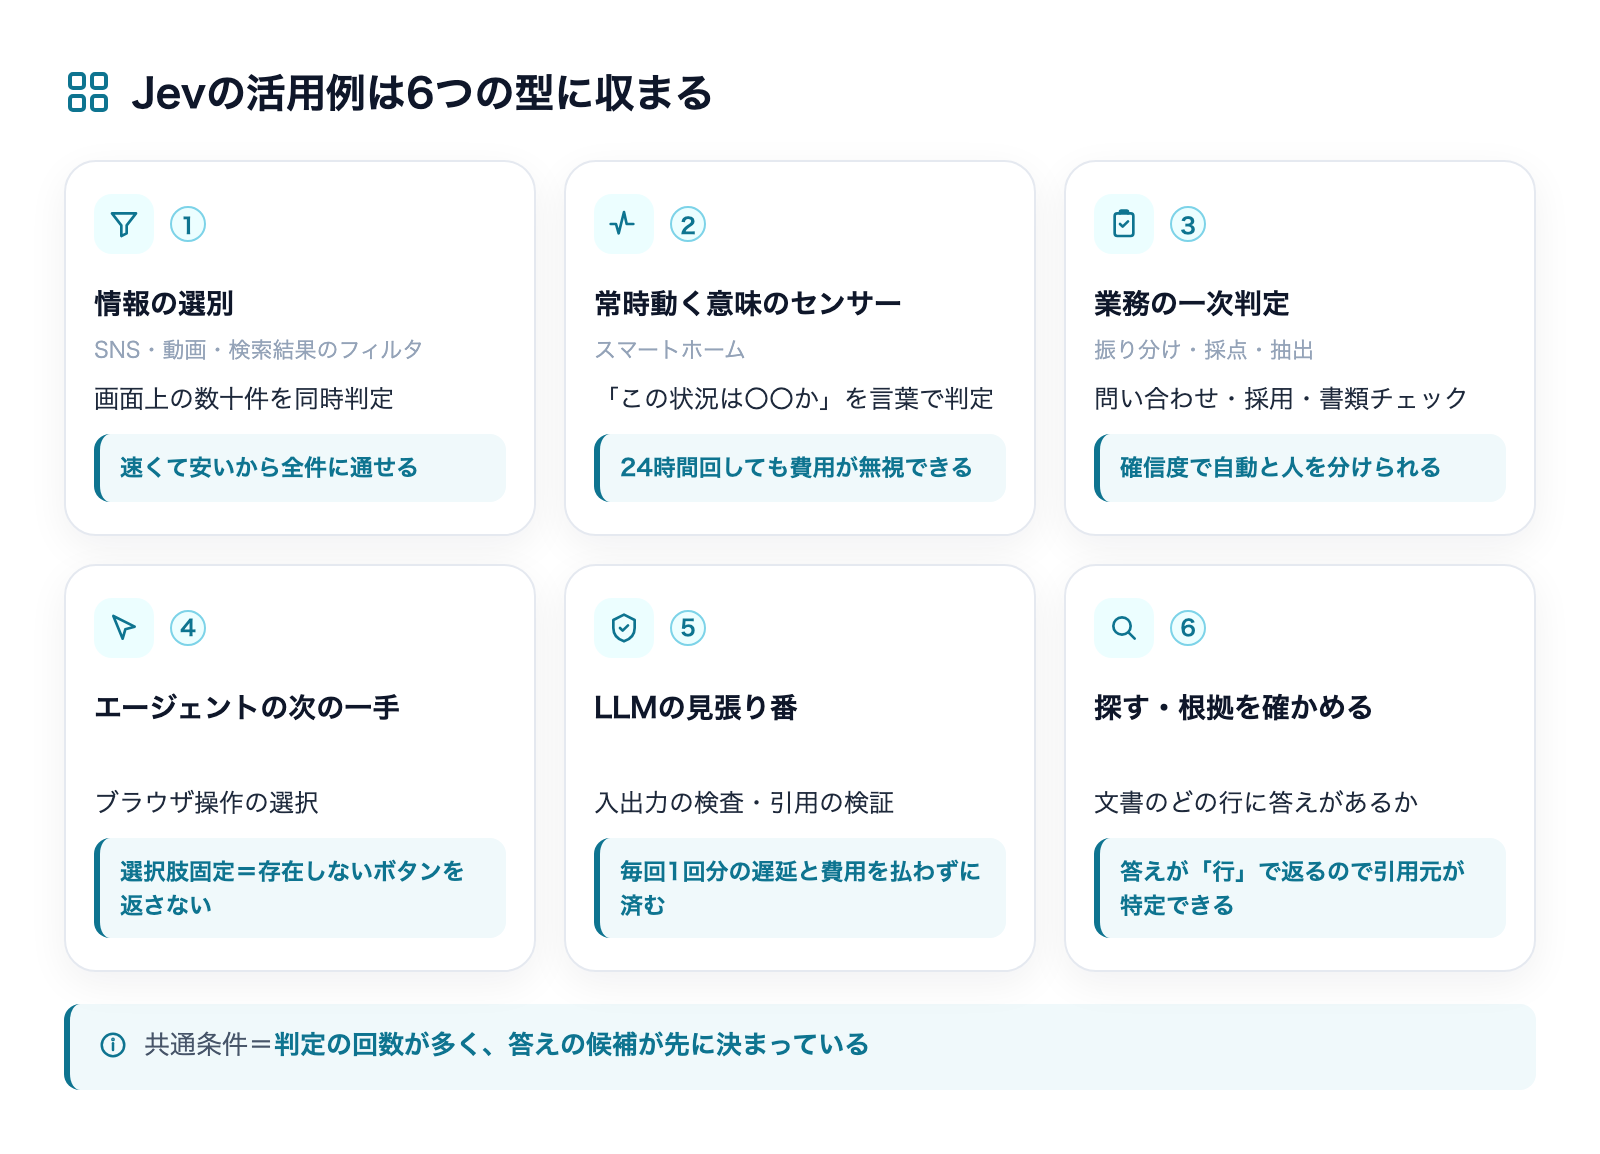
最も数が多いのがこの分野です。SNSやサイトの表示内容を、自分の基準で選り分けるブラウザ拡張機能が多数公開されました。
- Xのタイムライン選別: 投稿を「煽り」「宣伝」「スパム」「AIが書いた中身の薄い文章」などに分類してラベルを付け、しきい値を超えたものを畳む。自然文で条件を書けるものもあります
- YouTubeの選別: 中身の薄い動画やコメントを、スクロールに合わせて判定して隠す。判定結果を保存して再利用する作りのものもあります
- LinkedInの選別: 反応狙いの投稿を除去する用途
- 検索結果の色分け: 検索結果の各ページを「広告」「実体験」「解説」に判定して色を付ける。日本の開発者が公開した例です
- 返信欄の整理: 投稿に付いた返信を1件ずつ採点し、しきい値を超えたものを折りたたむ
なぜLLMでなくJevなのか。この用途では、1画面に数十件の判定が同時に発生します。ある開発者は、従来使っていた高速なLLMと比べて約6倍速く、約40分の1の費用だったと報告しています。別の開発者は「実質無料。広告ブロッカーの未来だと思う」と書いていました。速度と費用のどちらかが欠けると成立しない使い方です。
加えて、返ってくるのが確率なので、「0.8以上なら隠す」「0.5〜0.8はぼかす」のように、利用者が厳しさを自分で調整できます。文章で「これはスパムだと思います」と返ってくるのとは、扱いやすさが違います。
活用例2: 常時動く「意味のセンサー」
面白いと感じたのは、家庭用の自動化システムにJevを組み込んだ例です。スマートホーム基盤の拡張として公開されており、Jevの判定そのものをセンサーとして扱えるようにしたものです。
従来、家庭の自動化で使えるセンサーは「温度が何度を超えたら」「人感センサーが反応したら」といった数値や信号に限られていました。ここにJevを挟むと、「この状況は〇〇と言えるか」という言葉の判定が、そのままセンサーの1つになります。
なぜLLMでなくJevなのか。この種の判定は、数分おきに永続的に動き続けます。1回数円のモデルを24時間回すのは現実的ではありませんが、1回あたりの費用がほぼ無視できるなら成立します。常時稼働は、費用の単価が効いてくる典型です。
活用例3: 業務の一次判定——振り分け・採点・抽出
ここが、中小企業にとって最も実利のある領域です。公式ドキュメントは業務用途を19分野挙げていますが、日本の中小企業で当てはまりやすいものに絞ると次のようになります。
- 問い合わせの振り分け: 内容の分類、緊急度の採点、売り込みメールの判別、約束事項の抽出
- 採用: 応募内容を募集要件と突き合わせて評価する。実例として、求人票を読んで「この求人に応募すべきか」を職務範囲から判定する拡張機能が公開されています(判定はおよそ0.6秒と報告されています)
- 書類のチェック: 契約書や提出書類を分類し、必要な条項の欠落や規定違反を検出する
- リード判定: 見込み客の情報を理想の顧客像と照合し、確度を採点する
- 請求・保険処理: 申請内容の分類、不審な兆候の検出、優先順位付け
いずれも共通しているのは、「人が読んで、決めて、次に回す」形の工程だということです。文章を書かせる仕事ではありません。
なぜLLMでなくJevなのか。1件ずつなら、正直どちらでも処理できます。差が出るのは件数が増えたときです。公式の検証では、4種類の業務ワークフローの平均でJevは1件あたり0.0004ドル・0.4秒という結果が示されています。同じ検証の中で、大型モデルは1件あたり0.1〜0.2ドル・数十秒という桁でした。月に数千件を流すなら、この差はそのまま運用可否の差になります。
ただし精度については冷静に見る必要があります。同じ検証でJevの平均正解率は67.8%で、最上位の大型モデル(73.1%)より低い数字です。全部を任せきる前提の数字ではありません。後述する確信度による切り分けが前提になります。
国内で出てきた業務寄りの作例
公開から5日ほどで、日本でも業務に近い作例が出始めています。私が確認できた範囲で挙げます。
- kintoneへの組み込み: 製造業の方が、業務アプリの中にJevの判定を入れた例。既存の業務基盤に「判断の部品」として差し込む使い方です
- 支出メモの費目分類: 入力された支出の一言メモを、ミリ秒で勘定科目に振り分ける。経理の一次処理そのものです
- 契約書・論文の条項チェック: 「第n条が残りの全条項と矛盾しないか」を走査的に判定するという構想。文書検索の応用(後述)と同じ型です
- バナー広告の分析: Jevが「悩み訴求か」「顔があるか」「問いかけ型か」などを定量的に分類し、その結果を使ってLLMが言語化・制作する。「Jevが分類、LLMが言語化」という分担を、実務で最初に形にした例として分かりやすいと思います
- 株式市場の監視システムの一次審査: 大量の情報から「見るべきもの」を先に絞る用途
いずれも「決める」工程にJevを置き、「作る」工程は従来のモデルか人が担っています。この分担が、作例を横断して共通する型です。
公式が挙げている用途の一覧
参考までに、公式ドキュメントが列挙している業務用途を整理しておきます。自社に近い行があるかを見る用途で使ってください。
分野 | Jevに任せる判断 |
|---|---|
カスタマーサポート | 問い合わせの分類、緊急度の判定、約束事項の抽出、返答内容の検証 |
採用 | 応募書類と募集要件の突き合わせ、職種との適合度 |
営業・マーケティング | 見込み客と理想の顧客像の照合、購入意欲の採点 |
法務・コンプライアンス | 文書の分類、条項の欠落や規定違反の検出 |
保険・金融 | 申請内容の分類、不審な兆候の検出、優先順位付け |
EC | 商品情報の整形、属性の抽出、模倣品の検知 |
コンテンツ運営 | 投稿の監視、広告表現の審査 |
研究・調査 | 文献の選別、記録の分類、引用の裏付け確認 |
システム運用 | 問い合わせの振り分け先の決定、コード規約の意味的な検査 |
この表で注目してほしいのは、どの行も「決める」で終わっていて、「作る」が1つもないことです。用途を探すときの目印になります。
活用例4: AIエージェントの「次の一手」を決める
AIにブラウザを操作させる仕組みの中で、操作の判断だけをJevに任せ、文章の生成は従来のモデルに任せるという構成の作例が出ています。公開された拡張機能では、エージェントがページを見て、クリックする対象や次の行動を選ぶ部分にJevを使い、文章が必要な場面は別のモデルに投げる作りになっていました。
なぜLLMでなくJevなのか。エージェントの操作は、1つの作業を終えるまでに何十回も判断を繰り返します。1回3秒かかるモデルで30回判断すれば、それだけで90秒です。判断が0.1秒なら3秒で済みます。しかも選択肢が固定されているので、実在しないボタン名を返して処理が止まる、ということが起きません。
この「判断はJev、生成は従来モデル」という分担は、早期に使った開発者の評価とも一致します。ある開発者は「この種のモデルはLLMの置き換えではなく、LLMと組み合わせたときに非常によく機能する」と書いていました。
活用例5: LLMの見張り番にする
公式ドキュメントが具体的な手順書まで用意している用途が、LLMの入出力を検査する使い方です。利用者からの入力と、AIが返した出力の両方に対して、危険な兆候があるかを1回の問い合わせでまとめて判定します。
公式の手順書では、「指示の無視や暴露を狙っていないか」「危害や違法行為の助けを求めていないか」といった判定を複数並べ、あわせて深刻度を0〜3で採点しています。そのうえで、しきい値によって「通す」「人が確認する」「止める」を切り分ける設計です。
なぜLLMでなくJevなのか。公式の説明がそのまま答えになっています。「LLMの前にもう1つLLMを置けば、毎回1回分の遅延と費用を払うことになり、しかもその見張り役も言いくるめられる」という趣旨の記述です。検査は全通信に対して行うものなので、1回あたりの重さが致命的になります。
関連して、公式の手順書には「小型の安いモデルに抽出させ、その結果をJevが項目ごとに検証し、怪しいものだけ高価なモデルに回す」という段階構成も載っています。全部を高価なモデルに通さずに品質を保つための型で、考え方としては自社でも真似できます。
活用例6: 探す・根拠を確かめる
検索まわりも、公式が手順書を用意している領域です。中でも分かりやすいのが文書の中から答えのある行を探すという使い方でした。
公式の手順書では、ある利用規約を218の条文に分解し、各行に L052| のような通し番号を付けて丸ごと渡します。そのうえで2つの問いを同時に投げます。「この質問の答えが載っているのはどの行か」(選択肢=218行)と、「そもそもこの文書に答えは載っているか」(はい/いいえ)です。
返ってくるのは、行ごとの確率と、答えの有無の確率です。公式はこの結果を3段階で扱う例を示しています。0.7以上なら「答えが載っている」、0.35〜0.69なら「近いが完全には答えていない」、0.35未満なら「この文書には無い」という切り分けです。
なぜLLMでなくJevなのか。この形にすると、答えが「どの行か」という形で必ず返ってくるので、引用元が自動的に特定できます。文章で答えさせると、それらしい要約は返るものの、どこに書いてあったかは別途確かめる必要があります。社内規程や契約書のように「原文のどこか」が重要な文書ほど、この差が効きます。
関連する用途として、公式は次の3つも挙げています。いずれも「探した結果が正しいかを確かめる」側の仕事です。
- 検索結果の並べ替え: 既存の検索で候補を20件ほど出し、その関連度をJevで採点し直して並べ替える
- 参照文書の絞り込み: AIに回答させる前段で、拾ってきた文書が本当に関係あるか、内容が矛盾していないかを判定する
- 引用の検証: AIが書いた文章の主張と、その根拠として挙げられた文書を突き合わせ、実際に裏付けているかを判定する
3つ目は、社内でAIに資料を作らせている会社なら効きます。出典が付いているのに中身が対応していない、という事故は実際に起きます。全部を人が確かめるのは現実的でないので、機械で一次チェックを入れて、怪しいものだけ人が見る形にします。
なお選択肢の上限は255個です。218行なら1回で収まりますが、これを超える文書では「まず大まかな範囲を選ばせ、その中で行を選ばせる」という2段階にすると公式が案内しています。
うまくいかなかった例も見ておく
成功例ばかり並べても判断材料になりません。公開されている失敗例を1つ挙げます。
ある開発者が、Webページを決まった形式のデータに変換する拡張機能をJevで作ろうとし、「興味深い実験だったが、結局のところ失敗だった。分類器にやらせるには野心的すぎた」という趣旨の報告をしています。
これは仕様どおりの結果です。Jevはあらかじめ用意した選択肢から選ぶモデルであって、自由な文字列を取り出すモデルではありません。「ページから会社名と住所を文字列として抜き出す」ような、答えが無限にある抽出は守備範囲の外側です。公式も限界を説明したページで、開放的な抽出ではなく有限の選択肢に落とすよう案内しています。
もう1つ、作例からは見えにくいが実務でつまずきやすい点があります。Jevは指示を字義通りに読みます。公式は限界を説明したページで、否定・「〜を除く」といった限定・言外の条件に弱いと明記しています。「至急の案件を除いて振り分けて」のような書き方をすると、意図した通りに解釈されないことがあります。選択肢と指示は、含みのない平坦な日本語で書くのが前提です。
同じ理由で、次の使い方も向きません。いずれも公式が自ら苦手として挙げているものです。
- 数を数える・計算する(文字数、出現回数、リストの件数)
- 日付の前後や期間を判断する(文字列として読むため)
- 画像やPDFを読む(テキストのみ対応)
- 文章を書く(そもそも生成しない)
日本での作例と、日本語の精度
国内でも検証が始まっています。盤面を渡して次の一手を選ばせるオセロの実装が公開され、Jevの予想と探索アルゴリズムの予想を並べて可視化した投稿は9万回以上表示されました。遊びの例ですが、「選択肢から選ぶ」という性質が何に使えるかを直感的に示しています。
実測の報告もあります。ある開発者は、サーバーからAPIへの往復で中央値387ミリ秒・95パーセンタイル416ミリ秒という値を公開していました。公式の「70〜500ミリ秒」という記載と整合する範囲です。なお公式の数値はモデル側の応答時間であり、実際の体感には日本からアメリカのサーバーまでの通信時間が上乗せされます。画面の操作に合わせて動かす用途では、この往復時間を含めて測っておくのが安全です。
一方で、日本語については公式が精度の低下を明記しています。公式ドキュメントには、英語が主であり、日本語を含むCJK(中国語・日本語・韓国語)では精度が落ちること、そして非英語で運用する前に自分でテストすることが書かれています。
国内でも日本語での検証報告が出始めていますが、いずれも小規模な試行です。ここまで挙げた作例の多くが英語圏のものである点も踏まえてください。日本語の業務文書で同じ成績が出るかは、自社のデータで確かめるまで分かりません。
正解率7割のものを、どう業務に載せるか——実測で確かめた
ここまで何度か「確信度で切り分ける」と書いてきました。理屈は公式ドキュメントに載っていますが、本当に機能するのかは測らないと分かりません。2026年9月21日に、自作した日本語の問い合わせ25件(請求・技術・契約・売り込み・その他)をJevに流し、人手の正解と突き合わせました。
振り分けの一致率は96%(24/25)。ただし見るべきはそこではありません。正解したときの確信度の平均が0.95、外したときが0.47でした。外した1件は「カード情報を更新したい」という文で、正解は請求、Jevは契約。人が読んでも迷う境界です。Jevはそこで確信度0.47を返し、「迷った」と正しく申告していました。
この差があるので、しきい値で処理を分けられます。同じ25件で数えると、確信度0.6を境に自動と人手を分けた場合、自動処理した23件に誤りはなく、人の手に残ったのは2件でした。残った2件は、確信度が0.44と0.47の文で、どちらも「請求か契約か」の境界にあるものです。しきい値ごとの件数の表と、これをコードでどう書くかは、使い方の記事に載せています。
公式は「しきい値は1つではなく、間違えたときの結果の重さに応じて行動ごとに変える」と書いています。表示を消すだけなら0.6でよく、送金や削除のような取り返しのつかない操作には0.9以上を要求する、という使い分けです。
🔴 1点だけ注意があります。はい/いいえの問い(Noul)には確信度が付きません。返るのは確率1つだけです。確率が0.5付近なら迷っている、と読み替えます。
なお同じ25件を英訳して流したところ、一致率は同じ96%でした。日本語と英語で判定が割れたのは2件で、どちらも「請求か契約か」の境界にある文です(日本語で外した文は英語では当たり、英語で外した文は日本語では当たっていました)。公式は「日本語では精度が落ちる」と書いていますが、少なくとも問い合わせの振り分け程度では差が出ませんでした。25件は25件なので、自社の文面で必ず測ってください。測り方(スクリプトと、しきい値をコードでどう書くか)は、使い方の記事で扱います。
自社で試すなら、どこから手を付けるか
ここまでの作例を眺めて、共通している条件を整理すると3つになります。自社の業務を当てはめるときの判定基準として使えます。
- 判定の回数が多いこと。1日に数件なら、今使っているモデルで十分です。数百件・数千件になって初めて費用と速度の差が効きます
- 答えの候補を先に書き出せること。「適切に判断して」ではなく「A・B・Cのどれか」と書ける仕事かどうか。ここで詰まる場合は、業務側の定義がまだ固まっていません
- 間違えたときに取り返しがつくこと。正解率が7割前後の前提で組むので、いきなり最終決定を任せる設計にはしません
実際の着手は、今のシステムの中で「AIの返した文章から、はい/いいえを取り出している箇所」を探すところからが早道です。ある開発者も「LLMの文章からyes/noを取り出している場所こそ、Jevが効く場所だ」と書いていました。すでに判定として使っているのに、文章を経由しているせいで遅く・高く・不安定になっている箇所が、たいていどの現場にもあります。
まとめ
公開直後に出てきたJevの作例は、情報の選別・常時稼働の判定・業務の一次振り分け・エージェントの操作判断・LLMの検査、という5つの型にほぼ収まります。いずれも共通するのは「判定の回数が多く、答えの候補が決まっている」という条件です。
逆に、自由な文字列の抽出・計算・日付の処理・画像の読み取りは守備範囲の外で、公式自身がそう書いています。失敗例もそこで起きていました。
正解率は公式の検証で7割前後です。置き換えではなく併用、そして確信度が低いときは人に回す設計が前提になります。株式会社Fyveでは、こうした「どこまでをAIに任せてよいか」の線引きを、実際の業務フローに沿って整理する支援を行っています。
Jevの読み方・3つの型・登録手順・料金・制限をまとめたピラー記事です。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。