Cloudflare Clairicの使い方|料金と確信度の扱い

「Cloudflare の Clairic というモデルが preview を卒業したらしいが、何ができて、どう呼べばいいのか分からない」「請求書から金額や日付を抜き出したいが、AI が返す確信度をそのまま信じてよいのか」——紙やPDFの帳票をAIに読ませて手入力を減らそうとすると、まずこの2つで手が止まります。
結論から言うと、Clairic は Workers AI で動く「文章を書かずに、指定した型の値だけを返す」抽出モデルです。fields に「この項目は日付」「この項目は小数2桁の金額」と書けば、項目ごとに value・confidence・p_null・span が返ります。料金は入力だけの課金で、2026年11月18日の更新で本体が27Bに入れ替わり、これまでの9Bは Clairic-flash になりました。ただし確信度は「人が先に見る所」を決める手がかりであって、読み取りの正しさの保証にはなりません。
株式会社Fyveは、中小企業のAI導入を支援するなかで、紙の請求書をAIに読ませる仕組みと、文章を生成せずに数値で答えるモデルの実測を自社で続けてきました。この記事では、2026年11月20日にCloudflareの公式ブログ・開発者ドキュメント・Hugging Faceのモデル情報を読んで確かめた内容をもとに、Clairicの呼び方・返り値・料金と制限を整理し、私たちの実測から「確信度をどこまで信じてよいか」と、請求書で組むときの手順までを書きます。なお、Clairic自体はまだ私たちの手元で呼んでいません。公式の記述と、似た性質のモデルでの自社の実測を分けて書きます。
Cloudflare Clairicとは:文章を書かずに型の決まった値を返す抽出モデル
Clairic は、Cloudflare の Workers AI で提供されている抽出モデルです。公式ブログは、入力から値を取り出す(extract)、計算する(compute)、推定する(estimate)、予測する(forecast)の4つを行い、結果を型の決まった値として、確信度と確率つきで返すモデルだと説明しています。
普通のLLMに「この請求書の合計金額をJSONで返して」と頼むと、モデルはJSONの文字列を1文字ずつ生成します。Clairicは、項目ごとに型(日付・数値・リストなど)を先に決め、その型の値を返します。返ってくるのは文章ではなく、項目名と値と確信度の組です。
モデルは2つあります。2026年11月20日時点で、公式ドキュメントの記載は次のとおりです。
項目 | Clairic | Clairic-flash |
|---|---|---|
モデルID |
|
|
大きさ(公式ブログ) | 27B | 9B |
料金(入力100万トークンあたり) | $0.24(2026年12月1日までは $0.10と表記) | $0.10 |
出力の課金 | なし(入力トークンだけ課金) | |
文脈の長さ | 65,536トークン | |
ドキュメント上の状態 | preview | early research preview |
重み | Hugging Face で公開(ライセンスは Apache-2.0) | |
Hugging Face のモデルページでは、大きさの表示が 28B と 10B になっており、公式ブログの 27B・9B と少しずれています。元になったモデルは、Clairic が Qwen3.8-27B、Clairic-flash が Qwen3.5-9B と書かれています。
2026年11月18日の更新で変わったこと
Clairic は2026年10月19日に preview として発表され、そのときは @cf/cloudflare/clairic で9Bのモデルが動いていました。11月18日の公式ブログ「open-clairic」での変更点は次の4つです。
- 本体が27Bに入れ替わった:同じモデルID
@cf/cloudflare/clairicのまま、中身が27Bになりました。preview から使っている人には、新しいモデルがそのまま切り替わる形で届きます - 9Bは Clairic-flash へ:これまでの軽いモデルは
@cf/cloudflare/clairic-flashという別のIDになりました - 重みを公開:2つとも Hugging Face で重みが公開され、ライセンスは Apache-2.0 です。自分のサーバーで動かすための例もモデルページにあります
- PDFを受け付けるようになった:
documentsにPDFを渡せるようになりました
ブログによると、APIの形(リクエストとレスポンスの項目)は preview のときから変わっていません。preview で書いたコードは、そのまま新しいモデルに向きます。
「preview を卒業」と「preview」が並んでいる
ここは誤解しやすい点です。11月18日の公式ブログの見出しは「Clairic graduates from preview(preview を卒業)」ですが、同じ日以降の開発者ドキュメントのモデルページには、まだ「This model is in preview」と書かれています。Clairic-flash は「early research preview」です。
この記事では「一般提供(GA)になった」とは書きません。業務の本番に載せるなら、ドキュメントの表記が変わるまでは、仕様や料金が変わりうる前提で組むのが安全です。
Clairicの使い方:Workersから呼ぶ方法とRESTで呼ぶ方法
呼び方は2通りあります。Cloudflare Workers の中から呼ぶ方法と、外のプログラムからHTTPで呼ぶ方法です。どちらも渡す中身は同じで、必須は model と fields の2つです。
Workers の AI バインディングで呼ぶ
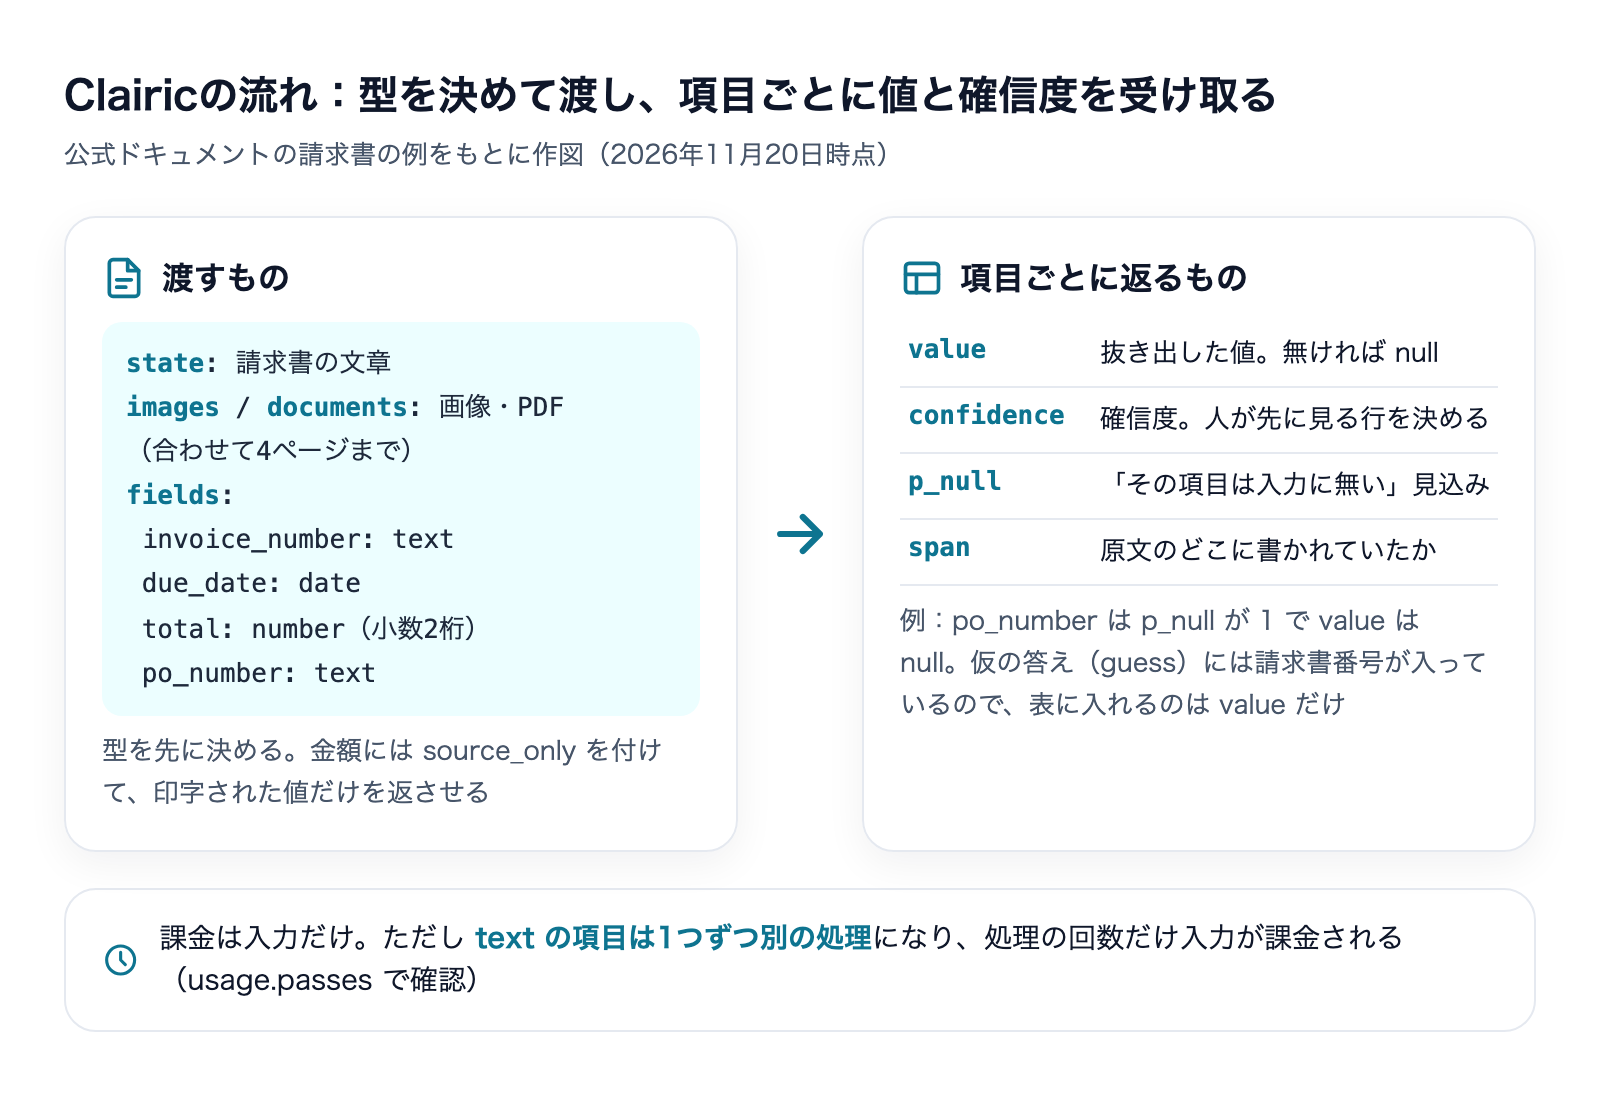
公式ドキュメントの例を短くしたものです。請求書の文章を state に入れ、抜き出したい項目を fields に並べます。
const response = await env.AI.run("@cf/cloudflare/clairic", {
  model: "clairic",
  state: "Invoice INV-2291 from Northwind Supply, issued 2026-09-02, net 30. ...",
  fields: {
    invoice_number: { type: "text" },
    due_date: { type: "date", instructions: "Issue date plus the net payment days" },
    total: { type: "number", decimals: 2, unit: "USD", instructions: "Amount due including shipping" },
    po_number: { type: "text", instructions: "Purchase order number" }
  }
});
instructions には、その項目の意味を短く書きます。上の例の due_date は「発行日に支払いまでの日数を足したもの」という指示で、書かれた日付を写すのではなく計算させる使い方です。
REST API で呼ぶ
Workers を使わない場合は、アカウントIDとAPIトークンを使ってHTTPで呼びます。
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clairic \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{ "model": "clairic", "state": "...", "fields": { ... } }'
Clairic-flash を使うときは、URLの末尾を @cf/cloudflare/clairic-flash に、model を clairic-flash に変えるだけです。
fields に書ける型
type に指定できる値は、公式のスキーマでは13種類あります。請求書や見積書で使うことが多いものを中心にまとめます。
型 | 返るもの | 請求書での使い道・主なオプション |
|---|---|---|
| 文字列 | 請求書番号・取引先名。 |
| 数値 | 合計金額・税額。 |
| 日付 | 発行日・支払期日。年の無い日付は |
| 計算した値 | 書類に無い値を計算で出す |
| 値の並び | 明細行。 |
| 候補の1つ | 支払方法(振込・口座振替など) |
| 推定値と幅 | 支払いまでの日数の見込みなど。 |
ほか |
| |
請求書で特に効くのが source_only というオプションです。これを付けると、入力に印字された値だけを返し、モデルが知識から補った値を返しません。金額のように「書類に書いてあるとおり」であってほしい項目には付けておくのが無難です。逆に knowledge を付けると、入力に無い値を事前の知識で答えることを許します。帳票の読み取りでは基本的に使いません。
知らないキーを書くとリクエストごと拒否されます。項目名は英字かアンダースコアで始め、64文字以内です。
返ってくる値:value・confidence・p_null・span の読み方
レスポンスは answers に項目ごとの結果が入り、ほかに model・truncated・usage が付きます。項目ごとの主な中身は次のとおりです。
キー | 意味 | 使いどころ |
|---|---|---|
| 抜き出した値。入力から決まらないときは null | そのまま表やシートに入れる |
| その値の確信度 | 人が先に見る行を決める |
| 「その項目は入力に無い」見込み | 空欄の判定。値が無いのに無理に埋めた行を見つける |
| 値が書かれていた位置(文字の開始と終了) | 人が原文の該当箇所を開く |
| 値が取れなかった理由(例: | 人に回す理由の記録 |
公式ドキュメントの例では、発注番号(po_number)が入力に無いとき、p_null が 1、value が null になっています。面白いのは、このとき guess(モデルの仮の答え)に請求書番号が入っていることです。「無い」と判断しつつ、一番近い候補は持っている。value ではなく guess を拾ってしまうと、請求書番号が発注番号の欄に入る事故になります。表に入れるのは value だけにします。
estimate の項目は、値に加えて median(中央値)・p10・p90(10%点と90%点)が返ります。「30日の見込みで、21〜38日の幅」のように、幅で受け取れます。
Clairicの料金と制限
料金:入力だけの課金だが、回数分かかる
2026年11月20日時点の公式ドキュメントの表記では、Clairic が入力100万トークンあたり $0.24、Clairic-flash が $0.10 です。出力のトークンには課金されません。公式ブログは「出力の生成の費用はこちらで持つ」と書いています。Clairic には「12月1日まで58%引きの $0.10」と表記されていますが、記事の寿命は割引期間より長いので、計算は通常の $0.24 を軸にしてください。契約前に最新の料金ページを確かめてください(Clairic のモデルページ)。
見落としやすいのが「パス」の数え方です。ドキュメントによると、text の項目は1つにつき1回の処理(パス)を使い、それ以外の型の項目はまとめて1回です。そしてパスごとに state 全体と画像すべてが入力に入るので、入力のトークンはパスの数だけ課金されます。
たとえば請求書番号・取引先名・品名の3つを text にし、金額と日付を number・date にすると、パスは4回です。1枚の請求書が2,000トークンなら、約8,000トークン分の課金になります。実際のパス数はレスポンスの usage.passes で確かめられます。文字の項目を必要なものだけに絞ることが、そのまま費用の削減になります。
画像は、縦横を32の倍数にそろえたうえで「(幅÷32)×(高さ÷32)+2」トークンとして数えられます。小さすぎる画像(約256×256px未満)は拡大されますが、大きい画像は縮小されないので、スキャンの解像度を上げすぎると費用に響きます。
入力の制限
- 文脈:65,536トークン。
stateとfieldsを合わせて 65,273 トークンに収める - 画像:PNG・JPEG・WebP を最大4枚。1枚4MiBまで
- PDF:1件4MiBまで。PDFのページ数と画像の枚数を合わせて4まで。暗号化されたPDFは拒否される
- 合計:画像と文書で8MiBまで、リクエスト全体で16MiBまで
- URLは渡せない:公式に「Remote URLs are not accepted」とあり、画像やPDFは data URL か base64 で渡す
「4ページまで」は実務で効きます。10ページの請求書の束をそのまま渡すことはできないので、ページごとか、1社の請求書ごとに分けて送る前処理が要ります。
大きすぎる入力は「切り詰め」か「拒否」か、ドキュメントが食い違っている
同じモデルページの中で、上限を超えた入力の扱いが2通りに書かれています。本文には「収まる場合は state の文章を切り詰める」とあり、パラメータの説明には「入力は切り詰めない。大きすぎるリクエストは拒否する」とあります。Hugging Face のモデルページは、レスポンスが入力の切り詰めを報告すると書いています。
2026年11月20日時点では、どちらが正しいかを公式の文書だけでは決められません。請求書の読み取りで「後半の明細が黙って落ちていた」は最も困る事故なので、大きな入力を送る前に自分で分割しておくのが確実です。
日本語の帳票について
公式ブログ・ドキュメント・Hugging Face のどこにも、日本語や多言語への対応についての記述はありません(2026年11月20日時点)。公式の例はすべて英語の請求書です。日本語の請求書に使う場合は、自社の見本で確かめてから任せる範囲を決めてください。
Clairicの確信度は「保証」ではなく「先に見る所」
Clairic のような、文章を生成せずに数値で答えるモデルの売りは、確信度が使えることです。ここは私たちが自社で測ってきたところなので、少し詳しく書きます。
私たちの実測:数値で答えるモデルの確信度は、外したときに下がった
2026年9月に、文章を書かずに選択肢と確率を返す判定モデル Jev で、日本語の問い合わせ25件の振り分けを測りました。正解したときの確信度は平均0.95前後で、外した1件は0.47でした。確信度0.6を境にすると、25件中23件を自動で処理して誤りはゼロ、人が見るのは2件で済みました。
同じ25件を、普通のLLMのJSON出力(構造化出力)でも測っています。こちらは正解したときが0.94、外したときが0.90で、差はほとんどありませんでした。返ってくる値も0.9・0.95・1.0の3種類だけで、外した3件はすべて0.90でした。LLMに「確信度も書いて」と頼むと、確信度を計算しているのではなく、確信度らしい数字を文章として生成しているだけになります。
Clairic は Jev とは別のモデルですが、確信度を文字として生成するのではなく、モデルの確率から出すという性質は同じ側にあります。だから「確信度の低い行を人が先に見る」という使い方が成り立つ見込みがあります。Jev の測り方の詳細は次の記事に書いています。
それでも、確信度で正しさは保証できない
一方で、同じ Jev が第三者のベンチマークでは確信度のずれ(較正誤差)が0.161で、比べた6モデルの中で最も悪い結果でした。自社の25件では分かれたのに、外の測定ではずれている。確信度は、条件が変われば当てにならなくなります。Cloudflare も preview の発表のときに「較正(確信度と実際の正解率が合っていること)は保証しない」「確信度を見て、自動化してよいかを判断すること」と書いていました。
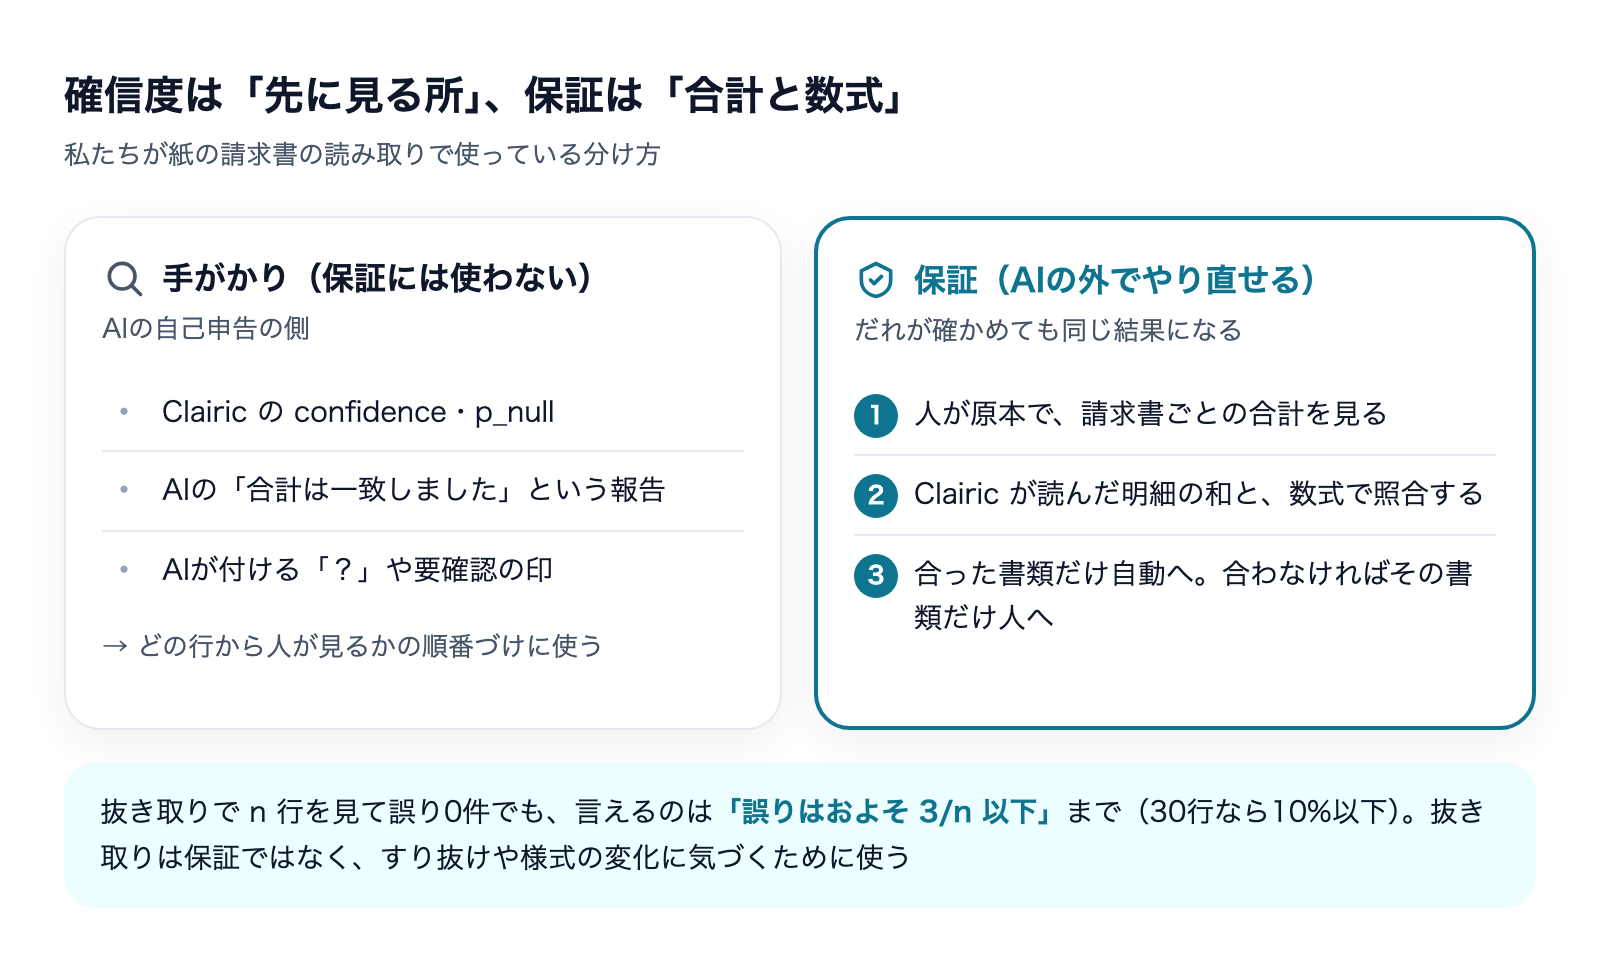
紙の請求書をAIに読ませる仕組みを作ったときにも、同じことが起きました。AIに明細を読ませ、「合計は表紙の金額と一致しました」と報告させたところ、一致したと2回答えたのに、実際には合っていない書類がありました。AIは、読めていないのに読めたと思い込むことがあります。確信度も、AIの「正確です」という報告も、AIの自己申告という点では同じ側です。
そこで私たちは、確信度を「どこから人が見るか」の順番づけに使い、保証には使わないことにしています。保証は、AIの外で、だれがやり直しても同じ結果になる方法で行います。
Clairicで請求書を読むときの組み方:5つの手順
ここからは、Clairic の返り値を使って請求書の読み取りを組むときの手順です。私たちが紙の請求書で組んだ型(AIで読み、数式で照合し、人が保証する)に、Clairic の項目を当てはめています。
- 項目を用途で絞る:支払いの確認なら、要るのは請求書ごとの合計と取引先と期日だけです。品名まで要るのは、単価の推移を見たいときです。項目を絞ると、人が確かめる量も、
textのパス数(=費用)も減ります - 金額は印字のとおりに取る:合計・税額・明細の金額には
source_onlyを付け、書類に印字された値だけを返させます。モデルに計算させると、数量の読み違いに金額が合わせて出て、検算が通ってしまうことがあるためです - 人が原本で合計を見る:請求書ごとの合計(税率ごとの合計があればそれも)を、人が原本で読みます。保証の起点はここです
- 数式でつなぐ:Clairic が返した明細の金額の和と、人が見た合計を、スプレッドシートの数式かスクリプトで照合します。合った書類だけ自動に回し、1つでも合わなければ、その書類だけ人に回します。合わなかった書類の中では
confidenceの低い行とp_nullの高い行から開き、spanで原文の位置を見ます - 抜き取りで漏れを見る:合計が合っても、同じ書類の中で打ち消し合う2つの誤りや、品名・日付の誤りは残ります。そこは抜き取りで見ます
抜き取りで言えることには限りがあります。n行を見て誤りが0件のとき、言えるのは「誤りの割合はおよそ 3/n 以下」まで(95%の確からしさ。統計で「3の規則」と呼ばれる目安)です。30行を見て0件なら10%以下、100行を見て0件でも3%以下です。全行を見ないかぎり「誤りはゼロ」とは言えません。だから保証は合計と数式で行い、抜き取りは、すり抜けた誤りや書類の様式の変化に気づくために使います。
紙の請求書をExcelのデータにする全体の設計は、次の記事にまとめています。
Clairicの速さと精度(Cloudflareの自己申告)
11月18日の公式ブログは、社内の評価セットでの結果を載せています。ブログ自身が「self-reported(自己申告)」で「おおよその目安」として見てほしいと断っている数字で、測ったのはCloudflareが自分で立てたサーバーでのHTTPの応答時間(全項目込み)です。
評価セット | 件数 | Clairic(中央値/95%点) | Clairic-flash(中央値/95%点) |
|---|---|---|---|
文字の項目 | 96 | 358ms/736ms | 155ms/328ms |
画像の項目 | 48 | 453ms/976ms | 305ms/605ms |
経費の監査 | 60 | 632ms/742ms | 393ms/512ms |
精度では、文字の項目336問のうち、preview の9Bが295問、新しいClairicが335問、Clairic-flashが328問に正解したとされています。画像の読み取りの誤りは207件から0件に減ったと書かれています。いずれも英語の評価セットで、日本からの往復の時間も含みません。私たちが Jev を日本から呼んだときは、往復の中央値が約0.5〜0.6秒でした。同じ桁の速さは期待できますが、数字は自分の環境で測ってください。
Clairicが向かない場面
- 何段もの計算:preview の発表では、多段の算術は苦手と書かれていました。11月の更新で計算用の仕組みが足されたと説明されていますが、苦手が解消したとは書かれていません。合計の検算はモデルではなく数式で行います
- 理由の説明が要る判定:返るのは値と確信度と位置で、「なぜそう読んだか」の文章は返りません。人に理由を示す必要がある場面には単独では使えません
- 長いPDFをまとめて読ませる:ページと画像を合わせて4までなので、分割が前提です
- URLを渡して読ませる:外部のURLは受け付けないので、ファイルを取ってきてbase64にする処理を自分で書きます
- 日本語の帳票を、確かめずに任せる:日本語への対応は公式に書かれていません
文章を生成せずに数値で答えるモデルは、ここ数か月で各社から出ています。OCRの読み取り結果を採点する側のモデルについては、次の記事で扱いました。Clairicは「読み取り」と「型にそろえる」を1回でやる側、こちらは別のOCRの結果を採点する側です。
Clairicについてよくある質問
preview で書いたコードは直す必要がありますか
公式ブログによると、APIの形は preview から変わっていないので、そのまま動きます。ただし、同じモデルIDの中身が9Bから27Bに変わり、料金も $0.10 から $0.24(割引期間中は $0.10)に変わります。速さと費用を優先して9Bのまま使いたい場合は、モデルIDを @cf/cloudflare/clairic-flash に変えます。
自分のサーバーで動かせますか
重みが Hugging Face で公開されていて、ライセンスは Apache-2.0 です。モデルページには、Python 3.11 以上と xgrammar を使って手元で動かす例があります。同時に送るとキューが埋まってエラーになると注意書きがあるので、まとめて流すときは順番に送る作りにします。
JSONモードのLLMと比べて何がうれしいのですか
形が壊れにくいことよりも、確信度が使えることと、出力に課金されないことです。私たちの実測では、軽量なLLMのJSON出力も25件で形は1件も壊れませんでした。差が出たのは確信度で、LLMの確信度は正解と不正解でほとんど変わりませんでした。どの行を人が見るかを決めたいなら、確率から確信度を出すモデルのほうが向いています。
まとめ
- Clairic は Workers AI の抽出モデルで、
fieldsに型を書くと、項目ごとにvalue・confidence・p_null・spanを返す - 2026年11月18日に本体が27Bに入れ替わり、9Bは Clairic-flash に。重みは Apache-2.0 で公開。ドキュメントの表記はまだ preview
- 入力だけの課金だが、
textの項目ごとにパスが増え、パスの数だけ入力が課金される - 画像とPDFのページは合わせて4まで、URLは不可。大きな入力の扱いはドキュメントが食い違っているので、自分で分割する
- 確信度は人が先に見る所を決める手がかり。保証は、人が原本で見た合計と、Clairic が読んだ明細の和を数式で照合して行う
株式会社Fyveでは、帳票の読み取りを「AIで読む・数式で照合する・人が保証する」の3つに分けて組んでいます。Clairic は、そのうちの「読む」を、確信度と位置つきで型にそろえて返してくれる部品です。まずは自社の請求書の見本を数十枚流し、確信度と実際の誤りがどこまで対応するかを測るところから始めるのが確実です。