MiniCPM-OCR Jevとは|OCRの見直しを減らす使い方

「OCRの精度は上がったのに、結局ぜんぶ人が見直している」「MiniCPM-OCR Jevという採点するモデルが出たらしいが、何をしてくれるのか分からない」——請求書や契約書の読み取りを自動化しようとして、見直しの手間で止まっている人ほど、この疑問にぶつかります。
結論から言うと、MiniCPM-OCR Jevは、OCRが読み取った結果に領域ごとに0〜1の点を付け、「どこを人が見ればよいか」を絞るための2Bの小さなモデルです。自分では文字を読み取らず、別のOCRの結果を採点します。点の高い領域は自動で通し、低い領域だけを人に回す使い方が公式に示されています。ただし公式の対応言語は英語と中国語だけで、閾値(どの点から自動で通すか)は自分の書類の見本で決める必要があります。
株式会社Fyveは、中小企業のAI導入を支援するなかで、スキャンした書類を読み取る仕組みや、AIの出力を別のAIに点検させる工程を自社で動かしてきました。この記事では、2026年10月30日に公式のGitHub・Hugging Face・導入手順の原文を読んで確かめた内容をもとに、MiniCPM-OCR Jevの仕組み・使い方2つ・閾値の決め方と、私たちが点検の工程で実際につまずいた「判定できなかったもの」の扱いまでを整理します。
MiniCPM-OCR Jevとは:OCRの結果を採点する2Bのモデル
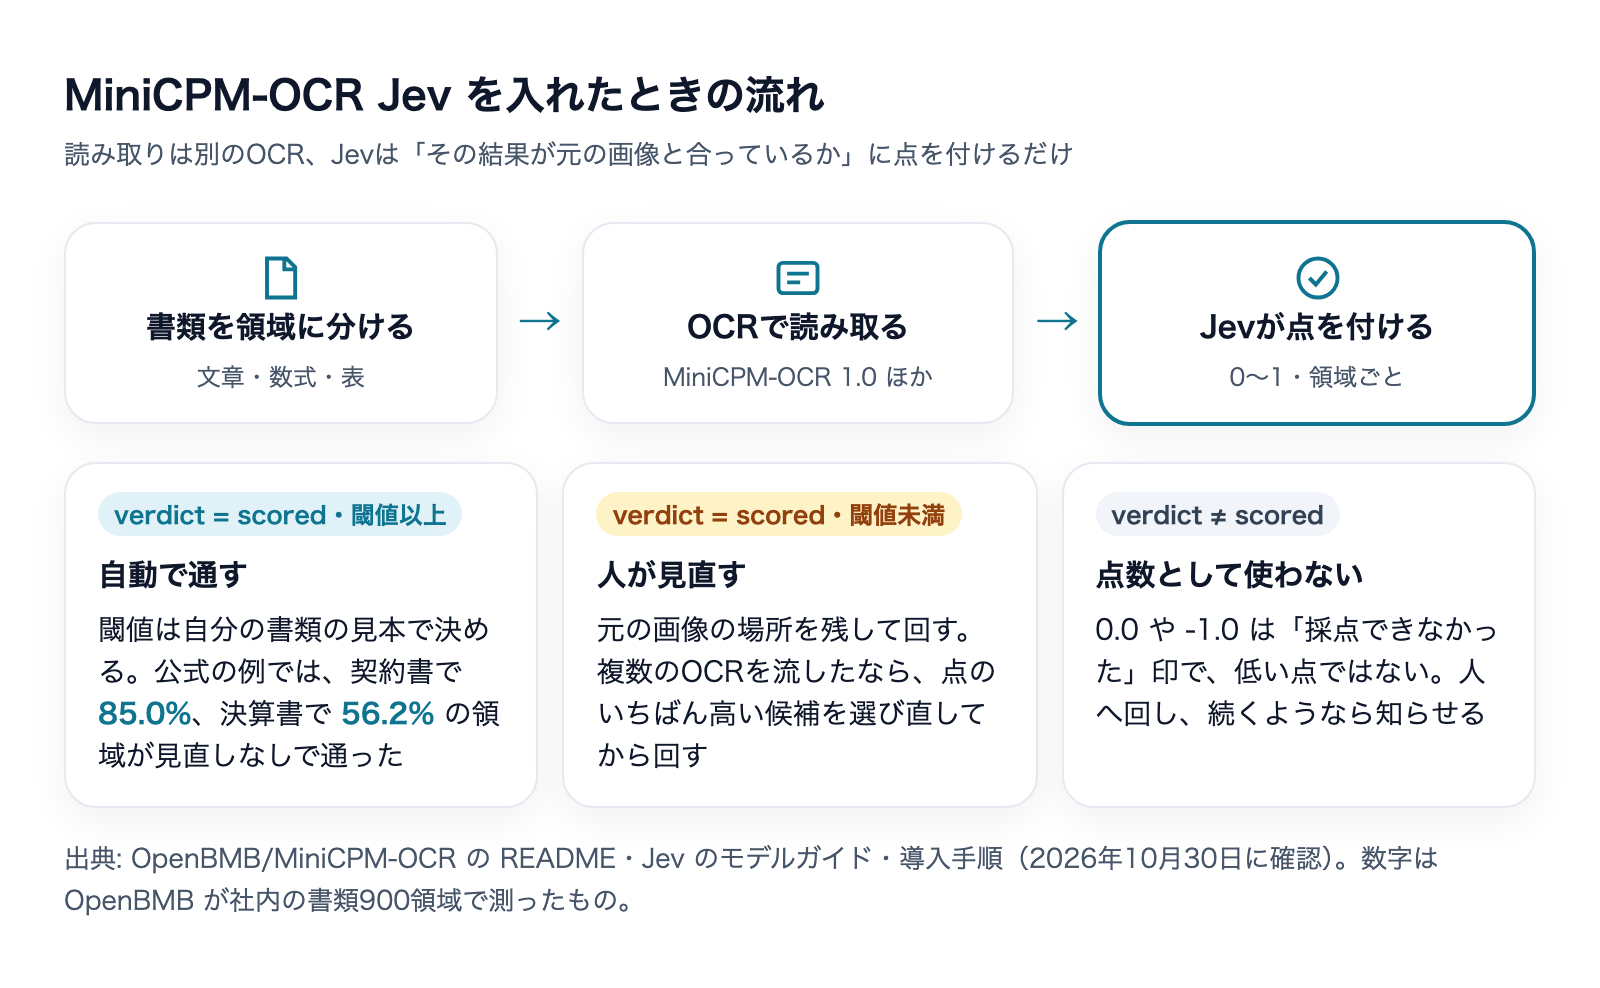
MiniCPM-OCR Jevは、OpenBMBが公開した、OCRの読み取り結果が正しいかを判定するモデルです。公式の説明は「OCR correctness decision model(OCRの正しさを判定するモデル)」です。文章・数式・表の領域を1つずつ受け取り、その読み取り結果が元の画像と合っている見込みを0〜1の点で返します。点が高いほど「正しい」とモデルが判断していることを表します。
同時に、読み取りそのものを担うMiniCPM-OCR 1.0(1.3B)も公開されました。こちらは書類やPDFをMarkdownやJSONに変換するOCRです。2つの役割ははっきり分かれています。
項目 | MiniCPM-OCR 1.0 | MiniCPM-OCR Jev |
|---|---|---|
役割 | 書類を読み取る(画像・PDF → Markdown・JSON) | 読み取った結果を採点する(0〜1の点) |
大きさ | 1.3B | 2B(Qwen3.5-2Bから学習) |
公式の対応言語 | 中国語・英語 | Hugging Faceの記載は英語・中国語 |
使える範囲 | コード・ドキュメント・モデルの重みすべてApache License 2.0 | |
公開 | GitHubのリポジトリ作成は2026年10月27日(Hugging Faceのモデル登録は10月21日・10月23日) | |
いずれも2026年10月30日に、GitHubのREADME・APIの記録とHugging Faceのモデル情報で確認した内容です。pipで入るSDK(minicpm-ocr)は同日時点で1.0.3でした。
名前に「Jev」とあるが、判定APIのJevとは別のモデル
ここは混同しやすいので先に書いておきます。2026年9月に公開された、文章を書かずに選択肢と確率だけを返す判定モデル「Jev」とは、別のモデルです。MiniCPM-OCR JevはOpenBMBがQwen3.5-2Bをもとに学習したもので、公式のガイドは「言語モデルの出力部分(lm_head)を、正しいか正しくないかの2値の分類に置き換えた」と説明しています。比較表には「JEV-35B-A3B」という別のモデルが並んでおり、同じものとして扱われてはいません。
共通しているのは、文章を生成せずに数値の判定だけを返すという性質です。判定APIのJevについては、以前に日本語の問い合わせの振り分けで実測した記事があります。
なぜOCRの見直しは減らないのか
MiniCPM-OCR Jevが解こうとしている問題は、精度そのものではありません。「どこが間違っているか分からない」ことです。
OCRの正解率が95%でも、間違っている5%がどこにあるかが分からなければ、人は100%を見直すしかありません。請求書の合計金額が1桁違っていれば支払いが狂うので、「たぶん合っている」で通すわけにはいかないからです。正解率が97%、98%と上がっても、見直す人の手間はほとんど変わりません。
私たちも同じ壁に当たっています。CPUだけで動くOCRを自社のMac miniで試したとき、日本語の印刷物はおおむね読めた一方で、合計欄のような短い行で読み違いが出ました。結論は「確信度の低い行を人が見る前提で使う」でしたが、そのOCRが返す確信度が本当に間違いと対応しているかは、別に確かめる必要がありました。
MiniCPM-OCR Jevは、この「間違いがどこにあるか」をOCRとは別のモデルに判定させる道具です。読み取りと採点を分けるので、どのOCRを使っていても後ろに付けられます。
MiniCPM-OCR Jevの仕組み:読み取った文字を描き直して、元の画像と見比べる
MiniCPM-OCR Jevは、テキストを読んで正誤を推測しているわけではありません。公式の導入手順によると、1つの候補を採点するときに次の3段を通ります。
- 事前の確認:候補の文字列の形が正しいかを確かめます。数式の領域ならLaTeXの文法を検査し、文法が壊れていればここで弾きます
- 描き直し:候補の文字列を画像に描き直します。モデルが文字の並びだけでなく、見た目のレイアウトまで「見られる」ようにするためです
- 採点:元の領域の画像・描き直した画像・候補の文字列の3つをモデルに渡し、0〜1の点を受け取ります
描き直しを挟むのがこのモデルの特徴です。その分、描き直しの環境(ブラウザやフォントの版)が変わると、点の絶対値が少しずれます。公式は「点の順位は変わらないが、小数第3位は約束しない」と書いています。Dockerイメージはこの環境を固定しているので、公開された数字と直接比べたいときはDockerを使うよう案内されています。
公式が出している数字
判定の力を測る指標として、公式はAUROC(正しい結果と間違った結果をどれだけ点で分けられるか。100に近いほどよい)を使っています。
比較 | AUROC(×100) |
|---|---|
MiniCPM-OCR Jev(2B) | 93.6 |
JEV-35B-A3B | 90.1 |
Qwen3.5-397B-A17B | 93.8 |
評価にはOpenBMBが公開しているJevOCRBenchを使っています。また、他社のOCRの結果を採点させた実験では、MiniCPM-OCR 1.0で92.7、GLM-OCRで91.9、PaddleOCR-VL-1.6で93.4、Xiaomi-OCR-0で93.1でした。読み取ったOCRが変わっても、判定の力はあまり落ちていません。
この数字を読むときに外せない前提が2つあります。1つは、JevOCRBenchがOpenBMB自身の作った評価だということ。もう1つは、他社OCRでの実験が同じ200サンプルでの結果だということです。公式のガイドも「別のOCRや新しい種類の書類で使うときは、自分のデータで別に確かめること」と書いています。
使い方1:点の高い領域は自動で通し、低い領域だけ人が見る
いちばん素直な使い方です。領域ごとに点を付け、閾値以上は自動で受け入れ、それ以外を人の見直しに回します。公式のガイドは、閾値を上げると自動で通る量が減るので、「自動で通した分の正しさ」と「人が見る量」の両方を見るよう求めています。
どれくらい見直しが減るのかは、公式がREADMEに出しています。OpenBMBが業務の書類900領域を用意し、人が1領域ずつ正誤を付けて測ったものです。
書類の種類 | 閾値 τ | 見直しなしで通せた割合 | 全部を通した場合の正しさ |
|---|---|---|---|
契約書 | 0.984 | 85.0% | 96.6% |
決算書 | 0.995 | 56.2% | 82.6% |
複雑な書類 | 0.994 | 35.1% | 75.0% |
「見直しなしで通せた割合」は、通した領域の正しさがほぼ100%のまま保てた範囲の上限です。契約書なら85%の領域を人が見ずに済み、残り15%だけを見ればよい計算になります。一方、表や数式が混ざる複雑な書類では35%にとどまります。
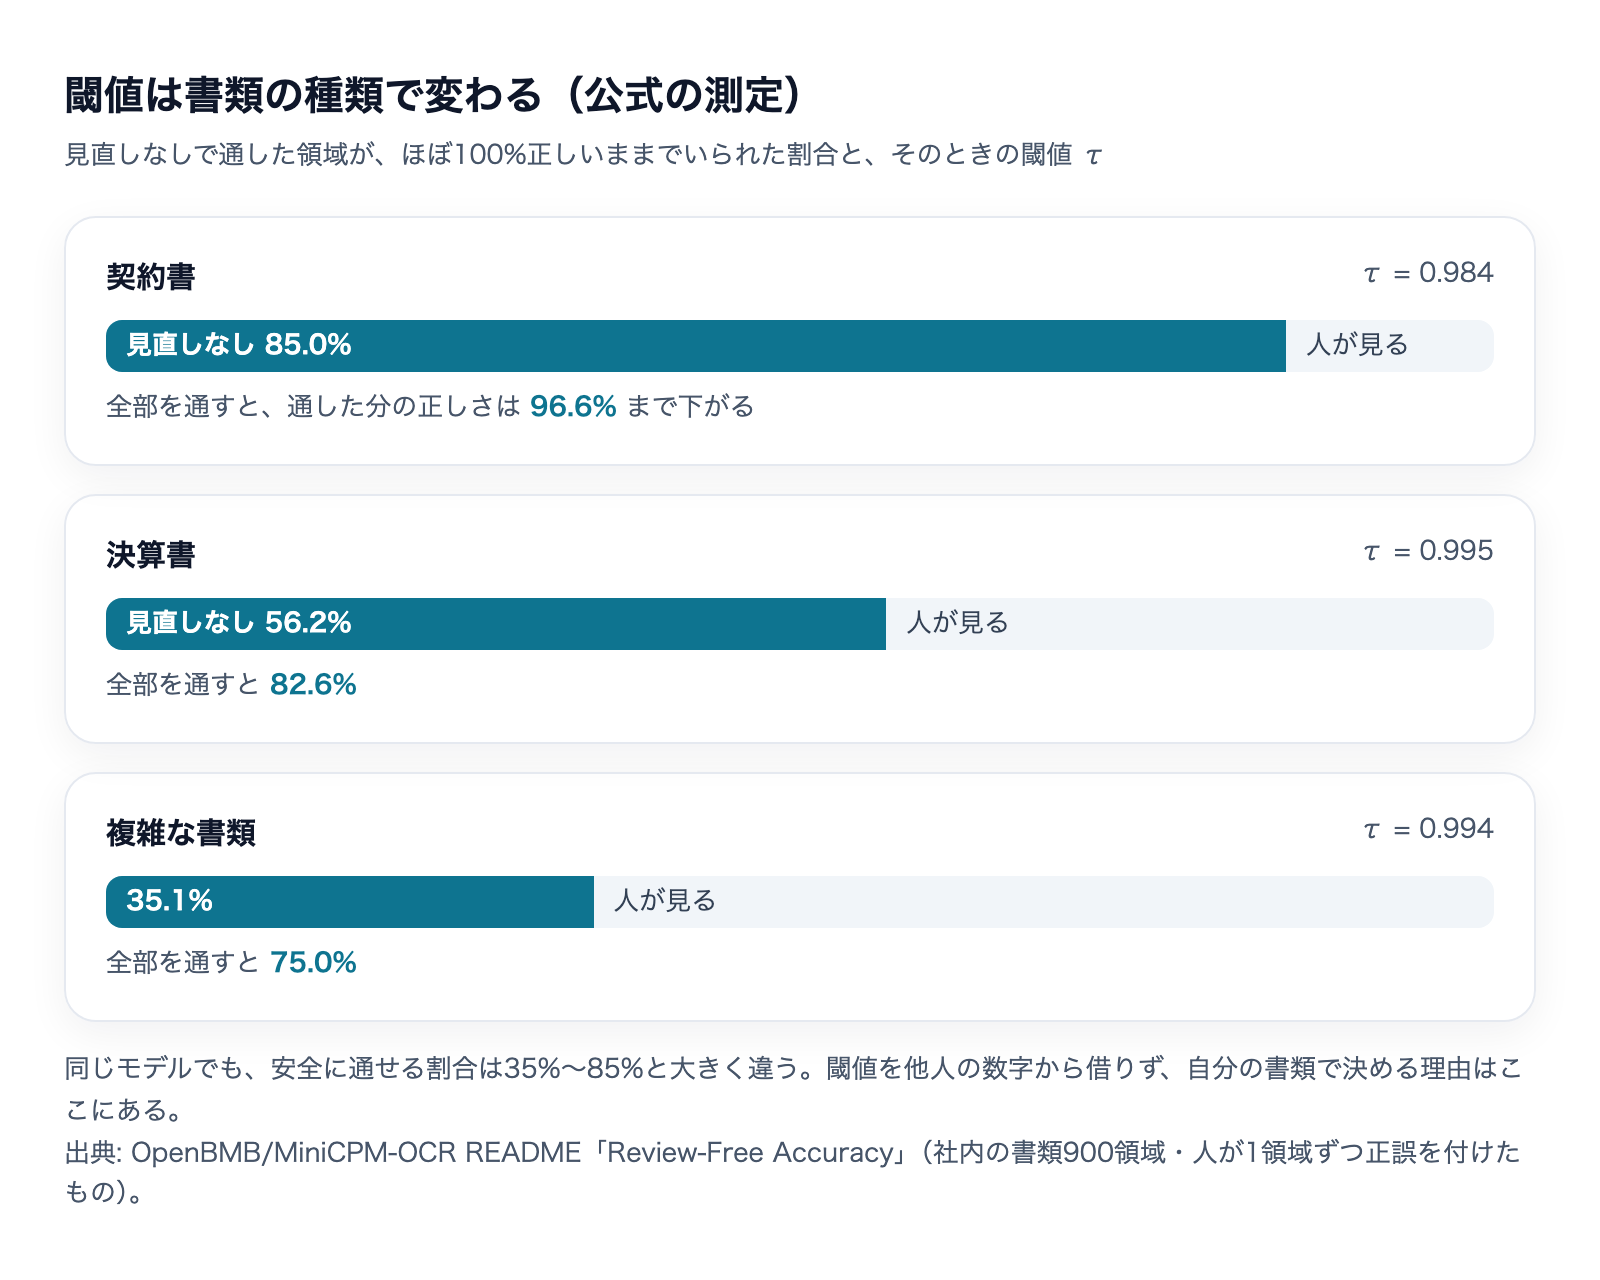
ここから分かるのは、同じモデルでも安全に通せる割合が書類の種類で2倍以上違うことです。決算書の閾値0.995を契約書に当てれば通せる分を取りこぼし、契約書の0.984を決算書に当てれば間違いを通してしまいます。公式がREADMEに「実際の用途の小さな束で確かめてから閾値を決めること」と一文で書いているのは、このためです。
使い方2:複数のOCRを流し、領域ごとに点の高い結果を選ぶ
もう1つの使い方は、同じ書類を複数のOCRで読み、領域ごとに点のいちばん高い候補を選んでつなぎ直すものです。OCRによって得意な領域が違うので、表はAのOCR、手書きはBのOCR、という選び方を自動でできます。
公式の実験では、OmniDocBench v1.6の書類で、各OCRの結果のうち点の低い領域を他の2つのOCRの候補から選び直したところ、総合点がMiniCPM-OCR 1.0で+0.18、PaddleOCR-VL 1.6で+0.25、Xiaomi OCRで+0.02上がりました。もともと強いOCRほど伸びしろは小さくなります。
この使い方には条件があります。
- 同じ切り分けを使う:比べる候補は、同じ領域の画像と同じ範囲の文字列でなければなりません。OCRごとに領域の切り方が違うと比べられないので、レイアウトの切り分けは1つに揃えます
- 候補の外は選べない:MiniCPM-OCR Jevは今ある候補から選ぶだけです。候補が全部間違っていれば、正しい結果は出てきません。全部が閾値を下回った領域は、人の見直しに回します
- OCRを回す回数が増える:3つのOCRを流せば、読み取りの計算も3倍かかります。見直しの手間と計算の費用のどちらが重いかで判断します
API経由では、1つの候補の採点(score)、1領域の候補から選ぶ(score_best)、複数の領域をまとめて選ぶ(score_best_batch)の3つが用意されています。
閾値の決め方:自分の書類で見本を作り、別の見本で確かめる
公式のガイドは、AUROCが高くても「自動で通した分の正しさ」が直接決まるわけではないとしたうえで、閾値の決め方を3段で示しています。
- 見本を集めて正誤を付ける:実際に扱う書類の種類と、実際に起きるOCRの間違いを含む見本を集め、領域ごとに候補が正しいか間違っているかを人が付けます
- 閾値ごとに2つの数字を測る:見本にMiniCPM-OCR Jevで点を付け、いくつかの閾値で「自動で通る率」と「通った分の正しさ」を測ります
- 許せる間違いの量で決め、別の見本で確かめる:業務が許せる間違いの水準で閾値を選び、決めるのに使っていない見本で確かめ直します。OCRを替えたときや書類の傾向が変わったときは、もう一度やり直します
点を「正しい確率」として読みたい場合は、点の帯ごとに実際の正答率が合っているかも確かめるよう書かれています。公式は「今のAUROCの結果から、どこでも使える既定の閾値は決まらない」と明記しています。
中小企業の請求書処理で考えると、最初の見本は数十枚でも始められます。ただ、金額欄・日付欄・品名欄のように間違えたときの重さが違う領域は、分けて閾値を持つほうが安全です。合計金額は厳しく、備考欄はゆるく、という具合です。これは公式が書いていることではなく、私たちがOCRの精度を項目単位で見てきた経験からの提案です。
いちばん気をつける所:「採点できなかった」を低い点として扱わない
導入手順のなかで、公式が何度も繰り返している注意があります。点を使う前に、必ずverdictという項目を見ることです。
採点の結果には、点(prob_yes)と一緒にverdictが返ります。verdictがscoredのときだけが、モデルが実際に採点した点です。事前の確認・描き直し・採点のどこかで失敗した場合も、点の欄には0.0や-1.0という固定の値が入って返ってきます。これは「間違っている」という判定ではなく、「採点できなかった」という印です。
たとえば画像のbase64の頭にdata:image/png;base64,を付けたまま送ると、verdictはencode_errorになります。領域の種類(category)を取り違えた場合は、エラーにならずに点だけが歪むと公式は書いています。数式の領域をtextとして送ると、LaTeXがそのまま文字として描かれ、正しい読み取りでも低い点が付きます。
私たちの点検の工程で起きたこと
この注意は、OCRに限らずAIに検品させる工程すべてに当てはまります。私たちも同じ所でつまずきました。
私たちは記事を公開する前に、書いたAIとは別のAIに点検させる工程を自動で動かしています。点検の結果は「合格」「不合格」「判定できなかった」の3つで、3つめは不合格と同じく公開せずに下書きへ戻す設計にしていました。疑わしいものは出さない、という安全側の倒し方です。
ある日、点検役のAIを呼び出す認証が切れました。それ以降、点検は毎回「判定できなかった」になり、記事はすべて下書きに戻り続けました。公開の事故は1件も起きませんでした。ただ、1週間あまり記事が1本も出ていないことに、原因を調べるまで気づけませんでした。安全側に倒す設計は正しく働いていたのに、「判定できない状態が続いている」ことを知らせる仕組みが無かったからです。
MiniCPM-OCR Jevを業務に組み込むときも、同じ3つに分けて扱うことをすすめます。
- 判定の結果を3つに分ける:
scoredで閾値以上/scoredで閾値未満/scored以外。3つめを点数の列に混ぜない - 3つめは安全な側に倒す:採点できなかった領域は、自動で通さず人の見直しに回す
- 3つめが続いたら知らせる:
scored以外の割合が普段より増えたら、通知が来るようにしておく。ここが抜けると、すべてが人の見直しに回っているのに誰も気づかない、という止まり方をします
3つめを低い点として扱うと、壊れた入力がそのまま「人が見るべき間違い」として積み上がります。見直す人は、OCRの間違いではなく、送り方の間違いを延々と確かめることになります。
MiniCPM-OCR Jevの入れ方:クラウドAPI・Docker・SDKの3通り
使い始める方法は3通りあります。いずれも公式のREADMEと導入手順に書かれている内容です。
方法 | 向く場面 | 条件 |
|---|---|---|
クラウドAPI | まず手元の書類で点の付き方を見たい | READMEからModelBestのプラットフォームの無料APIが案内されている。画像を外部に送ることになる |
Dockerイメージ | 公開された数字と同じ条件で採点したい | Linux+NVIDIAのGPU(VRAM 12GB以上・ドライバ535以上) |
SDK | Dockerを使わない・Macで動かす・使う推論エンジンを選びたい | Python 3.10以上。vLLM・SGLang・llama.cpp・Ollamaから選ぶ |
Dockerで動かした場合、採点の依頼は次のような形になります(公式の導入手順の例)。
curl -s http://127.0.0.1:8030/v1/rm/score -H 'Content-Type: application/json' -d '{
  "input_form": "ternary",
  "items": [
    {"case_id": "blk-001", "image": "<base64>",
     "ocr_text": "採点したいOCRの結果", "category": "text"}
  ]
}'返ってくる結果のverdictがscoredであることを確かめてから、prob_yesを点として使います。公式のリポジトリには文章・数式・表の3つの見本と参考の点が入っていて、自分の環境で採点した点が参考の点と0.02以内なら正常に入っている、という確かめ方ができます。
Macで動かす場合の制約
公式のエージェント向け手順書によると、Apple SiliconのMacで使えるのはllama.cppとOllamaの2つだけです。vLLMとSGLangはCUDAが前提なので起動しません。メモリは統合メモリで16GB以上が目安とされています。
もう1つ大きな制約があります。Macでは「描き直し」を含むサービスを動かさないよう明記されています。描き直しの環境を固定する手順がLinuxのパッケージ管理(apt)に頼っていて、Macでは同じフォントの環境を作れないためです。Macで動かす場合は、描き直した画像を自分で用意して採点だけをさせるか、Linux+GPUの環境でDockerを使うことになります。
なお、READMEには、コーディングエージェントに手順書を読ませて導入させる方法も載っています。「この手順書を読んで実行して」とURLを渡す形です。環境の確認から自己検査まで手順書に書かれているので、手で1つずつ打つより取りこぼしが減ります。
日本語の書類で使えるか
ここは正直に書きます。2026年10月30日時点で、公式の対応言語はMiniCPM-OCR 1.0が中国語と英語、MiniCPM-OCR JevもHugging Faceの記載は英語と中国語だけです。日本語の書類での精度は、公式には示されていません。私たちもまだ日本語の書類では試していません。
ただ、MiniCPM-OCR Jevは読み取りをせず、別のOCRの結果を採点するモデルです。日本語に強いOCRで読み取った結果を採点させる組み合わせは考えられます。その場合も、描き直しに日本語のフォントが正しく使われるか、点が日本語の間違いと対応するかは、前の節の手順どおり自分の見本で確かめるしかありません。
確かめる前に本番の書類を流すのは避けてください。とくにクラウドAPIは画像を外部に送るので、取引先の名前や金額が入った書類は、社内の取り決めを確認してから扱う必要があります。
向いている人・向いていない人
ここまでの内容から、MiniCPM-OCR Jevを試す価値がある場面をまとめます。
- 向いている:OCRの読み取り自体はおおむねできていて、見直しの手間で止まっている。書類の種類がある程度決まっていて、見本を数十件用意できる。英語や中国語の書類が多い
- 向いている:すでに複数のOCRを使っていて、どの結果を採用するかを人が決めている
- まだ早い:日本語の書類だけを扱い、自分で見本を作って確かめる時間が取れない
- 向いていない:そもそもOCRの読み取りがほとんどできていない。MiniCPM-OCR Jevは候補を採点するだけなので、候補が悪ければ救えません
よくある質問
MiniCPM-OCR Jevは無料で使えますか
モデルの重み・コード・ドキュメントはすべてApache License 2.0で公開されており、商用でも使えます。クラウドAPIも無料のAPIとして案内されていますが、回数などの条件は公式のAPIドキュメントで確認してください。
MiniCPM-OCR Jevだけで書類を読み取れますか
読み取れません。MiniCPM-OCR Jevは、別のOCRが読み取った結果に点を付けるモデルです。読み取りにはMiniCPM-OCR 1.0か、ほかのOCRを使います。
点が0.0で返ってきたのは、読み取りが間違っているということですか
そうとは限りません。0.0と-1.0は、採点に失敗したときの固定の値です。同じ項目のverdictを見て、scoredでなければ点数として扱わず、失敗の理由を確かめます。
閾値はいくつにすればよいですか
決まった値はありません。公式の測定でも、契約書は0.984、決算書は0.995と、書類の種類で違いました。自分の書類で正誤を付けた見本を作り、自動で通る率と通った分の正しさを測って決めます。
GPUが無くても動きますか
公式の手順はGPUを前提にしています。LinuxならNVIDIAのGPU、MacならApple Silicon(統合メモリ16GB以上が目安)でllama.cppかOllamaを使います。GPUが無い環境では、まずクラウドAPIで点の付き方を見るのが近道です。
まとめ
MiniCPM-OCR Jevは、OCRの結果に領域ごとの点を付けて、人が見直す所を絞るためのモデルです。読み取りはせず、どのOCRの後ろにも付けられます。公式の測定では、契約書で85%、決算書で56%の領域を見直しなしで通せていますが、その割合も閾値も書類の種類で大きく変わります。
使うときに押さえることは3つです。閾値は自分の書類の見本で決め、別の見本で確かめる。verdictがscoredでない結果を低い点として扱わない。採点できない状態が続いたら気づける仕組みを先に作る。日本語の書類は、公式の対応言語に入っていないので、試してから判断してください。
株式会社Fyveは、書類の読み取りやAIの出力の点検を業務に組み込む設計を、自社で動かしながら検証しています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。