Claude Sonnet 5.5のeffort設定|Claude Codeはmedium、APIはhigh

「Claude Sonnet 5.5のeffortは何にしておけばいいのか」「APIで試したときと、Claude Codeで使ったときで考える深さが違う気がする」——Sonnet 5.5に切り替えた直後、effort(思考の深さの設定)でこうした疑問を持つ方は多いはずです。
結論から言うと、Sonnet 5.5のeffortは使う場所によって既定値が違います。Claude CodeとClaudeのアプリでは medium、API(Claude Platform)では high です。まずは既定のまま使い、足りない作業だけ上げる。Claude Codeでは、ユーザー設定の一番上の階層に書いた effortLevel がSonnet 5.5に効かない点に注意する。この2つを押さえれば迷いません。
株式会社Fyveは、Claude Codeを社内業務と受託開発の両方で毎日使っています。本記事では、Anthropicの公式発表・ドキュメントに書かれていることと、私たちの手元での実測を分けて、Sonnet 5.5のeffortの選び方と設定方法を説明します。情報は2026年9月29日時点のものです。
Sonnet 5.5そのものの全体像は、次の記事にまとめています。
Sonnet 5.5のeffortとは|5段階と、場所で違う既定値
effortは、モデルが答えを出す前にどれだけ手間をかけて考えるかを決める設定です。Sonnet 5.5では5段階あり、浅い順に low・medium・high・xhigh・max です。低いほど速く、使うトークン(処理量の単位で、料金の計算にも使われるもの)が少なくなります。高いほど長く考えます。
既定値:Claude Codeとアプリはmedium、APIはhigh
Anthropicの発表ページは「Claude Codeと私たちのアプリでは既定のeffortをMediumに、Claude PlatformではHighに設定している」と書いています。モデル概要とClaude Codeのドキュメントも同じです。
使う場所 | 既定のeffort | 補足 |
|---|---|---|
Claude Code |
| 既定のモデルはOpus 5.5のまま。Sonnet 5.5へは自分で切り替える |
Claudeのアプリ(claude.aiのWeb・iOS・Android) |
| 無料プランでもSonnet 5.5を使える |
API(Claude Platform) |
| いちばん軽い思考の設定 |
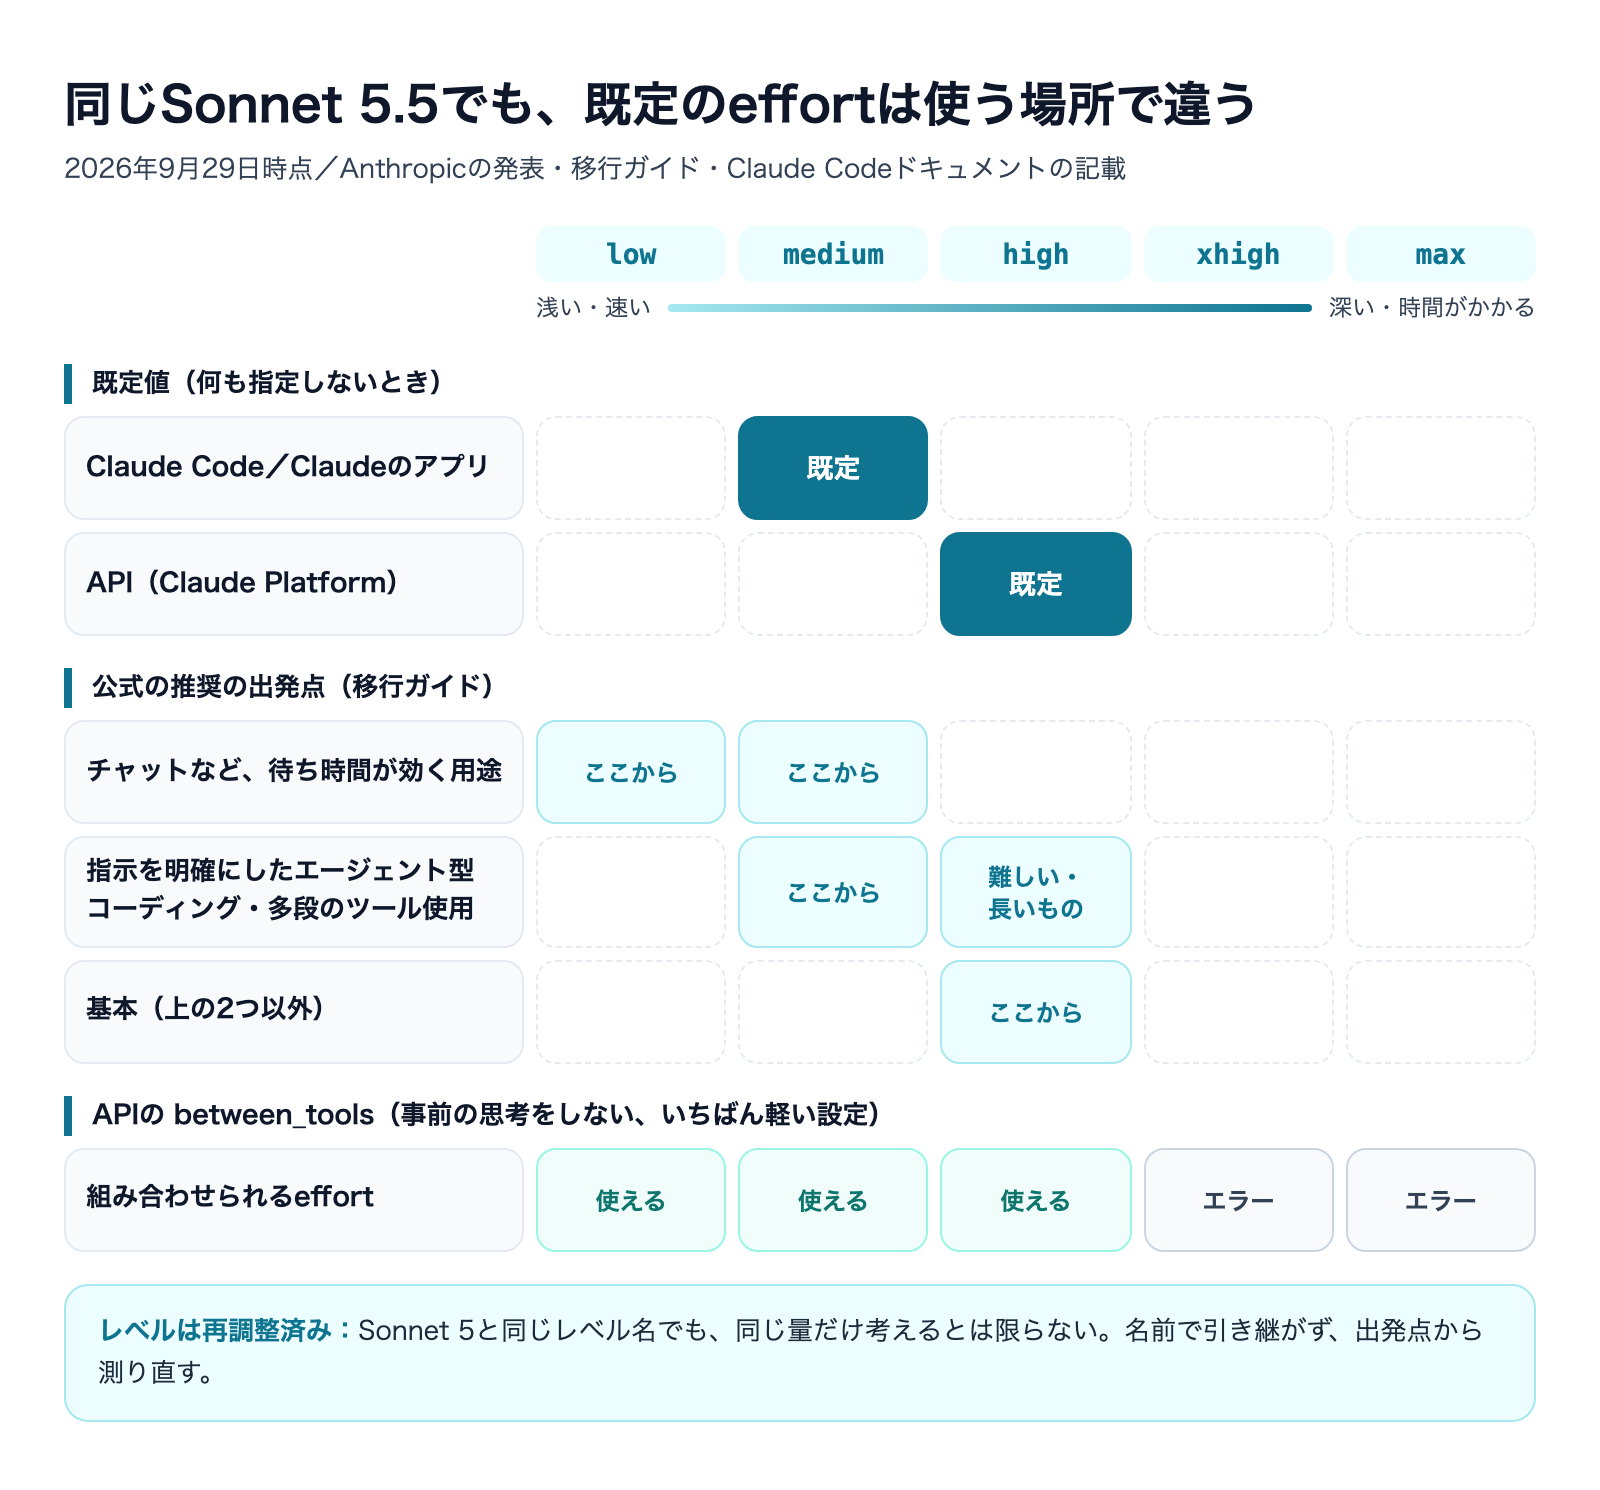
APIで組んだ社内ツールとClaude Codeの応答を比べて「深さが違う」と感じたら、モデルではなく既定のeffortの差かもしれません。比べるときは、両方でeffortを同じ値に明示してください。また、APIの仕組みは何も指定しなければhighで動くので、チャットのような用途で遅いと感じたら、まずeffortを確認します。
Opus 5.5との違い|APIに between_tools という軽い設定がある
Sonnet 5.5の思考(thinking)は「Adaptive」で既定でオンです。作業の難しさに合わせて、モデル自身が思考の量を調整します。Opus 5.5は思考が常時オンで切れませんが、Sonnet 5.5のAPIには、事前の思考をしない between_tools という軽い設定があります(disabled でオフにする指定はエラー)。Opus 5.5のeffortは、次の記事で解説しています。
Sonnet 5と同じレベルでも、同じ思考量にはならない
公式の移行ガイドは、Sonnet 5.5ではeffortの各レベルが再調整されたため、同じレベル名でもSonnet 5と同じ量だけ考えるとは限らないと説明し、effortを測り直すよう勧めています。「Sonnet 5ではhighでちょうどよかったから、Sonnet 5.5もhigh」と名前だけで引き継がず、出発点から選び直すのが安全です。
公式の推奨の出発点
移行ガイドが示している出発点は、次の3つです。
用途 | 最初に試すeffort |
|---|---|
基本(下の2つに当てはまらないもの) |
|
指示を明確にしたエージェント型のコーディング、ツールを何段も使う作業 |
|
チャットなど、待ち時間が使い心地に効く用途 |
|
Claude Codeがmedium、APIがhighという既定は、この出発点とよく合っています。Claude Codeの仕事は、明確な指示のもとでファイル操作やコマンド実行を重ねるものが中心だからです。
公式の数字から読む|effortは上げるほど良いわけではない
Anthropicの発表には、effortごとの成績と1件あたりのコストの比較が載っています(Anthropic自身の発表値で、第三者の再現ではありません)。effortの選び方に関係するものは次のとおりです。
ベンチマーク(何を測るか) | effort | 公式の主張 |
|---|---|---|
Terminal-Bench 4.0(ターミナル上のエージェント型コーディング) | Medium(アプリの既定) | Sonnet 5の最高スコアを、1件あたり10分の1未満のコストで大きく上回る |
CursorBench 4.0(あいまいな複数ファイルの課題) | Low | Sonnet 5の最高スコアを、1件あたり10分の1未満のコストで上回る |
FrontierCode 1.1(コード変更がそのまま取り込めるか) | High(APIの既定) | High同士でSonnet 5より10ポイント高く、1件あたり約15分の1のコスト |
発表の本文はこれらをまとめて、「いくつかのベンチマークで、LowかMediumのSonnet 5.5が、Sonnet 5の最高スコアを1件あたり約10分の1のコストで上回る」と書いています。公式の数字の上では、低めのeffortでも十分な場面があるということです。
公式は、高い設定ではOpus 5.5と同程度のコストで同程度の性能になりうる、とも説明しています。effortを上げ切るなら、Opus 5.5との費用差は縮むということです(使い分けはClaude Sonnet 5.5とOpus 5.5の使い分け)。
FrontierCodeでは、MaxがXhighより低かった
effortを上げすぎたときの例も、発表の脚注に載っています。FrontierCodeで、Sonnet 5.5はXhighで52.1%、Maxで46.2%と、最も高い設定のほうが点が低くなりました。
公式の説明では、MaxではClaude Codeのコードレビュー機能(多数のサブエージェントに作業を分担させる機能)を使うことが増え、時間切れや課題の範囲外の編集で減点されました。FrontierCodeは、質の良い変更でも範囲外なら減点する試験です。1つの試験での話ですが、「頼んだ範囲だけ直してほしい」作業にmaxを当てると、作業を広げすぎることがあると読めます。各ベンチマークの読み方はClaude Sonnet 5.5のベンチマーク結果と、その読み方で解説しています。
手元の実測|この課題ではmediumとhighの差はほぼ出なかった
Claude Codeの既定のmediumとAPIの既定のhighの差を、2026年9月29日に手元で確かめました。Claude Code v2.1.284(Maxプランの認証)で、claude -p --model claude-sonnet-5-5 --effort medium のようにeffortを明示し、同じ課題を対話なしで投げています。
課題は「日本の郵便番号("123-4567"/"1234567"/全角数字/前後の空白を許容)を "123-4567" に正規化するPython関数を1つ。不正なら ValueError。doctest 5個つき」。モデル自身が書いたdoctest(コード内の小さなテスト)を実行して合否を見ました。各条件3回の中央値です。
条件 | 所要時間(中央値/3回の幅) | 出力トークン(中央値/3回の幅) | 自分で書いたdoctest | 費用(API単価換算) |
|---|---|---|---|---|
Sonnet 5.5(medium=Claude Codeの既定) | 8.5秒(8.2〜9.0) | 439(415〜442) | 3/3合格 | 約$0.020 |
Sonnet 5.5(high) | 9.5秒(8.9〜9.6) | 505(406〜523) | 2/3合格 | 約$0.020 |
参考:Sonnet 5(high) | 8.9秒(8.8〜10.2) | 408(395〜412) | 3/3合格 | 約$0.022 |
mediumからhighに上げると、所要時間の中央値は8.5秒から9.5秒に、出力トークンは439から505に増えました。ただ、時間もトークンも3回の幅が重なっており、費用はどちらも約$0.020です。この課題では、差と呼べるほどの開きは出ませんでした。費用はClaude Codeが表示するAPI単価換算で、実際の請求額ではありません(キャッシュ書き込みで高く出る1回目を除いた値)。
highでも1回つまずいた
effortを明示する前の計測(後述)も含めて、Sonnet 5.5を計12回(medium 6回・high 6回)動かしたところ、2回、自分で書いたテストに自分のコードが通りませんでした。mediumで1回、highで1回で、2回とも同じ箇所です。テストには全角のマイナス記号「−」を書いたのに、コードの側でその記号を変換していませんでした。
highに上げても同じ間違いが起きたので、この課題に限っていえば、effortを上げれば防げるものではありませんでした。効くのは確認の手順です。書かせて終わりにせず、テストの実行まで頼んでください。Claude Codeならこう頼めば、その場で走らせて直させられます。
「この関数を書いたら、doctestを実際に実行して、全部通るまで直して。最後に実行結果も見せて」
課題は1種類の小さなもので、各条件3回です。品質が低いと言える材料ではなく、effortの差が効くのはもっと長く難しい作業のはずなので、自分の仕事で確かめてください。
effortの選び方の目安
公式の出発点と上の結果を踏まえた、私たちの目安です。軸は「その作業で、考え落としがどれだけ高くつくか」です。
effort | 向いている作業の目安 | 判断のポイント |
|---|---|---|
| 答えが1つに決まる定型作業、大量に回す単純処理、待ち時間を短くしたいチャット | 間違えてもすぐ気づけて直せる作業 |
| 指示がはっきりした実装や修正、普段の調べもの、文書のたたき台 | まずここから |
| 複数ファイルにまたがる改修、原因の分かりにくい不具合の調査 | mediumで足りないと感じた作業だけ上げる |
| 設計の判断を伴う作業、長く任せきりにする作業 | やり直しの手間が大きい作業に限る |
| 何度か試しても解けなかった難所 | 常用しない。足りなければOpus 5.5を検討 |
この線引きに公式の数値の根拠はありません。公式も、持続的な判断が要る複雑な仕事ではOpus 5.5がはっきり強いとしています。maxでも足りない作業は、モデルを替えるのが素直です。
Claude Codeでのeffortの設定方法
前提として、Sonnet 5.5にはClaude Code v2.1.284以降が必要で、既定のモデルはOpus 5.5のままです。Sonnet 5.5への切り替え手順は、次の記事にまとめています。
切り替えたあと、effortを指定する方法は公式ドキュメントによると次のとおりです。
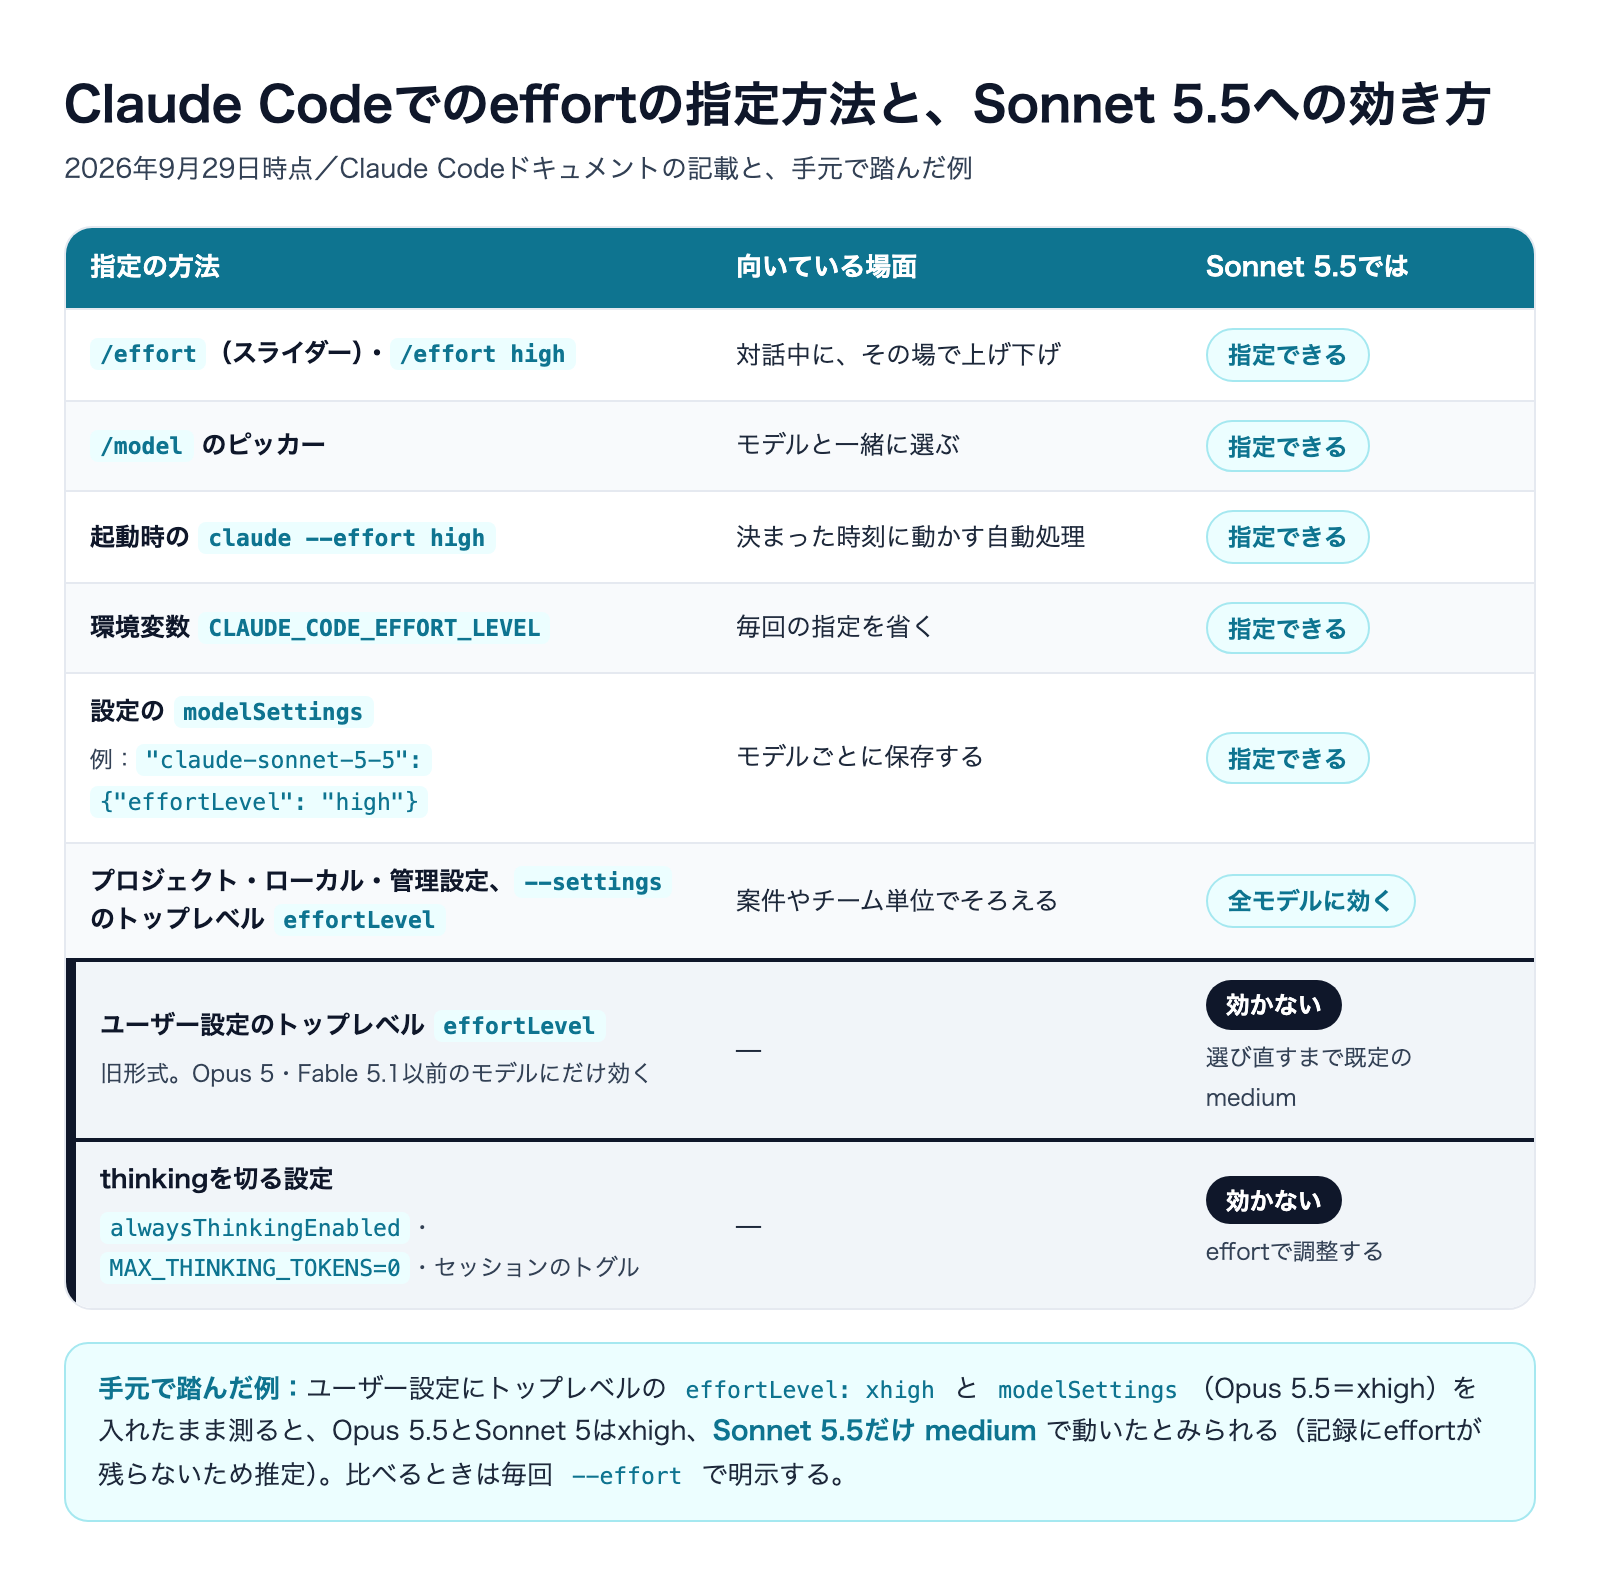
/effort:対話画面で打つとスライダーが開き、段階を選べる。/effort highのように段階名を付ければ直接指定できる/modelのピッカー:モデルを選ぶ画面で、effortも選べるclaude --effort high:起動するときに指定する- 環境変数
CLAUDE_CODE_EFFORT_LEVEL:シェルの設定に書いておけば、毎回指定しなくて済む - 設定ファイルの
modelSettings:モデルごとにeffortを保存できる
対話しながらなら /effort が手軽です。決まった時刻に動かす自動処理では、起動コマンドに --effort を書くのが確実です。私たちも自動処理ではモデル名を必ず書く運用にしています。Sonnet 5.5は場所によって既定のeffortが違うので、effortも書いておくのが安全です。モデルごとに決めたい場合は、modelSettings に次のように書きます。
"modelSettings": {
  "claude-sonnet-5-5": { "effortLevel": "high" }
}
自分で書き換えるのが不安なら、Claude Codeに「ユーザー設定の modelSettings で、claude-sonnet-5-5 の effortLevel を high にして。書き換える箇所を先に見せて」と頼めば十分です。
落とし穴:トップレベルの effortLevel はSonnet 5.5に効かない
ユーザー設定(自分の環境全体に効く設定ファイル)の一番上の階層に effortLevel を書いている場合、その指定はSonnet 5.5には効きません。
公式ドキュメントによると、この書き方は旧形式で、Opus 5・Fable 5.1以前のモデルにだけ効き続けます。Sonnet 5.5は、/effort か /model のピッカーで選ぶまで既定のmediumで動きます。なお、プロジェクト設定・ローカル設定・管理設定・--settings で渡した設定のトップレベル effortLevel は、全モデルに効きます。
「前からhighにしてあるから大丈夫」と思っている人ほど気づきにくい変更です。ユーザー設定でeffortを決めていた方は、/effort で選び直すか、modelSettings の側で指定し直してください。
手元で実際に踏んだ例
この落とし穴は、私たち自身が計測で踏みました。effortを明示せずに動かした1回目の計測で、ユーザー設定に modelSettings(Opus 5.5をxhigh)とトップレベルの effortLevel: xhigh の両方が入っていたのです(前の節の表は、その後の測り直し)。
その結果、Opus 5.5は modelSettings のxhigh、Sonnet 5はトップレベルのxhigh(旧モデルには効く)で動いた一方、Sonnet 5.5だけはトップレベルの指定が効かず、既定のmediumで動いたとみられます。出力の記録にeffortは残らないため推定ですが、この落とし穴そのものです。モデルごとに違う深さで動いていたため、effortを明示して測り直しました。比べるときや自動処理では、effortを毎回明示するのが確実です。
thinkingを切る設定も効かない
セッション中の思考のトグル、設定の alwaysThinkingEnabled、環境変数 MAX_THINKING_TOKENS=0 といった「思考を切る」設定も、Sonnet 5.5には効きません。速さを優先したいときは、effortを下げて調整します。
APIでのeffortと between_tools
APIでは、何も指定しなければeffortはhighです。チャットのように待ち時間が効く用途では、公式の出発点どおりmediumかlowを明示して試してください。
Sonnet 5までthinkingを切って(disabled)使っていた方は注意が必要です。Sonnet 5.5では disabled はエラー(400)になります。代わりに使うのが thinking: {"type": "between_tools"} で、事前の思考をしない、いちばん軽い設定です。ただし、effortが low・medium・high のときだけ受け付けられ、xhigh・max と組み合わせるとエラーになります。
コードを直すのが不安なら、Claude Codeに任せるのが早道です。移行ガイドによると、Claude Codeで /claude-api migrate this project to claude-sonnet-5-5 を実行すると、対象範囲を確認してから編集し、手で確認すべき項目のチェックリストも出します。個別に頼むなら「thinkingをdisabledにしている箇所をbetween_toolsに置き換えて。effortがxhighかmaxなら教えて」で足ります。エラー文と対処は次の記事にまとめています。
まとめ|既定は場所で違う。まず既定のまま、足りない作業だけ上げる
- effortは
low〜maxの5段階。既定はClaude Codeとアプリがmedium、APIがhigh - レベルは再調整され、Sonnet 5と同じ名前でも同じ思考量にはならない。公式の出発点は基本high、エージェント型のコーディングはmedium、チャットはmediumかlow
- 公式はLow・MediumでSonnet 5の最高スコアを約10分の1のコストで上回るとする一方、FrontierCodeではMaxがXhighより低かった
- 手元の小さな課題では、mediumとhighの差はほぼ出ず、highでも1回つまずいた。テストの実行まで頼む
- Claude Codeでは、ユーザー設定のトップレベル
effortLevelがSonnet 5.5に効かない。/effortかmodelSettingsで指定し直す - APIで最も軽いのは
between_tools。xhigh・maxとは組み合わせられない
株式会社Fyveでは、Claude Codeを業務に組み込むときのモデルとeffortの選び方も含めて支援しています。新しいモデルが出るたびに「その設定は本当に効いているか」を確かめることが、品質のぶれを防ぐ近道です。
Sonnet 5.5を、Sonnet 5・Opus 5.5と実務で比べてみた。
Opus 5.5の半額で、同じ仕事はどこまで足りるか。同じ5つの仕事で測りました(全31ページ)
Sonnet 5.5は単価$2/$10で、Opus 5.5の半額です。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを、Sonnet 5.5・Sonnet 5・Opus 5.5に同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は3モデルとも全問正解。差が出たのは、費用と作り込みと、細部の丁寧さでした。
- Opus 5.5 と同じ水準の作り込みを、Sonnet 5.5 がどれだけ安く終えたか
- Sonnet 5 から乗り換える意味はあるか——仕事別の早見表と判断フローつき
- 5つの仕事 × 3モデル=15本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを3つ並べて比較(LP・スライド・回せる3D)
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。