Claude Sonnet 5.5のベンチマーク結果と、その読み方

「Claude Sonnet 5.5のベンチマークで、Terminal-BenchがOpus 5.5を上回ったらしい」「Sonnet 5の10.3%から70.6%に跳ねたと聞いたけれど、本当にそこまで変わったのか」——発表の表を眺めても、その数字を自分の仕事の判断にどう使えばよいのか分からず、手が止まる方は多いはずです。
結論から言うと、Claude Sonnet 5.5は、Anthropicが発表した8項目すべてでSonnet 5を大きく上回り、Opus 5.5には多くの項目で数ポイント差まで近づきました。ただし8項目のうち7項目はOpus 5.5が上で、Sonnet 5.5が上回るのはTerminal-Benchの1行だけです。数字はすべてAnthropic自身の発表値で、2026年9月29日時点で独立した評価はまだ出ていません。
株式会社Fyveは中小企業のAI活用を支援しており、私自身もClaude Codeを毎日の実務で使っています。この記事では、全8項目を「何を測っているか」つきで並べ、脚注の意味、Terminal-Benchの70.6%の読み方、「1件あたり約10分の1のコスト」という主張の読み方、独立した評価がまだない点をお伝えします。
Sonnet 5.5の全体像は、こちらのガイドにまとめています。
先に結論:Sonnet 5.5のベンチマークから読み取れる4つのこと
Claude Sonnet 5.5は2026年9月28日(米国時間)に公開されました。Anthropicは発表ページで、ベンチマーク(AIの能力を同じ試験で測り、点数を並べたもの)の表を出しています。ここから言えるのは次の4つです。
- Sonnet 5からは全項目で大きく伸びた。とくにTerminal-Bench 4.0は10.3%から70.6%、図表の読み取り(Chartography)は15.6%から61.6%
- Opus 5.5との差は小さいが、上に立つのはほぼOpus 5.5。8項目中7項目でOpus 5.5が上
- 目玉は点数より「コスト対性能」。軽い設定のSonnet 5.5がSonnet 5の最高スコアを1件あたり約10分の1のコストで上回る、という主張がある
- すべてAnthropicの発表値で、脚注に条件がある。公開前の版で測った行や、比較相手の不具合の注記がついた行もある
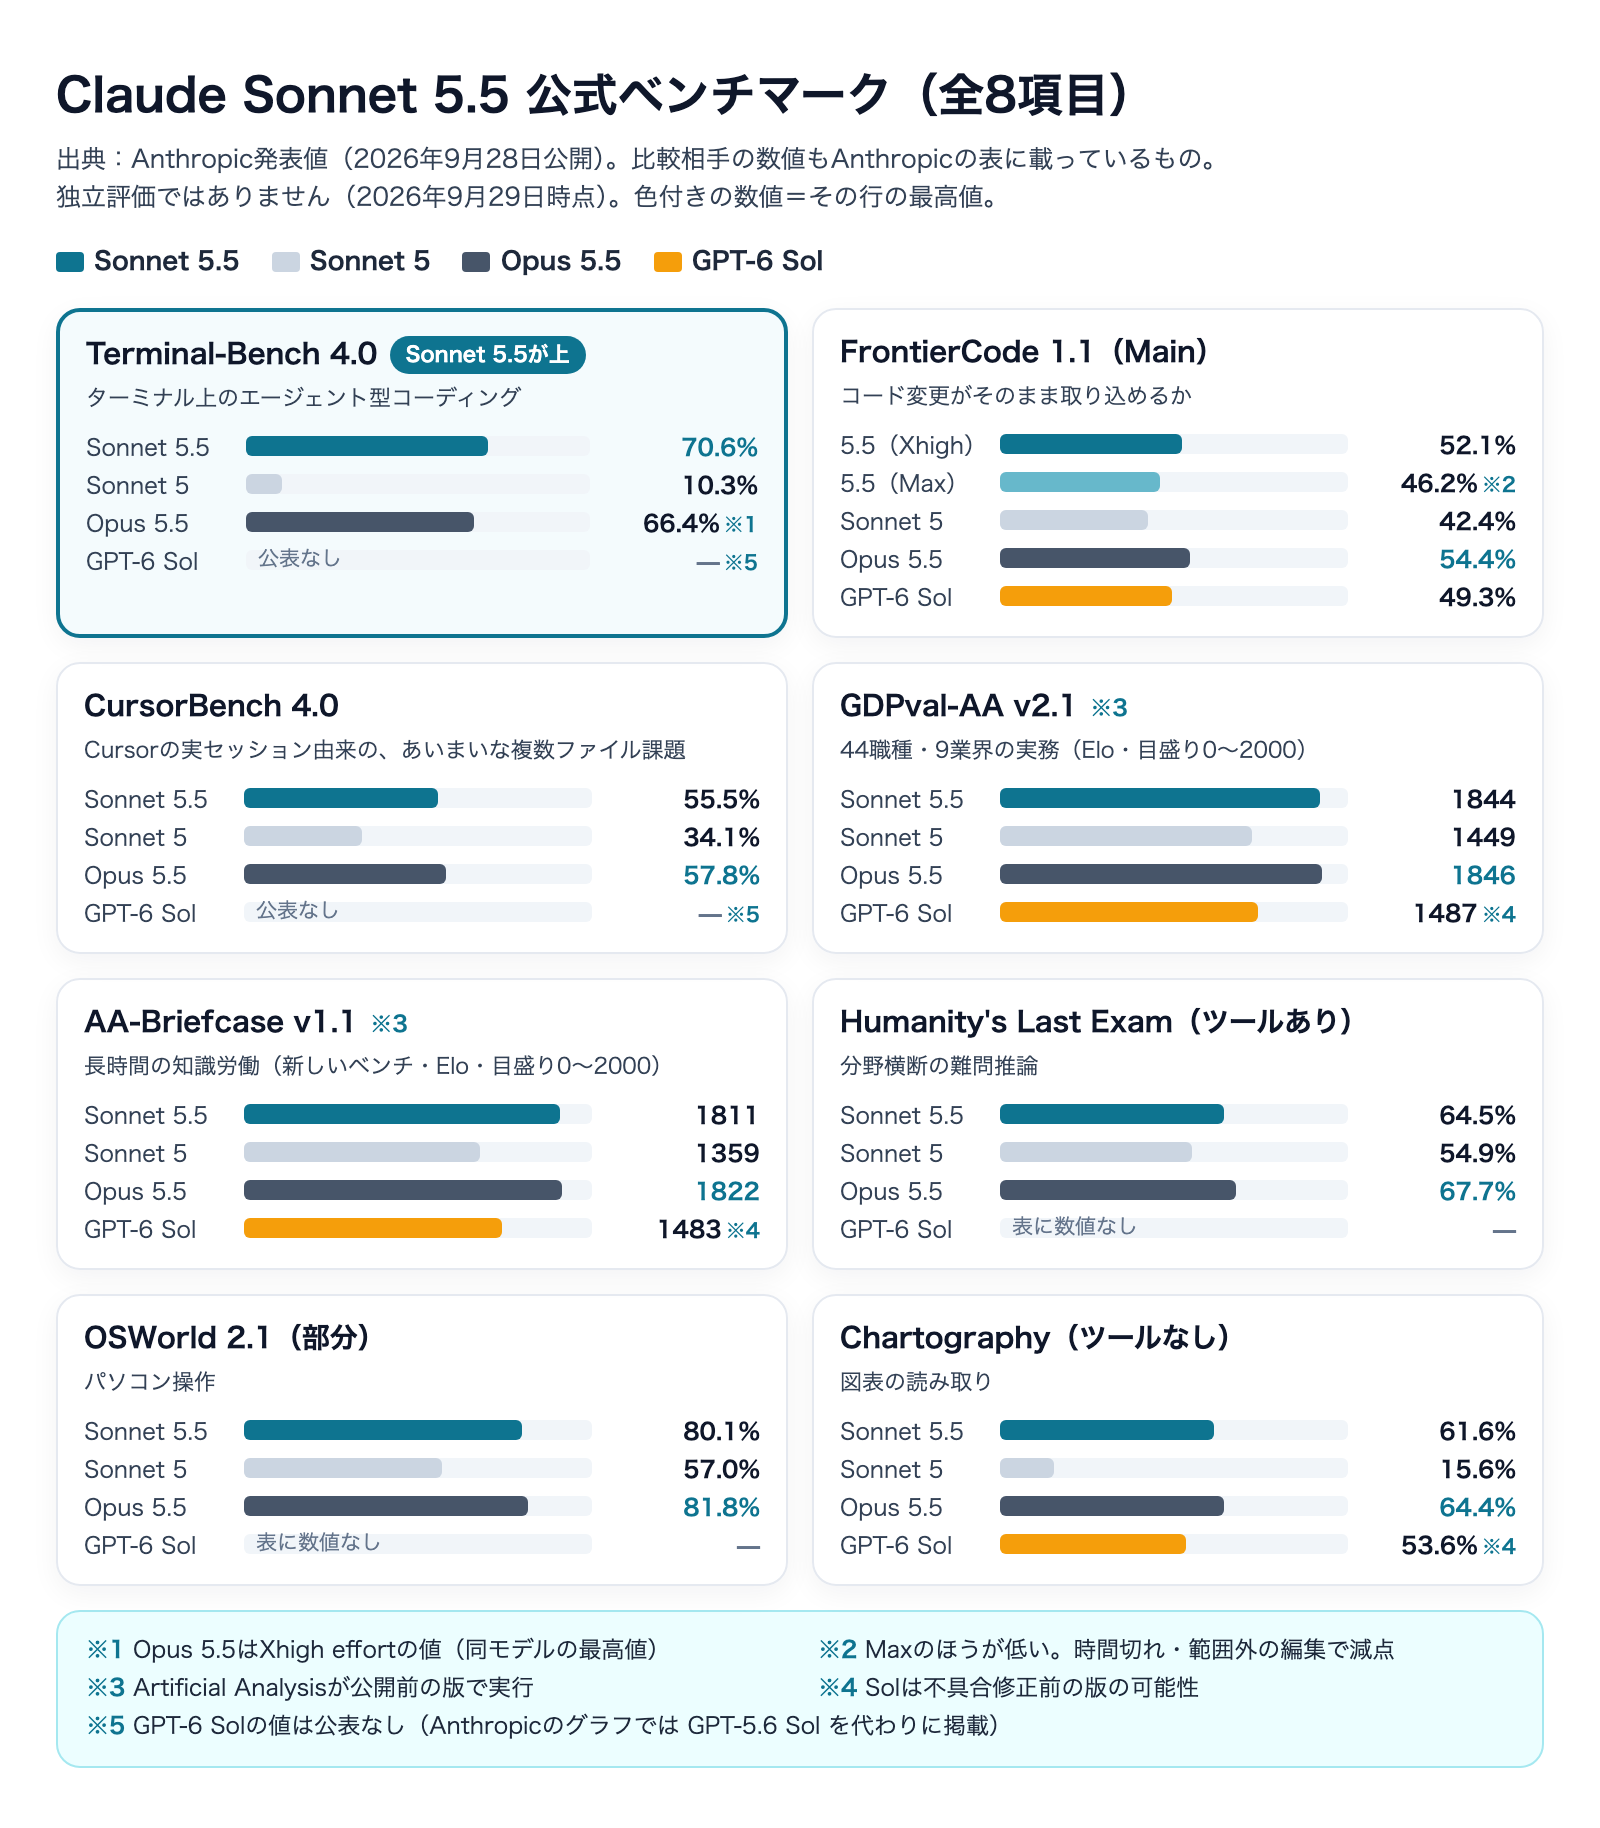
Claude Sonnet 5.5の公式ベンチマーク一覧(全8項目)
発表ページの表を並べます。比較相手の数値もAnthropicの表に載っているものです。「—」は表に数値がない項目、※は後で説明する脚注です。XhighやMaxは、effort(答える前にどれだけ考えるかの深さ)の段階を指します。
ベンチマーク | 何を測るか | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
Terminal-Bench 4.0 | ターミナル上のエージェント型コーディング | 70.6% | 10.3% | 66.4%(※1) | —(※5) |
FrontierCode 1.1(Main) | コード変更がそのまま取り込めるか | 52.1%(Xhigh)/46.2%(Max・※2) | 42.4% | 54.4% | 49.3% |
CursorBench 4.0 | Cursorの実セッション由来の、あいまいな複数ファイルの課題 | 55.5% | 34.1% | 57.8% | —(※5) |
GDPval-AA v2.1(※3) | 44職種・9業界の実務(Elo) | 1844 | 1449 | 1846 | 1487(※4) |
AA-Briefcase v1.1(※3) | 長時間の知識労働(新しいベンチ・Elo) | 1811 | 1359 | 1822 | 1483(※4) |
Humanity's Last Exam(ツールあり) | 分野横断の難問推論 | 64.5% | 54.9% | 67.7% | — |
OSWorld 2.1(部分) | パソコン操作 | 80.1% | 57.0% | 81.8% | — |
Chartography(ツールなし) | 図表の読み取り | 61.6% | 15.6% | 64.4% | 53.6%(※4) |
太字は各行の最高値です。8項目中7項目でOpus 5.5、Terminal-Benchの1項目でSonnet 5.5が最高値という並びです。GPT-6 Solとは、Solの数値がある4項目でしか比べられません。
各ベンチマークは何を測っているのか
8項目は、測っている仕事で3つに分けられます。自分の仕事に近い行を先に決めておくと、表の読み方がぶれません。
コーディング系(Terminal-Bench/FrontierCode/CursorBench)
Terminal-Bench 4.0は、ターミナル(コマンドを打って操作する黒い画面)の上で、AIが自分でコマンドを実行しながら作業を進める力を測ります。Claude Codeに作業を任せる使い方に最も近い試験です。FrontierCodeは、書いたコード変更がそのまま取り込める出来かを測り、課題の範囲外の変更を減点します。CursorBenchは、コードエディタCursorの実際の利用場面から作った、指示があいまいで複数のファイルにまたがる課題です。
FrontierCodeとCursorBenchは、どちらもOpus 5.5と2.3ポイント差です。
知識労働系(GDPval-AA/AA-Briefcase)
GDPval-AAは44職種・9業界の実務、AA-Briefcaseは長時間の知識労働を測ります。この2行だけ単位がElo(他のモデルとの勝ち負けから計算する相対的な強さ)なので、数字そのものに「何割できた」という意味はなく、読むべきは差です。GDPval-AAのSonnet 5.5は、Opus 5.5の2ポイント下、Sonnet 5の約400ポイント上。資料作りや調べ物にSonnet 5.5を使いたい人が最も注目すべき行です。
推論・操作・図表(Humanity's Last Exam/OSWorld/Chartography)
Humanity's Last Examは分野横断の難問を解く推論力で、Opus 5.5との差は3.2ポイント。%で測る行のうちOpus 5.5が上の行では最も大きな開きで、考え抜く深さが要る問題ほどOpus 5.5が上に来る並びです。OSWorldはパソコンの画面操作、Chartographyは図表の読み取りで、Chartographyの伸び幅はTerminal-Benchに次いで大きくなっています。
読み方1:Terminal-BenchでOpus 5.5を上回る70.6%をどう読むか
いちばん目を引くのは、Terminal-Bench 4.0でSonnet 5.5(70.6%)がOpus 5.5(66.4%)を4.2ポイント上回っている行です。ここは次の3つを並べて読みます。
Opus 5.5の66.4%は、最高設定(Xhigh)の値
脚注※1のとおり、Opus 5.5の66.4%はeffortをXhighにしたときの値で、同モデルの最高値です。Opus 5.5を軽い設定で回して負けた、という比べ方ではありません。このベンチに限っては、最高設定のOpus 5.5をSonnet 5.5が上回った、というのが表の読み方です。
公式自身が「複雑な仕事ではOpus 5.5がはっきり強い」としている
Anthropicは同じ発表の中で、「社内でも外部テスターでも、持続的な判断が要る複雑で終わりの見えない仕事では、Opus 5.5がはっきり強い」と書いています。発表した本人が、Terminal-Benchの1行を根拠に「Sonnet 5.5のほうが上」とは言っていないのです。残り7項目でOpus 5.5が上という並びとも合います。
私たちは、この行を「ターミナルで進める、範囲の決まった作業ならSonnet 5.5でも十分に戦える」という目星として使い、「Opus 5.5はもう要らない」とは読まないようにしています。
Sonnet 5の10.3%からの跳ね上がりは、「軽い設定で」とセット
Sonnet 5の10.3%は、ほぼ1割しか解けなかったということです。そこから70.6%へ、約7倍になりました。Anthropicはさらに、アプリの既定であるMediumのSonnet 5.5が、Sonnet 5の最高スコアを1件あたり10分の1未満のコストで大きく上回ると説明しています。前の世代でAIにターミナル作業を任せてうまくいかなかった人ほど、試し直す価値がある行です。
どちらをどんな仕事に使うかは、単価と手元の実測も含めてこちらで整理しています。
読み方2:脚注5つは、数字の条件そのもの
発表の表には5つの脚注がついています。数字だけを抜き出して比べると、ここが抜け落ちます。
脚注 | 対象 | 書いてあること | 読むときの注意 |
|---|---|---|---|
※1 | Terminal-Bench(Opus 5.5) | Xhigh effortの値(同モデルの最高値) | 普段の設定の数字ではない |
※2 | FrontierCode(Sonnet 5.5) | MaxのほうがXhighより低い(46.2%対52.1%) | effortを最大にすれば点が上がるとは限らない |
※3 | GDPval-AA/AA-Briefcase | Artificial Analysisが公開前の版で実行。その版には不具合があった(修正済み) | 公開された版の数字ではない |
※4 | GPT-6 Solの3項目 | Solの画像理解を劣化させる不具合が最近修正された。公式スコアは最新版を反映していない可能性 | Sol側が古い版の可能性つきで読む |
※5 | Terminal-Bench/CursorBench(GPT-6 Sol) | GPT-6 Solの値は公表されていない。グラフではGPT-5.6 Solを代わりに掲載 | GPT-5.6 Solの値を、GPT-6 Solの値として読まない |
※2:effortを最大にしたら、点が下がった
Anthropicの説明では、Maxにすると、Claude Codeのコードレビュー機能(多数のサブエージェントに作業を分担させる仕組み)を使うことが増え、時間切れや課題の範囲外の編集で減点されたとのことです。手を広げすぎたことが裏目に出た形で、頼んだ範囲を守ってほしい仕事では最大の設定が最善とは限らない、という実務にも通じる話です。
※3:知識労働系の2行は、公開前の版で測った数字
GDPval-AAとAA-Briefcaseは、Artificial Analysis(AIモデルを比較評価している外部の機関)が公開前の版で実行したものです。その版には、structured outputs(決まった形式で答えを返させる機能)の応答を劣化させうる不具合がありました。Anthropicは、影響は小さく、あるとしても点を低く見積もる側だと説明しています。ただ発表した側の見立てなので、「Opus 5.5と2ポイント差」は幅を持たせて読むのが安全です。
※4・※5:GPT-6 Solとの比較は4項目だけ、しかも条件つき
同じ$2/$10の単価で並ぶGPT-6 Solと比べられるのは、FrontierCode(52.1%対49.3%)、GDPval-AA(1844対1487)、AA-Briefcase(1811対1483)、Chartography(61.6%対53.6%)の4項目です。このうちFrontierCode以外の3項目には※4がつきます。Solとの違いを単価や使える場所まで含めて比べた記事はこちらです。
読み方3:「1件あたり約10分の1」は単価の話ではない
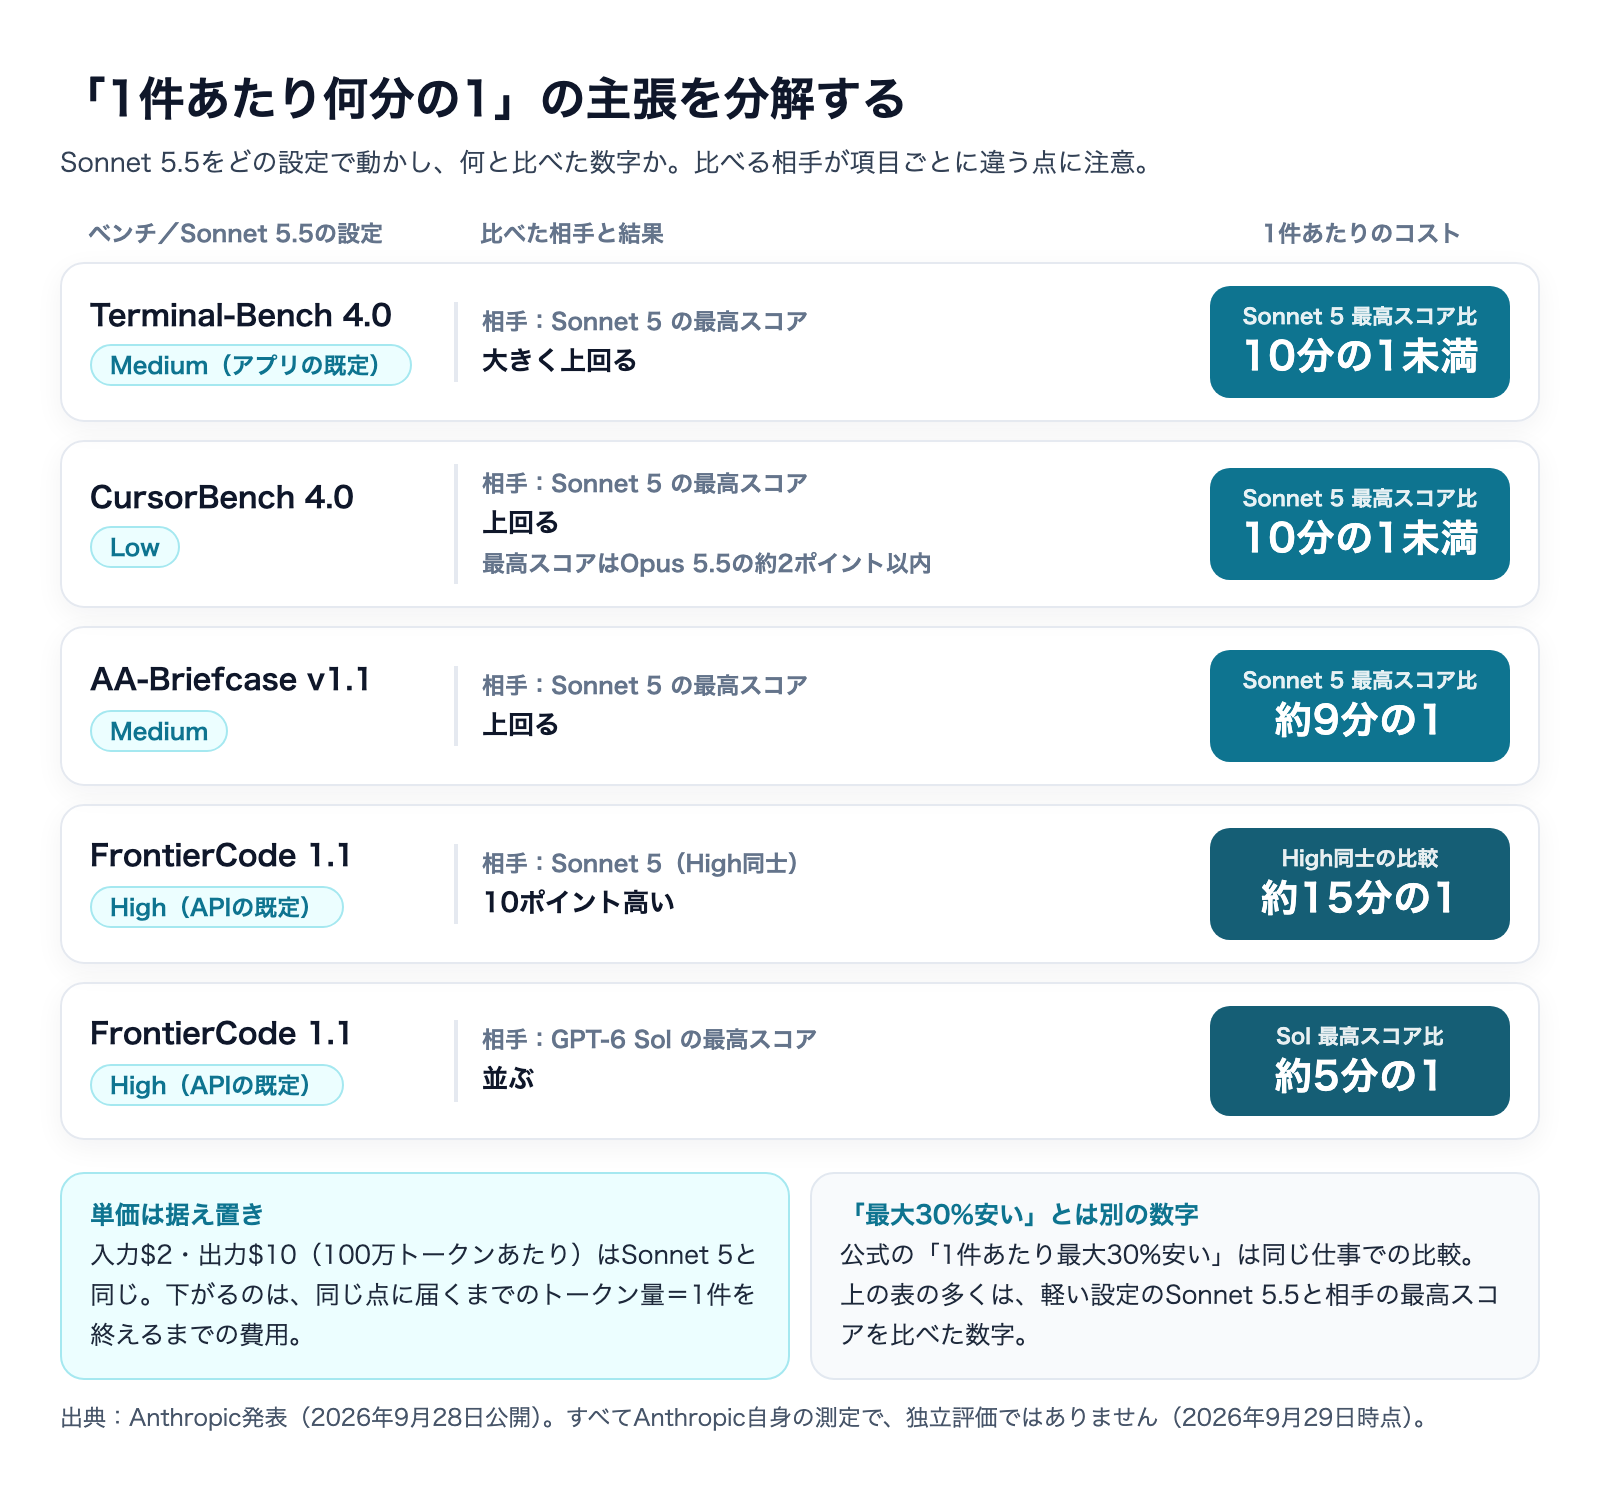
Sonnet 5.5の発表で、点数と同じくらい強調されているのが「コスト対性能」です。Anthropicはベンチごとに次のように説明しています。
- Terminal-Bench:アプリの既定のMediumで、Sonnet 5の最高スコアを1件あたり10分の1未満のコストで大きく上回る
- CursorBench:LowのSonnet 5.5が、Sonnet 5の最高スコアを10分の1未満のコストで上回る。最高スコアはOpus 5.5の約2ポイント以内
- AA-Briefcase:Mediumで、Sonnet 5の最高スコアを約9分の1のコストで上回る
- FrontierCode:API(Claude Platform)の既定のHighで、GPT-6 Solの最高スコアに約5分の1のコストで並ぶ。High同士ではSonnet 5より10ポイント高く、1件あたり約15分の1のコスト
取り違えやすい点が3つあります。
1つ目は、単価は据え置きだということです。API単価は入力$2・出力$10(100万トークンあたり・2026年9月29日時点)で、Sonnet 5と同じです。「10分の1」は、同じ点に届くまでに使うトークン(考える量やツールの呼び出し)が少ないので、1件を終えるまでの費用が下がる、という主張です。
2つ目は、比べている相手が項目ごとに違うことです。3項目は「Sonnet 5がいちばん良かったときの点」と軽い設定のSonnet 5.5の比較で、FrontierCodeは「High同士」と「Solの最高スコア」との比較です。同じ設定で同じ仕事をさせたら10分の1になる、という意味ではありません。公式の別の数字「1件あたり最大30%安い」は同じ仕事での比較で、比べ方が違います。
3つ目は、数字が低い設定に集中していることです。Anthropicは、Sonnet 5.5が最もよくOpus 5.5を補うのは低いeffortで回すときで、高い設定では同程度のコストで同程度の性能になりうる、と説明しています。安く数をこなすならSonnet 5.5を軽い設定で、深く考えさせたい仕事はOpus 5.5へ、というのが表から読める筋です。
読み方4:すべてAnthropicの発表値で、独立評価はまだない
ここまでの数字は、比較相手の分も含めてすべてAnthropicの表に載っている発表値です。Artificial Analysisが実施した2行も公開前の版の分で、2026年9月29日時点で、公開版を独立に測り直した数字はまだ出ていません。
海外メディアも発表値を報じています。VentureBeatはGDPval-AAの1844対1846などを伝えたうえで、「ベンチマークは本番の全ワークロードの代わりにはならない」と注意書きを添えました。報道はいずれも発表を伝えたもので、第三者が試験をやり直した結果ではありません。
発表値が信用できないという意味ではなく、どの試験を載せるかを決めたのは発表する側だ、という前提で読むということです。2026年9月22日に公開されたOpus 5.5の表も、同じ考え方で読み解いています。
ベンチの次は、自分の仕事で確かめる
ベンチの表は「どの仕事で試すか」を決める地図で、乗り換えの判断は自分の課題で測って決めます。私たちが手元のClaude Codeで関数を1つ書かせた小さな計測(2026年9月29日)では、Sonnet 5との速さに目立つ差は出ず、Sonnet 5.5が自分で書いたテストに通らない回もありました。計測の条件と結果、そこから決めた任せ方は、Sonnet 5.5とOpus 5.5の使い分けの記事にまとめています。
自分で測るときは、別名の sonnet ではなく、フルIDの claude-sonnet-5-5 で指定してください(手元の環境では、別名が前世代のSonnet 5で動いていました)。指定と確認の手順はこちらです。
まとめ:ベンチマークは「試す場所」を決める地図として読む
- Claude Sonnet 5.5は全8項目でSonnet 5を上回り、Opus 5.5には数ポイント差まで近づいた。ただし8項目中7項目はOpus 5.5が上
- Terminal-Benchの70.6%は、Opus側がXhigh(最高値)の値である点と、公式が「複雑な仕事ではOpus 5.5がはっきり強い」としている点を並べて読む
- 脚注:FrontierCodeはMaxのほうが低い/知識労働系の2行は公開前の版/GPT-6 Solの3項目は不具合修正前の可能性/Terminal-BenchとCursorBenchにSolの値はない
- 「1件あたり約10分の1」は値下げではなく、軽い設定のSonnet 5.5とSonnet 5の最高スコアの比較。単価は$2/$10で据え置き
- すべてAnthropicの発表値で、2026年9月29日時点で独立評価はまだない。乗り換えの判断は自分の課題で測って決める
株式会社Fyveでは、こうした新モデルの評価を自社の実務で回しながら、中小企業のAI活用を支援しています。発表の数字は「どこで試すか」の目星に使い、判断は自分の仕事の数字で下す。この順番なら、次のモデルが出たときも迷いません。
Sonnet 5.5を、Sonnet 5・Opus 5.5と実務で比べてみた。
Opus 5.5の半額で、同じ仕事はどこまで足りるか。同じ5つの仕事で測りました(全31ページ)
Sonnet 5.5は単価$2/$10で、Opus 5.5の半額です。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを、Sonnet 5.5・Sonnet 5・Opus 5.5に同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は3モデルとも全問正解。差が出たのは、費用と作り込みと、細部の丁寧さでした。
- Opus 5.5 と同じ水準の作り込みを、Sonnet 5.5 がどれだけ安く終えたか
- Sonnet 5 から乗り換える意味はあるか——仕事別の早見表と判断フローつき
- 5つの仕事 × 3モデル=15本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを3つ並べて比較(LP・スライド・回せる3D)
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。