Claude Opus 5.5のeffort設定|既定がmediumになった意味

「Opus 5.5のeffortは何にしておけばいいのか」「thinkingを切って速くしたいのに、設定が効かない」——Opus 5.5に切り替えた直後、思考の深さの設定でこうした疑問を持つ方は多いはずです。
結論から言うと、Opus 5.5のeffortは既定がhighからmediumに下がりました(APIとClaude Codeの両方)。しかもOpus 5.5ではthinking(思考)そのものを切ることができず、考える深さを調整できるのはeffortだけです。まずはmediumのまま使い、足りない作業だけ上げる。上げるときは設定ファイルの書き方の落とし穴に注意する。この2点を押さえれば迷いません。
株式会社Fyveは、Claude Codeを社内業務と受託開発の両方で毎日使っています。本記事では、Anthropicの公式ドキュメントの記述と私たちの手元での実測を分けて、Opus 5.5のeffortの選び方と設定方法を説明します。
Opus 5.5そのものの全体像は、次の記事にまとめています。
Opus 5.5のeffortとは|thinkingは切れず、深さだけを選ぶ
effortは、モデルが答えを出す前にどれだけ手間をかけて考えるかを決める設定です。Opus 5.5では選択肢が5段階あり、浅い順に low・medium・high・xhigh・max です。
Opus 5.5のeffortを理解するうえで、先に押さえておきたい前提が1つあります。それは、思考(thinking)を「オフ」にする選択肢がなくなったことです。
thinkingは常時オンで、無効化できない
公式のモデル概要によると、Opus 5.5の思考は「Adaptive」で常時オンです。作業の難しさに合わせてモデル自身が思考の量を調整する方式で、利用者がオフにすることはできません。
これまでのモデルでは、「単純な作業なので思考なしで速く返してほしい」という使い方ができました。Opus 5.5ではその手段がないため、速さと深さのバランスを取る調整つまみは、effortの1本に集約されたと考えてください。「思考のオン・オフ」と「思考の深さ」の2本立てだった設定が、「深さ」1本になったわけです。
thinkingを切る設定は、APIでもClaude Codeでも効かない
この変更は、これまでthinkingを切っていた人に直接影響します。
- APIの場合:リクエストで
thinking: disabledを指定したり、enabled+budget_tokensで思考量を決めたりすると、エラー(400)になります。effortの指定に置き換えてください - Claude Codeの場合:設定の
alwaysThinkingEnabled、環境変数MAX_THINKING_TOKENS=0、セッション中の思考のトグルは、Opus 5.5では効きません。これらを設定していても思考はオンのままなので、「切ったつもりで実は考えている」状態になります
「思考を切って速くしていた」運用をしていた方は、代わりにeffortを下げる設定に置き換えることになります。APIで使っている場合、thinking以外にも400エラーになる変更があります(ツールの強制指定が使えない、など)。移行の全体は次の記事で扱っています。
既定がmediumに下がったら、まずやること
公式のモデル概要・移行ガイド・Claude Codeのドキュメントはいずれも、Opus 5.5の既定effortを medium としています(Opus 5は high)。effortを一度も指定したことがない人は、モデルを乗り換えた瞬間に、考える深さも1段下げて使っていることになります。
移行ガイドが勧めているのは、effortを明示することと、選んだeffortでコストとレイテンシ(応答までの時間)を測り直すことの2つです。なお、発表内の顧客コメントとして、DeloitteのCarl Bennett氏が「最も低いeffortでも、Opus 5の最高effortより多くの既知のバグをコードレビューで見つけた」と述べたと、第三者の報道(OfficeChai)が伝えています。ただしこれは発表に載った声で、独立した評価ではありません。mediumで足りるかどうかは、自分の作業で確かめる前提で読んでください。
 読者特典・無料ダウンロード最新AI「4モデル」、実務で比べてみた。無料でダウンロード →
手元の実測:小さな課題では、mediumとhighの差はほぼ出なかった
既定のmediumと、Opus 5と同じhighとで、どれくらい差が出るのかを私たちの手元で確かめました。
条件は、Claude Code v2.1.280(Maxプランの認証)で、同じ課題を対話なしで投げるというものです。課題は「日本の郵便番号("123-4567"/"1234567"/全角数字/前後の空白を許容)を "123-4567" に正規化するPython関数を1つ。不正なら ValueError。doctest 5個つき」。各条件3回ずつ動かし、中央値を取りました。
条件 | 所要時間(中央値) | 3回の幅 | 出力トークン(中央値) | 3回の幅 | doctest |
|---|---|---|---|---|---|
Opus 5.5(既定effort=medium) | 19.0秒 | 13.7〜26.6秒 | 1,507 | 1,028〜2,473 | 3/3合格 |
Opus 5.5(effort=high) | 22.7秒 | 13.7〜23.4秒 | 1,532 | 935〜1,971 | 3/3合格 |
この課題では、mediumからhighに上げても、出力トークンの中央値は1,507から1,532でほぼ同じでした。所要時間の中央値は19.0秒から22.7秒に伸びましたが、3回の幅は時間もトークンも大きく重なっており、差と呼べるほどの開きは出ていません。易しい課題では、effortを上げても手間のかけ方はあまり増えないという結果で、作業の難しさに合わせて思考量を調整する「Adaptive」の仕組みと矛盾しません。
もう1つ、ばらつきの大きさにも注意が必要です。mediumでも13.7秒で終わる回と26.6秒かかる回がありました。1回だけ比べて「highのほうが遅かった/良かった」と決めると、偶然のぶれを設定の差と取り違えます。
限界もはっきりしています。課題は1種類の小さなもので、各条件3回だけです。正解率は全条件で満点だったため、effortによる品質差はこの実測からは測れていません。effortの差が効いてくるのは、もっと長く難しい作業のはずで、そこは自分の作業で確かめる必要があります。
effort 5段階の選び方
では、実際にどの段階を選べばよいのでしょうか。公式ドキュメントは各段階の用途を細かく割り当てていないため、ここからは私たちの判断基準として説明します。「その作業で、考え落としがどれだけ高くつくか」を軸に選ぶ、という考え方です。
各段階の目安
effort | 向いている作業の目安 | 判断のポイント |
|---|---|---|
| 答えが1つに決まる定型作業、使い捨ての下書き、大量に回す単純処理 | 間違えてもすぐ気づける・すぐ直せる作業 |
| 普段の実装・修正・調べもの・文章のたたき台 | まずここから。困ったときだけ動かす基準点 |
| 複数ファイルにまたがる改修、原因の分かりにくい不具合の調査、納品物の仕上げ | Opus 5と同じ既定。以前の感覚で使いたいならここ |
| 設計の判断を伴う作業、長時間任せきりにするエージェント作業 | やり直しの手間が大きい作業に限る |
| highやxhighで何度か試しても解けなかった難所 | 常用しない。ここでも足りなければ上位モデルを検討 |
この表の線引きに、公式が定めた数値の根拠があるわけではありません。あくまで「どこから試すか」の出発点として使い、自分の作業での結果を見て調整してください。
迷ったらmediumから始め、足りない作業だけ上げる
私たちがおすすめするのは、既定のmediumを基準点にして、困った作業だけ上げる進め方です。
理由は、最初からhighやmaxに固定すると、上げる必要のない作業まで時間とトークンを使うことになるからです。反対に、mediumで「考えが浅い」「見落としがある」と感じた作業が出てきたら、その作業の種類だけhighに上げる。こうすると、どの作業にどの深さが必要かが、自分の仕事の中で少しずつ見えてきます。
上げるか迷ったら、普段よく頼む作業を1つ選び、mediumとhighで数回ずつ動かして、結果の良し悪しと一緒に時間とトークンの増え方も見てください。先ほどの実測のとおり1回ではぶれに埋もれるので、数回が必要です。
maxでも足りなければFable 5.1へ
公式のモデル一覧は、「迷ったら大半の用途はOpus 5.5から始める。より難しい推論や長時間のエージェント作業、またはOpus 5.5を高effortにしても足りない場合はFable 5.1」と案内しています。effortを上げ切っても解けない作業は、深さの問題ではなくモデルの問題と考えて、上位モデルに回すのが公式の想定する使い方です。
なお、Fable 5.1にもeffortの設定があり、Opus 5.5とは既定値の事情が違います。Fable 5.1でのeffortの使い分けは、Claude Fable 5.1のeffort設定|lowとhighの使い分けで実測をもとに解説しています。
Claude Codeでのeffortの設定方法
Claude Codeでeffortを指定する方法は、公式ドキュメントによると次の5つです。
/effort:対話画面で打つとスライダーが開き、段階を選べる/effort high:段階名を付けて打つと、スライダーを開かずに直接指定できるclaude --effort high:起動するときに指定する- 環境変数
CLAUDE_CODE_EFFORT_LEVEL:シェルの設定に書いておけば、毎回指定しなくて済む - 設定ファイルの
modelSettings:モデルごとにeffortを保存できる
使い分けの考え方
対話しながら作業するなら、/effort がいちばん手軽です。「この不具合は手ごわいので、この作業だけ深く考えてほしい」という場面で、その場で上げ下げできます。
毎日決まった時刻に動かす自動処理のように、人が見ていない場面では、起動コマンドに --effort を書いておくのが確実です。私たちも自動処理ではモデル名を起動コマンドに必ず書く運用をしていますが、Opus 5.5からはeffortも同じ扱いにすべきだと考えています。既定値が変わったときに、知らないうちに考える深さが変わるのを防げるからです。
「Opus 5.5のときはいつもhigh」のように、モデルごとに決まった深さで使いたい場合は modelSettings が向いています。設定ファイルを自分で書き換えるのが不安なら、Claude Codeに「設定ファイルの modelSettings で、Opus 5.5のeffortをhighにして保存して」と頼み、書き換えた箇所を見せてもらってから反映するのが安全です。
落とし穴:トップレベルの effortLevel はOpus 5.5に効かない
ここが、Opus 5.5のeffort設定でいちばん注意したい点です。
設定ファイルの一番上の階層に effortLevel を書いてeffortを指定している方は、その指定がOpus 5.5には効きません。公式ドキュメントによると、これは旧形式の書き方のためです。指定が効かないまま、/effort で選び直すまで既定の medium で動き続けます。
「前からhighに設定してあるから大丈夫」と思っている人ほど、実際にはmediumで動いていることに気づきにくい変更です。Opus 5の頃に設定ファイルでeffortを決めていた方は、次のどちらかを行ってください。
- Opus 5.5に切り替えたあと、
/effortで段階を選び直す - モデルごとに保存したいなら、
modelSettingsの側で指定し直す
thinkingを切る設定(alwaysThinkingEnabled や MAX_THINKING_TOKENS=0)も、同じくOpus 5.5では効かない設定です。設定ファイルにこれらが残っている場合は、Opus 5.5では意味を持たないと理解しておいてください。
fast modeとの違い
effortはどれだけ考えるかを変える設定で、下げれば考える量そのものが減ります。fast modeは別の仕組みで、公式には同じ品質のまま最大2.5倍速で返すとされています。料金や有効化の手順は、次の記事で説明しています。
まとめ:まずmediumのまま、足りない作業だけ上げる
Opus 5.5のeffortについて、押さえておきたい点を振り返ります。
- Opus 5.5のthinkingは常時オンで切れない。考える深さを調整できるのはeffort(low/medium/high/xhigh/max)だけ。APIでthinkingを無効化する指定は400エラーになる
- effortの既定は、Opus 5のhighからmediumに下がった(APIとClaude Codeの両方)。移行ガイドの推奨は、effortを明示し、コストと応答時間を測り直すこと
- 手元の小さな課題では、mediumとhighの差はほぼ出なかった(トークン中央値1,507→1,532、幅は重なった)。判断は数回試してから
- 選び方は「考え落としがどれだけ高くつくか」。mediumを基準に、困った作業だけ上げる
- 設定ファイルのトップレベル
effortLevelはOpus 5.5に効かない。/effortで選び直すか、modelSettingsで指定し直す - maxでも足りなければ、公式の案内どおりFable 5.1を検討する
株式会社Fyveでは、Claude Codeを業務に組み込むときのモデル選びや、自動処理の設定の見直しも含めて支援しています。新しいモデルが出るたびに「深さの設定も変わっていないか」を確かめる習慣が、思わぬ品質のぶれを防ぐいちばんの近道です。
最新AI「4モデル」、実務で比べてみた。
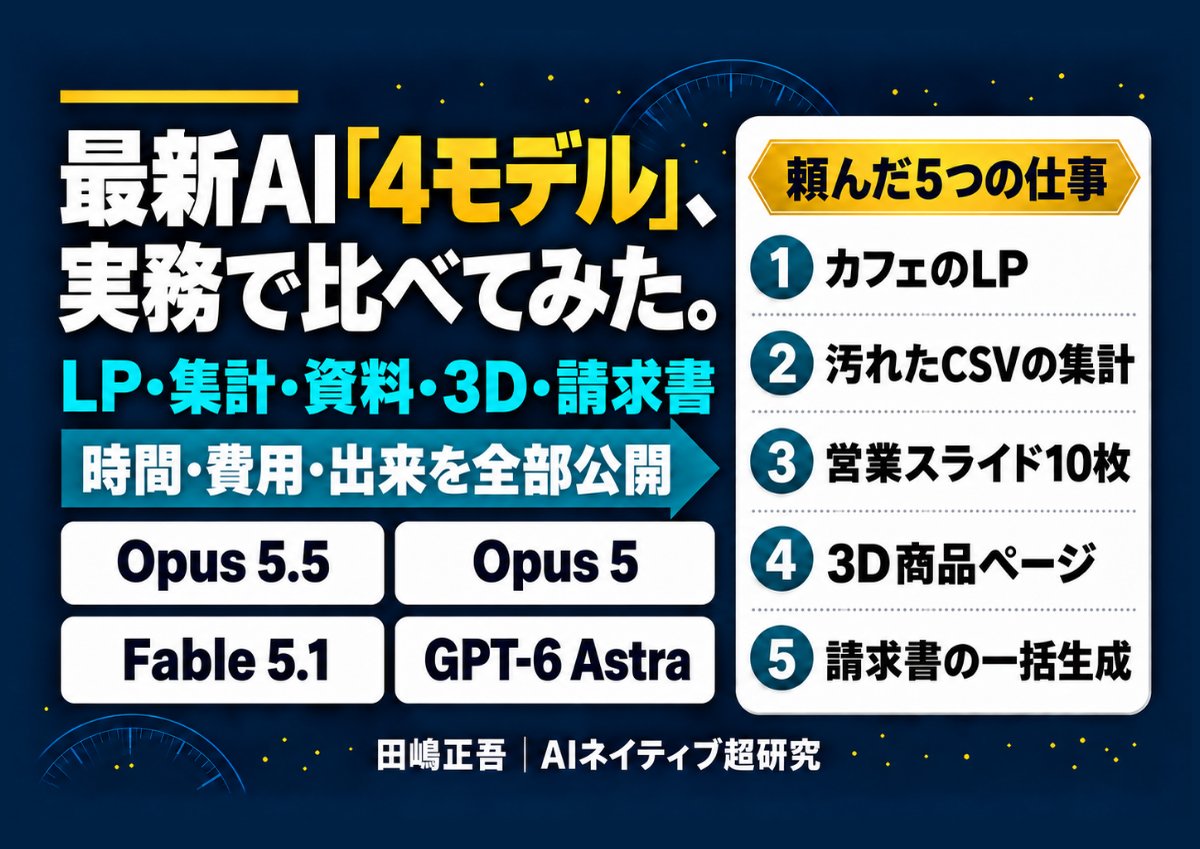
Opus 5.5・Opus 5・Fable 5.1・GPT-6 Astra に同じ5つの仕事を投げた実測(全31ページ)
公式ベンチでは、Opus 5.5 が上位の Fable 5.1 や GPT-6 Astra を多くの項目で上回りました。では実際の仕事ではどうか。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを4モデルに同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は4モデルとも全問正解。差が出たのは、速さと費用と、細かい指示の守り方でした。
- 5つの仕事 × 4モデル=20本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを4つ並べて比較(LP・スライド・回せる3D)
- Opus 5 と同じ作り込みを、Opus 5.5 がどれだけ短く終えたか
- 細かい指示を最後まで守ったのはどれか——仕事別の早見表と判断フローつき
メールアドレス登録で他にも様々な資料を閲覧できます
 +6
PDF 15点・合計400ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。