Gemini Decisions APIとは|料金とJevの違い

「Gemini Decisions API は何ができて、いくらかかるのか。Jev や OpenAI の Decisions API と何が違うのか」——2026年11月11日の Google の発表を見て、判定だけをAIに任せたい人ならまずこう考えるはずです。
結論から言うと、Gemini Decisions API は文章を生成せず、はい/いいえ・選択肢・段階評価の答えを確信度つきで返す判定専用のAPIです。モデルは Gemini Decision 1(gemini-decision-1)で、料金は入力100万トークンあたり0.10ドル、出力は0トークンで課金されません。同種の API と比べて目立つのは、画像・音声・動画・PDFをそのまま判定の材料に渡せることと、1回で最大1,000問を聞けることです。
株式会社Fyveは、判定専用モデルを自社の仕組みに組み込み、Jev や Cloudflare の Clef を同じ課題で比べてきました。この記事では、Google の公式ブログと公式ドキュメントで確かめた仕様を正として押さえ、その実測から「Gemini Decisions API を試すときに何を見ればよいか」をまとめます。
Gemini Decisions APIとは——文章ではなく「判定」を返すAPI
Gemini Decisions API は、Google DeepMind が2026年11月11日に発表した、決まった選択肢の中から答えを選ぶための API です。公式ブログは用途として、ツールの選択・ポリシーの確認・モデルの振り分け・文脈の採点を挙げています。
普通の LLM は、答えを1文字ずつ文章として書きます。Gemini Decisions API は、候補の答えを1回の処理でまとめて採点し、答えと確率と確信度だけを返します。「この問い合わせは返品か」と聞けば、文章で「はい、返品のご相談です」と返すのではなく、0.97 のような数字が返ります。返ってくる形が決まっているので、プログラムはその値でそのまま処理を分けられます。
同じ考え方の判定モデルとしては、先に TypeSafe の Jev があり、10月には Microsoft の Decision-1、OpenAI の Decisions API も出ています。Gemini Decisions API は、この流れに Google が加わったものです。
発表の要点(2026年11月12日時点)
項目 | 内容 | 出どころ |
|---|---|---|
発表日 | 2026年11月11日 | Google 公式ブログ |
モデル | Gemini Decision 1( | 公式ブログ・公式ドキュメント |
問いの型 |
| 公式ドキュメント |
1回で聞ける問いの数 | 1〜1,000問 | 公式ドキュメント |
渡せる入力 | テキスト・画像・音声・動画・PDF | 公式ブログ・公式ドキュメント |
文脈の上限 | 262,144トークン(入力とすべての問いの合計) | 公式ドキュメント |
速さ | 端から端まで150〜250ミリ秒、モデルの計算は中央値50〜100ミリ秒 | 公式ブログ(Google の説明値) |
料金 | 入力100万トークンあたり0.10ドル。出力は常に0トークン | 公式ブログ・公式料金ページ |
無料枠 | Google AI Studio で試作用の無料枠あり | 公式ブログ・公式料金ページ |
提供先 | Gemini API(v1beta)と Google AI Studio。Google Cloud の Gemini は「近日対応」 | 公式ブログ・公式ドキュメント |
料金はドル建て・税別の公式発表値です。契約前に必ず Gemini API の公式料金ページで最新の値を確認してください。
速さの150〜250ミリ秒は Google が出した説明値で、日本から呼んだときの往復時間ではありません。公式ブログは、問いを1問から100問に増やしても待ち時間がほとんど変わらないとも書いています。私たちが Jev を手元から呼んだときは、1件の中央値が197ミリ秒でした。地域と経路で数字は動くので、自社の環境で一度測ってから設計に使うのが安全です。
3つの問いの型と、返ってくる値
Gemini Decisions API への問いは、名前を付けて questions に並べます。1つ1つの問いに、型(type)・問いの文(instructions)・答えの候補(criteria)を書きます。公式ドキュメントで確かめた型ごとの違いは次のとおりです。
型 | 聞き方 | 返ってくる値 | 向いている仕事 |
|---|---|---|---|
| はい/いいえ。候補の説明は任意(はいの説明・いいえの説明) | 「はい」の確率(0.01〜0.99)と確信度 | 規則に反していないか・対象に当てはまるか |
| 2〜255個の選択肢に名前と説明を付ける | 選ばれた選択肢・全選択肢の確率(合計1)・確信度 | 担当の振り分け・使うツールの選択 |
| 2〜255段階の基準を順に並べる(2〜10段階を推奨) | 確率で重み付けした点数(0始まり)・段階ごとの確率・確信度 | 緊急度・品質・関係の深さの採点 |
確信度は、いちばん確率の高い答えの確率です。noul の場合は「はい」の確率と「いいえ」の確率の大きいほうになります。この数字を使って「確信度が低いものは人に回す」という線を引けるのが、判定専用モデルを使う一番の理由です。
仕組み——1つの材料に、たくさんの問いを同時に聞く
Gemini Decisions API の設計で押さえておきたいのは、判定の材料(input)は1回に1つで、それに対して最大1,000問を同時に聞くという形です。たとえば配送の写真を1枚渡して、「破損しているか」「どの対応をするか」「深刻度は何段階目か」を1回で聞けます。
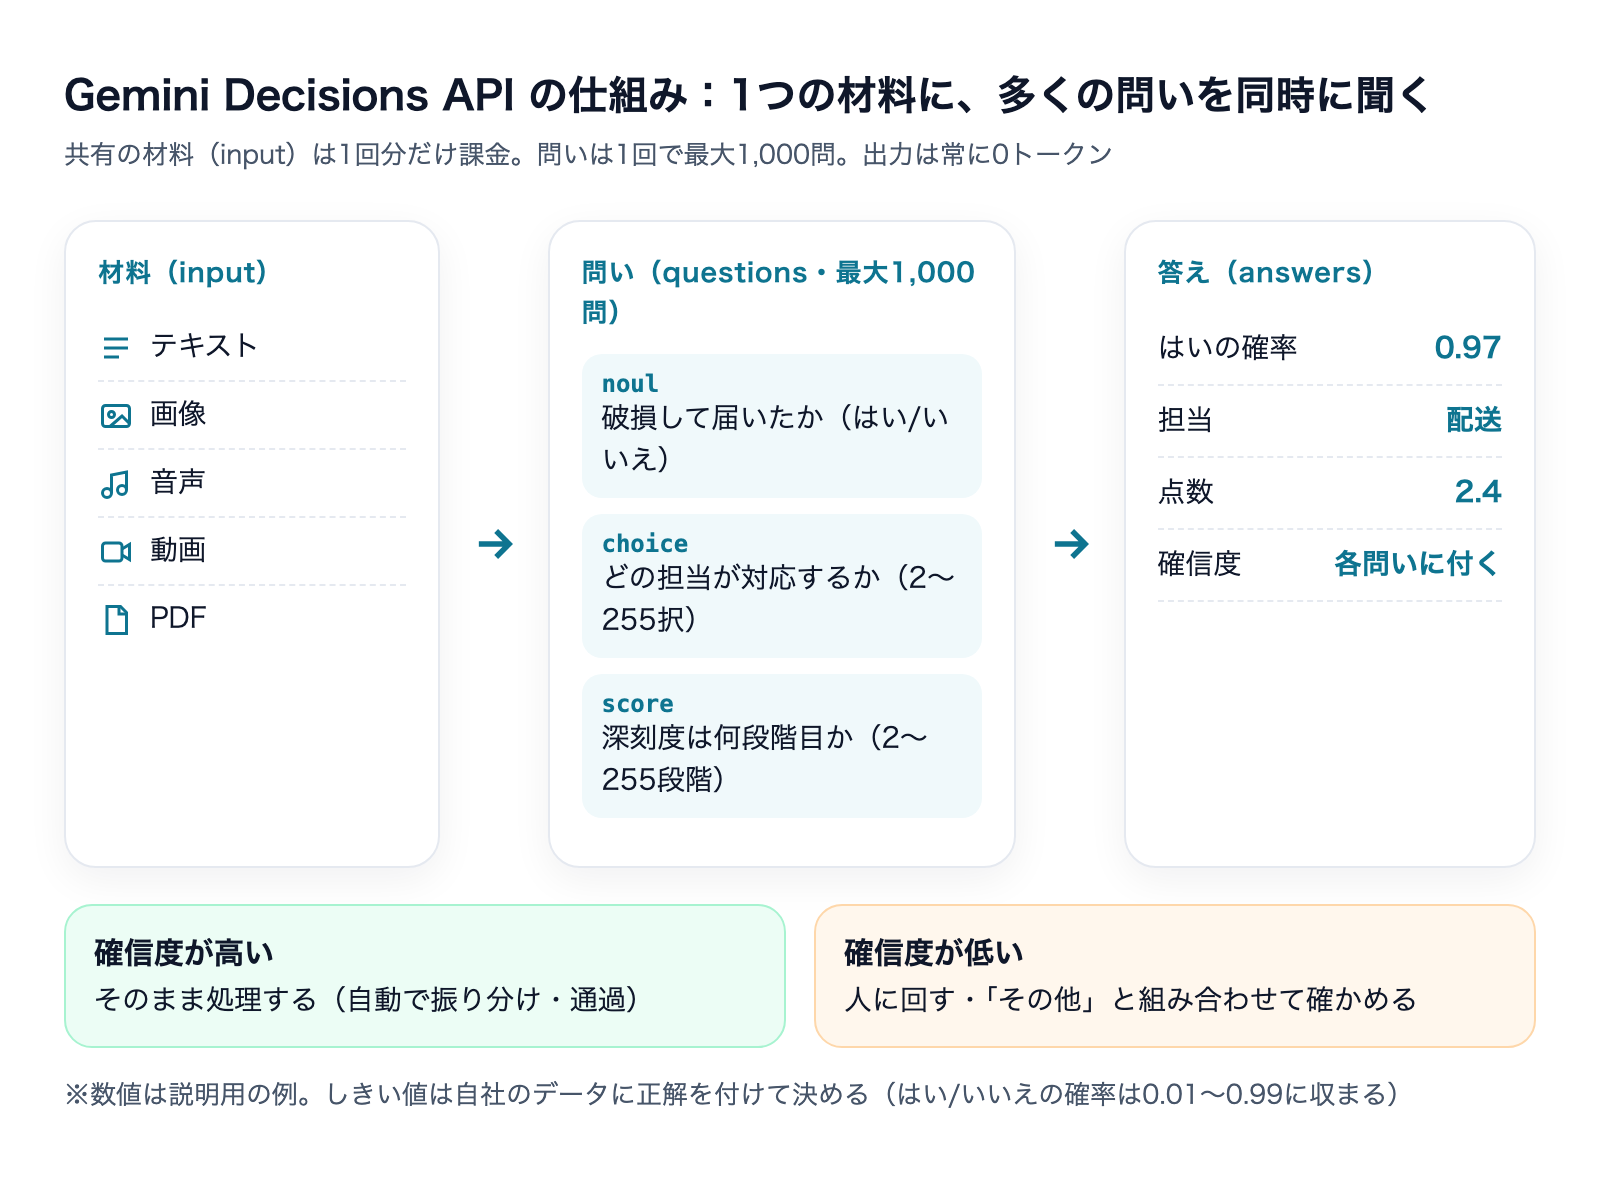
料金もこの形に合わせて決まっています。公式ブログによると、共有の材料はリクエストごとに1回だけ課金され、問いを足すたびに増えるのはその問いの文と候補の分だけです。同じ材料に聞きたいことが多い仕事ほど、1問あたりの費用は下がります。
料金はいくらか——私たちの実測の分量で計算する
料金は入力だけで、100万トークンあたり0.10ドルです。出力・思考・音声の書き起こし・OCR の料金は別にかかりません。ただし同じ材料を何度も送ると、そのたびに全量が課金されます。公式ドキュメントによると、この API は文脈のキャッシュにも Batch API にも対応していないためです。
実際の分量で計算してみます。私たちが自社で回している「Xのいいね検索」では、検索した話に投稿が関係するかを判定役に聞いています。このときの入力は1件あたり約540〜750トークンでした。間を取って1件650トークンとすると、次のようになります。
1日の判定件数 | 1か月(30日)の入力トークン | 1か月の料金の目安(入力0.10ドル/100万トークン) |
|---|---|---|
100件 | 195万 | 約0.20ドル |
1,000件 | 1,950万 | 約1.95ドル |
10,000件 | 1億9,500万 | 約19.5ドル |
画像・音声・動画を渡すとトークン数は大きく増えます。公式ドキュメントでは、画像と動画は解像度を4段階(low・medium・high・ultra_high、ultra_high は画像のみ)から選べ、細部と費用の釣り合いを調整できます。写真で判定するなら、まず low で正解率が足りるかを確かめてから解像度を上げるのが費用の面で無難です。
比べると、Jev と Microsoft の Decision-1 は、2026年10月12日に私たちが確認した時点で、どちらも入力100万トークンあたり0.042ドル・出力は無料でした。単価だけなら Gemini Decisions API は約2.4倍です。それでも上の表のとおり、1日1万件でも月20ドル前後に収まります。
私たちが Jev で1か月1万件の判定を検算したときも、総コストのほとんどは「人が確認する時間」で、モデルの料金は全体の0.1%未満でした。判定モデルの選び方を決めるのは単価よりも、人に回す件数をどこまで減らせるかです。
もう1つ、無料枠には条件があります。公式料金ページでは、無料枠で送った内容は Google の製品改善に使われ、有料枠では使われないと書かれています。顧客の問い合わせや社内の書類を判定にかけるなら、試作の段階から有料枠で使うことを勧めます。
Jev・Decision-1・OpenAI Decisions APIとの違い
判定専用のAPIは、2026年11月時点で少なくとも4つあります。問いの書き方はかなり揃っていて、はい/いいえの型の名前が noul、ほかに choice と score がある点、問いに type・instructions・criteria を書く点は、Jev・Decision-1 と Gemini Decisions API で共通です。違うのは、判定の材料を入れる欄の名前(Jev と Decision-1 は state、Gemini は input)と、置き場所・入力の種類・上限です。
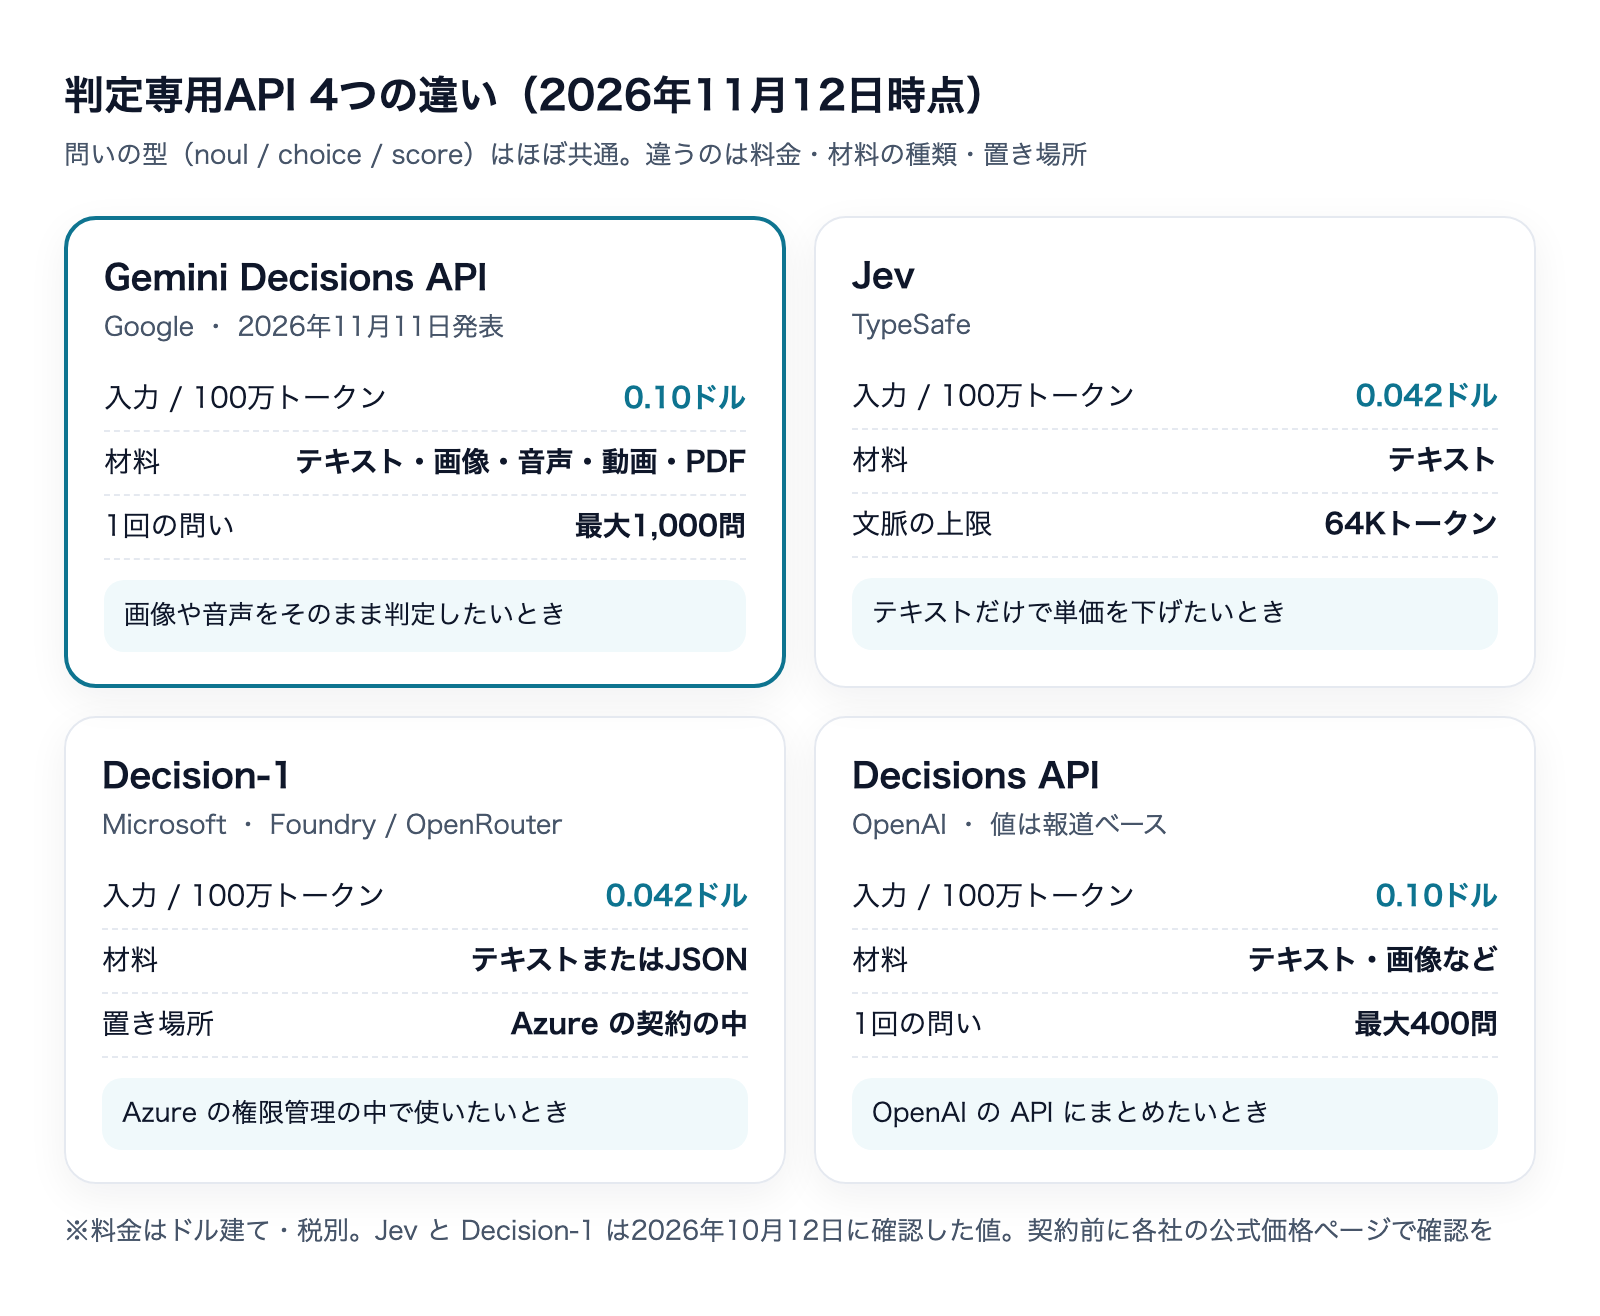
Gemini Decisions API | Jev(TypeSafe) | Decision-1(Microsoft) | Decisions API(OpenAI) | |
|---|---|---|---|---|
入力の料金(100万トークン) | 0.10ドル | 0.042ドル(10/12確認) | 0.042ドル(発表値) | 0.10ドル(報道) |
判定の材料 | テキスト・画像・音声・動画・PDF | テキスト | テキストまたはJSON | テキスト・画像など(報道) |
1回の問いの数 | 最大1,000問 | — | — | 最大400問(報道) |
文脈の上限 | 262,144トークン | 64Kトークン | 公式の記載なし | — |
置き場所 | Gemini API・AI Studio | TypeSafe の API ほか | Azure の Foundry・OpenRouter | OpenAI の API |
OpenAI の Decisions API は、9月29日に限定プレビューとして出たあと、10月22日に一般提供になったと複数の海外メディアが報じています。表の OpenAI の列はその報道に基づく値で、私たちはまだ公式の仕様書で確かめていません。経緯は Decisions APIとは|確信度を自分で測る手順 にまとめています。
選ぶときの目安は次のとおりです。
- 画像・音声・動画・PDFを、そのまま判定にかけたい:Gemini Decisions API。ほかのAPIでは、別のモデルで先に文字に起こす工程が要ります
- 1つの材料に、何十問も一度に聞きたい:Gemini Decisions API。共有の材料が1回分の課金で済みます
- テキストだけで、単価を下げたい:Jev。入力の単価は Gemini の半分以下です
- Azure の契約と権限の中で使いたい:Decision-1(詳しくは Decision-1とは|Jevと同じAPIで何が違う)
自社の実測——同じ形のAPIでも、外し方は違う
問いの書き方が揃っているなら、どれを使っても同じ結果になるのでしょうか。私たちの実測では、答えは「同じにはならない」でした。
2026年11月2日に、自社の「Xのいいね検索」で判定役を選ぶため、Jev と Cloudflare の Clef(Workers AI で10月1日に公開された判定モデル)を同じ課題で比べました。Clef も Jev と同じ noul・choice・score の形で問いを受け取ります。課題は「この投稿は、検索した話に関係するか」。検索語12個に対して候補241件を判定させ、正解は Claude(Opus)が0〜3で付けた点数の2以上としました。
Jev | Clef | |
|---|---|---|
F1(適合率と再現率の釣り合い) | 0.81 | 0.86 |
関係あり/なしの分けやすさ(AUC) | 0.92 | 0.96 |
関係ありを取りこぼさない割合(再現率) | 0.93 | 0.83 |
「言葉に触れているだけ」の66件を関係ありにした数 | 30件 | 9件 |
1件の速さ(中央値・手元から) | 197ミリ秒 | 537ミリ秒 |
この比較の費用(概算) | 0.0076ドル | 0.0312ドル |
差が出たのは、検索した言葉に触れてはいるが中身は別の話、という投稿でした。Jev は関係ありを取りこぼさない代わりに隣の話題も拾い、Clef は余計なものを落とす代わりに少し取りこぼしました。問いの書き方も答えの形も同じなのに、外し方の癖はモデルごとに違うということです。私たちは、余計な投稿が混ざらないことを優先して Clef を判定役に採用しました。
もう1つ分かったのは、確信度の分けやすさ(AUC)でも Clef が Jev を上回ったことです。9月に Jev と構造化出力の LLM を比べたときは、「迷ったときに低い確信度を出す」のが Jev だけの強みに見えました(経緯は JevはなぜLLMより速く安いのか|仕組みと9つの苦手)。判定専用モデルが増えた今は、それもモデルを選ぶ条件の1つにすぎなくなりました。
Gemini Decision 1 について、公式ブログは自社のベンチマークで較正の誤差が最も小さいと書いています。ただ、数値は画像で示されているだけで、比べた相手も Gemini 3.5 Flash-Lite 以外は名前が出ていません。上の実測のとおり、同じ形の API でも課題が変われば順位は入れ替わります。自社の課題で、いま使っているモデルと並べて測るまで、乗り換えは決めないほうがよいと私は考えます。
試す前に知っておきたい、公式ドキュメントの5つの制約
公式ドキュメントには、設計に直接効く制約が書かれています。どれも、知らずに組むと誤判定や想定外の費用につながります。
1. choice は「どれも当てはまらない」ときも、どれかを選ぶ
選択肢の確率は必ず合計1になるので、どの選択肢も合わない入力でも、いずれかが選ばれます。公式ドキュメントは対策として、確信度でしきい値を切る・はい/いいえの範囲確認と組み合わせる・説明付きの「その他」の選択肢を入れる、の3つを挙げています。
注意したいのは選択肢の名前です。選択肢は名前のアルファベット順に並べ替えられるので、none_of_the_above のように「最後に来るはず」という前提の名前は付けないよう、公式ドキュメントは勧めています。「その他」には other のような名前と、何をその他とするかの説明を書きます。
2. はい/いいえの確率は0.01〜0.99に収まる
noul の値は0.01〜0.99の範囲に丸められます。「0.995以上なら自動で通す」のような線を引くと、一度も条件を満たしません。しきい値は、自社のデータに正解を付けたうえで、この範囲の中で決めます。
3. キャッシュも Batch も使えない
文脈キャッシュ・Batch API・Flex/Priority の推論には対応していません。長い規程や商品カタログを毎回材料に入れる設計にすると、そのたびに全量が課金されます。共有の材料にまとめて1回のリクエストで多くの問いを聞く形にすると、費用を抑えられます。
4. 問いの文はテキストだけ・会話の履歴は渡せない
画像や音声を渡せるのは判定の材料(input)だけで、問いの文はテキストに限られます。会話の履歴・思考・ツール呼び出しの記録も入力にできません。チャットの流れを踏まえた判定をしたいなら、必要な部分を先にテキストにまとめて材料に入れます。
5. 提供は Gemini API の v1beta のみ
いまは Gemini Developer API の v1beta でだけ使えます。Google Cloud の Gemini での提供は「近日対応」とされていて、時期は書かれていません。社内の決まりで Google Cloud の契約の中でしか外部の AI を使えない会社は、提供の開始を待つことになります。
あわせて、制約とは別に入れておきたい確認が1つあります。私たちが読んだ、判定モデルを本番で回している公開の実装には、返ってきた答えが候補の中にあり、しかも確率がいちばん高いものかを、呼び出す側でも確かめる処理が入っていました。「構造上は壊れない」と説明されていても、ネットワークの不具合や仕様の変更で想定外の値が来ることはあります。数行で済む確認なので、最初から入れておくことを勧めます。
最初の1回を呼ぶまでの手順
公式ドキュメントのクイックスタートの流れを、短くまとめます。
- Google AI Studio で API キーを発行する(顧客のデータを扱うなら有料枠で)
- Python なら
google-genaiの3.2以降、JavaScript なら@google/genaiの最新版を入れる。REST で直接呼んでもよい https://generativelanguage.googleapis.com/v1beta/decisionsに、model・input・questionsを送る
問い合わせを担当に振り分ける問いは、たとえば次のように書きます(公式ドキュメントの例をもとに、日本語の問い合わせに置き換えたもの)。
curl -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-decision-1",
    "input": "月曜に注文した青いマグカップが、水曜に割れた状態で届きました。",
    "questions": {
      "is_damaged": {
        "type": "noul",
        "instructions": "商品は破損した状態で届いたか。"
      },
      "team": {
        "type": "choice",
        "instructions": "この問い合わせはどの担当が対応すべきか。",
        "criteria": {
          "billing": "請求・支払い・返金",
          "logistics": "配送・破損・交換",
          "support": "使い方・アカウントの質問",
          "other": "上のどれにも当てはまらない"
        }
      }
    }
  }'
答えは、問いに付けた名前ごとに answers の中に返ってきます。is_damaged には「はい」の確率と確信度が、team には選ばれた担当・全担当の確率・確信度が入ります。usage の total_output_tokens は常に0です。
入力が安全性の基準に引っかかった場合は、HTTP 400 とエラーの種類(safety など)が返ります。判定が返らない場合の扱い(人に回す・もう一度送る)は、最初から決めておきます。
判定モデルの呼び出しを自分で組み立てた手順は、Jev の例ですが Jevの使い方|Vercel経由で5分・3つの型と確信度の実測 でも紹介しています。問いの書き方はそのまま流用できます。
よくある質問
Gemini Decisions API は日本語で使えますか?
公式ブログにも公式ドキュメントにも、対応言語の記載はありません。日本語で使うなら、自社のデータに正解を付けた20〜50件で、正解率と確信度の分かれ方を必ず測ってください。私たちが Jev で確かめたときも、基準の文言を少し変えただけで点数が動きました。
無料で試せますか?
Google AI Studio に試作用の無料枠があります。ただし無料枠で送った内容は Google の製品改善に使われると公式料金ページに書かれているので、実際の顧客データは有料枠で扱ってください。
Gemini 3.5 Flash-Lite などの普通のモデルで、JSON を返させるのと何が違いますか?
答えの形を揃えるだけなら、普通のモデルの構造化出力でもかなりの精度が出ます。私たちの実測でも、選択肢を閉じた形で渡せば、形の崩れや選択肢の外の値はほとんど出ませんでした。違いが出るのは、確信度が業務で使える数字になっているかと、速さです。公式ブログは、ベンチマーク全体で Gemini 3.5 Flash-Lite より5倍近く安いとも書いています。
理由の説明は返ってきますか?
返ってきません。出力は確率と確信度だけです。人に判定の理由を示す必要がある場面では、Gemini Decisions API で振り分けたあと、必要なものだけを生成型のモデルに渡して説明を書かせる組み合わせにします。
まとめ
- Gemini Decisions API は、文章を生成せず、はい/いいえ・選択肢・段階評価の答えを確信度つきで返す判定専用の API(2026年11月11日発表・モデルは
gemini-decision-1) - 料金は入力100万トークンあたり0.10ドル・出力は0。共有の材料は1回分だけ課金され、1回で最大1,000問を聞ける
- ほかの判定 API との一番の違いは、画像・音声・動画・PDFをそのまま判定の材料に渡せること
- 選択肢は必ずどれかが選ばれる・はい/いいえは0.01〜0.99に収まる・キャッシュと Batch が使えない、の3点は設計の前に押さえる
- 同じ形の API でも外し方の癖は違う。乗り換えは、自社の課題でいまのモデルと並べて測ってから決める
判定専用モデルは、選ぶ自由が増えたぶん、自社のデータで測る手間が要るようになりました。株式会社Fyveは、こうした新しい API を自社の仕組みで実際に動かし、測った結果をもとに使い分けを判断しています。
Jevで得する仕事、損する仕事
Claude・GPTとの使い分けは3つの質問で決まる(全11ページ)
Jevは、渡した候補から選ぶことだけをするAIです。同じ判断をJev・Claude・GPTなど5つのAIにさせて測ると、正解率は88〜100%で並びました。差が出たのは速さと回数で、Jevは1回0.5秒と他の3〜5倍速く、1回の費用はGPT-5.6 Solの85分の1。だから任せるのは「選ぶだけの判断を、何度も・急いで回す仕事」です。書く・考える・説明する仕事はClaude・GPTに残します。
- 5つのAIに同じ判断をさせた実測(正解率・速さ・費用・外したときの自信)
- Jevに任せる仕事/Claude・GPTに残す仕事の一覧を、根拠つきで
- 候補を書けるか・何度も回すか・理由を見せるか——3つの質問で決める
- Claude Codeへの頼み方と、判断基準の書き方
メールアドレス登録で他にも様々な資料を閲覧できます
 +13
PDF 22点・合計538ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。