AIエージェントが遅い原因|測って分かった2つの無駄

「AIエージェントにまとめて作業させたら、思ったより遅い」「請求を見たら、想像していた額の何倍かになっていた」——AIに定常業務を任せ始めた人が、最初につまずくのはほぼここです。
結論から言うと、AIに任せた仕事の時間と費用は、仕事の量そのものではなく「何を持たせて、何度読み直させるか」で決まります。私が自分の工程を2か所測ったところ、片方は1往復あたり平均26万トークンを読み直していて、もう片方は96分のうち66分が「考えている時間」でした。どちらも、作業そのものの重さとは無関係でした。
株式会社Fyveは中小企業のAI活用を伴走支援しており、記事の生成やデータの整形といった定常業務を自前のAIエージェントに任せています。この記事では、私が実際に測って直した2か所を、前後の数字と直し方まで具体的に書きます。一般論ではなく、自分の工程を計測した記録です。
結論|AIエージェントが遅い原因は、たいてい「渡し方」にある
先に答えを置きます。AIエージェントの処理が遅い・高いとき、疑う順番は次の3つです。
- 1. 持たせすぎ——調べた資料や取得したページの中身を、会話の中にそのまま置いている
- 2. 考えさせすぎ——機械的に決まる処理まで、エージェントに判断させている
- 3. 直列——順番に待つ必要がない処理を、1件ずつ順番に流している
私が測ったのは1と2です。そしてどちらの直し方も、結果として「AIを外す」方向でした。AIの使い方を工夫したのではなく、AIに渡す範囲を狭めたら速くなり、安くなりました。
これは直感と逆です。詰まったとき、手は「もっと賢いモデルに替える」「もっと丁寧に指示を書く」「エージェントを増やす」方向に動きます。けれど測ってみると、ボトルネックはモデルの賢さではなく、工程の設計のほうにありました。
測る前に私が持っていた思い込み
私は自分が運営している情報サイト向けに、記事をまとめて作る流れをAIエージェントで組んでいます。1回に約10本をまとめて処理する設計です。
その1本目を回したとき、想定よりはるかに時間がかかりました。そのとき私が立てた仮説は「扱っている分量が多いから重いのだろう」でした。記事10本ぶんの調査と執筆をさせているのだから、時間がかかるのは当然だと考えたのです。
この仮説が間違っていたことは、計測して初めて分かりました。重かったのは仕事そのものではなく、仕事のために持たせていた荷物と、機械でいい所に置いたエージェントでした。
先に言っておくと、私は最初からこう作っていたわけではありません。普通に作って、測って、直しました。この順番を隠すと「最初から分かっていた人の話」になって再現性が落ちるので、正直に書いておきます。
無駄1|調べたページの全文を、会話の中に置いていた
1つ目は、外部のページを調べる工程です。
最初の実装では、調査で取得したページの本文を、そのまま会話の中に出していました。AIに「このページを読んで」と渡すなら、本文を渡すのが自然だと思ったからです。
ところが、これをやるとその本文は1回読まれて終わりではなく、その後のやりとりのたびに読み直されます。
公式の機構|過去のやりとりは「完全に保持されて」入力に入る
ここは感覚で語らず、一次情報を確認しておきます。Anthropicの公式ドキュメント(コンテキストウィンドウの解説・2026年10月3日時点)は、会話が進むときの振る舞いをこう書いています。
- 会話が進むにつれて、ユーザーのメッセージとアシスタントの応答はコンテキストウィンドウの中に積み上がり、過去のターンは完全に保持される(原文: previous turns are preserved completely)
- 各ターンの入力フェーズには、それまでの会話履歴のすべてと、今回のメッセージが含まれる(原文: Contains all previous conversation history plus the current user message)
- リクエストに入るものはすべてコンテキストウィンドウに数えられる——システムプロンプト、messages 内のすべてのメッセージ(ツールの実行結果・画像・ドキュメントを含む)、そしてツール定義
つまり、1回の調査で取得した本文を会話に置くと、その本文はその会話が続くかぎり、毎回の入力に乗り続けます。10往復すれば10回ぶん入力に乗る、という単純な話です。
ここは多くの人が意図せず踏む所です。「貼った時点で1回ぶん」と感じるのに、実際には「貼ったあと、やりとりの回数ぶん」かかります。
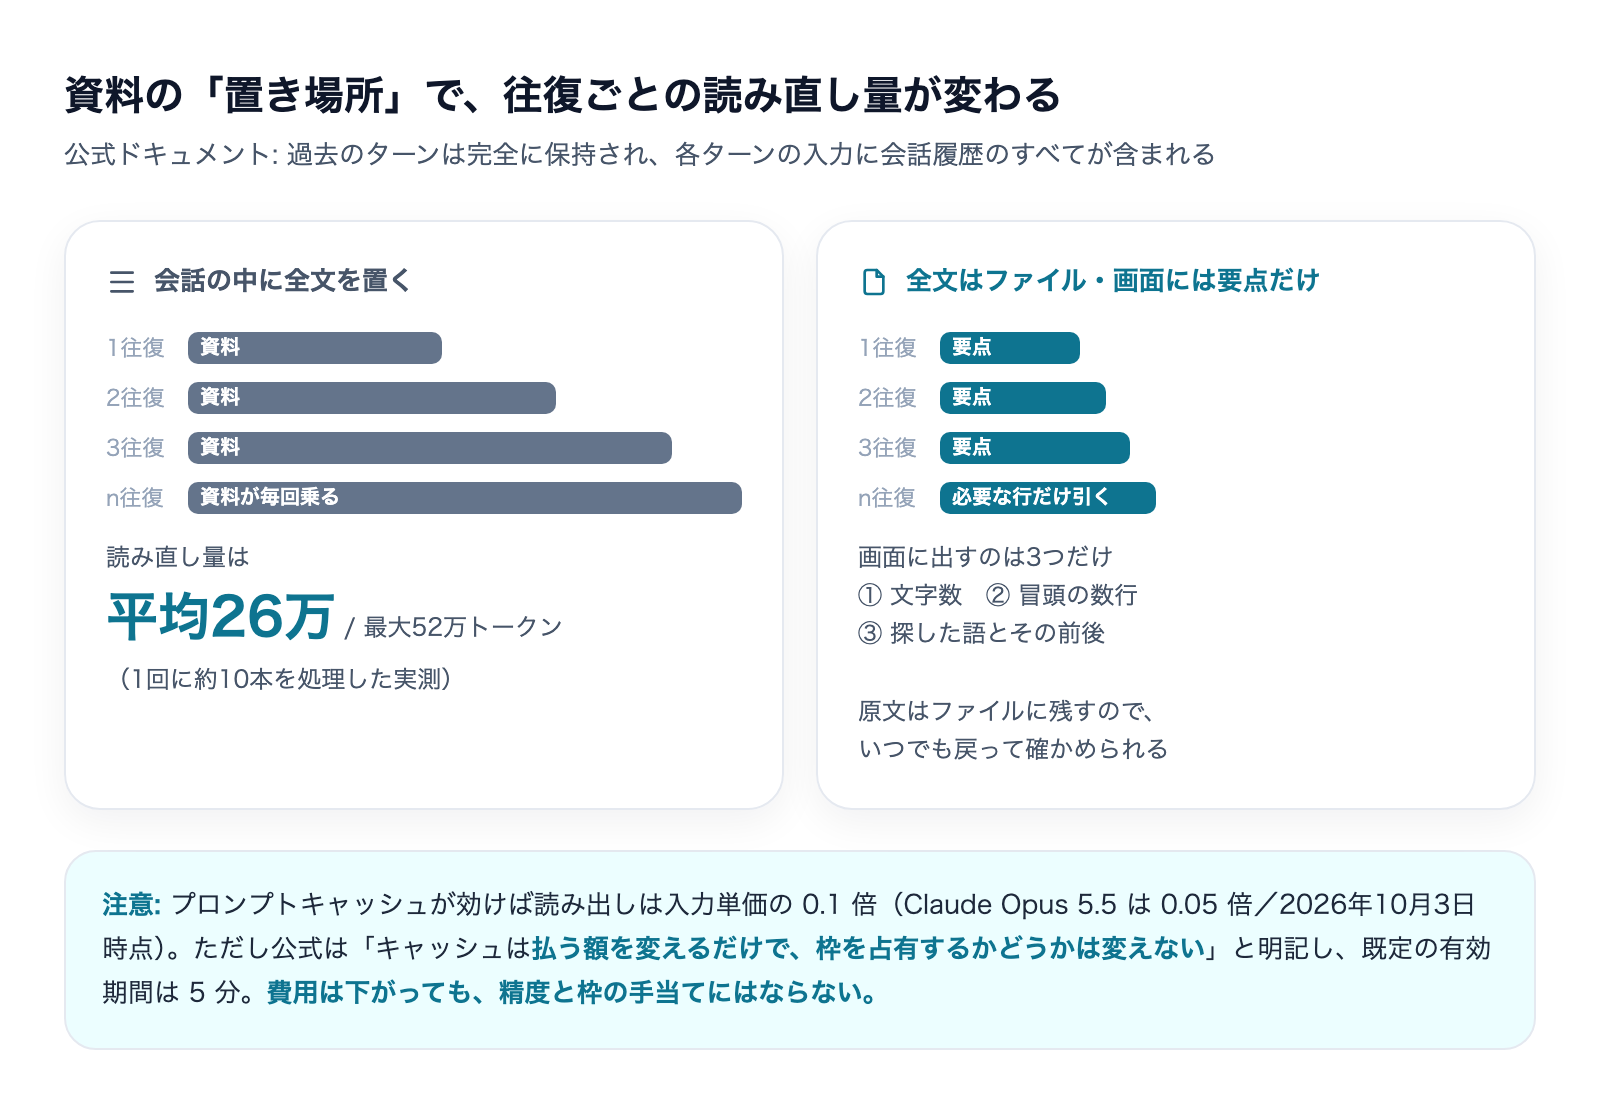
実測|1往復あたり平均26万トークン、最大52万トークン
私の工程で、この読み直し量を実際に測りました。1本目として約10本を処理したときの数字です。
- 執筆を担当させていたエージェントが1回の往復あたりに読み直していた量は、平均で約26万トークン
- 最大では約52万トークンに達していた
日本語は1文字がおよそ1〜3トークンに相当します。26万トークンは、ざっくり言えば10万字前後の文章を、1往復するたびに読み直させていたことになります。単行本1冊ぶんを毎回めくり直させながら、1段落だけ書き足させていたようなものです。
この数字を見て初めて、「重いのは仕事ではなく荷物だ」と分かりました。
🔴 ただし「読み直し量=そのまま請求額」ではない
ここは正確に書かないと読者を誤解させるので、一次情報で押さえます。読み直した量が、そのまま満額の請求になるわけではありません。プロンプトキャッシュが効いている場合、同じ前置きは「キャッシュからの読み出し」として扱われ、単価が下がります。
Anthropicの公式ドキュメント(プロンプトキャッシュの解説・2026年10月3日時点)によると、キャッシュヒット時の読み出しは標準的なモデルで入力単価の0.1倍、Claude Opus 5.5では0.05倍です(キャッシュへの書き込み側は5分有効で1.25倍、1時間有効で2倍)。価格は改定される領域なので、判断に使う前に必ず最新の公式価格ページで確認してください。
では「キャッシュが効くなら放っておいていいのか」というと、そうではありません。同じ公式ドキュメントが、こう明記しています。
- キャッシュされた前置きもコンテキストウィンドウは占有し続ける。プロンプトキャッシュが変えるのはそのトークンに対していくら払うかであって、数えられるかどうかではない(原文: changes what you pay for those tokens, not whether they count)
- キャッシュの有効期間は既定で5分。使われるたびに追加費用なしで更新されるが、間が空けば切れる
この2点が実務では決定的です。費用は10分の1になっても、枠は食ったままで、しかも工程の途中で待ちが入れば5分でキャッシュは切れます。間欠的に動く定常業務のエージェントは、まさにこの「間が空く」側にいます。
費用より先に効くのは、精度のほうだった
そして持たせすぎの本当の害は、請求額ではありません。公式ドキュメントは、トークン量が増えたときに何が起きるかをこう説明しています。
トークン数が増えると、正確さと想起の能力が劣化する——この現象は context rot と呼ばれている、と公式が名前を付けて書いています。そして「コンテキストは多ければ自動的に良いわけではない」「どれだけ空きがあるかと同じくらい、何を入れるかを選ぶことが重要になる」と続けます。
つまり全文を会話に置き続けることは、遅くなる・高くなるだけでなく、出力の質を下げる方向にも働きます。私が測ったのは時間と量でしたが、直すべき理由としてはこちらのほうが重いと考えています。
直し方|全文はファイルに置き、画面に出すのは3つだけ
直したあとの設計はこうです。
- 取得したページの全文は、ファイルとして保存する(会話の中には出さない)
- 会話の中に出すのは3つだけ——①その資料の文字数 ②冒頭の数行 ③探したい語とその前後
- 中身が必要になったら、そのときだけファイルを検索して、必要な行だけ読む
要点は「要約を作って渡す」ではなく、原文を失わずに、原文を会話に置かないことです。要約してから渡す方式だと、後から「原文ではどう書いてあったか」を確かめられなくなります。引用の逐語性や数字の正確さが要る仕事では、これは致命的です。
ファイルに原文を残して検索で引く方式なら、会話は軽いまま、原文にはいつでも戻れます。持たせる量を削りながら、確認できる範囲は減らさない——この両立が狙いでした。
なぜ「文字数」を最初に出すのか
地味ですが、画面に出す3つのうち①文字数がいちばん効きました。
文字数が分かると、AIも私も「この資料は全部読む価値があるのか、それとも特定の語だけ引くべきか」を先に判断できます。文字数を見ずに本文を渡すと、判断の機会そのものが消えて、ただ全部が持ち込まれます。
Anthropicは送信前に消費量を見積もるためのトークンカウントAPIも用意しています。工程の中で「渡す前に量を測る」という段を1つ作るだけで、持たせすぎはかなり防げます。
無駄2|画像を1本ずつ、エージェントに作らせていた
2つ目は、記事のカバー画像を用意する工程です。
最初の実装では、記事1本ごとに担当のエージェントを立て、そのエージェントに「この記事に合うカバー画像を作って」と任せていました。記事の内容を理解している担当が作るのだから、いちばん良いものが出るはずだと考えたからです。
実測|96分かかって、画像生成そのものは30分だった
1本目として約10本を処理したときの内訳です。
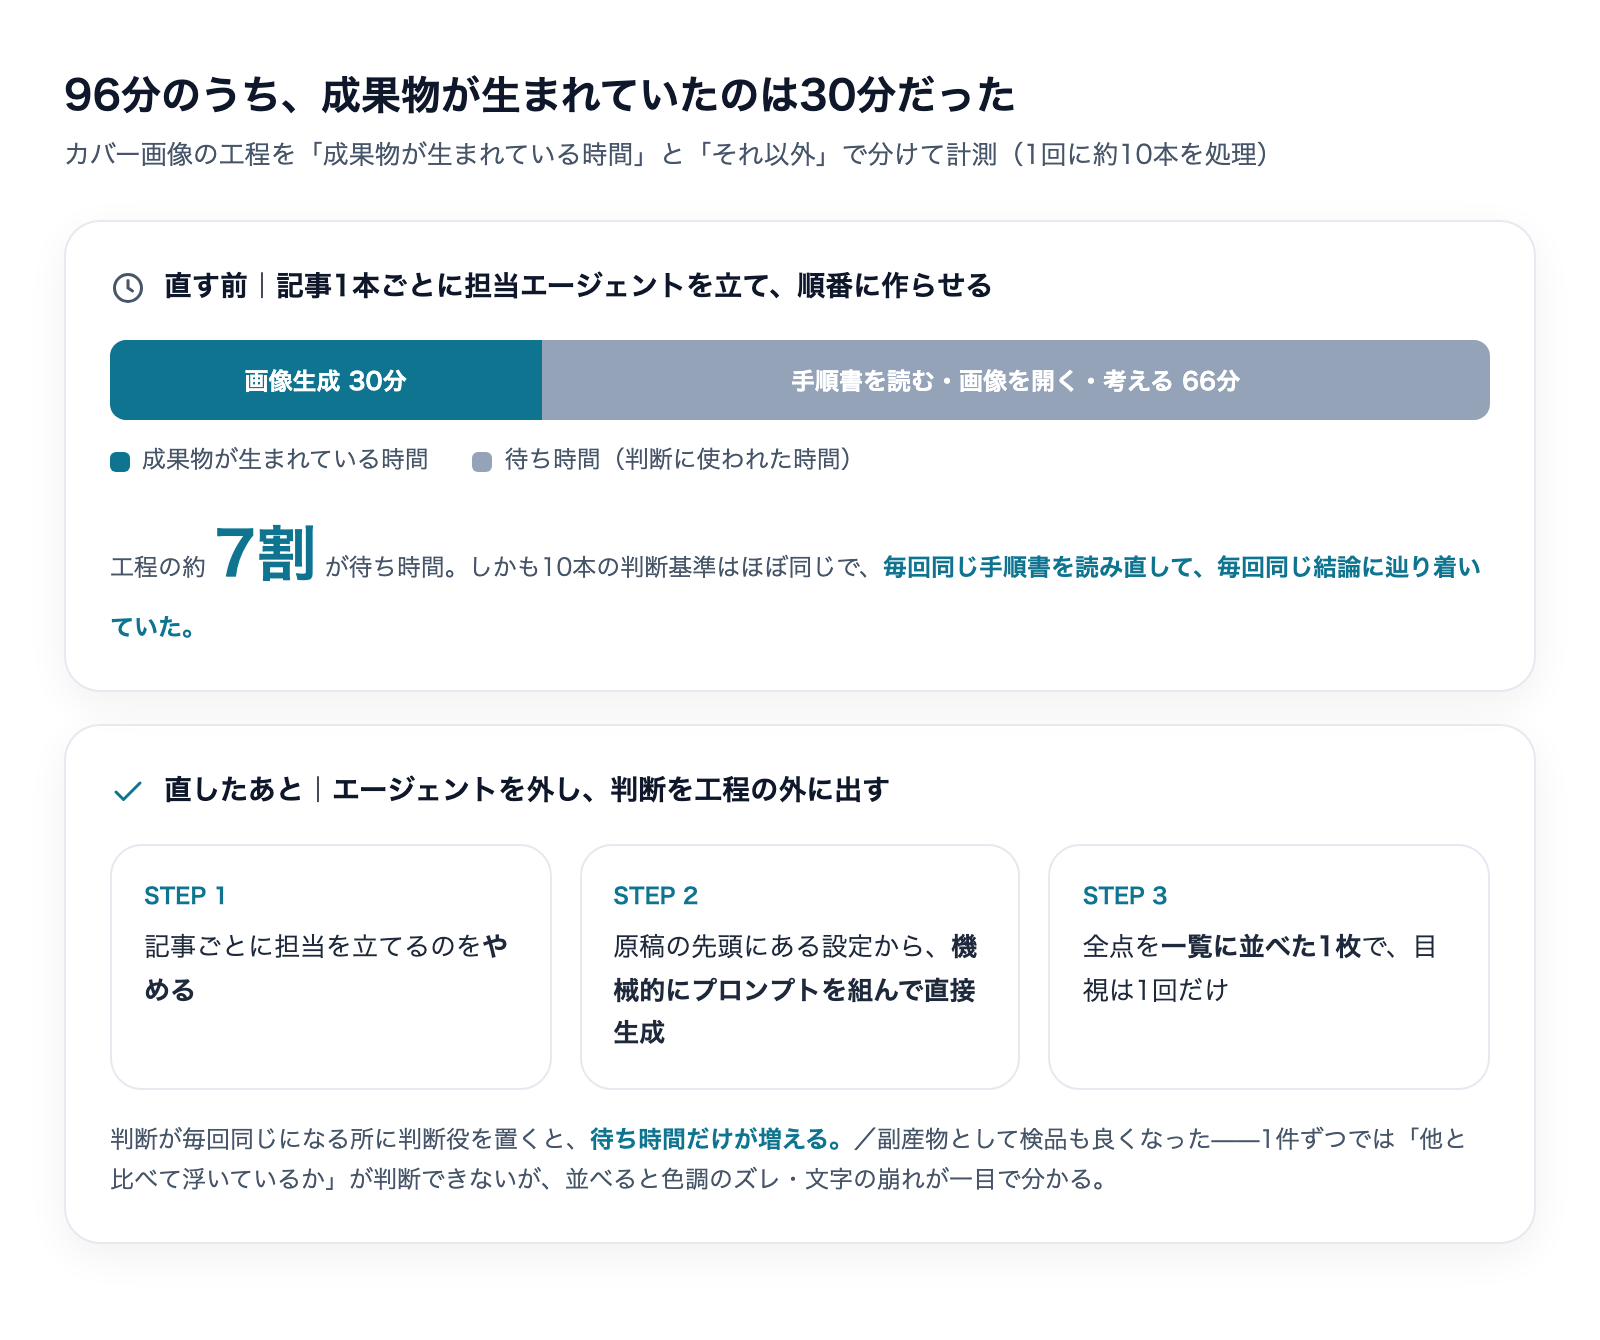
- カバー画像の工程に合計96分かかっていた(全体の約3分の2)
- そのうち画像生成そのものに使われていたのは30分
- 残りの66分は、エージェントが手順書を読み、生成した画像を何度も開き、どうするか考えている時間だった
比率で言えば、この工程の約7割は待ち時間でした。画像を作るための時間ではなく、画像を作る判断をするための時間です。
しかもこの66分は、良い判断に使われていたわけでもありませんでした。10本ぶんの判断基準は、実際にはほぼ同じだったからです。1本ごとに別の担当が、毎回同じ手順書を読み直して、毎回同じ結論に辿り着いていました。
直し方|エージェントを外して、原稿の設定から直接作る
直したあとはこうです。
- エージェントを使わない。記事ごとに担当を立てるのをやめた
- 各原稿の先頭に書いてある設定(タイトル・主題・使う色などの指定)から、機械的にプロンプトを組んで直接生成する
- 目視の確認は、生成した全点を一覧に並べた画像を1枚作り、それを1回だけ見る
ここで捨てたのは「記事ごとに最適な絵を考えさせる」という発想です。判断が毎回同じになる所に判断役を置くのは、ただの待ち時間でした。
目視を「一覧で1回」にすると、むしろ検品が良くなった
副産物として、確認の質が上がりました。
1本ずつ順番に確認していたときは、前の画像を覚えていないので「これは他と比べて浮いていないか」が判断できません。一覧にして並べると、色調が揃っていないもの・文字が崩れているもの・1枚だけ雰囲気が違うものが、一目で分かります。
検品を工程の中に埋め込む設計については、別の記事で詳しく書いています。

2つの無駄は、同じ教訓の裏表だった
並べてみると、この2つは同じことを別の角度から言っています。
| 無駄1(調査工程) | 無駄2(画像工程) |
|---|---|---|
症状 | やりとりが進むほど重くなる | 工程の7割が待ち時間 |
原因の型 | 持たせすぎ | 考えさせすぎ |
具体的に何を | 資料の全文を会話に置いた | 機械で決まる所にエージェントを置いた |
測った数字 | 1往復あたり平均26万・最大52万トークンの読み直し | 96分のうち画像生成は30分(残り66分は判断) |
直し方 | 全文はファイルへ。画面には文字数・冒頭・検索の前後だけ | エージェントを外し、原稿の設定から直接生成 |
方向 | どちらも「AIに渡す範囲を狭める」方向 | |
私はもともと、複雑な構成を好みません。最小構成で済むならそちらを選び、自動化より手動を選ぶこともあります。今回の2つはその考え方の実例になりました。改善は「AIを使う量を増やす」ことではなく、「AIに渡す範囲を狭める」ことでした。
AIに任せる範囲を広げる方向の改善もあります。ただそれは、渡し方を直したあとに考えることです。持たせすぎと考えさせすぎを抱えたまま範囲を広げると、無駄も一緒に増えます。
もう1つ、見落としやすい荷物——ツール定義とツールの実行結果
私が測ったのは資料の全文でしたが、公式ドキュメントを読み直して気づいた荷物がもう2種類あります。自分で工程を組む人は、ここも持たせすぎの対象になります。
先に引いたとおり、公式は「リクエストに入るものはすべてコンテキストウィンドウに数えられる」として、システムプロンプト・messages 内のすべてのメッセージ(ツールの実行結果・画像・ドキュメントを含む)・ツール定義を名指ししています。つまり次の2つは、会話に資料を貼っていなくても積み上がります。
- ツール定義——エージェントに持たせている道具の説明文。道具を増やすほど、毎回の入力に乗る前置きが太ります
- ツールの実行結果——検索やファイル読み込みの戻り値。これも「過去のターン」として保持され続けます
私の工程で言えば、資料の全文を会話から外しても、取得処理の戻り値をそのまま会話に返していれば同じことが起きます。出口を塞いでも、裏口が開いていれば荷物は入ってきます。
Anthropicはこの2つに対する公式の手当ても用意しています(2026年10月3日時点)。ツール定義側はツールの文脈管理や、定義の読み込みを後回しにする仕組み。実行結果側は、サーバー側で過去を要約するコンパクションや、古いツール結果を消すコンテキスト編集です。
ただし私の立場としては、これらは「持たせすぎを前提にした後始末」です。先にやるべきは、そもそも何を会話に置くかを決めることだと考えています。後始末の仕組みは、決めたうえで足りないときに足すものです。
自分の工程で同じ所を探す4つの問い
同じ診断を自分の工程に当てるなら、次の4つを順に見てください。測定の道具は要りません。
問い1|会話の中に、ファイルで足りるものが置かれていないか
取得したWebページ、PDFの中身、議事録の全文、データの一覧——これらが会話に直接置かれていないかを見ます。
判断の基準は単純です。「この中身は、今の1手のために全部必要か」。必要なのが一部なら、全文はファイルに置いて、必要な範囲だけを渡します。
問い2|やりとりが進むほど遅くなっていないか
同じような作業なのに、後半のほうが明らかに遅い・高いなら、持たせすぎの典型的な症状です。公式が書いているとおり、過去のターンは完全に保持されたまま入力に乗り続けるからです。
対処は会話を切ることではなく(切れば持たせた資料ごと消えます)、最初から会話に置かないことです。
問い3|判断が毎回同じになる所に、判断役を置いていないか
10件処理して10件とも同じ結論になるなら、そこは判断ではなく手順です。手順に判断役を置くと、待ち時間だけが増えます。
見分け方としては、「その工程の出力を10件並べてみて、違いが説明できるか」を試すのが早いです。説明できないなら、機械に落とせます。
問い4|確認を1件ずつやっていないか
検品は、まとめて並べたほうが精度が上がります。1件ずつ見ると「他と比べて変か」が判断できないからです。
並列化そのものが割に合う条件については、別の記事で整理しています。
どこを自動化しないか——AIを外す判断の基準
「AIを外す」と書くと後退のように聞こえますが、私は次の3つを基準にしています。
- 出力のばらつきが要らない所は、機械に落とす。毎回同じ形で良いものに判断役は不要
- 人が最後に目で見る所は、まとめて1回にする。回数を増やすより、比較できる形にするほうが効く
- 原文を失う圧縮はしない。要約で渡すより、原文を残して必要な範囲だけ引く
3つ目は特に重要です。費用を下げる方向の工夫は、たいてい「情報を削る」形になります。けれど削った情報は、後から確かめたいときに戻ってきません。削るべきは「毎回持ち歩く荷物」であって、「保管している原本」ではありません。
トークン消費そのものを抑える一般的な手当て(使用量の確認方法、プランの見直し、会話の切り方など)は、別の記事にまとめています。
正直に書いておくこと
この記事の限界を3つ書いておきます。
1つ目。最初からこう作っていたわけではありません。 普通に作って、1本目を回して、測ってから直しました。測るまで気づいていませんでした。「設計を先に考えれば避けられる」という話にはできません。
2つ目。測ったのは私の1つの工程です。 1回に約10本という規模の、記事を作る流れでの数字です。工程の性質が違えば比率は変わります。26万トークンや96分という数字をそのまま自分の環境の予測に使わないでください。使えるのは「どこを測れば分かるか」という形のほうです。
3つ目。費用の話は、キャッシュの効き方で変わります。 読み直し量がそのまま請求額になるわけではないことは本文に書きました。自分の環境でいくらになるかは、実際の利用明細と公式の価格ページで確認してください。この記事が言えるのは「量が積み上がる機構は公式が明記している」ところまでです。
よくある質問
Q. モデルを安いものに替えれば解決しませんか
単価は下がりますが、持たせすぎと考えさせすぎは残ります。しかも安いモデルに替えると判断の質が落ちるため、「毎回同じ判断をさせている所」では効果が出るのに、「本当に判断が必要な所」では品質が落ちます。先に工程を直したほうが、どのモデルを使っても効きます。
Q. プロンプトキャッシュを有効にすれば済む話では
費用の面では大きく効きます。公式の記載では、キャッシュヒット時の読み出しは標準的なモデルで入力単価の0.1倍です(2026年10月3日時点)。ただし公式も明記しているとおり、キャッシュは払う額を変えるだけで、コンテキストウィンドウを占有するかどうかは変えません。既定の有効期間は5分なので、間欠的に動く工程では切れることもあります。費用の手当てとしては有効で、精度と枠の手当てにはなりません。
Q. 要約してから渡せば軽くなりますか
軽くはなります。ただし、後から「原文にはどう書いてあったか」を確かめられなくなります。引用の逐語性や数字の正確さが要る仕事では、この代償のほうが大きいです。原文はファイルに残し、必要な範囲だけ引く形をおすすめします。
Q. エージェントを減らすと、品質は落ちませんか
私の工程では落ちませんでした。減らしたのは「判断が毎回同じになる所」だけで、判断が必要な所は残しています。むしろ検品を一覧で1回にしたことで、比較ができるようになり精度は上がりました。減らすべきかの見分け方は、本文の「問い3」に書いた「出力を10件並べて違いが説明できるか」です。
Q. 社内に開発者がいなくても取り組めますか
本文の4つの問いは、仕組みを作れなくても診断できます。「資料を会話に貼っていないか」「後半のほうが遅くなっていないか」「毎回同じ結論になる所に判断させていないか」「確認を1件ずつやっていないか」——この4つは、使っている人の感覚で答えられます。直す段で手が要るなら、そこから相談してください。
Q. 何から測り始めればいいですか
いちばん時間がかかっている工程を1つ選び、その中で「成果物が実際に生まれている時間」と「それ以外の時間」を分けて計るだけで十分です。私の場合は、96分のうち30分しか成果物を生んでいないと分かった時点で、直す場所が確定しました。
まとめ
AIエージェントが遅い・高いとき、原因は仕事の量ではなく渡し方にあることが多いです。私が自分の工程で測ったのは次の2つでした。
- 持たせすぎ——資料の全文を会話に置き、1往復あたり平均26万・最大52万トークンを読み直させていた。公式ドキュメントは「過去のターンは完全に保持される」と明記しており、これは設定ミスではなく仕様どおりの積み上がりです
- 考えさせすぎ——機械で決まる画像生成にエージェントを置き、96分のうち66分を判断に使っていた
直し方はどちらもAIに渡す範囲を狭める方向でした。全文はファイルに置いて必要な範囲だけ引く。判断が毎回同じになる所は機械に落とす。目視はまとめて1回にする。
そして測る前に、私はどちらも「仕事が重いから遅いのだろう」と思っていました。思い込みを外したのは、計測だけでした。1つの工程で「成果物が生まれている時間」と「それ以外」を分けて計るところから始めてください。
自社の業務のどこをAIに任せ、どこは任せないかの線引きから一緒に設計する伴走支援については、専属AI活用顧問サービスのページをご覧ください。株式会社Fyveは、仕組みを増やす前に測る順番を大事にしています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。