出力トークン上限とは|途中で切れる原因と確認手順

「AIに長い文章を書かせたら、途中でぷつんと切れた」「エラーも出ていないのに、最後まで出てこない」——出力トークン上限に当たったとき、誰もがまずこの不可解さに引っかかります。
結論から言うと、原因のほとんどは「出力トークン上限」という、入力側のコンテキストウィンドウとはまったく別の上限です。そして上限に当たってもエラーにはなりません。正常な応答として、文が途中で止まったまま返ってきます。
株式会社Fyveは毎日、AIに長文のHTMLを書かせる仕組みを自分たちの手で動かしています。この記事では、2026年9月30日に発表されたGoogleの新モデルで出力上限が一気に16倍になった件を入口に、私が実際にAPIを叩いて測った数字をもとに、出力トークン上限の正体・当たったときの見分け方・自分のモデルの上限を確かめる手順までをまとめます。
出力トークン上限とは何か — 「入れる側」とは別の上限がある
トークンの上限の話をするとき、多くの記事が扱っているのはコンテキストウィンドウです。「105万トークン入ります」「1Mコンテキストに対応」と言われるあれは、AIに渡せる情報の総量のことです。
一方で、AIが1回の応答で返せる量にも別の上限があります。これが出力トークン上限(output token limit、APIのパラメータ名では max_tokens や maxOutputTokens)です。名前が似ているせいで同じものだと思われがちですが、実務で詰まるのはほぼ出力側です。
入れる側と返す側は、桁がまったく違う
この2つは「どちらも大きい数字」ではありません。実際に測ると、桁が1つ違います。
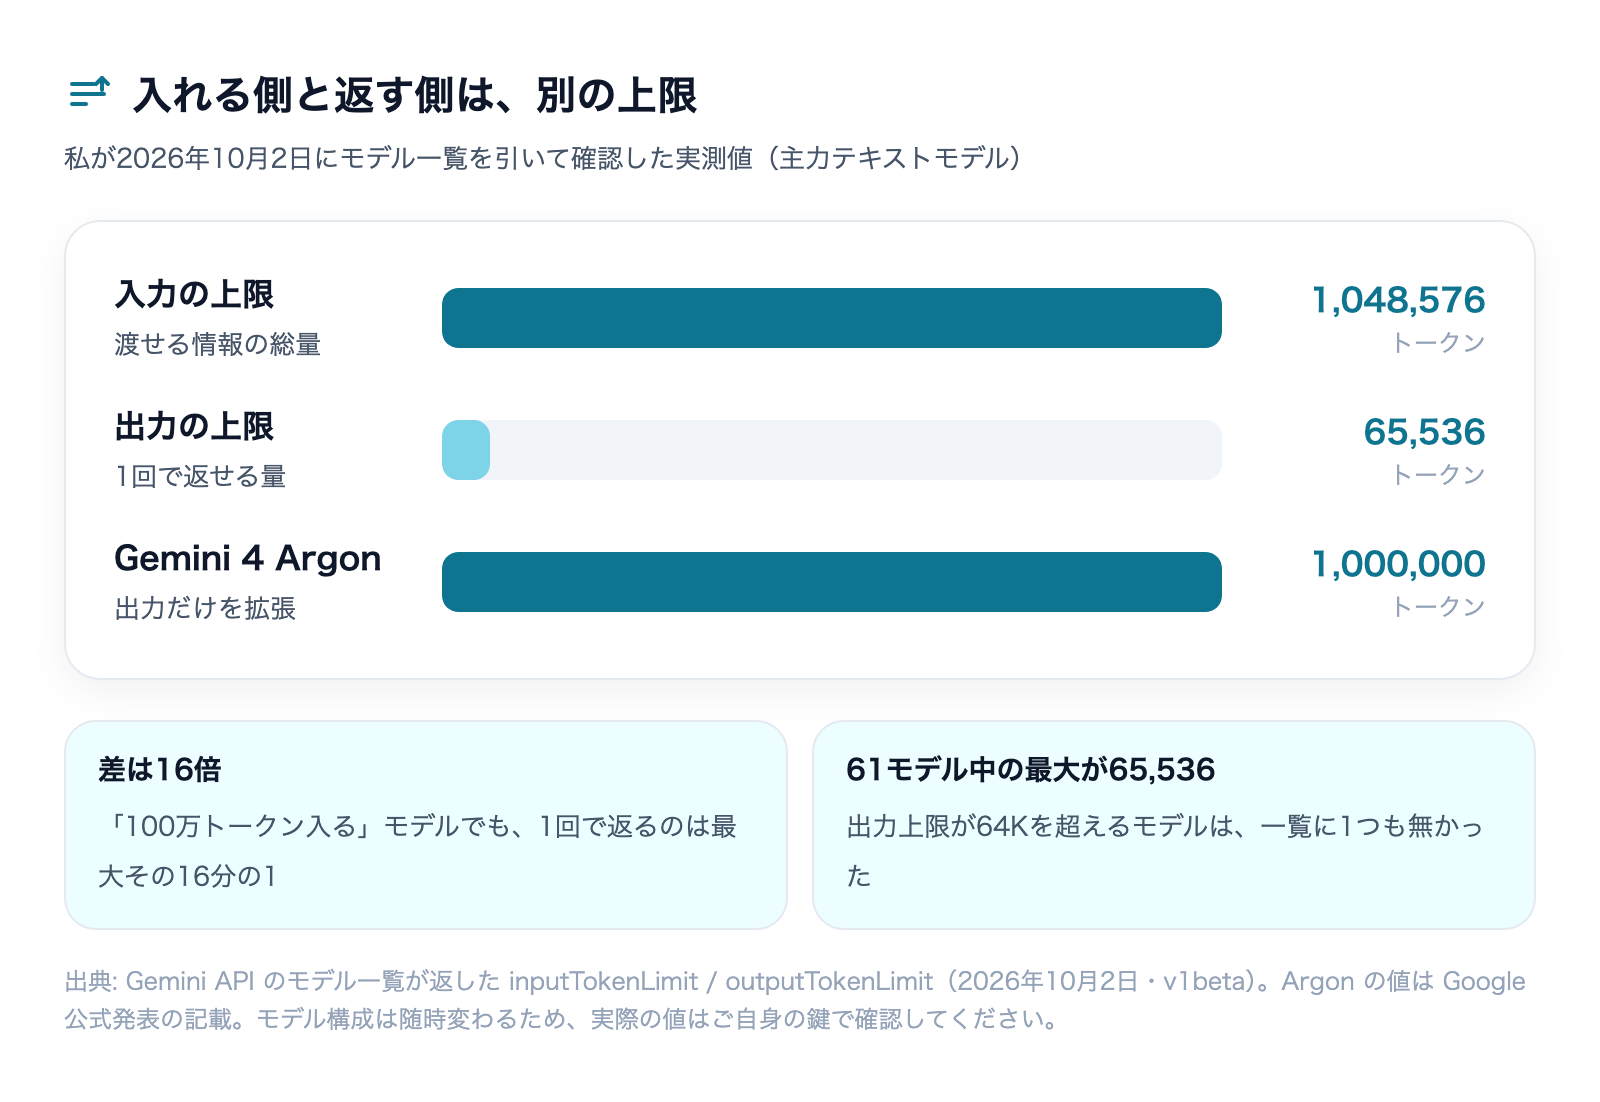
私は2026年10月2日、Gemini APIのモデル一覧エンドポイント(GET /v1beta/models)を叩いて、返ってきた全モデルの inputTokenLimit と outputTokenLimit をそのまま並べてみました。推測ではなく、提供元が機械可読な形で公開している値です。
モデル | 入力の上限 | 出力の上限 | 倍率 |
|---|---|---|---|
gemini-3.8-flash | 1,048,576 | 65,536 | 16倍 |
gemini-3.5-flash | 1,048,576 | 65,536 | 16倍 |
gemini-3.1-pro-preview | 1,048,576 | 65,536 | 16倍 |
gemini-3.8-live | 131,072 | 65,536 | 2倍 |
gemini-3.8-flash-tts | 8,192 | 16,384 | 0.5倍 |
gemini-3-pro-image | 131,072 | 32,768 | 4倍 |
※2026年10月2日時点に v1beta のモデル一覧が返した値。モデル構成は随時変わるため、実際の値はご自身の鍵で引いて確認してください。
主力のテキストモデルは、揃って入力1,048,576・出力65,536でした。入れられる量は返せる量の16倍です。つまり「100万トークン入る」モデルであっても、1回の応答で返ってくるのは最大でその16分の1しかありません。
61モデル中、出力上限が64Kを超えるものは1つもなかった
さらに踏み込んで、返ってきた61モデル全部の出力上限を集計しました。
- 65,536トークン … 38モデル
- 32,768トークン … 8モデル
- 8,192トークン … 6モデル
- 16,384トークン … 5モデル
- 1,024トークン … 1モデル
- 1トークン(埋め込み系) … 3モデル
そして61モデル中の最大値が65,536でした。64Kを超える出力上限を持つモデルは、この一覧には1つも存在しません。「入力側は100万トークンまで伸びたのに、出力側は65,536のまま据え置かれてきた」という状態が、数字で見えます。
入れる側の上限については、別の記事で日本語の文字数やA4の枚数に換算して整理しています。あわせて読むと、入力と出力で意識すべき場面が違うことがはっきりします。
Gemini 4 Argonが広げたのは「返す側」だった — 64K→1M
2026年9月30日、Googleは新しいフロンティアモデルGemini 4 Argonを発表しました。ベンチマークの話題が先に回りましたが、実務の設計を変えるのは別の一行です。
公式発表(Google公式ブログ、2026年9月30日)には、こう書かれています。
we are significantly expanding the model's output token limit to an industry-leading 1M tokens, up from the previous 64K tokens.
(出力トークン上限を、従来の64Kから業界最高水準の100万トークンへ大幅に拡張しました)
注目すべきは「up from the previous 64K」の部分です。先ほど私が実測した「61モデル中の最大値が65,536」とぴったり一致します。公式の言う「従来の64K」は、まさにいま全モデルに掛かっている天井のことでした。
つまりGemini 4 Argonで変わったのは、入力側ではなく出力側が16倍になったという点です。公式は「モデルが深く考え、1回の軌跡で数十万トークンを生成できる余裕を持つと、難しい問題を一度で解く推論の深さが新しい次元に入る」と説明しています。長い成果物を分割せずに一度で出させる使い方が、設計の選択肢に入ってきます。
ただし、2026年10月2日時点では誰も使えない
ここは勘違いしやすいところです。発表されたからといって、APIで呼べるわけではありません。
公式発表の冒頭にはこう書かれています。
which is rolling out to a set of trusted cyber defenders through our Fairwind Program
(Fairwind Programを通じて、信頼済みのサイバー防衛関係者の一団に向けて提供を開始しています)
そして同じ発表の中で、Googleは「フロンティア級の能力をこのレベルで安全に提供するには段階的なアプローチが必要」「開発者・企業・消費者に提供する前に、早期テスターからフィードバックを集めてガードレールを改善し続ける」と述べています。広く提供される順番は「有料のAPI利用者とGoogle AI Ultraの契約者から」と明記されていますが、時期は「できるだけ早く」とだけ書かれており、日付の約束はありません。
これも機械で確かめられます。私がモデル一覧を引いた同じ鍵で、GET /v1beta/models/gemini-4-argon を叩いた結果はHTTP 404でした。モデル名の候補をいくつか変えても同じです。発表済みだが、一般の鍵からは存在していない——この状態が、提供条件の話を裏付けています。
私がこの差を毎回確認するようにしているのは、「発表された機能」と「自分が使える機能」がずれたまま社内に伝わると、導入計画が実体のない前提で進んでしまうからです。発表を読んだら、自分の鍵で一覧を引いて、名前が返ってくるかどうかだけ見る。これで10秒で決着します。
価格は「導入価格」で、通常価格は2倍
もう一点、見落とすと計算が狂うのが価格です。発表に出ている数字は導入価格です。
入力(100万トークンあたり) | 出力(100万トークンあたり) | |
|---|---|---|
導入価格 | $2 | $10 |
導入期間の終了後 | $4 | $20 |
※Google公式ブログ(2026年9月30日時点)の記載。キャッシュ済み入力トークンは入力単価の95%割引とされています。契約前に、その時点の公式価格ページでご確認ください。
注意したいのは、導入期間がいつまでなのかは公式発表に書かれていない点です。記事や社内資料で「いまなら半額」と書いてしまうと、期限を根拠に判断を促したのに実は違った、という形で信頼を損ねます。私は見積もりを作るときは常に通常価格側($4/$20)で計算し、導入価格は「当たればラッキー」として扱っています。
そして出力側の単価は入力側の5倍です。出力上限が1Mになるということは、1回の呼び出しで最大$20まで出力費が積めるということでもあります。上限が広がると、事故ったときの金額も広がります。
「導入価格が後から上がる」は、この業界で何度も起きている型です。別のGoogleモデルで同じことが起きた例を記事にしています。
出力上限に当たると何が起きるか — 実際に当てて測った
ここが本題です。上限の数字を知っていても、当たったときにどう見えるかを知らないと、現場では気づけません。
私は maxOutputTokens をわざと小さくして、同じ依頼を投げる実験をしました。依頼文は「日本語で、AIの出力トークン上限について600字程度の解説文を書いてください。見出しは不要です。」の1文です(2026年10月2日・Gemini API v1beta)。
エラーにならない。HTTP 200で、文が途中で切れて返ってくる
まず、思考(thinking)を伴わない軽量モデル gemini-3.5-flash-lite での結果です。
maxOutputTokens | finishReason | 返ってきた本文 | 応答 |
|---|---|---|---|
120 |
| 228字(途中で切断) | HTTP 200 |
2,048 |
| 608字(完結) | HTTP 200 |
120トークンで打ち切った側の末尾は、こうなっていました。
……主な理由は、コンピューターのメモリや計算処理能力の限界、そして応答速度の維持にあります。AIが一度に大量のテキストを生成
文の途中です。句点もありません。そして応答そのものはHTTP 200の正常終了です。例外も投げられず、警告も出ません。唯一の手がかりは、応答に含まれる finishReason が STOP ではなく MAX_TOKENS になっていることだけです。
ここが実務で効く一点です。自分のコードが finishReason を見ていなければ、切れた文章がそのまま次の工程に流れます。私の記事生成の仕組みでも、出力がHTMLなので「閉じタグが足りない」という形で後段に現れます。生成直後に止めなければ、壊れた成果物が投函まで進んでしまいます。
対処は難しくありません。応答を受け取ったら、本文を使う前に finishReason(OpenAI系なら finish_reason、Anthropic系なら stop_reason)を見て、正常終了以外なら処理を止める。これだけです。上限そのものを広げるより先に、この1行の検査を置くほうが確実です。
思考する型のモデルでは、思考が同じ枠を食い潰す
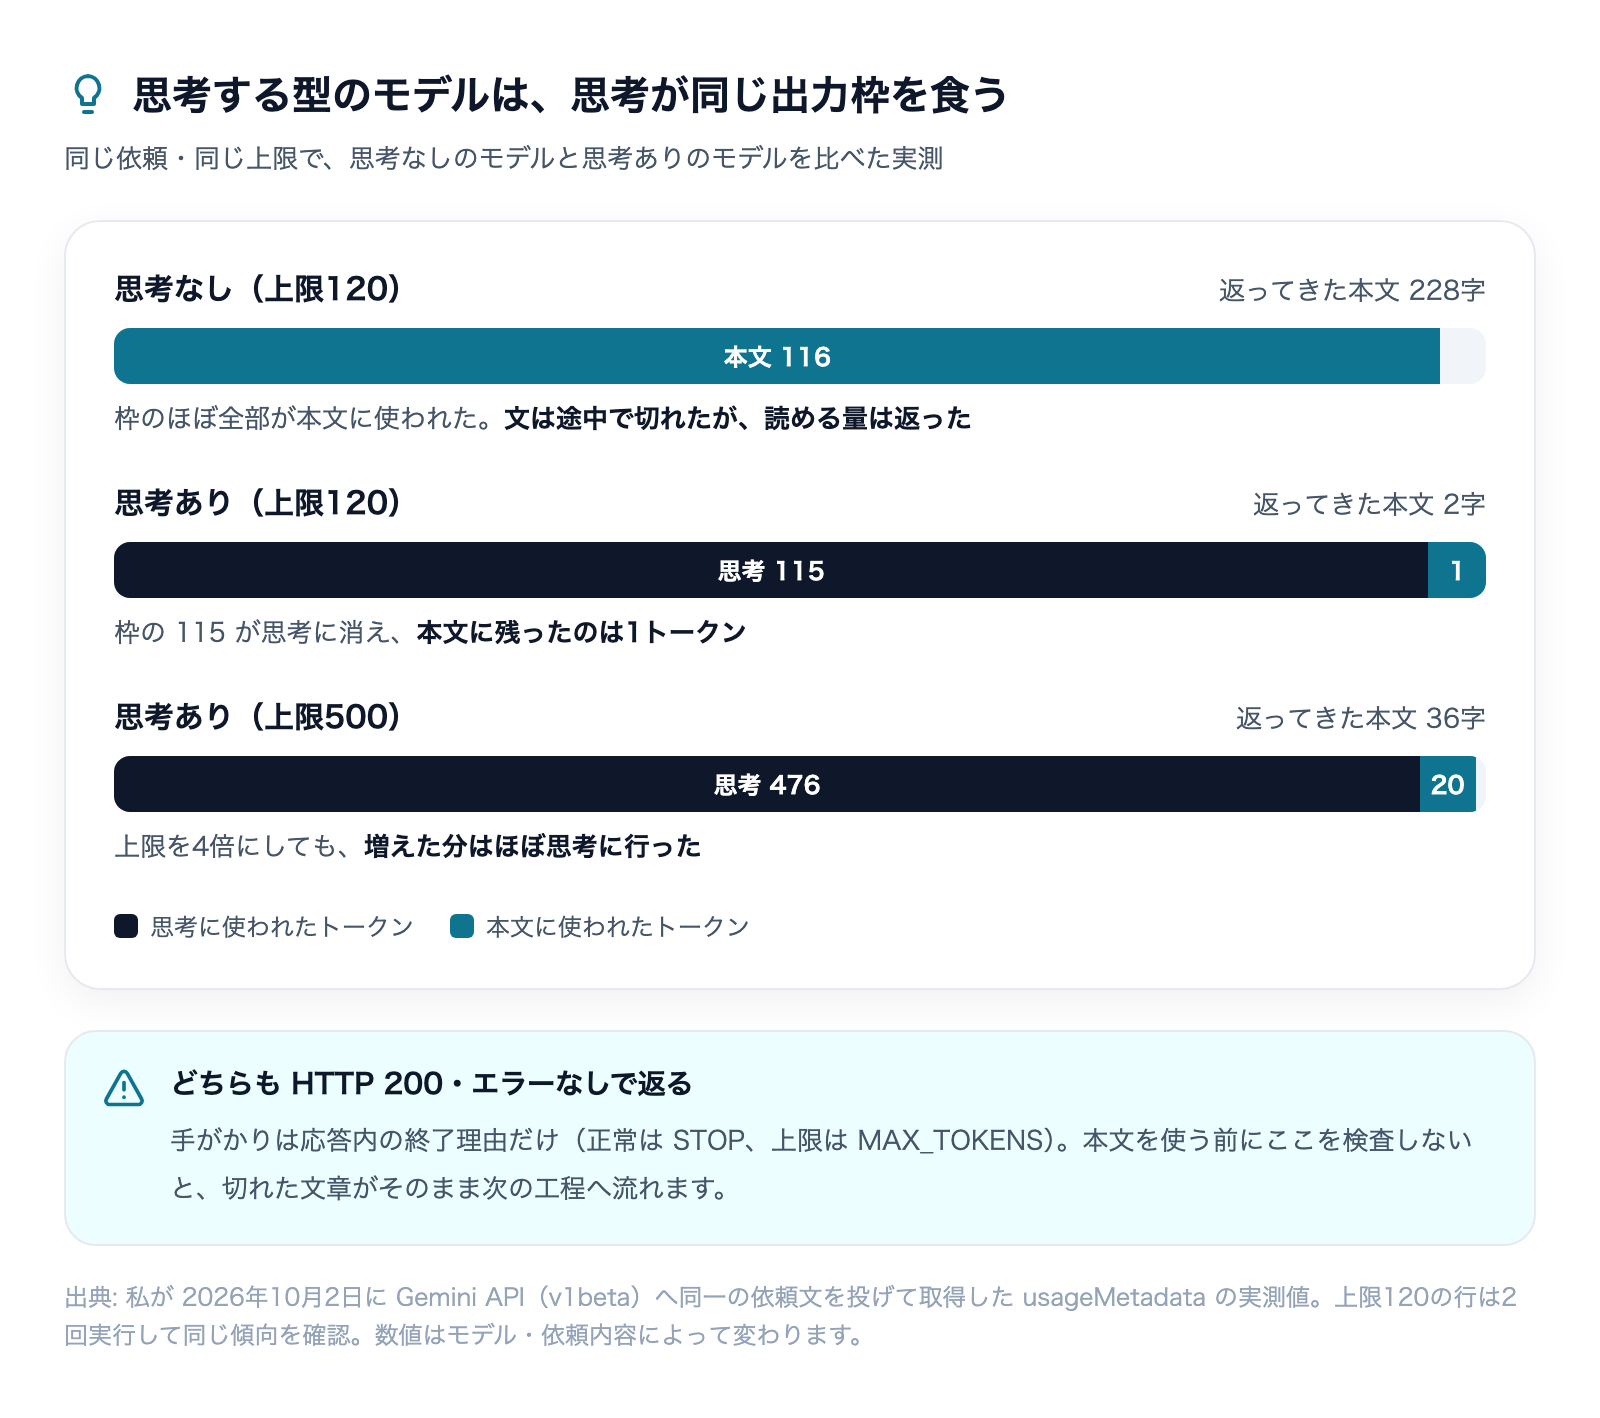
ここからが、私が測って一番驚いた部分です。同じ依頼・同じ上限を、思考を伴うモデル gemini-3.8-flash に投げると、結果がまったく違いました。
モデル | maxOutputTokens | 思考に使われた分 | 本文に使われた分 | 返ってきた本文 |
|---|---|---|---|---|
gemini-3.5-flash-lite(思考なし) | 120 | — | 116 | 228字 |
gemini-3.8-flash(思考あり) | 120 | 115 | 1 | 2字 |
gemini-3.8-flash(思考あり) | 500 | 476 | 20 | 36字 |
※応答の usageMetadata に含まれる thoughtsTokenCount と candidatesTokenCount の実測値。120トークンの行は2回実行して同じ傾向(115〜120が思考に消費)を確認しました。
読み取れることは1つです。思考に使われたトークンも、同じ出力枠から引かれています。上限120のうち115が思考に消え、本文に残ったのは1トークン=2文字でした。上限を500に増やしても、476が思考に行き、本文は36字です。
これは「上限に余裕を持たせたつもりなのに、答えがほとんど返ってこない」という現象の正体です。思考なしのモデルで動いていた設定値を、思考するモデルにそのまま持ち込むと壊れます。同じ120という数字で、片方は228字返し、もう片方は2字しか返しませんでした。
この「思考に使う分を別枠として見積もる」という考え方は、Claude Codeのthinking budgetの設定でも同じ構図になります。エラー別の対処とあわせて整理した記事があります。
自分が使っているモデルの出力上限を確かめる4手順
上限は提供元が公開しています。推測する必要はありません。私がいつもやっている確認の順番です。
手順1: モデル一覧を機械可読な形で引く
Gemini APIであれば、モデル一覧のエンドポイントが inputTokenLimit と outputTokenLimit を返します。ドキュメントの表を目で読むより、一覧をそのまま取得して並べるほうが速く、取り違えも起きません。個別のモデルページを探し回る必要はありません。
この方法の利点は、いま自分の鍵で使えるモデルだけが返ってくることです。ドキュメントには載っているが自分には提供されていないモデル、逆にドキュメントの更新が追いついていないモデルの差が、ここで消えます。Gemini 4 Argonが404だったのも、この性質のおかげで分かりました。
手順2: 入力側と出力側のどちらが効くのか切り分ける
症状で切り分けます。
- 渡した資料が反映されない・前の会話を忘れている → 入力側(コンテキストウィンドウ)の問題
- 返答が途中で切れる・最後まで出てこない → 出力側(出力トークン上限)の問題
- 長い資料を渡したときだけ料金が跳ねる → 入力側の段階的な単価設定の問題
私の経験では、相談として持ち込まれるのは圧倒的に2番目です。そして最初に疑われるのは「コンテキストウィンドウが足りないのでは」という入力側の仮説で、だいたい外れます。
手順3: 応答の終了理由を必ず見る
先ほどの実測どおり、上限超過は例外ではなく正常応答として返ります。本文を使う前に終了理由を検査する処理を、呼び出し側に1か所だけ置いてください。項目名は提供元ごとに違いますが、役割は同じです。
- Gemini系:
finishReason(正常はSTOP、上限はMAX_TOKENS) - OpenAI系:
finish_reason(正常はstop、上限はlength) - Anthropic系:
stop_reason(正常はend_turn、上限はmax_tokens)
※項目名・値は各社のAPIリファレンスでご確認ください。ここでは「終了理由という項目が必ずある」という点が要点です。
手順4: 思考する型かどうかで、必要な上限を別に見積もる
思考を伴うモデルを使うなら、欲しい本文の量に、思考の分を上乗せした値を上限に設定します。私の実測では、短い解説文1本を書かせるだけで400トークン以上が思考に使われました。本文と同じくらい、あるいはそれ以上を見ておくのが安全です。
応答の usageMetadata(OpenAI系・Anthropic系なら usage)には、思考に使われた分と本文に使われた分が別々に入っています。一度自分の用途で測って、比率を把握しておくのが確実です。1回測れば以後の見積もりが変わります。
私の運用では、出力上限はいくら必要なのか — 記事1本を実測した
ここで「64Kでは足りないのか」という疑問に、自分のデータで答えます。私は毎日、AIにSEO記事1本をHTMLで書かせて公開する仕組みを動かしています。この記事もその仕組みから出ています。
公開済みの記事3本について、本文HTMLをそのままトークン数え上げのエンドポイント(countTokens)に投げて測りました。
記事 | HTMLの文字数 | 実測トークン数 | 65,536に対する割合 |
|---|---|---|---|
A(最長) | 19,297字 | 7,934 | 12.1% |
B | 15,778字 | 7,283 | 11.1% |
C | 13,644字 | 6,132 | 9.4% |
※2026年10月2日に gemini-3.8-flash の countTokens で測定。トークナイザーは提供元ごとに違うため、他社APIでは数字が変わります。
いちばん長い記事でも65,536の12.1%でした。つまり私の用途では、64Kの出力上限は一度も足りていなかったわけではない——これが自分のデータで確認できたことです。「1Mになったから一度で出せる」は、私の記事生成には関係のない改善でした。
HTMLで出させると、タグが全体の4分の1から3分の1を食う
同じ3本から、もう1つ分かったことがあります。タグを取り除いた本文だけでも測り直して比べました。
記事 | HTML全体 | タグ除去後 | タグが占めるトークン |
|---|---|---|---|
A | 7,934 | 5,210 | 2,724(34%) |
B | 7,283 | 5,315 | 1,968(27%) |
C | 6,132 | 4,615 | 1,517(25%) |
マークアップのために全体の4分の1から3分の1を使っています。これは出力単価がそのまま掛かる部分です。「HTMLで出させる」という設計判断には、文章そのものに加えて3割前後の出力費が付いてくる、ということになります。
あわせて、日本語の文字数とトークン数の実測比も取れました。タグを除いた本文では1トークンあたり約1.9〜2.2文字でした。見積もりを安全側に寄せたいときは1文字=1.5トークンのような控えめな係数を使いますが、実測は用途ごとに取ったほうが精度が上がります。同じ文章でも、トークナイザーが違えば数字は動きます。
出力上限が1Mになると、設計はどう変わるのか
ここは意見が分かれるところなので、私の立場を先に書きます。上限が広がっても、私は分割して出させる設計を続けます。
理由は3つあります。
1つめは、検査の単位が大きくなりすぎることです。1回の応答で数十万トークンを出させると、どこかが壊れていたときに全部やり直しになります。私の仕組みでは、記事本文・図解のHTML・メタ情報を別の呼び出しに分けています。図解だけ作り直す、という直し方ができるのは分けているからです。
2つめは、費用の事故が大きくなることです。出力単価は入力の5倍で、通常価格では100万トークンあたり$20です。上限を1Mにしたまま暴走を1回許すと、それだけで$20が飛びます。私はむしろ上限を「必要量の2倍程度」に絞って設定するようにしています。上限は性能の設定ではなく、事故の天井として使うほうが実務では効きます。
3つめは、長い出力ほど途中の品質が落ちやすいことです。これは測りきれていないので断定は避けますが、少なくとも「一度で全部出せるようになったから一度で出すべき」という結論は出てきません。
では1Mの出力上限が効くのはどこか。公式が挙げている用途——大規模なコードベースの移行や、脆弱性の発見から修正までを一息でやり切るような、途中で切ると意味を失う仕事です。Googleは社内で、C/C++のコードベースをRustへ移行する作業に使ったと書いています。数十万行規模の書き換えを分割すると、整合性を取る作業が本体になってしまう——そういう種類の仕事です。
裏を返せば、文書を書かせる・要約させる・分類させるといった一般的な業務用途では、出力上限が64Kから1Mになったことの恩恵はほぼありません。私の記事生成が12.1%で収まっていたのと同じ理由です。発表の大きさと、自分の業務への影響の大きさは別に測る必要があります。
ベンチマークの数字をどう読むか — 「19中13勝」はどこの数字なのか
この発表では性能の話が先に広がりました。ただ、数字の出どころを確かめておく必要があります。
Google公式ブログに載っている個別のスコアは、次のとおりです。
- DeepSWE v1.1(実世界の長期的なソフトウェア開発タスク): 77.9%で最高水準
- AutomationBench(業務機能の端から端までの実行を測る、Zapierのベンチマーク): 51.3%で1位
- LVBench(長い動画の理解): 91.7%で最高水準
- CWE-bench v1(脆弱性の修正能力): 68%で首位タイ
- Vals Index(金融・コーディング・法務・税務の経済的影響を測る指標): 首位
一方で、各所で見かける「19のベンチマークのうち13で勝った」という勝ち数は、公式ブログ本文には書かれていません。これはGoogleが別に示した比較表を報道側が集計した数字です。
そしてその集計自体が、報道ごとに食い違っています。あるメディアは「19のうち13で単独首位」と書き、別のメディアは「Googleが開示した18のベンチマークのうち12で単独首位、1で首位タイ」と書いています。どちらも同じ発表を扱っているのに、母数と勝ち数が1つずつずれています。
私は、こういう数字を記事や社内資料の見出しに使いません。勝ち数は「どのベンチマークを数に入れるか」で動く値で、しかも集計したのは提供元自身の比較表です。使うなら、関心のある領域の個別スコアを1つ見るほうが判断の役に立ちます。自社がコード生成に使うなら DeepSWE、文書処理に使うなら Vals Index、という選び方です。
なお同じ発表には、報道では触れられにくい一行も入っています。信頼済みの防衛関係者と社内チームに対しては「サイバー関連のガードレールを外した状態で」提供すると明記されている点です。同じモデル名でも、渡される相手によって構成が違います。「Gemini 4 Argonはこういうモデル」と1つの像で語れない、ということでもあります。
よくある質問
コンテキストウィンドウが大きいモデルを選べば、長い出力も出せますか
いいえ、別の上限です。私が実測した主力モデルは入力1,048,576に対して出力65,536で、16倍の差がありました。入力側の数字は、出力側の長さを何も保証しません。
出力が途中で切れたとき、エラーで気づけますか
気づけません。実測では、上限で打ち切られた応答もHTTP 200の正常終了で返り、例外も警告も出ませんでした。判別できるのは応答内の終了理由(finishReason / finish_reason / stop_reason)だけです。本文を使う前にここを検査してください。
上限を最大まで上げておけば安全ですか
私はそうしていません。出力単価は入力の5倍で、上限は暴走時に請求される金額の天井にもなります。必要量を一度実測して、その2倍程度に絞るほうが実務では安全です。上限は性能の設定ではなく、事故の天井として使う項目だと考えています。
思考するモデルでは、上限をどれくらい積めばよいですか
私の実測では、短い解説文1本を書かせるだけで400トークン以上が思考に消えました。本文に欲しい量と同じか、それ以上を上乗せするところから始めて、応答に含まれる思考トークン数の実測値を見て詰めるのが確実です。思考なしのモデルで使っていた設定値をそのまま持ち込むと、本文がほとんど返らないことがあります。
Gemini 4 Argonはいつ使えるようになりますか
2026年10月2日時点では、公式発表に日付の約束はありません。「できるだけ早く」とされており、提供の順番は有料のAPI利用者とGoogle AI Ultraの契約者からと書かれています。私が同日にモデル一覧を引いた限りでは、一般の鍵からはまだ存在しません(HTTP 404)。使えるようになったかどうかは、ご自身の鍵でモデル一覧を引けばその場で分かります。
日本語だとトークンを多く消費しますか
英語よりは重くなります。ただ、私がタグを除いた日本語本文で測った実測は1トークンあたり約1.9〜2.2文字でした。漢字の比率や固有名詞の量で変わり、トークナイザーごとにも違うため、自分の文章で一度測るのがいちばん確実です。
まとめ
出力トークン上限は、入力側のコンテキストウィンドウとは別の上限です。そして実務で詰まるのは、ほぼ出力側です。
この記事で自分の手で確かめたことを、もう一度並べます。
- 入力と出力は桁が違う — 主力モデルは入力1,048,576に対して出力65,536(16倍差)。61モデル中、出力上限が64Kを超えるものは1つもなかった
- Gemini 4 Argonが広げたのは出力側 — 公式の逐語で64K→1M。ただし2026年10月2日時点では一般の鍵から404で、価格も導入価格(通常は$4/$20)
- 上限に当たってもエラーにならない — HTTP 200で文が途中のまま返る。手がかりは終了理由だけ
- 思考する型では思考が同じ枠を食う — 上限500のうち476が思考に消え、本文は36字だった
- 自分の必要量は測れる — 私の記事1本は最長でも65,536の12.1%。HTMLのタグが全体の25〜34%を占めていた
いま出力が途中で切れて困っているなら、上限を上げる前に応答の終了理由を見る1行を入れてください。そのうえで必要量を一度測れば、上限はいくらにすべきかが数字で決まります。発表された上限が16倍になったかどうかより、自分の用途が何パーセントを使っているかのほうが、判断には役に立ちます。
株式会社Fyveは、こうした「発表された数字」と「自分の環境で実際に効く数字」の差を、毎回自分の鍵で測って確かめながらAI導入の判断材料をつくっています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。