Claude Sonnet 5.5とGPT-6 Sol|同じ単価でどちらを使うか

「Claude Sonnet 5.5とGPT-6 Sol、どちらも入力$2・出力$10なら、何を基準に選べばいいのか」——1週間違いで同じ値段のモデルが2つ出て、どちらを仕事に組み込むかで迷っている方は多いはずです。
結論から言うと、単価が同じなので、決め手はすでに使っている道具と、使い方の形です。Claude Codeで仕事を回しているならSonnet 5.5、CodexやChatGPTで回しているならSolが素直な選択です。そのうえで、長い資料をまとめて読ませる・無料のチャットから試すならSonnet 5.5、追加料金で速さを買う・思考を完全に切りたいならSolに理由があります。
株式会社Fyveは、中小企業のAI活用を月額で伴走支援しながら、社内の開発と業務の自動化をClaude Codeで、コードのレビューや画像生成をCodexで回しています。この記事では、両社の公式情報をもとに、単価の外側にある条件の違い、比較表の読み方、使い分けの決め方の順に整理します。情報はすべて2026年9月29日時点です。
Sonnet 5.5そのものの全体像(Sonnet 5から何が変わったか)は、こちらのガイドにまとめています。
先に結論:Sonnet 5.5とGPT-6 Solは、道具と使い方の形で選ぶ
判断の軸は、いま使っている道具と、使い方の形の2つです。根拠の数字は次の章以降で示します。
- 道具で決める:Claude Codeやclaude.aiで回しているならSonnet 5.5。CodexやChatGPTのWorkで回しているならSol。単価が同じなので、乗り換えで取り返せる差はありません
- 使い方の形で決める:長い資料を1回で読ませる、同じ資料を30分〜1時間おきに読み直させる、無料のチャットから試すならSonnet 5.5。追加料金で応答を速くしたい、思考を完全に切りたいならSol
- ベンチマークは参考まで:Anthropicの比較表では、両方に数値がある4項目すべてでSonnet 5.5が上。ただしAnthropic側の発表で、Solの3項目には注記がつく
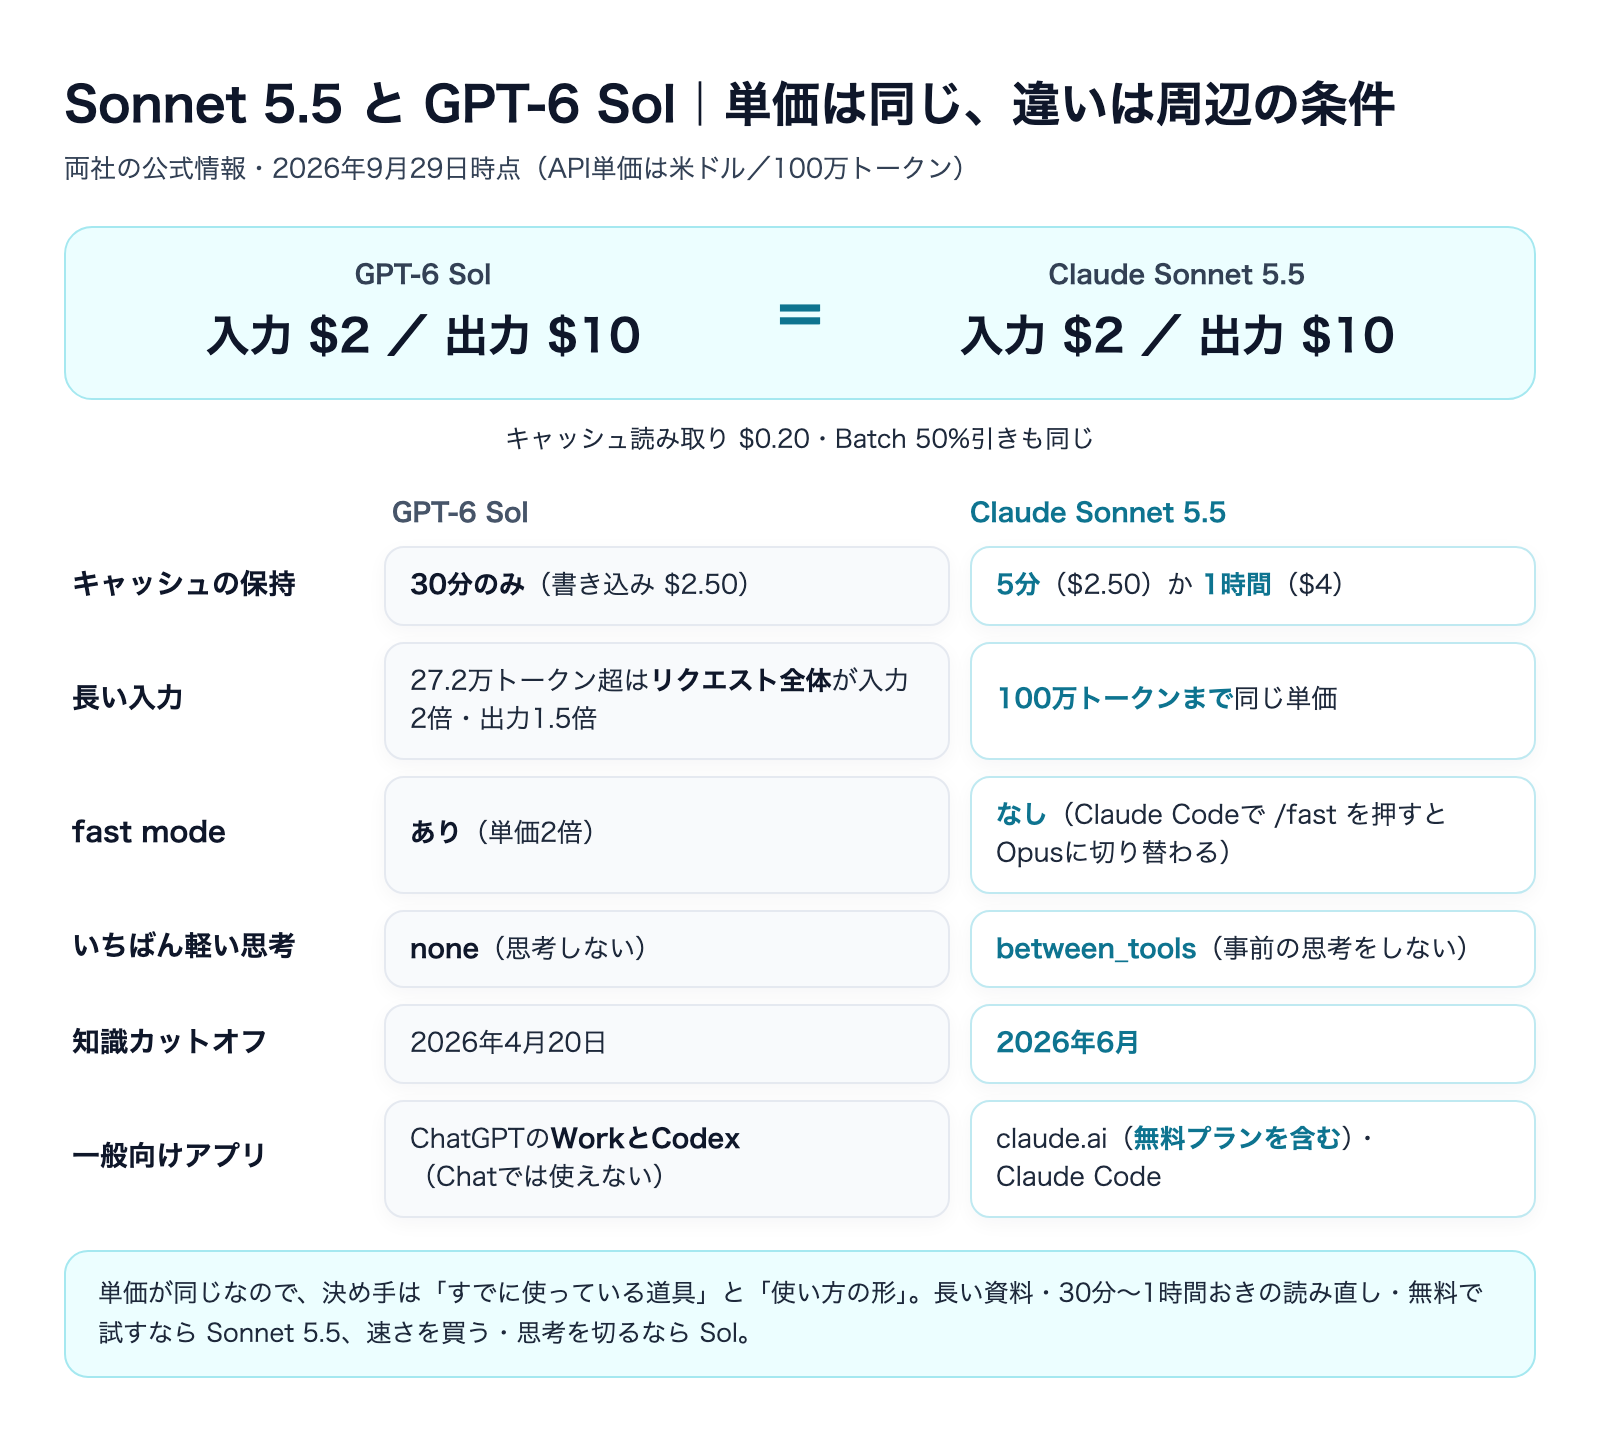
単価は同じ$2/$10、キャッシュ読み取りも同じ$0.20
API(使ったトークン量に応じて払う従量課金)の料金は、100万トークンあたり次のとおりです(米ドル・2026年9月29日時点)。
- Claude Sonnet 5.5:入力 $2/出力 $10(Anthropic公式)
- GPT-6 Sol:入力 $2/出力 $10(OpenAI公式)
入力も出力も同じです。キャッシュ(同じ前提を何度も読ませるとき、2回目以降を安く読ませる仕組み)の読み取りも、どちらも$0.20で入力の10%。まとめて非同期で流すBatchも、どちらも50%引きです。Solには、同じく50%引きになるFlexという処理区分もあります。第三者の報道でも、VentureBeatがSonnet 5.5の発表記事で、競合のGPT-6 Solを同じ$2/$10として並べています。
同じ単価なら、請求額の差は同じ仕事に使うトークンの量で決まります。Anthropicが主張する「1件あたり最大30%安い」も、同じ仕事に使うトークンが減った分の話で、単価の値下げではありません。Solとどちらが少ないトークンで済むかは、仕事によって変わります。
単価はどちらも改定されることがあります。契約前に、Anthropicの料金ページとOpenAIのGPT-6 Solのモデルページで最新の価格を確認してください。Sonnet 5.5のプランごとの条件や月額の試算は、こちらにまとめています。
違いは単価の外側の条件に出る
単価が同じでも、使い方次第で請求額や使い勝手が変わる条件があります。両社の公式ドキュメントから並べました(2026年9月29日時点)。
項目 | GPT-6 Sol | Claude Sonnet 5.5 |
|---|---|---|
公開日 | 2026年9月22日 | 2026年9月28日(米国時間) |
単価(入力/出力) | $2 / $10 | $2 / $10 |
キャッシュ読み取り | $0.20 | $0.20 |
キャッシュ書き込み | $2.50 | $2.50(5分)/$4(1時間) |
キャッシュの保持 | 30分のみ | 5分か1時間を選ぶ |
長い入力 | 27.2万トークン超は、そのリクエスト全体が入力2倍・出力1.5倍 | 100万トークンまで同じ単価 |
fast mode | あり(単価2倍) | なし |
思考の段階 |
|
|
コンテキスト | 105万トークン | 100万トークン |
知識カットオフ | 2026年4月20日 | 2026年6月 |
一般向けアプリ | ChatGPTのWorkとCodex(Chatでは使えない) | claude.ai(無料プランを含む)・Claude Code |
公式の位置づけ | 複雑なコーディングとエージェント型ワークフロー向け | 範囲がはっきりした日常の仕事、バグ修正、文書・スライド・表の作成 |
このうち、使い方によって差が大きく開くのは、キャッシュの保持と長い入力の2つです。順に見ていきます。
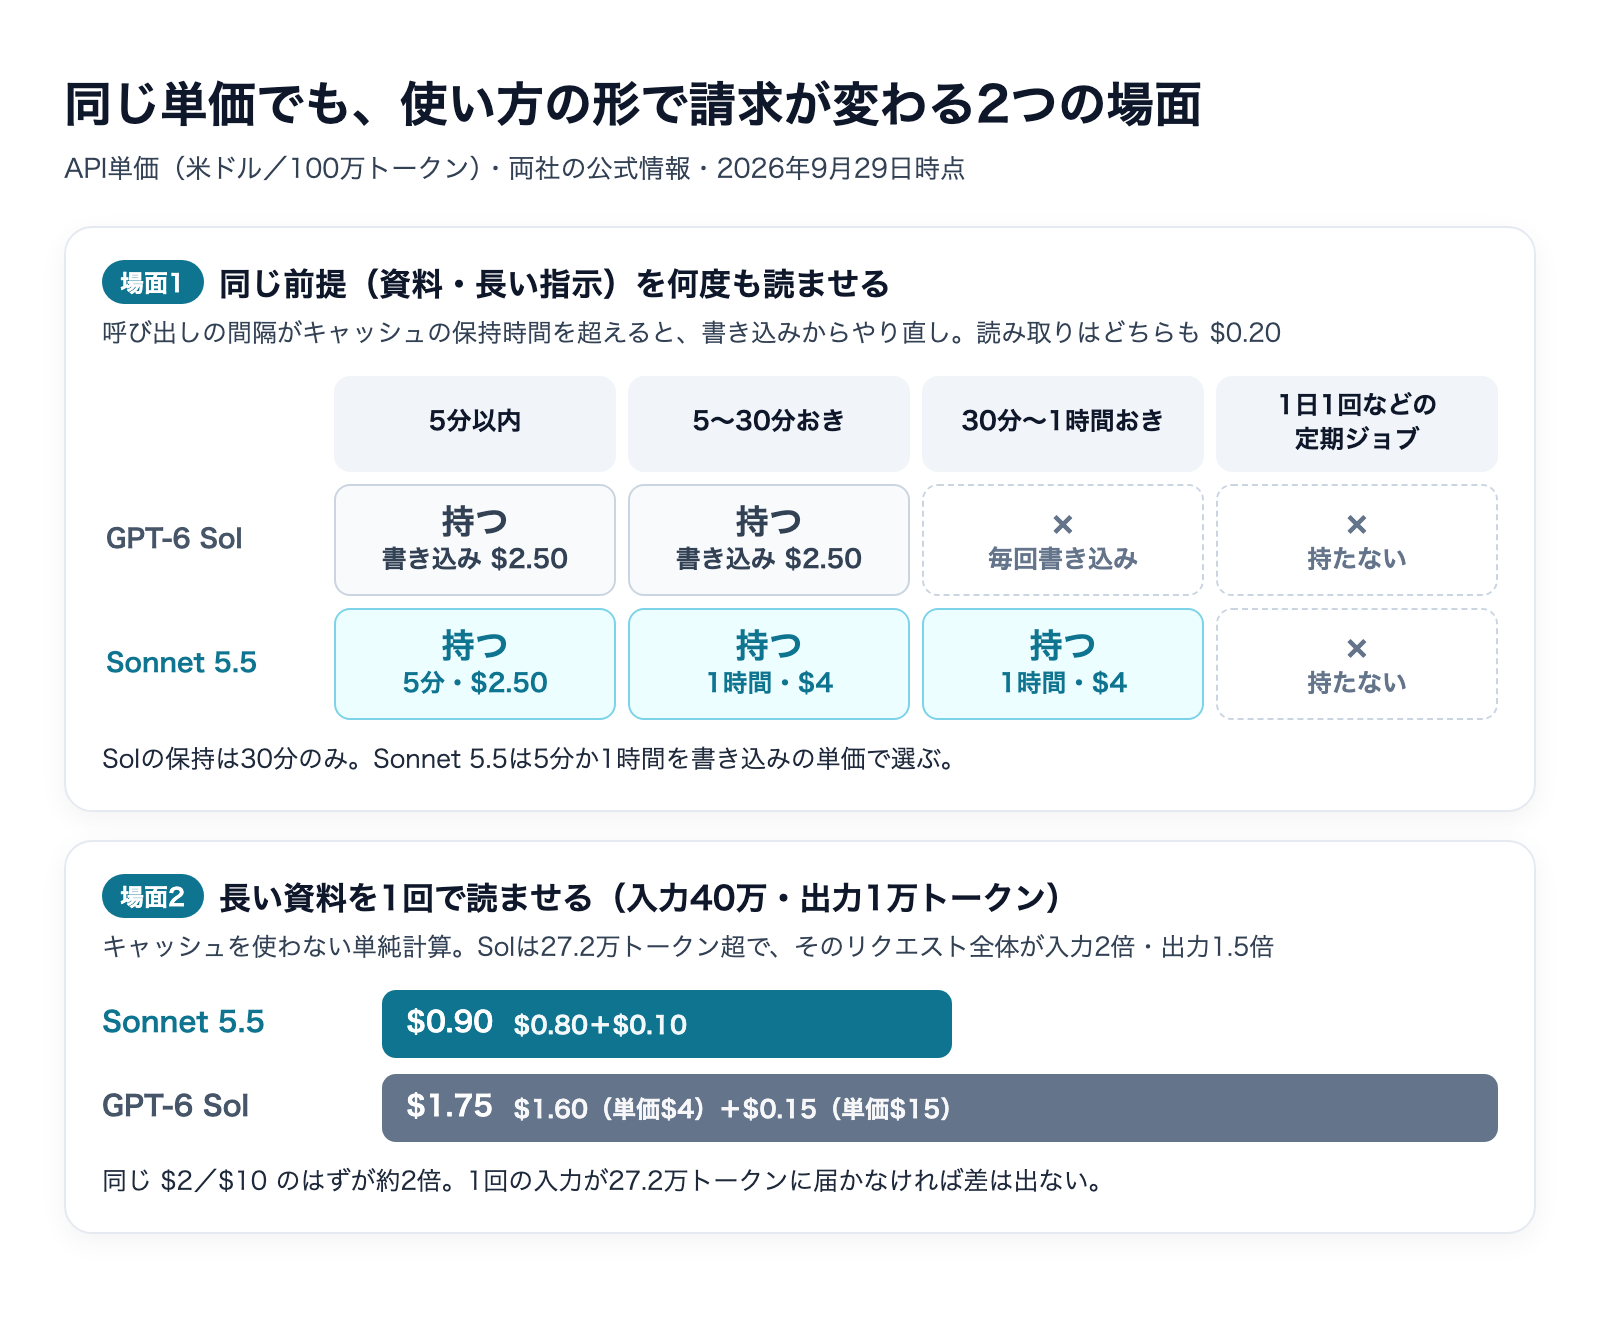
キャッシュの保持:Solは30分だけ、Sonnet 5.5は5分か1時間
キャッシュは、最初の1回に「書き込み」の料金がかかり、保持時間のうちに同じ前提を読ませると「読み取り」の$0.20で済む仕組みです。長いシステムプロンプトや社内資料を毎回読ませる使い方で効きます。
Solの保持時間は30分の1択です(書き込み$2.50)。Sonnet 5.5は、5分(書き込み$2.50)か1時間(書き込み$4)を選べます。呼び出しの間隔が保持時間を超えると、次の呼び出しは書き込みからやり直しになるので、間隔によって次のように分かれます。
- 5分以内(対話しながらの作業など):どちらも書き込み$2.50で持つ
- 5〜30分おき:Solは$2.50で持つ。Sonnet 5.5は1時間を選べば持つが、書き込みは$4
- 30分〜1時間おき:Sonnet 5.5の1時間キャッシュだけが持つ。Solは毎回書き込みからやり直し
- 1日1回などの定期ジョブ:どちらも持たない。差はない
どちらも読み取りは$0.20なので、差が出るのは書き込みの回数と単価です。保持時間の細かな数え方は、Anthropicの料金ページとOpenAIのプロンプトキャッシュの説明で確認してください。
長い入力:Solは27.2万トークンを超えると、リクエスト全体が割増
もう1つの大きな違いは、長い資料を1回で読ませるときの単価です。Solは、入力が27.2万トークンを超えると、超えた部分だけでなくそのリクエスト全体が入力2倍・出力1.5倍の単価になります。Sonnet 5.5は100万トークンまで同じ単価です。
たとえば入力40万トークン・出力1万トークンのリクエストを1回送る場合、キャッシュを使わない単純計算で次のようになります。
- Sonnet 5.5:入力 $0.80+出力 $0.10=$0.90
- Sol:入力 $1.60(単価$4)+出力 $0.15(単価$15)=$1.75
同じ単価のはずが、約2倍の差になります。契約書や議事録をまとめて読ませる、大きなコードベースを丸ごと渡す使い方が多いなら、この条件は表の単価より響きます。1回の入力が27.2万トークンに届かないなら、差は出ません。
なお、1回に扱える量(コンテキスト)はSolが105万、Sonnet 5.5が100万トークンでほぼ同じです。Solのほうが少し多く入っても、27.2万トークンを超えれば割増になります。
速さ:fast modeはSolだけ
Solには、単価2倍で応答を速くするfast modeがあります。Sonnet 5.5にはありません。Anthropicのfast modeはOpus系のモデルだけで、Claude CodeでSonnet 5.5のまま /fast をオンにすると、Opusに切り替わります(Opus 5.5のfast modeは入力$8/出力$40)。
一方でSonnet 5.5は、出力の生成がSonnet 5より30%以上速いと発表されています。標準の速さで足りるならSonnet 5.5、お金を払ってでも待ち時間を削りたい場面があるならSolに選択肢がある、という違いです。
考えない設定:Solのnone、Sonnet 5.5のbetween_tools
どちらも、回答前にどれだけ考えるかを段階で選べます(effort=考える深さの設定)。違うのは、いちばん軽い設定です。Solには思考をしない none があります。Sonnet 5.5は思考を切ることができず、いちばん軽いのは between_tools(事前の思考をしない設定)です。
分類や書式の変換のように考える必要が薄い処理を大量に流すなら、Solの none は選択肢になります。ただしOpenAIは、定型の反復作業向けにはLunaというモデルを別に用意しています。
既定の段階も違います。Solの既定はmedium、Sonnet 5.5はAPIではhigh、Claude Codeとアプリではmediumです。会社が違えば同じ「medium」でも考える量が揃う保証はないので、比べるときは段階の名前より、かかった時間と出力の量を見てください。
知識カットオフ:Sonnet 5.5のほうが2か月ほど新しい
学習データの時点(知識カットオフ)は、Solが2026年4月20日、Sonnet 5.5が2026年6月です。4月下旬から6月に出たライブラリの新しい版などは、Sonnet 5.5のほうが知っている可能性があります。ただ、どちらも数か月前で止まっているので、最新の情報は検索させるか資料として渡す前提で使ってください。
どこで使えるか:SolはChatGPTのChatでは選べない
Sonnet 5.5は、claude.ai(Web・iOS・Android)で無料プランを含めて使え、Claude Codeでも使えます。ただし、無料プランの既定モデルがSonnet 5.5に切り替わったかどうかは、公式に明記されていません。Claude Codeの既定はOpus 5.5のままです(v2.1.284以降で切り替えて使う)。
Solは、ChatGPTの中では「Work」と「Codex」で使え、ふだんの「Chat」では使えません。社内の非エンジニアにまずチャットで触ってもらうなら、無料から使えるSonnet 5.5のほうが始めやすいはずです。
Anthropicの比較表で並ぶのは4項目だけ
ベンチマークで直接比べられるのは、Anthropicが発表した比較表のうち、Sonnet 5.5とGPT-6 Solの両方に数値がある4項目だけです。
- FrontierCode 1.1(コード変更がそのまま取り込めるか):Sonnet 5.5 52.1%(xhigh)/Sol 49.3%
- GDPval-AA v2.1(44職種・9業界の実務・Elo):Sonnet 5.5 1844/Sol 1487
- AA-Briefcase v1.1(長時間の知識労働・Elo):Sonnet 5.5 1811/Sol 1483
- Chartography(図表の読み取り・ツールなし):Sonnet 5.5 61.6%/Sol 53.6%
4項目ともSonnet 5.5が上ですが、この表を読むときには注意が3つあります。
Solの数値も含めて、Anthropic側の発表
表の値は、Solの数値も含めてすべてAnthropicが自社の発表に載せたものです。第三者が同じ条件で再現した結果ではなく、Sonnet 5.5の独立した評価はまだ出ていません(2026年9月29日時点)。
さらに、差が大きく見えるGDPval-AA、AA-Briefcase、Chartographyの3項目には、Anthropic自身が脚注で「GPT-6 Solは画像理解を劣化させる不具合が最近修正されており、Artificial AnalysisとSurge AIの公式スコアは最新版を反映していない可能性がある」と書いています。この3項目のSolの値は、今の実力より低く出ている可能性があります。
反対側の注記もあります。GDPval-AAとAA-Briefcaseは、Sonnet 5.5の公開前の版で測ったもので、その版には応答を劣化させうる不具合がありました(修正済み)。Anthropicは、影響は小さく、あるとしても低く出る側だと説明しています。
FrontierCodeのSonnet 5.5はxhighでの値
FrontierCodeの52.1%は、Sonnet 5.5をxhighで動かしたときの値です。最上位のmaxでは46.2%と、かえって低く出ています。maxでは作業を多数のサブエージェントに分担させることが増え、時間切れや課題の範囲外の編集で減点された、とAnthropicは説明しています。
Anthropicはさらに、APIの既定のhighで動かしたSonnet 5.5が、Solの最高スコアに約5分の1のコストで並ぶと主張しています。これもAnthropicの測定です。
Terminal-BenchとCursorBenchは比べられない
Anthropicの表にはTerminal-Bench 4.0とCursorBench 4.0もありますが、GPT-6 Solの値は公表されておらず、Anthropicのグラフでは前の世代のGPT-5.6 Solが代わりに載っています。この2項目は、Sonnet 5.5とGPT-6 Solの比較には使えません。Humanity's Last ExamとOSWorldも、Solの欄は空いています。
VentureBeatも発表を伝える記事で、ベンチマークは本番の全ワークロードの代わりにはならないと注意を添えています。各ベンチマークが何を測っているのか、発表値をどう読むかは、こちらの記事で項目ごとに解説しています。
どちらを使うか:すでに使っている道具と、使い方の形で決める
Claude Codeで回しているならSonnet 5.5
Claude Codeに指示ファイルやスキルを書き溜めているなら、Sonnet 5.5で道具を替えずに済みます。Solに移ると、設定の手直しと契約・利用上限の二重管理がついてきます。単価が同じ以上、その手間を取り返せる差はありません。
Claude CodeでSonnet 5.5を使うときは、別名の sonnet ではなく、フルIDの claude-sonnet-5-5 で指定するのが確実です。私たちの手元(Claude Code v2.1.284・Maxプラン、2026年9月29日時点)では、--model sonnet で起動するとSonnet 5が使われました。/status か応答のモデル名で確かめてから使ってください。切り替えの手順はClaude CodeでSonnet 5.5を使う手順にまとめています。
CodexやChatGPTで回しているならSol
反対に、CodexやChatGPTのWorkで仕事を回しているなら、Solのままで構いません。Codexでは、Plus/Pro/Business/Enterprise/EduのプランでSolが、Free/GoのプランではLunaが、これまでのGPT-5.5の置き換え先になります。ChatGPTとCodexのGPT-5.5は2026年10月14日に引退する(APIは対象外)ので、移行の段取りはこちらで確認してください。
GPT-6 SolとLunaとは|Astraとの違いと選び方
両方使える・これからAPIで組むなら、使い方の形で決める
- 長い資料をまとめて読ませる(1回27.2万トークン超):Sonnet 5.5
- 同じ前提を30分〜1時間おきに読ませる:Sonnet 5.5(1時間キャッシュ)。5〜30分おきならSolの書き込みが安いが、差は書き込みの単価だけ。1日1回などの定期ジョブではキャッシュの差は出ない
- 待ち時間に追加料金を払える:Sol(fast mode)
- 思考を完全に切って大量に流す:Sol(
none)。定型作業ならLunaも候補 - まずチャットで試したい:Sonnet 5.5(claude.aiの無料プラン)
表に出ない制約も1つあります。Sonnet 5.5では、リスクの高いサイバーセキュリティ作業は目に見える形でSonnet 5に切り替わります(公式発表・日常のバグ修正には影響なし)。脆弱性の調査が主な用途なら、この点も踏まえてください。
決める前に、自分の仕事で数回試す
最後は、自社の代表的な作業で両方を試してから決めるのが確実です。私たちはSonnet 5.5の公開翌日、手元のClaude Code(v2.1.284)で、Sonnet 5.5とSonnet 5・Opus 5.5に同じ小さな課題(郵便番号を整形するPython関数とテストを書かせる)を解かせました。Solとの比較ではありませんが、試すときの注意が2つ見えました。
- 小さな課題では差が見えにくい:Sonnet 5.5(medium)とSonnet 5(high)の所要時間は、中央値で8.5秒と8.9秒。目立つ差は出なかった。1関数レベルの課題では、モデルの違いは見えにくい
- 同じ条件でも結果はぶれる:Sonnet 5.5は計12回のうち2回、自分で書いたテストに自分のコードが通らなかった。2回とも同じ箇所(テストに書いた全角のマイナス記号を、コード側で変換していなかった)
2つ目は1種類の小さな課題での観察で、Sonnet 5.5の品質が低いという意味ではありません。ただ、どのモデルに任せるにしても、書かせて終わりにせずテストの実行まで頼むのが安全です。
試すときは、同じ依頼文を使う、effortの段階を先に決める、時間・出力の量・正しさを分けて記録する、の3点を揃えると比較がぶれません。Claude Codeなら claude -p --model claude-sonnet-5-5 --output-format json で実行すると、所要時間や出力トークン数も記録されます。
よくある質問
無料で両方を試せますか?
Sonnet 5.5は、claude.aiの無料プランで使えます(2026年9月29日時点)。Solは、ChatGPTのWorkとCodexで使えるモデルで、Codexでは無料のFreeとGoのプランに割り当てられるのはSolではなくLunaです。Workで使えるプランは、OpenAIの案内で確認してください。
月額プランで使うなら、単価が同じことは関係ありますか?
請求額には直接は響きません。月額プランで効くのは利用上限です。Claudeの月額プランには5時間ごとに回復する利用上限があり、トークンを多く使うほど早く届きます。月額なら、単価より「少ないトークンで終わるか」と「使い慣れた道具か」が判断材料になります。
まとめ
- 単価は入力$2・出力$10で同じ。キャッシュ読み取り$0.20、Batchの50%引きも同じ(2026年9月29日時点)
- 違いは単価の外側に出る。キャッシュの保持、27.2万トークン超の割増(Solのみ)、fast mode(Solのみ)、思考を切れるか、知識カットオフ、無料のチャットで使えるか
- ベンチマークはAnthropicの表で比べられる4項目すべてでSonnet 5.5が上。ただしAnthropic側の発表で、Solの3項目は不具合の修正前の値かもしれない
- まず使っている道具で決め、次に使い方の形(長い資料・30分〜1時間おきの読み直し・無料で試すならSonnet 5.5、速さを買う・思考を切るならSol)で決める
- 最後は自社の代表的な作業で数回試し、テストの実行まで含めて確かめる
株式会社Fyveは、Claude CodeとCodexの両方を実務で使いながら、道具の選び方と組み込み方を検証しています。同じ単価のモデルが並んだときほど、単価表の外にある条件と、自社の使い方の形を見比べると迷わずに済みます。
Sonnet 5.5を、Sonnet 5・Opus 5.5と実務で比べてみた。
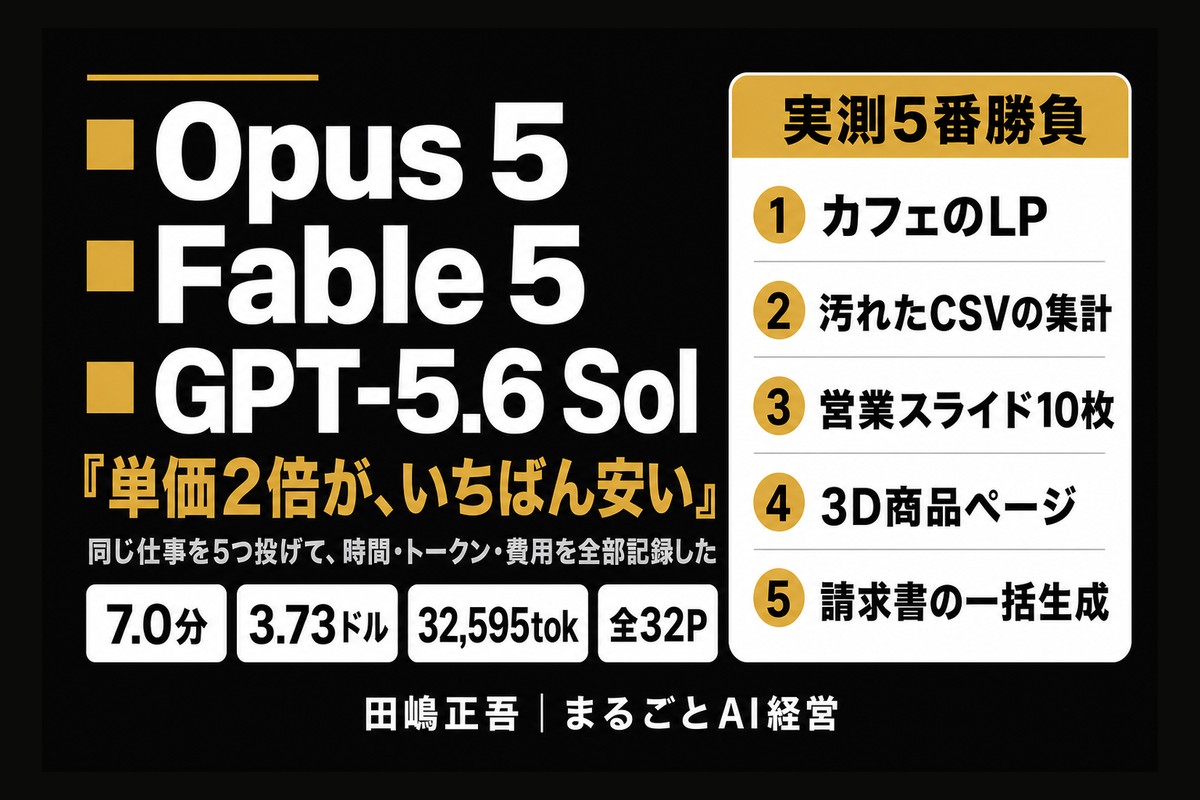
Opus 5.5の半額で、同じ仕事はどこまで足りるか。同じ5つの仕事で測りました(全31ページ)
Sonnet 5.5は単価$2/$10で、Opus 5.5の半額です。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを、Sonnet 5.5・Sonnet 5・Opus 5.5に同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は3モデルとも全問正解。差が出たのは、費用と作り込みと、細部の丁寧さでした。
- Opus 5.5 と同じ水準の作り込みを、Sonnet 5.5 がどれだけ安く終えたか
- Sonnet 5 から乗り換える意味はあるか——仕事別の早見表と判断フローつき
- 5つの仕事 × 3モデル=15本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを3つ並べて比較(LP・スライド・回せる3D)
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。