Claude Opus 5.5のベンチマーク結果と、その読み方

「Claude Opus 5.5のベンチマークはほとんど1位らしい」「でも、その数字を見て自分の仕事で乗り換えてよいのかは分からない」——新しいモデルが出るたびに発表の表を眺めて、結局どう判断すればよいのか迷う方は多いはずです。
結論から言うと、Claude Opus 5.5のベンチマークは、Anthropicが発表した9項目のうち7項目で比較相手の中の最高値です。ただし、これはAnthropic自身の発表値で、2026年9月23日時点で独立した第三者の評価はまだ出ていません。残り2項目ではGPT-6 Astraが上回っています。表の数字は「どの仕事で試す価値があるか」の目星として使い、最終判断は自分の課題で数回測って決めるのが安全です。
株式会社Fyveは中小企業向けにAIの業務活用を支援しており、私自身もClaude Codeを毎日の実務で使っています。この記事では、全ベンチマークを「何を測っているか」つきで並べたうえで、発表値を自分の仕事の判断に使える形で読む方法と、自分の課題で測り直す手順をお伝えします。
先に結論:Opus 5.5のベンチマークから読み取れる3つのこと
Claude Opus 5.5は2026年9月22日(米国時間)に公開されました。Anthropicは発表ページで、ベンチマーク(AIの能力を同じ試験で測って点数を並べたもの)の表を出しています。この表から言えることは、次の3つに絞れます。
- コーディングと実務系の試験で、比較相手より高い点が並んでいる。特にターミナル上のエージェント型コーディング(Terminal-Bench 4.0)は66.4%で、2番手のGPT-6 Astra(57.9%)と8.5ポイント差
- 全項目1位ではない。業務自動化(AutomationBench)と科学系のターミナル作業(Terminal-Bench-Science)はGPT-6 Astraが上
- すべてAnthropicの発表値。第三者が同じ条件で再現した数字はまだない。だから「自分の課題で数回試す」手順が最後の決め手になる
以下、表の全体を見てから、この3点を順に掘り下げます。
Claude Opus 5.5の公式ベンチマーク一覧(全9項目)
Anthropicの発表ページに載っている表を、そのまま並べます。比較相手の数値も、Anthropicの表に載っているものです。「—」は表に数値が載っていない項目です。
ベンチマーク | 何を測るか | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
Terminal-Bench 4.0 | ターミナル上のエージェント型コーディング | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
FrontierCode v1.1 | コーディング | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
CursorBench 4.0 | Cursor上のコーディング | 57.8% | 51.8% | 46.6% | — | 41.7% |
GDPval-AA v2.1 | 44職種の実務(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
AutomationBench | 業務自動化 | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
Humanity's Last Exam(ツールあり) | 難問推論 | 67.7% | 65.6% | 63.6% | 57.2% | — |
Terminal-Bench-Science 0.1 | 科学系ターミナル作業 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
OSWorld 2.0(部分) | パソコン操作 | 81.8% | 80.7% | 74.0% | — | — |
Chartography(ツールあり) | 図表読解 | 89.0% | 88.4% | 83.4% | — | — |
太字は各行の最高値です。9項目中7項目でOpus 5.5が最高値、2項目でGPT-6 Astraが最高値という並びです。
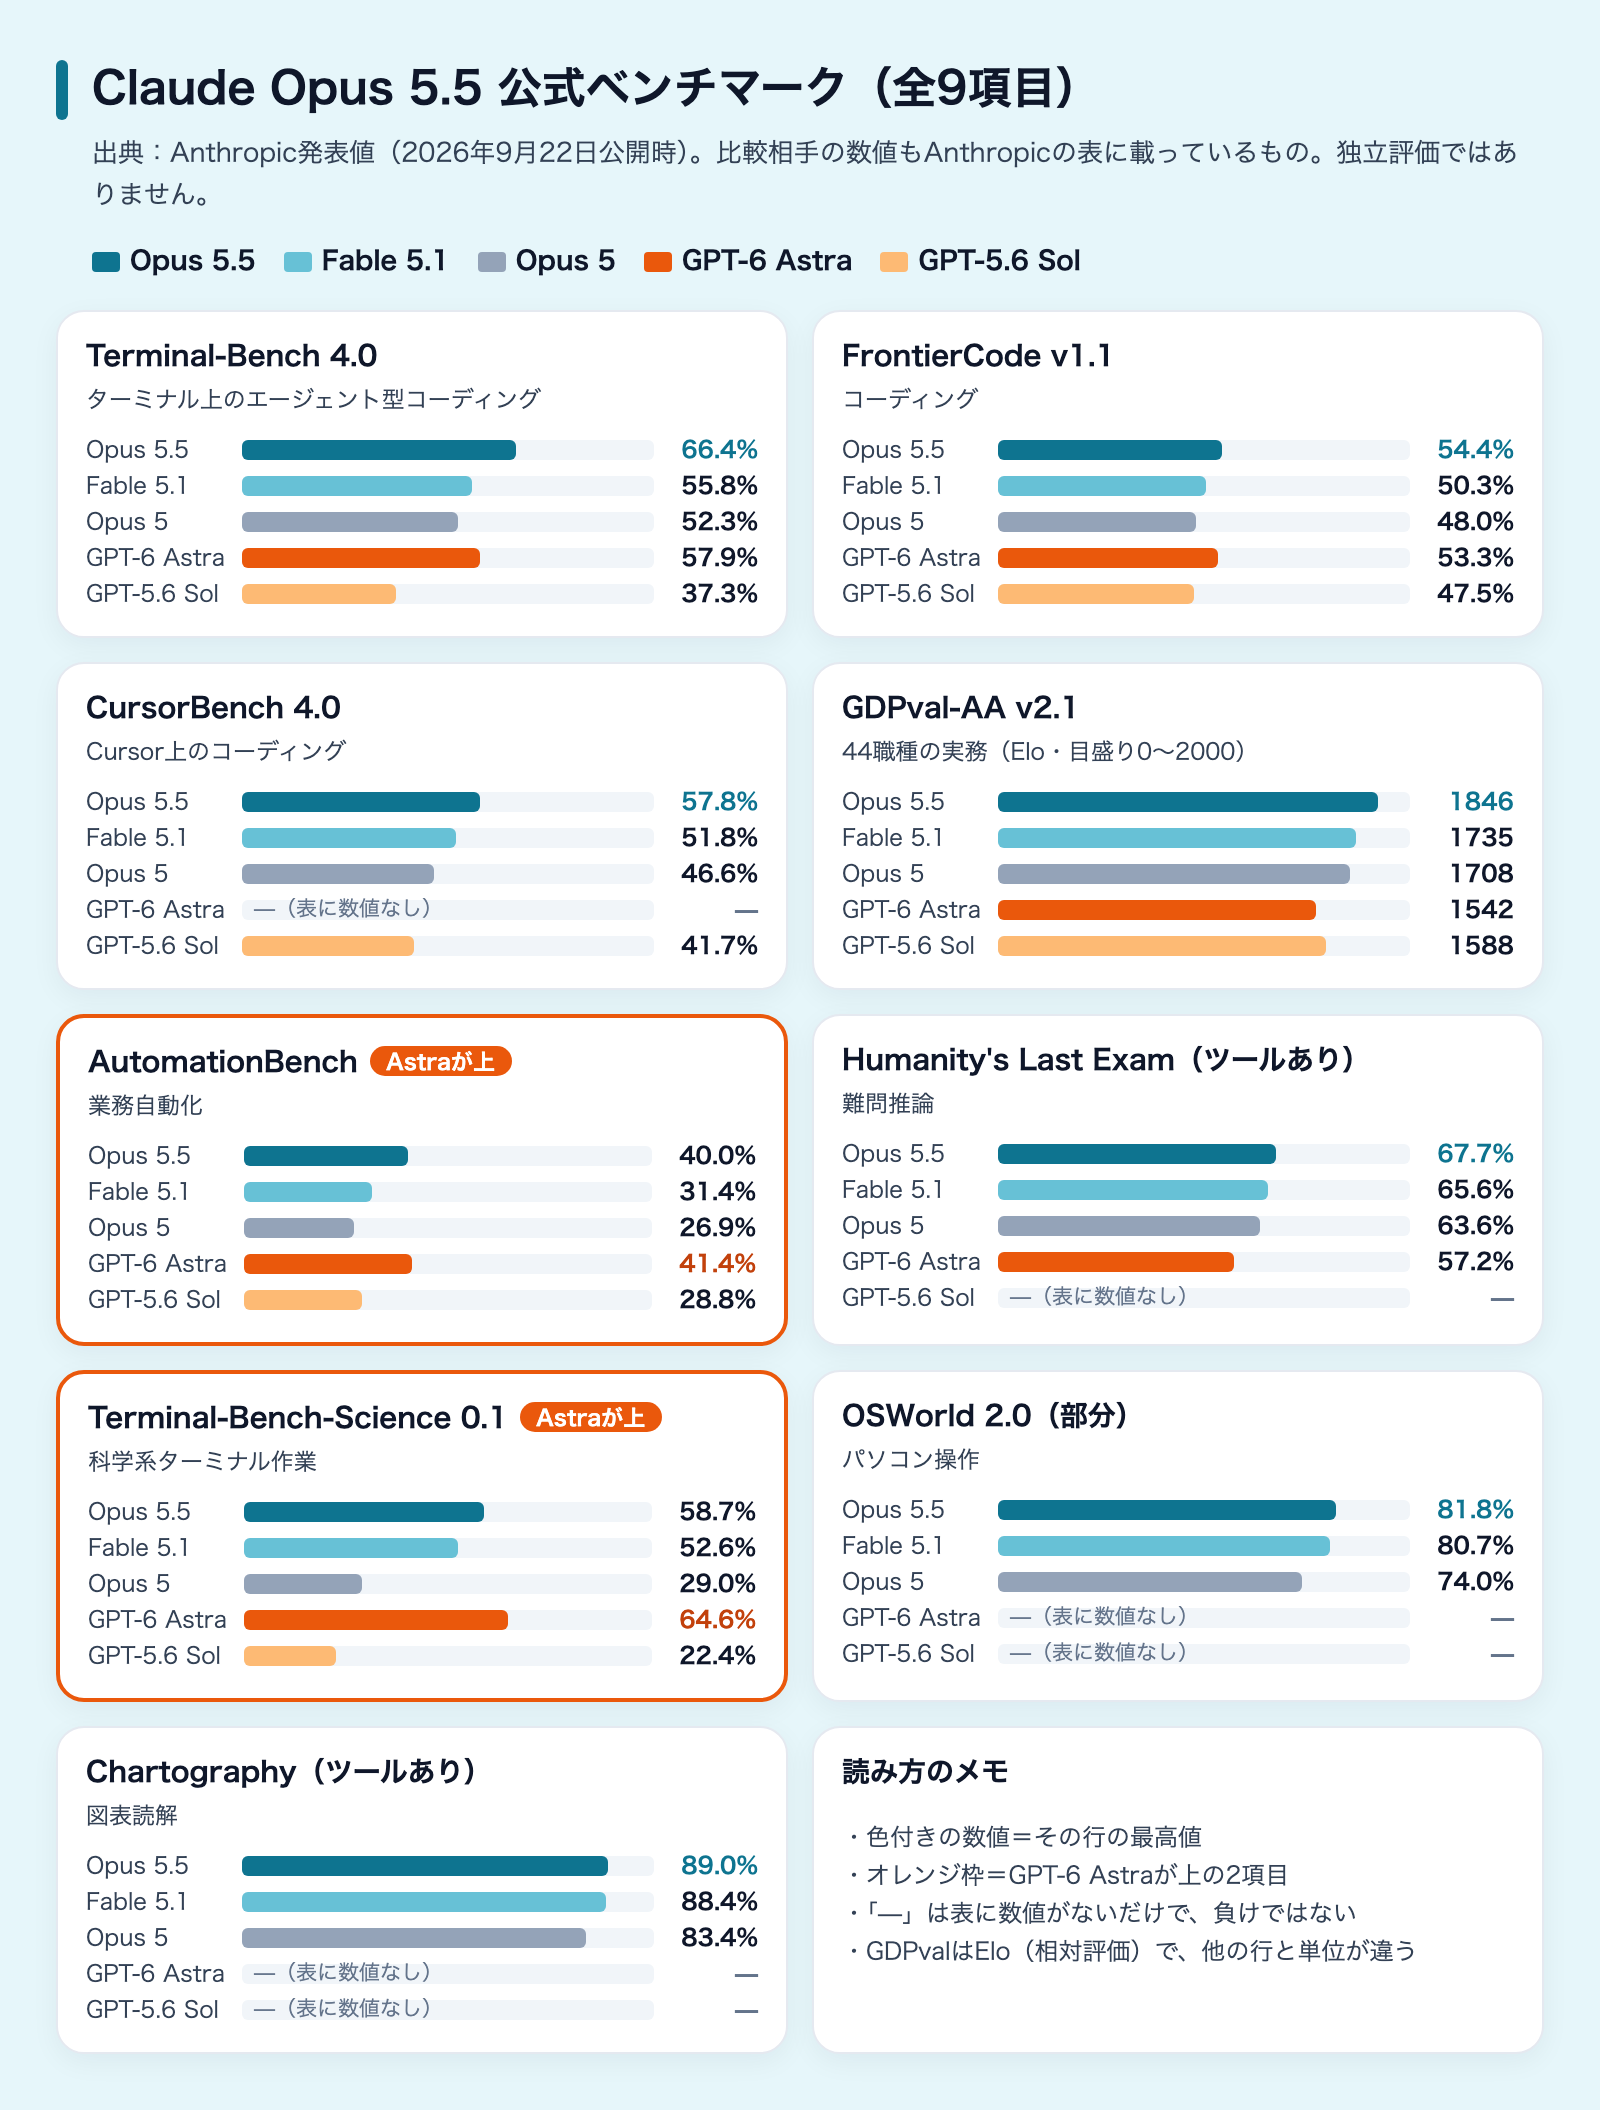
この表を見て「Opus 5.5が一番強い」で止めてしまうと、判断を誤る場面があります。点差の大きさ、測っている仕事の中身、数字の出どころの3つを分けて読むと、同じ表から得られる情報が大きく変わります。
 読者特典・無料ダウンロード最新AI「4モデル」、実務で比べてみた。無料でダウンロード →
各ベンチマークは何を測っているのか
9項目は、測っている仕事で大きく3つに分けられます。自分の仕事に近い行がどれかを先に決めておくと、表の読み方がぶれません。
コーディング系(Terminal-Bench 4.0/FrontierCode/CursorBench)
Terminal-Bench 4.0は、ターミナル(黒い画面でコマンドを打つ操作環境)の上で、AIが自分でコマンドを実行しながらコーディングを進める力を測ります。Claude Codeのように「AIに作業を任せて、ファイルの作成からテストまで回してもらう」使い方に最も近い試験です。Opus 5.5は66.4%で、Opus 5(52.3%)から14.1ポイント上がっています。
FrontierCode v1.1はコーディングの試験です。Opus 5.5は54.4%で最高値ですが、GPT-6 Astra(53.3%)との差は1.1ポイントしかありません。この差は「互角」と読むのが妥当です。
CursorBench 4.0は、コードエディタのCursor上でのコーディングを測ります。Opus 5.5は57.8%で、GPT-5.6 Sol(41.7%)より16.1ポイント高い結果です。GPT-6 Astraの数値は表に載っていません。
実務・業務系(GDPval-AA/AutomationBench)
GDPval-AA v2.1は、44職種の実務をこなす力を測ります。この行だけ単位が%ではなくElo(対戦の勝ち負けから計算する相対的な強さの指標)なので、他の行と数字の大きさを比べても意味がありません。Opus 5.5は1846で、GPT-6 Astra(1542)とは300点以上の開きがあります。資料作成や調査のような、コード以外の知識労働にOpus 5.5を使いたい人が最も注目すべき行です。
AutomationBenchは業務自動化の試験です。ここはGPT-6 Astraが41.4%で、Opus 5.5(40.0%)を1.4ポイント上回っています。
推論・操作・読解(Humanity's Last Exam/Terminal-Bench-Science/OSWorld/Chartography)
Humanity's Last Exam(ツールあり)は、非常に難しい問題に対する推論力を測ります。Opus 5.5は67.7%で、上位モデルのFable 5.1(65.6%)より2.1ポイント高い結果です。
Terminal-Bench-Science 0.1は、科学系の作業をターミナル上で進める力を測ります。GPT-6 Astraが64.6%で、Opus 5.5(58.7%)を5.9ポイント上回る、この表で最も大きなOpus 5.5の負けです。一方でOpus 5(29.0%)からは約2倍に伸びています。
OSWorld 2.0(部分)はパソコンの画面操作、Chartography(ツールあり)は図表の読み取りを測ります。どちらもOpus 5.5が最高値ですが、Fable 5.1との差はそれぞれ1.1ポイント、0.6ポイントです。この2行は、Opus 5.5とFable 5.1がほぼ並んでいると読むのが自然です。
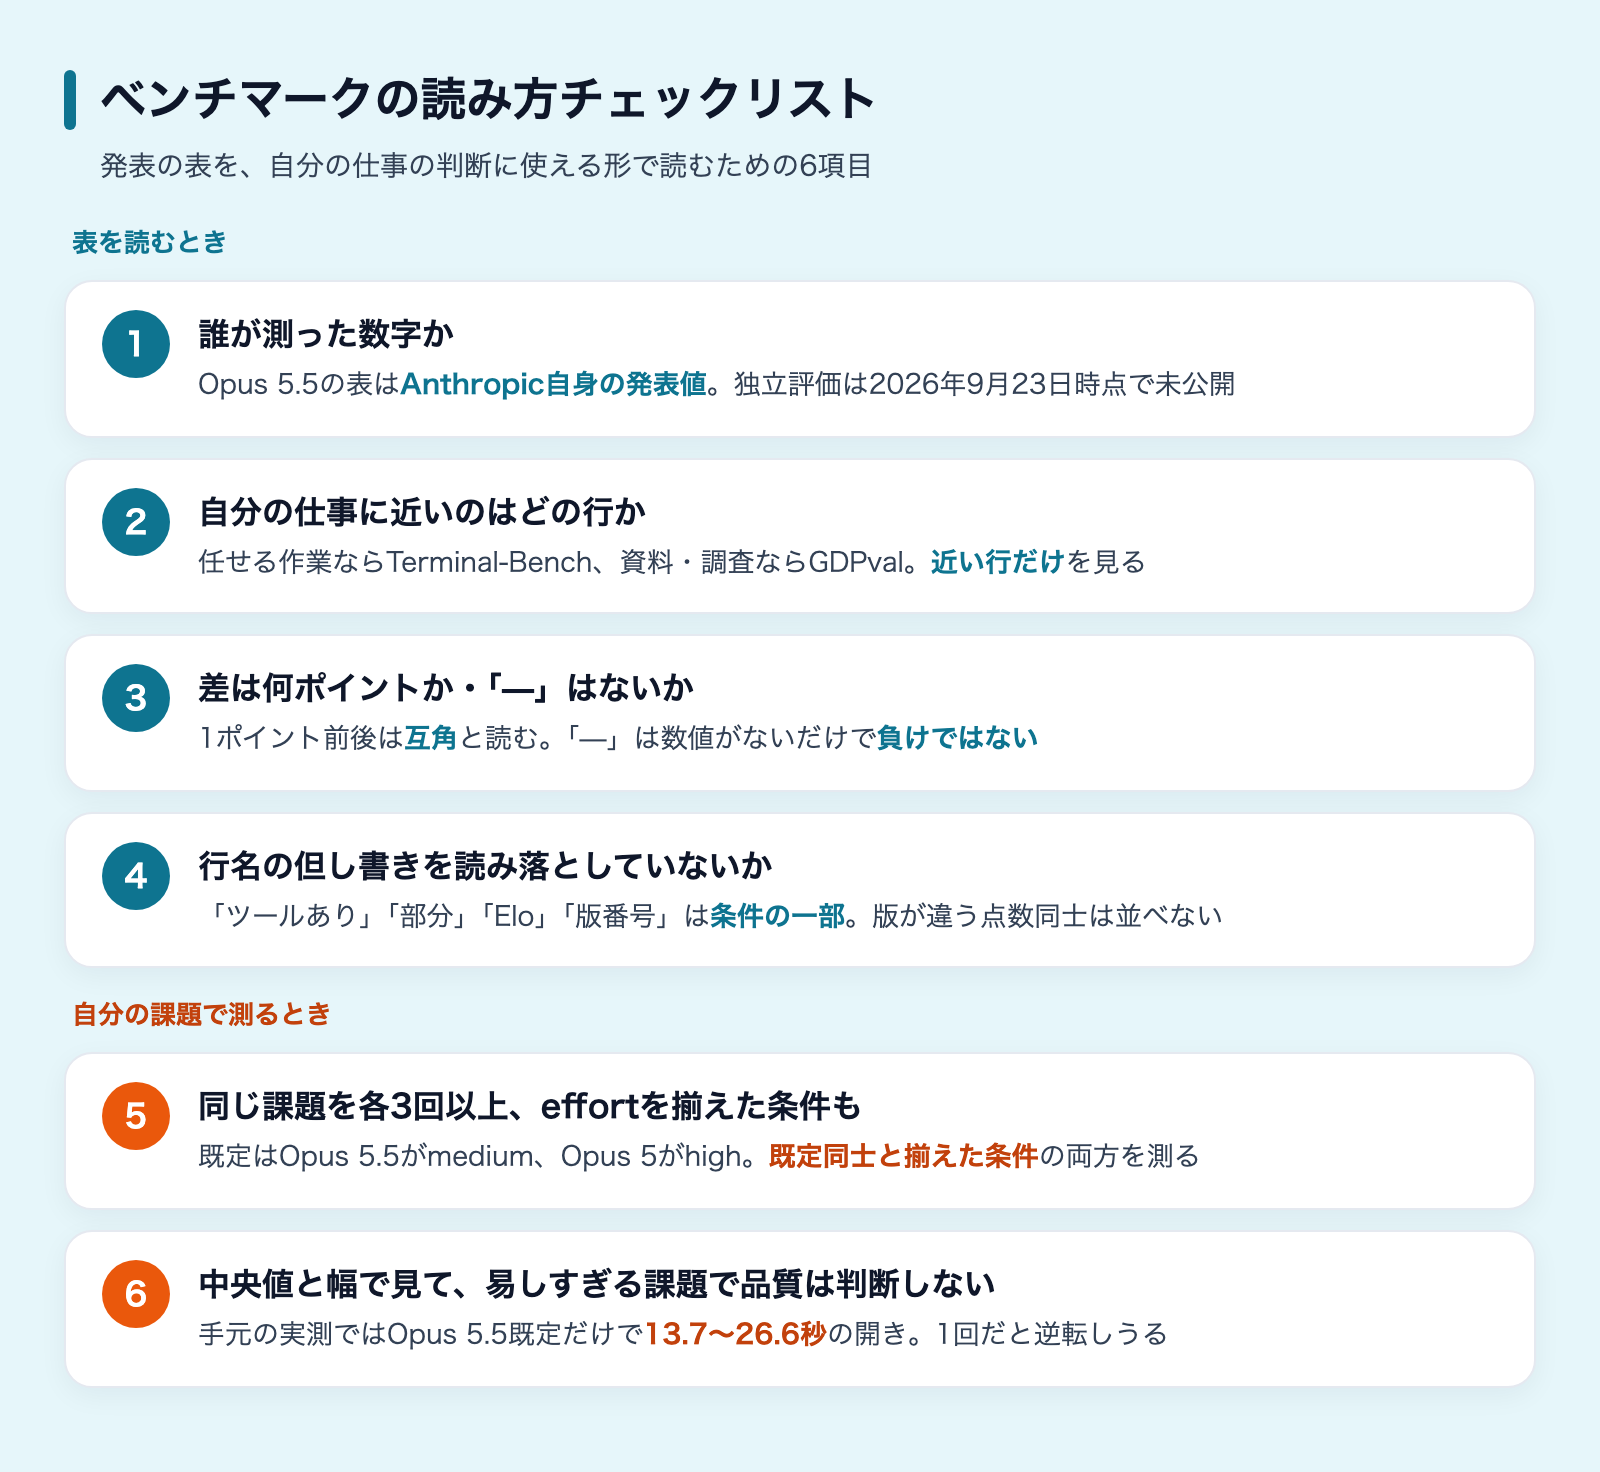
読み方1:Anthropic自身の発表値で、独立評価はまだない
この表で最初に押さえるべきは、すべてAnthropicが自社で測って発表した数字だという点です。比較相手のGPT-6 AstraやGPT-5.6 Solの数値も、Anthropicの表に載っているものです。
発表後、海外メディアのOfficeChaiは「Opus 5.5がほとんどの項目でAstraを上回り、Terminal-Bench-ScienceはAstraが上」とこの表を報じました。ただし、これは発表値を伝えた報道であって、第三者が同じ試験をやり直した結果ではありません。Artificial Analysisのような独立評価の機関から、Opus 5.5の数字は2026年9月23日時点でまだ出ていません。
発表値が信用できないという意味ではありません。どの試験を表に載せるかを選んだのが発表する側だ、という前提を持って読む、ということです。独立評価が出てくると、発表値と近い数字になるのか、差が縮むのかが分かります。それまでは、表の数字を「試す価値がある仕事の目星」として使い、断定の根拠にはしないのが安全です。
読み方2:GPT-6 Astraが上の2項目は「負け」ではなく「得意の違い」
GPT-6 Astraが上回った2項目は、業務自動化(AutomationBench:41.4%対40.0%)と科学系のターミナル作業(Terminal-Bench-Science:64.6%対58.7%)です。
業務自動化の1.4ポイント差は、FrontierCodeの1.1ポイント差と同じく互角の範囲です。一方、科学系の5.9ポイント差ははっきりした差です。研究・分析系の作業をターミナル上でAIに任せることが多い人は、Astraも候補から外さないほうがよい、というのがこの行の読み方になります。
Astraとどちらを使うかを、単価や得意な仕事まで含めて判断したい方は、こちらで整理しています。
読み方3:「—」の行と「9項目中7項目で最高値」の数え方
表には「—」が6か所あります。GPT-6 AstraはCursorBench・OSWorld・Chartographyの3行、GPT-5.6 SolはHumanity's Last Exam・OSWorld・Chartographyの3行が空欄です。OSWorldとChartographyの2行は、Anthropicの3モデル(Opus 5.5・Fable 5.1・Opus 5)だけの比較になっています。
「—」は負けではありません。数値が載っていないだけで、その行でAstraやSolが劣っているのか優れているのかは、この表からは分かりません。
この前提で「9項目中7項目で最高値」を数え直すと、中身が変わって見えます。5モデルすべての数値がそろっている行は、Terminal-Bench 4.0、FrontierCode、GDPval-AA、AutomationBench、Terminal-Bench-Scienceの5行だけです。この5行に限ると、Opus 5.5が最高値なのは3行、GPT-6 Astraが最高値なのは2行です。
「7項目で1位」は間違いではありませんが、比較相手が欠けた行も含んだ数え方です。記事やSNSで「ほぼ全勝」と紹介されているのを見たら、どの行で誰と比べた結果なのかを表に戻って確かめると、読み違いを防げます。
読み方4:Fable 5.1の数字をどう読むか
表では、上位モデルのFable 5.1をOpus 5.5が全9項目で上回っています。ただし、OSWorldは1.1ポイント、Chartographyは0.6ポイントと、差がごく小さい行もあります。また、何時間も続く長時間の作業や、Opus 5.5のeffort(思考の深さ)を上げても解けない難しい問題は、この9行では測られていません。公式がFable 5.1の出番を残しているのはまさにその領域なので、この表だけで「Fable 5.1はもう要らない」とは読めません。
どの仕事をどちらに任せるかの具体的な分け方は、こちらで整理しています。
読み方5:行名についている但し書きは、条件の一部として読む
表の行名には、数字の意味を変える但し書きがいくつかついています。数字だけを抜き出して比べると、ここが抜け落ちます。
- 「(ツールあり)」:Humanity's Last ExamとChartographyについています。ツールを使える条件で解いた成績で、同じモデルでもツールが使えない環境で同じ点が出るとは限りません。チャット画面だけで使う場合とClaude Codeのように道具を使わせる場合とでは、前提が違うと考えておくのが安全です
- 「(部分)」:OSWorld 2.0についています。行名からは何を部分的に測ったのかまでは読み取れないため、OSWorld 2.0の試験全体の成績として扱わず、但し書きごと読むのが無難です
- 「Elo」:GDPval-AAだけ単位がEloです。Eloは他のモデルとの勝ち負けから決まる相対評価なので、1846という数字そのものに「何割できた」という意味はありません。読むべきは他のモデルとの差です
- 版番号:Terminal-Bench 4.0、FrontierCode v1.1、GDPval-AA v2.1、Terminal-Bench-Science 0.1、OSWorld 2.0のように、試験名の後ろに版番号がついています。同じ名前の試験でも、版が変われば問題や採点が変わっている可能性があるので、過去のモデルの記事で見た点数と比べるときは、版番号が同じかを先に確かめます
とくに版番号は見落としやすい点です。以前のモデルの発表で見た「Terminal-Benchの点数」と今回の66.4%を並べて「何ポイント伸びた」と読むのは、版が同じときだけ成り立ちます。今回の表の中のOpus 5(52.3%)との比較であれば、同じ版・同じ表の数字なので、そのまま並べて問題ありません。
自分の課題で測る手順:数回試して、中央値と幅で見る
ここまでの読み方をまとめると、ベンチマークの表は「どの仕事で試すか」を決める材料で、乗り換えの判断は自分の課題で測って決める、という順番になります。
1回ではなく数回測る理由は、私の手元の実測にあります。2026年9月23日に、小さなコーディング課題1種類をClaude CodeでOpus 5とOpus 5.5に各3回投げたところ、速さの方向は公式の主張と一致しました。ただ、Opus 5.5の既定設定だけでも所要時間は13.7秒から26.6秒まで約2倍ぶれ、1回だけ測ると結論が逆転しうる結果でした。
この実測の条件と数字の詳細は、Opus 5との比較記事にまとめています。
測る手順は次の5つです。
- 普段の仕事から課題を1〜3個選ぶ:表の中で自分の仕事に近い行(コーディングならTerminal-Bench、資料や調査ならGDPval)を思い浮かべ、それに当たる実際の作業を選ぶ。正解が判定できる課題にする
- 今使っているモデルとOpus 5.5に、同じ課題を各3回以上投げる:1回では逆転がありうるため、最低3回
- effortを揃えた条件も入れる:Opus 5.5の既定はmedium、Opus 5の既定はhighで、既定のまま比べると設定の差が混ざる。既定同士と、揃えた条件の両方を測る
- 時間・出力トークン・正しさを記録し、中央値と幅で見る:平均ではなく中央値を使い、最速と最遅の幅も必ず残す
- 全回が正解になる易しい課題なら、品質の判断はしない:差がつく難しさの課題を追加するか、品質は実務で様子を見る
Claude Codeを使っているなら、この計測自体をClaude Codeに任せられます。たとえば次のように頼めば十分です。
「この課題を claude -p で、今のモデルと claude-opus-5-5 にそれぞれ3回ずつ投げて。--output-format json で結果を取り、所要時間・出力トークン・テストの合否を表にして、中央値と最小〜最大の幅も出して。Opus 5.5は既定のeffortと --effort high の2条件で」
表の点数を眺めて迷うより、自分の課題の数字を持っているほうが判断は早くなります。次に新しいモデルが出たときも、同じ依頼文のモデルIDを差し替えるだけで使い回せます。
まとめ:ベンチマークは「試す場所」を決める地図として読む
- Claude Opus 5.5は、Anthropicが発表した9項目のうち7項目で比較相手の中の最高値。ターミナル上のコーディング(66.4%)と44職種の実務(Elo 1846)で差が大きい
- 業務自動化と科学系のターミナル作業はGPT-6 Astraが上。表に「—」がある行は、比較できていないだけで負けではない
- すべてAnthropic自身の発表値で、2026年9月23日時点で独立評価の数字はまだない
- 5モデルの数値がそろった5行に限ると、Opus 5.5の最高値は3行、GPT-6 Astraは2行
- Fable 5.1を全項目で上回っていても差が1ポイント前後の行があり、長時間の作業や高effortでも解けない問題はこの9行では測られていない
- 「(ツールあり)」「(部分)」「Elo」「版番号」は数字の条件の一部。版が違う試験の点数同士は並べない
- 手元の小さな課題でも、同じ条件で所要時間が約2倍ぶれた。1回の計測では逆転しうる
- 乗り換えの判断は、自分の課題で各3回以上、effortを揃えた条件も含めて測り、中央値と幅で決める
株式会社Fyveでは、こうした新モデルの評価を自社の実務で回しながら、中小企業のAI活用を支援しています。発表の数字に振り回されず、自分の仕事の数字で判断する習慣を持っておくと、次のモデルが出たときも同じ手順で迷わず決められます。
最新AI「4モデル」、実務で比べてみた。
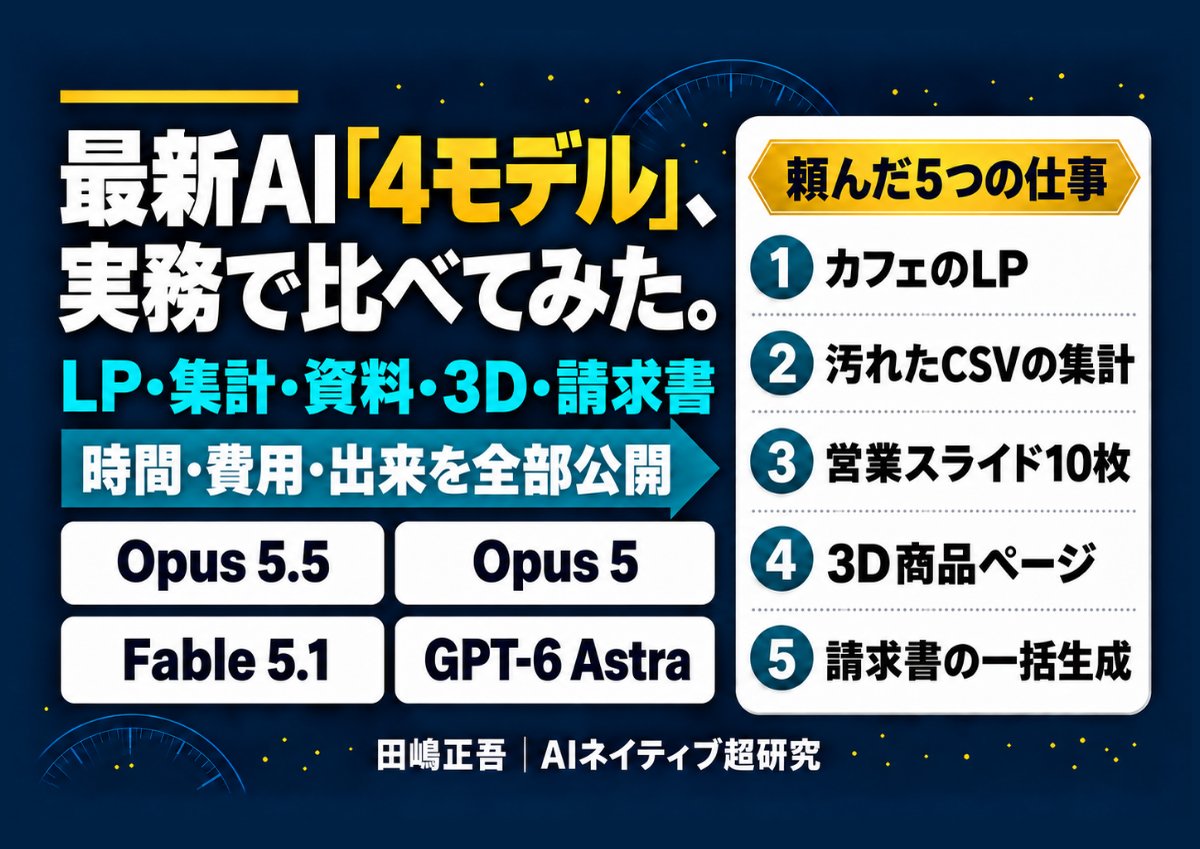
Opus 5.5・Opus 5・Fable 5.1・GPT-6 Astra に同じ5つの仕事を投げた実測(全31ページ)
公式ベンチでは、Opus 5.5 が上位の Fable 5.1 や GPT-6 Astra を多くの項目で上回りました。では実際の仕事ではどうか。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを4モデルに同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は4モデルとも全問正解。差が出たのは、速さと費用と、細かい指示の守り方でした。
- 5つの仕事 × 4モデル=20本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを4つ並べて比較(LP・スライド・回せる3D)
- Opus 5 と同じ作り込みを、Opus 5.5 がどれだけ短く終えたか
- 細かい指示を最後まで守ったのはどれか——仕事別の早見表と判断フローつき
メールアドレス登録で他にも様々な資料を閲覧できます
 +6
PDF 15点・合計400ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。