Muse Spark Openとは|商用ライセンスの条件と使い方

「Metaが公開したMuse Spark Openは、うちの会社でも無料で使えるのか」「オープンウェイトなら、社内のデータを外に出さずにAIを動かせるのか」——新しいAIモデルの公開を知ったとき、多くの担当者がこの2つで手が止まります。
結論から言うと、Muse Spark Openは社内利用や自社製品への組み込みなら、ほとんどの中小企業が無料で使えるライセンスです。ただし製品に組み込むなら「Built with Muse Spark Open」の表示が要り、資格の要る業務の代行など使ってはいけない用途も決まっています。また、データを社外に出さない使い方をするには、700GB以上のGPUメモリか、自社のクラウド契約が必要です。
株式会社Fyveは、中小企業のAI導入を支援しながら、自社でも中古のMac miniでAIの無人ジョブを毎日動かしています。この記事では、2026年10月15日に公開されたライセンス本文とモデルカードを読み、条文が実務で何を意味するのかと、私たちならどの経路で試すかを整理します。
Muse Spark Openとは|2026年10月15日公開のオープンウェイトモデル
Muse Spark Openは、Meta Superintelligence Labsが2026年10月15日に重みを公開した大規模言語モデルです。Metaは発表で「米国の研究所が出したオープンウェイトモデルとして、これまでで最も高性能」と説明しています。
オープンウェイトとは、学習済みのモデルの中身(重み)をダウンロードできる形で配ることです。ChatGPTやClaudeのように提供会社のサーバーでしか動かないモデルと違い、手元や自社のクラウドで動かせます。ただし「オープンソース」とは別物で、使い方の条件はモデルごとのライセンスで決まります。
3行でわかる要点
- 規模:総パラメータ8,160億、1トークンあたりに使うのは420億(Mixture of Experts=専門家を切り替える構造)。文脈は最大100万トークン
- 入力:テキスト・画像・動画・音声を受け付け、出力はテキスト
- ライセンス:Meta独自の「Muse Model License」。改変・蒸留・販売まで認める一方、表示義務と利用ポリシーがある
公開されたモデルの仕様
項目 | 内容 |
|---|---|
公開日 | 2026年10月15日 |
構造 | Mixture of Experts(256の専門家のうち1トークンごとに8つを使用・62層) |
パラメータ | 総8,160億/アクティブ420億 |
文脈の長さ | 最大100万トークン |
入出力 | 入力:テキスト・画像・動画・音声/出力:テキスト |
言語 | 100以上の言語のデータで学習(すべての言語で評価済みではない) |
考える深さ | low/medium/high/xhighの4段階。既定はxhigh |
配布形式 | BF16とNVFP4(4ビットに圧縮した形式) |
SiliconANGLEの報道によると、このモデルは2026年8月に出た非公開版のMuse Spark 1.2を土台に、Metaのサービス側の安全装置がなくても動くよう追加の安全学習をかけたものです。一方で、10月12日に発表された上位のMuse Wonderは引き続き非公開で、Metaの有料APIとMuse Code経由でしか使えません。つまりMetaの最上位ではなく、一段下のモデルを開いたという位置づけです。
なお、9月に発表された個人向けのAIエージェント「Meta Muse」は別の製品です。名前が似ているので混同しないよう注意してください。
Muse Model Licenseで商用利用できる範囲
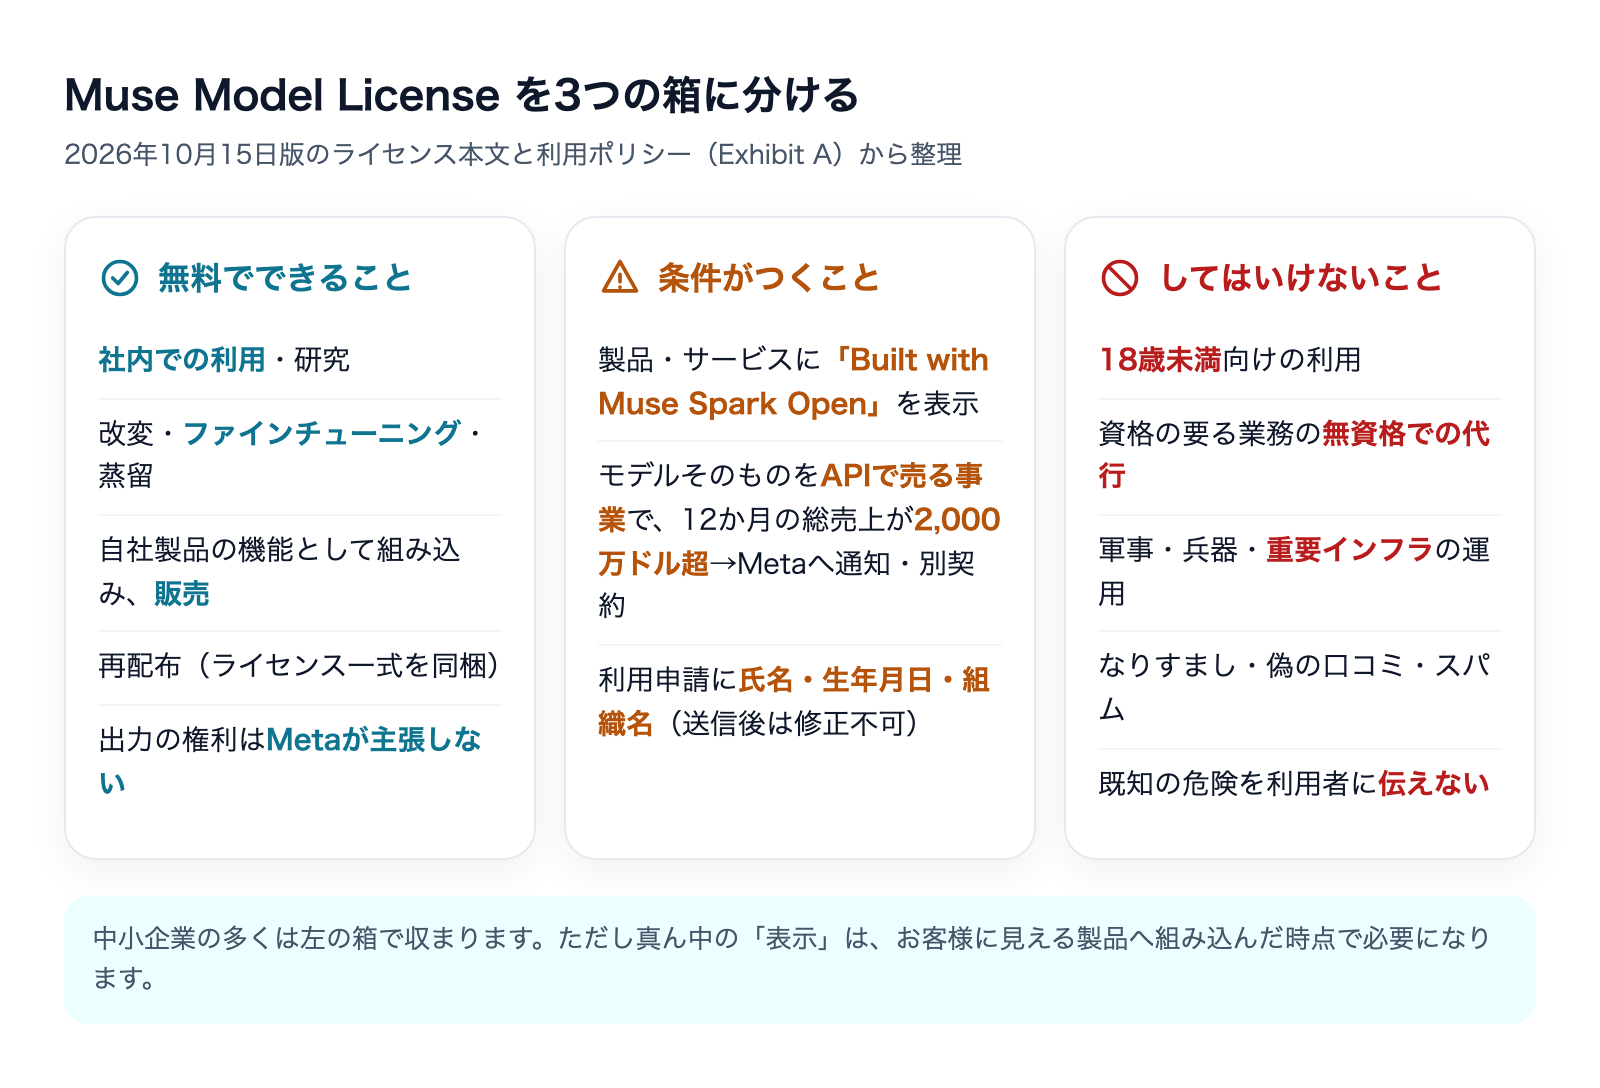
中小企業がいちばん知りたいのは「お金を払わずに仕事で使えるか」でしょう。ライセンス本文(Hugging FaceのLICENSE.md)を読むと、答えはほぼ「使える」です。冒頭で、使用・複製・改変(ファインチューニングを含む)・派生物の作成・蒸留・公開・配布を、無償で認めています。
無料でできること
- 社内での利用と研究:社内の文書整理や問い合わせの下書きに使う、といった用途
- 改変・ファインチューニング・蒸留:自社のデータで追加学習させたり、小さなモデルに知識を移したりできる
- 自社製品への組み込みと販売:自社のアプリやサービスの一機能として動かし、それを売ってよい
- 出力の扱い:第4条で「Metaはソフトウェアが生成した出力の所有権を主張しない」と明記
2,000万ドルの条件が当てはまるのは「モデルを売る事業」だけ
報道で目立った「年間売上2,000万ドル超は別契約」という条件は、第3条のModel as a Service(モデルをサービスとして売る事業)にだけかかります。第三者にAPIなどでAIモデルそのものを使わせる事業で、自社と関連会社の総売上が連続する12か月で2,000万ドルを超えた場合、事前にMetaへ通知し、別の書面契約を結ぶ必要があります。
同じ第3条で、(a)社内利用・研究・それ以外の商業活動、(b)自社製品の機能の一部として使うこと(モデルを売る形でないもの)は対象外と書かれています。つまり、AIの推論APIを売る事業者でなければ、会社の売上規模に関係なくこの条件は関係ありません。
「Built with Muse Spark Open」の表示義務
見落としやすいのが第2条の表示義務です。Muse Spark Open、またはそれを改変・蒸留したモデルを使う製品やサービスでは、画面・説明書・Webサイト・設定メニューのいずれかに「Built with Muse Spark Open」と目立つように表示しなければなりません。
ここでいう派生物(Derivatives)は広く定義されていて、Muse Spark Openの出力を使って学習・改変・蒸留したモデルも含まれます。たとえば「Muse Spark Openで作った問答集で別の小さなモデルを学習させた」場合も、表示の対象になると読むのが安全です。
社内でしか使わないツールに表示が要るかは、条文が「各製品またはサービス」という書き方のため読み切れません。私たちなら、社内ツールでも設定画面か社内マニュアルに1行書いておきます。手間はほとんどかからず、後から解釈で揉めるよりずっと安いからです。
利用ポリシーで禁止されている使い方
ライセンスには「Exhibit A」として利用ポリシーが付いていて、これを守ることが利用の条件です(第1条)。2026年10月15日付のポリシーから、中小企業の業務に関係しそうなものを抜き出します。
禁止の分類 | 業務で引っかかりやすい例 |
|---|---|
対象年齢 | 18歳未満が使うことは想定していない。子ども向けサービスに組み込むなら、提供側でリスクを評価し対策する必要がある |
無資格での専門業務 | 法律・税務・医療など、資格の要る助言をAIが代わりに行うサービス |
高リスクの用途 | 軍事・兵器、重要インフラの運用、違法薬物、自傷につながる用途 |
欺く行為 | 詐欺、偽情報、スパム、なりすまし、偽の口コミやエンゲージメントの生成 |
危険の不告知 | AIを使ったシステムの既知の危険を、利用者に適切に伝えないこと |
特に注意したいのは「無資格での専門業務」と「偽の口コミ」です。たとえば士業の事務所が顧客向けに自動回答を出す場合、AIの回答をそのまま助言として出す設計は避け、資格者が確認する工程を挟むべきです。また、店舗の口コミ返信の下書きは問題になりにくい一方、口コミそのものを作らせるのは明確に禁止に当たります。
もう1つ、ライセンスの第5条は、ソフトウェアも出力も「現状のまま」提供され、派生物の安全性・展開・利用の責任はすべて利用者が負うと定めています。モデルカードも、安全性の評価結果は「改変したモデルには当てはまると考えないこと」と書いています。自社で追加学習したら、安全面の確認も自社の仕事になります。
性能はどの程度か|Metaが公開したベンチマーク
モデルカードには、他のオープンウェイトモデルとの比較表が載っています。いずれもMeta自身が出した数字で、第三者の再現ではない点に注意してください。
ベンチマーク(測るもの) | Muse Spark Open | 比較対象の例 |
|---|---|---|
MCP-Atlas(ツールを使いこなす力) | 89.2 | Qwen3.8 84.5/GLM 5.3 84.2/Kimi K3 82.3 |
JobBench(業務タスクをやり切る力) | 61.8 | GLM 5.3 61.4/Kimi K3 54.3 |
OSWorld Verified(PC操作) | 80.4 | Kimi K3 84.8 |
Terminal-Bench 2.1(端末でのコーディング) | 76.4 | Kimi K3 85.0/GLM 5.3 83.9/Qwen3.8 82.0 |
Artificial Analysis Intelligence Index(総合) | 39 | GLM 5.3 45/Kimi K3 44/Qwen3.8 40 |
読み取れるのは、ツールを呼び出して作業を進める力は比較対象の中で最も高く、コーディングと総合指標では中国製の上位モデルに届いていないということです。MCP-AtlasはSiliconANGLEによると、36の実際に動くMCPサーバー上の220のツールを使う試験です。業務システムとつないで手順をこなすエージェント用途を想定しているなら、候補に入れる価値があります。
日本語の性能は、モデルカードに個別の記載がありません。「100以上の言語で学習、ただしすべては評価していない」とあるだけです。日本語の文書を扱う業務に使うなら、自社の実際の書類で試してから判断してください。
Muse Spark Openを使う3つの経路と費用
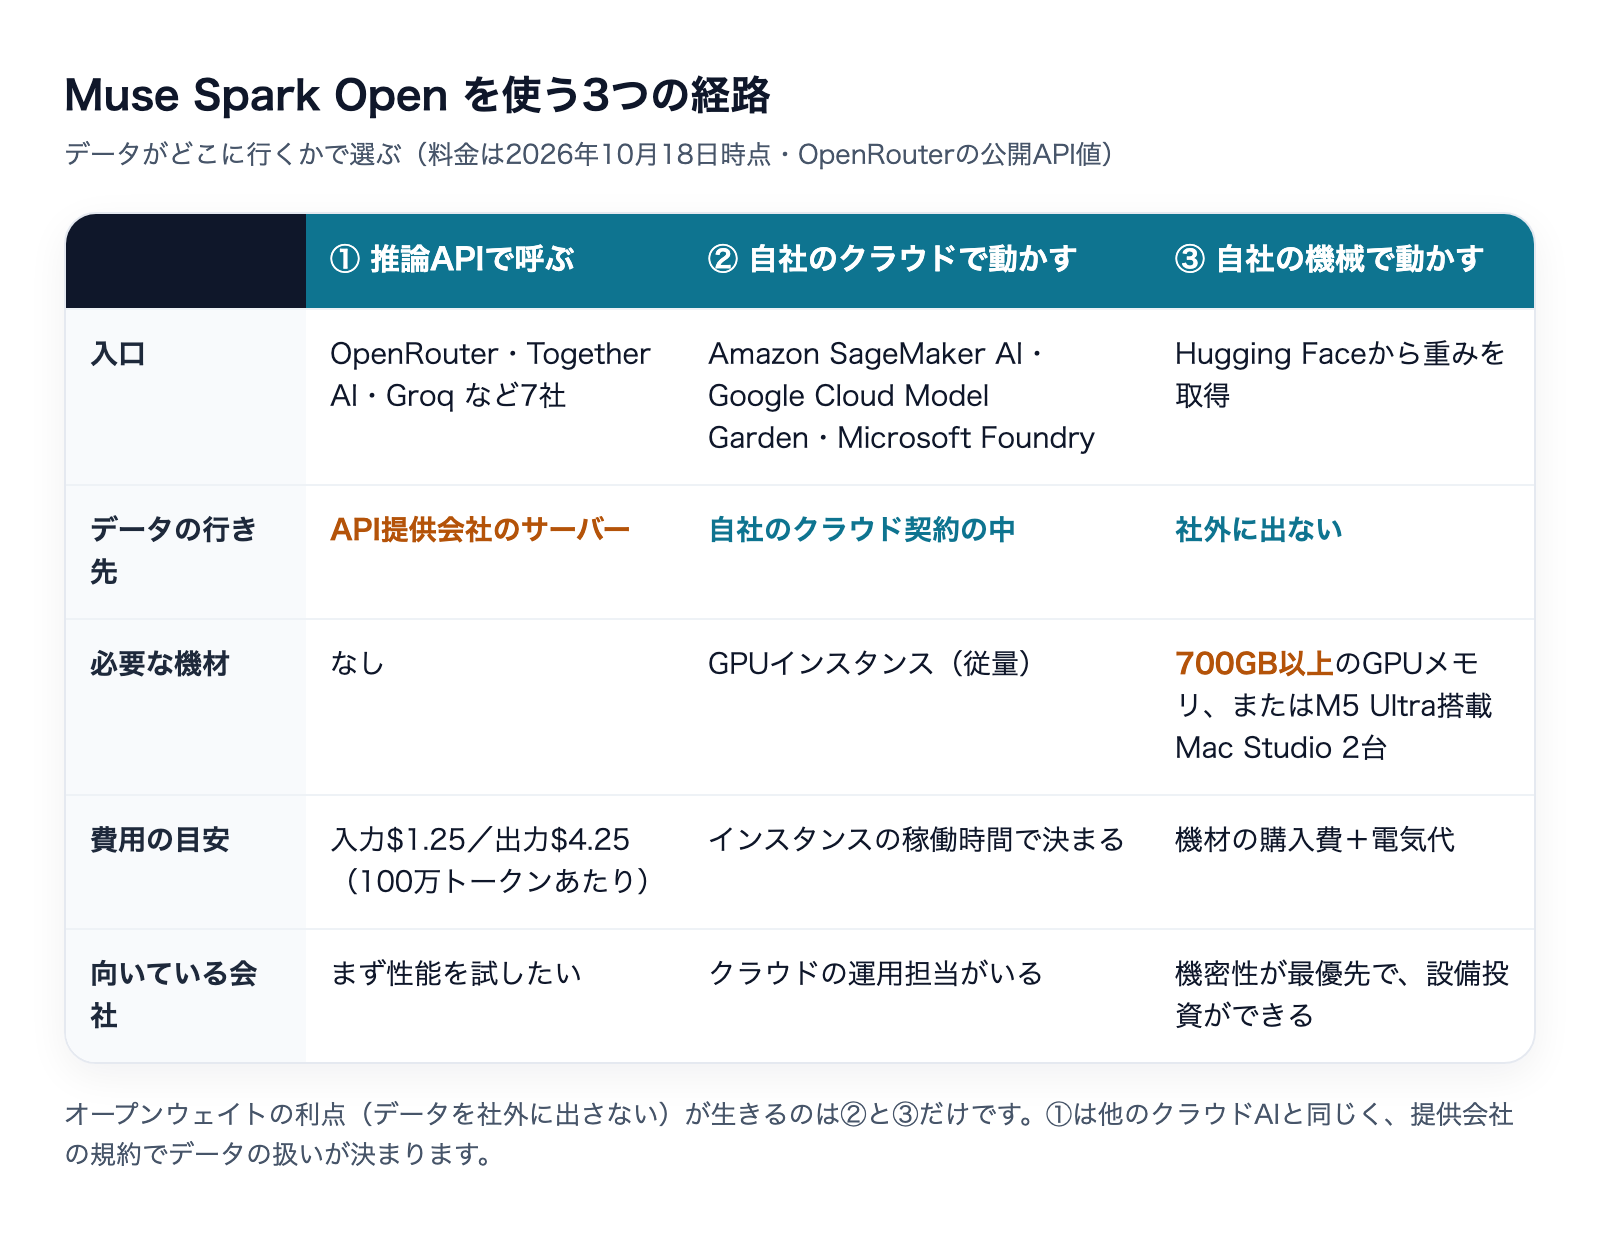
Metaの発表では、使い方の入口が3種類用意されています。どれを選ぶかで、オープンウェイトの利点が生きるかどうかが変わります。
① 推論APIで呼ぶ(いちばん手軽)
Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AIの7社が、公開当日からAPIで提供しています。OpenRouterの公開APIでは、2026年10月18日時点で入力100万トークンあたり1.25ドル、出力100万トークンあたり4.25ドル(米ドル・税の扱いは記載なし)です。契約前に最新の価格をOpenRouterの公式ページでご確認ください。
たとえば、長めの社内資料を読ませて要点をまとめる作業で、入力100万トークン・出力20万トークンを使うと、1.25ドル+0.85ドルで約2.1ドルです。性能を試すにはこの経路が最も早く、機材も要りません。
ただし、この経路ではデータはAPI提供会社のサーバーに送られます。データの扱いはその会社の規約で決まり、ChatGPTやClaudeのAPIを使うのと条件は変わりません。「オープンウェイトだから安全」とはならない点に注意してください。複数のAPI提供会社をまとめて使う入口の考え方は、こちらで整理しています。
② 自社のクラウドで動かす(データを自社の契約内に置く)
重みは、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Modelsのモデルカタログからも取得できます。自社が契約しているクラウドの中でモデルを動かせば、データは自社の契約の範囲に留まります。
費用は使うGPUインスタンスの稼働時間で決まるため、一律の金額はありません。常時起動しておくと高くつくので、使う時間帯だけ立ち上げる運用が前提になります。すでにAWSやAzureを社内で運用している会社なら、最も現実的な「データを外に出さない」選択肢です。
③ 自社の機械で動かす(機材のハードルが高い)
モデルカードによると、圧縮版(NVFP4)でも少なくとも700GBのGPUメモリ、圧縮しない版(BF16)では2TBが必要です。Metaは、M5 Ultraを積んだMac Studio 2台をAppleのMLXでつなぎ、合計約1TBのメモリで動かす構成を実演しています。
この構成で動く「デスクトップで動く初めてのこのクラスのモデル」という打ち出しは目を引きますが、Mac Studioの最上位構成を2台そろえる投資になります。機密性の高いデータを大量に扱い、社外のサーバーに一切出せない事情がある会社以外には、まず①か②で試すことをおすすめします。
私たちならどう判断するか|Mac miniで無人ジョブを回す立場から
私たちはまだMuse Spark Openを業務に入れていません。ここでは、自社でAIの無人ジョブを毎日動かしている立場から、どこを見て判断するかを書きます。
手元の機械で動かす案は、桁が違う
私たちの無人ジョブは、中古で買ったMac mini(M1・メモリ16GB)で24時間動いています。2026年5月にこの機械を用意したとき、手元でAIモデルを動かす構成も比べました。そのときの結論は、16GBの機械で実用になるのは、140億パラメータのモデルを4ビットに圧縮したもの(重みが約9GB)までというものでした。macOS自体が数GBを使い、長い文章を扱うとさらにメモリを食うためです。そこで、機械は常駐させる役に割り切り、AIの推論はAPIに任せる構成を選びました。
Muse Spark Openが求める700GBは、私たちの機械のメモリの40倍以上です。中小企業が手持ちのPCで動かせる大きさではありません。「オープンウェイト=自社のPCで無料で動く」と受け取ると判断を誤ります。現実の選択肢は①か②です。
オープンウェイトの本当の利点は「同じ版を使い続けられる」こと
私たちの無人ジョブは、どのAIモデルを使うかを1つのファイルの1か所で指定しています。モデルの世代が変わるたびにそこを書き換えていて、直近では2026年10月11日に2行を書き換えました。クラウドのAIでは、古い版をいつ終えるかは提供会社が決めます。そのたびに、出力の癖が変わっていないかを確かめ直す手間が発生します。
重みを手元(②か③)に持てば、業務の手順が固まった後も、同じ版で好きなだけ動かし続けられます。帳票の読み取りや定型文の分類のように、毎回同じ結果が出ることのほうが、最新の賢さより大事な業務では、ここが最大の利点です。逆に①のAPI経由では、提供会社がその版の提供をやめれば使えなくなるので、この利点は得られません。提供終了への備え方はこちらにまとめています。
既定の「xhigh」は、そのまま使うと費用がかさむ
モデルカードによると、考える深さの既定値は4段階で最も深いxhighです。深く考えるほど出力トークンが増え、API経由なら料金に、自社クラウドなら処理時間に跳ね返ります。モデルカード自身も、複雑な問題やコーディングにはhighかxhigh、速く短い答えが欲しいときはlowかmediumを勧めています。
私たちも、文章を書くジョブと定型の転記をするジョブで、使うモデルを分けています。全部を最上位にすると、費用だけが増えて結果はほとんど変わらないからです。Muse Spark Openを使うなら、要約や分類はlow、手順の多い作業だけhighと、仕事ごとに段階を決めておくのが安全です。この配分の考え方はこちらで詳しく書いています。
「AIの答えを別のAIが確かめる」用途は相性がよい
モデルカードは、得意な用途の1つに「LLM-as-a-judge(AIの出力を別のAIが評価すること)」を挙げています。私たちも、記事を公開する前に、書いたAIとは別の処理に検査をさせる仕組みを使っています。こうした検査は社内利用なので、第3条の2,000万ドルの条件にはかかりません。
ただしモデルカードは、取り返しのつかない操作の前には人が確認する工程を入れること、モデルの考える過程をそのまま利用者に見せないこと、システム側でも安全装置を重ねることを推奨しています。AIに検査をさせる場合でも、最後に止められる人や仕組みを残しておくのが前提です。
導入前に確認する5つのこと
ここまでの内容を、社内で検討するときのチェックリストにまとめます。
- 用途が利用ポリシーに当たらないか:資格の要る助言の代行、口コミの生成、18歳未満の利用がないかを確認する
- 表示義務をどこで満たすか:お客様に見える製品なら、画面か説明書に「Built with Muse Spark Open」を入れる場所を決める
- データをどこに置くか:社外に出せないデータを扱うなら①のAPIは使わず、②の自社クラウドを前提にする
- 日本語の精度を自社の書類で試したか:モデルカードに日本語の評価はない。実際の帳票やメールで10件ほど試す
- 考える深さを仕事ごとに決めたか:既定のxhighのまま全部を流さない
なお、Hugging Faceから重みを取得するには申請が必要です。申請フォームでは、正式な氏名・生年月日・略称でない正式な組織名を求められ、送信後は修正できません。会社として使うなら、誰の名前で申請するかを先に決めておきましょう。
Muse Spark Openのよくある質問
Q. 商用利用は本当に無料ですか
社内利用や自社製品への組み込みなら、ライセンス料はかかりません。別契約が必要になるのは、AIモデルそのものをAPIなどで第三者に売る事業で、総売上が12か月で2,000万ドルを超える場合だけです。ただし、動かすための計算資源(APIの利用料やクラウドの費用)は別途かかります。
Q. オープンソースのモデルと考えてよいですか
いいえ。重みは公開されていますが、表示義務や利用ポリシーなど、一般的なオープンソースライセンスにはない条件が付いています。報道でも「オープンソースではなく独自ライセンス」と扱われています。
Q. 日本の会社でも使えますか
ライセンス本文には、欧州の利用者はMeta Platforms Ireland、それ以外はMeta Platforms, Inc.が契約相手になるという定めがあるだけで、日本を除外する記載はありません。日本語の性能は公式に評価されていないため、業務の書類で試してから判断してください。
Q. 社内だけで使うツールにも「Built with」の表示は必要ですか
条文は「各製品またはサービス」に表示を求める書き方で、社内ツールの扱いは明記されていません。私たちは、社内ツールでも設定画面かマニュアルに1行書いておくことをおすすめします。
Q. ChatGPTやClaudeの代わりになりますか
目的によります。ツールを使って手順をこなす力はMetaの比較表で上位ですが、コーディングや総合指標では他のオープンウェイトモデルに届いていない項目もあります。「データを自社の契約内に置きたい」「同じ版を長く使い続けたい」という事情があるときに、検討する意味が大きいモデルです。
まとめ|重みが公開されたことと、自社で動かせることは別
Muse Spark Openは、改変・蒸留・販売まで認める、中小企業にとって使い勝手のよいライセンスで公開されました。2,000万ドルの条件はモデルを売る事業者向けで、ほとんどの会社には関係ありません。押さえるべきは、製品に組み込むときの「Built with Muse Spark Open」の表示と、資格業務の代行や口コミ生成などの禁止用途です。
一方で、データを社外に出さずに動かすには、700GB以上のGPUメモリか自社のクラウド契約が要ります。まずはAPIで性能を確かめ、データの置き場所と同じ版を使い続ける必要性が見えてから、自社クラウドへ移す順番が現実的です。株式会社Fyveでは、こうしたモデル選びとデータの置き場所の判断から、AI導入の伴走をしています。
参照した一次情報
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。