Grok 4.7とは|料金は安いのに実費が高い理由

「Grok 4.7は入力100万トークンあたり2ドルらしい。これなら開発コストを半分にできるのでは」——新しいモデルの料金表を見たとき、誰もが一度はこう考えます。
結論から言うと、単価の安さは実費の安さに直結しません。公開直後に第三者機関が独立計測した数字では、Grok 4.7は1タスクあたりの実費でGPT-6 Astraを上回っています。トークン単価は安いのに、支払う金額は高くなるという逆転が起きています。
株式会社Fyveは、無人で動くAIジョブを毎日回しながら、中小企業のAI導入を支援しています。この記事では公式発表・公式ドキュメント・第三者の独立計測を突き合わせ、Grok 4.7を「どこに入れて、どこには入れないか」を自分で判断できる形に整理します。
Grok 4.7とは|2026年9月21日公開のコーディング・知識労働向けモデル
Grok 4.7は、xAI(公式サイトおよび開発者ドキュメント上の表記は「SpaceXAI」)が2026年9月21日に公開した最新モデルです。公式発表のタイトルは「Introducing Grok 4.7」で、位置づけは「コーディングと知識労働のための最も高性能なモデル」とされています。
公開日は3つの独立した情報源で一致しています。公式発表ページの日付、同日のThe Decoderの報道、そして独立計測を行うArtificial Analysisのモデルページがいずれも2026年9月21日としています。
公式が挙げている変更点
公式発表が「何を変えたか」として挙げているのは、次の4点です。
- ベースモデルが大きくなった — Grok 4.6と比べて、より大きな新しいベースモデルを使っている
- 強化学習を長く回した — より難しいタスクの組み合わせで、完了まで数時間かかる問題に重みを置いて訓練した
- 自分の出力を検証する力を上げた — 自分の作業をより慎重に確認し、長い文脈の扱いが改善した
- 自社のエージェント環境をネイティブに理解する — Grok Botのハーネスを前提に訓練し、対話タスクと一般的な知識労働を強化した
価格と速度については、公式が「Grok 4.6と同じ価格・同じ速度で提供する」と明記しています。値上げなしで世代を上げた形です。
スペックの要点
公式の開発者ドキュメントに記載されている仕様は次のとおりです(2026年9月22日時点)。
項目 | 値 |
|---|---|
モデル名 |
|
コンテキストウィンドウ | 500,000トークン |
知識のカットオフ | 2026年5月 |
入出力 | 入力はテキストと画像/出力はテキスト |
出力上限 | テキスト出力の上限なし |
推論の強度 | low / medium / high(既定)/ xhigh の4段階 |
入力単価 | 100万トークンあたり2.00ドル |
出力単価 | 100万トークンあたり6.00ドル |
対応API | Responses API / Chat Completions |
ツール | 関数呼び出し・Web検索・X検索・コード実行 |
推論の強度が4段階ある点は、後で出てくるベンチマークの読み方に直結します。同じ「Grok 4.7」でも、highで測った数字とxhighで測った数字は別物だからです。
要約記事で見かけるが、一次情報では確認できない項目
ここは正直に書いておきます。この記事を書く前に集めたニュース要約には「パラメータ数2.1兆」「SpaceXのエンジニアリングデータセットを活用」といった記述が含まれていました。
しかし公式発表ページと公式ドキュメントを読み直したところ、どちらの記述も一次情報では確認できませんでした。公式が書いているのは「Grok 4.6より大きい新しいベースモデル」という相対的な表現だけで、具体的なパラメータ数は公開されていません。訓練データの出所についても同様です。
Artificial Analysisのモデルページも「プロプライエタリ(重みは非公開)」と記載しており、パラメータ数は確定情報として扱っていません。私はこの2項目を本文に書かないことにしました。数字を1つ盛るより、出所が言えない数字を落とすほうが読者の判断には役立ちます。
料金の読み方|$2/$6の裏にある「200kトークンの崖」
Grok 4.7の料金で最初に押さえるべきは、単価表が1行ではなく2行あることです。
公式料金表(2026年9月22日時点)
条件 | コンテキスト | 入力/100万 | キャッシュ入力/100万 | 出力/100万 |
|---|---|---|---|---|
プロンプトが20万トークン未満 | 50万 | $2.00 | $0.50 | $6.00 |
プロンプトが20万トークン以上 | 50万 | $4.00 | $1.00 | $12.00 |
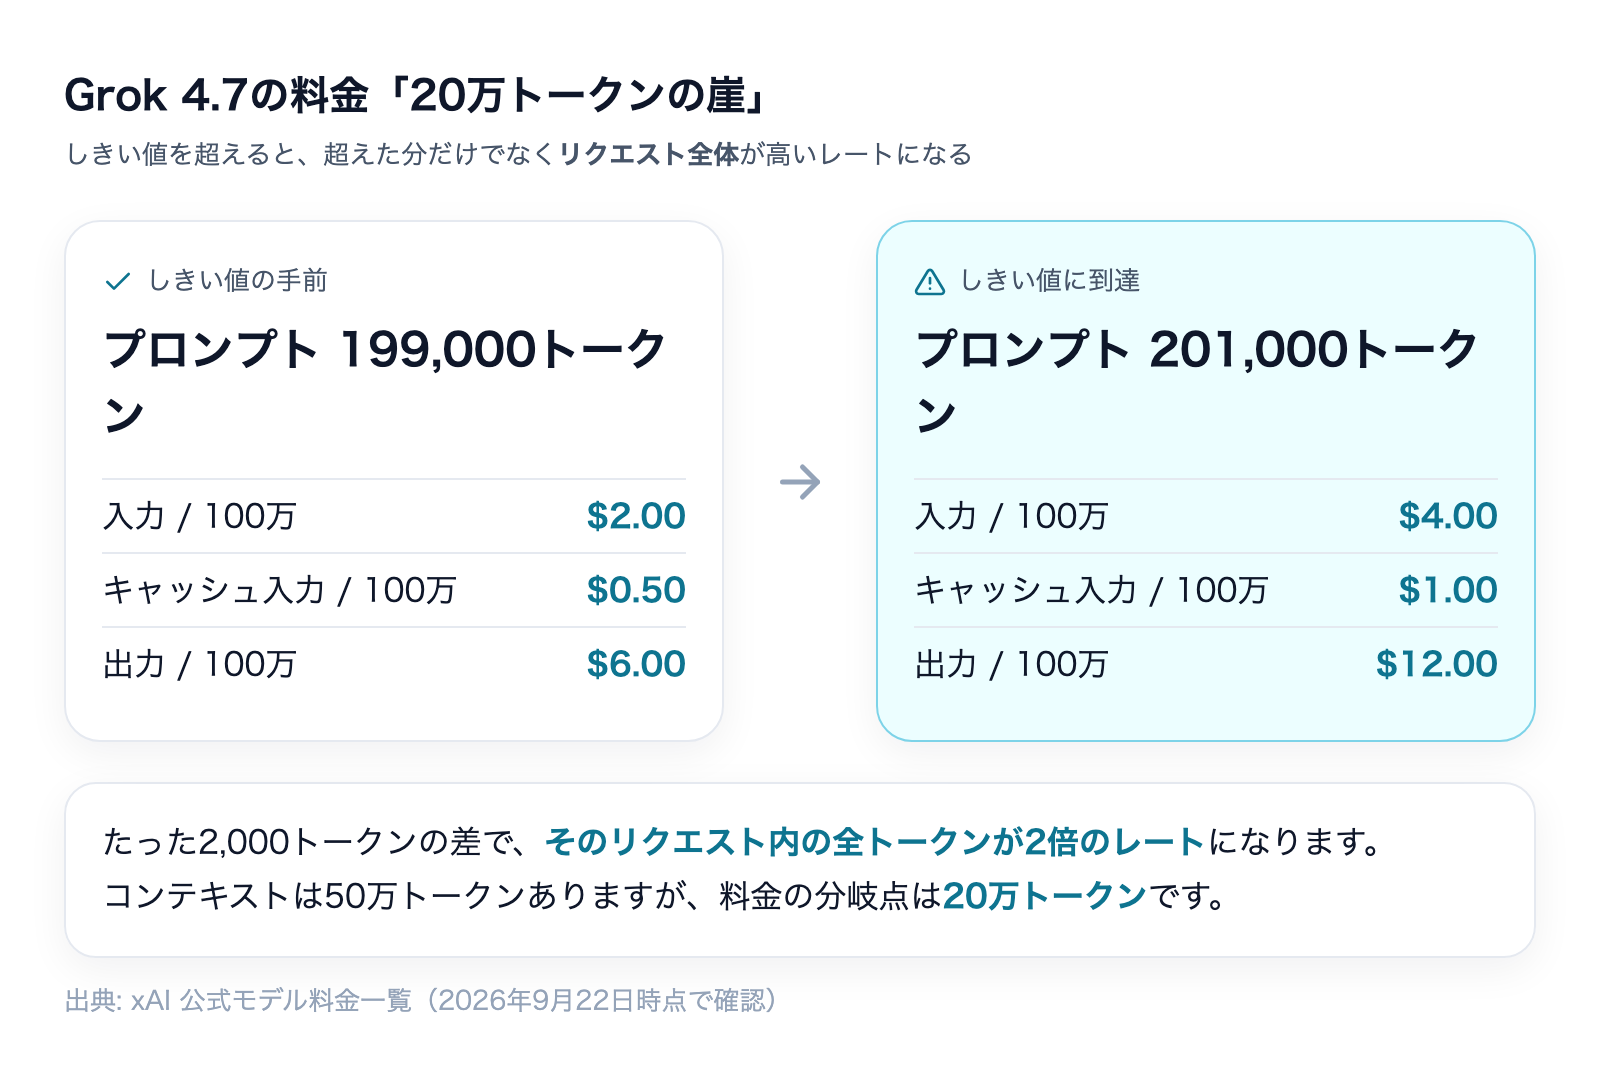
公式料金ページには、この2行の意味について重要な注記があります。「しきい値に達したリクエストは、そのリクエスト内のすべてのトークンが高いほうのレートで課金される」という但し書きです。
つまり20万トークンを超えた瞬間、超えた分だけが高くなるのではありません。そのリクエスト全体が倍額になります。19万9,000トークンのプロンプトと20万1,000トークンのプロンプトでは、単価が2倍違うということです。
コンテキストウィンドウが50万トークンあるので「長い文脈を投げられる」と読めますが、料金の設計上は20万トークンが実質的な分岐点になっています。長時間動くエージェントに使うときほど、ここが効いてきます。
もう3つの但し書き
公式ドキュメントには、見落とすと計算が狂う条件がさらに3つ書かれています。
- Fast版は2倍 — 「Grok 4.7 Fast」は同じモデルを高速なインフラで提供するもので、標準の2倍のレートで課金されます。提供先はCursorとGrok Buildのみで、公開APIでは使えません。Grok Buildの無料枠にも含まれません
- 米国リージョンは10%増 — 推論を米国内に留める専用エンドポイントがあり、こちらを使うとトークン使用料に10%のプレミアムが乗ります
- キャッシュキーの指定は事実上必須 — 公式は「プロンプトのキャッシュキーを設定することを強く推奨する」と書き、その理由として「設定しないと、キャッシュが冷えたサーバーに振られて入力の満額を払うことが多い」と明記しています
キャッシュ入力の単価は0.50ドルで、通常入力の4分の1です。キャッシュが効くかどうかで入力コストが4倍変わるということなので、「推奨」と書かれていても実質的には設定するかしないかの選択ではありません。
単価は安いのに実費は高い|独立計測の1タスクあたりコスト
ここが本記事の核心です。
Artificial Analysisは、10種類の評価を束ねた「Intelligence Index」を自前のハードウェアで独立に実行し、そのついでに1タスクを完了するまでの実費を計測して公開しています。同社はこの計測について「Artificial Analysisが独立して測定した評価結果」「専用ハードウェア上での独立テスト実行」と明記しています。
1タスクあたりの実費(Intelligence Index v4.3.2)
モデル(推論強度) | 1タスクあたり実費 | Intelligence Index |
|---|---|---|
GPT-5.6 Luna(max) | $0.18 | 37.3 |
DeepSeek V4.1 Flash(max) | $0.27 | 39.5 |
Gemini 3.8 Flash(high) | $1.24 | 40.9 |
Muse Spark 1.3(max) | $1.60 | 48.1 |
Kimi K3(max) | $2.00 | 43.6 |
GLM-5.3(max) | $2.01 | 44.8 |
GPT-6 Astra(max) | $3.26 | 52.7 |
Grok 4.7(xhigh) | $3.74 | 46.4 |
Claude Opus 5(max) | $5.86 | 50.8 |
Claude Fable 5.1(max) | $7.63 | 53.4 |
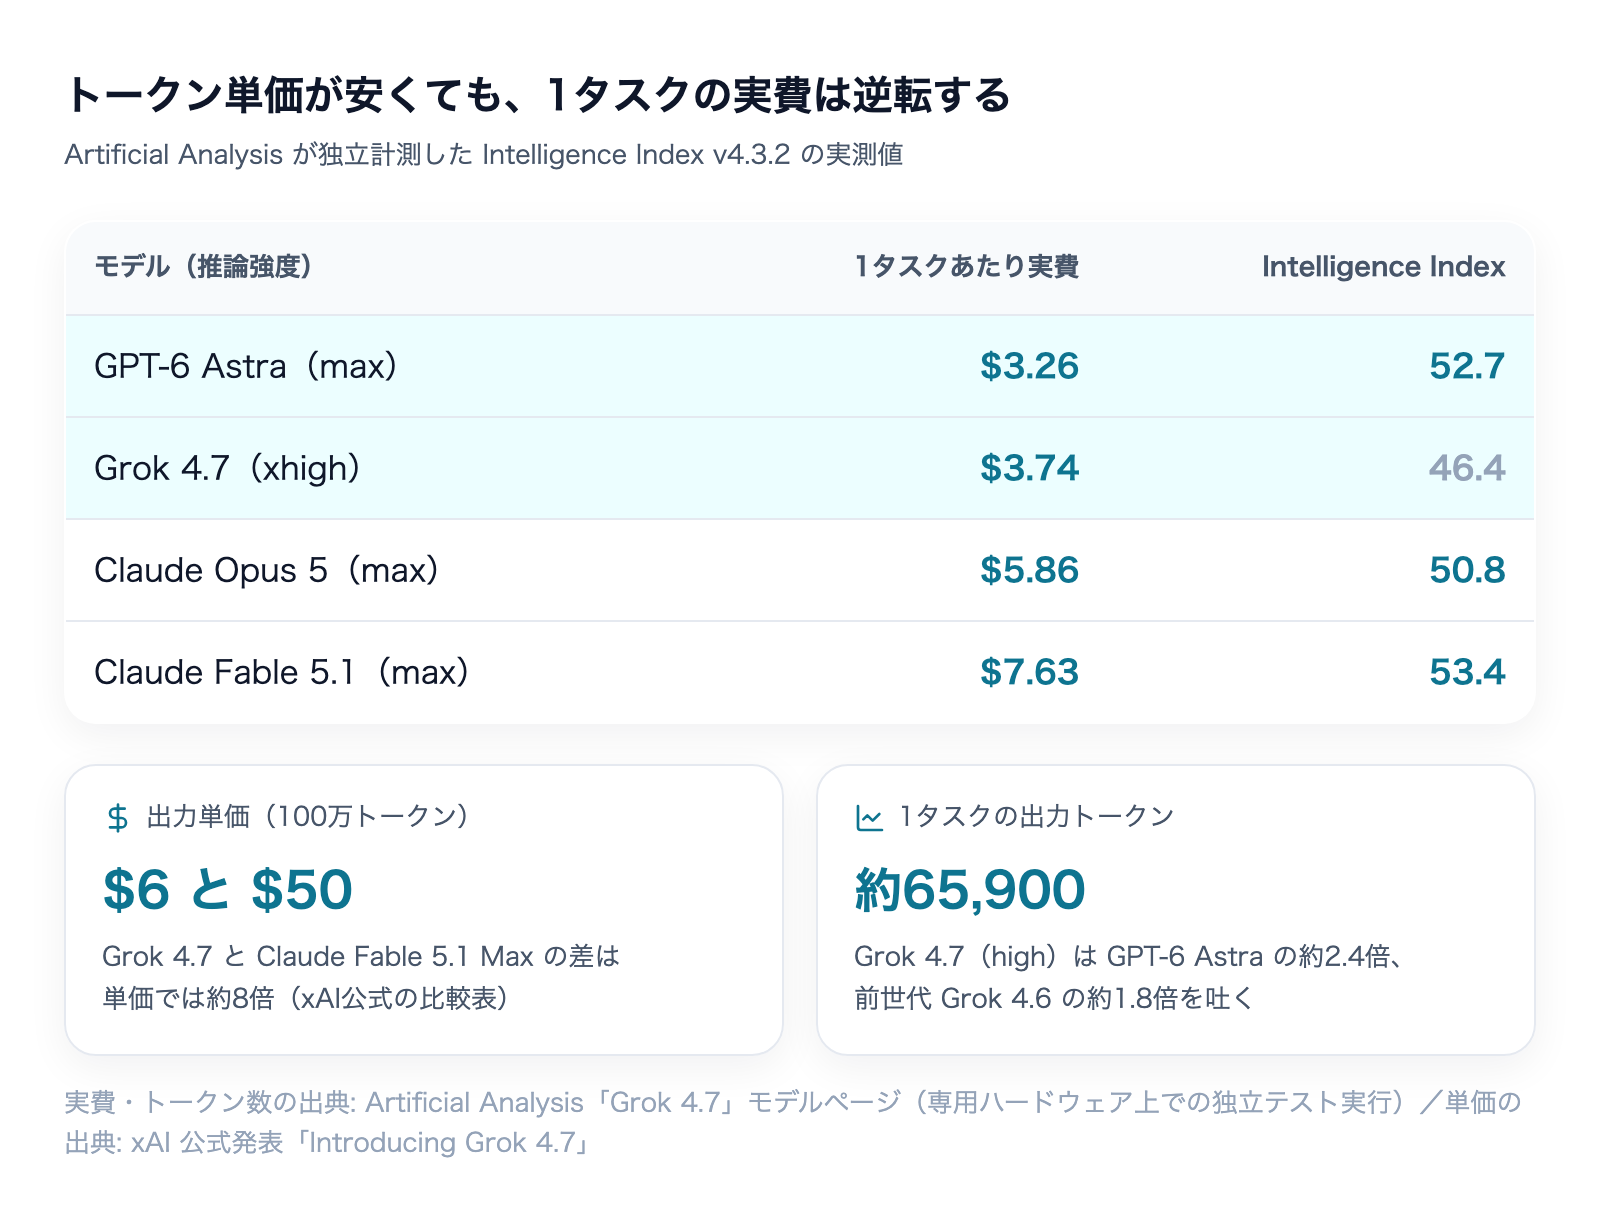
Grok 4.7は1タスクあたり3.74ドル、GPT-6 Astraは3.26ドルです。実費でGrok 4.7のほうが約15%高いうえに、知能指標では46.4対52.7で下回っています。
単価表だけを見ていた人には、これは納得しにくい結果のはずです。公式の比較表でも、Grok 4.7は入力2ドル・出力6ドルに対し、Claude Fable 5.1 Maxは入力10ドル・出力50ドルと並べられています。単価では5倍から8倍の開きがあるのに、実費の差は3.74ドル対7.63ドルで約2倍にとどまっています。
理由は「吐く量」|出力トークンが2.4倍
からくりは出力量です。同じくArtificial Analysisが公開している、1タスクあたりの出力トークン数を見ると理由がはっきりします。
モデル(推論強度) | 回答トークン | 推論トークン | 合計 |
|---|---|---|---|
GPT-6 Astra(max) | 10,514 | 16,691 | 約27,200 |
Grok 4.6(high) | 17,053 | 18,782 | 約35,800 |
Grok 4.7(high) | 19,268 | 46,633 | 約65,900 |
Grok 4.7が1タスクで吐くトークンは、GPT-6 Astraの約2.4倍です。トークン単価が3分の1でも、使う量が2.4倍なら支払額は追いつきません。
さらに注目したいのは前世代との比較です。Grok 4.6の約35,800トークンに対しGrok 4.7は約65,900トークンで、約1.8倍に増えています。増えた分のほとんどは推論トークン(18,782→46,633、約2.5倍)です。
公式は「価格はGrok 4.6と同じ」と書いていて、これは事実です。ただし同じ単価でも、同じ仕事を終えるのに1.8倍のトークンを使うなら、請求額は上がります。値上げはしていないが、支払いは増える。この2つは矛盾しません。
Artificial Analysisは別の角度からも同じ傾向を記録しています。Intelligence Indexの全評価を通したとき、Grok 4.7(xhigh)が生成した出力トークンは2億4,000万で、同価格帯の推論モデルの中央値9,400万の2.5倍を超えています。「饒舌さ」は誤差ではなく、このモデルの性格です。
速いのに遅い|最初の1文字と、最後の1文字
速度の数字も、単一の指標で見ると判断を誤ります。Artificial AnalysisがxAIのAPI経由で計測した値は次のとおりです。
- 最初のトークンまでの時間(TTFT)は0.85秒 — 同価格帯の推論モデルの中央値3.79秒に対し、かなり速い部類
- 出力速度は毎秒42.3トークン — 同価格帯の中央値70.8トークン毎秒に対し、遅い部類
反応は速いが、書き終わるのは遅い。しかも吐く量が2.4倍なので、最後の1文字まで待つ時間は数字以上に開きます。
人が画面の前で待つチャット用途なら、最初の反応が速いことは体感を大きく改善します。一方で、誰も見ていない時間に長いタスクを回す無人運用では、効くのは後者です。この使い分けの基準は後半で詳しく書きます。
同じベンチマークで数字が食い違う|Terminal-Bench 4.0の38.0%と26%
Grok 4.7をめぐって、いま最も注意が必要なのがここです。
公式発表ページの比較表には「Multi-hour terminal work / Terminal-Bench 4.0」という行があり、Grok 4.7(xHigh)の値は38.0%と記載されています。
一方、The Decoderは同じ2026年9月21日の記事で、Artificial Analysisのチャートを引きながら「Grok 4.7はTerminal-Bench 4.0でわずか26%にとどまり、GPT-6 Astraの60%、Claude Fable 5.1の55%に大きく引き離された」と報じています。
同じ名前のベンチマークで、12ポイントの開きがあります。どちらが正しいかは、この記事では判定しません。私の手元でTerminal-Bench 4.0を実行していない以上、判定できる立場にないからです。読者に持ち帰ってほしいのは次の事実です。
- ベンチマーク名が同じでも、誰が測ったかで数字は変わりうる
- 足回り(推論強度・ハーネス・試行回数・採点方法)が違えば、同じ問題セットでも結果は動く
- したがって「ベンチマークで◯%」という数字は、出所とセットでしか意味を持たない
比較相手の選び方も一緒に見る
もう1つ、公式の比較表の読み方として押さえておきたい点があります。
公式が価格とベンチマークを並べた表で、比較相手として置かれているのはGrok 4.6・GPT-5.6 Sol Max・Claude Fable 5.1 Maxの3つです。一方、Artificial Analysisの知能指標で首位を争っているのはClaude Fable 5.1とGPT-6 Astraで、GPT-6 Astraは公式の価格・ベンチマーク表には並んでいません(別の図では比較対象として登場します)。
これはベンダー資料として珍しいことではありません。ただ、読む側は「この表に誰がいて、誰がいないか」を毎回確認する必要があります。公式表の中でGrok 4.7が有利に見えても、表の外にもっと強い相手がいることはあります。
公式表で素直に強い項目もある
公平を期すために書いておくと、公式が出した数字の中には、比較相手を大きく引き離している項目もあります。
評価 | Grok 4.7 xHigh | Grok 4.6 High | GPT-5.6 Sol Max | Fable 5.1 Max |
|---|---|---|---|---|
CursorBench 4.0(ソフトウェア工学) | 46.3% | 40.4% | 41.7% | 51.8% |
DeepSWE v1.1(ソフトウェア工学) | 71.0%※ | 65.2% | 72.7% | 70.0% |
EEBench(電気工学) | 64.0% | 53.0% | 39.4% | 56.4% |
Harvey Legal Agent(法務) | 19.6% | 15.8% | 2.5% | 6.7% |
HealthBench Professional(臨床推論) | 56.7% | 48.5% | 60.5% | 62.1% |
※印はhigh effortでの測定値だと公式が注記しています。同じ表の他のセルと足回りが揃っていない可能性がある、という意味です。
EEBenchとHarvey Legal Agentの2項目では、Grok 4.7が表内の他モデルを上回っています。前世代からの伸び幅もこの2つが大きく、「難しいタスクに重みを置いて強化学習を長く回した」という公式の説明と方向は合っています。
GitHub CopilotとCursorで使う|対応プランと管理者が最初に見る設定
モデル単体の話から、実際に触れる場所の話に移ります。
GitHub Copilotでは一般提供(GA)
GitHubは2026年9月21日付の公式Changelogで、Grok 4.7のCopilot提供を告知しています。GitHubの公式ドキュメント「Supported AI models」でも、Grok 4.5・4.6と並んでGA(一般提供)として掲載されています。
- 対象プラン: Copilot Pro / Pro+ / Max / Business / Enterprise
- モデルピッカーで選べる場所: Visual Studio Code / Visual Studio / Copilot CLI / GitHub Copilotクラウドエージェント / GitHub Copilotアプリ / JetBrains / Xcode / Eclipse
- 課金: 従量課金のもとで「プロバイダーの定価」で課金される
- 展開: 段階的にロールアウトされるため、まだ見えない環境がある
「プロバイダーの定価で課金される」という書き方は、Copilot側で独自の倍率をかけるのではなく、xAIの表示価格がそのまま乗るという意味です。つまり前半で見た20万トークンの崖も、そのまま効いてくると考えておくのが安全です。
管理者が最初に確認すべき1点
中小企業の情報システム担当・管理者にとって、Changelogで最も重要なのは課金でも対応IDEでもなく、次の一文です。
Copilot EnterpriseとCopilot Businessの管理者は、Copilot設定のモデルポリシーでGrok 4.7へのアクセスを管理できます。そして既定のモデル有効化設定のもとでは、新しいモデルは自動的に有効になります。管理者がグローバル既定をオフにしているか、このモデルを明示的に無効化していない限り、という条件つきです。
言い換えると、何もしなければ社内で使える状態になります。「新しいモデルは検証してから解禁する」という運用にしたいなら、モデルが増えるたびに対応するのではなく、グローバル既定のほうを先に切っておく必要があります。これはGrok 4.7に限った話ではなく、モデルが週単位で増える今の環境に対する構えの話です。
Copilot側でのGrokの扱いは、入口によってデータの流れ方が変わります。この点は別記事で整理しています。
Cursor・Grok Build・モデルゲートウェイ
公式ドキュメントの「Where it runs」には、Copilot以外の提供先も列挙されています。
- xAI API — コンソールでキーを発行して利用
- Grok Build — 同社のコーディングエージェントの既定モデル
- Cursor — 全プランで利用可能(Fast版もCursorとGrok Buildのみで提供)
- モデルゲートウェイ — OpenRouter / Vercel / Cloudflare
すでにCursorやCopilotを契約しているなら、新たにAPIキーを発行しなくてもモデルピッカーから選ぶだけで試せます。評価のコストはほぼゼロなので、「自分の仕事で1週間回してみる」が現実的な検証方法になります。
私たちが無人運用でモデルを入れ替える基準
ここからは、私の実運用の話です。
私は無人で動くAIジョブを毎日走らせています。記事の下書き、情報収集、定型処理などを、人が見ていない時間帯に自動で回す構成です。この運用では、モデル選定の基準が対話利用とはっきり変わります。
基準1|単価ではなく「1本の完了コスト」で比べる
無人ジョブで意味があるのは「100万トークンいくらか」ではなく、「この仕事を1本終わらせるのにいくらかかるか」です。今回のArtificial Analysisの1タスク実費は、まさにこの見方の数字なので参考になります。
実務で見積もるときは、こう置き換えます。
- 1本の仕事で読み込む入力(資料・過去ログ・ソースコード)の量
- そのモデルが吐く出力の量(推論トークンを含む)
- キャッシュが効く割合(同じ前提を繰り返し投げるジョブほど効く)
- 20万トークンの崖を踏む頻度
この4つを掛け合わせると、単価表の順位はしばしば入れ替わります。出力が多いモデルは、出力単価の重みが効いて不利になります。
基準2|失敗したときの後始末を費用に入れる
無人運用でいちばん高くつくのは、トークン代ではありません。誰も見ていない時間に、間違った成果物が積み上がることです。
人が横にいれば、おかしな出力はその場で止められます。無人ではそれができないので、間違いは翌朝まで残り、下流の処理にも波及します。私の場合、自動で公開まで進む経路には必ず独立した検査を挟み、疑わしければ公開せず退避する設計にしています。この検査自体もトークンを消費するので、1本あたりの費用は単純な生成コストの倍近くになります。
それでも検査を外さないのは、差し戻し1回の損失がトークン代よりはるかに大きいからです。安いモデルに替えて再実行が1回増えるなら、そのモデルは安くありません。
無人でAIを回すときの止め方・監視の考え方は、以下で詳しくまとめています。
基準3|要約ではなく一次情報で判断する
今回の記事は、その具体例そのものになりました。
手元のニュース要約には「パラメータ数2.1兆」「SpaceXのエンジニアリングデータセットを活用」と書かれていましたが、公式発表と公式ドキュメントを開いて確認したところ、どちらも一次情報には存在しませんでした。さらにTerminal-Bench 4.0のように、公式と第三者で数字自体が食い違う項目もありました。
要約だけを見てモデルを切り替える判断をしていたら、存在しない根拠で意思決定していたことになります。モデル選定は、料金ページとベンチマークの出所を自分の目で開くところから始めるべきです。ここはAIに任せてよい作業ではありません。
入れてよい場所・入れないほうがよい場所
以上を踏まえた、現時点での私の整理です。
判断 | 理由 | |
|---|---|---|
対話しながらのコーディング補助 | 試す価値あり | 最初の反応が速く、CursorやCopilotで追加費用なしに切り替えて比較できる |
既存のCopilot環境での併用 | 試す価値あり | GAで提供されており、モデルピッカーで1件ずつ比較できる |
短い入力で完結する定型処理 | 条件つきで可 | 20万トークンの崖を踏まず、キャッシュキーを設定できるなら単価の安さが効く |
長時間の無人エージェント | いまは主力にしない | 出力量が前世代比1.8倍で、崖を踏むと全トークンが倍額になる |
品質が直接売上に触れる本番経路 | いまは替えない | 知能指標で上位と6ポイント差があり、実費で優位が出ていない |
なお、前世代のGrok 4.5を検討したときも判断の枠組みは同じでした。当時の比較と、無人ジョブでの役割分担については以下にまとめています。
中小企業が今週決めるなら|3つの判断
最後に、社内で意思決定する立場の方に向けて、今週のうちにできることを3つに絞ります。
1. 主力モデルは替えない。ただし試す枠は作る
公開から数日の段階で、業務の本番経路を新しいモデルに寄せる理由はありません。独立計測の実費でも知能指標でも、現時点で乗り換えを正当化する数字は出ていないからです。
一方、CursorやGitHub Copilotを契約済みなら、追加費用なしでモデルピッカーから選べます。「来週の自分の作業のうち3件だけGrok 4.7で通してみる」程度の枠を作るのが、いちばん安い評価方法です。
2. 管理者はモデルの既定有効化を確認する
Copilot Business / Enterpriseを使っている場合、新しいモデルは既定で自動的に有効になります。「検証してから解禁する」運用にしたいなら、グローバルの既定有効化設定を先に切っておく必要があります。モデルが増えるたびに後追いで止めるやり方は、いずれ追いつかなくなります。
3. 比較するなら「1タスクの実費」で比べる
社内で「あのモデルは安いらしい」という話が出たときに、単価表で議論を始めないことです。比べるべきは、同じ仕事を1本終わらせるのにいくらかかったか。この記事で見たように、単価で3分の1でも実費で負けることは実際に起こります。
無人でAIを動かす前提の上限設定や暴走防止の考え方は、以下で整理しています。
まとめ
Grok 4.7について、本記事で確認した事実を整理します。
- 2026年9月21日公開。コーディングと知識労働向けで、価格と速度はGrok 4.6と同じ
- 入力$2・出力$6(100万トークンあたり)、コンテキスト50万トークン、推論強度は4段階
- プロンプトが20万トークンに達すると、そのリクエストの全トークンが倍額になる
- 独立計測の1タスク実費は$3.74で、GPT-6 Astraの$3.26を上回る。知能指標は46.4対52.7で下回る
- 理由は出力量。1タスクあたり約65,900トークンを吐き、GPT-6 Astraの約2.4倍、前世代Grok 4.6の約1.8倍
- Terminal-Bench 4.0は公式38.0%・第三者報道26%と食い違う。数字は出所とセットで読む
- GitHub CopilotでGA。Pro / Pro+ / Max / Business / Enterpriseで利用でき、既定では自動的に有効になる
新しいモデルが出るたびに料金表を見比べるのは、もう現実的ではありません。週単位でモデルが増える環境では、「何を基準に比べるか」を先に決めておくほうが早いからです。単価ではなく1本の完了コストで、ベンチマークの数字は出所とセットで、そして導入判断は自分の業務で1週間回してから。
株式会社Fyveは、こうした判断の基準づくりから、無人で動く仕組みの設計・運用までを伴走しています。モデルが増え続けること自体は止められませんが、増えても揺れない基準は作れます。
参考にした情報源
- xAI「Introducing Grok 4.7」公式発表(2026年9月21日)
- xAI公式開発者ドキュメント「Grok 4.7」およびモデル料金一覧(2026年9月22日時点で確認)
- GitHub公式Changelog「Grok 4.7 is now available in GitHub Copilot」(2026年9月21日)
- GitHub公式ドキュメント「Supported AI models in Copilot」
- Artificial Analysis「Grok 4.7」モデルページ(Intelligence Index v4.3.2・独立計測)
- The Decoder「xAI launches Grok 4.7 at bargain prices...」(2026年9月21日)
料金・提供条件は変更される可能性があります。契約前には必ず各社の最新の公式価格ページでご確認ください。
重みが公開されたモデルの最上位を、同じ独立計測で並べた記事です。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。