MiMo-V2.6-Proとは|実費44分の1で何が違うか

「オープンウェイトの最上位が出た」「Claude並みの性能が44分の1で使える」——こういう話を見かけて、自社の業務をそのまま載せ替えていいのか判断がつかない。
結論から言うと、実費が44分の1というのは本当です。ただし44分の1なのは料金であって、任せられる仕事の範囲ではありません。分かれ目は「出てきた答えを、こちらで検算できる仕事かどうか」です。
株式会社Fyveは中小企業のAI導入を支援しています。この記事では、2026年9月21日に公開されたXiaomiの「MiMo-V2.6-Pro」について、独立計測の実データとモデル配布元の実データの両方を自分で取得して、何が本当に安いのか・どこで差が出るのかを整理します。
MiMo-V2.6-Proとは|1日で何が公開されたのか
MiMo-V2.6-Proは、中国のXiaomiが公開した大規模言語モデルです。重みが誰でもダウンロードできる「オープンウェイト」型で、ライセンスはMIT——商用利用が認められています。
まず押さえておきたいのは、公開されたのは1つのモデルではなく3つだったという点です。ニュース記事の多くは最上位のProだけを取り上げますが、中小企業にとって現実的なのはむしろ他の2つかもしれません。
Hugging Faceの公開APIで、Xiaomi公式アカウントのリポジトリ一覧を2026年9月22日に取得した結果が次のとおりです。
リポジトリ | 位置づけ | 公開日時(UTC) | ライセンス |
|---|---|---|---|
MiMo-V2.6-Pro-RL | 最上位。この記事で扱うモデル | 2026-09-21 15:39 | MIT |
MiMo-V2.6-Flash-RL | 軽量版 | 2026-09-21 15:39 | MIT |
MiMo-V2.6-Distill-Qwen-9B | 9B規模の蒸留版 | 2026-09-21 18:18 | MIT |
公開日について補足します。ベンチマーク機関のArtificial Analysisは「2026年9月21日リリース」と記載しており、Hugging Faceのリポジトリ作成時刻は2026年9月21日15時39分(UTC)です。これは日本時間では9月22日0時39分にあたります。海外発のモデルは、この日付のずれが後から混乱のもとになるので、両方を押さえておくと安全です。
スペック上の位置づけ
Artificial Analysisが公開しているモデル諸元は次のとおりです(2026年9月22日取得)。
- 総パラメータ約1.0兆・うち推論時に使うのは420億(MoEと呼ばれる、必要な部分だけを動かす構造)
- コンテキスト100万トークン
- 入力はテキスト・画像・音声・動画に対応し、出力はテキスト
- API提供元は1社のみ(Xiaomi自身)
前世代のMiMo-V2.5-Proはテキスト入力のみでしたから、扱える入力の種類はここで大きく広がっています。
「Opus 5水準」は正確ではない
このモデルの紹介でよく見かけるのが「Claude Opus 5に匹敵する性能」という表現です。私も最初はその前提で調べ始めましたが、独立計測の実数を見ると、この表現は正確ではありませんでした。
Artificial AnalysisのIntelligence Index(10種類の評価を合成した総合スコア。バージョンはv4.3.2)で、2026年9月22日時点の値を並べます。
モデル | 総合スコア | 重みの公開 |
|---|---|---|
Claude Fable 5.1 | 53.4 | 非公開 |
GPT-6 Astra | 52.7 | 非公開 |
Claude Opus 5 | 50.8 | 非公開 |
Grok 4.7 | 46.4 | 非公開 |
MiMo-V2.6-Pro | 46.3 | 公開(MIT) |
GLM-5.3 | 44.8 | 公開 |
Kimi K3 | 43.6 | 公開 |
読み取れることは2つあります。
1つめ。「重みが公開されているモデルの中では首位」は事実です。GLM-5.3の44.8、Kimi K3の43.6を上回っています。これは十分に大きなニュースです。
2つめ。ただしOpus 5とは4.5ポイント差があり、「同水準」ではありません。この一覧でMiMoのすぐ上にいるのはGrok 4.7(46.4)で、上位3モデルとの間には明確な段差があります。
前世代からの伸びは本物です。MiMo-V2.5-Proの総合スコアは26でしたから、5か月で20ポイント以上を積み増したことになります。これは「追い上げが速い」という評価には十分値します。ただし「もう追いついた」とは違います。
実費は本当にOpus 5の44分の1
性能の話をしたので、次は費用です。ここは前評判どおりでした。
モデルの費用を比べるとき、トークン単価だけを見ると判断を誤ります。同じ仕事をさせたときに、そのモデルが実際に何トークン吐くかで請求額が変わるからです。この点については、同じ構図を別のモデルで扱った記事があります。
Artificial Analysisは、同じベンチマーク一式を各モデルに解かせたときの1タスクあたりの実測課金額を公開しています。2026年9月22日時点の値です。
モデル | 1タスクあたり実費 | MiMoとの倍率 |
|---|---|---|
MiMo-V2.6-Pro | $0.133 | — |
Kimi K3 | $2.00 | 15.0倍 |
GLM-5.3 | $2.01 | 15.1倍 |
GPT-6 Astra | $3.26 | 24.5倍 |
Grok 4.7 | $3.74 | 28.1倍 |
Claude Opus 5 | $5.86 | 44.0倍 |
Claude Fable 5.1 | $7.63 | 57.3倍 |
Claude Opus 5との比較で44.0倍、Fable 5.1とでは57.3倍の開きがあります。重みが公開されている他社モデル(GLM-5.3・Kimi K3)と比べても15倍ほど安い。ここは誇張ではありませんでした。
なぜここまで安いのか
トークン単価の設定そのものが低く、さらにキャッシュの割引が極端に効いています。
- 入力:100万トークンあたり$0.435
- 出力:100万トークンあたり$0.87
- キャッシュヒット時の入力:100万トークンあたり$0.0036
キャッシュヒット時の単価は通常の入力単価の約0.8%——つまり99%以上の割引です。同じ前提文を何度も投げる用途(社内文書を毎回読ませる、同じ指示書で定型処理を回す)では、この設計が効きます。
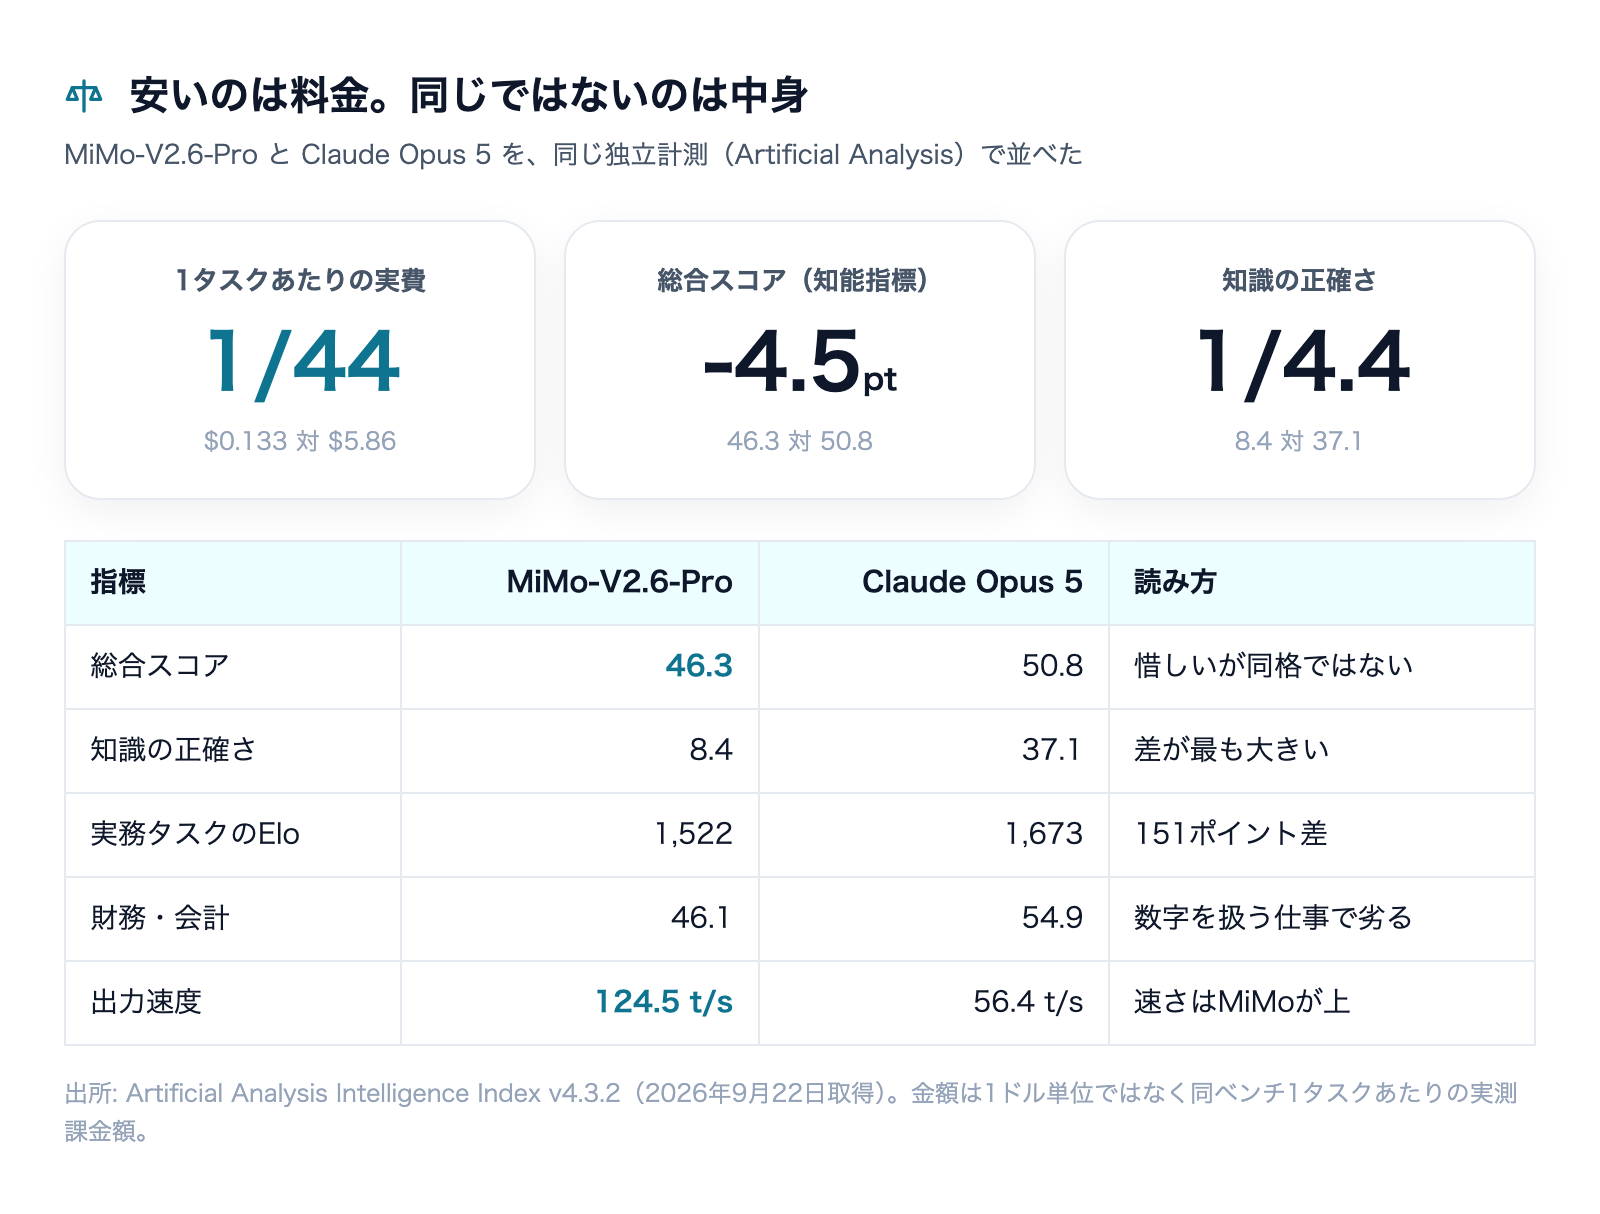
速度も速い。出力速度は毎秒124.5トークンで、Claude Opus 5の56.4、GPT-6 Astraの65.3、Grok 4.7の39.5を上回ります。ベンチ1タスクの所要時間は8.12分で、Opus 5の12.83分より短い。安くて速いのは事実です。
「速い」の中身を分解する
速度は1つの数字ではありません。Artificial Analysisは応答を3つの区間に分けて計測しており、これを開けると体感が予測できます。
モデル | 入力処理 | 推論(考えている時間) | 回答の生成 | 合計 |
|---|---|---|---|---|
Grok 4.7 | 0.85秒 | — | 12.67秒 | 13.5秒 |
MiMo-V2.6-Pro | 2.34秒 | 16.06秒 | 4.02秒 | 22.4秒 |
GLM-5.3 | 3.12秒 | 32.76秒 | 8.19秒 | 44.1秒 |
MiMo-V2.5-Pro(前世代) | 2.77秒 | 43.04秒 | 10.76秒 | 56.6秒 |
Claude Opus 5 | 49.25秒 | — | 8.86秒 | 58.1秒 |
Kimi K3 | 4.08秒 | 49.22秒 | 12.30秒 | 65.6秒 |
ここで目を引くのが前世代からの改善幅です。合計は56.6秒から22.4秒へ、2.5倍速くなっています。主因は推論時間で、43.0秒から16.1秒へ縮みました。
一見すると矛盾します。先ほど「吐く量が2.15倍に増えた」と書いたのに、待ち時間は短くなっている。種明かしは出力速度です。前世代は毎秒46.5トークンでしたが、今世代は124.5トークンで約2.7倍。量が2.15倍になっても、吐く速さが2.7倍になったので、体感の待ち時間はむしろ縮んだという関係です。
この分解は実務でそのまま使えます。考える時間(推論)は長文を投げるほど伸び、回答の生成時間は出力の長さで決まります。チャット的に人が待つ用途なら推論時間の短さが効き、夜間バッチのように待てる用途なら気にしなくてよい。同じ「速い」でも効く場面が違います。
なお、Claude Opus 5の入力処理49.25秒という数字は、推論を別区間として切り出していない計測方式の違いによるもので、単純に「入力を読むのが遅い」という意味ではありません。合計値で比べるのが安全です。
見落とされている数字|前世代より実費は2.46倍に増えている
ここからが、要約記事ではまず触れられていない部分です。
MiMo-V2.6-Proのトークン単価は、前世代のMiMo-V2.5-Proと1円たりとも変わっていません(入力$0.435・出力$0.87・キャッシュヒット$0.0036で完全に同額)。値上げはしていない。
にもかかわらず、同じベンチを解かせたときの1タスクあたりの実費はこう変わりました。
MiMo-V2.5-Pro | MiMo-V2.6-Pro | 変化 | |
|---|---|---|---|
総合スコア | 26.0 | 46.3 | +20.3 |
1タスク出力トークン | 29,884 | 64,276 | 2.15倍 |
1タスク実費 | $0.054 | $0.133 | 2.46倍 |
トークン単価 | $0.435/$0.87 | $0.435/$0.87 | 変更なし |
単価が同じなのに実費が2.46倍になった理由は、吐く量が2.15倍に増えたからです。賢くなったぶん、長く考えて長く書くようになった。性能向上の相当部分が「推論の量」で買われています。
これは欠陥ではありません。推論型のモデルでは自然な進化です。ただし「単価が据え置きだから費用も据え置き」という読み方をすると、請求書で2.5倍を見ることになります。乗り換えを検討するときは、必ず自社の実タスクで1件あたりの費用を測ってください。
費用の内訳を開けると、最大の費目はキャッシュの書き込み
「キャッシュヒットが99%引き」と聞くと、キャッシュを使えば使うほど安くなるように感じます。実際の内訳を見ると、そう単純ではありませんでした。
Artificial Analysisは1タスクの実費を費目別に公開しています。MiMoの2世代分を並べます。
費目 | MiMo-V2.5-Pro | 構成比 | MiMo-V2.6-Pro | 構成比 |
|---|---|---|---|---|
キャッシュの書き込み | $0.0182 | 33.7% | $0.0536 | 40.2% |
推論(考えている部分の出力) | $0.0156 | 28.8% | $0.0326 | 24.5% |
回答(読者に返る部分の出力) | $0.0104 | 19.3% | $0.0233 | 17.5% |
キャッシュの読み出し | $0.0052 | 9.6% | $0.0195 | 14.6% |
通常の入力 | $0.0047 | 8.6% | $0.0042 | 3.2% |
合計 | $0.0541 | 100% | $0.1332 | 100% |
最大の費目は、出力でも入力でもなくキャッシュの書き込みでした。全体の40.2%を占めています。しかも前世代の$0.0182から$0.0536へ、2.94倍に増えています——実費全体の増加率(2.46倍)より速いペースです。
なぜこうなるのか
キャッシュは「一度読ませた内容を保存しておき、次から安く再利用する」仕組みです。ここで見落とされやすいのが、保存する行為そのものに課金されるという点です。
つまりキャッシュが効くのは、同じ内容を「何度も」再利用したときだけです。
- 効く使い方:同じ指示書・同じ参照資料を前提に、1日に何十件も処理を流す。書き込みは1回で、読み出しが何十回も乗る
- 効かない使い方:毎回違う資料を読ませて1回きりの回答を得る。書き込み代だけ払って、再利用の機会が来ない
キャッシュヒット時の単価が通常入力の0.8%しかないのは魅力的ですが、その割引に到達する前に書き込み代を払っているのがこの内訳です。「キャッシュがあるから安い」ではなく、「同じものを繰り返し使う設計にしたときだけ安い」と読むのが正確です。
自社の処理がどちらなのかは、実際に流してみないと分かりません。ここでも測り直しが要ります。
安さの代償はどこに出るか|知識の正確さが4.4分の1
総合スコア46.3は「10種類の評価の合成値」です。合成値を分解すると、MiMoがどこで稼ぎ、どこで落としているかがはっきり分かれます。
特に差が大きいのが、AA-Omniscience Indexという指標です。これは「事実をどれだけ正確に知っているか、知らないことを知らないと言えるか」を測るもので、実務でいえばハルシネーション(もっともらしい嘘)の起きにくさに近い性質を持ちます。
モデル | 総合スコア | 知識の正確さ | 実務タスクElo | 財務・会計 |
|---|---|---|---|---|
Claude Fable 5.1 | 53.4 | 43.5 | 1,678 | 56.4 |
GPT-6 Astra | 52.7 | 43.4 | 1,569 | 55.2 |
Claude Opus 5 | 50.8 | 37.1 | 1,673 | 54.9 |
Grok 4.7 | 46.4 | 32.0 | 1,657 | 51.9 |
MiMo-V2.6-Pro | 46.3 | 8.4 | 1,522 | 46.1 |
GLM-5.3 | 44.8 | 14.3 | 1,525 | 44.7 |
Kimi K3 | 43.6 | 19.7 | 1,510 | 46.9 |
注目すべきは総合スコアと知識スコアのねじれです。
MiMoは総合46.3でGrok 4.7(46.4)とほぼ並びます。ところが知識の正確さでは8.4対32.0で、4倍近い開きがあります。Claude Opus 5の37.1と比べると4.4分の1です。さらに、総合スコアでMiMoより下のKimi K3(43.6)やGLM-5.3(44.8)の方が、知識の正確さでは上(19.7・14.3)という逆転まで起きています。
つまりMiMoの総合46.3は、推論力や処理能力で稼いだ46.3であって、事実の確かさで稼いだものではないということです。前世代の知識スコアは3.25でしたから改善はしていますが、上位モデルとの距離はここが最も遠い。
実務タスクの総合力を人間の評価で測るAA-Briefcase Eloでも、MiMoは1,522でOpus 5の1,673から151ポイント下。財務・会計を扱う指標でも46.1対54.9と差がつきます。数字や事実を正確に扱う領域ほど、差が素直に出ます。
では、どの仕事なら任せてよいのか
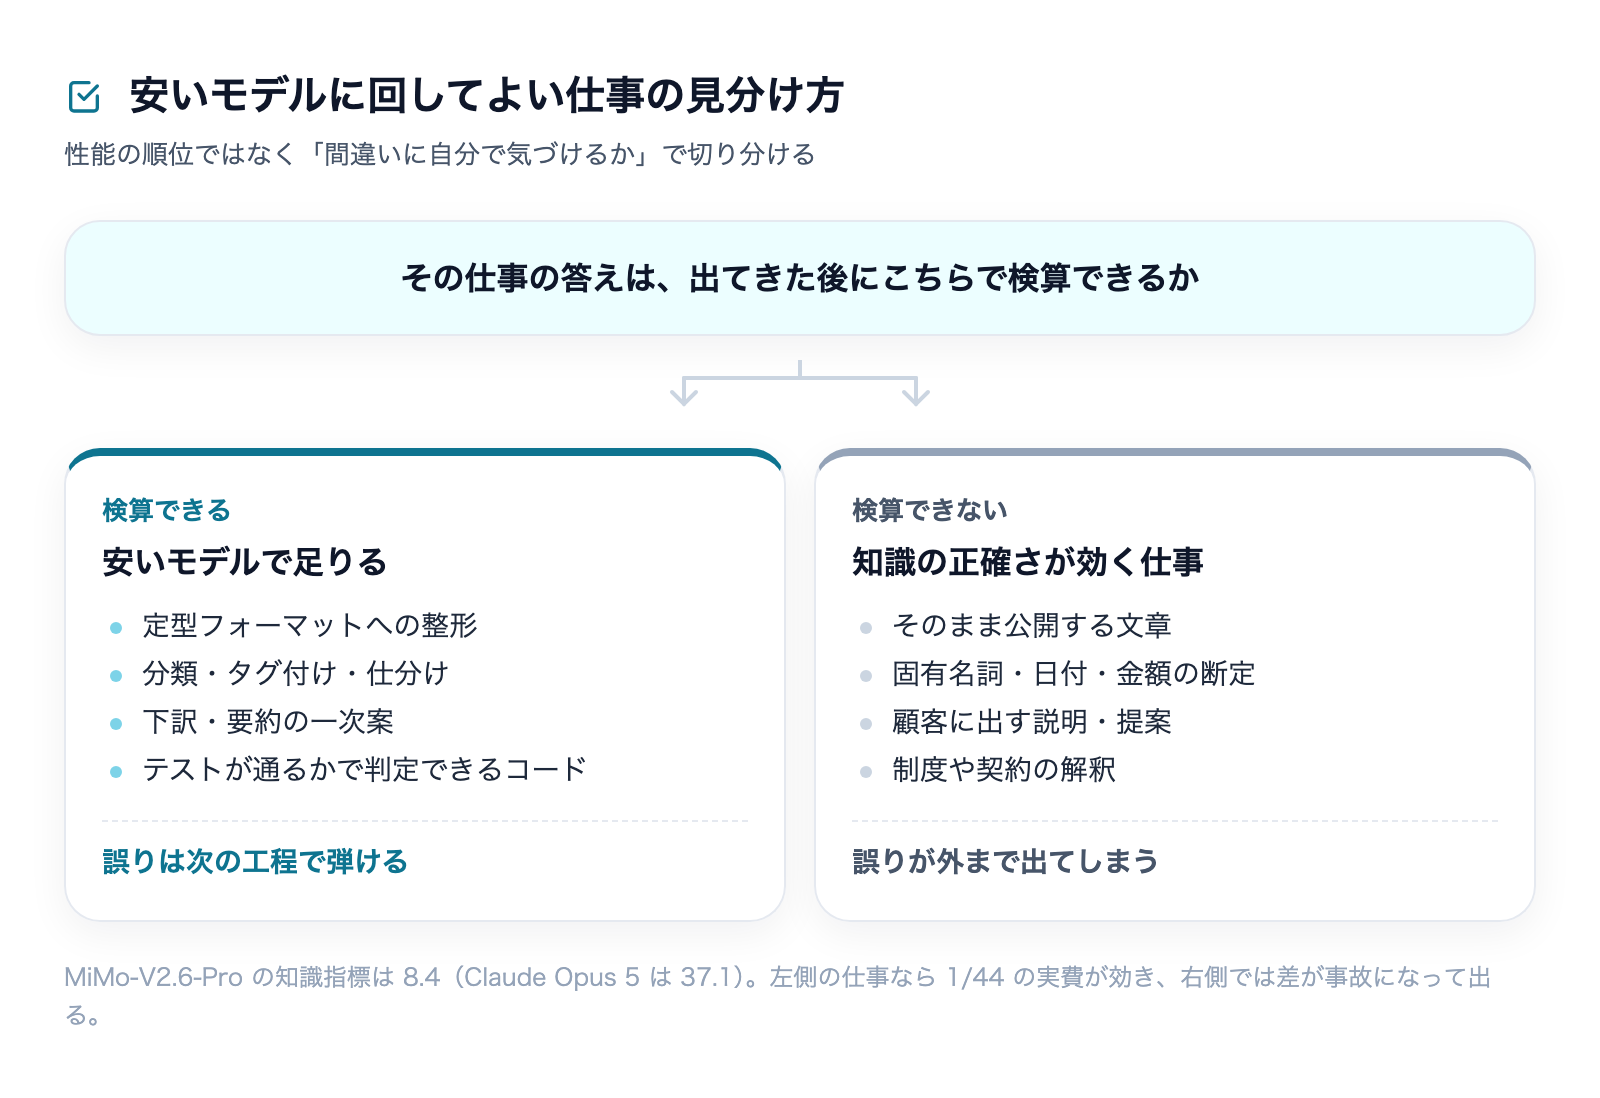
ここが実務の判断どころです。私はモデルの順位表ではなく「出てきた答えを、こちらで検算できるか」で切り分けています。
検算できる仕事=安いモデルで足りる
- 定型フォーマットへの整形:出力の形が決まっているので、崩れていればその場で分かる
- 分類・タグ付け・仕分け:件数が合うか、想定外のラベルが出ていないかで検品できる
- 下訳・要約の一次案:人が最後に読む前提なので、誤りは次の工程で弾ける
- テストが通るかで判定できるコード:機械が合否を出してくれる
この領域では、知識スコアの差は事故になりません。誤りが起きても、外へ出る前に止まる工程設計になっているからです。ここに44分の1の実費が効きます。
検算できない仕事=知識の正確さが効く
- そのまま公開する文章:誤りに気づけるのは読者側になってしまう
- 固有名詞・日付・金額の断定:もっともらしい嘘が最も混ざりやすい
- 顧客に出す説明・提案:信用が直接削られる
- 制度や契約の解釈:間違いが実害になる
この領域は、知識スコア8.4と37.1の差がそのまま事故率の差として出ます。ここで浮かせた費用は、1回の訂正で簡単に吹き飛びます。
私自身の運用での線引き
私は日々の業務の一部を無人で回していますが、そこでも同じ基準を使っています。定型的な整形や変換の処理は軽いモデルに、公開する文章を書く処理は上位モデルに割り当て、実行するコマンドの側でモデルを明示的に指定して固定しています。
「その場で一番安いモデルが選ばれる」状態にしないことが肝心です。詳しくはこちらで書きました。

「MITだから自社で動かせる」の現実
オープンウェイトの話でいちばん誤解されるのがここです。MITライセンスは「重みを配ってよい・商用に使ってよい」という許諾であって、「あなたの会社のパソコンで動く」という意味ではありません。
実際のサイズを確認しました。Hugging FaceのファイルAPIで、MiMo-V2.6-Pro-RLのリポジトリ内容を2026年9月22日に取得した結果です。
- 重みファイル(safetensors)は130本・合計566.0GB
- しかもこれはfp8という圧縮済みの形式での数字
566GBを推論で動かすとなると、業務用GPUを何枚も束ねた構成が要ります。中小企業が社内サーバーに置ける規模ではありません。
一方、同時に公開された9B蒸留版は約94億パラメータです。こちらは一般的な構成なら20GB弱で、GPU1枚に載る現実的なサイズです。「自社で動かす」を本気で検討するなら、見るべきはProではなくこちらです。
なお、自社で動かすかAPIで借りるかという判断そのものについては、別のモデルを題材に整理した記事があります。
ダウンロード実数が示していること
公開から約1日後のダウンロード数も取得しました。ここに現場の判断が表れています。
リポジトリ | ダウンロード数 | いいね |
|---|---|---|
MiMo-V2.6-Flash-RL(軽量版) | 2,641 | 321 |
MiMo-V2.6-Pro-RL(最上位) | 985 | 330 |
MiMo-V2.6-Distill-Qwen-9B(蒸留版) | 804 | 271 |
注目は「いいね」ではダウンロード数の順位が逆転していることです。最上位のProが最も多く支持を集めている(330)のに、実際に落とされているのは軽量版(2,641)のほうが2.7倍多い。評価したいモデルと、手元で動かせるモデルは別だということが、そのまま数字に出ています。
参考までに、前世代は公開から時間が経っていることもあり、MiMo-V2.5が286,775、MiMo-V2-Flashが101,860と桁が違います。ここでも軽量版のほうが実際に使われている構図は同じです。
「オープン」にも度合いがある
もう1点。オープンウェイトは0か1かではありません。Artificial AnalysisはOpenness Index(開放度指標)という別のスコアを出しており、重みの公開だけでなく学習データや手法の開示までを含めて評価しています。
MiMo-V2.6-Proの開放度はまだ掲載されていませんが、前世代のMiMo-V2.5-Proは38.9でした。同じく重みを公開しているDeepSeek V4 Proは版によって44.4〜50.0、NVIDIAのNemotron 3 Ultraは83.3です。
MITという最も緩いライセンスを選んでいても、開放度の総合評価では中位にとどまります。ライセンスの文言と、実際にどこまで中身が開示されているかは別の話だということです。「オープンだから中身が分かる」と考えて検証可能性を期待すると、想定とずれる可能性があります。
業務に載せる前に確認しておくこと
費用の魅力は本物なので、検討する価値はあります。そのうえで、私なら次の4点を先に潰します。
1. API提供元が1社しかない
Artificial Analysisの記載では、このモデルのAPI提供元は1社(Xiaomi自身)です。提供が止まったとき、そのまま切り替えられる先がありません。基幹的な処理に組み込むなら、代替経路を先に決めておくべきです。
2. 実費は自社のタスクで測り直す
この記事の$0.133はベンチマーク上の値です。前世代から実費が2.46倍になった例が示すとおり、同じ単価でも吐く量が変われば請求額は変わります。自社の典型的な処理を10件ほど流して、1件あたりの実費を出してから判断してください。
3. 何を渡すかを決めてから使う
海外事業者のAPIに業務データを送ることになります。顧客情報・契約内容・未公開の数字を渡さない線引きを、使い始める前に決めておく必要があります。これはMiMoに限った話ではありません。
4. ライセンスは必ず自分で確認する
MiMoはMITで商用利用が明記されていますが、オープンウェイトを名乗るモデルのライセンスは横並びではありません。世代が変わった際に条件が後退していた例もあります。
要約記事で見かけるが、一次情報では確認できなかった項目
この記事を書くにあたって元にしたニュース要約と、一次情報の照合で食い違った点を残しておきます。落とした事実そのものが、読者にとっての判断材料になると考えるためです。
- 「Claude Opus 5/GPT-5.6 Sol 水準の性能」:Artificial Analysisの実測では、Opus 5が50.8に対しMiMoは46.3で4.5ポイント差があります。また「GPT-5.6 Sol」というモデル名は同機関の掲載一覧に見当たりませんでした(GPT-5.6 Lunaは37.3、GPT-6 Astraは52.7として掲載)。本記事では実測値のみを採用しています。
- 公開日:要約では9月22日となっていましたが、Artificial Analysisの記載は9月21日、Hugging Faceのリポジトリ作成時刻は9月21日15時39分(UTC)=日本時間9月22日0時39分でした。本記事では両方を明記しています。
- リポジトリ名:実在するのは「MiMo-V2.6-Pro」ではなく「MiMo-V2.6-Pro-RL」で、同時に3本が公開されていました。
- モデルカード本文は取得できませんでした:Hugging Faceのモデルカード(README)と個別モデルAPIは認証エラーを返したため、本記事の数値は検索API経由のメタデータとファイルAPI、およびArtificial Analysisのモデルページのみを出所としています。
まとめ
MiMo-V2.6-Proについて、実データで確認できたことを整理します。
- 重みが公開されたモデルの中では首位(総合46.3。GLM-5.3の44.8、Kimi K3の43.6を上回る)
- ただしClaude Opus 5とは4.5ポイント差で、「同水準」ではない
- 1タスクの実費はOpus 5の44.0分の1($0.133対$5.86)。速度も上で、安さと速さは本物
- 単価は前世代と同額なのに、実費は2.46倍(吐く量が2.15倍に増えたため)
- 最も差が大きいのは知識の正確さ(8.4対37.1=4.4分の1)。総合スコアが下のモデルにも負ける項目
- MITでも自社では動かしにくい(最上位の重みは566GB。現実的なのは9B蒸留版)
判断の軸は1つです。出てきた答えをこちらで検算できる仕事なら、44分の1の実費は素直に効きます。検算できない仕事では、浮かせた費用が1回の訂正で消えます。
モデルの順位表を追いかけるより、自社の業務を「検算できる/できない」で棚卸しするほうが先です。どの業務をどちらに置くかが決まっていれば、新しいモデルが出るたびに悩む必要がなくなります。株式会社Fyveでは、その棚卸しからご一緒しています。
※本記事の数値は2026年9月22日時点で各一次ソースから取得したものです。料金・性能は変更される場合があるため、導入判断の際は最新の公式情報をご確認ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。