Anthropic利用方針改定|AI発信の自動化はどこまで

「AIに書かせた記事を公開しているけれど、規約の線はどこにあるのか」「AI検索に拾わせるための施策は、提供元の方針に触れないのか」——発信や制作をAIに任せ始めると、必ずここで手が止まります。
結論から言うと、Anthropicが2026年10月8日に発表した利用方針の改定で、実務にいちばん効くのは報道が見出しにした「モデルへの虐待」ではありません。「検索エンジンやAIが答えの材料にしている場所を、出自・著者・独立性を偽ったコンテンツで操作してはならない」という一文です。施行は2026年11月12日で、条文はすでに公開されています。
株式会社Fyveは中小企業のAI活用を月額で伴走しており、私たち自身もこのサイトの記事をAIに書かせ、公開まで無人で回しています。だからこの改定は他人事ではありません。この記事では公式の方針ページと発表記事を実際に開き、条文の原文を引きながら、自分の運用のどこを見ればいいのかを整理します。報道が強調した点と条文の重心がずれている箇所は、ずれていること自体を書きます。
2026年10月8日に発表され、11月12日に施行される
まず日付を2つに分けます。ここを混ぜると「もう禁止されている」と誤解したまま社内に説明してしまいます。
- 発表日: 2026年10月8日(Anthropicの公式ニュース記事「2026 Usage Policy update」)
- 施行日: 2026年11月12日(公式記事の表現は「The updated policy takes effect on November 12.」)
重要なのは、改定後の条文が、施行を待たずにすでに読める状態で公開されていることです。方針ページの冒頭には「Effective November 12, 2026」と書かれており、ページに載っているのは新しい版の本文です。つまり「施行されてから慌てて読む」必要はなく、約1か月の猶予のあいだに原文を突き合わせられます。
公式記事の書き出しは「Each year, Anthropic updates its Usage Policy in response to the evolving capabilities of our models, and the feedback we've received from our customers.」です。毎年の定期改定という位置づけで、今回が例外的な引き締めというわけではありません。
方針全体は3つの階層でできています。
- Universal Usage Standards(全員に適用される禁止事項)
- High-risk Use Case Requirements(特定領域で満たすべき追加要件)
- Additional Use Case Guidelines(補足のガイドライン)
今回いちばん話題になった変更は1つ目に、そして実務で見落とされやすい論点は2つ目に入っています。順に見ていきます。
報道の見出しは「モデルへの虐待」だが、実務の影響はそこではない
この改定で広く見出しになったのは、Claudeに対する虐待的な振る舞いの禁止です。私が確認した範囲では、TechCrunchが2026年10月8日の記事で、この点を見出しに取っています。
条文の適用範囲は、公式記事の説明では「sustained and needless abusive or cruel behavior toward our models」です。TechCrunchも「only in extreme cases, where users repeatedly act cruelly toward our models, with no discernible purpose」と、極端な場合に限られると伝えています。
そして同じ説明の中で、除外されるものが明示されています。公式記事は「common versions of user frustration」を、TechCrunchは「common versions of user frustration, pushback, dark creative themes, or model testing」を除外対象として挙げています。
つまり、思いどおりに動かないAIに強い言葉で言い直すこと、出力を厳しく突き返すこと、暗い題材の創作、挙動を試すためのテストは、従来どおり問題になりません。業務でAIを使っている限り、この条項に引っかかる場面はほぼ想定しなくていいと読めます。
注意したいのは、この「読みやすくて話題になる変更」が見出しを占めたことで、同じ改定に含まれている実務直撃の条項が報道からこぼれた点です。実際、私が確認した報道では、次の節で扱う条項の本文に触れたものを見つけられませんでした。方針の改定を報道の要約だけで把握すると、重心を取り違えます。
実務に効くのは「欺く行為」の節——6つの禁止行為を原文で読む
今回の改定で新しく立った節が「Do Not Engage in Deceptive Campaigns or Artificial Activity」です。公式記事は、これまで散っていた規定を1つにまとめたと説明しています。
「We've consolidated those rules into a new section titled Do Not Engage in Deceptive Campaigns or Artificial Activity, which applies to deceptive activity of any kind (whether political or commercial).」
ここで効いているのは「whether political or commercial」という括弧です。従来この種の規定は選挙・政治の文脈に寄せて読まれがちでしたが、改定後は商業的な欺きも同じ節で等しく扱われます。普通のビジネス発信をしている事業者が、自分には関係ないと読み飛ばせなくなったのはこの一語です。
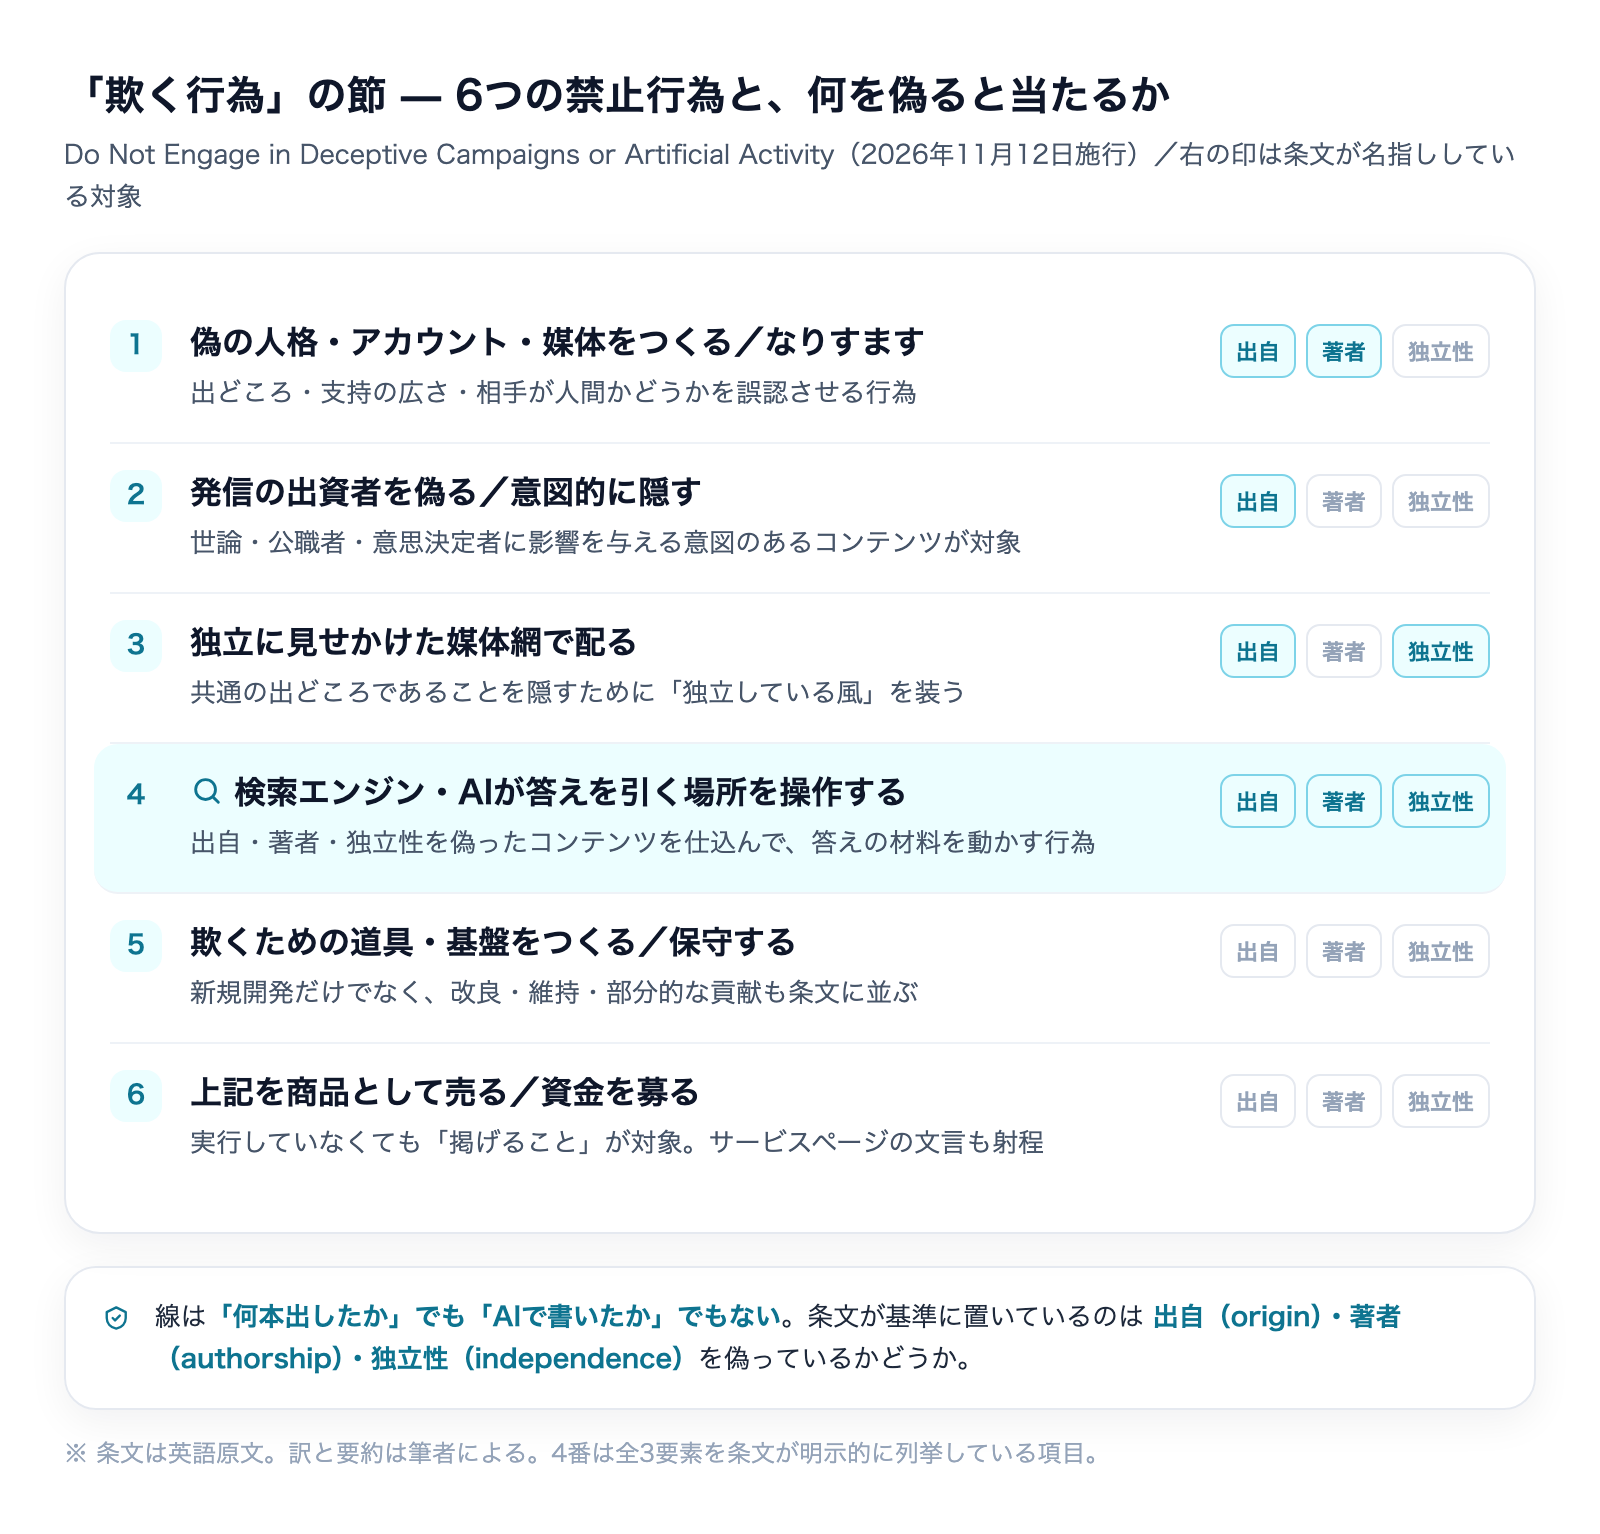
節の中身は6つの禁止行為です。原文と、実務での当たり方を並べます。
1. 偽の人格・アカウント・媒体をつくる、実在の人や組織になりすます
原文は「Create or operate fake personas, accounts, media outlets, or organizations, or impersonate real people, organizations, or media outlets, in order to mislead people about their origin or attribution, how widely a view is held, or whether they are interacting with a human (e.g., sockpuppets, astroturfing, fake reviews, or bots that claim to be human)」です。
条文が守ろうとしているものが3つ並んでいる点に注目してください。出どころ(origin or attribution)/その意見がどれくらい広く支持されているか(how widely a view is held)/相手が人間かどうか(whether they are interacting with a human)。この3つを誤認させることが禁止の対象です。
実務で当たりやすいのは3つ目です。問い合わせ対応やSNSの返信をAIに任せていて、相手が人間だと思い込む作りになっていないか。「人間だと主張するボット(bots that claim to be human)」が例示されているので、積極的に人間を装っていなければ射程外と読めますが、名前と顔写真を人のものに見せて運用しているなら、一度見直す側に入ります。
2. 発信の出資者・スポンサーを偽る、意図的に隠す
原文は「Misrepresent or intentionally conceal the sponsorship of content or messaging intended to influence public opinion, officials, or other decision-makers」です。
対象は「世論・公職者・その他の意思決定者に影響を与えることを意図したコンテンツ」で、誰がカネを出しているかを偽る・意図的に隠す行為です。広告記事・タイアップ・団体名義の発信など、スポンサーの存在が読者から見えない形になっている発信が点検対象になります。
3. 独立した別々の媒体に見せかけたネットワークで配る
原文は「Distribute content through networks of fake or ostensibly independent outlets, websites, or accounts to hide that it comes from a common source」です。
鍵は「ostensibly independent」(独立しているように見せかけた)です。複数のサイトやアカウントを持つこと自体ではなく、同一の出どころであることを隠すために独立を装うのが問題になります。
サテライトサイトを複数立てて相互にリンクさせる手法、同じ運営者が屋号を変えて複数の比較サイトを持つ構成は、ここを正面から読む必要があります。運営者情報を各サイトに明記していれば「隠している」側には当たりにくい、という読み方になりますが、断定は避けます(後述の注意参照)。
4. 検索エンジンやAIが答えを引く場所を、出自を偽ったコンテンツで操作する
原文はこうです。
「Manipulate the sources from which search engines or AI systems draw answers by seeding them with content that misrepresents its origin, authorship, or independence」
これが今回の改定で、日本の事業者にいちばん効く一文だと私は読みました。理由を3つ挙げます。
第一に、対象が検索エンジンとAIの両方に明記されていることです。従来この種の規定は「選挙の世論操作」として読まれてきましたが、ここでは答えの出どころを操作する行為そのものが名指しされています。SEOやAI検索対策(AIO・LLMO)として語られている施策領域と、条文の射程がまっすぐ重なります。
第二に、禁止の基準が「量」ではなく「偽り」で引かれていることです。条文が挙げるのは origin(出自)/authorship(著者)/independence(独立性) の3つで、記事を何本出したか、AIで書いたかどうかは条件に入っていません。大量に出すこと自体が禁止された、という読み方は条文から出てきません。
第三に、「seeding them with content」という動詞が選ばれていることです。答えの材料になる場所に、そういう狙いで仕込む行為を指しています。自社の実務や検証を書いて公開する通常のコンテンツ運用と、材料を仕込んで答えを動かすことを目的にした運用とを、条文は書き分けようとしています。
5. 欺くための道具・基盤をつくる、改良する、維持する
原文は「Build, improve, maintain, or contribute to tools, systems, or infrastructure designed to facilitate or enable deceptive campaigns, including astroturfing, sockpuppet account creation, coordinated inauthentic behavior, or scaled impersonation」です。
自分で欺く発信をしていなくても、それを可能にする道具をつくる側も対象になります。動詞が「Build, improve, maintain, or contribute to」と4つ並んでおり、新規開発だけでなく保守や部分的な貢献も含まれる書き方です。受託開発やツール提供をしている事業者は、この節を自分の納品物の側から読む必要があります。
6. 上記を商品・サービスとして売る、資金を集める
原文は「Market, sell, or solicit funding for any of the above as a product or service」です。実行していなくても売り物として掲げること・出資を募ることが対象になります。サービスページの文言が射程に入るという意味で、ここは見落としやすい条項です。
いちばん誤読されそうな点——「AIで書くこと」は禁止されていない
ここが本記事でもっとも強く言いたいところです。改定の説明を要約で読むと、「AIで書いたと開示しないと規約違反になる」という結論に飛びたくなります。条文はそう書いていません。
整理すると、方針は2つの別の要求をしています。
- 全員に適用される禁止(欺く行為の節)= 隠すな・偽るな。誰が発信しているか、誰がカネを出しているか、独立しているかを誤認させてはならない
- 高リスク領域での追加要件(High-risk Use Case Requirements)= 言え。該当領域では、AIを使ったことを相手に明確に伝えなければならない
後者の原文は「An individual who receives advice or who is the subject of a decision based on a High-risk AI Recommendation must be clearly told that AI was used to produce it」です。この積極的な開示義務は、方針が列挙する高リスク領域に限って課されます。
方針が高リスクとして挙げている領域は次のとおりです。
- 法律に関する助言・法的文書
- 医療の診断・治療
- 金融の投資・税務に関する推奨
- 与信の判断
- 保険の引受・給付査定
- 住宅の入居審査・退去
- 採用のスクリーニング・人事上の決定
- 教育・資格に関する判断
- 医療アクセス・トリアージ
- 公的給付の受給資格
- 在留・法的地位の判断
同じ節には、人のレビューを挟む要件もあります。「A qualified person must meaningfully review a High-risk AI Recommendation, with the authority to change or modify it, before it is delivered」——変更する権限を持った適格な人が、届ける前に実質的にレビューするという条件です。「形式的に目を通した」では要件を満たさない書き方になっています。
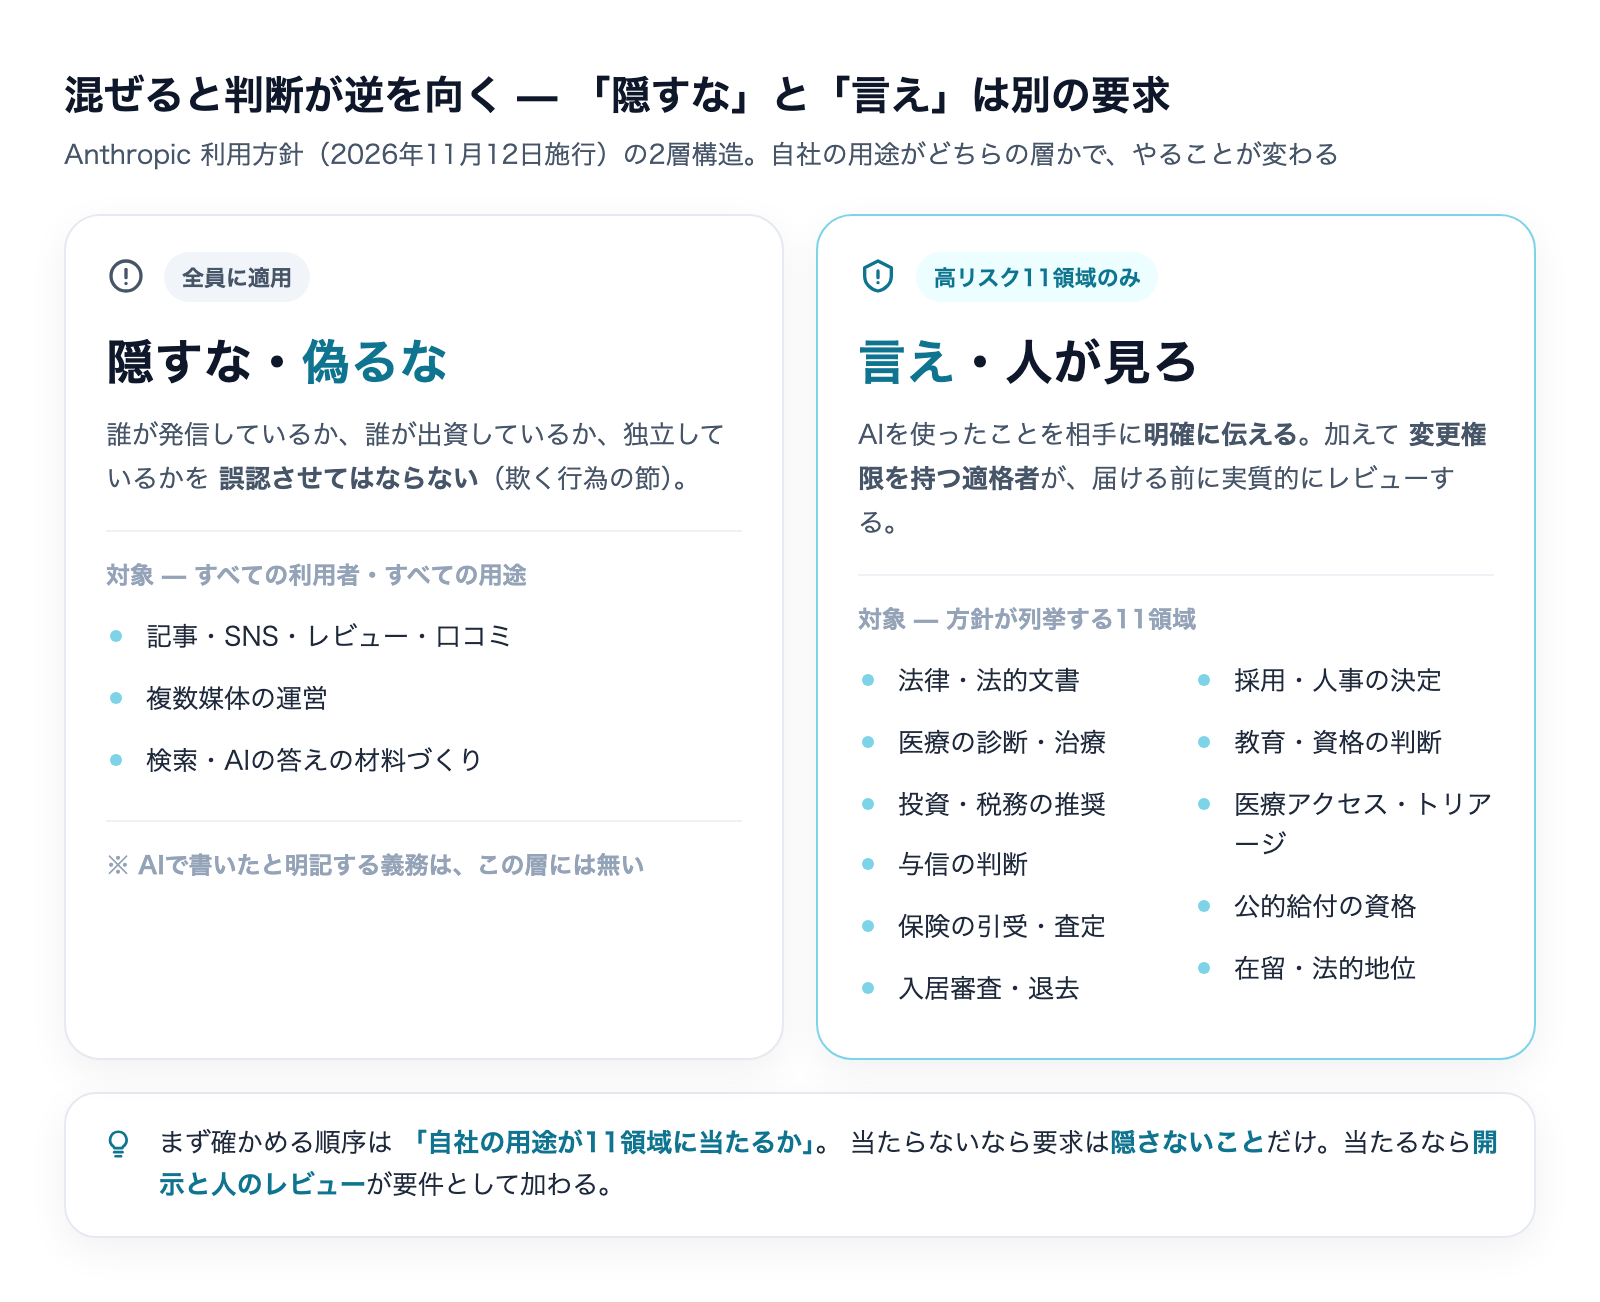
この2層を取り違えると、実務の判断が逆を向きます。一般的な業務の文書や記事に開示を義務づける条文は見当たりません。一方で、採用スクリーニングや与信の判断にAIの推奨を使っているなら、開示と人のレビューが明確な要件として課されています。自社の用途がどちらなのかを先に確かめるのが順序です。
なお、AIで書いたことを「開示するかどうか」は規約とは別に、読者との信頼や受託時の合意の問題として残ります。その観点は別記事で扱っています。
AI文章に印が入る仕組みと、開示の文面の型についてはAI文章の透かしとは|Claudeの仕様と限界・企業の対応で整理しました。今回の改定は規約の線の話で、こちらは検出と開示の話です。別の論点なので、両方を分けて持っておくと判断しやすくなります。
私たちはこの線をどう越えないようにしているか
私たち自身が、この節を自分の運用に当てて点検する立場にあります。このサイトには2026年10月9日時点で882本の記事が公開されており、その大半はAIが本文を書き、公開までの工程も無人で回しています。条文の射程にまっすぐ入る運用です。
そのうえで、6つの条項に照らして越えないようにしている点を、仕組みの側から書きます。やっていることは4つだけです。
- 名前を隠していない。記事は法人名義の自社サイトに出しており、運営者が誰かを隠す構成を取っていません。条文の origin・authorship に当たる部分を、そもそも伏せていない
- 独立を装った別媒体に配っていない。同じ内容を、無関係に見える複数のサイトへ出所を隠して配る運用をしていません。条文の「ostensibly independent」に当たる構成を持たない
- 出典と確認日を本文に残している。外部の数字や仕様に触れるときは、どの一次情報をいつ確認したかを記事内に書いています。これは条文の要求ではありませんが、出自を偽らない運用の実装として機能します
- 公開前に、書いた側とは別のAIが点検している。本文を書いた工程とは分離した別プロセスで、機密・事実の裏取り・規範の適合を審査し、通らなかったものは公開せず下書きに退避させています
正直に書くと、この4つは今回の改定に備えて用意したものではありません。別の理由(誤りを出さないため・クライアント情報を漏らさないため)で先に組んでいたものが、結果として条文の側と同じ向きを向いていたというだけです。
そこから引き出せる判断が1つあります。「隠さない」を既定にしておくと、提供元の方針が改定されたときに動かす必要がない。逆に、出どころを曖昧にすることで成り立っている運用は、規約が変わるたびに作り直しが必要になります。方針は毎年改定される、と公式記事が明言している以上、これは毎年起きます。
選挙の節は「広がった」のではなく「的が絞られた」
報道では選挙関連の禁止が強化されたように読めますが、条文の変化はもう少し込み入っています。節の名前は「Do Not Undermine Democratic Processes」に改称され、中身は5つの禁止行為に絞られました。
- 「Generate automated calls or messages to voters or public officials at scale that conceal their artificial origin」(人工的な出所を隠した、有権者や公職者への大量の自動連絡)
- 「Create content, or operate accounts or systems, that falsely appear to come from or on behalf of a real candidate, official, election authority, campaign, or news outlet, including fabricated statements, endorsements, or synthetic media not disclosed as synthetic」(実在の候補者・当局・報道機関を装う)
- 「Generate or disseminate false or misleading information in political and electoral contexts, including about candidates, parties, policies, voting procedures, or election security」(政治・選挙の文脈での偽情報)
- 「Encourage, glorify or facilitate the disruption of electoral or civic processes, including interference with voting systems, vote counting, certification processes, or any other infrastructure used for voting」(選挙・市民プロセスの妨害)
- 「Create or disseminate content or engage in behavior designed to suppress voter turnout or discourage legitimate political participation through deception or intimidation」(投票率の抑圧)
そして撤回された規定があります。公式記事は、個人に合わせた投票関連のターゲティングに対する一律の禁止を外したと説明しており、認める例として「nonprofits using Claude to write information for voters in other languages」(非営利団体がClaudeで他言語の有権者向け情報を書く)を挙げています。
つまりこの節は、正当な市民活動を巻き込んでいた広すぎる網を外し、欺きと妨害に的を絞り直した改定です。「選挙関連が厳しくなった」という一言でまとめると、方向を取り違えます。5つの条文に共通するのは、偽る・装う・隠すという動作で、節が変わっても欺く行為の節と同じ軸が通っています。
残り3つの改訂——武器・監視・自律的な物理動作
ここは多くの事業者にとって直接の関係は薄いですが、改定の全体像として押さえておきます。
武器の禁止がソフトウェア側へ広がった
公式記事の説明では、禁止の範囲が「software and components that make weapons work」(武器を機能させるソフトウェアと部品)に明示的に拡張され、行為の例として「arming drones and other autonomous vehicles」(ドローンやその他の自律走行体の武装化)が挙げられています。物理的な兵器そのものから、それを動かすソフトウェア側へ線が引き直されたということです。
同意なき追跡・捜査対象の推薦が明確に禁止された
公式記事は「tracking people without their consent...whether it happens in real time or through analysis of previously collected data」と説明しており、リアルタイムの追跡だけでなく、既に集めたデータの事後分析も同じ扱いになります。あわせてClaudeは「decide or recommend who to investigate, arrest, or charge」(誰を捜査・逮捕・起訴するかを決める、または推薦する)ことができないと書かれています。
民間の事業者でも、購買履歴や位置情報の分析で個人を追う処理をAIに任せている場合は、同意の有無が条文上の分かれ目になります。
物理的に動く機器には、止められる人を置く要件
怪我を引き起こしうるハードウェアにClaudeをつなぐ場合、公式記事の説明では、運用者は「observe the equipment and stop it if needed」(機器の動作を観察し、必要なら止める)必要があります。方針側の条文はさらに具体的で、「there must be a qualified individual who is able to observe the equipment's operation and stop it at any time, and the equipment must stop or hold a safe state when that individual intervenes」——いつでも止められる適格者の存在と、介入時に機器が停止または安全状態を保つことの両方が要件です。
対象として示されているのは、車両・航空機、力を加える機械、危険エネルギーを扱う系、医療機器、安全制御、産業プロセスの6分類です。
11月12日までに見ておく5つの点検
以上を踏まえて、施行日までに自社で確かめられることを手順にします。条文の解釈をこちらで決めるのではなく、自分の運用のどこを原文と突き合わせるべきかという形で並べます。
点検1: AIが関わっている対外的な出力を全部書き出す
記事・SNS投稿・レビューへの返信・問い合わせ対応・メール文面・提案資料・レポート。媒体ごとに、誰の名前で出ているかを1列足して書き出します。ここを一覧にしないと、残りの点検が机上の話になります。
点検2: 「名前で出ているか/出どころが辿れるか」で2つに分ける
欺く行為の節が見ているのは出自・著者・独立性です。だから分類の軸は「AIで書いたか」ではなく「出どころが読者から辿れるか」にします。運営者情報が載っていない媒体、屋号を変えて運用しているアカウント、匿名で出しているレビューや口コミが、ここで浮きます。
点検3: 複数媒体の関係が「独立しているように見える」構成になっていないか
サテライトサイト、比較サイト、別ブランドのメディアを持っている場合、同一運営であることが各媒体から分かるかを確かめます。条文が問題にしているのは媒体を複数持つことではなく、共通の出どころを隠すことです。
点検4: 高リスク領域に当たる用途がないかを11領域と照合する
採用のスクリーニング、与信、保険の査定、入居審査、医療、法務、公的給付。1つでも当たるなら、開示と「変更権限を持つ人のレビュー」が要件になります。自社がどちらの層にいるかは、ここで決まります。
点検5: サービスページの文言を、6つ目の条項に照らして読む
「売る・掲げる」ことが対象の条項があるため、提供メニューの説明文も点検対象です。口コミ対策・評判管理・AI検索対策を商品として出している場合、何を提供すると書いてあるかを条文の語(出自・著者・独立性)と並べて読み直します。
点検の結果をルールとして社内に落とす段になったら、作り方は生成AI社内ガイドラインの作り方|実務で使えるルール設計の考え方にまとめています。あわせて、入力したデータが学習に使われるかという別軸の論点はAIに業務情報を入れて大丈夫?主要4社の学習ポリシーで各社を比較しています。
注意——条文の解釈は、最後は原文を自分で読む
ここまで原文を引きながら書いてきましたが、私たちは法律の専門家ではありません。そして本記事は、特定の運用が方針に適合しているかどうかを保証するものではありません。
理由は条文の作りにあります。欺く行為の節の各条項には「in order to mislead people about...」「intended to influence...」「designed to facilitate...」のように目的・意図を条件にする語が入っています。目的要件が入っている条文は、同じ外形の行為でも意図によって結論が変わりえます。記事の側から「この構成ならセーフです」と言い切れる種類の条文ではありません。
実務では次の順で扱うのが安全だと考えています。
- まず原文を自分で開く(方針ページと発表記事の2つ。要約で判断しない)
- 判断が分かれそうな運用は、外形ではなく「何のためにそうしているか」を書き出す
- 事業の根幹が条文の近くにあるなら、弁護士に見てもらう。記事やブログの整理はその前段にすぎません
また、本記事の引用はすべて英語の原文からで、訳はこちらで付けたものです。日本語訳と原文で意味が食い違う可能性があるため、判断に使うときは英語の原文に戻ってください。
よくある質問
AIで書いた記事に「AI生成」と明記しないと規約違反になりますか
方針を読むかぎり、一般的な記事に明記を義務づける条文は見当たりません。全員に適用される節が禁止しているのは、発信者・出資者・独立性を偽ったり意図的に隠したりすることです。一方、方針が列挙する11の高リスク領域に当たる用途では、AIを使ったことを相手に明確に伝える要件が課されます。自社の用途がどちらかで答えが変わります。
記事を大量に出していること自体が問題になりますか
条文には本数や頻度の基準がありません。基準になっているのは出自・著者・独立性を偽っているかどうかです。量そのものを禁じる記述は見当たりません。ただし、出どころを隠すために媒体を増やしている構成は、量ではなく「隠している」側で読まれます。
AI検索対策(AIO・LLMO)はやってはいけないということですか
条文が禁じているのは、答えの材料になる場所を出自・著者・独立性を偽ったコンテンツで仕込んで操作することです。自社の名前で、自社の実務や検証を書いて公開する施策と、この条文の射程は同じではありません。ただし境目は意図を含む条件で引かれているため、どちらに当たるかを記事側で断定はできません。自社の施策が「何を偽っているか/偽っていないか」で説明できるかを確かめるのが実務的です。
Claude以外のAIを使っていれば関係ありませんか
この方針はAnthropicの製品に適用されるものです。他社のAIには各社の方針が適用されます。ただし、複数社のAIを併用している場合は最も厳しい条件が実質的な制約になりますし、方針の方向性は各社で似通う傾向があります。自社が使っているすべての提供元の方針を一度並べるのが確実です。
施行日の11月12日に何かが自動で止まりますか
公式記事には、施行日に特定の機能が止まるという記述はありません。その日から新しい方針が適用されるということです。やっておくべき準備についても、公式記事は特定の手続きを指定していません。
2026年4月のOAuth関連の規約変更とは別の話ですか
別の話です。あちらは認証方法と自動化の構成に関する規約の論点で、当時の整理はAnthropic OAuth規約変更後のHermes Agent合法運用ガイドに書いています。本記事は毎年の利用方針(Usage Policy)の定期改定で、別の文書です。重なるのは「自動化している運用を提供元の条件に合わせて点検する」という作業の型だけです。
まとめ——線は「AIで書いたか」ではなく「出どころを偽っていないか」
2026年10月8日に発表され、2026年11月12日に施行されるAnthropicの利用方針改定について、実務の要点を3つに絞ります。
- 報道の重心と条文の重心がずれている。見出しを取ったモデルへの虐待の禁止は極端な場合に限られ、通常の業務利用では当たらない。実務に効くのは新設された「欺く行為」の節のほう
- いちばん見落とされている一文は、検索エンジンとAIの答えの出どころに関する条項。禁止の基準は量でもAI利用の有無でもなく、出自・著者・独立性を偽っているかで引かれている
- 「隠すな」と「言え」は別の要求。全員に適用されるのは偽るな・隠すなで、AIを使ったと明確に伝える義務は11の高リスク領域に限って課される。この2層を混ぜると判断が逆を向く
新しい規約が出たときに最も危ういのは、報道の見出しをそのまま社内ルールにしてしまうことです。今回の改定は、見出しになった条項と実務に効く条項が別でした。株式会社Fyveは、こうした改定を自分たちの無人運用に先に当てて点検してから、お客様の運用のどこを見るべきかを一緒に決めています。
本記事の日付・条文の引用は2026年10月9日時点で、Anthropicの公式方針ページおよび公式発表記事を確認したものです。施行前後で記述が更新される可能性があるため、判断の際はその時点の原文を必ずご確認ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。