Gemini 4 Neon vs Opus 5.5|使い分け

「Gemini 4 Neon と Claude Opus 5.5、仕事に使うならどちらか」「Google の表では Neon が勝っているが、Claude Code で使っている Opus 5.5 から乗り換えるべきか」——11月18日に Neon が出て、Google が発表の比較表に Opus 5.5 を並べたことで、こう迷っている人は多いはずです。
結論から言うと、長い資料をまとめて読む仕事・回数の多い業務の自動化・費用を抑えたい仕事は Neon、Claude Code で長く回すコーディングと端末で動かす作業は Opus 5.5が、いま公開されている数字から言える使い分けです。コーディングの点数は1ポイント前後の差で並んでおり、差がはっきり出るのは長い文脈と費用のほうです。
株式会社Fyveは、中小企業の AI 活用を月額で伴走支援しながら、社内の定期の仕事でも仕事の重さに合わせてモデルを分けて毎日動かしています。この記事では、2026年11月21日時点の Google と Anthropic の公式の発表・ドキュメント、第三者の計測、私が同じ日に手元で2つのモデルを呼んで確かめた結果をもとに、Gemini 4 Neon と Opus 5.5 の違いと使い分けを整理します。
Gemini 4 Neon と Opus 5.5 の使い分け早見表
先に、迷ったときの答えを表にします。理由はこのあと1つずつ説明します。
やりたいこと | 選ぶモデル | 理由 |
|---|---|---|
Claude Code でリポジトリを長く触らせる開発 | Opus 5.5 | Claude Code の既定のモデルで、Google の表では端末の作業の点数が Neon をわずかに上回る |
1回で長いコードや長い文章を出させる | Opus 5.5 | 1回の出力の上限が 128K で、Neon の同期の上限 65,536 の約2倍 |
契約書・議事録・PDF の束など、数十万トークンを一度に読ませる | Neon | Google の表で長文の検査(GraphWalks)が 95.2% 対 66.8% |
回数の多い調べもの・業務の自動化を安く回す | Neon | 単価が4分の3で、第三者の計測でも1つの仕事あたりの費用が低い |
Google AI Pro のアプリや Antigravity で使いたい | Neon | Gemini アプリの「Deeper analysis」の欄が Neon |
AWS(Bedrock)や Microsoft Foundry の契約の中で使いたい | Opus 5.5 | Anthropic のモデル一覧に各クラウドの ID がある。Neon は Google の発表に名前が無い |
ポイントは、Google の表の「Neon が多くの行で勝っている」を、そのまま「Opus 5.5 より上」と読まないことです。Opus 5.5 が上回った2行はどちらもコーディングで、Claude Code で開発している人にとってはいちばん効く行です。逆に、長い資料を扱う仕事では差が大きく開いています。
2つのモデルの位置づけ|同じ格のモデルではない
比べる前に、2つが各社の中でどこに置かれたモデルかを押さえておきます。ここを取り違えると、比べ方そのものを誤ります。
Gemini 4 Neon:Google の中位のモデル
Neon は2026年11月18日に発表され、同じ日から Gemini API の有料枠・Google AI Studio・Gemini アプリ・Antigravity で順に提供が始まったモデルです(Google の発表・2026年11月18日)。Gemini 4 の中では、速い Hydrogen と、いちばん深く考える Carbon の間に置かれています。
Google の上には Carbon があり、Neon で詰まった仕事は Carbon に上げる、というのが Gemini API のドキュメントの示す流れです。2つの違いは別の記事にまとめています。
Claude Opus 5.5:Anthropic の長時間の仕事向けのモデル
Opus 5.5 は2026年9月22日に発表された Anthropic のモデルです(Anthropic の発表・2026年9月22日)。Anthropic のモデル一覧では「長く回すエージェントのコーディングと知的な仕事のため」のモデルと説明されています。発表では、多くの仕事で上位の Fable 5.1 と同じ水準の結果を、Opus 5 より40%安い費用で出すとしていました。
Anthropic の中でも、Opus 5.5 の上には11月9日に出た Fable 5.2 があります。つまり Neon も Opus 5.5 も「会社のいちばん上のモデル」ではなく、ふだんの難しい仕事を受け持つ主力の段にあるモデル同士の比較です。Google が発表の表で Opus 5.5 と並べたのも、この位置が近いからだと読めます。
Claude Opus 5.5とは|Opus 5から何が変わったのか【完全ガイド】
Gemini 4 Neon と Opus 5.5 の違いを一覧で比べる
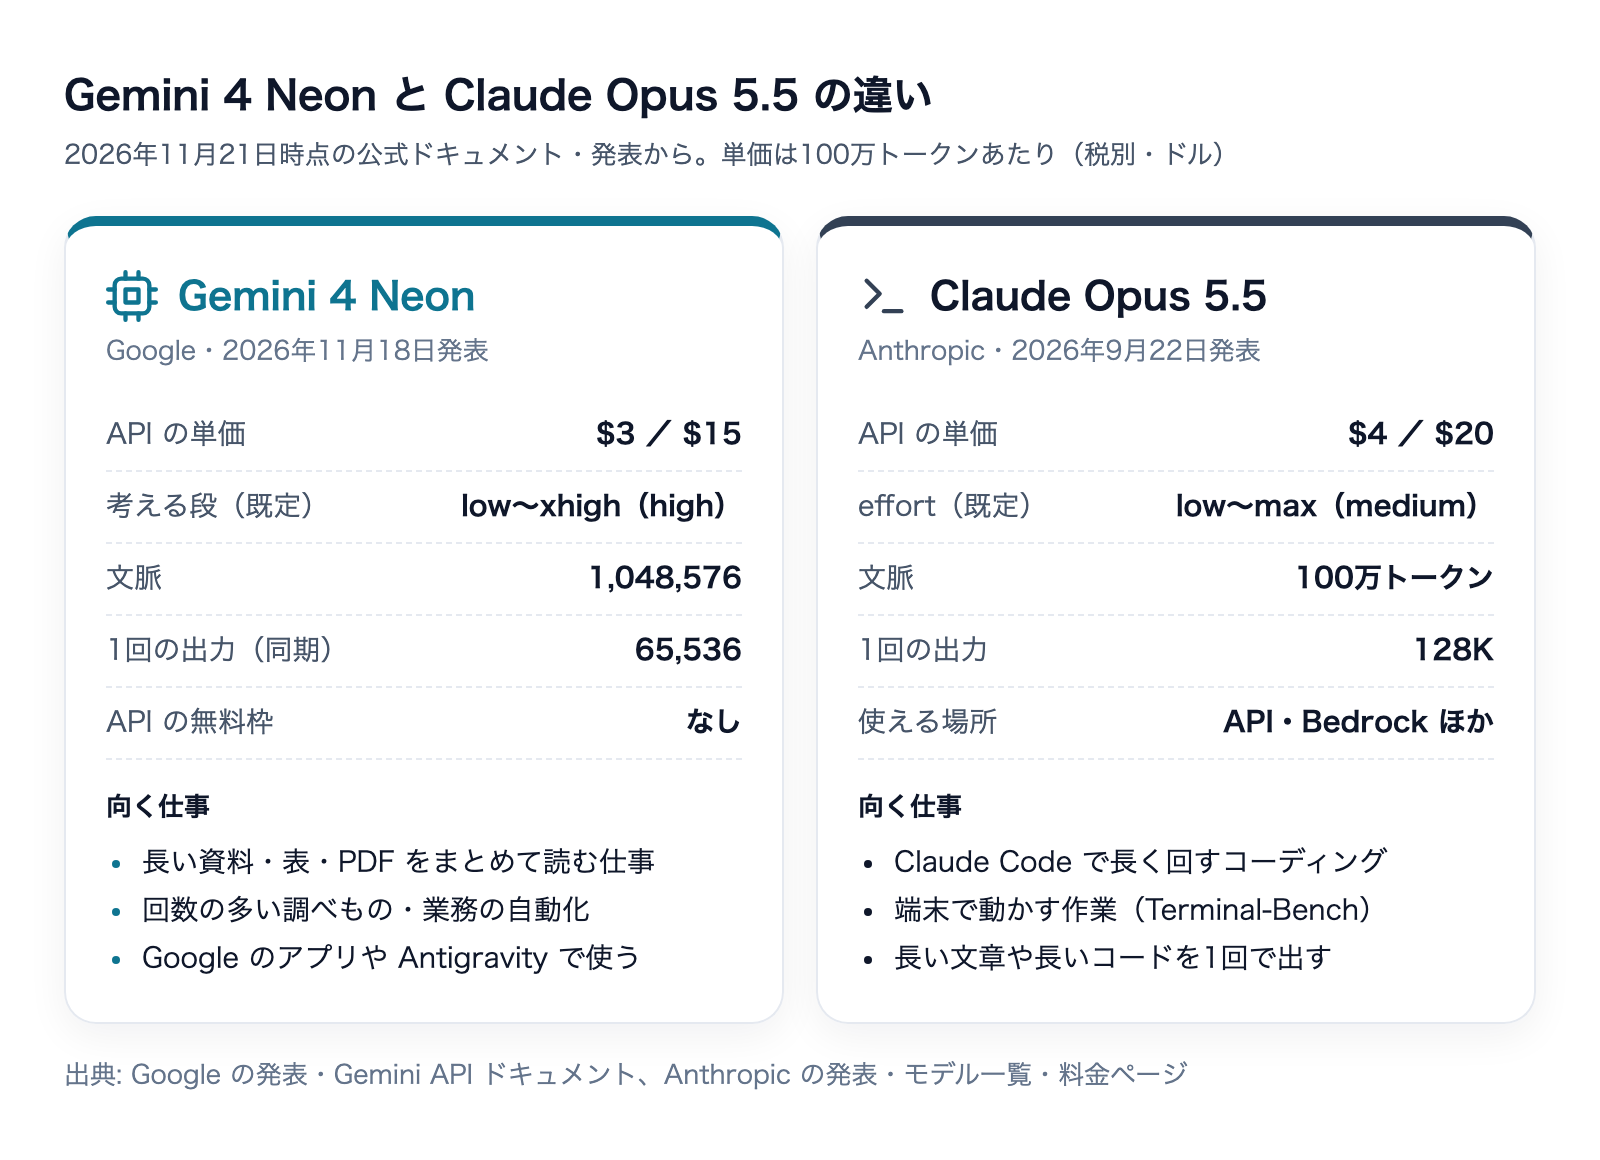
使い分けに関わる違いを、両社の公式のドキュメントから表にします。いずれも2026年11月21日時点の記載で、単価は100万トークンあたりの税別のドルです。
項目 | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
API のモデル名 | gemini-4-neon | claude-opus-5-5 |
発表日 | 2026年11月18日 | 2026年9月22日 |
API の単価(入力/出力) | $3/$15(出力は思考のトークンを含む) | $4/$20 |
キャッシュを読んだときの入力 | $0.15 | $0.20 |
考える段の名前 | thinking level:low・medium・high・xhigh | effort:low・medium・high・xhigh・max |
考える段の既定 | high | medium |
考えるのを止められるか | 止められない(最も軽い minimal は Gemini 4 では使えない) | 止められない(思考は常にオン。止める指定は 400 エラー) |
文脈の長さ | 1,048,576 トークン | 100万トークン(追加料金なし) |
1回の出力の上限 | 65,536(同期) | 128K |
API の無料枠 | なし | なし |
主なクラウド | Gemini API(Google AI Studio) | Claude API・Amazon Bedrock・Google Cloud・Microsoft Foundry |
出典は、Neon が Gemini API のモデルのページと料金のページ、Opus 5.5 が Anthropic のモデル一覧と料金のページです。
この表で見落としやすいのは、既定の考える段が違うことです。Neon は何も指定しないと high で考え、Opus 5.5 は medium で考えます。何も設定せずに同じ問題を投げると、Neon のほうが1段深く考えた状態で比べることになります。あとで見る第三者の計測でも、この差がそのまま点数に出ています。
Google の比較表から読む|コーディングは並び、長文で差が開く
Google は Neon の発表に、Neon・Claude Opus 5.5・GPT-6.2 Sol の3つを並べた表を載せました。他社のモデルを名指しで並べた表なので、この比較の材料としてはいちばん直接的です。
ただし読む前に2つ注意があります。1つは、Google 自身が出した数字だということ。もう1つは、Google の評価方法の資料によると、Opus 5.5 の値は基本的に各社が公開した数字から引いたもので、Opus 5.5 には公開されている中で最大の推論の設定の値を使っていることです。Neon の側は、特に断りが無い行は Gemini API の最も高い考える段の値です。
この表で Opus 5.5 が Neon を上回った行は2つだけでした。
- Terminal-Bench 4.1(端末でコマンドを動かして仕事を終わらせる検査):Neon 65.2%、Opus 5.5 65.8%
- FrontierCode 2.0(難しいコーディングの検査):Neon 46.2%、Opus 5.5 47.3%(Neon は既定の high の値)
どちらも差は1ポイント前後で、検査の誤差の範囲に近い差です。言い換えると、コーディングの力はほぼ並んでいると読むのが妥当です。
一方で、Neon が大きく上回った行もあります。使い分けに関わるものを挙げます。
- GraphWalks(25.6万〜100万トークンの長い文脈の中で関係をたどる検査):Neon 95.2%、Opus 5.5 66.8%
- AutomationBench(業務の自動化の検査):Neon 56.3%、Opus 5.5 42.5%
- CursorBench 4.1(Cursor での開発の検査):Neon 65.4%、Opus 5.5 58.1%
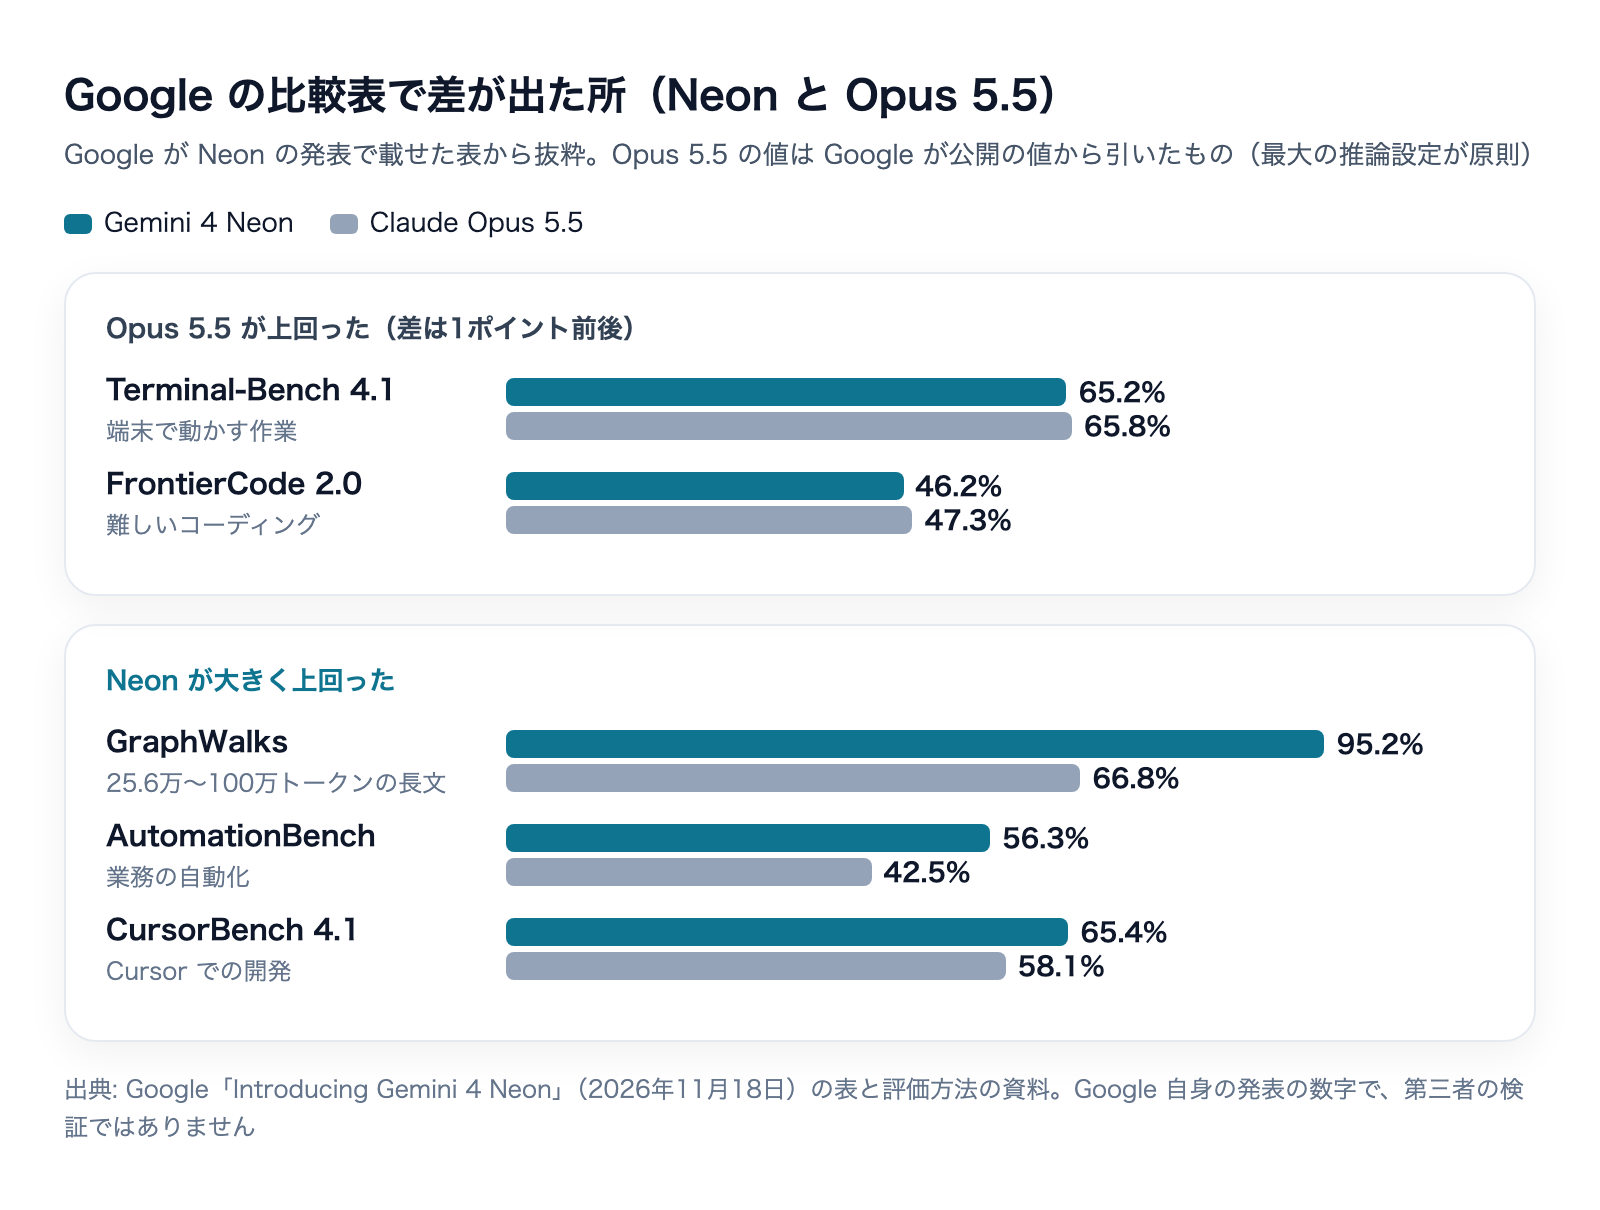
いちばん差が大きいのは長い文脈です。どちらも100万トークン前後を入れられますが、入れられることと、入れたものの中から正しく拾えることは別です。数十万トークンの資料の束を一度に読ませて答えを出させる仕事なら、いま公開されている数字では Neon が有利です。
表のすべての行と、各検査が何を測っているかは、ベンチマークの記事で扱います。
第三者の計測ではどうか|既定の段のままだと差が広がる
Google の数字だけでは判断しにくいので、第三者の計測も見ておきます。AI モデルを横並びで計測している Artificial Analysis は、2つのモデルの比較のページを出しています(Artificial Analysis の比較のページ・2026年11月21日に確認)。
項目 | Neon(xhigh) | Opus 5.5(max) |
|---|---|---|
Intelligence Index(総合の点数) | 61 | 59 |
総合の点数の計測1件あたりの費用 | $6.44 | $10.04 |
同じく1件あたりの時間 | 21.5分 | 25.6分 |
Terminal-Bench 4.0(Artificial Analysis の計測) | 63.6% | 59.6% |
FrontierCode 2.0(Artificial Analysis の計測) | 44.4% | 46.4% |
どちらもいちばん上の段どうしで比べると、総合の点数は2点差で、費用は Neon が約3分の2です。コーディングは、端末の作業で Neon、難しいコーディングで Opus 5.5 が上という結果で、Google の表と同じく決定的な差はありません。
使い分けに効くのは、同じページにある段ごとの総合の点数です。Neon は既定の high で60、Opus 5.5 は既定の medium で48でした。Opus 5.5 は max で59、xhigh で57、high で52です。何も設定を変えずに使うと、Neon は自分の上限に近い力で動き、Opus 5.5 は上限より一段も二段も下の力で動いていることになります。
つまり、Opus 5.5 を Neon と同じ水準で使いたいなら effort を上げる必要があり、そのぶんトークンと待ち時間が増えます。Opus 5.5 の既定が medium になった理由と上げ方は、別の記事にまとめています。
Claude Opus 5.5のeffort設定|既定がmediumになった意味
もう1つ、エージェントとしての実際の仕事ぶりで順位を付ける Arena の Agent Arena の表(Arena の Agent Arena・2026年11月21日に確認)では、Neon(High)が1,333点、Opus 5.5(Max)が1,336点でほぼ並び、1つの仕事あたりの費用の中央値は Neon が $2.52、Opus 5.5 が $5.79 でした。Neon の値は「暫定」の印付きです。点数はほぼ同じで、費用は半分以下という形は、Artificial Analysis の結果と同じ向きです。
費用の違い|単価の差より、1つの仕事あたりの差が大きい
API の単価は、入力も出力も Neon が Opus 5.5 の4分の3です。同じ入力と出力のトークン数なら、Neon の費用は Opus 5.5 の75%になります。
ただ、実際の費用は「1回でどれだけ考えるか」で決まります。上の第三者の計測では、1つの仕事あたりの Neon の費用は Opus 5.5 の、Artificial Analysis で約64%、Arena で約44%でした。単価の比の75%より、差が大きく開いています。考えるトークンの量や、仕事を終えるまでの往復の回数が、モデルによって違うからです。
ここから言えるのは、回数の多い仕事ほど Neon の費用の利点が効くということです。逆に、月に数回の重い設計の相談のように回数が少ない仕事では、費用の差より、手元の道具で使えるか・出力が足りるかのほうが判断に効きます。
キャッシュ・Batch・月の試算など、費用の細かい表は料金の記事で扱います。Opus 5.5 の料金は、既存の記事にまとめています。
Claude Opus 5.5の料金|値下げで月いくら変わるのか
使える場所の違い|どの道具から使うかで決まることが多い
実務では、モデルの点数より「いつも使っている道具から選べるか」で決まることがよくあります。2026年11月21日時点で、両社の発表とドキュメントから分かる範囲を並べます。
使う場所 | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
各社のチャットのアプリ | Gemini アプリ(Google AI Pro・Ultra の「Deeper analysis」) | Claude のアプリ |
各社のコーディングの道具 | Antigravity(有料の AI Pro・Ultra と企業) | Claude Code(既定のモデル) |
API | Gemini API の有料枠 | Claude API |
他社のクラウド | Google の発表に名前なし | Amazon Bedrock・Google Cloud・Microsoft Foundry |
GitHub Copilot | 11月18日から(Copilot Pro+・Business・Enterprise など) | 9月22日から |
GitHub Copilot は、GitHub の更新履歴(2026年11月18日)で Neon の提供開始が告知されています。Opus 5.5 も9月22日から選べるので、Copilot を契約している人は、同じ画面で2つを切り替えて同じ課題を試せます。乗り換えを決める前に、自分のリポジトリで両方を数回ずつ走らせるのがいちばん確かです。
Neon がどのプランで使えるか、出てこないときの原因は、別の記事で詳しく扱っています。Opus 5.5 のプランも既存の記事にあります。
Claude Opus 5.5はどのプランで使えるのか|無料では使えるか
手元で2つのモデルを呼んでみた結果
2026年11月21日の11時すぎに、同じ問題を2つのモデルに投げてみました。問題は「りんごは1個120円、みかんは1個45円。両方を1個以上買って、合計がちょうど1,000円になる買い方は何通りか。答えと理由を3行以内で」です。120と45はどちらも15の倍数で、1,000は15で割り切れないので、正解は0通りです。
Opus 5.5:3つの段とも正解
Claude Code(2.1.296)から --model claude-opus-5-5 を付け、effort を low・medium・high に変えて1回ずつ呼びました。
effort | 答え | 出力トークン | かかった時間 |
|---|---|---|---|
low | 0通り(15の倍数で説明) | 171 | 2.5秒 |
medium | 0通り(両辺を5で割り、3の倍数で説明) | 147 | 2.5秒 |
high | 0通り(medium と同じ筋道) | 169 | 2.4秒 |
この程度の問題では、段を上げても答えも時間もほとんど変わりませんでした。effort の差が出るのは、もっと長く考える必要がある仕事です。
Neon:無料枠の鍵では答えまで届かない
Neon は、私の手元にある Gemini API の無料枠の鍵で呼びました。同じ問題のトークン数を数える呼び出し(countTokens)は通り、85トークンと返りました。一方、答えを出させる呼び出し(generateContent)は、429 RESOURCE_EXHAUSTED で止まりました。
これは Google の料金のページにある「Neon は無料枠では使えない」という記載のとおりの動きです。答えの中身を並べて比べるには、有料枠の鍵か、Neon を選べるアプリ・Copilot が要ります。この記事では Neon の答えを確かめておらず、性能の比較は上の公式と第三者の数字によるものです。
どちらを選ぶか|仕事の種類で分けて固定する
私たちは社内の定期の仕事で、文章を書く仕事には Claude の上位のモデル、回数の多い機械的な仕事には一段軽いモデル、画像を作る仕事には別の会社のモデル、と仕事ごとにモデルを分けて固定しています。1つのモデルに全部を任せるより、費用と品質の釣り合いを取りやすいからです。Neon と Opus 5.5 も、どちらか1つに決めるより、仕事で分けるのが現実的です。
Opus 5.5 を選ぶ場面
- Claude Code で開発している:既定のモデルで、設定やスキルをそのまま使える。端末の作業の点数は Google の表で Neon をわずかに上回る(第三者の計測では Neon が上で、ほぼ互角)
- 1回で長い出力が要る:出力の上限が 128K。長い仕様書や大きなファイルを1回で書かせる仕事
- AWS や Microsoft の契約の中で使う:Bedrock・Foundry に ID があり、社内の手続きが増えにくい
- 回数より1回の確かさを取りたい:effort を xhigh・max まで上げられ、上げた分だけ点数が伸びる
Neon を選ぶ場面
- 数十万トークンの資料を一度に読ませる:Google の表の長文の検査で差が最も大きい
- 回数の多い調べもの・業務の自動化:1つの仕事あたりの費用が Opus 5.5 の半分前後という第三者の計測がある
- 動画や音声も材料にしたい:Gemini API のモデルのページで、入力に文字・画像・動画・音声・PDF を受け付けると書かれている
- Google AI Pro の契約がある:アプリと Antigravity で追加の契約なしに選べる
迷ったら、Neon の既定と Opus 5.5 の high 以上で比べる
自分の仕事で比べるときは、段をそろえるのが大事です。Neon の既定の high と、Opus 5.5 の既定の medium で比べると、Opus 5.5 を一段低い状態で評価してしまいます。第三者の総合の点数で近いのは、Neon の high(60)と Opus 5.5 の max(59)です。費用まで含めて比べるなら、この組み合わせから始めると判断を誤りにくくなります。
乗り換えるときに直すところ
Opus 5.5 から Neon へ、またはその逆へ API で乗り換えるときは、モデル名だけでなく、考える段の指定の書き方が変わります。
- 段の指定の場所が違う:Opus 5.5 は
output_config.effort、Neon はthinking_level(REST ではthinkingConfig.thinkingLevel) - 段の名前が違う:Opus 5.5 の max は Neon に無い。Neon の上限は xhigh
- 出力の上限が違う:Opus 5.5 で 65,536 を超える出力を前提にしていた仕事は、Neon では分けるか、長い出力の方式を使う
- 単価に思考のトークンが入る:Neon の出力の単価は思考のトークンを含む。費用の見積もりは出力の量だけで出さない
Neon の段の選び方は、別の記事で詳しく扱っています。
よくある質問
Gemini 4 Neon は Opus 5.5 より賢いのですか?
総合の点数では、Google の表でも第三者の Artificial Analysis でも Neon がわずかに上です(61対59)。ただしコーディングの2つの検査では Opus 5.5 が上回っており、どの仕事でも上という関係ではありません。差がはっきりしているのは、長い文脈と費用です。
Claude Code で Neon は使えますか?
Claude Code は Anthropic のモデルを使う道具なので、Neon を選ぶ道具としては Google の Antigravity か、両方を選べる GitHub Copilot が現実的です。Neon をコーディングの道具で使う方法は、別の記事にまとめています。
Opus 5.5 の上の Fable 5.2 と比べるべきでは?
Fable 5.2 は Anthropic のいちばん上のモデルで、単価は $8/$40 と Neon の2倍以上です。Google が表で並べたのも Opus 5.5 でした。費用を抑えて主力の仕事を回すモデルを選ぶなら、Neon の比べる相手は Opus 5.5 です。Opus 5.5 と Fable 5.2 の選び方は別の記事にあります。
Claude Fable 5.2 vs Opus 5.5の選び方
まとめ
Gemini 4 Neon と Claude Opus 5.5 は、各社の主力の段にあるモデル同士で、コーディングの力は1ポイント前後の差で並んでいます。Claude Code で長く回す開発・長い出力・AWS や Microsoft の契約の中で使う仕事は Opus 5.5、数十万トークンの資料を読む仕事・回数の多い自動化・費用を抑えたい仕事は Neon、と分けるのが、2026年11月21日時点の数字から言える使い分けです。
比べるときは、Neon の既定が high、Opus 5.5 の既定が medium であることを忘れずに、段をそろえて自分の仕事で試してください。株式会社Fyveは、こうしたモデルの選び方を含めて、中小企業の AI 活用を月額で伴走支援しています。
御社の業務に合わせた Gemini の導入支援
Gemini の導入の相談から社員研修、月額での伴走まで支援します。
まずは初回の無料相談で、今の業務とお困りごとを伺います。