Gemini 4 Neon thinking levelの選び方

「Gemini 4 Neon の thinking level は low・medium・high・xhigh のどれにすればいいのか」「Argon では medium だったのに、Neon では何を指定すればいいのか」——Neon を API や開発ツールに組み込むとき、最初に手が止まるのがこの設定です。
結論から言うと、Gemini 4 Neon の thinking level は既定の high から始め、品質が足りれば medium・low へ下げ、high で解けない仕事にだけ xhigh を使います。Google も「モデルを替える前に、まず段を調整する」とすすめています。注意したいのは、API の既定は high でも、Antigravity の既定は Medium で、同じ Neon でも入口によって考える量が違うことです。
株式会社Fyveは、中小企業の AI 活用を支援する立場で、複数社の AI モデルを社内の自動化と開発に使い分けています。この記事では、2026年11月18日に発表された Gemini 4 Neon の thinking level について、公式のドキュメントと、私たちが手元の Gemini API で確かめた結果(無料の鍵でも段の書き方を検証できる方法を含む)をまとめます。
Gemini 4 Neon の thinking level とは|4段と既定の high
thinking level は、モデルが答える前にどれだけ考えるかを決める設定です。Gemini のモデルは答えの前に内部で推論し、その量で品質・待ち時間・トークンの使用量が変わります。Gemini API のドキュメントは、thinking level を「Neon の品質・待ち時間・トークン使用量を調整する主な手段」と位置づけています。
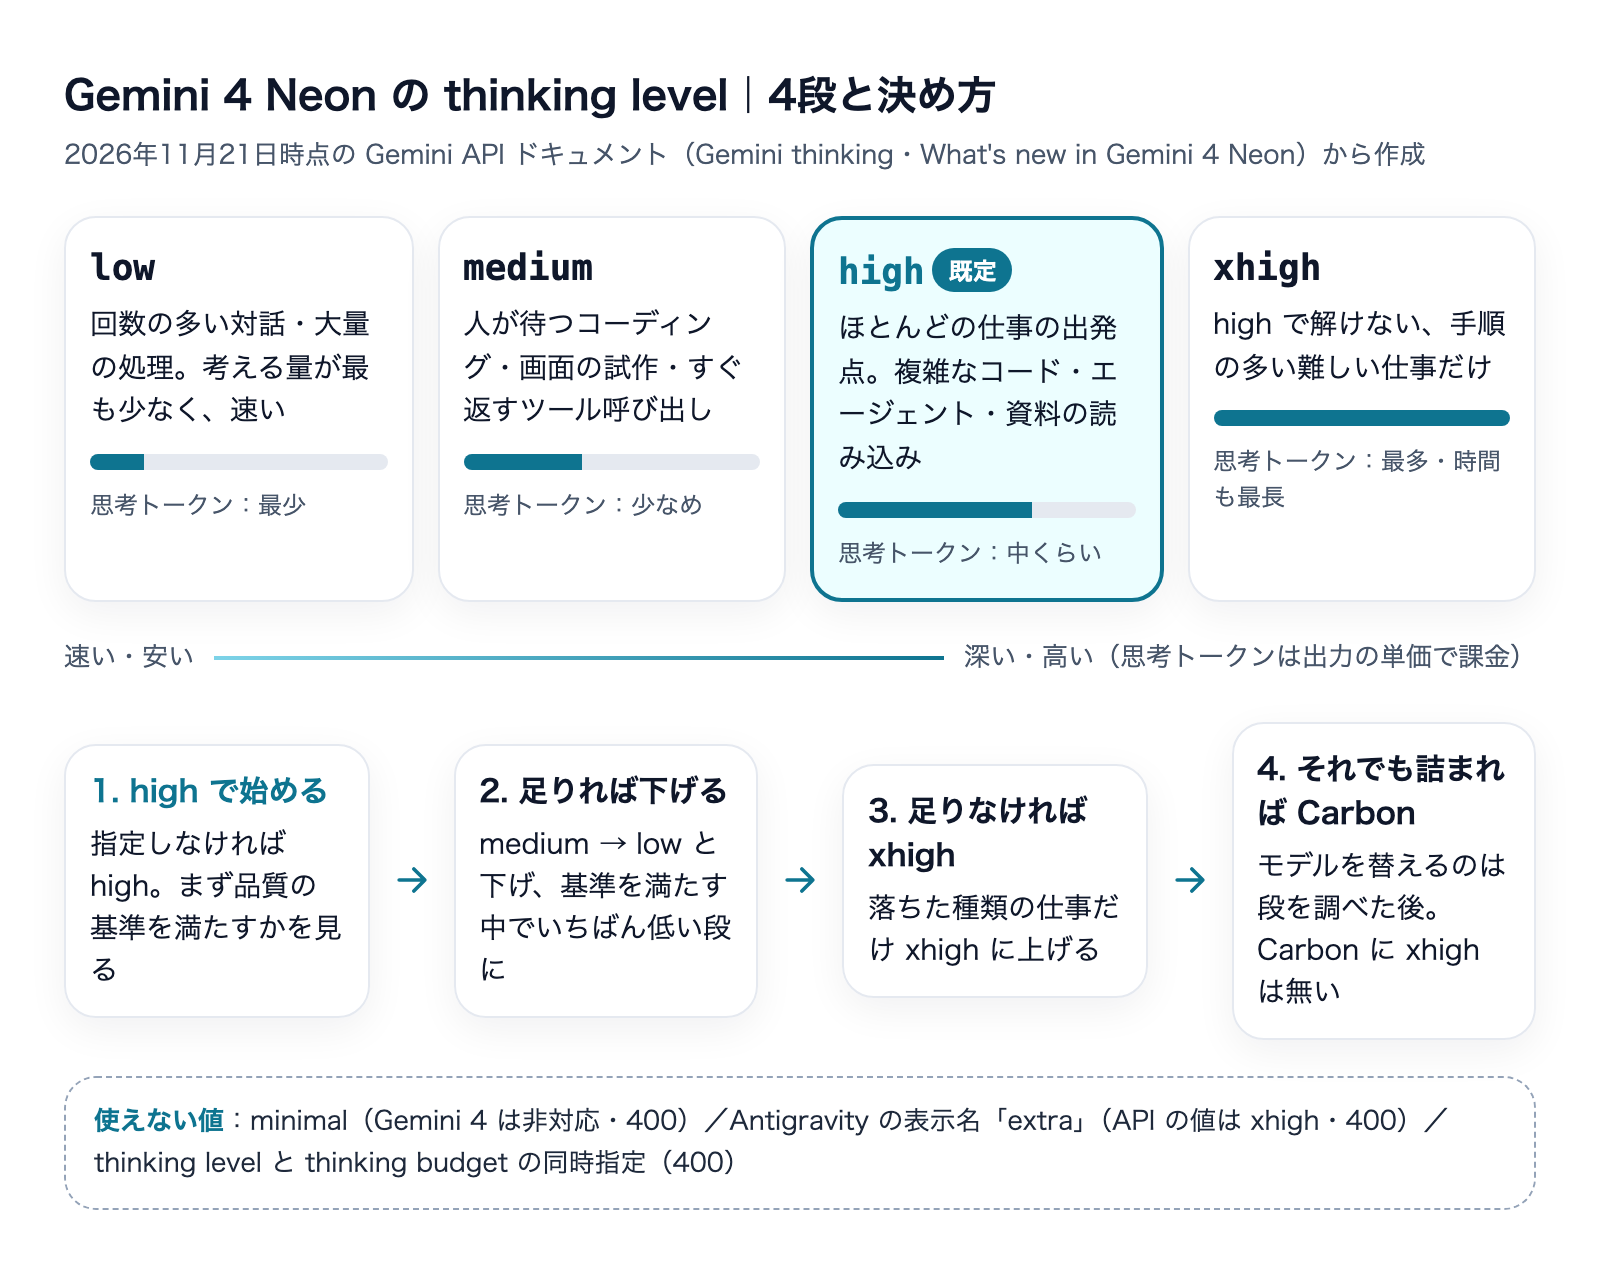
Gemini 4 Neon が対応している段は low・medium・high・xhigh の4つで、指定しなければ high で動きます。公式の説明(2026年11月21日時点の Gemini thinking と What's new in Gemini 4 Neon)を、日本語でまとめると次のとおりです。
段 | トークンの使い方 | 向く仕事(公式の説明) |
|---|---|---|
low | 最も少ない・最も速い | 費用と速さを優先する仕事。速い対話、大量の処理。エージェントの仕事もこなせる |
medium | 少なめ・応答が速い | 人が待つコーディング、画面の試作、すぐ返す対話、待ち時間が気になるツール呼び出し |
high(既定) | 知能と速さの釣り合い | ほとんどの仕事の推奨の既定。複雑なコーディング、エージェントの実行、ツール呼び出し、画像や資料を含む知識の仕事 |
xhigh | 最も多い・最も深い推論 | high で足りない、手順の多い難しいエンジニアリング・分析・科学の問題。待ち時間とトークンが増えてもよいときだけ |
Gemini 3 世代の一部で使えた minimal は、Gemini 4 のモデルでは使えません。ドキュメントには「minimal を送るとエラーで拒否される」と書かれており、私たちの手元でも 400 のエラーになりました(後の節で詳しく書きます)。いちばん浅い段は low です。
段の決め方|high から始めて、下げるか xhigh に上げる
Google の Choosing a model のページには、「大きいモデルや小さいモデルに切り替える前に、thinking level を調整する」と書かれています。モデルを替えると、単価・速さ・使える段が一度に変わります。段だけを動かせば、同じモデルのまま費用と品質の釣り合いを探せます。
ドキュメントが示す手順は、出力の上限(max_output_tokens)を 65,536 以上にしたうえで、対応するすべての段で評価し、品質の基準を満たす中でいちばん低い段を選ぶ、というものです。これを Neon に当てはめると、次の順になります。
- high で始める:指定しなければ high です。まず、今の仕事で品質の基準を満たすかを見ます
- 足りれば下げる:medium、low の順に下げ、基準を満たす中でいちばん低い段にします。費用も待ち時間も減ります
- 足りなければ xhigh:high で落ちた種類の仕事だけを xhigh にします。最初から xhigh を既定にはしません
- それでも詰まれば Carbon:Choosing a model には「Neon の high や xhigh で詰まったら Carbon に上げる」と書かれています
反対に、Neon の low でも遅い・高いと感じる仕事は、速いモデルの Hydrogen に任せる選択肢があります。Neon と Carbon の使い分けは、こちらで詳しく比べています。
low|回数が多く、答えの形が決まっている仕事
問い合わせの振り分け、短い要約、決まった項目の抜き出しのように、1回あたりの考える量が少なくてよい仕事に向きます。公式は「エージェントの仕事もこなせる」と書いており、low でもツールを呼ぶ仕事が回らないわけではありません。まず low で流し、落ちる件だけを見直す使い方ができます。
medium|人が待っている対話とツール呼び出し
開発者が画面の前で返事を待つコーディングや、画面の試作に向く段です。Choosing a model でも、Neon と Hydrogen の medium は「対話しながらのコーディングと画面の試作に合う」と説明されています。Antigravity の既定もこの medium です。
high|迷ったらここ(既定)
複数のファイルにまたがる修正、リポジトリ全体の不具合探し、資料を読み込んでの分析など、Neon が得意とする仕事の多くは high が出発点です。Google の発表では、既定の high の Neon は、Carbon より1つの仕事あたりの費用が32%低いとされています。
xhigh|high で解けない仕事にだけ
Google は xhigh を「high で足りない、難しい手順の多い問題のために取っておく」よう書いています。xhigh は待ち時間とトークンが増え、テキストや JSON の抜き出しのような簡単な仕事では考えすぎたり、出力の上限を使い切ったりすることがある、という注意もあります。
既定の段は入口によって違う|API は high、Antigravity は Medium
Neon で最初に押さえておきたいのは、「既定は high」が Gemini API の話だという点です。入口ごとの既定と、段の書き方は次のとおりです(2026年11月21日時点の各公式ドキュメント)。
入口 | 既定の段 | 段の書き方 |
|---|---|---|
Gemini API(Interactions API) | high |
|
Gemini API(generateContent) | high |
|
Gemini Enterprise Agent Platform(Google Cloud) | HIGH | 手引きの例は大文字の LOW・MEDIUM・HIGH・XHIGH |
Google Antigravity(アプリ・拡張) | Medium | モデルの選択欄で Low・Medium・High・Extra |
Antigravity CLI | medium |
|
Antigravity では、Neon は新しい会話の既定のモデルになっています(まだモデルを選んでいない場合)。そのため「Antigravity で試した Neon」と「API で呼んだ Neon」は、何も指定しなければ別の段で動いています。Antigravity で良かった結果を API で再現したいとき、またはその逆のときは、段をそろえてから比べてください。
Antigravity での選び方と、Orchestrator(Neon が計画し Hydrogen が実行する組み合わせ)の設定は、こちらにまとめています。
なお、Gemini アプリについては、今回読んだ公式の発表とドキュメントに、段を選ぶ設定の案内はありませんでした。アプリで選べるのは「Deeper analysis」の欄としての Neon です。
Argon・Carbon から乗り換えるときの段
Gemini 4 の4つのモデルは、既定の段と対応する段がそろっていません。乗り換えでいちばん間違えやすいのはここです。
モデル | 既定 | 対応する段 |
|---|---|---|
gemini-4-neon | high | low・medium・high・xhigh |
gemini-4-hydrogen | high | low・medium・high・xhigh |
gemini-4-carbon | medium | low・medium・high |
gemini-4-argon | medium | low・medium・high |
Argon から Neon へ:Gemini アプリでは Neon が Argon の欄を置き換えました。API で Argon を使っていたコードのモデル名だけを gemini-4-neon に書き換えると、段を指定していなければ medium から high に上がります。考える量が増える方向に動きます。移行ガイドも「Neon の既定は high。違う動きにしたいときは thinking_level を指定する」と書いているので、medium と high の両方を自分の評価で試してから決めるのが安全です。段を明示して書いておけば、乗り換えで何が変わったかを後で追えます。
Neon から Carbon へ:Neon の xhigh で詰まって Carbon に上げるとき、段をそのままにすると失敗します。Carbon と Argon は xhigh に対応しておらず、手元では「Thinking level XHIGH is not supported for this model」の 400 が返りました。Carbon に上げるときは段を high に直します。Carbon では high がいちばん深い段です。
Gemini 3 から Neon へ:minimal を使っていた設定は 400 になるので low に直します。また、移行ガイドは temperature・top_p・top_k を外すよう書いています。thinking level とは別の設定ですが、同じタイミングで直すことが多い所です。
API での thinking level の指定方法
Interactions API で指定する
Google のドキュメントの例は、Interactions API の generation_config に thinking_level を書く形です。REST では次のようになります。
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "この関数の競合状態を調べて、ロックの取り方を書き直してください。",
    "generation_config": {
      "thinking_level": "xhigh"
    }
}'考えた内容の要約を受け取りたいときは、generation_config に "thinking_summaries": "auto" を足します。返ってくるのは要約ですが、課金は要約ではなく、実際に考えたすべての思考トークンに対してかかります。
generateContent で指定する
generateContent では、generationConfig の中の thinkingConfig に thinkingLevel を書きます。Google Cloud の Neon の手引きの例は大文字の "HIGH" ですが、私たちの確認では小文字の xhigh と大文字の XHIGH のどちらも受け付けられました。
"generationConfig": {
  "thinkingConfig": {
    "thinkingLevel": "high"
  }
}
thinking budget は使わない
古いモデルでは、考える量をトークン数で指定する thinking budget がありました。Gemini 4 のドキュメントが案内しているのは thinking level だけです。両方を同時に入れると、「You can only set only one of thinking budget and thinking level.」の 400 が返りました(2026年11月21日に手元で確認)。古い設定を使い回すときは、budget の行を消して level に置き換えます。
手元で確かめた結果|無料の鍵でも段の書き方は検証できる
2026年11月21日 10:30〜10:31(日本時間)に、私たちが普段使っている無料枠の Gemini API の鍵で、Neon の段の指定を1つずつ送りました。Neon は無料枠では使えないため、生成の呼び出し(generateContent)は low・medium・high・xhigh のどれでも 429(RESOURCE_EXHAUSTED、無料枠の上限が limit: 0)が返ります。
問題は、使えないはずの minimal を送っても、同じ 429 が返ったことです。無料の鍵では、段の書き方を間違えていても「枠が無い」というエラーに隠れて気づけません。Neon が使えないときの原因の切り分けは、こちらにまとめています。
そこで、トークンを数えるだけの countTokens に、生成のリクエストをそのまま(generateContentRequest として)渡してみました。countTokens は無料の鍵でも通るうえ、段の指定は先に検証されます。結果は次の図のとおりです。
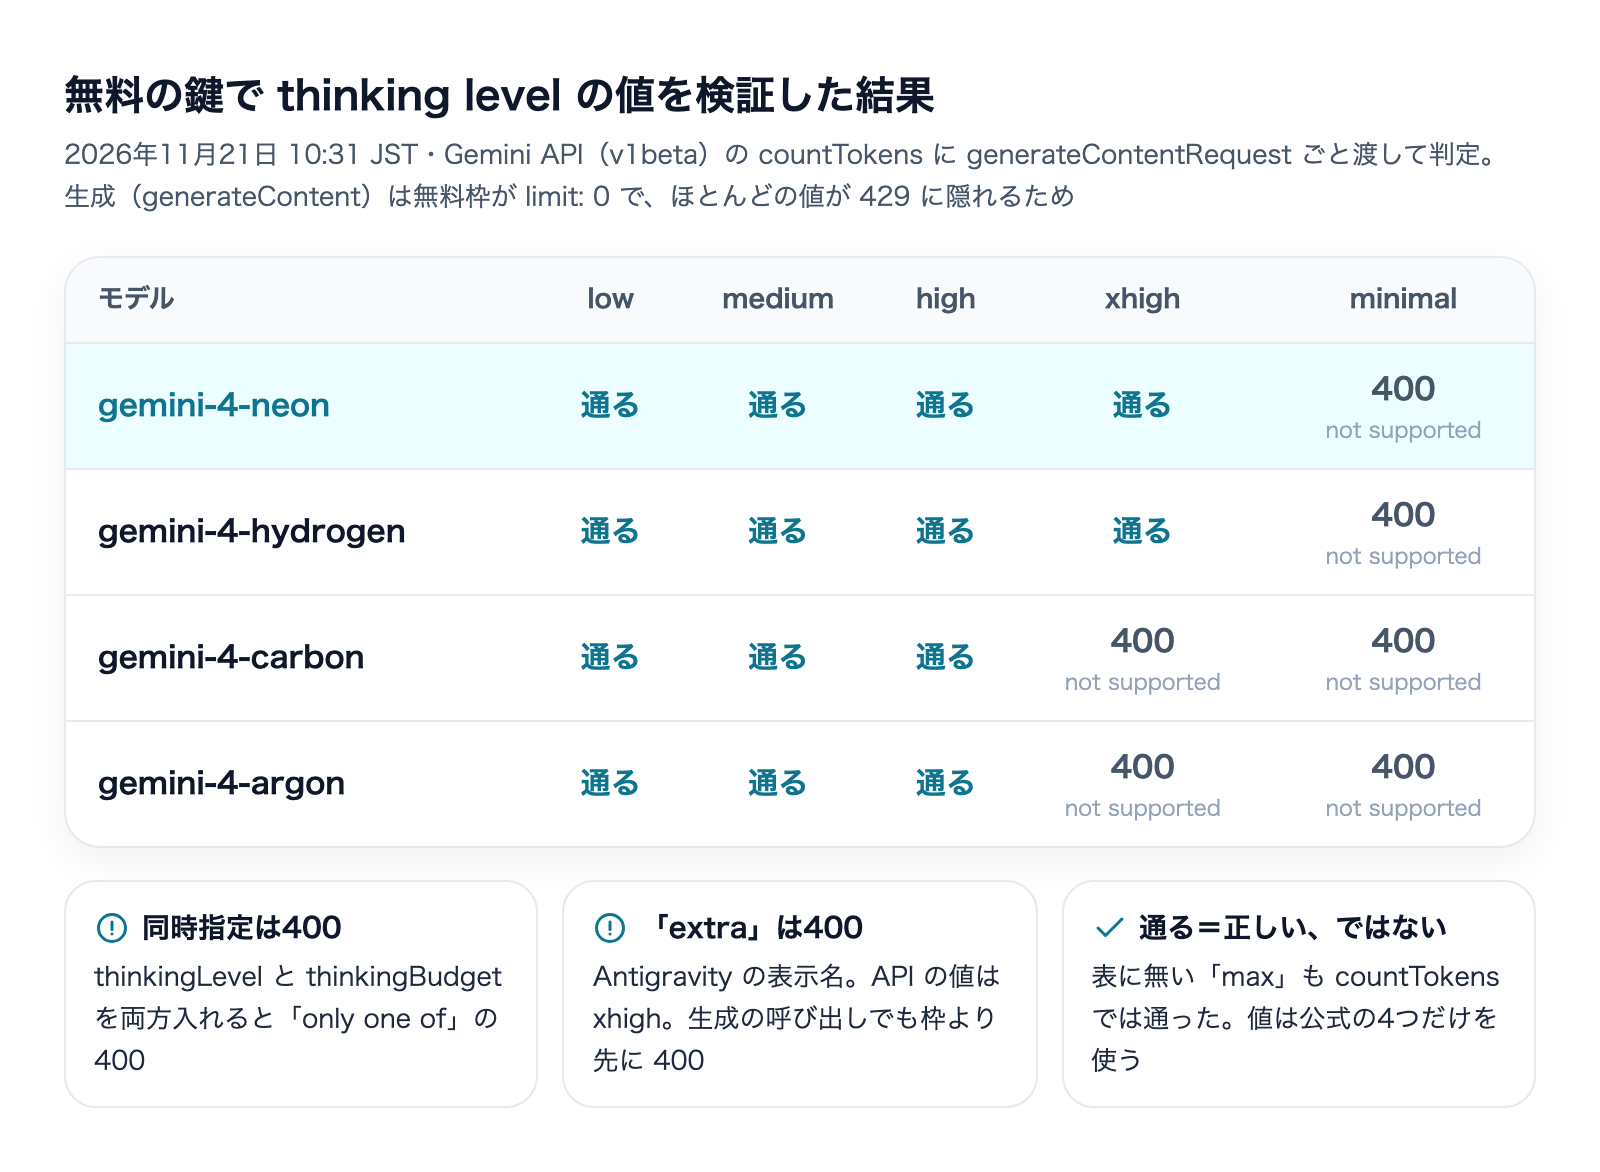
この結果から分かったことは4つです。
- Neon は low〜xhigh の4つが通り、minimal は 400:「Thinking level MINIMAL is not supported for this model」と返り、ドキュメントの表と一致しました
- Carbon と Argon は xhigh が 400:Neon から上げるときに段を直し忘れると、ここで止まります
- Antigravity の表示名「extra」は API では使えない:generateContent でも Interactions API でも、枠のエラーより先に 400 が返りました。Interactions API のエラーには、受け付ける値として minimal・low・medium・high・xhigh が並んでいました(この並びは Gemini 全体の値で、Neon が minimal に対応するという意味ではありません)
- countTokens で通る=正しい、ではない:ドキュメントの表に無い
maxも、4つのモデルすべてで countTokens を通りました。生成のときにどう扱われるかは、無料の鍵では確かめられません。段の値は公式の4つ(low・medium・high・xhigh)だけを使ってください
検証に使ったリクエストは次の形です。有料の鍵を作る前に、設定ファイルの書き方だけ先に確かめたいときに使えます。
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:countTokens" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "generateContentRequest": {
      "model": "models/gemini-4-neon",
      "contents": [{"parts": [{"text": "確認用の短い文"}]}],
      "generationConfig": {"thinkingConfig": {"thinkingLevel": "xhigh"}}
    }
  }'
一方で、段ごとに思考トークンがどれだけ増えるか、答えの質がどう変わるかは、Neon では有料の枠でないと測れません。私たちは今回この部分を測れていません。同じ4段を持つ Hydrogen で、段ごとの思考トークンと時間を測った結果はこちらにあります(xhigh だけが思考トークン・時間ともにはっきり増えました)。
thinking level と費用|思考トークンは出力の単価で数える
段が費用に効くのは、思考トークンが出力トークンと同じ単価で課金されるからです。Gemini 4 Neon の出力の単価は、思考トークンを含めて100万トークンあたり $15.00 です(2026年11月21日時点・Gemini API の有料枠の標準価格)。思考トークンが1回あたり1万トークン増えると、それだけで1回 $0.15、1,000回で $150 増える計算になります。料金は変わることがあるので、使う前に公式の料金ページで確かめてください。
Google の発表には、段ごとの費用について次の記述があります。
- 既定の high では、Carbon より1つの仕事あたりの費用が32%低い
- Vals Index と Agent Arena の high で、競合する上位モデルより1つの仕事あたり約50〜80%低い費用
- xhigh は最も高い知能のスコアを出し、それでも競合モデルの最上位の設定より1つの仕事あたり36%以上低い
ベンチマークの数字を読むときも段に注意が要ります。Artificial Analysis Intelligence Index の 61(総合3位)は、xhigh で測った値です。既定の high で同じ結果になるとは限りません。
出力の上限を絞って費用を抑えない
max_output_tokens は、思考トークンと答えのトークンを合わせた上限です。考えている途中で上限に達すると、状態が「incomplete」になり、答えが切れるか空のまま返ります。そこまでに考えた分の思考トークンは課金されます。
Google は「費用や待ち時間を減らしたいなら、max_output_tokens を小さくするのではなく、段を low や medium に下げる」よう書いています。移行ガイドも、8,192 のような低い上限を書いたままのアプリは、上限を外すか 65,536 に上げるよう案内しています。上限で答えが切れる仕組みは、こちらで説明しています。
thinking level でつまずきやすい所
ドキュメントと手元の結果から、Neon の段の設定でつまずきやすい所を5つ挙げます。
- minimal を指定している:Gemini 3 の Flash 向けの設定を使い回すと起きます。low に直します。無料の鍵では 429 に隠れるので、countTokens で確かめます
- Antigravity の「Extra」をそのまま API に書く:API の値は xhigh です。
extraは 400 になります - Carbon に上げたのに xhigh のまま:Carbon は high までです。400 が返ったら段を high にします
- thinking budget と level を両方書いている:同時指定は 400 です。level だけにします
- Antigravity と API で段がそろっていない:既定が Medium と high で違います。結果を比べる前に、どちらも段を明示します
私たちの段の選び方
私たちは社内で、無人で動く定型の仕事と、人が手元で使う開発ツールの両方で AI モデルを使っています。どちらでも決めているのは、モデルと推論の強さを必ず書いておき、提供元の既定に任せないことです。たとえば、夜間に自動で動く仕事は、起動するスクリプトの中でモデルを明示し、マシンの既定に頼らない決まりにしています。開発に使う Claude Code の推論の強さ(effort)は当面 high で運用し、いちばん上の段は利用枠を見て使うかを決めています。
この決まりを作ったのは、既定が知らないうちに変わると、費用や待ち時間の変化の理由を後から追えなくなるからです。Neon はまさにその例で、Argon の medium から high に既定が上がり、しかも Antigravity では Medium と、入口によって既定が違います。
Neon の段に当てはめると、私たちは次の順で決めるのがよいと考えています。
- 仕事を3つに分ける:形の決まった大量の仕事(振り分け・要約・抜き出し)/人が待つ対話やツールの1手/中身を考えさせる仕事(コード・調べもの・エージェント)
- 最初の段を決める:大量の仕事は low、対話は medium、考えさせる仕事は high から始める
- xhigh は「high で失敗した仕事」にだけ足す:xhigh でも失敗するなら、段ではなくモデルを Carbon に替える
大量の仕事だけなら、Neon の low よりも、単価が半分の Hydrogen のほうが合うことも多いはずです。Neon を選ぶ理由は「Hydrogen では浅いが、Carbon ほどは要らない」仕事にあるので、Neon の中では high を中心に置き、上下に1段ずつ動かすのが自然な使い方です。
自分の仕事で段を決める手順
Google のおすすめは「上限を大きくして全部の段で評価し、基準を満たすいちばん低い段を選ぶ」です。私たちは次の手順で数をそろえて比べることをおすすめします。
- 実際の仕事から10〜20件を選ぶ:うまくいった例だけでなく、前のモデル(Argon など)で失敗した例も入れる
- 合格の基準を先に決める:「分類が正しい」「表の数字が元の資料と合う」など、見れば判定できる形にする
- 段の書き方を countTokens で先に確かめる:設定の誤りで評価が全部失敗する、という無駄を避ける
- max_output_tokens を 65,536 以上にして、low・medium・high で流す:上限で切れた失敗を混ぜないため
- 合格した件数・思考トークン・時間を並べる:Interactions API なら
total_thought_tokensを記録しておく - high でも落ちる件だけを xhigh で流す:xhigh で直るなら、その種類の仕事だけ xhigh にする。直らなければ Carbon を試す
20件を4段で流すと80回の呼び出しです。Neon は有料の枠でしか動かないので、評価は Batch API や Flex を使うと安く済みます。Google の Choosing a model には、どちらもトークンの費用が50%下がり、急がない評価やデータの処理に向くと書かれています。
Gemini 4 Neon の thinking level のよくある質問
thinking level を指定しないと、どの段で動きますか?
Gemini API では high で動きます。Antigravity では Medium が既定です。Carbon・Argon は API でも既定が medium なので、そこから乗り換えると段が上がります。
xhigh にすれば答えは必ず良くなりますか?
なりません。Google は、テキストや JSON の抜き出しのような簡単な仕事では、xhigh が考えすぎたり、出力の上限を使い切ったりすることがあると注意しています。xhigh は high で足りない仕事に限って使います。
Antigravity の「Extra」と API の xhigh は同じですか?
Antigravity のドキュメントでは、選択欄の Extra は xhigh の推論の深さに当たり、CLI では xhigh と書くと説明されています。ただし API に extra と書くと 400 になるので、API では xhigh と書きます。
無料枠で段の違いを試せますか?
試せません。Neon は Gemini API の無料枠では使えず、生成の呼び出しは段にかかわらず 429 になります。無料の鍵でできるのは、countTokens で段の書き方が受け付けられるかを確かめるところまでです。
段によって料金の単価は変わりますか?
単価は変わりません。変わるのは1回あたりの思考トークンの量で、思考トークンは出力と同じ単価(2026年11月21日時点で100万トークンあたり $15.00)で数えられます。段を上げると、同じ単価のまま使うトークンが増えます。
まとめ|Neon は high を中心に、上下に1段ずつ動かす
- Gemini 4 Neon の thinking level は low・medium・high・xhigh の4段。API の既定は high、Antigravity の既定は Medium
- 決め方は、high で始め、足りれば下げ、足りない仕事にだけ xhigh。xhigh でも詰まれば Carbon(Carbon は high まで)
- minimal・
extra・budget との同時指定は 400。無料の鍵では生成の呼び出しが 429 に隠れるので、countTokens で書き方を確かめる - 思考トークンは出力の単価で課金される。費用を抑えるなら、出力の上限ではなく段を下げる
株式会社Fyveでは、モデルと設定を仕事ごとに書いておき、提供元の既定が変わっても理由を追える形で AI を運用しています。Neon の段も、まず既定を明示するところから始めてみてください。
御社の業務に合わせた Gemini の導入支援
Gemini の導入の相談から社員研修、月額での伴走まで支援します。
まずは初回の無料相談で、今の業務とお困りごとを伺います。