Gemini 4 Neonの性能|ベンチマークの数値と読み方

「Gemini 4 Neon の性能は、実際どのくらいなのか」「Google の表では Claude Opus 5.5 や GPT-6.2 Sol に勝っている行ばかりだけれど、そのまま信じていいのか」——11月18日に Neon が出て、数字の表を前にこう迷っている人は多いはずです。
結論から言うと、Gemini 4 Neon の公式ベンチマークは19行のうち16行で3社の中で最も高く、Opus 5.5 に負けたのはコーディングの2行、GPT-6.2 Sol に負けたのは図表を読む1行だけです。ただし Neon の数字は原則いちばん高い thinking の段(xhigh)で測った値で、他社の数字は各社の自己申告です。第三者の計測を段ごとに見ると、既定の high と xhigh の差は総合の点数で1点しかなく、1つの仕事あたりの費用は約1.7倍になります。性能を読むときは、どの段の数字かを先に確かめる必要があります。
株式会社Fyveは、中小企業の AI 活用を月額で伴走支援しながら、社内の定期の仕事でも複数社の AI を仕事ごとに分けて毎日動かしています。この記事では、Google が2026年11月18日に公開した比較表と評価方法の資料、第三者の Artificial Analysis が段ごとに測った数字、報道を突き合わせ、Gemini 4 Neon の性能の数字と、その読み方を整理します。
Gemini 4 Neon そのものの位置づけとできることは、こちらにまとめています。
Gemini 4 Neon のベンチマーク一覧(2026年11月18日公開)
Google は Neon の発表と同じ2026年11月18日に、Neon・Claude Opus 5.5・GPT-6.2 Sol の3つを並べたベンチマークの表を公開しました(Google の発表・2026年11月18日、評価方法の資料)。表は画像で載っているので、全行を文字に起こします。太字は3つの中で最も高い値、「—」は数字の記載が無い行です。
分野 | ベンチマーク(何を測るか) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|---|
総合 | AA Index v5.0.1(Artificial Analysis の総合の点数) | 61 | 59 | 57 |
総合 | Vals Index v2.2(Vals AI の総合の点数) | 70.9% | 70.1% | 66.1% |
コーディング | CursorBench 4.1(Cursor での開発) | 65.4% | 58.1% | — |
コーディング | Terminal-bench 4.1(端末でコマンドを動かして仕事を終わらせる) | 65.2% | 65.8% | 61.5% |
コーディング | FrontierCode 2.0(難しいコーディング) | 46.2% | 47.3% | 43.8% |
コーディング | SWE-sweep(各社の道具で動かした場合) | 39.0% | 10.1% | 8.3% |
コーディング | SWE-sweep(同じ小さな道具で動かした場合) | 12.8% | 3.6% | 11.6% |
事務の仕事 | AutomationBench(業務の自動化) | 56.3% | 42.5% | 41.3% |
事務の仕事 | Agents' Last Exam v1.1(エージェントの実務の課題) | 75.8% | 71.6% | 73.0% |
科学・数学 | RiemannBench(数学) | 84.0% | 80.0% | 80.0% |
科学・数学 | Terminal-Bench-Science 0.1(端末での科学の研究作業) | 70.5% | 63.3% | 68.0% |
推論 | HLE-Diamond(専門家級の難問) | 71.3% | 67.9% | 64.0% |
画像・動画を読む | MKA(画像や資料を使って調べる) | 56.5% | 53.0% | 52.7% |
画像・動画を読む | Chartography(込み入った図表を読む) | 73.5% | 66.3% | 75.1% |
画像・動画を読む | LVBench(長い動画を読む) | 89.0% | 83.7% | 87.6% |
長い文脈 | GraphWalks(25.6万〜100万トークンの中で関係をたどる) | 95.2% | 66.8% | 80.1% |
セキュリティ | CWE-Bench v2(脆弱性を直す) | 70.7% | 67.1% | 66.0% |
セキュリティ | SEC-bench Pro(脆弱性を見つける) | 90.5% | — | 88.3% |
セキュリティ | WebExploitBench v1.2(Web アプリの侵入テスト) | 51.3% | 37.1% | — |
表の外でも、Google は発表の本文で次の数字を挙げています。Artificial Analysis の Coding Agent Index で58.6(1位)、Zapier の AutomationBench と Andon Labs の Vending-Bench 2(事業の運営を長く続ける模擬の検査・$16,843)でともに1位、Arena の新しい Agent Arena Index で1336(2位)、Web の裏側のコードを安全に書けるかを見る AutoBaxBench の難しい区分で76%です。
数字だけを見ると「ほとんどの行で勝っている」モデルです。ただ、この表は条件がそろった比べ方ではありません。次の3つを押さえてから読む必要があります。
Gemini 4 Neon のベンチマークを読む前に押さえる3つの条件
条件1:Neon の数字は原則「いちばん高い thinking の段」で取っている
評価方法の資料には「特に断りが無い限り、すべて Gemini API の最も高い thinking の設定で測った」と書かれています。Neon の thinking level は low・medium・high・xhigh の4段で、既定は high です。つまり表の多くの行は、何も設定しないで使ったときより1段上の xhigh の値です。
例外として明記されているのは FrontierCode 2.0 で、Neon の 46.2% は既定の high の値です。ほかに、Terminal-bench 4.1 の Neon の値は Artificial Analysis が Antigravity CLI(1.5.9)で測ったもの、Agents' Last Exam は Google が Antigravity CLI(1.4.8)で5時間の枠で測ったもの、と測り方が行ごとに書き分けられています。
条件2:他社の数字は、各社の自己申告と公開のランキングから引いている
資料によると、Gemini 以外の数字は特に断りが無い限り各社が自分で公表した値で、Opus 5.5 と GPT-6.2 Sol は公表されている中で最も高い推論の設定の値を使っています。公表の値が無いときは「手に入る中で最もよい推論の設定」の値です。
同じ問題を同じ環境で3つのモデルに解かせた表ではない、ということです。たとえば LVBench は、API の制約から Gemini は1秒1コマ(低い解像度)、GPT-6.2 Sol は500コマ、Opus 5.5 は600コマと、動画の渡し方がモデルごとに違います。Chartography の Opus 5.5 の値は Anthropic のシステムカードから引いた値で、Neon と Sol は Google が自分で測っています。
条件3:道具(ハーネス)の違いが数字を大きく動かす行がある
いちばん差が開いて見える SWE-sweep の 39.0% 対 10.1% 対 8.3% は、Neon を Antigravity CLI、Opus 5.5 を Claude Code、GPT-6.2 Sol を Codex と、各社のコーディングの道具で動かした値です。資料には、Antigravity CLI には既定でサブエージェントをコードベース全体に広げる道具があり、バグ探しのような SWE-sweep の課題に特に向いている、と書かれています。
同じ小さな道具(mini-SWE)でそろえた行では、Neon 12.8%、Opus 5.5 3.6%、GPT-6.2 Sol 11.6% です。Neon が上なのは変わりませんが、Sol との差は 30.7 ポイントから 1.2 ポイントに縮みます。Google も発表で「Antigravity の道具で3倍以上になる」と書いており、この行はモデルの力と道具の力が混ざった数字として読むのが妥当です。
なお、セキュリティの3行は安全のための絞り込みを外して測った値です(ほかの行は絞り込みをオンにして測定)。
Gemini 4 Neon の性能が高い分野
条件を踏まえたうえで、それでも差がはっきり出ている分野を挙げます。
長い資料の中から関係をたどる(GraphWalks)
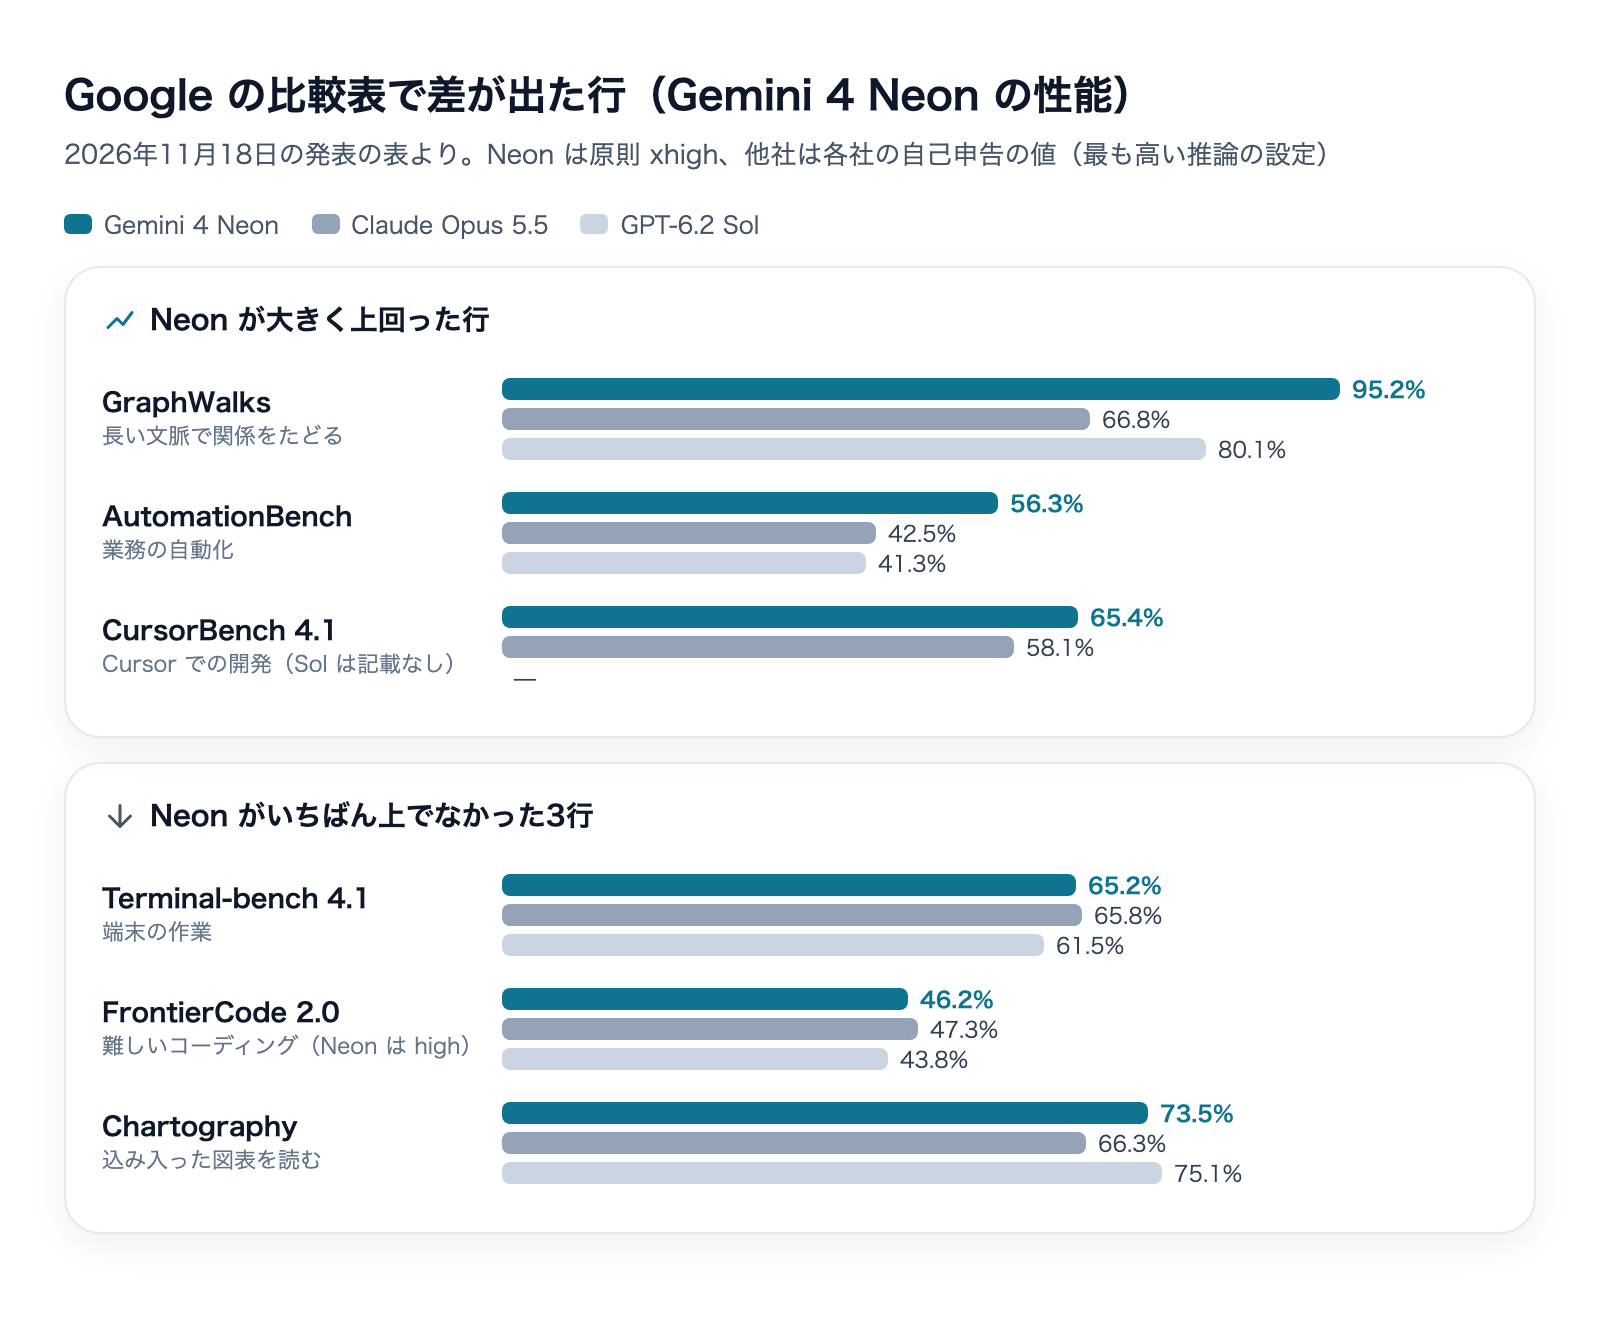
いちばん差が大きいのは長い文脈です。25.6万〜100万トークンの文脈で関係をたどる GraphWalks で、Neon は 95.2%、Opus 5.5 は 66.8%、GPT-6.2 Sol は 80.1% でした。この行は Google が200問を自分で測った値です。100万トークン前後を入れられるモデルは他にもありますが、入れられることと、入れたものの中から正しく拾えることは別で、その差がこの行に出ています。
事務の自動化と実務の課題(AutomationBench・Agents' Last Exam)
Zapier の AutomationBench は、公開のランキングから引いた値で Neon 56.3%、Opus 5.5 42.5%、Sol 41.3% と、10ポイント以上の差があります。複数の SaaS をまたいで業務を流す検査で、中小企業の事務の自動化に最も近い行の1つです。Agents' Last Exam は 75.8% 対 71.6% 対 73.0% で、差は数ポイントです。
難問の推論と科学(HLE-Diamond・Terminal-Bench-Science)
HLE-Diamond は 71.3% 対 67.9% 対 64.0%、Terminal-Bench-Science は 70.5% 対 63.3% 対 68.0% です。どちらも Neon の値は xhigh で、HLE-Diamond は Artificial Analysis のランキングの値、Terminal-Bench-Science の Neon の値は Google が5回の平均で自分で測った値です。
Gemini 4 Neon が負けている分野
表の中で Neon が最も高くなかったのは3行だけです。数は少ないものの、どれも業務の使い方に関わる行です。
端末の作業と難しいコーディング(Terminal-bench 4.1・FrontierCode 2.0)
Opus 5.5 が上回ったのは、Terminal-bench 4.1(65.8% 対 65.2%)と FrontierCode 2.0(47.3% 対 46.2%)の2行です。差は1ポイント前後で、コーディングの力はほぼ並んでいると読むのが妥当です。ただ、Claude Code で開発している人にとってはいちばん効く2行でもあります。Opus 5.5 との使い分けは、別の記事にまとめています。
込み入った図表を読む(Chartography)
Chartography では GPT-6.2 Sol が 75.1% で、Neon の 73.5% を上回りました。Google は発表の本文で Chartography の 73.5% を Neon の強みとして挙げていますが、表の中では Sol が上です。決算資料のグラフや設計図面の読み取りが仕事の中心なら、Sol と並べて試す価値があります。
第三者の計測で段ごとに見る|high と xhigh の差は1点
Google の表は xhigh の値が中心です。実際に使うときの段で性能を見るには、第三者の計測が役に立ちます。AI モデルを横並びで測っている Artificial Analysis は、Neon を4つの段それぞれで計測しています(Artificial Analysis の Neon と Carbon の比較のページ、Neon と Argon の比較のページ・いずれも2026年11月21日に確認)。
項目 | low | medium | high(既定) | xhigh |
|---|---|---|---|---|
Intelligence Index(総合の点数) | 44 | 55 | 60 | 61 |
総合の点数の計測1件あたりの費用 | $0.75 | $1.90 | $3.74 | $6.44 |
同じく1件あたりの時間 | 3.7分 | 8.3分 | 14.8分 | 21.5分 |
Terminal-Bench 4.0(端末の作業) | 32.8% | 54.5% | 61.6% | 63.6% |
FrontierCode-AA 2.0(コーディング) | 26.9% | 36.9% | 43.3% | 44.4% |
HLE-Diamond(難問の推論) | 54.2% | 63.6% | 68.4% | 71.3% |
AutomationBench-AA(業務の自動化) | 76.0% | 77.8% | 79.2% | 79.3% |
GDP.pdf(仕事の資料を読んで考える) | 31.4% | 32.8% | 33.4% | 28.0% |
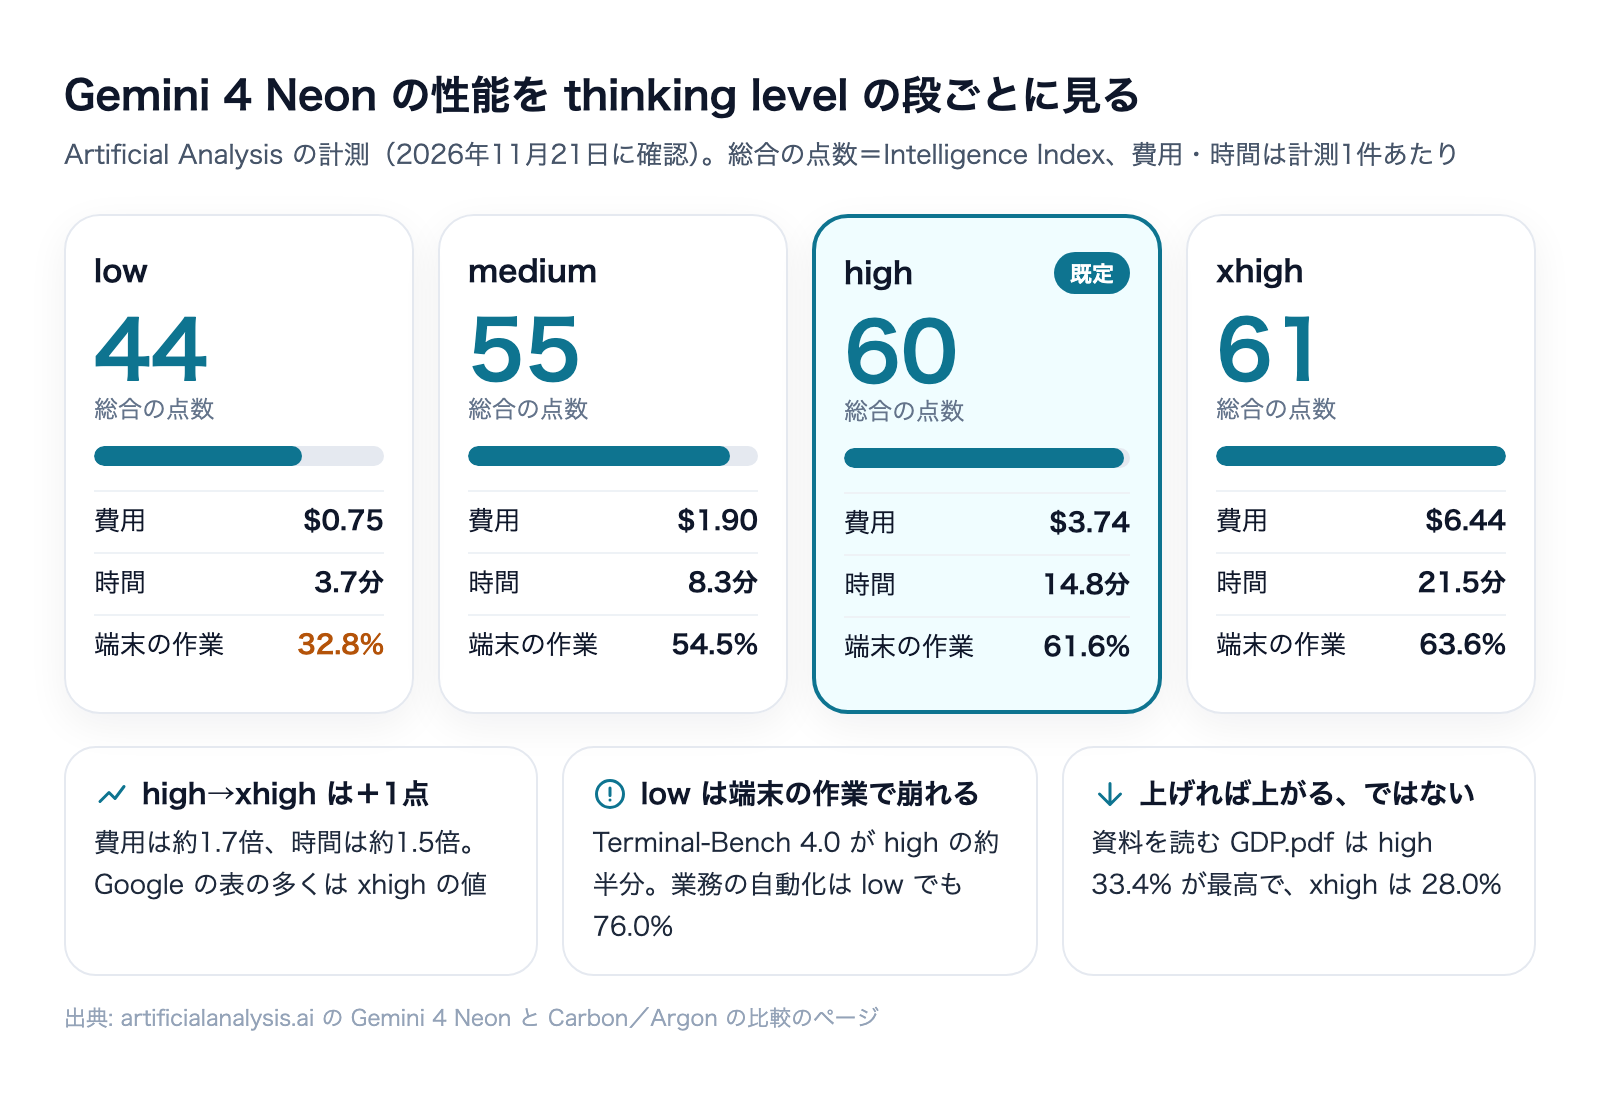
この表から読めることは3つあります。
- high から xhigh に上げても、総合の点数は60から61に1点しか上がらない。一方で1件あたりの費用は $3.74 から $6.44 へ約1.7倍、時間は14.8分から21.5分へ延びる
- low は端末の作業で崩れる。Terminal-Bench 4.0 は high の 61.6% に対して low は 32.8% と半分ほどになる。業務の自動化(AutomationBench-AA)は low でも 76.0% で、high との差は約3ポイント
- 段を上げるほど上がるとは限らない。GDP.pdf は high の 33.4% が最も高く、xhigh は 28.0% に下がっている
Google の表の数字の多くは xhigh の値なので、既定の high で使う人が実際に受け取る性能は、総合の点数で見ると1点ほど低いと考えておけば大きく外れません。一方、low まで下げると総合で16点下がり、端末で動かす仕事は特に落ちます。段の選び方は、別の記事で詳しく扱っています。
Gemini 4 の上位モデルや前の世代と比べた数字
Google の表には、同じ Gemini 4 の Carbon や、Gemini アプリで Neon に置き換えられた Argon の列はありません。Artificial Analysis の同じページから、総合の点数と1件あたりの費用だけを並べます。
モデル(段) | Intelligence Index | 1件あたりの費用 | Terminal-Bench 4.0 |
|---|---|---|---|
Gemini 4 Neon(xhigh) | 61 | $6.44 | 63.6% |
Gemini 4 Neon(high・既定) | 60 | $3.74 | 61.6% |
Gemini 4 Carbon(high・Carbon の上限) | 60 | $7.76 | 65.2% |
Gemini 4 Carbon(medium・Carbon の既定) | 58 | $6.59 | 60.6% |
Gemini 4 Argon(high) | 50 | $9.95 | 57.1% |
総合の点数では、Neon の既定の high が Carbon のいちばん上の high と同じ60です。それでも端末の作業(Terminal-Bench 4.0)は Carbon の high が 65.2% で、Neon の xhigh(63.6%)より上でした。物理の難問の CritPt でも Carbon は 69.0% で、Neon(最高で low の 62.0%)を上回っています。Google が「Neon で詰まったら Carbon に上げる」としている仕事の種類と、数字の向きは合っています。
費用については、Google は発表で「既定の high で、Carbon より1つの仕事あたり32%安い」としています。上の表の Artificial Analysis の値とは計り方が違うので、比はそろいません。Carbon との使い分けと、Argon からの乗り換えで変わる点は、それぞれ別の記事で扱います。
順位の数字は、見た日によって変わる
Neon の「総合で何位か」は、どこを見たかで違います。Google の発表と 9to5Google の報道(9to5Google・2026年11月18日)では、Artificial Analysis の Intelligence Index で「xhigh で61・総合3位」です。一方、私が11月21日に見た Artificial Analysis の Neon のページでは、同じ61で「95モデル中6位」と表示されていました。
点数は同じでも、ほかのモデルが後から計測に加わると順位は下がります。Agent Arena も、Google の発表は「1336・2位」、11月21日に見た Arena のページでは High の段で1,333・暫定の扱いでした。記事や資料に書くときは、順位より点数を、点数には確認した日付を添えるのが安全です。
手元で確かめたこと|無料枠の鍵では計測を再現できない
2026年11月21日の11時48分に、私の手元にある Gemini API の無料枠の鍵で Neon を呼びました。モデルの情報を取る呼び出し(models.get)は通り、入力の上限 1,048,576 トークン・出力の上限 65,536 トークンと返りました。短い日本語の問題文のトークン数を数える呼び出し(countTokens)も通り、74トークンでした。
一方、答えを出させる呼び出し(generateContent)は 429 RESOURCE_EXHAUSTED で止まりました。Google の料金のページにある「Neon は無料枠では使えない」という記載のとおりです。つまり、この記事の性能の数字を自分の手で再現するには、有料枠の鍵か、Neon を選べる Gemini アプリ・Antigravity が要ります。この記事の数字はすべて Google と第三者の公表値で、私が測った性能の値は入っていません。
無料枠で止まるときの原因と対処は、別の記事で扱っています。
業務で Gemini 4 Neon の性能を判断するときの使い方
私たちは社内の定期の仕事で、文章を書く仕事、回数の多い機械的な仕事、画像を作る仕事と、仕事ごとにモデルを分けて固定しています。新しいモデルが出たときにベンチマークの表で見るのは、全部の行ではありません。次の3つの順で見ています。
1. 自分の仕事に近い行だけを見る
19行すべてが自分の仕事に関係するわけではありません。資料の束を読ませる仕事なら GraphWalks、SaaS をまたぐ事務の自動化なら AutomationBench、開発なら Terminal-bench と FrontierCode、と近い行を2〜3行に絞ると、Neon を選ぶかどうかの判断がはっきりします。
2. 行ごとに「誰が、どの段で、どの道具で測ったか」を確かめる
同じ表の中に、Google が自分で測った値、公開のランキングの値、他社の自己申告が混ざっています。差が大きく見える行ほど、測り方の違いが効いていないかを評価方法の資料で確かめます。SWE-sweep の 39.0% はその典型です。
3. 自分の仕事の10件で、high から試す
第三者の計測では、high と xhigh の差は総合で1点、費用は約1.7倍でした。まず既定の high で自分の仕事を10件ほど流し、足りない仕事だけ xhigh に上げ、それでも足りなければ Carbon に上げる、という順が費用の面でも無理がありません。
Gemini 4 Neon の性能でよくある質問
Gemini 4 Neon は Carbon より性能が上ですか?
総合の点数では、Neon の xhigh(61)が Carbon の high(60)を1点上回り、Neon の既定の high は Carbon と同じ60です。ただし端末の作業や物理の難問では Carbon が上の行があり、全部で上という関係ではありません。
表の数字は、Gemini アプリで使ったときにも当てはまりますか?
表の数字は Gemini API で、多くは xhigh の段で測った値です。Gemini アプリや Antigravity では段の既定や上限が API と同じとは限らず、たとえば Antigravity の選択欄の既定は Medium です。アプリでの体感は、表の数字より低く出ることがあると考えておくのが安全です。
Opus 5.5 や GPT-6.2 のベンチマークの全体はどこで見られますか?
比較相手の側の数字は、各社の発表をもとにした別の記事にまとめています。
Claude Opus 5.5のベンチマーク結果と、その読み方
1週間前に出た Gemini 4 Hydrogen と比べるとどうですか?
Hydrogen は11月12日に出た速いモデルで、Google の表の比較相手も Claude Sonnet 5.5 と GPT-6.1 Terra と、Neon とは別の格です。Hydrogen の数字の一覧は別の記事にあります。
まとめ:Gemini 4 Neon の性能は「段をそろえて」読む
Gemini 4 Neon の公式ベンチマークは、19行のうち16行で Claude Opus 5.5 と GPT-6.2 Sol を上回り、特に長い文脈(GraphWalks 95.2%)と事務の自動化(AutomationBench 56.3%)で差が大きく開いています。負けたのは、コーディングの2行(Opus 5.5 に1ポイント前後)と、図表を読む1行(Sol に1.6ポイント)です。
ただし数字の多くは xhigh の値で、他社の数字は自己申告、SWE-sweep のように道具の違いが大きく効く行もあります。第三者の計測では、既定の high は xhigh と総合で1点しか違わず、費用は約6割で済みます。2026年11月21日時点の数字から言えるのは、まず high で自分の仕事に近い行の性能を確かめ、足りない仕事だけ段を上げるという使い方です。株式会社Fyveは、こうしたモデルの選び方を含めて、中小企業の AI 活用を月額で伴走支援しています。
御社の業務に合わせた Gemini の導入支援
Gemini の導入の相談から社員研修、月額での伴走まで支援します。
まずは初回の無料相談で、今の業務とお困りごとを伺います。