GPT-6 SolとLunaとは|Astraとの違いと選び方

2026年9月22日に公開された「GPT-6 Sol」と「GPT-6 Luna」を見て、最初に浮かぶのは「安い版が出たのか、で、うちは何か変えなきゃいけないのか」という問いだと思います。モデルが増えるたびに比較記事を読んで、結局どれも試さずに今の設定のまま、という状態は誰にでも起こります。
結論から書きます。今回いちばん重要なのは値下げではなく、同時に案内された「GPT-5.5 が2026年10月14日に ChatGPT・ChatGPT Work・Codex から引退する」という期限です。設定ファイルやスケジュール実行で gpt-5.5 を名指ししている人は、3週間以内に書き換える必要があります。単価の話はその次です。
株式会社Fyveは、AIを「試す」ではなく「毎日動かし続ける」前提で中小企業の導入を支援しています。その立場から見ると、新モデルのニュースで本当に読むべきなのは性能表ではなく、今動いている設定のどこが壊れるかです。この記事では公式ドキュメントで確認できた事実だけを使って、3モデルの違い・料金の実数・そして私たちが自分の無人運用をどう組み替えたかを順に書きます。
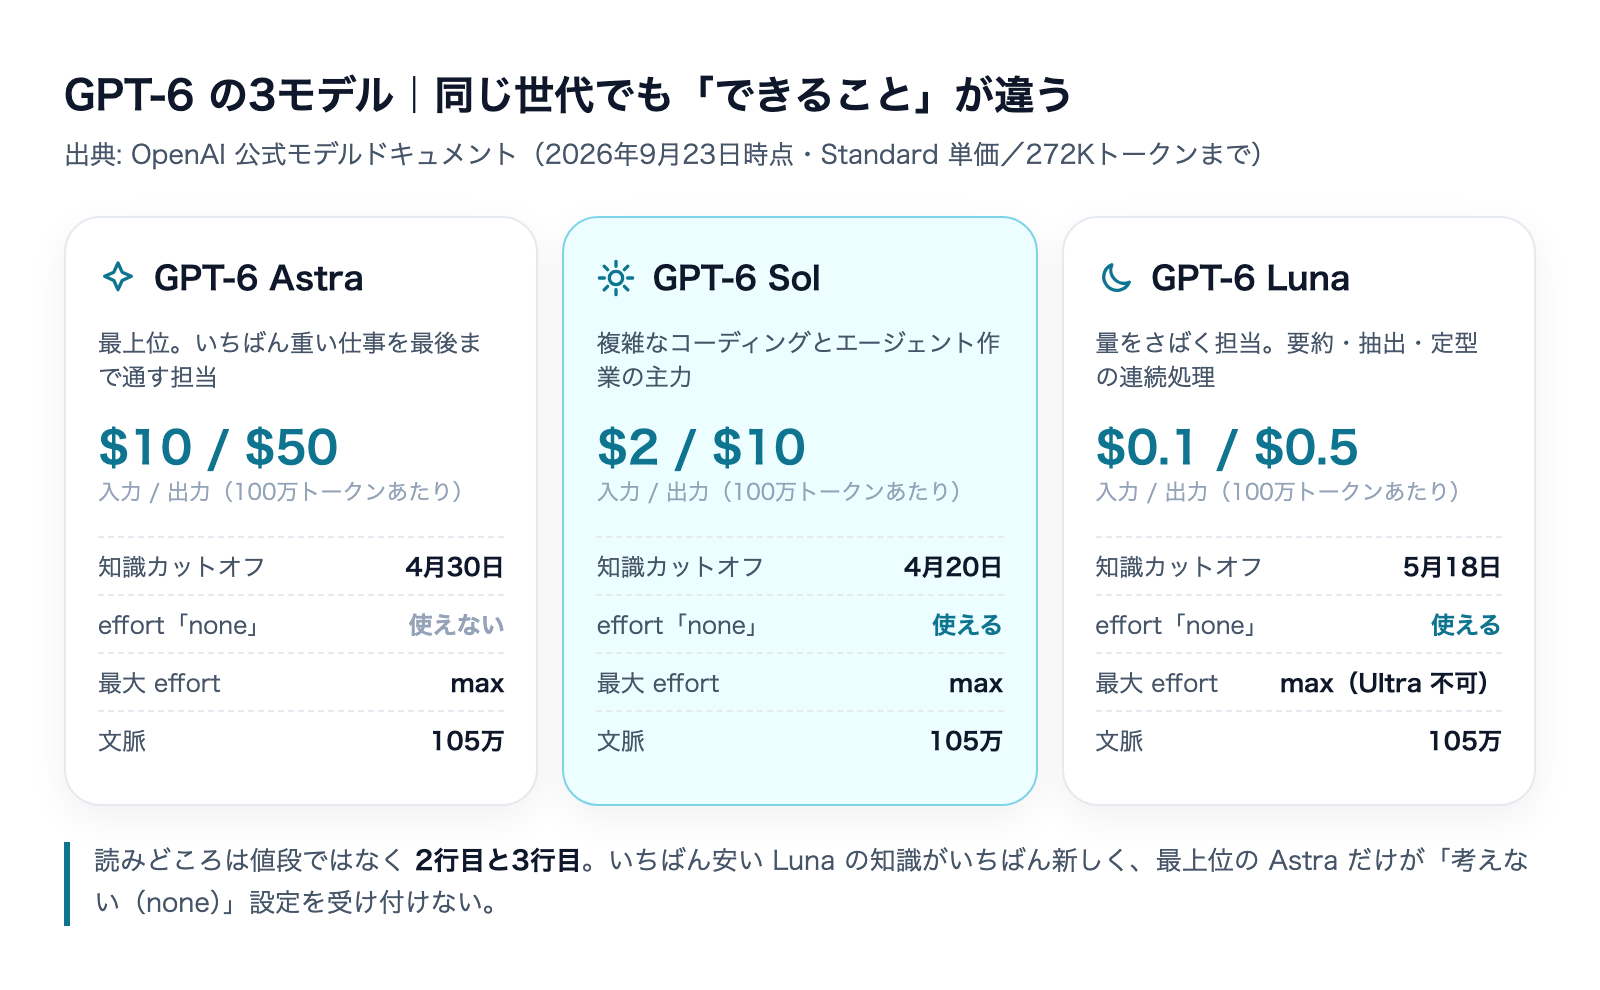
まず全体像:GPT-6 は3モデル体制になった
2026年9月3日に最上位の GPT-6 Astra が登場し、その約3週間後に下位2モデルが加わりました。これで GPT-6 世代は3階層になります。
- GPT-6 Astra — 「いちばん難しい仕事を最後まで通す」最上位モデル
- GPT-6 Sol — 「複雑なコーディングとエージェント的な作業」の主力
- GPT-6 Luna — 「焦点の定まった大量処理」向けの最も効率的なモデル
この3語の説明はいずれも公式モデルドキュメントの記述をそのまま訳したものです。名前の付き方自体は前世代から引き継がれていて、Sol・Luna という呼び分けの由来はGPT-5.6とは?Sol・Terra・Lunaの違いと選び方で整理しています。ただし世代が上がると各モデルの役割も少し動いているので、5.6 の感覚をそのまま持ち込むと判断を誤ります。
いちばん急ぐのは値下げではなく、10月14日の引退
ChatGPT と Codex 側の公式ドキュメントには、新モデルの案内と並んで次の内容が書かれています。
2026年10月14日、GPT-5.5 が ChatGPT・ChatGPT Work・Codex のすべてのプラン(一般ユーザー・Business・Enterprise・Edu を含む)から引退します。ただしこの引退は OpenAI API には適用されません。
ここが実務上いちばん効きます。ChatGPT サインインで Codex を使っている場合、10月14日より前に代替を選ぶ必要があり、公式は次のように案内しています。
プラン | 公式が案内する代替 |
|---|---|
Plus・Pro・Business・Enterprise・Edu |
|
Free・Go | デスクトップアプリで |
そして書き換える対象として公式が名指ししているのは、以下です。
- ワークスペースの既定モデル
- 保存済みのモデル設定
- 管理者が配布している構成(managed configurations)
- カスタムエージェント
- スケジュール実行しているタスク
- モデルを選択しているスクリプト
この6つのうち、目に見えないところで止まるのは後ろの3つです。画面から使っているぶんにはモデル選択欄が変わるだけで済みますが、夜間に勝手に動いているスケジュール実行やスクリプトは、誰も見ていない時間に静かに失敗します。気づくのは翌朝、あるいは数日後です。
なお、これより前に gpt-5.4 と gpt-5.4-mini が2026年8月31日に Codex(ChatGPT サインイン時)から引退済みで、その代替もそれぞれ gpt-6-sol・gpt-6-luna と案内されています。Enterprise と Edu では Luna を使うのに管理者による有効化が先に必要です。ここを知らないまま設定だけ書き換えると「書いたのに選べない」で止まります。
 無料枠でできる3つ・できない5つの線引き金額でなく「倍率」で覚えるプラン早見表週1回30秒で回る使用量の管理ルール(コピペ可)登録すると、過去の特典もまとめて受け取れます(PDF 15点・合計400ページ + すぐ使えるzip素材 3点)
「ChatGPT で使える」の中身に注意
公式ドキュメントには、見落とすと話が噛み合わなくなる一文があります。
「ChatGPT では、GPT-6 Sol と GPT-6 Luna は Work と Codex で利用できます。Chat では利用できません。」
つまり、いつもの ChatGPT の会話画面では出てきません。使えるのは業務向けの Work と、開発向けの Codex です。ニュースの見出しだけを読んで「ChatGPT で使えるようになった」と社内に共有すると、試した人が見つけられずに混乱します。共有するときは面(Work/Codex/API)まで書いてください。
提供面を公式の表記どおりに並べると次のとおりです(2026年9月23日時点)。
面 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
デスクトップアプリの Work / Codex | 対応 | 対応 |
ChatGPT Work(Web) | 対応 | 対応 |
Codex CLI | 対応 | 対応 |
Codex IDE 拡張 | 対応 | 対応 |
Codex cloud | 公式一覧に項目なし | 非対応と明記 |
API | 対応 | 対応 |
Sol の行を「非対応」と書かずに「項目なし」としたのは、公式の機能一覧に Codex cloud の行そのものが無いためです。書いていないことを「できない」と読み替えない——これは他社の仕様を記事にするときに私が最も気をつけている点です。cloud で使う予定があるなら、自分のアカウントのモデル選択欄で実際に確認してください。
Astra にできないことが、Sol と Luna にはある
ここが今回いちばん面白い部分です。下位モデルは単に「安くて弱い」わけではありません。
1. 思考量ゼロ(none)を指定できる
GPT-6 の推論モデルは reasoning.effort で思考の深さを指定します。Sol と Luna は none / low / medium(既定)/ high / xhigh / max を受け付けます。
一方、Astra は none を受け付けません。指定すると HTTP 400 が返ります(公式の Reasoning ガイドに明記)。
公式が none の用途として挙げているのは「推論や多段のツール呼び出しの恩恵がない、遅延が致命的なタスク」で、具体例は音声・高速な情報検索・分類です。言い換えると、考えなくていい工程を「考えない」と宣言できるのは下位2モデルだけということになります。分類・抽出・定型判定を大量に回す処理では、これは単価差以上に効きます。
2. 知識カットオフが素直に並んでいない
3モデルの知識カットオフは公式ページにこう書かれています。
モデル | 知識カットオフ |
|---|---|
GPT-6 Sol | 2026年4月20日 |
GPT-6 Astra | 2026年4月30日 |
GPT-6 Luna | 2026年5月18日 |
いちばん安い Luna が、いちばん新しい世界を知っています。上位モデルほど新しいはず、という思い込みで「最新の話題は Astra に聞く」と決めていると、実は逆です。もっとも、1か月弱の差で結論が変わる場面は限られますし、どのモデルでも最新情報は検索ツールで補うのが正しい設計です。ここで言いたいのは数字そのものより、階層=新しさではないという事実を知っておくことです。
3. Chat Completions での関数呼び出しの扱いが違う
Sol と Luna は Chat Completions でも関数呼び出し(function calling)が使えますが、reasoning_effort を none にしたときだけという条件が付きます。Astra は Chat Completions での関数呼び出しに対応していません。どちらも、ツールを使わせたいなら Responses API を使うのが公式の推奨です。
なお Codex 側のドキュメントには「Chat Completions API のサポートは非推奨で、将来のリリースで削除される」とも書かれています。今から新しく組むなら Responses API 一択です。
4. Ultra は Luna では使えない
ChatGPT デスクトップアプリ側の思考レベルには Max(同じタスクに時間をかける)と Ultra(サブエージェントで並列分担する)があります。Luna は Max までで、Ultra は使えません。この2つの違いはGPT-6 Astraの新しい思考レベル「max」とはで詳しく書いています。並列分担させたい仕事を Luna に振っても、その設定は現れません。
5. 「量をさばく」は説明文だけでなくレート制限にも出ている
Luna が大量処理向けだというのは、キャッチコピーではなく上限値に現れています。公式のレート制限表を並べると次のとおりです(最上位の Tier 5・Standard)。
モデル | RPM(毎分リクエスト) | TPM(毎分トークン) | バッチ待ち行列上限 |
|---|---|---|---|
GPT-6 Astra | 15,000 | 4,000万 | 150億 |
GPT-6 Sol | 15,000 | 4,000万 | 150億 |
GPT-6 Luna | 30,000 | 1億8,000万 | 150億 |
Luna だけ毎分トークンが4.5倍、毎分リクエストが2倍です。Tier 1(使い始め)でも、バッチ待ち行列の上限が Astra・Sol の150万に対して Luna は500万と差が付いています。「安いから量を流せる」のではなく、量を流す前提で上限が設計されていると読むのが正しいです。逆に言うと、少量でも深く考えさせたい仕事に Luna を選ぶ理由はここにはありません。
文脈長で選ぶ理由は、今回はない
3モデルとも、文脈ウィンドウは105万トークン、最大入力は92万2,000トークン、最大出力は12万8,000トークンでまったく同じです。長い資料を読ませたいから上位モデル、という選び方は今回に限っては成り立ちません。選ぶ軸は思考量・単価・提供面の3つです。
料金は本当に「半額」なのか
以下は2026年9月23日時点で私が公式のモデルページと API 変更履歴を開いて確認した Standard 単価です(100万トークンあたり・入力272Kトークンまで)。契約や見積もりに使う前には、必ずご自身でOpenAI公式の価格ページを確認してください。
モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
GPT-6 Astra | $10 | $1 | $50 |
GPT-6 Sol | $2 | $0.20 | $10 |
GPT-6 Luna | $0.10 | $0.01 | $0.50 |
GPT-5.6 Sol(前世代) | $4 | $0.40 | $20 |
GPT-5.6 Luna(前世代) | $0.20 | $0.02 | $1.20 |
前世代と並べると、値下げ幅はモデルによって違います。
- Sol: 入力 $4→$2、出力 $20→$10。どちらもちょうど50%減
- Luna: 入力 $0.20→$0.10 で50%減、出力は $1.20→$0.50 で約58%減
「一律50%引き下げ」という要約が出回っていますが、Luna の出力だけは50%より大きく下がっています。出力トークンが多いワークロード(要約・生成)では、この差がそのまま効きます。
Astra と比べると、Sol は入力・出力とも5分の1、Luna は100分の1です。GPT-6 Astraの料金|実際に月いくらかかるのかで書いた月額試算を、そのまま5分の1・100分の1に置き換えられる——というのは乱暴で、実際には思考量の設定次第で出力トークン数自体が変わります。単価表だけで月額は決まりません。
注意点として、公式ページには次の条件も併記されています。いずれも見落とすと請求が想定とずれます。
- キャッシュ入力は未キャッシュ入力の10%、キャッシュ書き込みは1.25倍で課金される
- 入力が272Kトークンを超えると、そのリクエスト全体が入力・キャッシュ2倍/出力1.5倍になる
- Batch と Flex は Standard の50%、Fast モードは該当レートの2倍
- Sol・Luna では地域指定処理(regional processing)に10%の上乗せがある
また、前世代の GPT-5.6 Sol の $4/$20 は公式ページ上で「少なくとも2026年11月21日まで」の販促価格と注記されています。つまり比較の基準になっている前世代の価格自体が期間限定でした。ここは期限を根拠に判断を急がせる話ではないので、通常価格を軸に考えてください。
5.5から移ると、キャッシュの挙動が変わる
ここは料金表を見ているだけでは気づけない落とし穴です。プロンプトキャッシュの仕様が、GPT-5.5 以前と GPT-5.6 以降(=GPT-6 を含む)で変わっています。
項目 | GPT-5.5 以前 | GPT-5.6 以降(GPT-6 含む) |
|---|---|---|
キャッシュ書き込み課金 | 追加課金なし | 未キャッシュ入力の1.25倍 |
キャッシュ読み出し | モデルごとの単価 | 未キャッシュ入力の0.1倍 |
保持時間の設定値 |
|
|
最小キャッシュ長 | リクエスト設定で変動 | 可視入力1,024トークン固定 |
区切り位置の明示指定 | 非対応 | 対応(explicit モード) |
スケジュール実行しているジョブにとって、いちばん効くのは保持時間です。GPT-5.5 では24時間保持が選べたので、1日1回動くジョブでも前日のキャッシュに当たる可能性がありました。GPT-6 では保持は30分のみ(最後の書き込みまたは再利用から最低30分。再利用するたびに延長される)。1日1回しか動かない処理は、毎回キャッシュを書き直すことになります。そして書き込みには1.25倍の課金が付きます。
単価が半額になっても、キャッシュの当たり方が変わると実際の請求は素直に半分にはなりません。ここは移行後に使用量ダッシュボードで実測して確認すべき箇所です。
一方で、GPT-6 世代で新しく使えるようになった制御もあります。prompt_cache_options.mode を explicit にすると、どこまでをキャッシュに書くかを自分で指定できます。最後の区切り以降は未キャッシュ単価で処理され、書き込み課金は発生しません。毎回変わる末尾(その日のデータなど)を書き込みから外せる、ということです。1リクエストあたり書き込みは4つまで、という上限も公式に明記されています。
私の使い方で言えば、固定の指示文と参照表までを1つ目の区切りにして、その日ごとに変わる素材はそれより後ろに置く形にしています。変わらないものを前に、変わるものを後ろに——これだけで書き込み課金の対象がはっきりします。
私たちの運用では、単価より「工程」を組み替えた
私は自社のサーバーで、毎晩人が見ていない時間に動く定型ジョブをいくつも回しています。素材を読み込み、重複を判定し、本文を組み立て、最後に形式を検査する——といった流れを、決まった時刻に無人で通すものです。
これまでは1本のジョブを1つのモデルで通していました。理由は単純で、そのほうが設定が1行で済むからです。しかし今回の3階層化で、この横着に値段が付いていることがはっきりしました。「重複しているかどうかを判定する」工程に、最上位モデルの単価と思考時間を払い続けていたわけです。
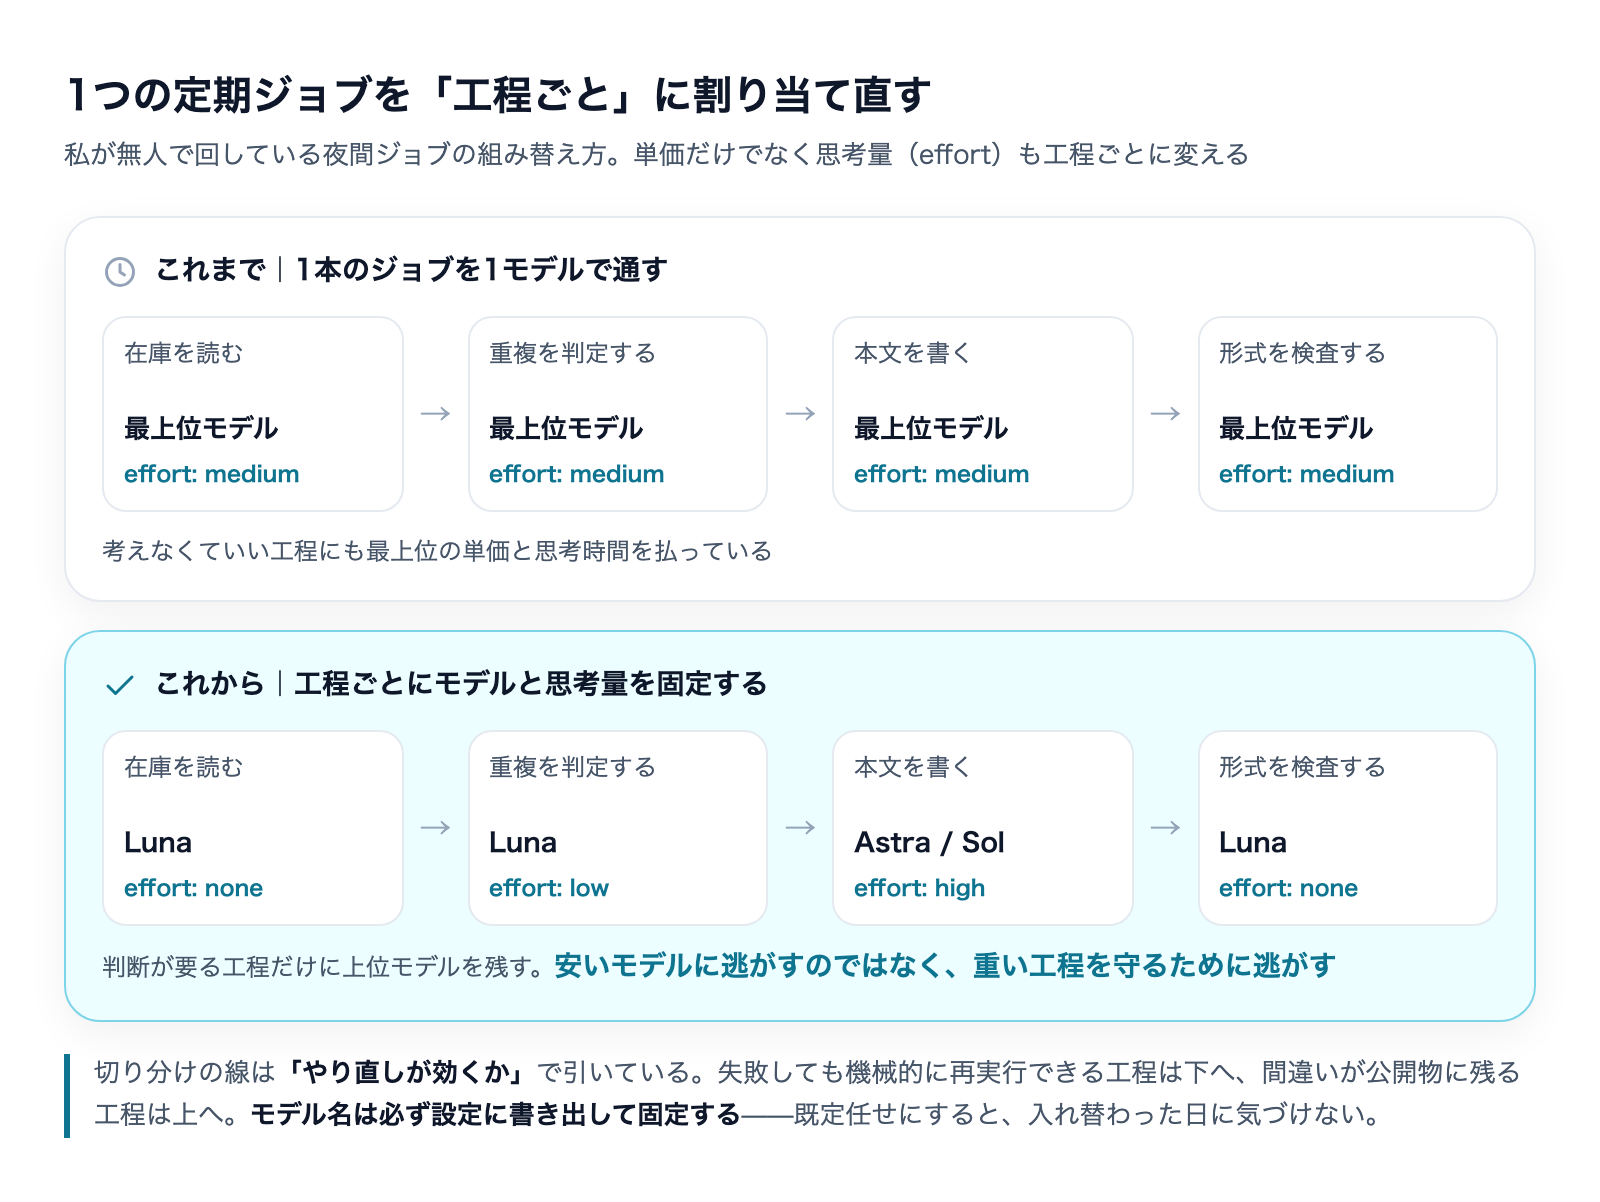
組み替えるときに使った線引きは、単価ではなく「やり直しが効くか」です。
- 失敗しても機械的に再実行できる工程(読み込み・形式検査・単純な分類)→ 下位モデル+低い思考量。ここは
noneが使えるかどうかが直接効く - 間違いが成果物に残る工程(判断・本文の組み立て)→ 上位モデル+高い思考量
大事なのは順序です。安いモデルに逃がすためではなく、重い工程に予算を残すために逃がす。全体を下げると品質が落ちて、結局やり直しが増えます。
もう1つ、GPT-6 世代で使えるようになった仕掛けがあります。会話の途中に configuration_update という項目を挟むと、リクエスト単位の reasoning.effort を変えないまま、次の応答から思考量を上げ下げできます。公式が明記しているとおり、これは最初のプロンプトの前半(プレフィックス)を書き換えないので、プロンプトキャッシュが効いたままになります。「軽く下書き→難所だけ深く考えさせる」を、キャッシュを壊さずに1つの会話の中でやれるということです。
ただし公式は制約も併記しています。configuration_update を2つ隣り合わせに置くと API が拒否すること、自動の圧縮(compaction)や自動の切り詰めとは併用できないこと、そして応答が報告する reasoning.effort はリクエスト単位の設定のままで更新後の値ではないこと。最後の点はログを見て「効いていない」と誤解しやすいので、検証するなら使用トークン数のほうを見てください。
設定に書き出して固定する
私が運用で必ず守っているルールが1つあります。使うモデル名は必ず設定ファイルに明示して固定することです。既定任せにしていると、提供側の推奨が入れ替わった日に、こちらは何も変えていないのに出力の質やコストが変わります。無人で回しているジョブほど、変化に気づくのが遅れます。
Codex では設定ファイルに1行書くだけです。
model = "gpt-6-sol"コマンドで一時的に切り替えるなら次のとおりです。
codex --model gpt-6-sol
codex exec -m gpt-6-sol "Review the current changes"今回の10月14日の引退案内が「スクリプトとスケジュールタスクを書き換えろ」と名指ししているのは、まさにこの固定をしている人に向けた注意です。固定していれば安全、ではありません。固定しているからこそ、期限までに自分で書き換える責任が発生します。
ニュースの要約と公式で食い違った点
今回、手元に届いたニュース要約と公式ドキュメントを突き合わせたところ、3か所ずれていました。同じ情報源を見ている方のために残しておきます。
要約の記述 | 公式で確認した内容 |
|---|---|
9月23日リリース | API変更履歴の日付は9月22日(日本時間では9月23日未明) |
API価格を一律50%引き下げ | Sol は入出力とも50%減だが、Luna の出力は約58%減 |
Free・Go ユーザーはデスクトップ版で Luna を試用可 | 「試用」ではなくGPT-5.5 引退に伴うプラン別の代替案内。Plus 以上は Sol、Free・Go は Luna |
加えて、要約には10月14日の GPT-5.5 引退がまったく入っていませんでした。読者にとって実際に手を動かす必要がある情報は、値下げよりこちらです。ニュースの要約は「何が発表されたか」を伝えますが、「自分は何をすればいいか」までは教えてくれません。公式ドキュメントを1枚開くかどうかで、記事の価値は変わります。
今週やること:チェックリスト
gpt-5.5という文字列を検索する。設定ファイル、スケジュール実行、スクリプト、カスタムエージェント、ワークスペース既定値。10月14日以降も動き続ける必要があるものを洗い出す- プランに応じた置き換え先を決める。Plus 以上なら
gpt-6-sol、Free・Go ならデスクトップアプリでgpt-6-luna。Enterprise・Edu は管理者による Luna の有効化を先に済ませる - 置き換えたら、いちばん重い仕事を1つだけ流して比べる。思考レベルは世代間で厳密に対応しないので、慣れたタスクを低めの設定から試して調整する(これも公式の案内)
- 「考えなくていい工程」を1つ見つけて
noneにする。分類・抽出・形式検査あたりが候補。ここだけで効果が出るなら、工程分割を広げる価値がある - API を使っているなら、272Kトークンの境界を超えていないか確認する。超えた瞬間にリクエスト全体の単価が跳ね上がる
よくある質問
普段の ChatGPT で GPT-6 Sol は使えますか
使えません。公式ドキュメントは「Work と Codex で利用でき、Chat では利用できない」と明記しています(2026年9月23日時点)。
GPT-5.5 は完全になくなるのですか
ChatGPT・ChatGPT Work・Codex からは2026年10月14日に引退します。OpenAI API はこの引退の対象外と公式に書かれています。API 経由で使い続けている場合、今回の期限の直接の影響は受けません。
Astra をやめて Sol に全部移していいですか
単価だけ見れば魅力的ですが、いちばん難しい仕事を最後まで通すという Astra の位置づけは変わっていません。全部を下げるのではなく、工程を分けて「難所だけ Astra に残す」ほうが、やり直しの回数まで含めた総コストは下がりやすいです。判断材料はGPT-6 Astraとは|変更点・料金・使えるプランにまとめています。
Luna はどこまで任せられますか
公式の説明は「要約・抽出・焦点の定まったコーディングを含む、集中した大量処理向けの最も効率的なモデル」です。逆に言えば、広く判断させる仕事には向きません。Ultra(サブエージェントによる並列分担)も使えないので、タスクを自分で分割してくれることを期待しないほうがいいです。
まとめ
GPT-6 Sol と Luna の登場は、単価表の更新としては「Sol が Astra の5分の1、Luna が100分の1」という話です。しかし手を動かす必要が生まれたのは、同時に案内された10月14日の GPT-5.5 引退のほうでした。
そして3モデルの差は、値段だけではありません。none を受け付けるのは下位2モデルだけ、知識がいちばん新しいのはいちばん安い Luna、Ultra が使えないのも Luna。階層は値段の順に並んでいても、できることは値段の順には並んでいない——ここを押さえておくと、次にモデルが増えたときも慌てずに済みます。
私たちがやったのは、モデルを乗り換えることではなく、1本の仕事を工程に割って、それぞれに合ったモデルと思考量を当て直すことでした。単価の比較より、この作業のほうが効きます。株式会社Fyveでは、こうした「動かし続けるための設計」をお客様の環境に合わせて組み立てています。
Codexに「課金」する前に読む本
無料枠の限界・プランの選び方・元の取り方を実測で(全26ページ)
課金の答えは、料金表の読み比べからは出ません。無料枠でできること・できないこと、金額でなく「倍率」で覚えるプランの構造、Claude Codeとの二刀流で枠を使い切る配分まで——両方に課金して1人会社を回している実運用から公開します。
- 無料枠でできる3つ・できない5つの線引き
- 金額でなく「倍率」で覚えるプラン早見表
- 週1回30秒で回る使用量の管理ルール(コピペ可)
- Claude Codeとの二刀流——枠を使い切る係の割り当て
メールアドレス登録で他にも様々な資料を閲覧できます
 +6
PDF 15点・合計400ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。