Reflection AI Beamとは|501Bを使う条件

「501Bパラメータのオープンウェイトモデルが出た」という知らせが流れてきたとき、自社のAI活用計画にそれを入れていいのか、すぐには判断できません。性能表には見慣れないベンチマーク名が並び、「オープンウェイト」「Apache 2.0」「23Bアクティブ」といった言葉が、どれも良いことのように見えます。けれど実際に使い始めようとすると、そもそも手に入らない、動かす機械が無い、数字の出所が分からない——といった壁に順番にぶつかります。
結論から書きます。Reflection AIの「Beam」は、2026年10月5日に発表されたモデルですが、本稿執筆時点(2026年10月8日)で重み(weights)はまだ公開されていません。公式は「今月中にApache 2.0ライセンスで重み・技術レポート・モデルカード・開発者向け資材を公開する」と予告しており、現時点の入手経路は早期アクセスの待機リスト登録だけです。つまり今できるのは「評価」ではなく、公開されたときに何を確認するかを決めておくことです。
株式会社Fyveは、無人で動くAIジョブを毎日運用しており、そのジョブごとにどのモデルを使うかを決め続けています。その立場から言うと、新モデルは発表された日の数字で判断しても、ほぼ必ず後から見直しになります。だから私は、発表段階のモデルは「候補として記録するだけ」にして、実際に自分のタスクを流せるようになってから評価する運用にしています。この記事では、Beamを題材に、その確認手順をそのまま使える形で書きます。
結論:2026年10月8日時点のBeamの状態
まず事実関係だけを整理します。ここが曖昧なまま性能の話に進むと、判断を誤ります。
項目 | 2026年10月8日時点の状態 |
|---|---|
発表日 | 2026年10月5日(Reflection AI公式ブログ) |
重みの公開 | 未公開。「今月中に公開する」と予告 |
予定ライセンス | Apache 2.0(公式が明記) |
現在の入手経路 | 早期アクセスの待機リスト登録のみ |
公開を待っている資材 | 重み・技術レポート・モデルカード・開発者向け資材 |
公開前の工程 | 最終のレッドチーミングと評価を実施中と公式が説明 |
性能数値の検証状況 | すべてベンダー自己申告。第三者による独立検証は未実施 |
「オープンウェイト」という言葉は、ライセンスの話であって、今すぐ手元に落とせるかどうかの話ではありません。Apache 2.0は商用利用・改変・再配布まで広く許す寛容なライセンスで、公開されれば扱いやすいのは確かです。ただライセンスが寛容であることと、配布が始まっていることは別の事実です。ここを混ぜると、「もう使える」という前提で計画を立ててしまいます。
Beamとは何か:501B総パラメータ・23Bアクティブのスパース MoE
Beamは、コーディング・推論・エージェント的な作業を狙って作られたスパース Mixture-of-Experts(MoE)モデルです。公式が示している構成と学習規模は次のとおりです。
- 総パラメータ 501B(5,010億)/アクティブ 23B(230億)のスパースMoE
- 事前学習データ量:23.8兆トークン(公開ウェブおよび商用ソース)
- 事前学習:NVIDIA GB300 NVL72を6,144基、4週間未満
- 強化学習:NVIDIA GB300を約10,500基、4週間、1億回超のロールアウトを生成
- 強化学習の環境:コーディング・エージェント・STEMの高品質環境を100万件
- 安全性:事前学習チェックポイントから、別のSFT/RLパイプラインで2つ目のモデルを学習させる手法を公式が説明
MoEは、入力トークンごとにモデル内部の一部(エキスパート)だけを使う構造です。Beamの場合、全体では5,010億パラメータを持ちながら、1トークンの処理で実際に計算に関わるのは230億パラメータぶんだけ、ということになります。公式はこの構造を根拠に、「GLM-5.2と同等のスコアを、3〜4分の1の推論計算量で達成する」と説明しています。報道では、この比較相手であるGLM-5.2が750Bパラメータのモデルであること、そしてBeamが2兆パラメータ超のQwen 3.8-Maxの性能に迫ること、米国のスタートアップ発のオープンモデルとして中国勢の先行オープンモデルに比肩する初の事例であることが整理されています。
資金面では、Reflection AIが250億ドル評価で資金調達し、NVIDIA GB300 NVL72の利用に関して63億ドル規模の契約を結んでいることも報じられています。つまりこれは、個人や小さな研究チームの成果物ではなく、相当な計算資源を投じて作られたモデルです。その前提は、後述する「自社で動かせるか」の判断にそのまま響いてきます。
ベンチマークの読み方:勝ち負けは分野で割れている
ここが、要約記事では必ず落ちる部分です。「GLM-5.2に匹敵」という一文だけを見ると、全分野で横並びという印象になります。しかし公式が出している比較表を項目ごとに見ると、Beamはコーディングとツール呼び出しでGLM-5.2を上回り、純粋な推論系ではGLM-5.2を下回っています。方向性のある差であって、一律の同等ではありません。
公式表からGLM-5.2と直接比較できる項目だけを抜き出すと、こうなります(数値はいずれもReflection AIの自己申告)。
ベンチマーク | 系統 | Beam | GLM-5.2 | 差 |
|---|---|---|---|---|
AutomationBench(public) | ツール呼び出し | 37.0 | 26.2 | +10.8 |
IFBench | 一般能力 | 79.7 | 73.3 | +6.4 |
SWE Bench Pro v1 | コーディング | 65.5 | 62.1 | +3.4 |
LongBench v2 | 一般能力 | 65.5 | 64.0 | +1.5 |
MCP Atlas | ツール呼び出し | 78.7 | 77.8 | +0.9 |
tau3 banking | ツール呼び出し | 38.0 | 37.1 | +0.9 |
DeepSWE v1.1 | コーディング | 44.4 | 44.0 | +0.4 |
AA-LCR | 一般能力 | 79.3 | 78.3 | +1.0 |
GPQA Diamond | 推論 | 90.5 | 91.2 | −0.7 |
Terminal Bench v2.1 | コーディング | 80.1 | 81.0 | −0.9 |
AIME 2026 | 推論 | 97.8 | 99.2 | −1.4 |
HLE(no tools) | 推論 | 36.2 | 40.5 | −4.3 |
CriPT AA | 推論 | 16.3 | 20.9 | −4.6 |
推論系の4項目(GPQA Diamond・AIME 2026・HLE・CriPT AA)はすべてGLM-5.2のほうが上です。一方でツール呼び出し系は3項目すべてBeamが上で、AutomationBenchは10ポイント以上の差がついています。エージェントとして道具を使わせる用途を考えているなら意味のある差ですが、難問を解かせる用途なら期待を下げる必要がある、という読み方になります。「同等」の一語で丸めずに、自分の用途に近い系統の行だけを見るのが正しい使い方です。
比較相手の世代に注意する
もうひとつ重要なのが、比較相手の世代です。公式表にはGLM-5.2だけでなく、GLM-5.3・Kimi K3・DeepSeek V4.1 Flashといった新しい世代も並んでいます。そちらと比べると、構図はかなり変わります。
ベンチマーク | Beam | GLM-5.3 | Kimi K3 | DeepSeek V4.1 Flash |
|---|---|---|---|---|
Terminal Bench v2.1 | 80.1 | 88.2 | 88.3 | 90.6 |
DeepSWE v1.1 | 44.4 | 61.0 | 68.0 | 74.2 |
SWE Bench Pro v2-Hard | 77.2 | 84.3 | 88.2 | (記載なし) |
HLE(no tools) | 36.2 | 42.3 | 46.9 | 39.1 |
MCP Atlas | 78.7 | 84.2 | 82.3 | (記載なし) |
つまりBeamが「匹敵する」と言っているGLM-5.2は1世代前で、同じ表に載っているGLM-5.3・Kimi K3・DeepSeek V4.1 Flashは、多くの項目でBeamより上の数字が出ています。これはBeamの価値を否定するものではありません。Beamの主張は「少ない推論計算量で同水準」という効率の話であり、絶対性能で先頭を取るという話ではないからです。ただ「オープンウェイトの最強モデルが出た」と受け取ると、事実と離れます。効率で選ぶのか、絶対性能で選ぶのかを、自分の側で先に決めておく必要があります。
なお、ここまでの数値はすべてReflection AIが自社で測って公開したものです。重みが未公開なので、第三者が同じ条件で測り直した結果はまだ存在しません。独立検証が無い段階の数字は、方向性の参考までに使い、契約や投資の根拠には使わない——これは新モデル全般に当てはまる線引きです。
「23Bアクティブだから軽い」は誤読になりやすい
MoEの説明で最も誤解されるのが、アクティブパラメータの意味です。アクティブ23Bが効いてくるのは1トークンあたりの計算量であって、メモリに置く重みの量ではありません。どのエキスパートが呼ばれるかは入力ごとに変わるため、推論では一般に全エキスパートの重みを載せられる前提で見積もります。自己ホストのVRAM見積もりでMoEモデルが総パラメータ基準で扱われているのは、このためです。
推論時の重みの占有量は、1パラメータあたりの精度(バイト数)で概算できます。一般的な目安として、FP16では1パラメータあたり約2バイト(10億パラメータあたり約2GB)、INT8では約1バイト(約1GB)、INT4では約0.6GBとされています。Beamの総パラメータ501Bに当てはめた単純計算が下表です。
精度 | 1Bあたりの目安 | 501Bの重みの概算 |
|---|---|---|
FP16/BF16 | 約2GB | 約1,000GB(1TB) |
INT8/FP8 | 約1GB | 約500GB |
INT4 | 約0.6GB | 約300GB |
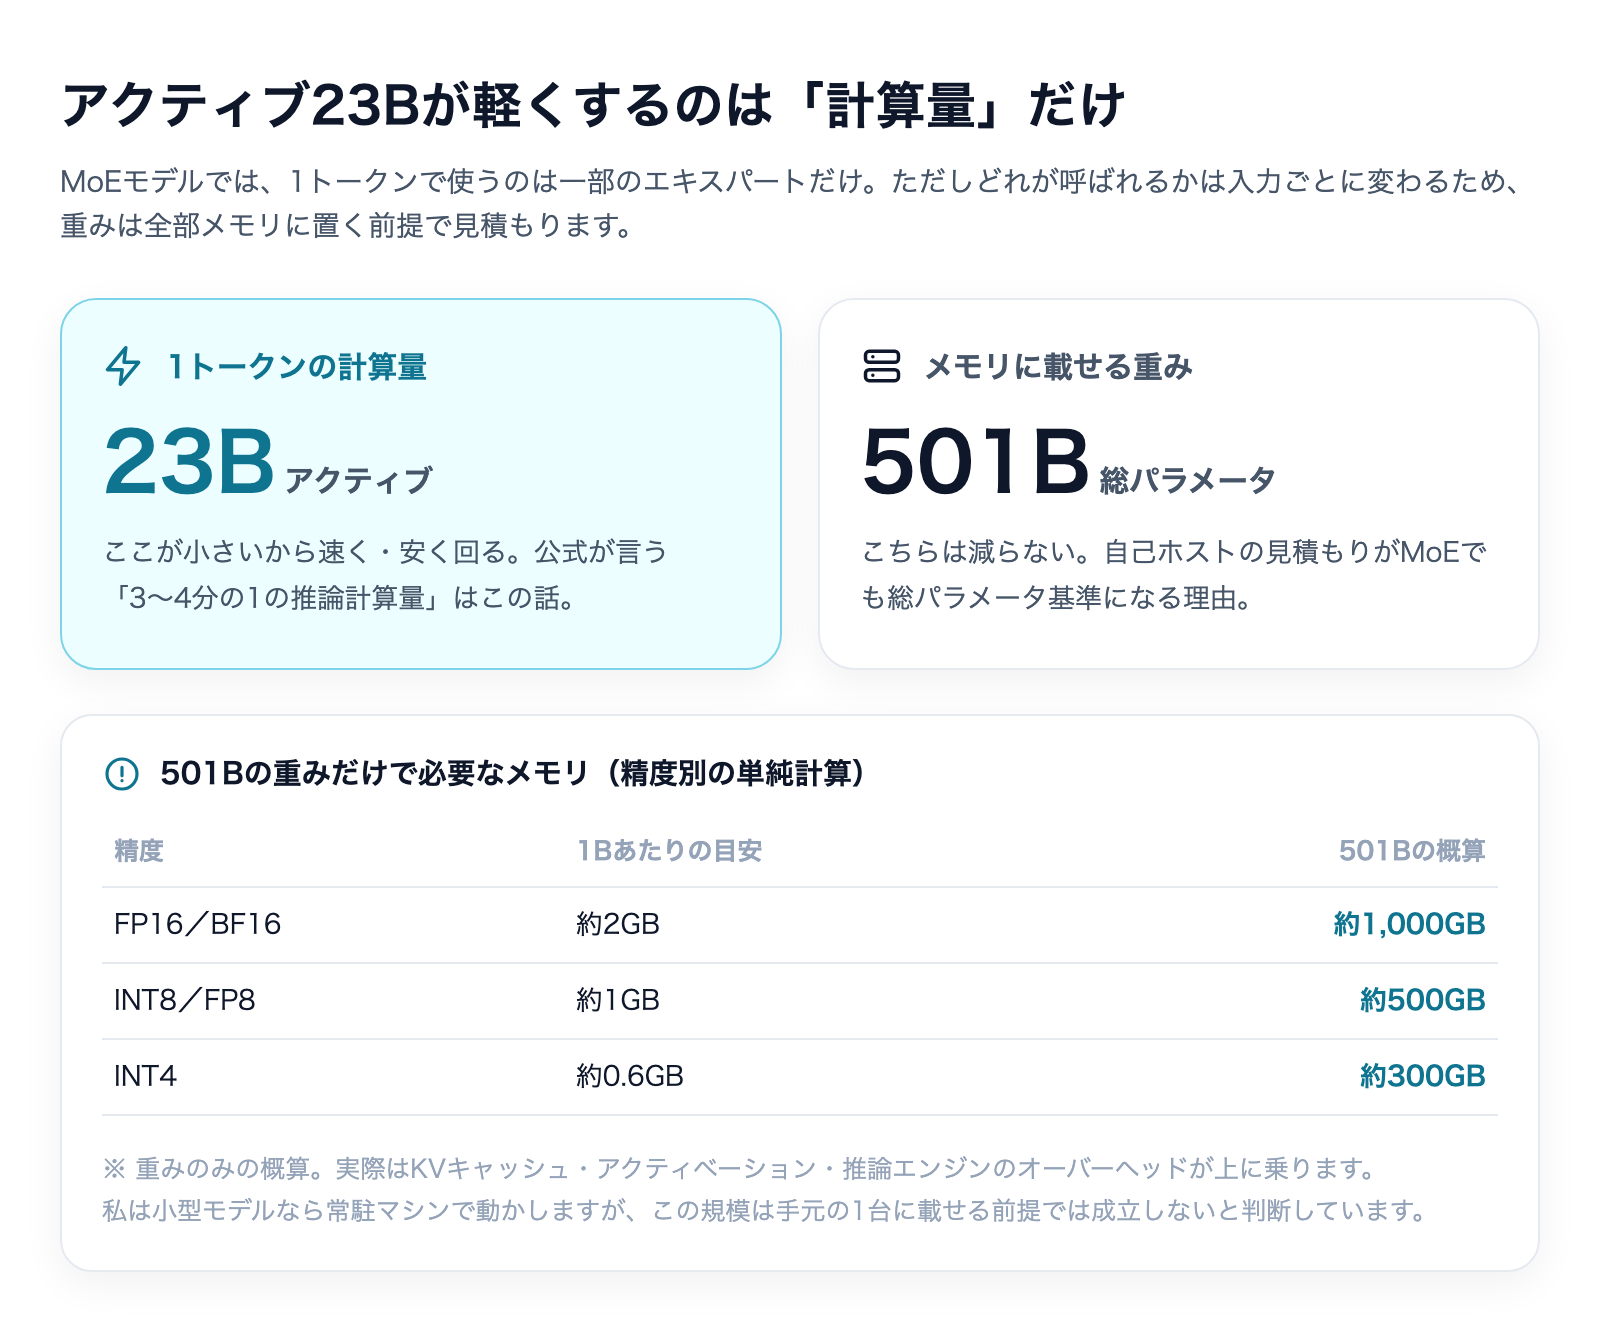
これは重みだけの概算で、実運用ではKVキャッシュ・アクティベーション・推論エンジンのオーバーヘッドが上に乗ります。文脈を長く取ればKVキャッシュはさらに膨らみます。量子化やCPUへのオフロードで必要量は下げられますが、下げれば速度や精度に跳ね返ります。いずれにしても、1台のワークステーションや市販ノートPCに載る規模ではありません。実際の数値はモデルカードと推論エンジン側の対応状況が出てから確定するので、公開されたらまずそこを読むべき項目です。
私は以前、無人ジョブの一部をオープンウェイトモデルの自前運用に寄せられないか検討しました。結論は、小型のモデルであれば常駐マシンで動くものの、数百Bクラスは手元の機械に載せる前提では成立しないというものでした。載せるための機材費と、API従量課金で同じ処理を回したときの月額を並べると、うちの処理量では後者が明確に安かったからです。この比較の立て方はMac miniでAIエージェントを常駐させたときの実測コストに書いたとおりで、Beamのような大型モデルでも考え方は同じです。「オープンウェイトだから安い」ではなく、重みが無料でも、動かす場所の費用は無料にならないという順番で見ます。
文脈長は一次情報の中で割れている
計画に入れる前に確認すべき項目として、もう一つ具体例を挙げます。Beamの文脈長(コンテキストウィンドウ)です。
公式ブログの記述を読むと、インフラ構成を説明する箇所では最大256Kトークンとされており、学習工程の説明では、強化学習を256Kで行い、中間学習の段階で1Mトークンまで拡張したという書き方になっています。一方、二次メディアの解説では「1Mトークンの文脈」と単純に紹介されているものがあります。
どちらが間違いというより、一次情報の中で節によって書き分けられており、製品仕様としての確定値がまだ提示されていないのが実態です。学習時に扱えた長さと、公開される重みを推論エンジンに載せたときに実用できる長さは、同じとは限りません。長い文脈を前提にした使い方(大きなコードベースを丸ごと読ませる、長時間の議事録をまとめて処理する等)を計画しているなら、この数字はモデルカードが出るまで未確定として扱うのが安全です。実際の値は公開後にモデルカードと推論エンジンの対応状況で確認してください。
新モデルの発表を自社の計画に入れる前の4確認
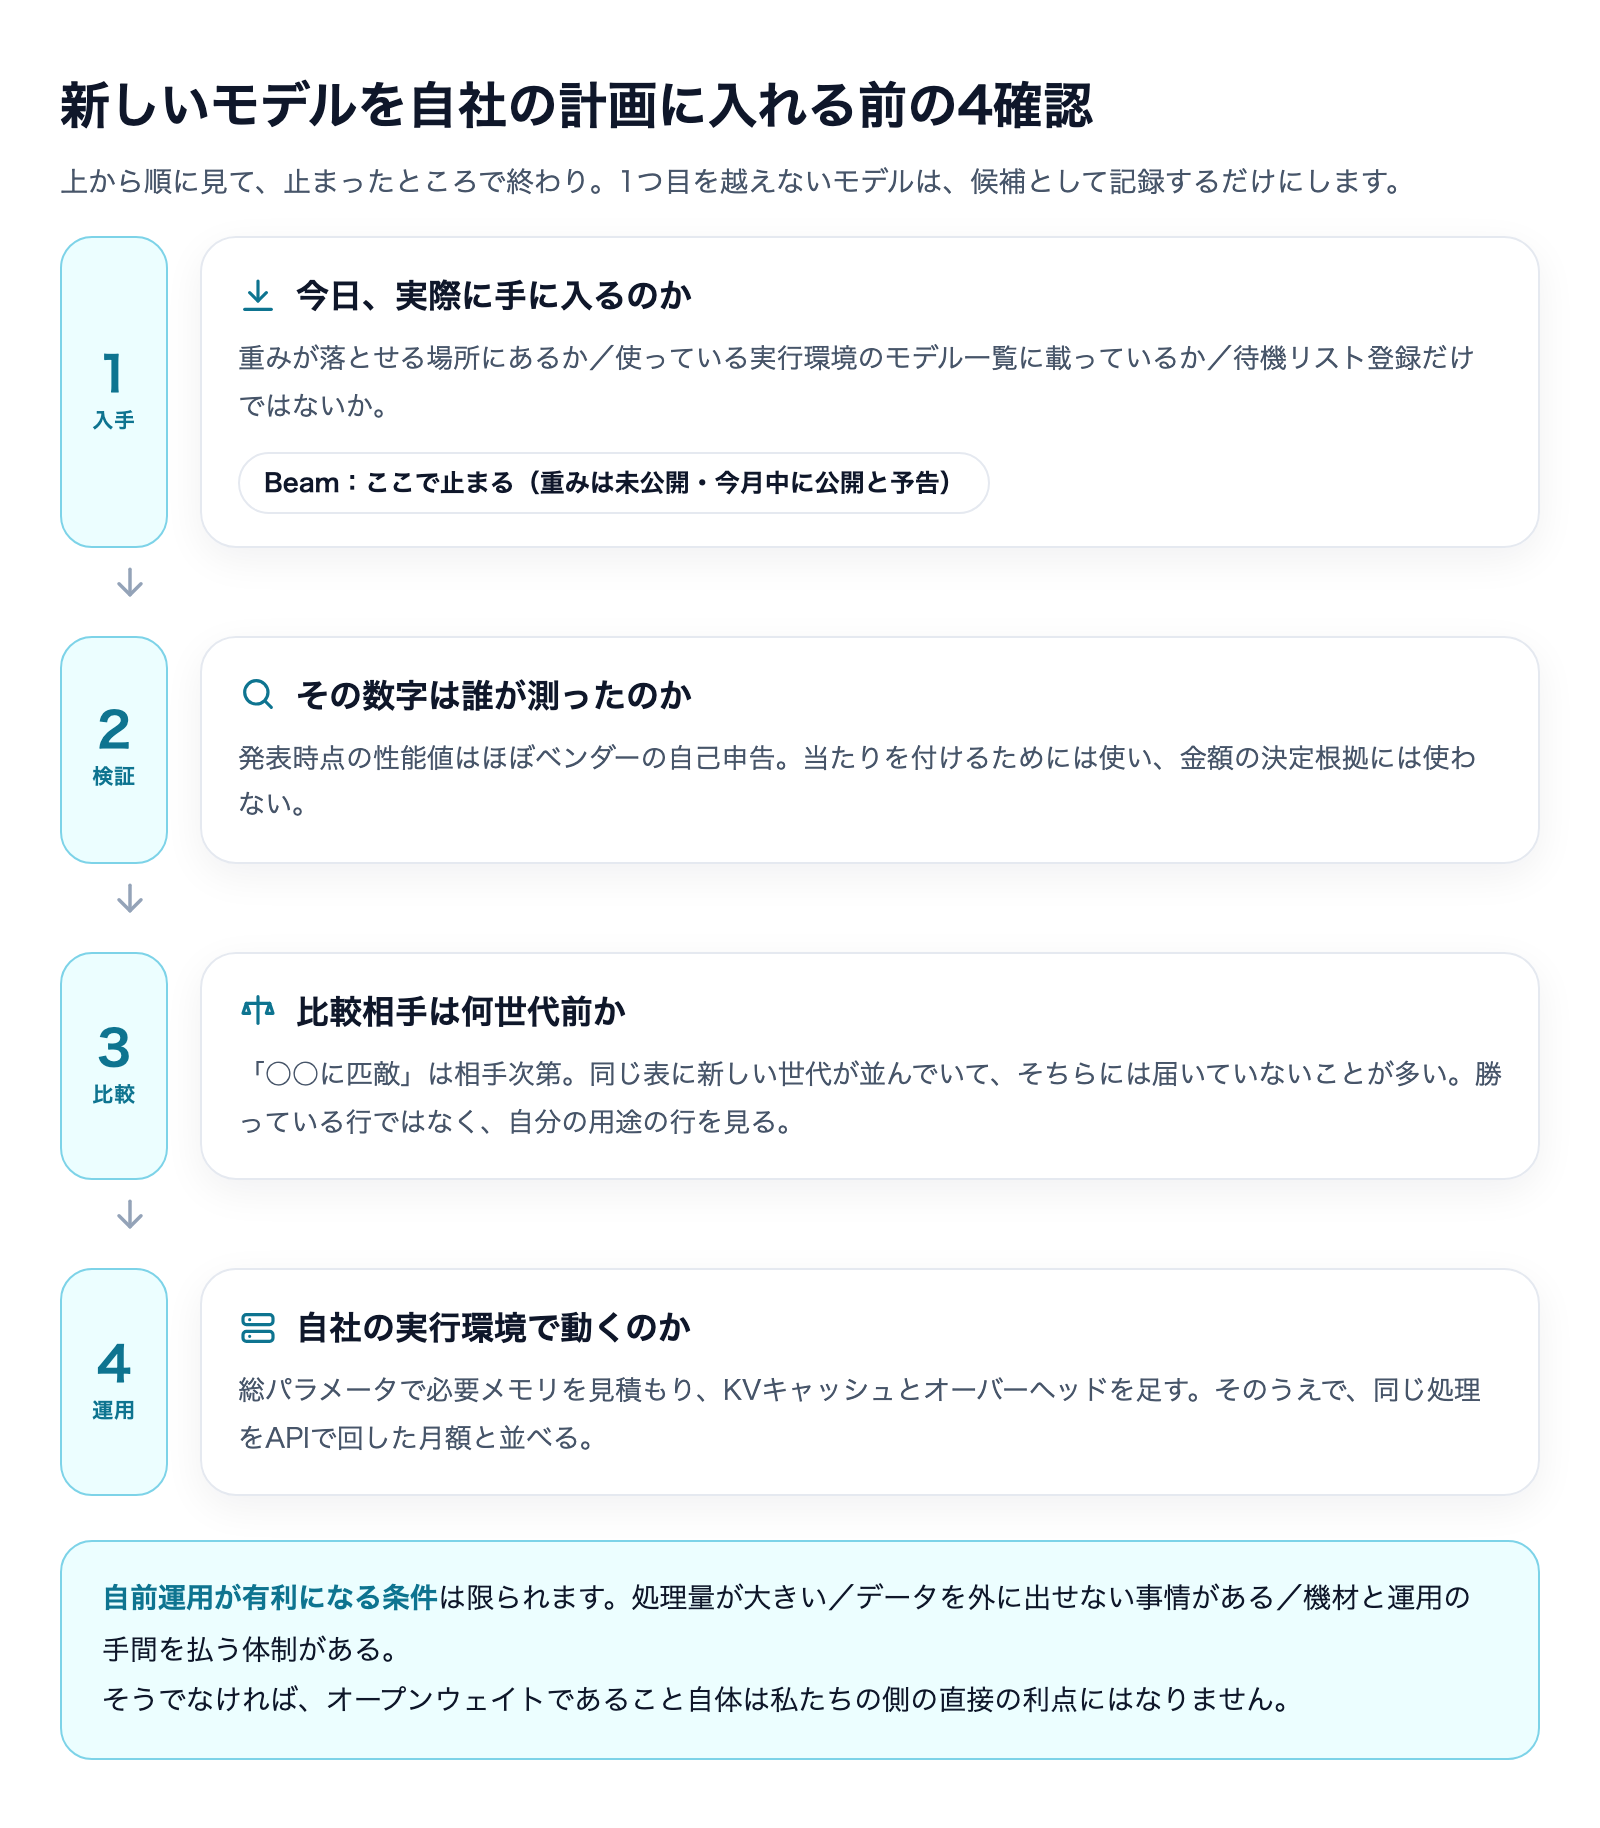
ここまでをBeam以外にも使える形にまとめます。新しいモデルの発表を見たとき、私が順番に確認しているのは次の4点です。順番にも意味があります。1つ目で止まれば、残りを調べる必要はありません。
確認1:今日、手に入るのか(入手可能性)
発表と配布は別です。「公開」と報じられていても、重みの配布が始まっていないことは珍しくありません。確認するのは、重みが実際に落とせる場所に置かれているか、自分が使っている推論基盤や実行環境のモデル一覧に載っているか、待機リスト登録だけなのか、の3点です。Beamは本稿執筆時点でこの最初の関門を越えていません。ここで止まったモデルは、候補として記録するだけにして、評価には進まないのが時間の節約になります。
確認2:その数字は誰が測ったのか(検証状況)
発表時点の性能値は、ほぼすべてベンダーの自己申告です。これは不正という意味ではなく、第三者が測り直す材料(重み)がまだ無い、という構造的な話です。自己申告値は「どの方向が得意そうか」の当たりを付けるために使い、金額の決定根拠には使わない。独立検証が出てから、あるいは自分のタスクで流してから、判断を確定させます。
確認3:比較相手は何世代前か(比較の土台)
「○○に匹敵」という表現は、比較相手を確認しないと意味が取れません。同じ発表資料の中に、より新しい世代が並んでいて、そちらには負けている——という形は頻繁にあります。Beamの公式表がまさにそれで、GLM-5.2には競れていますが、GLM-5.3・Kimi K3には多くの項目で届いていません。比較表は「勝っている行」ではなく「自分の用途の行」と「相手の世代」を見るのが実務的です。
確認4:自社の実行環境で動くのか(運用の現実)
最後が、動かす場所の話です。アクティブパラメータではなく総パラメータで必要メモリを見積もる、KVキャッシュとオーバーヘッドを足す、量子化で削るなら精度と速度の代償を見る。そのうえで、同じ処理をAPIで回した場合の月額と並べます。自前運用が有利になるのは、処理量が大きく、データを外に出せない事情があり、機材と運用の手間を払う体制がある場合に絞られます。そうでなければ、オープンウェイトであることは自社にとって直接の利点になりません。
私の運用:発表段階のモデルは「在庫」に積むだけ
私は無人で動くAIジョブを毎日回していて、ジョブごとに使うモデルを固定しています。文章を書かせるジョブには大きなモデルを、形の決まった機械的な処理には小さく安いモデルを割り当てる、という分け方です。この運用で学んだことを3つ書きます。Beamのようなニュースへの向き合い方は、ここから導いています。
1つ目は、モデル名を必ず明示的に指定しておくこと。 ヘッドレスで動くジョブでは、使うモデルを実行時に明示するようにしています。環境の既定値に任せていると、世代交代のタイミングで、気づかないうちに別のモデルで動き始めます。品質が落ちても誰も見ていない時間帯に起きるので、事故としては発見が遅れます。新しいモデルが出たときに「黙って切り替わらない」状態を保っておくのが、新モデルを落ち着いて評価できる前提条件です。
2つ目は、ベンチマークではなく自分のタスクで比べること。 公開されているスコアは、自分の仕事とは別の問題を解いた結果です。私はモデルを入れ替えるとき、実際に同じ指示を同じ素材で流して、出力を並べて読みます。ベンチマークで数ポイント上のモデルが、自分の用途では明確に劣ることもあるので、入れ替えの判断は必ず自分の素材で確かめます。
3つ目は、小型モデルの価格改定のほうが実務への影響が大きいこと。 大型モデルの最高性能が上がるニュースは目立ちますが、定型処理を大量に回す現場では、小型で安いモデルの条件が変わるほうが月額に直接響きます。価格の条件が区切りで変わる場合はなおさらで、その実例は小型モデルの料金と使い分けで扱いました。新モデルの発表を見たら、自社の処理のうち一番本数が多い処理にそれが効くかを先に考える——これが私の優先順位です。
Beamについて言えば、現時点でやったことは「候補として記録した」だけです。重みが公開され、使っている実行環境で動く形になった時点で、自分のタスクを流して判断します。発表の日に評価を確定させないのは、消極的な態度ではなく、確定できる材料がまだ無いからです。
中小企業にとって、オープンウェイトは何の選択肢なのか
ここまで慎重な書き方をしてきましたが、オープンウェイトモデルの意味そのものは小さくありません。中小企業の立場で整理すると、価値が出るのは次のような場面です。
場面 | オープンウェイトの意味 | 注意点 |
|---|---|---|
データを外部に出せない業務 | 自社管理の環境内で完結させられる | 機材・運用体制の費用が別途かかる |
特定業務への作り込み | 追加学習で自社業務に寄せられる | 学習データの整備が実作業の大半になる |
提供終了・仕様変更のリスク | 手元に重みがあれば使い続けられる | 保守・セキュリティ更新は自社負担 |
単価の引き下げ | 市場全体の価格水準を押し下げる | 自社が直接運用する必要はない |
見落とされやすいのは最後の行です。オープンウェイトモデルの恩恵の大部分は、自分で動かさなくても受け取れます。有力なオープンモデルが出れば、商用APIの価格と性能の水準がそれに引っ張られるからです。「オープンウェイトだから自社で動かすべき」という結論に飛ばず、自社で動かす必要が本当にあるのはどの業務かを先に特定する。そこを詰めずに自前運用へ進むと、機材と人手の費用が、浮かせたはずのAPI費用を上回ります。
なお、本稿の比較表にも登場したDeepSeek V4.1 Flashのように、オープン系モデルを実務でどう使い分けるかという観点は料金と旧モデルの扱いから見たモデル選択に整理しています。
まとめ
Reflection AIのBeamは、2026年10月5日に発表された総パラメータ501B・アクティブ23Bのスパース MoEモデルで、Apache 2.0での重み公開が今月中に予告されています。公式の主張は「GLM-5.2と同等のスコアを3〜4分の1の推論計算量で」という効率面にあり、絶対性能で先頭を取るという話ではありません。
本稿執筆時点(2026年10月8日)で押さえるべき点は4つです。
- 重みはまだ公開されていない。入手経路は早期アクセスの待機リストのみで、「オープンウェイト」はライセンス方針の話であって配布状況の話ではない
- 公開されている数値はすべてベンダー自己申告で、独立検証は未実施。方向性の参考に留める
- 勝ち負けは分野で割れている。GLM-5.2に対してコーディング・ツール呼び出しで上、推論系では下。さらにGLM-5.3・Kimi K3には多くの項目で届いていない
- アクティブ23Bは計算量の話で、メモリは総パラメータ基準。501Bの重みはINT8換算でも概算500GB規模で、手元の1台に載る規模ではない
そして、この4点を確認する手順自体は、Beamに限らずどの新モデルにも使えます。①今日手に入るか ②その数字は誰が測ったか ③比較相手は何世代前か ④自社の環境で動くか。この順番で見て、1つ目で止まったものは記録だけして先に進まない。新モデルの発表が週単位で続く状況では、この割り切りが判断の速さと正確さの両方を支えます。
どのモデルをどの業務に割り当てるか、自前運用とAPI利用のどちらが自社の処理量に合うかは、処理の本数と扱うデータの性質で変わります。私たちは中小企業のAI活用を、こうしたモデル選定や運用設計の段階から月額で伴走する形で支援しています。自社の業務に当てはめた判断をご希望の方は、AI活用の伴走支援をご覧ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。