DeepSeek V4.1-Flashとは|料金と旧モデルの扱い

「モデル名は一文字も変えていないのに、返ってくる答えの質が変わった気がする」——AIをAPI経由で業務に組み込んでいると、ときどきこの違和感に出会います。
結論から言うと、モデル名が通ることと、同じモデルが応答することは別です。DeepSeekが2026年9月10日に公開した「DeepSeek-V4.1-Flash」では、旧世代の名前を受け付けたまま、その裏で応答するモデルを入れ替える措置が取られました。さらに、いったん告知された統合の予定が、期日の直前に撤回されています。
株式会社Fyveは、AIを常時動かす無人の定型ジョブを運用しており、まさに「どのモデルが動いているつもりか」を取り違えて失敗した経験があります。この記事では、V4.1-Flashの中身と料金を整理したうえで、モデルの指定をどこに置くべきかという運用の話まで踏み込みます。
DeepSeek V4.1-Flashとは(2026年9月10日公開)
DeepSeek-V4.1-Flashは、DeepSeekが「新しいアーキテクチャ系列の最小モデル」と位置づけて公開したマルチモーダル(画像と文章の両方を扱える)モデルです。公式のニュースページは2026年9月10日付で、新しい料金は同日04:00 UTCから適用されたと明記されています。
主なスペック
公開されているモデルカードと、APIドキュメントの記載を突き合わせると、主な仕様は次のとおりです。
項目 | 内容 |
|---|---|
API上のモデル名 |
|
パラメータ規模 | 552B のMoE(混合エキスパート)構成 |
1トークンあたりの活性パラメータ | 入力処理時 8B / 出力生成時 16B |
コンテキスト長 | 1M(100万)トークン |
最大出力 | 384Kトークン |
画像入力 | 対応(ネイティブ) |
思考モード | 思考あり(既定)/思考なしの両対応 |
ライセンス(公開重み) | MIT License |
同時実行の上限 | 2,500( |
「552Bなのに活性8B」が、このモデルの設計の要点です。入力を処理する段階では1トークンあたり8Bぶん、出力を生成する段階では16Bぶんのパラメータしか動きません。入力が長くなりがちなエージェント用途でコストが効きやすい構造になっています。
MoEという用語は、モデル内部を複数の「専門家」に分け、入力に応じて一部だけを動かす方式を指します。モデル全体は大きいのに、1回の処理で動く部分は小さく抑えられる、というのが利点です。
料金(2026年9月13日時点)
料金は100万トークンあたりの単価で、しかもピーク帯と閑散帯(オフピーク)で2倍違います。閑散帯の単価はピーク帯の50%と明記されています。
区分 | deepseek-flash(閑散帯) | deepseek-flash(ピーク帯) |
|---|---|---|
入力・キャッシュヒット | $0.003 | $0.006 |
入力・キャッシュミス | $0.15 | $0.3 |
出力 | $0.6 | $1.2 |
報道などで見かける「入力100万トークン0.15ドル」という数字は、キャッシュミス時・かつ閑散帯の単価です。ピーク帯なら0.3ドルになりますし、キャッシュが効けば0.003ドルまで下がります。1つの数字だけを取り出すと、実際の請求額とはかなりずれます。
ピーク帯は月曜から金曜の01:00〜04:00 UTCと06:00〜10:00 UTC、それ以外は閑散帯です。日本時間に直すと、おおむね10時〜13時と15時〜19時——つまり日本の業務時間の真ん中がピーク帯に当たります。この時間帯別料金そのものの考え方は、以前DeepSeekが時間帯別料金を導入したときに詳しく書いたので、重い処理を時間で逃がす設計はそちらを参照してください。
なお価格は変動します。上記は2026年9月13日時点で公式のモデル・料金ページに記載されていた数字です。契約や試算の前に、必ず最新の公式料金ページでご確認ください(DeepSeek公式: Models & Pricing)。
上限はトークンではなく「同時実行数」で決まる
料金表には、見落としやすい行がもう1つあります。同時実行の上限(Concurrency Limit)です。deepseek-flashが2,500、deepseek-v4-proが500と、5倍の差が付いています。
この数字が効いてくるのは、業務でAIを回す設計をするときです。1日に処理したい件数からトークン量を見積もる人は多いのですが、実際に詰まるのは「同じ瞬間にいくつ走っているか」のほうです。夜間に1,000件をまとめて処理しようとすると、総トークン量には余裕があっても同時実行の上限に当たります。
逆に言えば、この上限は設計の自由度でもあります。上限が5倍あるということは、1件あたりを速く終わらせる代わりに並べて流す、という組み方が取りやすいということです。私の運用でも、重い処理は「並列度をいくつにするか」を先に決めてから件数を割り当てています。
推論の努力量を1〜100で指定できる
もう1つ実務的に効くのが、推論にかける努力量を1から100の整数で連続的に指定できるという仕様です(モデルカードに記載。同カードのInstructモデルのベンチマークは最大値の100で測定されたと明記されています)。
「高精度モード」と「高速モード」の二択ではなく、連続的な目盛りになっているのが実用上の違いです。同じ処理でも、下書きを作る段階は低く、最終確認は高く、といった振り分けができます。コストと精度のトレードオフを、工程ごとに別の値で決められるという意味です。
ベンチマークの数字が最大値で測られている点は、読むときに注意が必要です。公開値と同じ精度を期待するなら同じ設定が必要になり、その場合のコストは低い設定のときとは変わってきます。
設計の主眼は、賢さよりKVキャッシュの圧縮
モデルカードの題は「Pushing the Limits of KV Cache Compression(KVキャッシュ圧縮の限界を押し広げる)」です。つまりこのモデルの主眼は、ベンチマークの点数よりもメモリの使用量を削ることにあります。
KVキャッシュとは、長い文脈を扱うときにモデルが「すでに読んだ部分」を保持しておく作業メモリのことです。文脈が長くなるほど膨らみ、そのまま費用と速度に跳ね返ります。公式の説明では、前世代と比べて必要な高速メモリ(HBM)は約1/4、SSDの保存量は約1/8になったとされ、モデルカードでは1トークンあたり890バイトという数字が示されています。
ここが重要なのは、キャッシュヒット時の課金が、エージェント型の使い方では請求額の大きな割合を占めるという点です。公式もその前提でキャッシュ圧縮を費用削減の手段として説明しています。長い指示や大きなコードベースを何度も読ませる使い方をしているなら、効きやすい改善だと言えます。
旧モデル名は生きている。ただし応答するモデルは退役済み
ここからが、この更新でいちばん実務に効く部分です。
公式は、旧世代のdeepseek-v4-flashとdeepseek-v4-flash-vision-expについて「退役した(retired)」と明言しています。ただし名前は引き続き受け付けられ、その要求はV4.1-Flashが処理し、Flashの価格で課金されます。
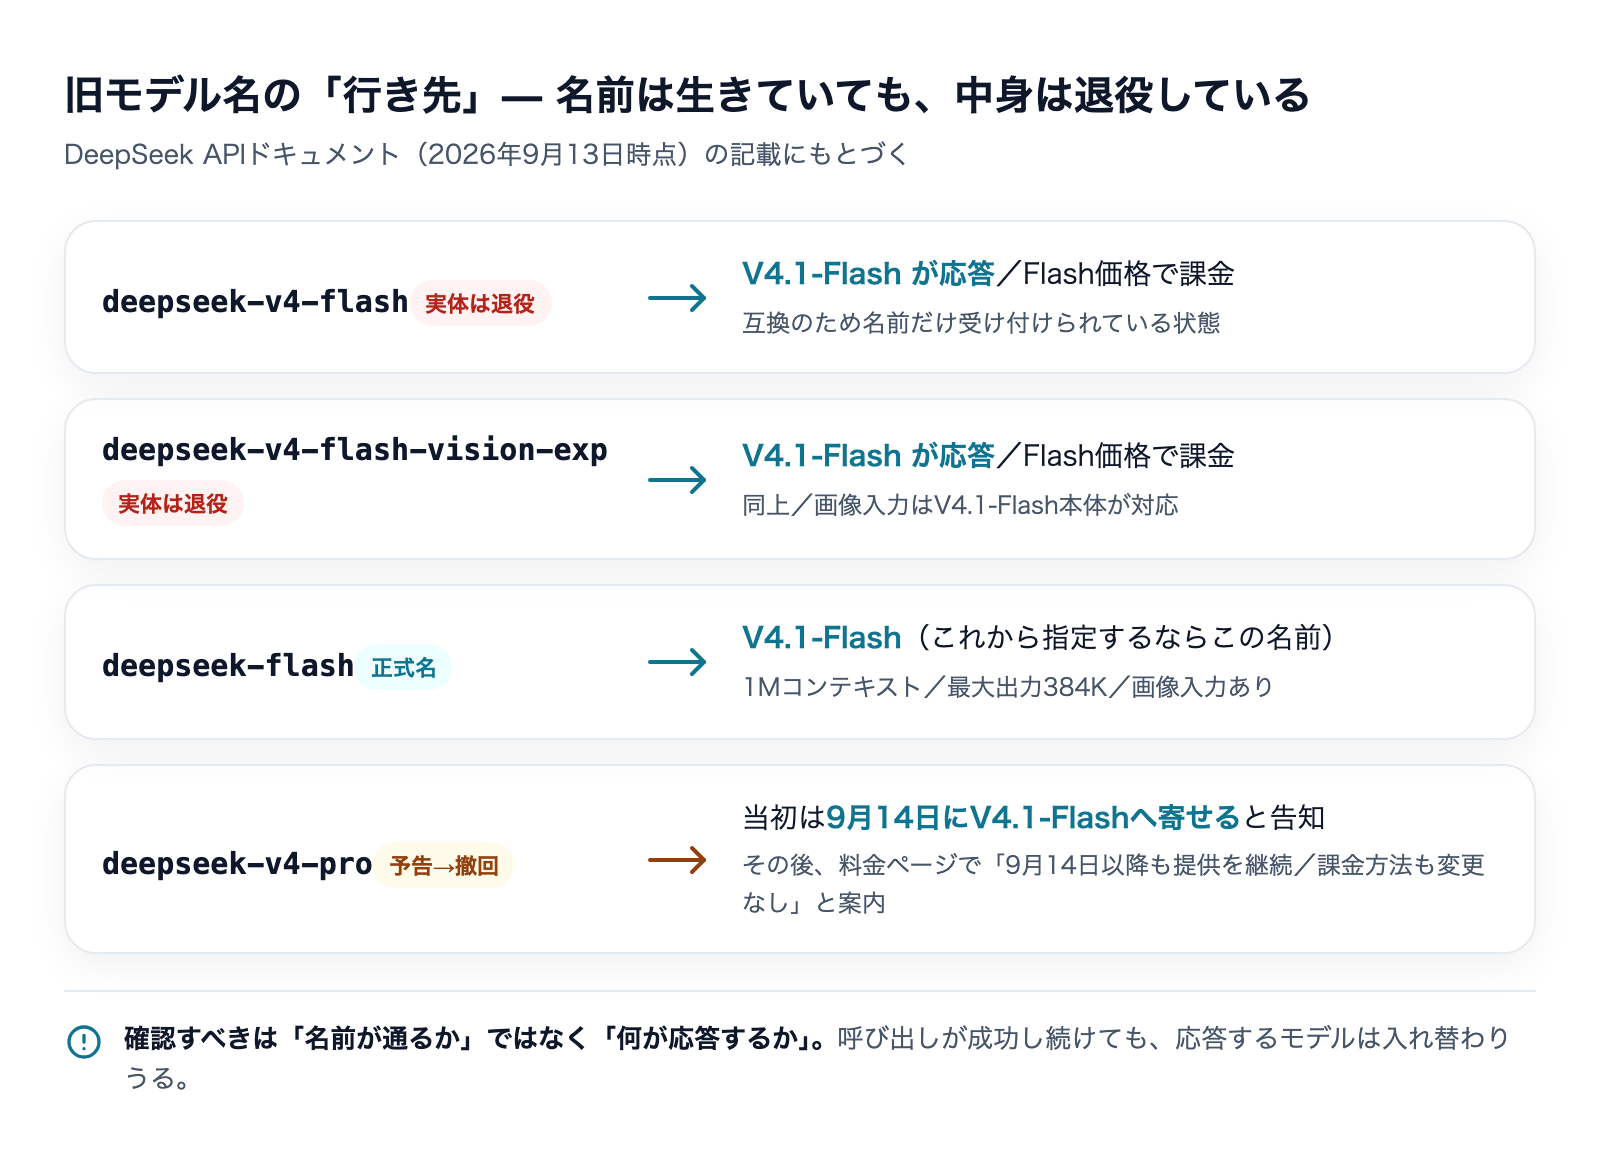
「呼べる」と「同じものが返る」は別
この形の変更が厄介なのは、何もエラーが出ないことです。
APIの提供が終了する場合は、呼び出しが失敗します。失敗すればログに残り、監視が鳴り、誰かが気づきます。一方で今回のように名前だけが生き残る場合、呼び出しは200で返り続け、課金も続き、ただ応答の中身だけが変わります。気づく手がかりは「なんとなく結果が違う」という感覚しかありません。
AIの提供終了そのものへの備え方はAIのAPI提供終了に備える記事で手順としてまとめていますが、あの記事が扱っているのは「止まる日」です。今回は止まりません。止まらないまま中身が変わるほうが、棚卸しの網から漏れやすいという意味では厄介です。
乗り換えるときに引っかかる差分
deepseek-v4-proからFlash系へ移す場合、単価と性能以外にも見ておく差分があります。
- 画像入力の有無が逆転する。料金ページの機能表では、V4.1-Flashは画像入力に対応、
deepseek-v4-proは非対応です。Proを使っていた処理には画像が入っていないはずなので、移行で失われる機能ではなく、増える機能として扱えます - 接続先の形式は2つ用意されている。OpenAI形式(
https://api.deepseek.com)とAnthropic形式(https://api.deepseek.com/anthropic)の両方が公式に案内されています。既存のクライアントをそのまま向けられる場合があるため、移行コストの見積もりが変わります - 思考モードの既定が「思考あり」。既定で思考モードが有効なため、出力トークンが想定より増えることがあります。切り替え方は公式ドキュメントに別項があります
9月14日の統合予告は、いったん撤回された
さらに、この件には続きがあります。
9月10日付の公式ニュースページには、「2026年9月14日04:00 UTCから、すべてのdeepseek-v4-proへの要求をV4.1-Flashへ、V4.1-Flashの料金で回す」と書かれています。同じページには「V4-Proは段階的に終了させる(phasing out)」という記述もあります。
公式の2ページが、いま食い違っている
ところが、2026年9月13日時点の公式料金ページには、こう追記されています。
「利用者の要望を受け、2026年9月14日以降もDeepSeek V4 ProのAPI提供を継続することを決定しました。課金方法も変更ありません。変更がある場合は改めて告知します」(要旨。原文は英語)
つまり、同じ提供元の2つの公式ページが、期日の前日時点で逆のことを書いています。ニュースページは「9月14日に寄せる」と告知したまま残り、料金ページは「継続する」と案内している状態です。料金ページにはdeepseek-v4-proの単価も引き続き掲載されています。
私がここから引き出した教訓は、ひとつだけです。告知は一度読んで終わりにできない。読んだ内容が正しかったとしても、その後で覆ることがあります。しかも覆った事実は、最初に読んだページのほうには反映されないことがあります。
撤回の理由は公式には「利用者の要望」とだけ書かれています。推測を断定で書くことはしませんが、公開されているベンチマークの内訳を見ると、どういう要望だったのかは察しがつきます。
「平均で勝つ」と「自分の用途で勝つ」は違う
公式は「複数者によるテストで、V4.1-FlashはV4-Proを性能・コスト・速度・総実行時間で上回った」と述べています(原文は "Tests by multiple parties"。第三者に限るとは書かれていません)。ところが、同じDeepSeekが公開しているモデルカードの数字を項目別に見ると、勝ち負けはきれいに分かれます。
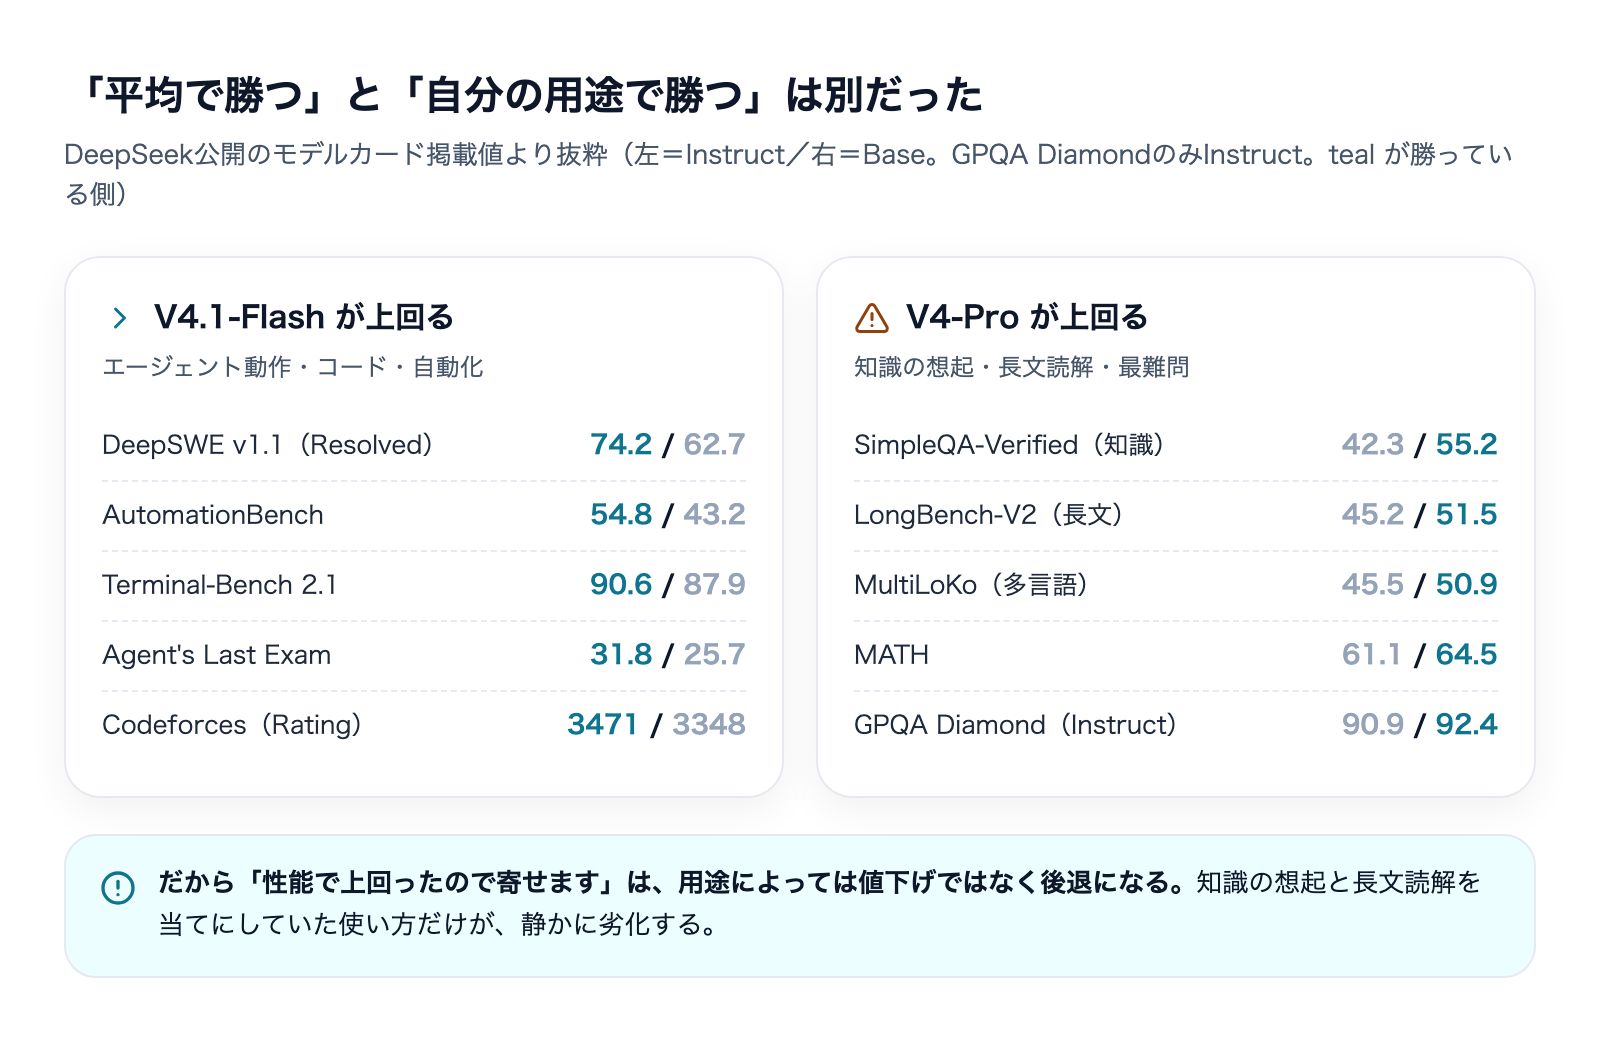
エージェント的な作業やコード関連では、V4.1-Flashが明確に上回っています。ソフトウェア課題の解決率(DeepSWE v1.1)は62.7から74.2へ、自動化タスク(AutomationBench)は43.2から54.8へと、いずれも10ポイント以上の差です。
一方で、知識を正確に思い出す力と、長い文書を読み解く力では、V4-Proのほうが上のままです。事実想起(SimpleQA-Verified)は55.2に対して42.3、長文読解(LongBench-V2)は51.5に対して45.2。どちらも小さくない差です。
なお、いま挙げた数字のうち前段のDeepSWEとAutomationBenchは指示調整済み(Instruct)モデルの表、後段のSimpleQA-VerifiedとLongBench-V2は素のモデル(Base)の表の値です。別の表をまたいで並べているので、厳密な同条件の比較ではありません。傾向として「エージェント寄りは新モデル、知識と長文は旧上位モデル」と読んでください。
ここに、モデルを勝手に寄せられることの怖さが出ます。コードを書かせていた人にとっては値下げと性能向上でも、社内文書を大量に読ませて事実を答えさせていた人にとっては、静かな劣化になりえたということです。撤回の判断は、おそらくこの層の声によるものでしょう。
言い換えると、「総合で上回った」という説明は、平均の話をしています。自分の用途がその平均のどこに位置するかは、自分で測らないと分かりません。
「1Mトークン対応」と「長文が読める」も別の話
ここで一見矛盾して見えるのが、1Mトークンのコンテキストに対応しているのに、長文読解のベンチマークでは前世代の上位モデルに負けているという点です。
モデルカードの学習過程の記述が、この2つを整合させてくれます。事前学習は45Tトークン規模のマルチモーダルなデータで行われ、疎な注意機構の学習はまず64Kの長さで進められ、1Mトークンまで文脈が拡張されたのは34Tトークンの時点と書かれています。つまり全体の学習のうち、最長の文脈で鍛えられたのは後半の一部です。
これは欠陥という話ではなく、仕様表の「対応」は入力を受け付ける上限であって、その長さで精度が保たれる保証ではないということです。100万トークン入るからといって、100万トークンぶんを正確に読み解けるとは書かれていません。
長い資料をまとめて読ませる用途を考えているなら、ここは仕様表ではなく自分の資料で確かめるべき箇所です。手元の代表的な文書を実際に入れて、答えの正確さを見る。これは後述する「出力の基準を1つ作る」と同じ作業です。
私が無人運用で踏んだ、同じ型の失敗
ここまでは提供元側の話ですが、「動いているつもりのモデルと、実際に動いているモデルがずれる」事故は、自分の設定でも起こります。私は実際に2回踏みました。
モデル名を2か所に書いていたら、世代がずれた
私は、AIが無人で文章を作り、別のジョブがそれを機械的に点検する、という2段構えの定型処理を毎日動かしています。2026年8月12日に見つけたのは、この2つのジョブが違う世代のモデルで動いていたという事実でした。
原因は単純です。作る側のモデルは起動スクリプトの設定で指定していたのに、点検する側のモデル名だけ手順書の中に直接書き込んでいました。世代を上げるとき、起動スクリプト側は更新したのに、手順書の中の1行を更新し忘れた。それだけです。
エラーは出ません。どちらのジョブも正常終了します。ただ、点検する側が一世代前の判断力で見ている状態が続きます。対策として、モデルの指定は起動側の1か所だけに集約し、手順書の側には「モデル名を書かない」というルールを明記しました。
暗黙の既定に依存した経路は、静かに壊れる
もうひとつは、同じ日に起きた別の失敗です。点検側のジョブを動かすための認証情報を、私は「親の処理から自動で受け継がれるはず」という前提で組んでいました。実際には受け継がれておらず、別の保存済み認証が偶然代わりに効いていただけでした。
その保存済み認証の有効期限が切れた瞬間、点検のジョブは起動できなくなりました。結果として、25回連続で「判定できませんでした」という状態のまま処理が流れ続けました。これも派手なエラーではなく、静かな停止でした。
2つの失敗の型はまったく同じです。「たぶんこうなっているはず」に依存した箇所が、ある日、黙って別の挙動に変わった。DeepSeekの旧モデル名の話と、構造は同じものです。
いま守っている3つのルール
- 無人で動かす処理では、必ずモデルを明示する。未指定にして環境の既定値に任せることを禁止にしています。既定値は、こちらの合意なく変わりうるものだからです
- モデル指定の置き場所は1か所に限る。2か所に書けるということは、2か所がずれるということです
- 定型処理には「下限のモデル」を決めておく。コストのために軽いモデルへ落とす判断はしますが、下限は越えさせません
どこからモデルを買うか(提供元と直接契約するか、ゲートウェイ経由にするか)という一段上の選び方はAIゲートウェイの判断をまとめた記事に、機密性の高い工程を手元のマシンへ寄せる考え方はクラウドと手元の切り分けの記事に整理しています。
今週やる5つの確認
DeepSeekを使っていない場合でも、同じ確認は他の提供元に対して有効です。
- 1. 呼び出しているモデル名を全部書き出す。自分で書いたコードだけでなく、外注して作ってもらった仕組み、業務ツールの連携設定、社内の誰かが作った自動化まで含めて洗い出します
- 2. その名前が「現行の正式名」か確認する。旧名・別名・実験版の名前で呼んでいないか。今回のケースなら
deepseek-v4-flash系がそれに当たり、現行名はdeepseek-flashです - 3. バージョンが固定されているか見る。提供元が日付付きの固定版を出しているなら、重要な処理はそちらを指定します。固定できない場合は「いつ変わってもおかしくない」前提で設計します
- 4. 出力の基準を1つ作る。代表的な入力を5〜10件決めて、期待する答えを控えておきます。中身が入れ替わったとき、これがないと「なんとなく違う」で終わってしまいます
- 5. 告知の窓口を2か所見る。今回のように、ニュースページと料金ページで内容が食い違うことがあります。片方だけを信じないという意味でも、2か所です
費用の話として言えば、いちばん効くのは項目2と項目3です。旧名で呼び続けている処理は、課金だけ新しい価格で、応答は自分が選んだわけではないモデルから返ってきている可能性があります。
よくある質問
旧モデル名のまま呼び続けて問題はありますか
当面は動きます。公式も互換のために名前を受け付けると説明しています。ただし公式のニュースページには「一時的に(temporarily)」という語が使われており、いつまで受け付けられるかは示されていません。いま動いていることを根拠に放置するのは避け、現行名へ切り替えることをおすすめします。
入力100万トークン0.15ドルは、業界で最安ということですか
その数字は閑散帯・キャッシュミス時の単価なので、単体で最安と比較するのは適切ではありません。比較するなら、自分の使い方でのキャッシュヒット率、処理が走る時間帯、入力と出力の比率まで揃えて試算する必要があります。同じ提供元の中でも、キャッシュが効くかどうかで50倍の差(0.003ドルと0.15ドル)が付きます。
重みが公開されているなら、自分で固定できますか
モデルカードではMITライセンスで公開されているため、自分の環境で動かせば「勝手に入れ替わる」問題は原理的に起きません。ただしこの規模のモデルを自前で動かす負担は小さくなく、公式自身が大規模な構成についてはGPUの台数規模で相談する話を持ち出しています。API経由の手軽さと、自分で固定できることのどちらを取るかという選択です。
V4-Proは結局どうなるのですか
2026年9月13日時点では、公式料金ページが「9月14日以降も提供を継続する」と案内しています。一方でニュースページには「段階的に終了させる」「V4.1-Proが出るまでの措置」という記述も残っています。継続は決定というより、当面の措置と読むのが妥当でしょう。V4-Proに依存している処理があるなら、移行先の検討は始めておくほうが安全です。
まとめ
DeepSeek-V4.1-Flashは、552BのMoEで活性パラメータを入力8B・出力16Bに抑え、KVキャッシュを前世代の約1/4に圧縮した、コスト効率を主眼に置いたモデルです。1Mトークンの文脈と画像入力に対応し、重みはMITライセンスで公開されています。エージェント的な作業とコードでは前世代の上位モデルを上回りますが、知識の想起と長文読解では下回ります。
ただ、この更新からいちばん持ち帰るべきなのは、スペックではないと思っています。旧モデル名が生きたまま中身が入れ替わり、統合の予告が期日前日に覆り、2つの公式ページが食い違っている——この状態が、AIを業務に組み込むうえでの通常だということです。
だから確認すべき問いは「そのモデル名は通るか」ではなく、「いま実際に応答しているのは何か」になります。自分の設定の中で、モデル名を書いた場所が2か所以上ないか。未指定のまま環境の既定値に任せている処理はないか。出力が変わったときに気づける基準を持っているか。
私たちが無人運用で踏んだ2つの失敗は、どちらも「たぶんこうなっているはず」に依存した箇所から起きました。株式会社Fyveでは、こうした運用の勘所を含めて、中小企業のAI活用を月額で伴走する形で支援しています。モデルの選定や費用の試算でつまずいている段階であれば、そこから一緒に整理していきます。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。