Mistral Large 4とは|性能・料金と乗り換え判断

「Mistral Large 4がClaude Opus 5.5を上回った」「セキュリティ分野で世界1位」——2026年10月6日の公開プレビュー発表以降、こうした見出しが並びました。自社のAIを乗り換えるべきか、と考えた方も多いはずです。
結論から言うと、話題になっている「82%」は能力の勝利ではなく、各社の方針の違いが数字に化けたものです。総合的な知能指標ではまだ明確な差があり、主力モデルを乗り換える理由にはなりません。ただし「重みが手元に来る」という一点だけは、一部の会社にとって本物の価値があります。
株式会社Fyveは中小企業のAI導入を月額で伴走しており、私自身も日々の業務のほぼ全てをAIで回しています。この記事では公式発表と独立評価を突き合わせ、2026年10月7日時点で分かっていること、まだ分かっていないこと、そして実務で何をすべきかを整理します。
Mistral Large 4(Le Chonk)とは
Mistral Large 4は、フランスのMistral AIが2026年10月6日に公開プレビューとして発表した汎用マルチモーダルモデルです。「le Chonk」という愛称が公式に付けられています。
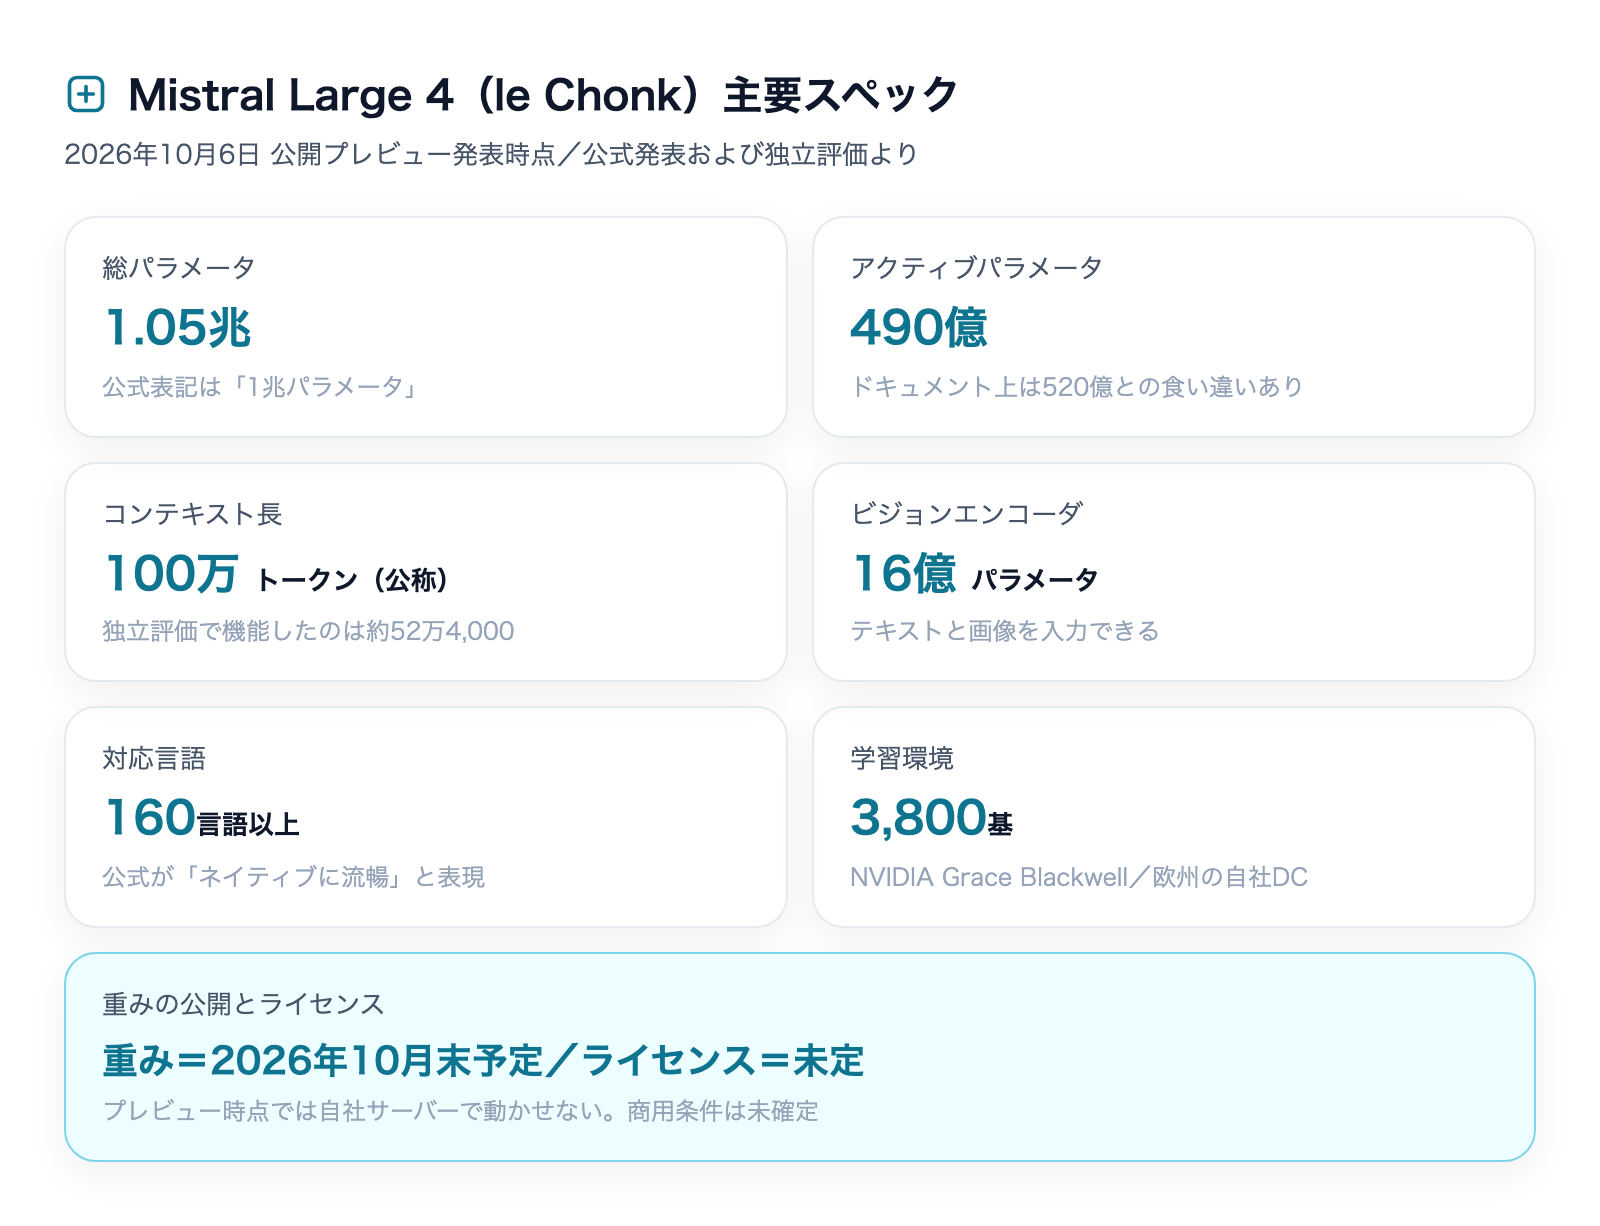
公式発表によると、総パラメータ数は1兆クラス、そのうち1トークンあたりに実際に動くのは490億パラメータです。全体のうち5%程度しか使わない「粒度の細かいMixture-of-Experts(MoE)」という構造で、1兆パラメータ級の規模を中位価格帯で提供できる理屈になっています。
主要スペック
- 総パラメータ: 1.05兆(公式表記は「1兆パラメータ」)
- アクティブパラメータ: 490億
- ビジョンエンコーダ: 16億パラメータ(テキストと画像を入力できる)
- コンテキスト長: 100万トークン(公称)
- 対応言語: 160言語以上に「ネイティブに流暢」と公式が表現
- 学習環境: NVIDIA Grace Blackwell GPU 3,800基、Mistral自社の欧州データセンター
学習を欧州の自社データセンターで完結させたことを、Mistralは明確に打ち出しています。これは性能の話ではなく、データの所在地を気にする顧客に向けた設計思想の表明です。
「アクティブ490億」の読み方に注意する
MoE構造のモデルで最も誤解されやすいのが、このアクティブパラメータという数字です。「490億しか動かないなら、490億規模のモデルと同じ感覚で扱える」と考えると、2か所で判断を間違えます。
1つ目は必要なメモリ量です。1トークンごとに使うのは490億分でも、どの専門家(エキスパート)が呼ばれるかは入力次第なので、1.05兆パラメータ分すべてを読み込んでおく必要があります。動かすのに必要なのは「490億分のメモリ」ではなく「1.05兆分のメモリ」です。
2つ目は品質の期待値です。逆に性能面では、1.05兆の規模そのままではなく、実際に働く490億相当に近い振る舞いをする場面があります。MoEは「安く大きく見せる」構造であって、「大きいまま安くなる」構造ではありません。
この2つを合わせると、MoEモデルの立ち位置が見えてきます。APIで使う分には価格面の恩恵が大きく、自社で動かそうとすると規模の重さがそのまま効く——これが実務上の結論です。
「公開プレビュー」と「重み公開」は別の話
ここが混乱しやすい点です。2026年10月6日に始まったのはAPI経由の公開プレビューで、モデルの重み(ウェイト)が配布されるのは2026年10月末の予定とされています。つまり発表時点では自社サーバーで動かすことはできません。
さらに重要なのが、ライセンスがまだ決まっていないという点です。Mistralは重みと同時にアーキテクチャの詳細・ライセンス・事後学習の手法を公開する予定だと説明しています。過去のMistral Large 3はApache 2.0、Medium 3.5は修正MITでしたが、Large 4がどうなるかは発表されていません。
「オープンウェイトだから自由に商用利用できる」と前提を置いて計画を立てるのは、現時点では危険です。
「セキュリティでOpus 5.5を上回った82%」の正体
今回いちばん拡散したのが、この数字です。結論を先に書くと、この82%は「Mistralができること」と「他社がやらないこと」を同じ軸に並べた結果です。順を追って説明します。
何を測ったベンチマークなのか
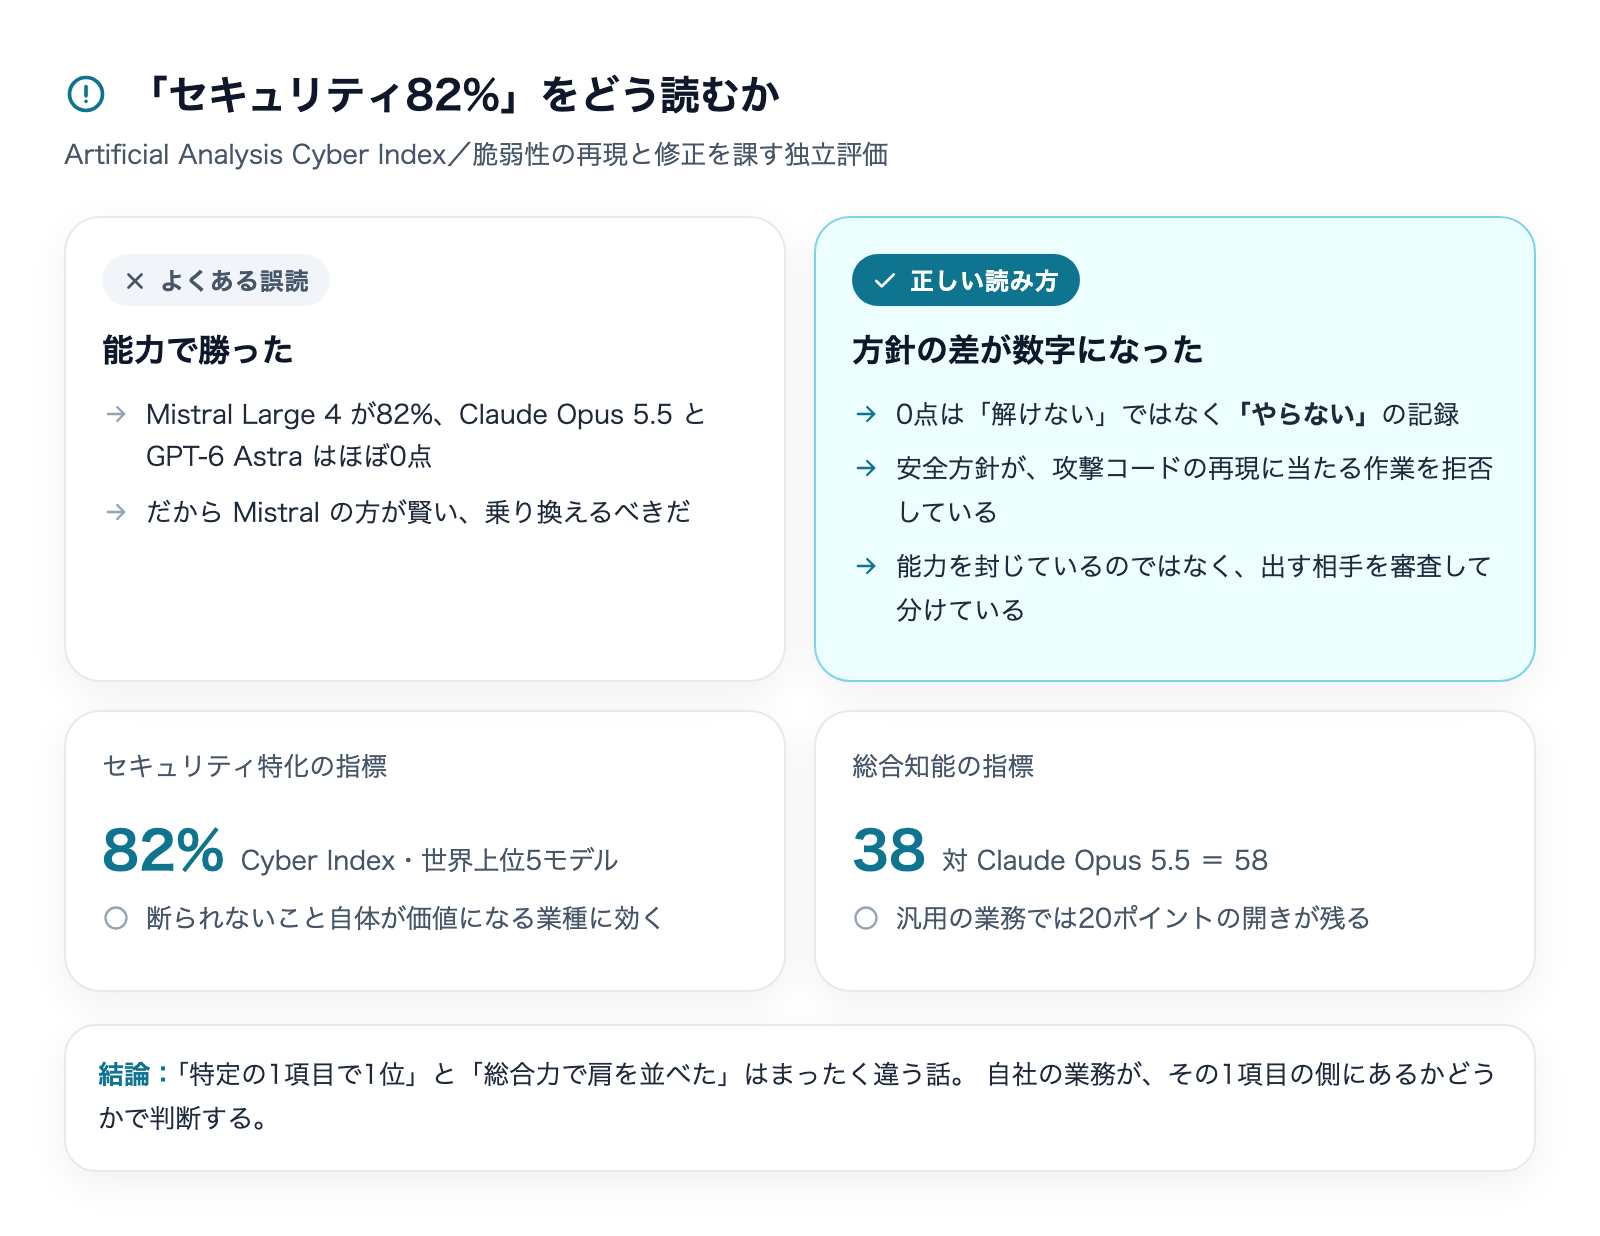
出所はArtificial Analysis社のCyber Indexという独立評価です。オープンソースソフトウェアに実在する脆弱性をモデルに再現させ、さらに修正させるという課題で、Mistral Large 4は82%を記録し、同指標で世界上位5モデルに入ったと報じられています。より細かい内訳では、CyberGym-E2E-AAという項目で1回の試行での成功率81.7%を記録して首位となり、2位・3位のモデル(78.6%・77.9%)を上回りました。
数字そのものは本物です。問題はここからです。
Opus 5.5とGPT-6 Astraが「ほぼ0点」の理由
同じテストで、Claude Opus 5.5とGPT-6 Astraはほぼ0点でした。しかしその理由は、脆弱性の再現ができなかったからではなく、課題そのものを拒否したからです。安全方針が、攻撃コードの再現に当たる作業をブロックしています。
これはつまり、このベンチマークがモデルの能力と同じくらい、提供元の方針を測っているということです。「0点」は「解けない」ではなく「やらない」の記録です。
私がこの構造を先に知っていた理由
私にとってこの結果は意外ではありませんでした。2026年6月にClaudeのFable 5が公開されたとき、仕様を確認する中でサイバー・生物・化学といった領域の要求が来ると、自動的に下位の安全なモデルへ振り替えられる「安全ルーティング」が組み込まれていることを確認していたからです。ユーザーには通知が出ます。
さらにAnthropicは、安全分類器を外した上位版を一般公開せず、審査を通した組織にだけ別チャネルで提供する形を取っています。能力を封じているのではなく、出す相手を選んで分けているという構造です。この仕組みについては別記事で詳しく整理しています。
Claude Mythos 5とは|モデルを渡さず能力だけ配る
この前提を知っていると、今回の「Mistralが1位、Claudeは0点」という並びがどう見えるかが変わります。一般公開の窓口で測れば0点になるのは当たり前で、それは能力の優劣の証明になっていません。
では82%に意味はないのか
意味はあります。ただし意味の種類が違います。
これは「セキュリティ検証の作業を、審査なしの通常のAPIで引き受けてくれるモデルが存在する」という意味です。脆弱性診断やコード監査を業務にしている会社にとっては、方針で断られないこと自体が実用上の価値になります。逆に一般的な中小企業の業務では、この82%が効く場面はまずありません。
Mistral Large 4は、攻撃への耐性を測るB3 Attack Resistanceで93.3%、Cybenchで93%という数字も公式に出しています。拒否しないことと無防備であることは別だ、という主張です。
総合力では、まだ明確な差がある
セキュリティの見出しに隠れがちですが、汎用的な知能を測る指標では差がはっきり出ています。
主なベンチマーク(独立評価・2026年10月時点の報道ベース)
指標 | Mistral Large 4 | 比較対象 |
|---|---|---|
Intelligence Index(総合知能) | 38 | Claude Opus 5.5: 58 / Gemini 4 Argon: 53 |
DeepSWE v1.1(ソフトウェア工学) | 61.7% | GLM-5.3・Kimi K3: 69% |
Terminal-Bench 4.0 | 28.3% | — |
Finance Agent v2 | 54.7% | GLM-5.3: 55.8% / GPT-6 Astra: 53.5% |
SciCode-Verified | 91.8% | GLM-5.3: 92.5% / Qwen3.8: 93.8% |
Harvey's Legal Agent(法務) | 15.83% | Muse Spark 1.2: 25.42% / Gemini 4 Argon: 19.58% |
Dense 200(画像の位置把握) | 42% | GPT-6 Astra: 41% |
総合知能で38対58は、20ポイントの開きです。画像の位置把握では競合をわずかに上回り、金融・科学系の課題ではほぼ横並びにつけていますが、法務エージェントのような長い手順を要する課題では大きく離されています。
「特定の1項目で1位」と「総合力で肩を並べた」は、まったく違う話です。
コンテキスト100万トークンにも但し書きがある
公称100万トークンですが、独立した評価では実際に機能する長さは約52万4,000トークンだったと報告されています。また、アクティブパラメータについても公式発表の490億に対してドキュメント上は520億と記載されており、食い違いが指摘されています。
プレビュー段階のモデルでは、こうしたズレは珍しくありません。だからこそ、公称値を前提に設計を決めず、自社の実データで測ってから決める必要があります。
ベンチマークを業務判断にそのまま持ち込まない
私はこれを一度、身をもって学びました。
2026年6月に公開されたClaudeのFable 5は、SWE-bench Verifiedで95.0%という当時の最高水準を記録したモデルでした。数字だけ見れば即乗り換える判断になります。ところが第三者のコードレビュー検証では、33タスクのうち19件がタイムアウトし、レビュー精度は下位モデルを下回るという結果が出ました。
そのとき出てきた指摘が、今も私の判断基準になっています。「トークン単価で評価するのではなく、解決したタスクあたりのコストで評価せよ」です。
ベンチマークは「同じ問題を解かせたときの順位」を示すだけで、「自社の仕事が終わるか」は示しません。この読み方の違いについては、個別モデルの記事でも繰り返し書いています。
料金 — 「半額」は今の価格である
料金はここが最も注意すべき点です。2026年10月7日時点で、2つの価格が並んで報じられています。
- 標準価格: 入力100万トークンあたり1.36ドル/出力100万トークンあたり4.18ドル(Mistral公式の価格表記)
- ローンチ時の割引価格: 標準の50%引きとして、入力0.68ドル/出力2.09ドル。キャッシュ済み入力は0.07ドル
記事やSNSで「入力0.68ドルで1兆パラメータ級が使える」と紹介されているのは、この割引後の数字です。割引の終了時期は公表されておらず、私も確認できていません。「いつまで」と書かれた情報を見かけても、根拠を確かめるまで信じない方が安全です。
価格は変わります。契約や予算化の判断をする前に、必ずMistralの公式価格ページでその時点の条件をご確認ください。
単価の安さは、総額の安さと一致しない
ここで前述の「解決したタスクあたりのコスト」が効いてきます。単価が半分でも、同じ仕事を終えるのに2倍の試行が必要なら総額は変わりません。総合知能で20ポイント下のモデルを使うということは、手戻りや作り直しが増える可能性を引き受けるということです。
参考として、私自身のAI運用コストは2026年8月時点で月額約4万円です。内訳の主軸はClaudeの最上位サブスクリプションで、実働のほぼ全部がそこに乗っています。画像生成を従量課金のAPIからサブスクの枠内に移して、月数千円をゼロにしたこともあります。
この構造で分かるのは、単価表を比べるより「どのプランの枠内で仕事が終わるか」を設計した方が、コストは大きく動くということです。従量課金のモデルを1つ増やすと、安くなるどころか管理対象が増えて総額が上がることもあります。
オープンウェイトに価値があるのは、どんな会社か
ここが今回のMistral Large 4で、唯一「他では代わりが効かない」部分です。
私はモデルが一夜で消える経験をした
2026年6月、私はClaudeのFable 5を中心にWeb制作と業務自動化のワークフローを組み直していました。公開から3日後、米国の輸出管理上の指令を理由に、このモデルは全世界で提供停止になりました。
性能を前提に組んだ手順は、そのモデルがないと同じ成果を出せません。私に残った選択肢は「同等のモデルが再登場するのを待つ」か「ワークフローを根本から作り直す」かの二択でした。
そのとき得た教訓が、1つのモデルの強さに最適化した仕組みは、そのモデルが消えると一緒に崩れるということです。以降は代替モデルへの切り替え先を先に決めておく設計に変えました。この一件の経緯は別記事に残しています。

重みが手元にあると、何が変わるか
重みを自社で保有できれば、提供元の都合で消えることも、値上げされることも、仕様が勝手に変わることもありません。データを社外に出さずに動かすこともできます。欧州で学習を完結させたという設計思想も、同じ関心に応えるものです。
これは「性能がどちらが上か」とはまったく別の価値です。そして価格表を眺めているだけでは見えてきません。
ただし1.05兆パラメータは、中小企業が自社で動かせる規模ではない
現実的な話をします。アクティブが490億とはいえ、総パラメータ1.05兆のモデルを読み込んで動かすには、相応のGPUメモリが必要です。中小企業が社内のサーバー1台で回せる規模ではありません。
「重みが公開される」ことと「自社で動かせる」ことの距離は、思っているより遠いです。規模の小さいモデルで自社運用を検討した場合に何が必要になるかは、こちらで具体的に書いています。
そもそも全部を手元で動かす必要があるのか、という切り分けも先にやっておく価値があります。
乗り換えるべきか — 3つに分けて考える
ここまでを踏まえて、立場別に整理します。
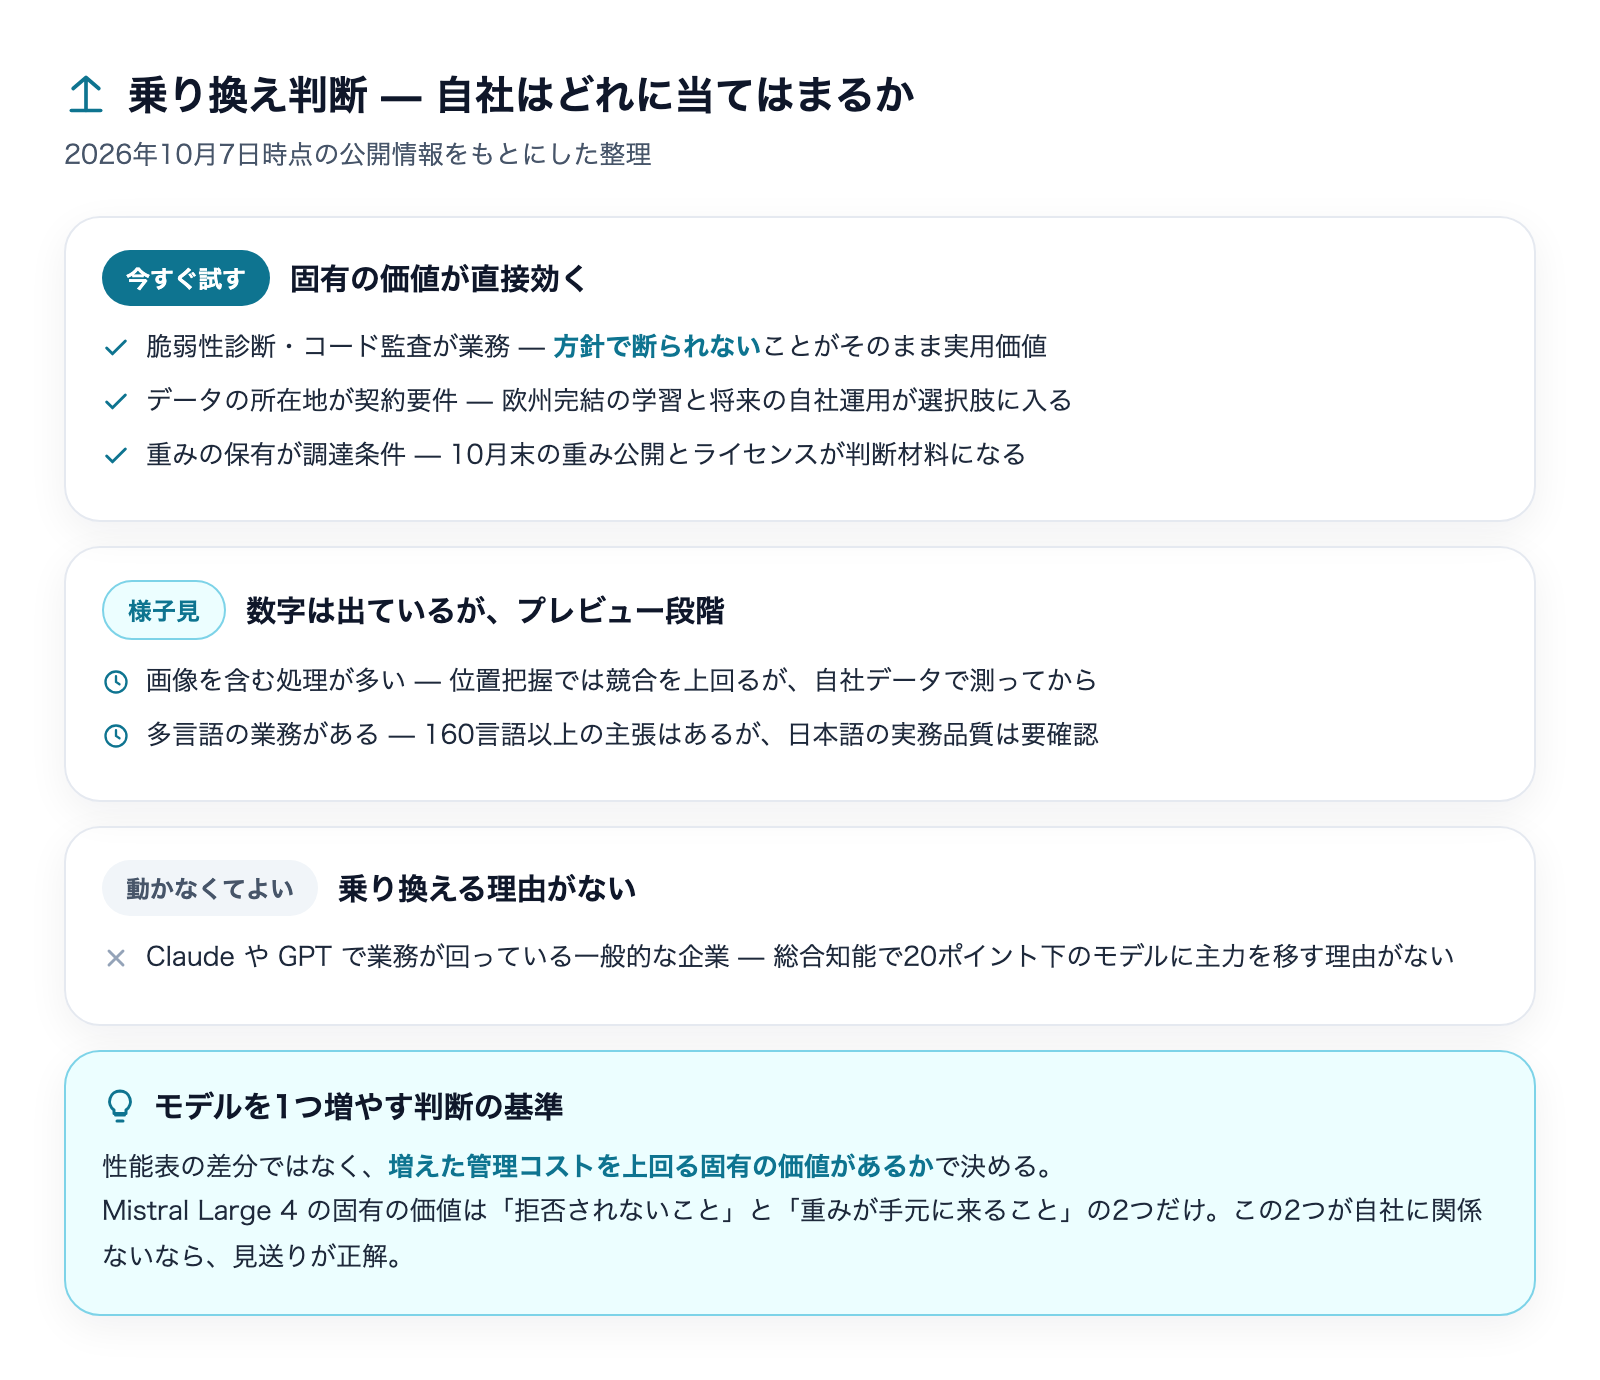
今すぐ試す価値がある
- 脆弱性診断・コード監査を業務にしている: 方針で断られないモデルという価値がそのまま効く。他社モデルで作業が止まっていたなら、試す理由がある
- データの所在地が契約要件になっている: 欧州完結の学習と、将来の自社運用の両方が選択肢に入る
- 重みの保有が調達条件に入っている: 10月末の重み公開とライセンスが、そのまま判断材料になる
様子見でよい
- 画像を含む処理を多く扱っている: 画像の位置把握では競合を上回る数字が出ているが、プレビュー段階。自社データで測ってから
- 多言語の業務がある: 160言語以上という主張は魅力的だが、日本語の実務品質は自分で確かめる必要がある
動かなくてよい
- ClaudeやGPTで業務が回っている一般的な企業: 総合知能で20ポイント下のモデルに主力を移す理由がない
「拒否しないモデル」を社内に入れるときは、先にルールを決める
1つ目のカテゴリに当てはまる会社に、実務的な注意を1点だけ添えます。
方針で断られないモデルは、裏返すと社内の誰が使っても断られないということです。これまでは提供元の安全方針が、意図しない使い方に対する最後の歯止めとして働いていました。その歯止めがない道具を入れるなら、代わりの歯止めを自社で用意する必要があります。
私がクライアントに対してAIの情報漏洩リスクを説明するとき、技術的な対策と並べて必ず伝えているのが「人為的なリスクは技術では止まらないので、人に関するガイドラインを社内で決めてください」という点です。拒否しないモデルは、この原則がそのまま当てはまります。
最低限、決めておくべきことは3つです。
- 誰が使えるか: アカウントを配る範囲を限定し、業務上の必要がある担当者に絞る
- 何に使ってよいか: 自社が管理している資産の検証に限る、など対象の範囲を文書にする
- 記録が残るか: 誰がいつ何を実行したかを後から辿れる状態にしておく
この3つが決まっていない状態で導入すると、便利さと引き換えに説明できないリスクを抱えます。
私自身の結論も最後のカテゴリです。主力は変えません。理由は性能だけではなく、複数のモデルを使い分けると、作業の文脈を受け渡す手間が増えるからです。私はできるだけ1つのモデルに統一する方針を取っています。モデルを1つ増やす判断は、性能表の差分ではなく「増えた管理コストを上回る固有の価値があるか」で決めるべきです。
今回のMistral Large 4で言えば、その固有の価値は「拒否されないこと」と「重みが手元に来ること」の2つに限られます。この2つが自社に関係ないなら、見送りが正解です。
いま実務でやるべき3つのこと
この発表を自社の改善につなげるなら、やることは3つです。
1. 10月末の重み公開とライセンスを確認する
重みが実際に出るか、そしてどのライセンスになるかで、このモデルの意味は大きく変わります。商用利用の条件が確定するまで、自社運用の計画は仮置きにしておきます。
2. 「このモデルが消えたら困る業務」を棚卸しする
これはMistralを使うかどうかとは無関係に、今日からできる作業です。業務ごとに、どのモデルに依存しているか、止まったときの代替が決まっているかを書き出します。私がFable 5の提供停止で痛い思いをしたのは、この棚卸しをしていなかったからです。
代替先を1つ決めておくだけで、次に同じことが起きたときの損害はまったく違います。
3. ベンチマークではなく、自社のタスクで比べる
自社の実際の仕事を3つほど選び、同じ指示を複数のモデルに投げて、できあがりと所要時間を記録します。これだけで「どの指標が自社に関係あるか」が分かります。
手順は難しくありません。半日あれば終わります。
- 課題を3つ選ぶ: 毎週発生していて、人が手でやると時間がかかる仕事を選びます。「よくある質問への返信文を作る」「請求書の内容を表に転記する」「議事録から決定事項だけ抜く」など、結果の良し悪しが自分で判断できるものにします
- 正解を先に用意する: その3つについて、過去に人がやった成果物を手元に置きます。これが採点基準になります。基準なしで出力を眺めると「なんとなく良さそう」で終わります
- 同じ指示文で投げる: 比較するモデルに、一字一句同じ指示を渡します。モデルごとに指示を書き換えると、モデルの差ではなく指示の差を測ることになります
- やり直した回数を数える: 出来上がりの質だけでなく、満足する結果に至るまでに何回指示し直したかを記録します。ここが「解決したタスクあたりのコスト」の実測値になります
4つ目が最も重要で、ベンチマークには絶対に出てこない数字です。1回で通るモデルと3回やり直すモデルでは、単価が半分でも総額は逆転します。
今回のCyber Indexの82%がまさにその例です。世界1位の数字でも、自社の業務に関係しなければ判断材料にはなりません。逆に、順位表に載っていない「自社の書類フォーマットをどれだけ正確に守れるか」の方が、実務では決定的なことがあります。
私も以前、書類の読み取りと文章生成を含むシステムを開発したとき、MistralとOpenAIのモデルを工程ごとに使い分けました。選定の理由は総合ベンチマークの順位ではなく、その工程で求められる精度とコストの釣り合いでした。モデルは「優れている順」ではなく「工程に合う順」で選ぶのが実務です。
まとめ
2026年10月7日時点で、Mistral Large 4について分かっていることを整理します。
- 2026年10月6日に公開プレビュー開始。総パラメータ1.05兆・アクティブ490億のマルチモーダルMoEモデル
- 話題の「セキュリティ82%」は能力差ではなく方針差。競合がほぼ0点なのは拒否しているため
- 総合知能の指標では38対58で、Claude Opus 5.5に明確な差がある
- 料金は標準で入力1.36ドル/出力4.18ドル。流通している安い数字はローンチ割引後で、終了時期は未公表
- 重みの公開は2026年10月末予定、ライセンスは未定。公称100万トークンの文脈長も独立評価では約52万4,000トークン
- 一般的な企業が主力を乗り換える理由はない。価値があるのは「拒否されないこと」と「重みを持てること」が要件になっている会社
新しいモデルが出たとき、順位表を見て乗り換えを考えるのは自然な反応です。けれど実際に効くのは、自社の業務がどのモデルに依存していて、それが止まったとき何が起きるかを把握していることです。順位は毎月入れ替わりますが、この棚卸しは資産として残ります。
どのモデルを使うべきか、自社の業務でどう比較すればいいかを一緒に整理したい場合は、専属AI活用顧問サービスで月額の伴走としてお受けしています。株式会社Fyveは、順位表ではなく御社の工程を基準にした判断をお手伝いします。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。