Googleがバグ報奨を停止した理由|AI生成報告の見分け方

「AIに書かせたレポートが上がってきたが、正しいのか確かめる方が時間がかかる」「外注先の成果物が、読む限り完璧なのに嘘かもしれない」——AIを業務に入れた組織が、必ずどこかでこの壁に当たります。
結論から言うと、問題はAIの精度ではなく「受け入れ工程(インテーク)の設計」です。生成コストがほぼゼロになった一方で、検証コストは人間の時間に張り付いたまま。この非対称が放置されると、受け取る側が先に潰れます。
株式会社Fyveは、自社メディアの記事生成を無人で回しながら、この受け入れ工程を何度も作り直してきました。本記事では2026年10月に起きたGoogleのバグ報奨プログラム停止を入口に、私たちが実際に踏んだ失敗を含めて、現場で機能する検証の組み方をお伝えします。
Googleがバグ報奨の受付を止めた——2026年10月1日に何が起きたか
2026年10月1日、Googleはオープンソース脆弱性報奨プログラム(OSS VRP)における「製品の脆弱性報告」の新規受付を一時停止しました。プログラム全体の廃止ではなく、受付対象を絞る形の停止です。
Googleが挙げた理由は、次の一文に集約されています。
This pause is due to a significant rise in automated submissions, the vast majority of which are not valid.
(この一時停止は、自動化された提出物の著しい増加によるものであり、その大半は有効なものではありません)
注目すべきは、Googleが「質が低い」とも「AIが悪い」とも言っていない点です。述べているのは「増加した」と「大半が有効でない」という2つの事実だけ。つまりこれは品質論ではなく、処理能力の問題として説明されています。
止まったものと、止まっていないもの
停止の範囲は限定的です。混同されやすいので整理します。
区分 | 状態 |
|---|---|
OSS VRP の製品脆弱性報告(新規) | 一時停止(2026年10月1日〜) |
OSS VRP のサプライチェーン脆弱性報告 | 継続して受付 |
10月1日より前に提出済みの報告 | 継続して対応 |
Google Cloud VRP(対象リポジトリ) | 継続(代替経路として案内) |
Patch Rewards Program | 継続 |
Googleは2027年第1四半期(Q1)にプログラムの状況を改めて更新するとしています。恒久的な打ち切りではなく、処理体制を立て直すための時間稼ぎという位置づけです。
この件は2026年10月4日にTechCrunchが、翌10月5日にHelp Net Securityが報じ、いずれもGoogleの同一の声明文を引用しています。本記事の事実関係は、これら複数の報道とGoogle自身の告知を突き合わせて確認したものです。
なぜAI生成の報告は厄介なのか——「読めば分かる間違い」ではない
AIが混ぜ込む誤りの性質を理解しないと、対策の方向を間違えます。従来のスパムとは質が違います。
報道で指摘されている典型的な破綻パターンは、次のようなものです。
- 存在しない攻撃経路を、もっともらしい手順書の形で提示する
- ソースコードの挙動について誤った前提を置き、その上で整合した推論を積む
- 実際には到達不可能な関数を「到達可能だ」と断定する
ここが核心です。これらは専門用語の使い方も文章構造も正しいため、形式チェックでは落ちません。誤りが「読めば分かる」形では現れず、コードを実際に追って反証するまで判定できない。つまり検証に、報告を書くより何倍もの専門知識と時間を要求します。
結果として生まれるのが、生成コストと検証コストの決定的な非対称です。
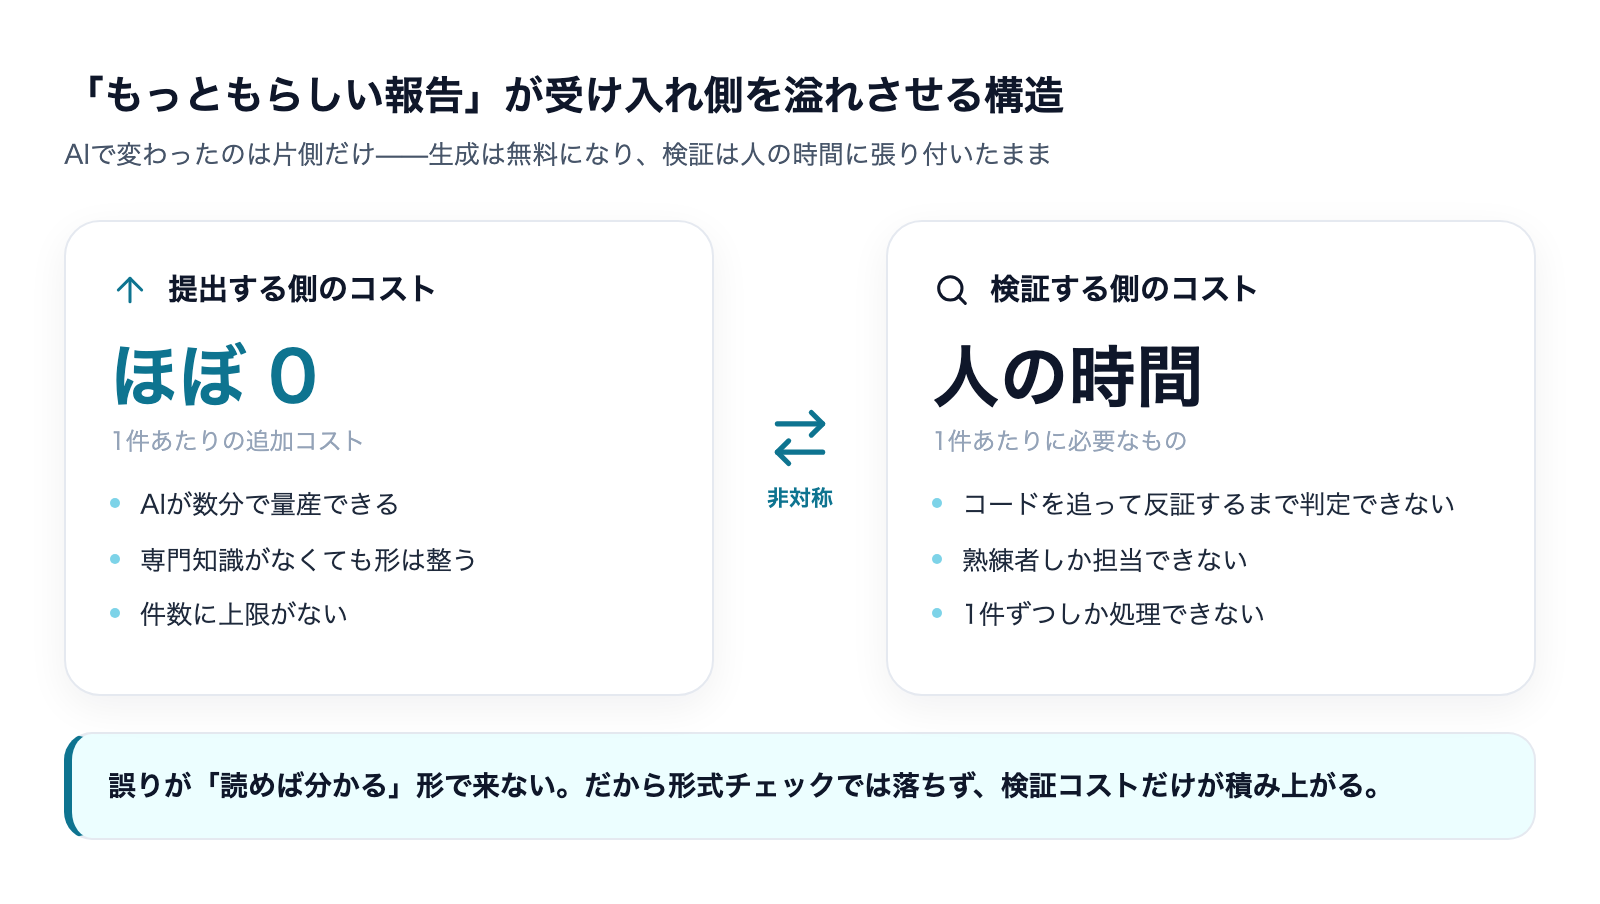
片側はほぼ無料で無限に供給でき、もう片側は熟練した人間の時間に固定されている。この構造では、受け取る側のキューはいつか必ず溢れます。Googleのような体制を持つ組織が受付を止めたのは、個別の報告を裁くより、流入そのものを止める方が合理的になったという判断です。
先例としてのcurl——数字で見ると何が起きたか
この問題は2026年に突然現れたわけではありません。より早く、より明確な数字とともに同じ壁に当たった事例があります。広く使われているデータ転送ツール「curl」です。
curlの開発を率いるDaniel Stenberg氏は、2026年1月に同プロジェクトのバグ報奨プログラムの終了を発表しました。運用実績は次の通りです。
項目 | 実績 |
|---|---|
開始 | 2019年4月 |
終了 | 2026年1月31日 |
確認された脆弱性 | 87件 |
支払総額 | 10万米ドル超 |
報告の確認率(従来) | 15%超 |
報告の確認率(2025年) | 5%未満 |
7年近く機能していたプログラムです。壊れたのは仕組みではなく、入力の質でした。確認率が15%超から5%未満へ落ちた状況を、Stenberg氏はこう表現しています。
Not even one in twenty was real.
(20件に1件すら本物ではなかった)
そして運用者側の負荷について、次のように書いています。
The never-ending slop submissions take a serious mental toll to manage and sometimes also a long time to debunk.
(終わりのない粗悪な提出物は、対応する側に深刻な精神的負担を与え、反証するのに長い時間を要することもある)
「精神的負担」という言葉が入っている点を、私は軽く読むべきではないと考えています。自動化された流入が人間のレビュアーに当たり続ける構造は、工数の問題である前に担当者が離職する問題です。
最も重要なのは「その後」——賞金を外したら流入が止まった
curlの事例で実務的に価値があるのは、終了そのものではなく続きです。
2026年2月25日、curlは脆弱性報告の受付をHackerOneへ戻しました。ただし金銭的な報奨は復活させていません。「報奨金はなくなったままで、バグバウンティではない」と明言した上での復帰です。
その結果についてStenberg氏は次のように述べています。
Since we dropped the bounty, the inflow tsunami has dried out substantially.
(報奨金をやめてから、流入の津波は大幅に収まった)
受付窓口は開けたまま、報告を書く動機から金銭を外しただけで、粗悪な流入が実質的に止まった。ここから引き出せる教訓は明確です。問題はAIの存在ではなく、AIを使って無価値な提出物を大量生産することに報酬が設定されていた誘因構造にあったということです。
なお同氏は、この収束が報告先の変更による一時的なものかもしれないと留保も付けています。「しばらくすれば提出者が新しい送り先を見つけるだけかもしれない」と。断定を避けたこの姿勢自体が、検証可能な範囲でしか語らないという良い実践例です。
これは「AIが悪い」という話ではない
ここまでの事実から、私が引く結論は次の通りです。
AIによって、もっともらしい成果物を作るコストがほぼゼロになりました。一方で、その成果物が正しいかを判定するコストは下がっていません。この2つの変化が同時に起きていない領域に、報酬や評価が紐づいていると、制度が壊れます。
裏を返せば、やるべきことは3つに絞られます。
- 誘因を見直す——「出した量」に報いる仕組みを、「検証を通った量」に報いる仕組みへ変える
- 検証コストを機械側へ下げる——人間が読む前に、機械で落とせるものを落とす
- 人間の判断を最後に残す——ただし人間が見る件数を、意図的に絞り込む
これは中小企業の現場でもそのまま使える観点です。私たち自身も、まったく同じ問題に当たりました。
無人運用で同じ壁に当たって作り直した、受け入れ工程の設計
私たちは自社メディアの記事生成を自動化して運用しています。生成する側がAIなので、ここで扱っているのは「AIの成果物を、人間がほとんど介在せずに受け入れるかどうか判定する」という、Googleやcurlが直面したのと構造的に同じ問題です。
何度も失敗しながら残った設計が、次の4層です。
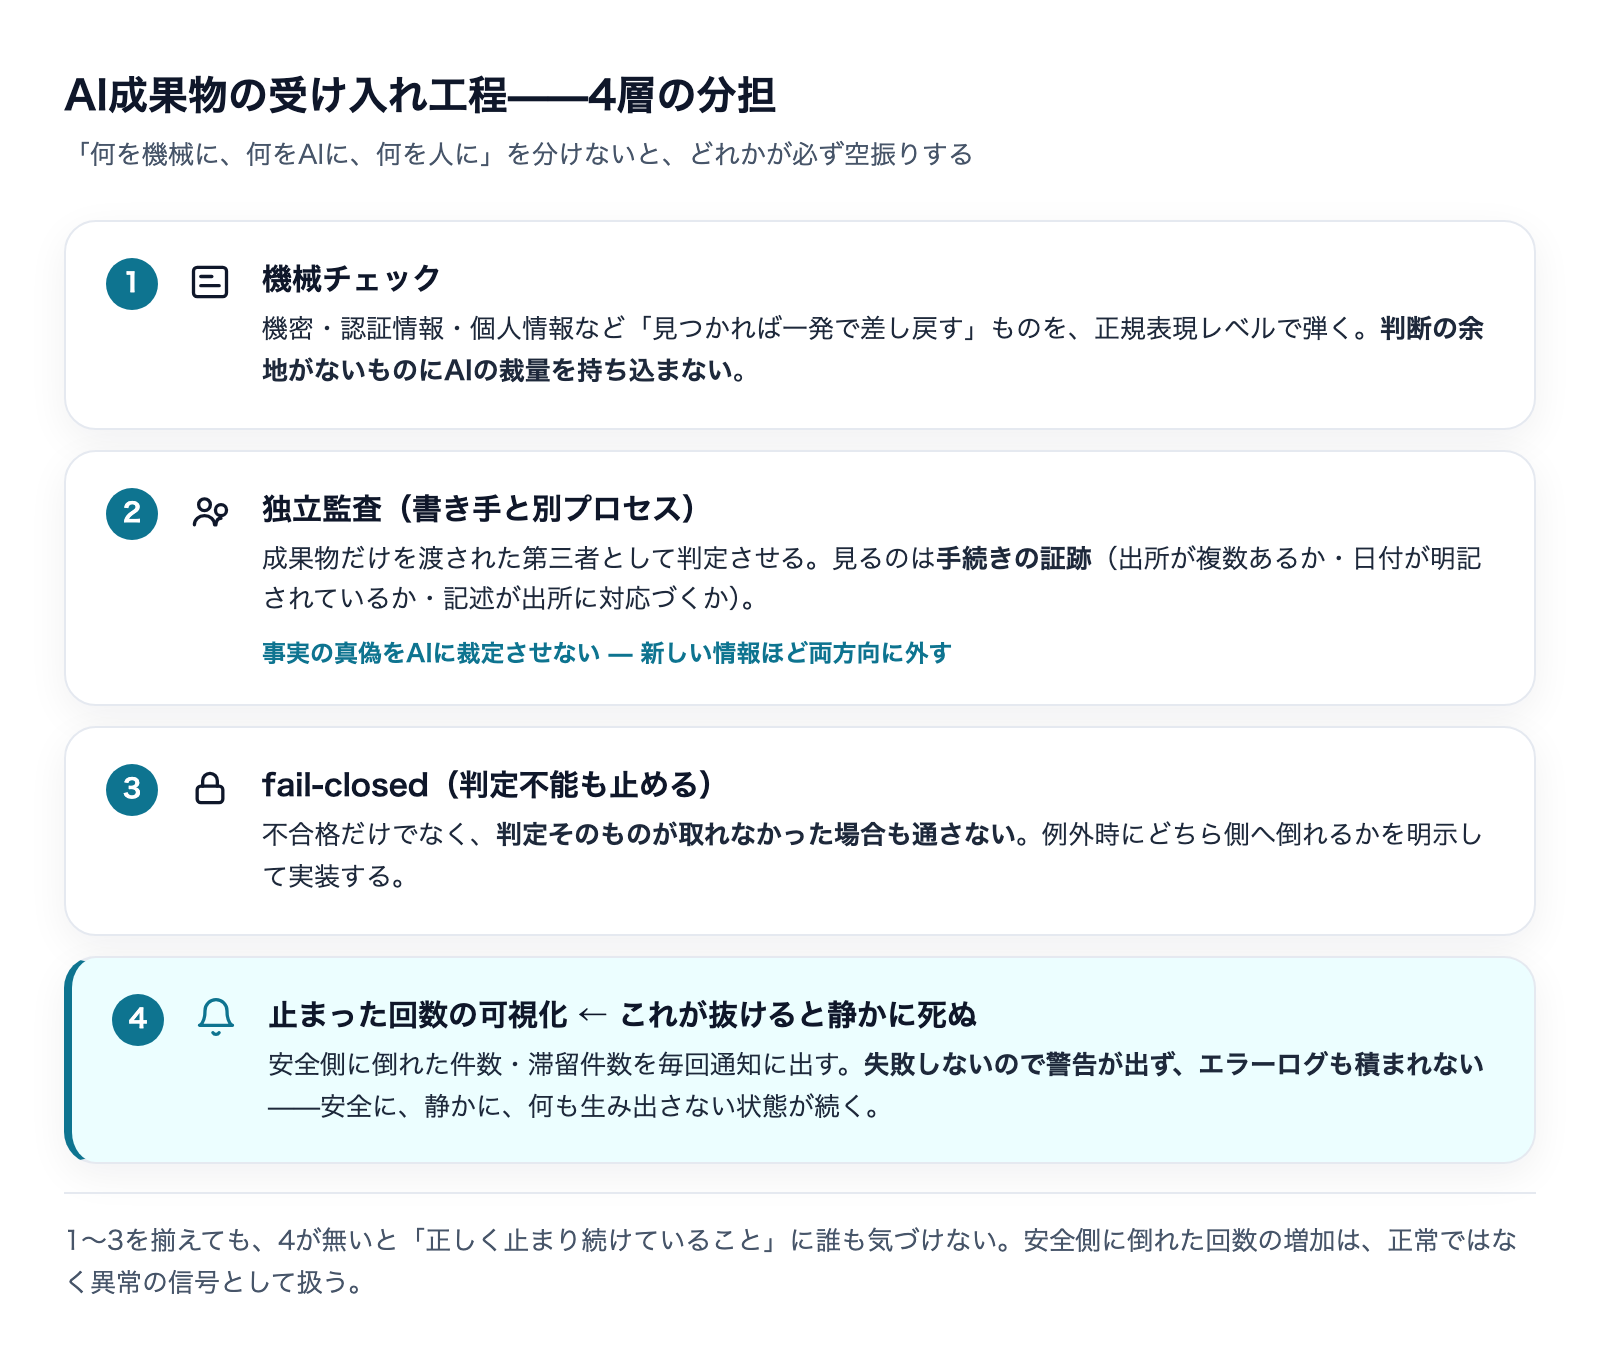
1. 機械で判定できるものを、AIに判断させない
最初に置いたのは、AIによる審査ではなく決定的なパターン検査です。機密情報の混入、内部パス、認証情報、個人情報といった「見つかったら一発で差し戻す」類のものは、正規表現レベルの検査で機械的に弾きます。
理由は2つあります。機械の方が安く速いこと、そして機械の方が確実なことです。この種の判定にAIの裁量を入れると、文脈次第で見逃しが発生します。判断の余地がないものに判断を持ち込まないのが原則です。
2. 書き手に自分の成果物を監査させない
次に、執筆の文脈から切り離した別プロセスで監査役を立てました。同じ会話の続きで「これをチェックして」と頼むのではなく、成果物だけを渡された第三者として判定させる形です。
これは実際の事故を受けた変更です。記事に添えるサムネイル画像で、本来入るべき文字が入っていない画像が自己チェックを通過して世に出たことがありました。書き手は「文字を入れる指示で作った」という前提を持っているため、出来上がった画像を「文字が入っているもの」として扱ってしまう。前提を共有している限り、同じ思い込みは二度繰り返されます。
対策として、監査役には画像ファイルを実際に開いて目で確認することを必須にしました。生成時の意図ではなく、出来上がった実体だけを見る。この分離を入れてから、同種の見落としは止まっています。
3. 判定が取れなければ止める(fail-closed)
3層目は方針です。監査の結果が「合格」でない場合——不合格だけでなく、判定そのものが取れなかった場合も含めて——公開せず保留に倒します。
「疑わしきは通さない」は当たり前に聞こえますが、実装では逆になりがちです。エラーで判定が取れなかったときに処理を続行してしまう作りは、よく書かれます。例外時にどちら側へ倒れるかを、明示的に決めて書く必要があります。
4. fail-closedは「静かに」壊れる——これが最大の教訓
ここが、私が最も費用を払って学んだ部分です。
監査役を動かすための認証が期限切れになり、監査が「判定不能」を返し続ける状態に入ったことがありました。設計通り、記事はすべて保留に倒れました。安全側に倒れたという意味では、仕組みは正しく動いています。
問題は、その状態に誰も気づかないまま25回分の実行が過ぎたことです。失敗していないので警告は出ない。公開されないだけなので、エラーログも積まれない。安全に、静かに、何も生み出さない状態が続きました。
ここから得た原則は明確です。fail-closedを採用するなら、「止まった回数」そのものを可視化する通知が必須です。安全側に倒れた回数が増えていることは、正常ではなく異常の信号として扱わなければなりません。無人運用が沈黙して止まる現象については、別記事で原因の切り分け方を整理しています。
5. 既存のものを書き換える工程は、機械ガードで固める
新しく作る処理より危険なのは、すでにあるものを書き換える処理です。壊れても即座には分からず、時間が経ってから「数字が落ちている」という形でしか現れません。事後の監査では救えない領域です。
そこで、既存コンテンツへの追記は専用の手順だけに限定し、次のガードを内蔵させました。
- バイト一致の検証——追記した分を除去したら元の内容と完全に一致するか確認する(意図しない変更の検出)
- 参照先の実在確認——リンク先が実際に存在するか、書き込む前に確かめる
- 冪等性——すでに適用済みなら何もしない(何度実行しても結果が変わらない)
- 読み戻しと自動巻き戻し——書き込み後に取得し直し、想定と違えば自動で元に戻す
人間の確認を挟まずに安全性を担保するには、こうした機械的な検査を工程に埋め込むしかありません。「気をつける」は仕組みではないからです。
6. 「担当者を決める」は仕組みではない
最後に、設計以前の話として書いておきたいことがあります。
私たちは手順書に「この工程は人が行う」と明記していました。にもかかわらず、その工程は実行されませんでした。種の供給が止まったことに気づかないまま2週間にわたって空回りしていた期間があり、別の工程では必要な作業が抜けたまま8日間放置されていたことがあります。
どちらも、ドキュメントの記述は正しかったのです。実行する仕組みが無かっただけ。担当を文章で宣言することと、仕組みを作ることは別物です。
対策として入れたのは、未処理件数を毎回の通知に強制的に出すことでした。滞留が数字として目に入る状態を保つ。可視化されない滞留は、必ず忘れられます。
「AIの監査をAIにやらせる」ときに外してはいけない設計
ここまで「独立した監査役を立てる」と書いてきましたが、その監査役も実際にはAIです。当然こう疑われます——AIの成果物をAIに検査させて、何が担保されるのかと。
正当な疑問です。そして私たちは、ここで一度明確に失敗しています。
失敗: 監査役に「事実の真偽」を判定させた
当初、監査役には記事内容の正しさそのものを判定させていました。しかし検証してみると、正しい記述を誤りとして差し戻し、同時に本物の誤りを素通りさせるという結果が出ました。1本の記事で両方向に外したのです。
原因は構造的なものでした。監査役のAIが持っているのは学習した時点での世界像です。扱っている題材が新しいリリースや新機能であるほど、その世界像には載っていません。結果として、知らない新事実を「そんなものは無い」と否定し、一方で古い知識と矛盾しない誤りは「知っている形」に見えるため通してしまう。新しい情報ほど、両方向に外すのです。
修正: 監査役の仕事を「手続きの検査」に狭めた
そこで、監査役の職務範囲を次のように変更しました。
旧(機能しなかった) | 新(機能している) | |
|---|---|---|
監査役が判定するもの | 記述内容は事実として正しいか | 裏取りの手続きが踏まれているか |
具体的な確認項目 | AI自身の知識と照合 | 発表日が本文に明記されているか/出所が複数列挙されているか/本文の数値と固有名詞が列挙された出所に対応づくか |
事実の正しさの担保 | 監査役(失敗) | 書き手側の裏取り義務(複数の一次情報で確認する規定) |
つまり、事実の真偽は上流(書き手の調査義務)で担保し、監査役は「手続きが踏まれた証跡があるか」だけを見るという分担です。監査役が自分の一般知識で真偽を推論して落とす判定は、明示的に禁止しました。
この分担に変えてから、監査は安定して機能しています。一般化すると次のようになります。
- AIが得意な検査——形式の遵守、項目の欠落、内部の整合性、禁止事項の混入、記述と添付資料の対応
- AIが不得意な検査——自分の学習データに無い新しい事実が真実かどうかの判定
検収プロセスを設計するときは、この線引きをそのまま使えます。AIに任せるのは「揃っているかの確認」であって、「本当かどうかの確認」ではありません。本当かどうかは、根拠の提出を義務づけることで生成側に戻すのが正解です。
中小企業の現場に置き換える——AI成果物の検収をどう設計するか
ここまでの話は、オープンソースや自動化パイプラインに限りません。すでに多くの現場で起きていることです。
- 外注先から上がってくる成果物に、AIの出力がそのまま混ざっている
- 社内で作られた調査レポートや提案書の根拠が、検証されていない
- 応募書類や問い合わせの件数が増え、選別に時間を取られている
いずれも「もっともらしい成果物が、検証されないまま大量に流れてくる」という同じ形です。私たちが顧問先と最初に整えるのは、ツールの選定ではなくこの受け入れ工程です。
検収プロセスの点検リスト
以下は、AI成果物を受け取る工程を点検するときに私たちが使う観点です。
- 機械で落とせるものを人が読んでいないか——形式・必須項目・禁止語の確認を人の目で行っているなら、そこは自動化できる
- 作った人が検品していないか——同じ担当者が作成と確認を兼ねている工程は、前提ごと見落とす
- 判定できないときにどちらへ倒れるか——確認が取れなかった案件が「とりあえず通る」運用になっていないか
- 止まったことが見えるか——保留・差し戻しの件数が、毎週誰かの目に入る形になっているか
- 根拠の提出を求めているか——結論ではなく、参照した一次情報を成果物に添付させる(これが最も効きます)
- 量に報いていないか——件数や速度を評価指標にしていると、検証されていない成果物が増える
特に5つ目は費用対効果が高い対策です。根拠の一次情報を添えることを必須にすると、裏付けのない成果物は提出段階で自然に減ります。検証する側の負荷を、生成する側へ戻す仕組みだからです。
AI導入にかかる費用全体の考え方や、AIレビューが誤った指摘を返してきたときの扱いについては、それぞれ別記事で整理しています。

報告する側・提出する側はどうすればいいのか
ここまで受け取る側の設計を書いてきましたが、提出する側の作法にも触れておきます。AIを使って調査や発見を行うこと自体は、何も悪くありません。問題になるのは、AIの出力を検証せずにそのまま提出する行為です。
Googleもcurlも、AIの使用を禁止したわけではありません。止めたのは「検証されていないものが大量に届く」状態です。実際curlは、報奨金を外した状態で受付窓口そのものは開けています。
提出物の信頼性を自分で担保するために、最低限押さえるべき点は次の通りです。
- 自分で再現してから出す——AIが「可能だ」と言った経路を、実際に動かして確認する。再現できていないものは提出しない
- 何を検証し、何を検証していないか明記する——AIの推測部分と自分で確認した部分を分けて書く。これだけで受け取る側の判定コストが大幅に下がる
- 根拠を添える——参照した一次情報、実行したコマンド、得られた出力を添付する
- 量を目的にしない——「とりあえず出す」件数は、自分の信用を削る方向にしか働かない
2つ目は特に効果があります。「ここは未検証です」と正直に書かれた報告は、受け取る側がどこを見ればいいか分かるため、むしろ扱いやすくなります。断定で埋めた報告の方が、結果的に信用を失います。
これは社内の報告書や提案書でも同じです。AIで作った部分を隠すより、どこを自分で確認したかを明示する方が、組織内の信用は積み上がります。
まとめ
2026年10月1日、GoogleはOSS VRPの製品脆弱性報告の受付を一時停止しました。理由は自動化された提出物の急増と、その大半が有効でなかったことです。サプライチェーン報告や提出済みの案件は継続し、2027年Q1に状況が更新される予定です。
先行事例であるcurlは、確認率が15%超から5%未満へ落ちたことを受けて2026年1月末に報奨プログラムを終了し、翌月に金銭報酬のない形で受付を再開しました。結果として流入は大幅に収まりました。効いたのはAIの排除ではなく、誘因の設計変更です。
受け入れ工程を作るときの要点を、改めて整理します。
- 機械で判定できるものに、AIの裁量を持ち込まない
- 作成者と検品者を分離する(同じ前提を共有させない)
- 判定が取れないときは止める側へ倒す
- 止まった回数を可視化する——fail-closedは静かに壊れる
- 既存のものを書き換える工程には機械ガードを埋め込む
- 量ではなく、検証を通った量に報いる
AIの精度は今後も上がります。しかし「もっともらしいが間違っているものが、ほぼ無料で大量に作れる」という構造自体は変わりません。だからこそ、受け取る側の工程設計が競争力になります。株式会社Fyveは、ツール選定の前段にあるこの受け入れ工程の設計から、中小企業の現場に伴走しています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。