Gemini Live Avatarとは|料金と数分の壁

「AIのアバターを受付に置けば、人を張らずに24時間対応できるのでは」——アバター付きの音声AIが発表されるたび、必ずこの発想が出てきます。
結論から言うと、いま出たばかりの Gemini Live Avatar は「常駐させる」用途に向いていません。公式のモデルカードが連続対話の上限を「数分程度で、長時間ではない」と明記しているからです。そして課金はアバターが喋っている秒数に付きます。
株式会社Fyveは、AIを業務に入れる前に「公式が何を約束していないか」を読むところから始めます。本記事では発表資料ではなく料金表・API仕様書・モデルカードの一次情報だけを使い、Gemini Live Avatar を業務に入れるかどうかの判断材料を整理します。
結論:Gemini Live Avatarで最初に確認する3点
- 連続稼働は「数分」が公式の想定。モデルカードの Known Limitations に明記されています。常駐の無人受付は設計として成立しません
- 映像の単価は音声の12分の1なのに、請求では映像が主役になる。1秒あたりのトークン量が音声の約248倍だからです
- 日本語は対応言語表に入っています。ただし発表ブログの「97言語」と公式ドキュメントの言語表「24言語」が食い違っており、どちらを前提に設計するかを決める必要があります
以下、それぞれを一次情報の数字で確認していきます。
Gemini Live Avatarとは|音声だけだった層に「映像」が乗った
Gemini 3.8 Live with Live Avatar は、Googleが2026年9月24日に発表した機能です(Google公式ブログの掲載日)。既存の音声対話モデル Gemini 3.8 Live に、喋る人物の映像をほぼリアルタイムで生成するレイヤーを足したものです。
元になっている Gemini 3.8 Live 自体は、その前の週に発表された音声対話モデルです。つまり新しいモデルが出たのではなく、既存モデルの出力に映像という選択肢が1つ増えたという構造です。
公式ブログが挙げている特徴は次の4点です。
- リップシンクと表情:発話に合わせて口の動きと表情が追従する。会話の途中で言語が切り替わっても、映像の忠実度を落とさず視覚的なドリフトも出さない
- 非同期のツール呼び出し:会話を続けながら、裏でツールやAPIを叩いてデータを取ってくる
- プリセットと独自アバター:用意されたアバターのライブラリから選べる。参照画像から独自のアバターを作ることもできる(条件あり・後述)
- SynthID電子透かし:生成された音声と映像の両方に、知覚できない透かしが埋め込まれる
音声対話そのもののコスト構造については、同じモデルの音声側を扱った記事で詳しく整理しています。
どこから使えるか|「提供開始」の中身を正確に読む
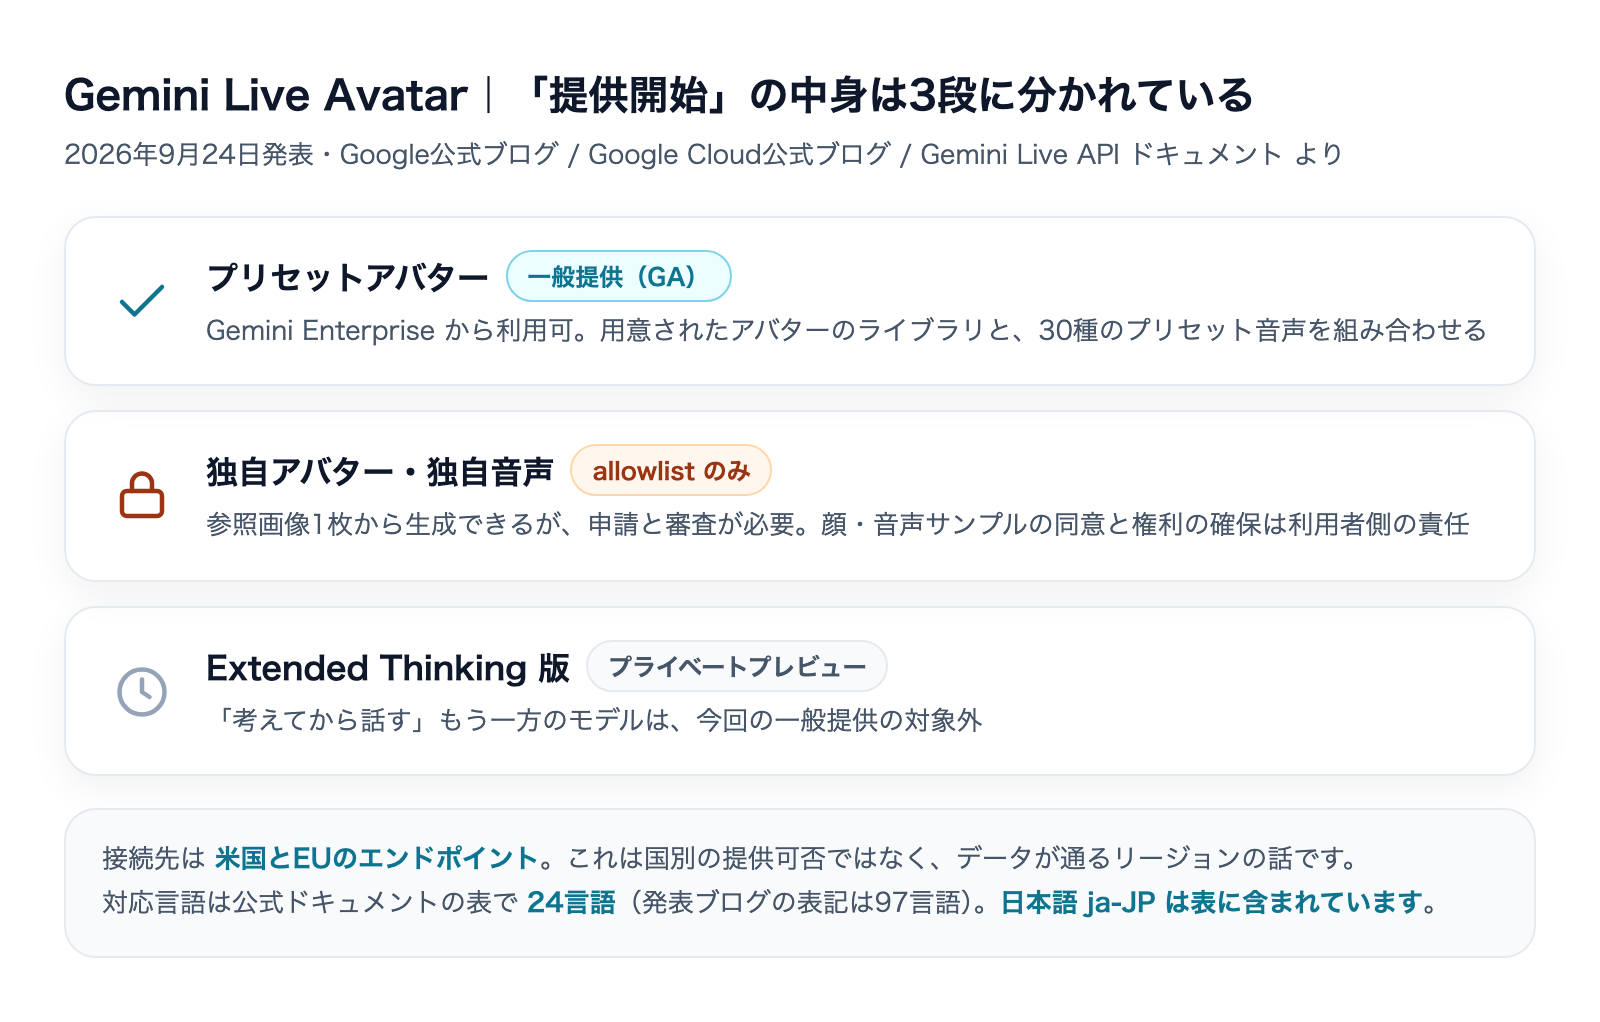
Gemini Enterprise で一般提供、エンドポイントは米国とEU
Google Cloud公式ブログは「一般提供(generally available)」と明記しており、提供先は Gemini Enterprise です。同ブログは、米国とEUのエンドポイント、プロビジョンドスループット、エンタープライズ向けのコンプライアンスとデータガバナンスを伴う形で提供されると書いています。
ここは読み間違えやすいところです。「米国とEUで提供開始」という言い方をすると国別の提供可否の話に聞こえますが、公式が書いているのはエンドポイント(接続先リージョン)の所在です。日本向けのリージョンエンドポイントは列挙されていません。データの所在地に制約がある業務では、この1点だけで採否が決まります。
プリセットは使える、独自アバターは審査待ち
提供の粒度が2段になっています。
- プリセットアバター:用意されたライブラリから選んで使える
- 独自アバター:公式ブログの表現では「エンタープライズのallowlist経由のみ」。API仕様書側は「一部の顧客のみ利用可能。アクセス申請はGoogle Cloudの担当チームへ」と書いています
つまり「自社の顔でアバターを作る」は、現時点では申請と審査を通した先の話です。検証をプリセットで始める前提で計画を立てるのが現実的です。
もう一方のモデルは非公開プレビューのまま
Gemini 3.8 Live には「考えてから話す」Extended Thinking 版があります。Google Cloud公式ブログは、Extended Thinking 版は依然としてプライベートプレビューであると明記しています。一般提供されたのは通常版の方だけです。
いちばん大事な制約:連続稼働は「数分」
公式のKnown Limitationsが「数分」と書いている
Google DeepMindが公開している Gemini 3.8 Audio のモデルカードには、Known Limitations の項に次の記述があります。
Live Avatar を使う構成は「数分程度の連続対話に対応できるが、長時間ではない」——原文は「a few minutes of continuous interaction, rather than extended hours」です。
発表資料は「常駐のブランド大使」「対話型のウォークスルー」といった用例を挙げており、読み手は自然と「置いておけるもの」と受け取ります。しかしモデルカードは置いておけないと書いている。この2つを並べて読めるかどうかが、導入計画の質をそのまま分けます。
出力の上限も64K→24Kに縮む
同じモデルカードの Outputs 項には、もう1つ見落としやすい数字があります。
- Gemini 3.8 Live(音声とテキスト):出力 64Kトークン
- Live Avatar 有効時(音声・映像・テキスト):出力 24Kトークン
入力側のコンテキストウィンドウは最大128Kトークンで共通ですが、アバターを有効にすると出力の枠が3分の1強まで縮みます。映像のトークンが同じ出力予算を食うためです。長く喋らせる設計は、料金の前にこの上限で先に詰まります。
だから「常駐の受付」ではなく「短い応対」の道具
ここまでの2つを合わせると、適した形がはっきりします。数分で終わる、目的が1つに決まった応対です。予約の確認、申込内容の読み合わせ、操作の手順案内——終わりが見えているものに向いています。
逆に「何を聞かれるか分からない窓口を無人で開けておく」は、技術的に支えられていません。現状の仕様のまま押し込むと、セッションが切れる前提の再接続処理を自分で書くことになり、その保守がそのまま運用コストとして残ります。
料金|単価は音声の12分の1なのに、請求では主役になる
公式料金表(2026年9月26日時点)
Google Cloudの Agent Platform 料金ページに載っている Gemini 3.8 Live API の単価です(100万トークンあたり・Non-globalリージョン・米ドル)。契約前に最新の公式料金ページでご確認ください。
種別 | 単価(/100万トークン) |
|---|---|
入力:テキスト | $0.75 |
入力:映像・画像 | $1.00 |
入力:音声 | $3.00 |
出力:テキスト(応答+推論) | $4.50 |
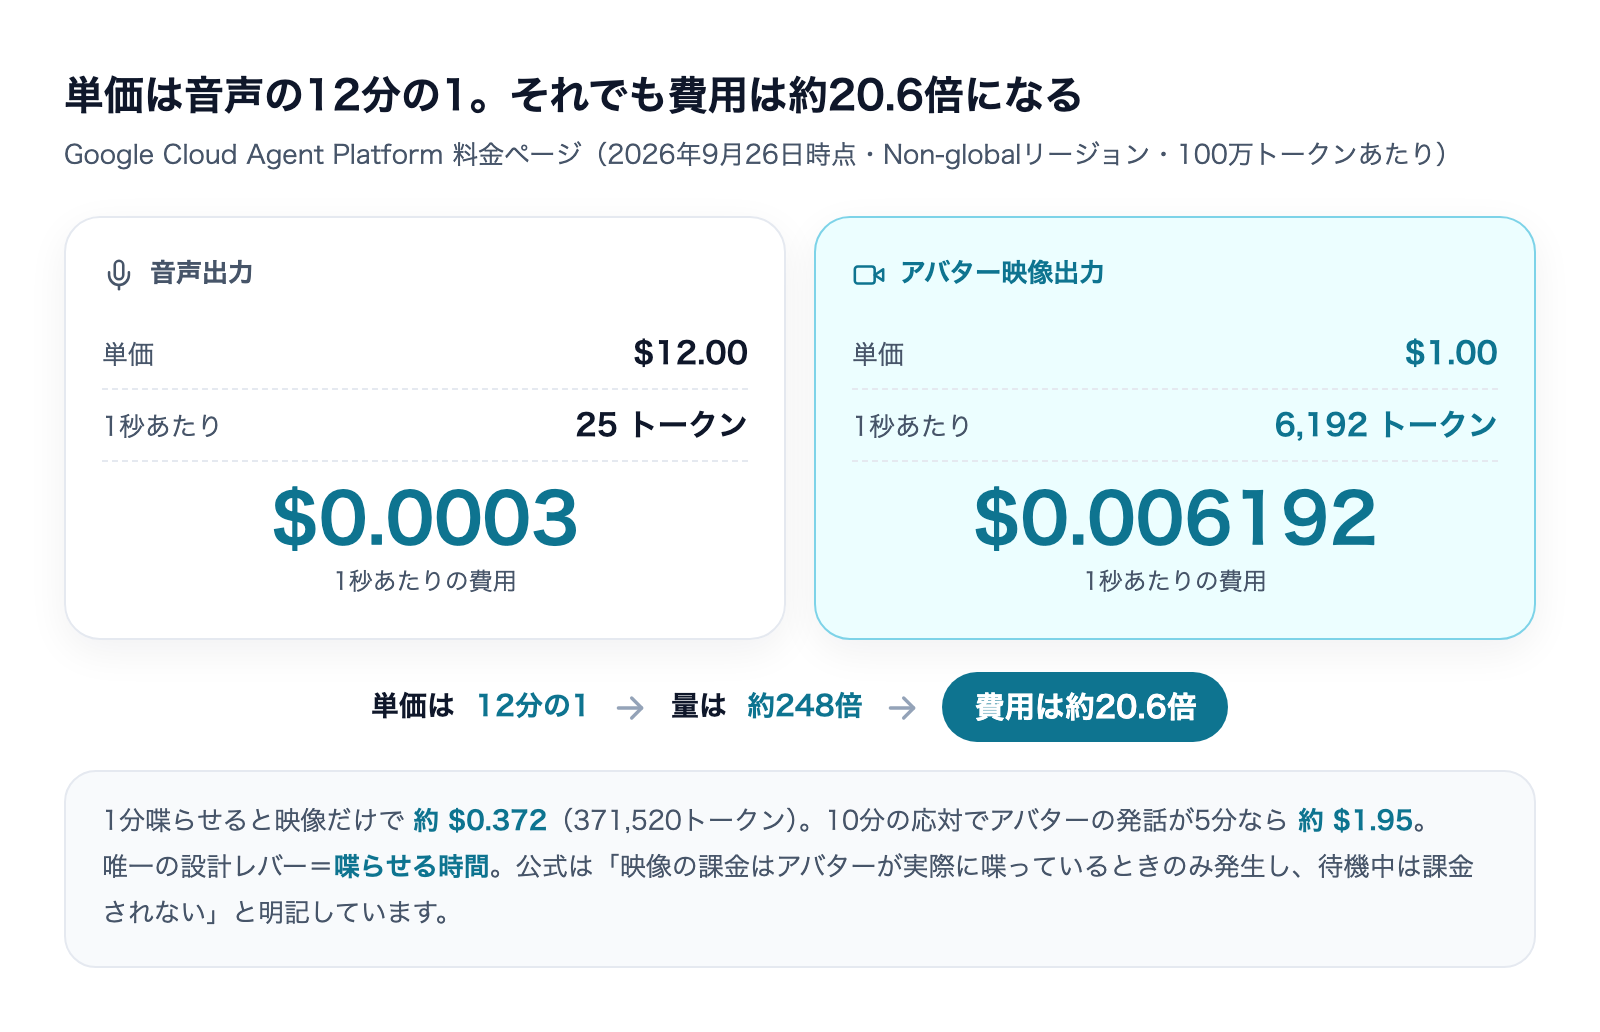
出力:音声 | $12.00 |
出力:映像(アバター) | $1.00 |
単価表だけを見ると、アバター映像は音声出力の12分の1です。安く見えます。ここで判断を止めると必ず外します。
秒あたりのトークン量が音声の約248倍
同じ料金ページには、時間をトークンに換算する比率が書かれています。
- 音声:25トークン/秒
- 画像入力:258トークン/枚
- アバター映像の出力:6,192トークン/秒
- 音声からテキストへの書き起こしを有効にした場合:生成されたテキストは標準のテキスト出力単価で課金
6,192 ÷ 25 = 約248。同じ1秒に対して、映像は音声の約248倍のトークンを消費します。単価が12分の1でも、量が248倍なら費用は約20.6倍です。
1分喋らせるといくらか
上の数字だけで実額が出ます。アバターが1分間喋り続けた場合の出力側の費用です。
項目 | トークン量 | 費用 |
|---|---|---|
アバター映像(60秒) | 371,520 | 約 $0.372 |
音声(60秒) | 1,500 | 約 $0.018 |
合計 | — | 約 $0.39 |
10分の応対のうちアバターが実際に喋るのが5分なら、出力側は約$1.95。1時間喋り続けさせたら映像だけで約$22.3です。人件費と比べれば安いと感じるかもしれませんが、問題は金額の絶対値ではなく費用が「アバターの発話時間」に正比例するという構造の方です。
「喋っている間だけ課金」が唯一の設計レバー
公式料金ページには、そのまま設計指針になる一文があります。映像の課金はアバターが実際に喋っているときだけ発生し、待機中(聞いている間)は課金されない。
つまりコストを動かせる場所は1つに絞られます。アバターに喋らせる時間を削ることです。相槌を映像で返さない、長い説明は画面のテキストに逃がす、選択肢の提示は音声だけにする——こうした設計が請求書に直接効きます。逆に「丁寧に長く説明するアバター」は、体験を良くしながら費用を線形に増やします。
もう1つ、料金ページの注記に見落としやすい仕様があります。セッションのコンテキストウィンドウは、ターンごとに累積分がすべて再課金されると明記されています。過去のやりとりは毎ターン再処理されるため、会話が長引くと入力側も加速的に増えます。ここでも効く対策は同じで、会話を短く閉じることです。
カメラ入力をONにすると、入力側も跳ねる
Live Avatar は相手側のカメラ映像や画面共有を受け取れます。ただし入力の仕様を見ると代償がはっきりします。API仕様書によると、入力の映像・画像はJPEGの1FPSとして扱われます。1秒あたり1枚です。
画像入力は258トークン/枚なので、カメラをONにすると入力は258トークン/秒。音声入力の25トークン/秒に対して約10.3倍のトークン量です。単価差(映像$1.00 対 音声$3.00)を考慮しても、費用では約3.4倍になります。
「相手の様子を見ながら話せる」は魅力的な機能ですが、常時ONにする理由がない業務なら切っておく方が素直です。本当に見る必要がある数十秒だけONにするのが、仕様に沿った使い方です。
日本語は使えるのか|97言語と24言語が食い違っている
発表ブログは97、公式ドキュメントの表は24
ここは一次情報どうしが割れている箇所なので、そのまま開示します。
- Google公式ブログ:会話の途中でも97言語をまたいで切り替えられる、と書いている
- Google Cloud公式ブログ:Gemini 3.8 Live は97言語を理解し話す、と書いている
- Gemini Live API の公式ドキュメント:機能一覧に「24の対応言語で会話できる」と書き、実際に24行の言語表(言語名とBCP-47コード)を載せている
数え直しても表は24行で、ブログの97には届きません。どちらかが誤りなのか、97は「認識できる言語」で24は「合成音声で応答できる言語」なのか、公式には説明がありません。提案書や社内資料に書くなら、より狭い方(ドキュメントの言語表)を前提に置くのが安全です。97を根拠に多言語対応を約束すると、確認できない数字で判断を促すことになります。
日本語(ja-JP)は表に入っている
実務上の答えは出ています。公式ドキュメントの24行の言語表に Japanese (Japan) / ja-JP が含まれています。日本語での音声対話は仕様上の対応範囲です。
あわせて、プリセット音声は30種類が一覧化されています。声のトーンやアクセントはシステム指示で誘導できるとも書かれており、「英語に前向きで明るい、フランス語訛りの声で」といった指定の例まで載っています。
非同期ツール呼び出し|会話を止めずに裏で処理する
発表資料で地味に扱われていますが、業務に入れるときに効くのはこの機能です。公式ブログは、Live Avatar が会話を続けたままバックグラウンドでツール呼び出しとデータ取得を実行できると書いています。Google Cloud側は「依頼を受け付けたと応答しつつ会話を続け、処理は裏で終わらせる」と説明しています。
これは単なる高速化ではありません。従来型の音声エージェントでは、在庫照会や本人確認のAPIを叩いている数秒が無言の待ち時間になり、その沈黙が「壊れているのでは」という不安を生んでいました。裏で走らせられるなら、その沈黙を設計から消せます。
ただし副作用があります。裏で動いていることは利用者から見えません。何がいつ実行されたかをログで追える形にしておかないと、後から「その操作は誰の指示だったのか」を再現できなくなります。音声で任せる範囲をどう切るかという論点は、他社の音声エージェントでも同じ形で出てきます。
独自アバターは「顔の権利」を自分で持つ話になる
参照画像の要件は具体的に決まっている
独自アバターはallowlist経由に限られますが、API仕様書には参照画像の要件がすでに全部書かれています。検証の順番を考えるうえで参考になるので挙げておきます。
- 形式:PNG推奨(可逆圧縮であることと、アルファ透過で明るい背景・暗い背景のどちらでもアバターの周りに四角い枠が出ないため)
- カラーモード:RGB
- サイズ:最小 704×1280ピクセル(縦向き)/解像度720p以上/5MB未満
- アスペクト比:9:16の縦向きが標準(横向きも対応)
- 構図:バストショットで、頭と肩がフレームの60%超。下半身・腕・手・マイクなどの持ち物は切る
- 背景:簡素で、他の人物や目立つ物を入れない
- 向きと表情:正面・頭は水平・目はレンズを見る。表情はニュートラルで、笑顔・目を細める・歯を見せるのは不可
- 使ってはいけない画像:未成年、著名人、不適切な内容
独自音声も同じ枠組みで、10〜20秒の音声サンプルをセッションごとに渡す形です。事前の学習やアップロードは不要と明記されています。録音のコツとして「ラジオ声を作らない」「空調と窓を閉じる」「わずかに笑みを浮かべると声に温かみが乗る」まで書かれています。
同意と権利の確保責任は、利用する側にある
ここが実務上いちばん重い一文です。独自アバターと独自音声のどちらの項にも、同じ趣旨が書かれています。
顔や音声のサンプルを処理するために必要な同意と権利の確保は、すべて利用者側の責任である——加えて GenAI Prohibited Use Policy、Google Cloud Acceptable Use Policy、Service Specific Terms の第32条への準拠が求められます。
社員や代表者の顔でアバターを作るなら、退職後にその顔をどう扱うかまで含めた同意が必要になります。生成物にはSynthIDの透かしが入りますが、透かしは「AI生成であること」を示すだけで、使う権利があることを保証しません。ここを詰めずに始めると、作った後に止められない資産を抱えます。
なお、録画済みの素材からアバター動画を作る用途なら、リアルタイム生成でなくても成立します。目的が「毎回違う会話に応じる」ではなく「同じ説明を量産する」なら、そちらの方が制約は軽くなります。
画面録画→HeyGenアバター動画自動生成|Hermes Agent公式事例
私が中小企業に勧める使い方・勧めない使い方
秒で課金されるものは「工程を分けて」設計する
私は毎日、無人で動く定型ジョブを複数の時間帯で走らせています。そこで身についた原則が1つあります。時間や量で課金されるものは、1本の長い処理にせず工程を分け、高い工程だけを短くすることです。
モデルを固定し、重い処理の前に軽い判定を置いて、重い方に入る件数そのものを減らす。使用量で請求されるものは、単価交渉より「入れない設計」の方が効きます。
Live Avatar はまさにこの型に当てはまります。単価$1.00という数字は交渉の余地がありませんが、アバターに喋らせる秒数は完全に自分の設計変数です。しかも公式が「待機中は課金されない」と明記している——ここまで設計レバーがはっきり示されている機能は珍しいです。
勧めない:24時間置いておく無人窓口
連続数分という上限と、発話秒数に比例する課金の2つが重なるため、常時開けておく窓口には向きません。「人を置かずに済む」という期待でこれを選ぶと、セッション管理の実装と想定外の請求の両方を抱えることになります。
勧める:終わりが決まっている、短い1回の応対
向いているのは、始まりと終わりが設計できる数分の応対です。予約内容の確認、申込書の読み合わせ、操作の初回案内、来訪者の一次受付——いずれも目的が1つで、終わったら切れて問題ありません。
そしてこの用途なら、映像が要るのかを冷静に検算できます。音声だけで足りるなら費用は約20分の1です。映像を足す理由が「その方が親切そうだから」であれば、その親切は1分あたり約$0.37で買っていることになります。顔が必要な理由を言語化できるかどうかが、私の判断基準です。
導入前に決める4つのこと
- データの所在:エンドポイントは米国とEU。自社の業務でそれが許容されるかを先に確認する
- 映像が必要な理由:音声のみと比べて約20.6倍。顔がある必然性を1文で書けるか
- 応対の終わり方:数分で閉じる設計になっているか。切れたときに誰が引き継ぐか
- 顔と声の権利:独自アバターを使うなら、誰の顔で・いつまで・退職後はどうするかを同意書の水準で決めておく
この4つが埋まらないうちは、プリセットアバターでの検証に留めておくのが安全です。
よくある質問
日本語でアバターと会話できますか
公式ドキュメントの対応言語表に Japanese (Japan) / ja-JP が含まれているため、仕様上は可能です。ただし提供はGemini Enterprise経由で、エンドポイントは米国とEUです。
Gemini アプリや無料のAPIから使えますか
公式が提供先として挙げているのは Gemini Enterprise です。無料枠での提供は案内されていません。独自アバターの作成はさらにallowlistが必要です。
アバターが黙っている間も課金されますか
公式料金ページは、映像の課金はアバターが実際に喋っているときのみ発生し、待機中(聞いている間)は課金されないと明記しています。ただし音声入力とコンテキストの再処理は別に発生します。
知識のカットオフはいつですか
モデルカードには2025年1月と記載されています。最新の情報が必要な応対では、ツール呼び出しで外部から取ってくる設計が前提になります。
「97言語対応」と書いてよいですか
お勧めしません。発表ブログは97ですが、公式ドキュメントの言語表は24行です。確認できる範囲で書くなら、ドキュメント側の24言語を根拠にするのが安全です。
まとめ
Gemini Live Avatar は、2026年9月24日に Gemini Enterprise で一般提供が始まった、音声対話に映像を足す機能です。リップシンクと表情、非同期のツール呼び出し、音声と映像の両方に入るSynthID——発表資料の内容は素直に強力です。
一方で、モデルカードは連続対話は数分程度と書き、Live Avatar有効時は出力上限が64Kから24Kに縮むと書き、料金ページは映像出力が6,192トークン/秒だと書いています。この3つを読んだ上でなら、「常駐の受付」ではなく「終わりが決まった短い応対」に使う、という設計に自然に落ちます。
そして費用を動かせる場所は1つだけです。アバターに喋らせる時間。公式が「待機中は課金しない」と書いてくれている以上、そこを削る設計が唯一のコスト対策になります。
新機能を業務に入れるときにいちばん効くのは、発表資料ではなく仕様書のKnown Limitationsと料金ページの注記を読むことです。株式会社Fyveは、こうした一次情報の読み合わせから逆算して、入れる・入れないを判断しています。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。