Gemini 4 Hydrogenのthinking level

「Gemini 4 Hydrogen の thinking level は low・medium・high・xhigh のどれにすればいいのか」「既定の high のままでいいのか、xhigh にすれば賢くなるのか」——Hydrogen を API や業務の仕組みに組み込もうとすると、最初にこの設定で手が止まります。
結論から言うと、まずは既定の high のまま使い、速さや費用が気になる仕事だけ medium や low に下げ、high で解けない難しい仕事にだけ xhigh を使うのが Google の推奨です。いちばん浅い minimal は Hydrogen では使えず、指定するとエラーになります。段を選ぶときは、自分の仕事を4段すべてで流し、合格する中でいちばん低い段を選びます。
株式会社Fyveは、中小企業の AI 活用を月額で伴走支援しながら、社内の定型作業でも複数の AI を毎日動かしています。この記事では、Google の Gemini API ドキュメントと Google Cloud の手引きに書かれていることと、私たちが2026年11月13日に手元の Gemini API で各段を実際に呼んだ結果だけを使い、4段の意味と選び方を整理します。
Gemini 4 Hydrogen そのものが何か、3.8 Flash から何が変わったかは、こちらにまとめています。
Gemini 4 Hydrogen の thinking level とは|答える前に考える量の目安
thinking level(考える段)は、モデルが答えを書く前に、内部でどれだけ考えるかを選ぶ設定です。Gemini 4 Hydrogen は2026年11月12日に Google が発表したモデルで、API でのモデル名は gemini-4-hydrogen です。
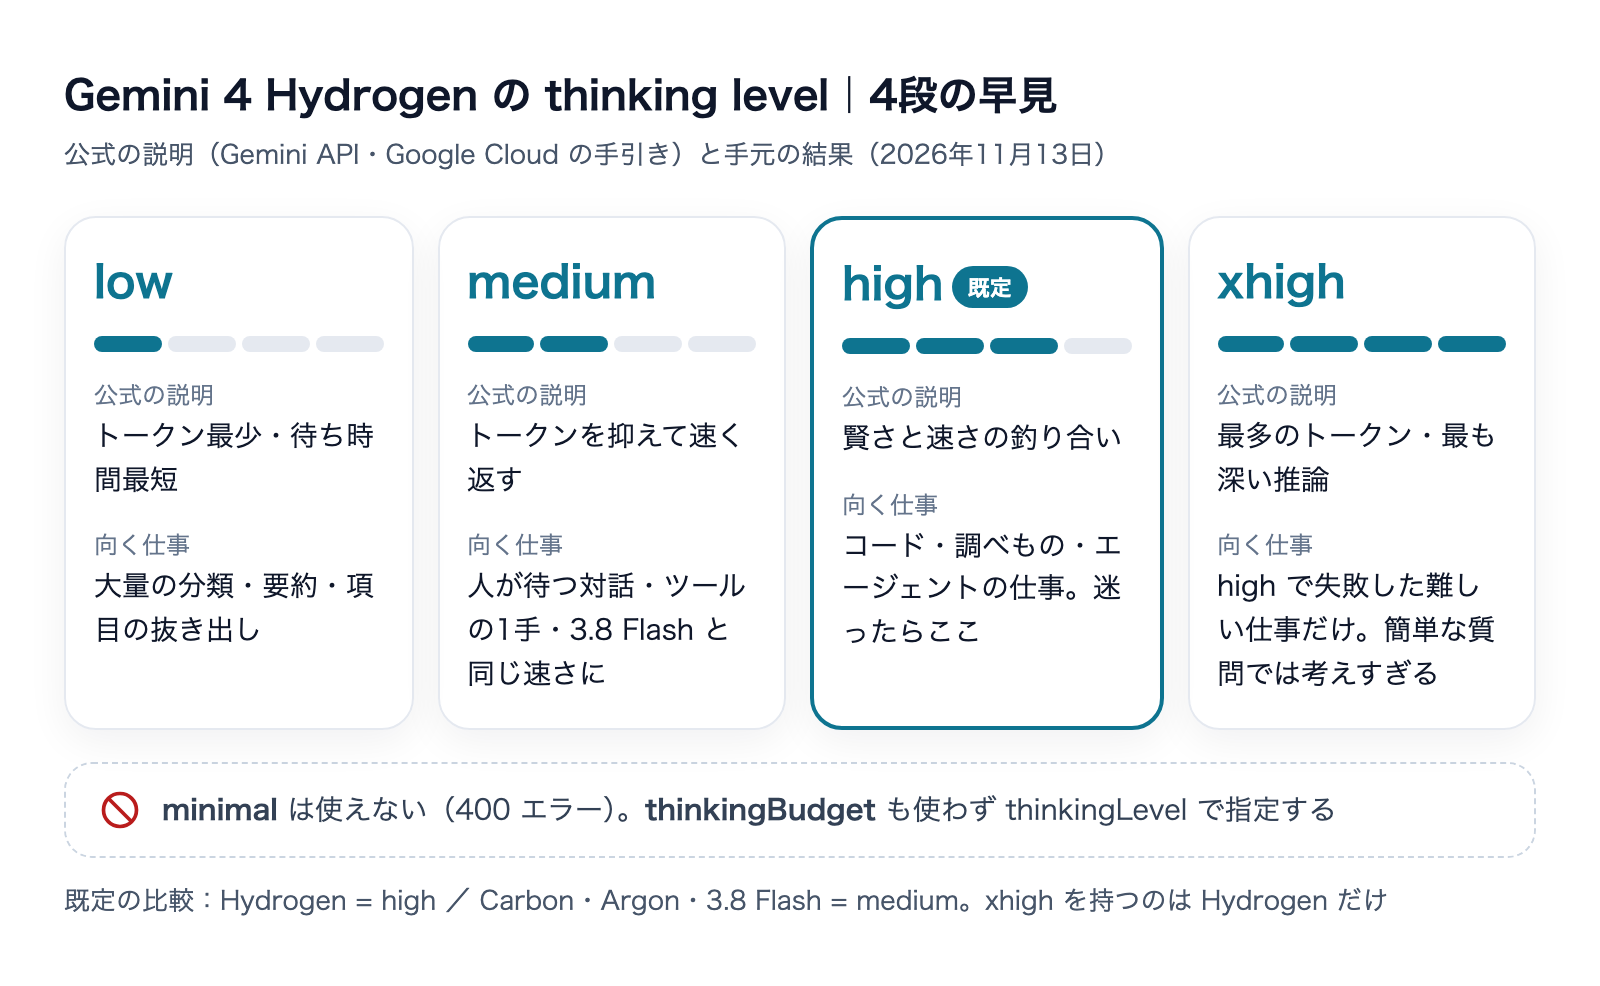
Hydrogen で選べる段は low・medium・high・xhigh の4つで、何も指定しないと high で動きます(Gemini API の移行ガイド「What's new in Gemini 4 Hydrogen」・2026年11月13日確認)。
押さえておきたいのは、次の3点です。
- 考えた分もお金がかかる:考える途中で使ったトークン(思考トークン)は、出力トークンとして課金されます。Hydrogen の出力の単価は100万トークンあたり $7.50 で、公式は「思考トークンを含む」と書いています
- 考えた分も出力の上限に数えられる:
max_output_tokens(出力の上限)は、思考と答えを合わせた量の上限です。上限を小さくしすぎると、考えるだけで使い切って答えが空になります - 段は「目安」で、決まった量ではない:段を上げると考える量が増える傾向はありますが、何トークン考えるかを決める設定ではありません。後で載せる手元の結果でも、1回ごとのばらつきは大きく出ました
段の名前と数は Gemini のモデルごとに違います。Hydrogen では xhigh があり minimal が無い、という形を覚えておくと混乱しません。
4段それぞれの意味と向く仕事
Google は、Gemini API のドキュメントと、企業向けの Google Cloud(Gemini Enterprise Agent Platform)の手引きの2か所で、段ごとの性格と向く仕事を説明しています。2つを並べると次のとおりです(どちらも2026年11月13日確認)。
段 | Gemini API の説明 | Google Cloud の手引きが挙げる仕事 |
|---|---|---|
low | トークンがいちばん少なく、待ち時間がいちばん短い。費用と速さを優先する仕事に | 大量の分類、振り分け、要約、決まった項目の抜き出し |
medium | トークンを抑えて速く返す。対話しながらのコーディング、画面の試作、すぐ返してほしいチャットに | ふつうのコーディング、ツールの利用、文書への質問、動画の理解 |
high(既定) | 賢さと速さの釣り合い。ほとんどの仕事の推奨の既定 | 何段もツールを呼ぶエージェントの仕事、コードの生成、設計の作り直し、画像や動画を含む複雑な分析 |
xhigh | トークンがいちばん多く、いちばん深く考える。high で足りない、難しく何段もあるコーディングやエージェントの仕事に | 深い推論、数学の証明、科学の分析、いちばん複雑な複数ファイルにまたがる開発 |
表の「Gemini API の説明」の列は、Gemini API ドキュメントの thinking のページの英語の説明を、私たちが日本語にしたものです。
low|回数が多く、答えの形が決まっている仕事
low は、考える量をいちばん抑える段です。問い合わせの分類、文章の要約、請求書から決まった項目を抜き出す、といった答えの形が決まっていて、1日に何百回も呼ぶ仕事に向きます。1回あたりの差は小さくても、回数が多いと費用と待ち時間の差が積み上がります。
ほかの Gemini のモデルにある minimal(ほぼ考えない段)は、Hydrogen にはありません。「とにかく最速で」という用途では、low が下限です。
medium|すぐ返してほしい対話とツール呼び出し
medium は、前のモデル Gemini 3.8 Flash の既定の段です。人が画面の前で待っている対話や、エージェントの中で何度も呼ばれるツールの1手など、1回の待ち時間が体感に効く場面に向きます。
Google Cloud の手引きは、3.8 Flash から乗り換えて同じくらいの速さを保ちたいなら、MEDIUM をはっきり指定するよう書いています。何も書かずに乗り換えると high で動くからです。
high|迷ったらここ(既定)
high は Hydrogen の既定で、Google が「ほとんどの仕事の推奨の既定」としている段です。発表で示された「3.8 Flash より約2.5倍速く仕事を終える」も、Artificial Analysis Intelligence Index の 51 も、この high での数字です。
コードを書く、資料を読んで調べる、ツールを何度も呼んで作業を進める、といった中身を考えさせる仕事は、まず high で試すのが出発点になります。
xhigh|high で解けない仕事にだけ
xhigh は Hydrogen にだけある、いちばん深く考える段です。外部の総合指標 Artificial Analysis Intelligence Index は、high の 51 に対して xhigh で 54 と公表されています。
ただし、Gemini API のドキュメントは「簡単な質問では考えすぎたり、max_output_tokens を使い切ったりすることがある」と注意しています。xhigh は「上げれば上げるほど良い」段ではなく、high で失敗した仕事に限って使う段です。
既定は high|3.8 Flash・Carbon・Argon との違い
同じ Gemini でも、モデルごとに選べる段と既定が違います。Gemini API の thinking のページにある一覧から、乗り換えで関係するモデルを抜き出します(2026年11月13日確認)。
モデル | 既定 | 選べる段 |
|---|---|---|
Gemini 4 Hydrogen | high | low・medium・high・xhigh |
Gemini 4 Carbon | medium | low・medium・high |
Gemini 4 Argon | medium | low・medium・high |
Gemini 3.8 Flash | medium | low・medium・high |
Gemini 3.6 Flash | medium | minimal・low・medium・high |
ここから分かるのは次の3つです。
- Gemini 4 の3モデルの中で、既定が high なのは Hydrogen だけ。Carbon・Argon から Hydrogen に切り替えると、何も変えなくても考える段が1つ上がる
- xhigh を選べるのは Hydrogen だけ。Carbon・Argon の上限は high
- minimal は Gemini 4 のモデルと 3.8 Flash では使えない。3.6 Flash など古いモデルで minimal を指定していた仕組みは、そのまま Hydrogen に向けるとエラーになる
なお、Gemini API のドキュメントには「簡単な仕事は minimal で」という一般的な目安も書かれていますが、Hydrogen では minimal が使えないので、簡単な仕事は low に読み替えます。
Carbon・Argon と Hydrogen をどの仕事に使い分けるかは、こちらで詳しく比べています。
API での thinking level の指定方法
Gemini API には、昔からある generateContent と、新しい Interactions API の2つの呼び方があり、書き方が少し違います。
generateContent で指定する(REST)
generationConfig の中の thinkingConfig に thinkingLevel を書きます。私たちが11月13日に手元で試したのもこの書き方で、low・medium・high・xhigh はどれも通りました。
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key=$GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{"role": "user", "parts": [{"text": "この問い合わせを3つの分類のどれかに振り分けて"}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "low"}
    }
  }'
Python の SDK(google-genai)では、Google Cloud の手引きの書き方に合わせると types.ThinkingConfig(thinking_level="HIGH") のように大文字で書きます。
from google import genai
from google.genai import types

client = genai.Client()
response = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="この見積書の明細を表にまとめて",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="MEDIUM")
    ),
)
print(response.text)
print(response.usage_metadata.thoughts_token_count)  # 考えた量
応答の usageMetadata の thoughtsTokenCount に、その回に考えたトークンの数が入ります。段を変えて比べるときは、この数字と答えの出来を並べて見ます。
Interactions API で指定する
Interactions API では、generation_config の thinking_level に小文字で書きます。Gemini API ドキュメントの例をもとにすると、次の形です。
interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="この支払いの再試行の処理に、同時に動いたときの不具合がないか調べて",
    generation_config={"thinking_level": "xhigh"},
)
print(interaction.output_text)
print(interaction.usage.total_thought_tokens)  # 考えた量
考えた量は usage.total_thought_tokens で取れます。考えた中身の要約がほしいときは、同じ generation_config に "thinking_summaries": "auto" を足すと、要約が返ってきます(既定では最終の答えだけが返ります)。
thinking budget は使わない
以前の Gemini のモデルには、考える量をトークン数で決める thinkingBudget(thinking budget)という設定がありました。Google Cloud の手引きは、Hydrogen で thinking_budget を指定すると HTTP 400 のエラーになると書いています。
一方、私たちが11月13日に Gemini API(Google Cloud ではなく AI Studio の鍵)で thinkingBudget: 0 を付けて呼んだところ、エラーにはならず、応答が返りました。そのときも思考トークンは29使われていて、「考えない」にはなっていません。
つまり、Gemini API では受け付けても効いていない可能性が高く、Google Cloud ではエラーになるということです。古いコードに thinkingBudget が残っていたら、thinkingLevel に書き換えておくのが安全です。
ツールの中で選ぶとき
Google Antigravity では、モデルの選択肢から Hydrogen を選び、考える段を Low・Medium・High・Extra から選びます。Gemini CLI での設定も含めて、ツールでの選び方はこちらにまとめています。
手元の Gemini API で4段を比べた結果
2026年11月13日の早朝、私たちが普段使っている Gemini API の鍵で、同じ問題を段を変えて1回ずつ解かせました。問題は「りんご120円・みかん45円で、ちょうど1,000円になる買い方を全部挙げる」です。120と45はどちらも15の倍数なのに1,000は15で割り切れないので、答えは「0通り」になるひっかけです。
段 | 思考トークン | 答えのトークン | 応答まで | 答え | 1,000回の出力の費用(試算) |
|---|---|---|---|---|---|
minimal | — | — | — | 400 エラー | — |
low | 363 | 200 | 3.4秒 | 正解 | 約 $4.2 |
medium | 738 | 230 | 5.1秒 | 正解 | 約 $7.3 |
high | 293 | 190 | 7.2秒 | 正解 | 約 $3.6 |
指定なし(=high) | 677 | 178 | 4.9秒 | 正解 | 約 $6.4 |
xhigh | 2,470 | 566 | 11.9秒 | 正解 | 約 $22.8 |
費用の列は、思考トークンと答えのトークンの合計に、出力の単価 $7.50(100万トークンあたり・2026年11月13日時点の公式の移行ガイドの値)を掛けて1,000倍した試算です。入力は1回95トークンで、1,000回でも約 $0.14 なので省いています。料金は変わることがあるので、使う前に公式の料金ページ(https://aistudio.google.com/docs/pricing)で確かめてください。
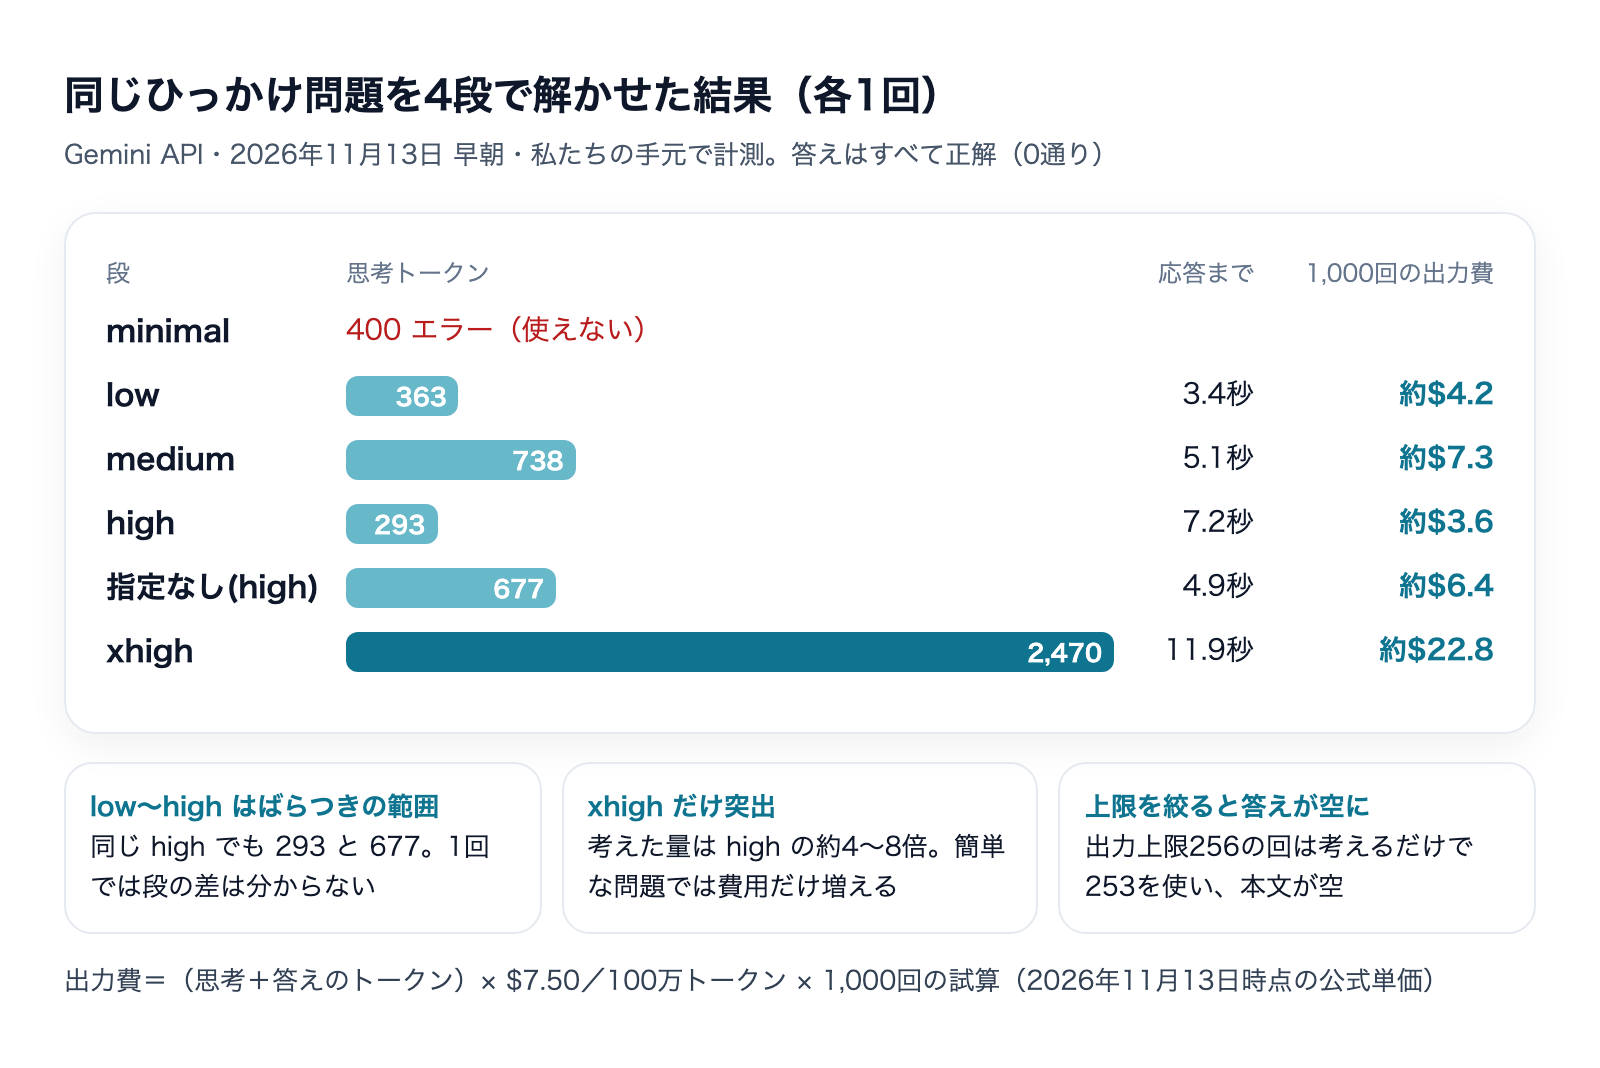
この結果から読み取れることは3つです。
- low・medium・high の差は、1回ではばらつきに埋もれる。いちばん分かりやすいのは「high」と「指定なし」で、同じ high の段なのに思考トークンは293と677で、2倍以上違いました。medium が high より多く考えたのも、1回だけの結果です
- xhigh だけははっきり違う。思考トークンは high の約4〜8倍、時間は約1.7〜2.4倍、出力の費用は約3.5〜6倍でした。簡単な問題では、xhigh は答えの質を上げずに費用だけを上げます
- この問題では、どの段でも正解した。少し考えれば解ける問題なら、low で足ります。段の差が出るのは、もっと手順の多い仕事です
同じ日に、出力の上限(maxOutputTokens)を256にして呼んだ回では、考えるだけで253トークンを使い、答えの本文が空のまま「MAX_TOKENS」で止まりました。段を下げずに上限だけを絞ると、費用は抑えられても答えが返らないことがある、という実例です。出力の上限で答えが切れる仕組みは、こちらで詳しく説明しています。
thinking level でつまずきやすい所
ドキュメントと手元の結果から、設定でつまずきやすい所を5つ挙げます。
1. minimal を指定するとエラーになる
Hydrogen に minimal を送ると、「Thinking level MINIMAL is not supported for this model」という 400 のエラーが返ります(11月13日に手元で確認)。古いモデル向けの設定を使い回しているときに起きやすいので、low に直します。
2. 出力の上限を絞りすぎて答えが空になる
上の実例のとおり、思考トークンも max_output_tokens に数えられます。Google は「費用を下げたいなら、出力の上限を小さくするのではなく、段を下げる」ようにと書いています。上限は思考と答えの両方が入る大きさにしておきます。
3. 既定のまま乗り換えて、費用と待ち時間が増える
3.8 Flash や Carbon・Argon はどれも既定が medium です。モデル名だけを gemini-4-hydrogen に書き換えると、段が high に上がり、1回あたりに考える量が増える方向に動く可能性があります。乗り換えるときは、段を明示して書いておくと、何が変わったのかを後で追えます。
4. 会話の途中で履歴を書き換えるとエラーになる
Hydrogen は、考えた内容を暗号化した「thought signature」を応答に付けて返します。Google Cloud の手引きによると、前の発言やシステムの指示を書き換えてから同じモデルに送り直すと、既定では 400 のエラーになります。履歴を要約したり削ったりする仕組みでは、prefix_mismatch_behavior を DROP にする設定が案内されています。
5. 長い出力を何回かに分けるときは、途中で段を変えない
Hydrogen は、1回の出力が 65,536 トークンを超える長い仕事を、続きを何回かに分けて出せます。Google Cloud の手引きは、その途中で thinking_level を変えてもエラーにはならないが、変えないようにと書いています。
私たちの段の選び方
私たちは社内で、無人で動く定型の仕事を毎日いくつも回しています。そこで決めているのは、仕事の重さでモデルと設定を分け、どの仕事にどの設定を使うかを必ず書いておくことです。たとえば、決まった形の集計や転記のような機械的な仕事は速くて安い設定、公開する文章の執筆や判断が要る仕事は上位の設定、と仕事ごとに固定しています。
設定を書かずにおくと、提供元が既定を変えたときに、知らないうちに費用や待ち時間が変わります。今回の Hydrogen はまさにその例で、3.8 Flash の既定 medium から high に上がりました。
Hydrogen の段に当てはめると、私たちは次の順で決めるのがよいと考えています。
- 仕事を3つに分ける:形の決まった大量の仕事(分類・要約・抜き出し)/人が待つ対話やツールの1手/中身を考えさせる仕事(コード・調べもの・エージェント)
- 最初の段を決める:大量の仕事は low、対話は medium、考えさせる仕事は既定の high から始める
- xhigh は「high で失敗した仕事」にだけ足す:最初から xhigh を既定にしない
この順は Google の推奨と同じ向きです。違うのは、最初から4段すべてを試すのではなく、仕事の種類で当たりを付けてから試す点です。仕事の種類が多い会社ほど、全部を4段で試すのは手間がかかるからです。
自分の仕事で段を決める手順
Google のドキュメントがすすめているのは、「出力の上限を大きくしたうえで4段すべてで評価し、品質の基準を満たす中でいちばん低い段を選ぶ」やり方です。私たちの手元の結果でも1回ごとのばらつきが大きかったので、次のように数をそろえて比べることをおすすめします。
- 実際の仕事から10〜20件を選ぶ:うまくいった例だけでなく、前のモデルで失敗した例も入れる
- 合格の基準を先に決める:「分類が正しい」「表の数字が元の資料と合う」など、見れば判定できる形にする
- 出力の上限を大きくして、low・medium・high で流す:答えが途中で切れて失敗した、という結果を混ぜないため
- 合格した件数・思考トークンの平均・時間の平均を並べる:
thoughtsTokenCountを記録しておく - high でも落ちる件があれば、その件だけ xhigh で流す:xhigh で直るなら、その種類の仕事だけ xhigh にする
20件を4段で流すと80回の呼び出しです。手元で確かめたかぎり、Gemini API の無料枠では、Hydrogen は1日20回で上限に達しました(11月13日・無料の鍵)。評価をまとめて回すなら、有料の枠で行うのが現実的です。
Gemini 4 Hydrogen の thinking level のよくある質問
thinking level を指定しないと、どの段で動きますか?
high で動きます。Gemini 4 の Carbon・Argon や 3.8 Flash は既定が medium なので、そこから乗り換えると段が1つ上がります。
xhigh にすれば答えは必ず良くなりますか?
なりません。Google は、簡単な質問では考えすぎることがあると注意しています。手元の簡単な問題では、どの段でも正解し、xhigh は費用と時間だけが増えました。
minimal はなぜ使えないのですか?
Gemini 4 のモデルと 3.8 Flash は minimal に対応していません。理由は公式には書かれていません。いちばん浅い段は low です。
Gemini アプリで thinking level を選べますか?
11月13日時点の発表とドキュメントには、Gemini アプリの中で Hydrogen の段を選ぶ方法は書かれていません。段を自分で選べるのは、Gemini API・Google AI Studio と、Antigravity などの開発ツールです。
段によって料金の単価は変わりますか?
単価は変わりません。変わるのは考える量で、考えた分が出力のトークンとして課金されます。段を上げると、同じ単価のまま使うトークンが増えます。
まとめ|迷ったら high、xhigh は最後の手段
- Gemini 4 Hydrogen の thinking level は low・medium・high・xhigh の4段で、既定は high。minimal は 400 エラー
- Carbon・Argon・3.8 Flash の既定は medium。xhigh を持つのは Hydrogen だけ
- 考えた分は出力トークンとして課金され、
max_output_tokensにも数えられる。上限を絞るより段を下げる - API では
thinkingConfig.thinkingLevel(generateContent)かgeneration_config.thinking_level(Interactions API)で指定する。thinkingBudgetは使わない - 手元の結果では、low〜high の差は1回ではばらつきに埋もれ、xhigh だけが費用と時間をはっきり増やした
- 段は、自分の仕事を10〜20件流して、合格する中でいちばん低い段を選ぶ
段の設定は小さな項目に見えますが、回数の多い仕事では費用と待ち時間に直接効きます。株式会社Fyveでは、こうした設定を実際の業務に当てはめたときに何が変わるかを、引き続き手元で確かめながらお伝えしていきます。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。