Gemini 4 Hydrogenのベンチマーク|数値と読み方

「Gemini 4 Hydrogen のベンチマークは、結局どれくらい強いのか」「Google の表では Claude Sonnet 5.5 や GPT-6.1 Terra に勝っている行が多いけれど、そのまま信じていいのか」——新しいモデルの数字の表を前にして、こう迷う方は多いはずです。
結論から言うと、Gemini 4 Hydrogen の公式ベンチマークは、資料や図表を読む仕事と、事務の定型作業を任せる仕事では3社の速いモデルの中で最も高く、コマンドラインの作業・画面の操作・科学の計算では Claude Sonnet 5.5 に届いていません。ただし Hydrogen の数字は原則としていちばん高い thinking の段(xhigh)で測った値で、他社の数字は各社の自己申告や公開のランキングから引いたものです。条件がそろった比べ方ではない点を押さえて読む必要があります。
株式会社Fyveは、中小企業の AI 活用を月額で伴走支援しながら、社内の定型作業でも複数社の AI を毎日動かしています。この記事では、Google が2026年11月12日に公開したモデルカードと評価の手法の資料、Google の発表、報道を突き合わせ、数字の一覧と、その数字をどう読めばよいかを整理します。
Gemini 4 Hydrogen そのものが何か、3.8 Flash から何が変わったかは、こちらにまとめています。
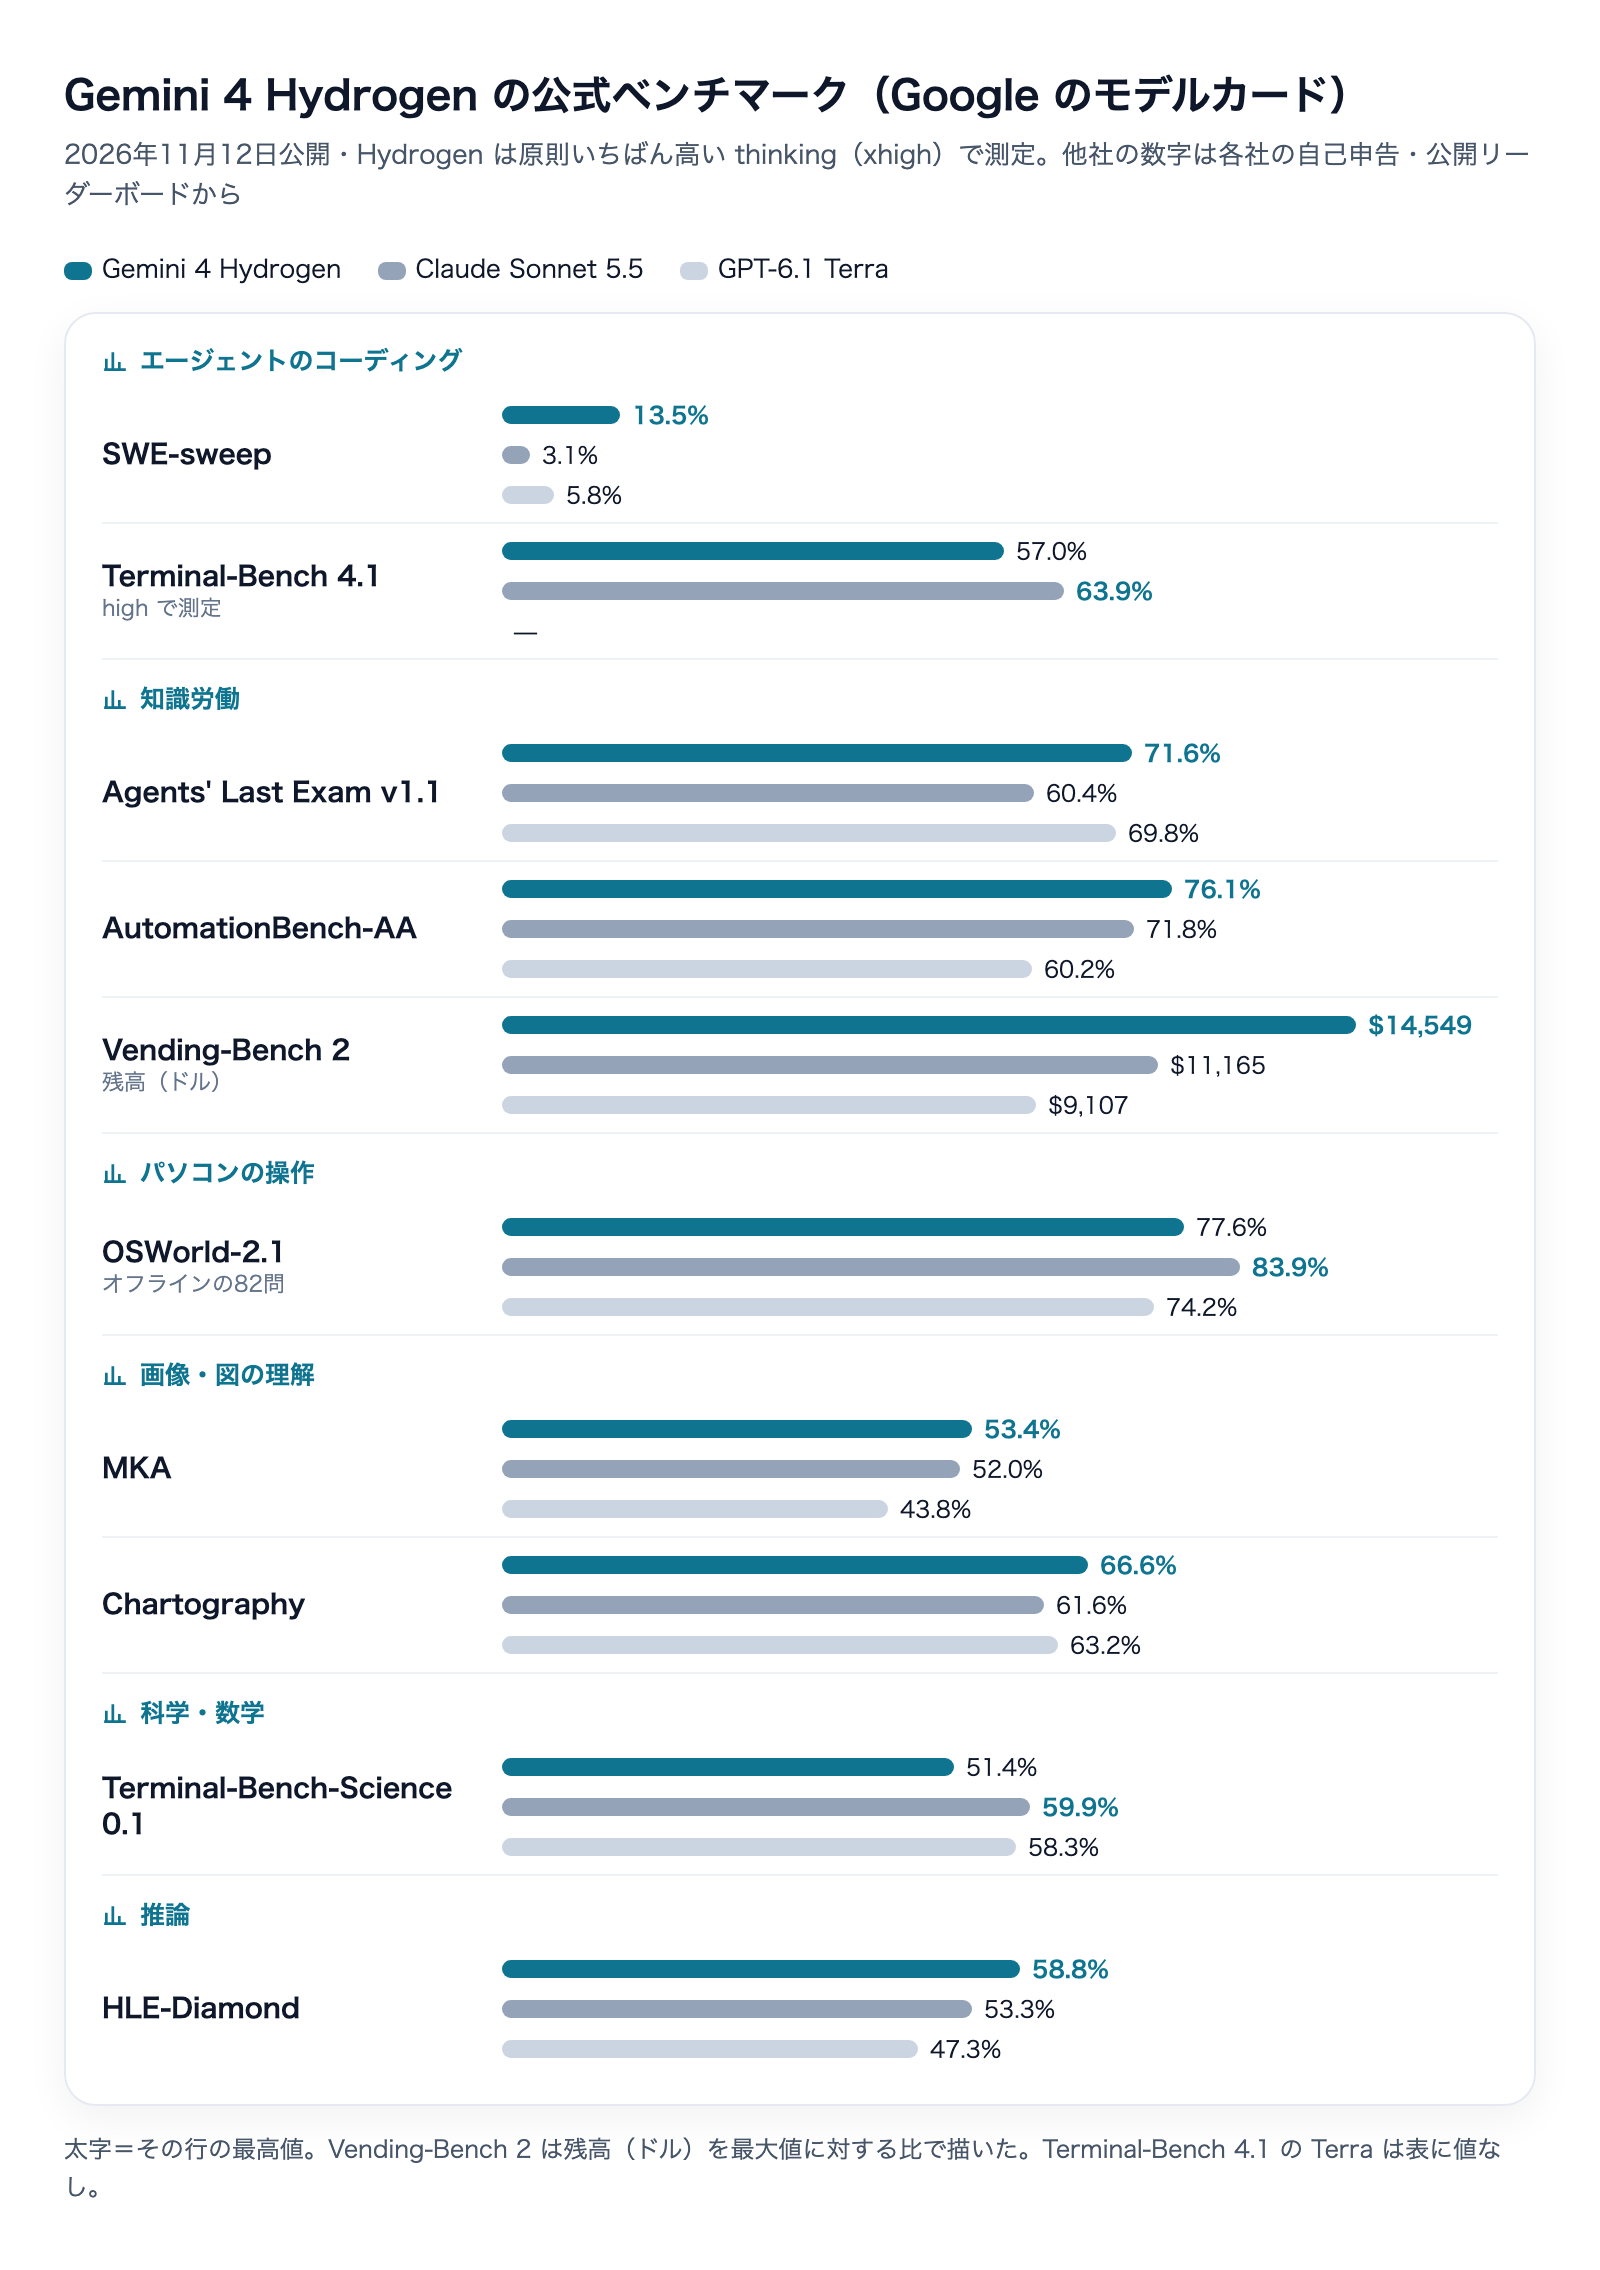
Gemini 4 Hydrogen のベンチマーク一覧(2026年11月12日公開)
Google DeepMind は、Gemini 4 Hydrogen の発表と同じ2026年11月12日に、モデルカードとベンチマークの表を公開しました。表に並んでいる比較相手は、同じ「速い中位のモデル」の格にあたる Claude Sonnet 5.5(Anthropic)と GPT-6.1 Terra(OpenAI)の2つです。上位の Gemini 4 Carbon・Argon や、前の世代の Gemini 3.8 Flash は、この表には入っていません。
分野 | ベンチマーク | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|
エージェントのコーディング | SWE-sweep | 13.5% | 3.1% | 5.8% |
エージェントのコーディング | Terminal-Bench 4.1(不正を差し引いた正答率) | 57.0% | 63.9% | — |
知識労働 | Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
知識労働 | AutomationBench-AA | 76.1% | 71.8% | 60.2% |
知識労働 | Vending-Bench 2(最終の残高) | $14,549 | $11,165 | $9,107 |
パソコンの操作 | OSWorld-2.1(オフラインの部分) | 77.6% | 83.9% | 74.2% |
画像・図の理解 | MKA | 53.4% | 52.0% | 43.8% |
画像・図の理解 | Chartography | 66.6% | 61.6% | 63.2% |
科学・数学 | Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
推論 | HLE-Diamond | 58.8% | 53.3% | 47.3% |
太字は各行の最高値です。10行のうち Hydrogen が最高なのは7行、Sonnet 5.5 が最高なのは3行で、Terra が最高の行はありません。
表の外でも、Google の発表には次の数字が書かれています。
- Artificial Analysis Intelligence Index(複数のテストをまとめた総合の指数): 既定の high で51、いちばん高い xhigh で54。上位モデルの Gemini 4 Argon の50を上回る
- Vals Tax Agent Bench(税務の作業): 52.3%で全体の1位
- Vals Legal Research Bench(法務の調べもの): 55.8%で1位タイ
- Agent Arena(人の投票で決まるエージェントの順位): 5位
- Terminal-Bench 4.1 の前の世代との比較: Gemini 3.8 Flash の18.2%から57%へ、3倍を超える
Artificial Analysis の指数と Terminal-Bench 4.1 の伸び、HLE-Diamond・MKA・Agents' Last Exam の値は、9to5Google の2026年11月12日の記事にも同じ数字で載っています。
Gemini 4 Hydrogen のベンチマークを読む前に押さえる3つの条件
Google はモデルカードとは別に、評価の手法をまとめた資料(Gemini 4 Hydrogen Model Evaluation)を公開しています。ここに、表の数字がどんな条件で取られたかが書かれています。この条件を知らずに表を読むと、自分の使い方で出る性能を見誤ります。
条件1: Hydrogen の数字は原則「いちばん高い thinking の段」で取っている
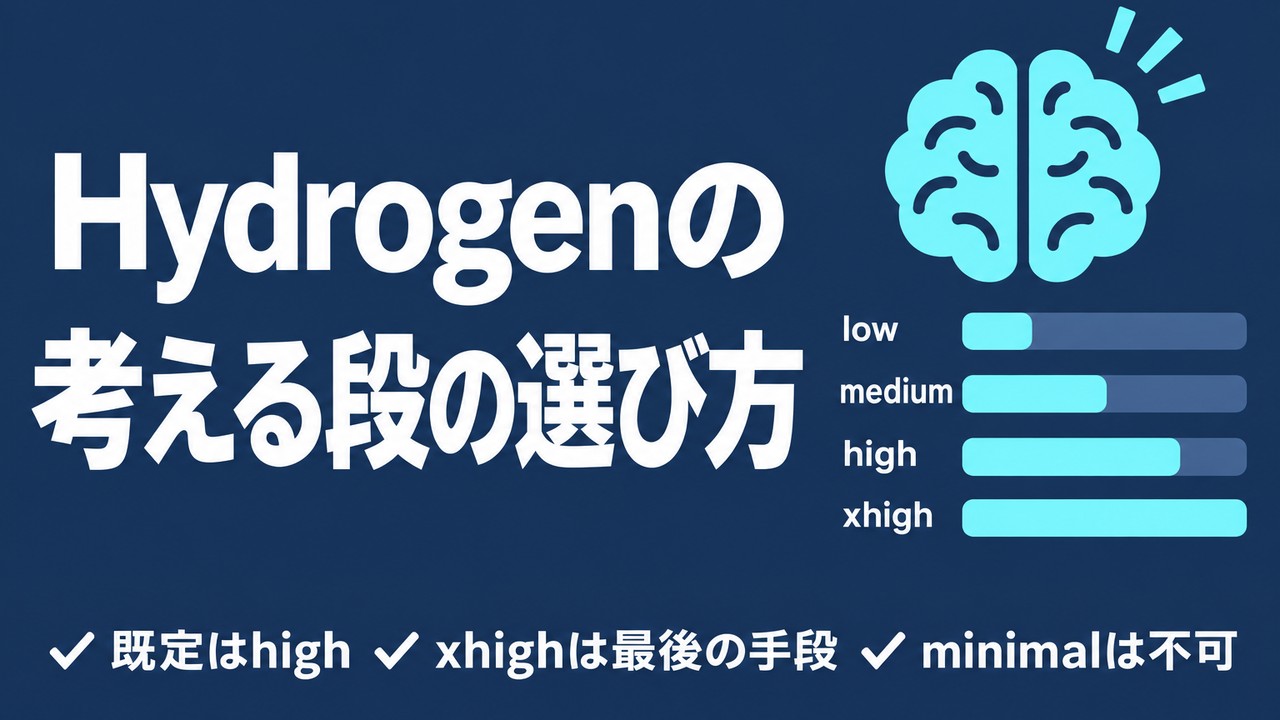
評価の資料には「すべての結果は、下に別の記載がない限り、Gemini API で最も高い thinking の設定で実行した」とあります。Gemini 4 Hydrogen の thinking level は low・medium・high・xhigh の4段で、API で何も指定しないときの既定は high です。つまり表の大半は、既定より1段高い xhigh で出した数字だと読むのが自然です。
例外として明記されているのは Terminal-Bench です。4.1 と 4.0 はどちらも「high の段で」測ったと書かれています。
段の差がどれくらい点に効くかは、Artificial Analysis の指数が1つの手がかりになります。high で51、xhigh で54。3点の差です。ほかのベンチマークで段ごとの値は公開されていないので、「既定の high で使うと、表の数字より少し下がりうる」と考えておくのが安全です。thinking level の各段の意味と選び方は、こちらで整理しています。
条件2: 他社の数字は、各社の自己申告と公開のランキングから引いている
同じ資料には「Gemini 以外のモデルの結果は、別の記載がない限り、各社が自分で出した数字から取った」「Sonnet 5.5 と GPT-6.1 Terra は、公開されている最大の推論の設定の結果を使い、それが無いときは手に入る最良の結果を使った」とあります。行ごとの出どころは次のとおりです。
ベンチマーク | Hydrogen の数字 | 他社の数字 |
|---|---|---|
SWE-sweep | Google が自社のツール(Antigravity CLI 1.4.8)で計算 | 公開のランキング |
Terminal-Bench 4.1 | Google が計算(1問5回の平均・high) | Sonnet 5.5 は公開のランキング |
Agents' Last Exam v1.1 | Google が計算(122問・5時間の枠) | Sonnet 5.5 は Google が同じ条件で計算、Terra は公開のランキング |
AutomationBench・HLE-Diamond | どちらも Artificial Analysis のランキングから | |
Vending-Bench 2 | どちらも Andon Labs の公開ランキングから | |
OSWorld-2.1 | Google が計算(3回のうち最高) | Sonnet 5.5 は Google が同じ条件で計算、Terra は公開のシステムカードから |
MKA | Google が計算 | Artificial Analysis のランキングから |
Chartography | Google が計算(道具なし) | Terra は Google が計算、Sonnet 5.5 は公開のシステムカードから |
Terminal-Bench-Science 0.1 | Google が計算(1問5回の平均) | 公開のランキング |
第三者のランキングから3つとも引いている行(AutomationBench・HLE-Diamond・Vending-Bench 2)は、測り方がそろっている度合いが比較的高いと読めます。一方、Hydrogen だけを Google が自社のツールで測り、相手はランキングの値を使っている行(SWE-sweep など)は、ツールの違いが点に混ざっている可能性があります。
実際、Agents' Last Exam の Terra の値は、OpenAI 自身が10月26日の発表で出した数字(v1 で medium 57.6%・max 60.0%)と、Google の表の値(v1.1 で69.8%)が一致しません。版(v1 と v1.1)が違うためで、どちらかが誤りというわけではありませんが、版をまたいだ数字を並べて比べないよう注意が必要です。GPT-6.1 Terra 側の公式の数字の読み方は、こちらにまとめています。
GPT-6.1 Terraのベンチマーク|公式の数値と読み方
条件3: 1回勝負の値と、複数回の平均・最高値が混ざっている
資料によると、Hydrogen の数字は原則「pass@1」(1回答えさせて、その1回で採点する)で、多数決や並列で何度も解かせる工夫は使っていません。ただし行によって扱いが違い、Terminal-Bench は1問につき5回の平均、OSWorld は3回走らせたうちの最高値です。
平均と最高値では、同じモデルでも最高値のほうが高く出ます。OSWorld の Hydrogen 77.6% と Sonnet 5.5 83.9% はどちらも Google が「3回のうちの最高」で計算した値なので、この2つの比較は条件がそろっています。ここで Sonnet 5.5 が上回っているのは、読み落とせない結果です。
Gemini 4 Hydrogen がベンチマークで強い分野
条件を踏まえたうえで、Hydrogen が上に出ている行を、仕事の言葉に置き換えて見ていきます。
資料・図表・画像を読む(MKA・Chartography)
MKA(Multimodal Knowledge Agent)は、Google の発表で「新しいベンチマーク」として紹介された、画像や資料を見ながら答える力を測るテストです。Hydrogen は53.4%で、Sonnet 5.5 の52.0%をわずかに上回り、Terra の43.8%とは約10点の差があります。Chartography はグラフや図表を正しく読み取れるかを測るもので、Hydrogen 66.6%・Terra 63.2%・Sonnet 5.5 61.6% です。
MKA は、Hydrogen の値を Google が計算し、ほかの2つは Artificial Analysis のランキングから引いています。測った側が違ううえに Sonnet 5.5 との差は1.4点なので、「ほぼ並んでいる」と読むのが妥当です。Terra との差は大きく、図の多い資料を読ませる仕事では Hydrogen を候補に入れる理由になります。
事務の定型作業を任せる(AutomationBench・Agents' Last Exam・Vending-Bench 2)
AutomationBench-AA は Artificial Analysis が運営する、業務のツールを使った自動化の作業を測るベンチマークです。Hydrogen 76.1%・Sonnet 5.5 71.8%・Terra 60.2% で、3つとも同じランキングから引いた値です。Agents' Last Exam v1.1 は、ソフトウェアを使う知識労働の課題(122問)を、点数のつく採点表で評価するもので、Hydrogen は71.6% でした。
Vending-Bench 2 は、自動販売機の経営を長い期間任せ、最後に手元に残ったお金で評価するテストです。仕入れ・値付け・在庫の判断を何度も重ねるので、長く動かしたときに判断がぶれないかが表れます。Hydrogen は残高 $14,549 で、Sonnet 5.5 の $11,165、Terra の $9,107 を上回りました。
この3つは、請求書の転記、表計算の集計、問い合わせの仕分けのような「道具を使って、決まった手順を何度も回す仕事」に近い行です。Google が Hydrogen を「日常の実行役」と位置づけているのと、数字の向きは合っています。
難しい問題の推論(HLE-Diamond)
HLE-Diamond は、Google の表で「推論」の分野に置かれているテストです。Hydrogen 58.8%・Sonnet 5.5 53.3%・Terra 47.3% で、3つとも Artificial Analysis のランキングの値です。Google の発表は「同じ格のモデルの中で首位」と書いています。
SWE-sweep の13.5%は、絶対値の低さも見る
SWE-sweep では Hydrogen 13.5% に対して Sonnet 5.5 3.1%・Terra 5.8% と、比率では大きな差がついています。ただし3つとも点数そのものは低い行です。評価の資料によると Hydrogen の値は Google の Antigravity CLI で計算し、細かい課題ごとの得点を重みづけした値で、他社はランキングの値です。ツールの違いが混ざりうる行なので、私たちはこの行を「コーディングで Sonnet 5.5 の4倍強い」とは読みません。
Gemini 4 Hydrogen がベンチマークで負けている分野
Google の表で Hydrogen が最高を取れていない3行は、どれも「長い手順を、外の環境を触りながら進める」タイプの仕事です。
コマンドラインの作業(Terminal-Bench 4.1)
Terminal-Bench は、ターミナルでコマンドを打ちながら、環境構築やデータ処理などの課題を最後までやり切れるかを測ります。Hydrogen は57.0%、Sonnet 5.5 は63.9%で、約7点の差です。Terra の4.1の値は表にありません。
Hydrogen のこの値は、条件1で書いたとおり xhigh ではなく high で測った値です。xhigh にすれば上がる可能性はありますが、Google はその値を出していません。前の世代の 3.8 Flash(18.2%)からは3倍以上に伸びており、前のモデルで「ターミナルの作業は任せられない」と判断していた人には、見直す理由になる伸び方です。
画面を見てアプリを操作する(OSWorld-2.1)
OSWorld は、パソコンの画面を見て、マウスとキーボードの操作でアプリの作業を終えられるかを測ります。Google はインターネットにつながない82問の部分で測っており、Hydrogen 77.6%・Sonnet 5.5 83.9%・Terra 74.2% でした。
Sonnet 5.5 の83.9%と Terra の74.2%は、OpenAI が Terra の発表で出した図の値とも一致します。条件3で書いたとおり Hydrogen と Sonnet 5.5 は同じ条件で Google が計算しているので、画面操作は Sonnet 5.5 が上と読んでよい行です。Terra とは3.4点差で、Hydrogen が上です。
科学・数値の計算(Terminal-Bench-Science 0.1)
Terminal-Bench-Science は、科学の計算や分析をターミナルで進める課題です。Hydrogen 51.4%・Terra 58.3%・Sonnet 5.5 59.9%で、3つの中では最下位でした。研究の計算や、数値のシミュレーションを任せたい場合は、Hydrogen の上位の Carbon・Argon か、他社のモデルも並べて試すのがよさそうです。上位モデルとの使い分けは、こちらで比べています。
Gemini 3.8 Flash や上位モデルと比べた数字
表は他社との比較ですが、発表とモデルカードには、前の世代や上位モデルと比べた数字も書かれています。
比べた相手 | 項目 | 数字 | 出どころ |
|---|---|---|---|
Gemini 3.8 Flash | Terminal-Bench 4.1 | 18.2% → 57% | Google の発表 |
Gemini 3.8 Flash | 仕事を終える速さ(high) | 約2.5倍速い | Google の発表 |
Gemini 3.8 Flash | 作り話の主張 | 5分の1未満に減少 | Google の発表 |
Gemini 3.8 Flash | 協力企業の試験(グラフ・SQL・データの多い業務) | 2〜2.8倍速く、トークンは12〜23%少ない | Google の発表 |
Gemini 3.8 Flash | 不当な断り(安全に答えられる依頼を断る割合) | 5.57ポイント増(悪化) | モデルカード |
Gemini 3.8 Flash | 画像つきの依頼での安全性 | 7.00ポイント改善 | モデルカード |
Gemini 4 Argon | Artificial Analysis Intelligence Index | Argon 50 に対し Hydrogen 51(xhigh で54) | Google の発表 |
見落とされやすいのが、不当な断りの増加です。モデルカードは「断りの口調は 3.8 Flash と同程度だが、不当な断りは増えており、特に画像などを含む依頼で多い」と書いています。画像つきの業務の依頼を大量に流す使い方では、断られた件数を数える仕組みを入れておくと安心です。
上位モデルとの関係では、総合の指数で Hydrogen が Argon を上回っている一方、モデルカードの安全性の評価の節には「Hydrogen は Argon と比べて、一般的な能力の大きな向上は見られなかった」とあります。Hydrogen は Carbon をもとに作られたモデルで、Google 自身も「いちばん難しい長い推論は Carbon・Argon、速い実行は Hydrogen」と役割を分けています。総合の指数の1点差で「上位より賢い」と読まないほうがよいでしょう。
手元で確かめたこと: 表の数字を出す xhigh は、1回の費用が大きい
表の数字の多くが xhigh で取られているなら、同じ性能を自分の仕事で引き出すには xhigh で動かすことになります。そこで、私たちが2026年11月13日の早朝に Gemini API で同じ問題(りんご120円・みかん45円で、ちょうど1,000円になる買い方は何通りか、というひっかけを含む算数)を段ごとに1回ずつ解かせた結果を、費用の目で並べ直しました。答えはどの段も正解(0通り)でした。
thinking level | 考えたトークン | 答えのトークン | かかった時間 | 1,000回の出力の費用(試算) |
|---|---|---|---|---|
low | 363 | 200 | 3.4秒 | 約 $4.2 |
medium | 738 | 230 | 5.1秒 | 約 $7.3 |
high(既定) | 293 | 190 | 7.2秒 | 約 $3.6 |
xhigh | 2,470 | 566 | 11.9秒 | 約 $22.8 |
費用は、考えたトークンと答えのトークンを足し、出力の単価(100万トークンあたり $7.50・思考トークンを含む・2026年11月13日時点の Gemini API の料金ページ)を掛けて1,000回分にした試算です。入力の費用は含めていません。
xhigh だけが考える量・時間とも突出していて、high の約6倍の出力費になりました。ただしこれは各段1回ずつの結果で、同じ high でも、段を指定しなかった回(既定の high のはず)では考えたトークンが677と、倍以上に割れています。1回の差には、ばらつきが大きく混ざっています。それでも「xhigh は考える量が桁で増えうる」という向きは、モデルカードの「高い段では性能を出すためにより多くのトークンを使うことがある」という注意書きとも合っています。
つまり、表の数字は「費用をかけて最大の段で回したときの上限」に近いものです。日常の仕事を既定の high で流すなら、表より少し低い性能と、ずっと安い費用の組み合わせになると考えておくのが現実的です。
業務で Gemini 4 Hydrogen を選ぶときのベンチマークの使い方
ここまでの内容を、私たちが実際にモデルを選ぶときの手順にまとめます。
1. 自分の仕事に近い行だけを見る
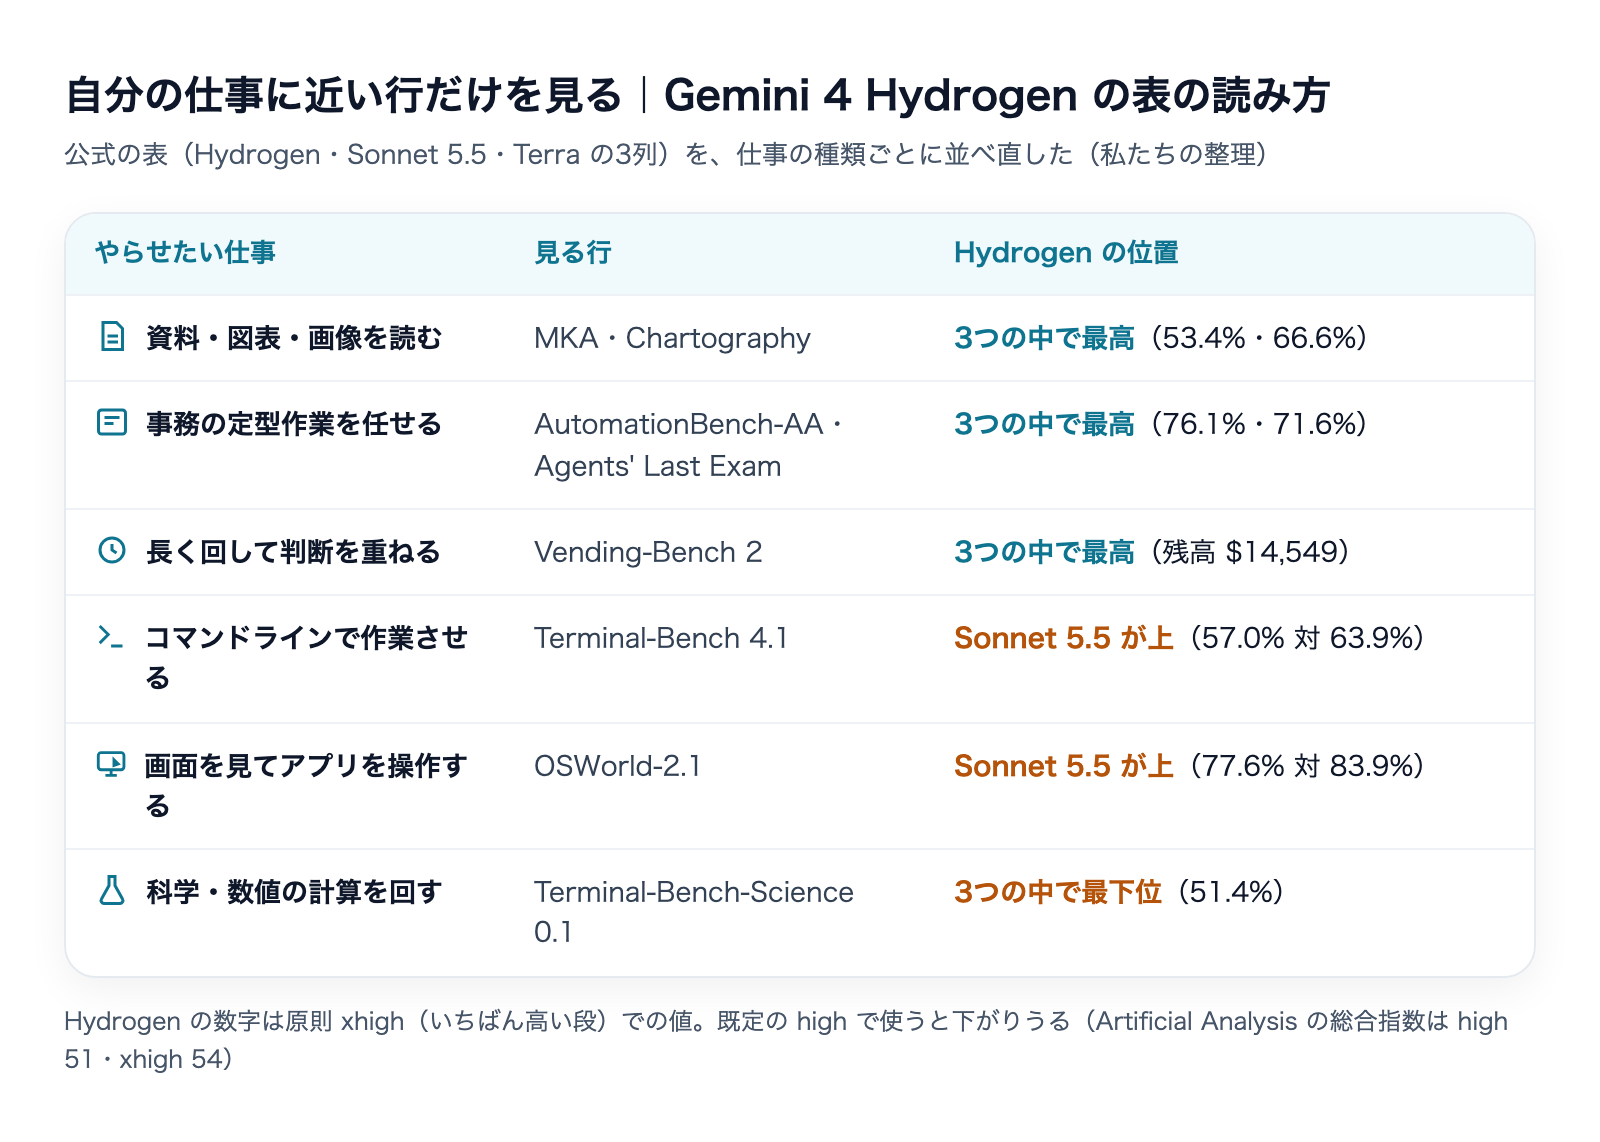
10行すべての平均で「どのモデルが一番か」を決めても、自分の仕事に効くとは限りません。図表の読み取りなら MKA と Chartography、ツールを使う事務なら AutomationBench と Agents' Last Exam、画面操作なら OSWorld、というように、仕事に近い行を2〜3本選んで見ます。Hydrogen は前の2つで強く、画面操作とコマンドラインでは Sonnet 5.5 に届かない、という形がはっきりしています。
2. 行ごとに「誰が測ったか」を確かめる
条件2の表のとおり、第三者のランキングから3つとも引いた行と、Google が自分で測った行が混ざっています。差が数点しかない行で、片方だけ自社のツールで測っている場合は、その差を「ほぼ同じ」と読みます。私たちは、差が大きく、かつ測り方がそろっている行(AutomationBench の Terra との約16点差、OSWorld の Sonnet 5.5 との約6点差など)を、判断の材料として重く見ています。
3. 自分の仕事の10件で、段を変えて試す
ベンチマークは候補を絞るためのもので、最後は自分の仕事で確かめるしかありません。私たちは社内の無人ジョブで、仕事ごとにモデルと設定を明示して固定しています。新しいモデルを入れるときも、実際の仕事から10件ほどを選び、既定の high と1段下の medium で回して、正解の数・かかった時間・出力のトークンを並べてから決めます。Hydrogen なら、xhigh は high で足りなかった仕事にだけ使う、という順番が費用の面でも合理的です。
他社のモデルとどう使い分けるかは、こちらで GPT-6.1 Terra と並べています。Claude Sonnet 5.5 の公式の数字は、こちらで読み方を整理しています。
Gemini 4 Hydrogen のベンチマークでよくある質問
表に Gemini 3.8 Flash の列が無いのはなぜですか
Google のモデルカードの表は、同じ格の他社のモデル(Claude Sonnet 5.5・GPT-6.1 Terra)との比較になっています。3.8 Flash と比べた数字は、表ではなく発表の本文(Terminal-Bench 4.1 の18.2%→57%、約2.5倍の速さなど)と、モデルカードの安全性の節に書かれています。
Gemini 4 Hydrogen は Argon より賢いのですか
Artificial Analysis の総合の指数では Hydrogen(high で51)が Argon(50)を1点上回っています。ただしモデルカードは、Argon と比べて一般的な能力の大きな向上は無かったと書いており、Google も難しい長い推論は Carbon・Argon の役割としています。総合の指数の1点差で上下を決めないほうが安全です。
表の数字は、Gemini アプリや Antigravity で使ったときにも当てはまりますか
評価の資料によると、数字は Gemini API で取ったもので、SWE-sweep と Agents' Last Exam は Antigravity CLI を使っています。Gemini アプリや Antigravity では、どの段で動いているかや、組み合わせる道具が API と違うことがあるため、表の数字がそのまま出るとは限りません。
安全性の詳しい報告はありますか
モデルカードには「Gemini 4 Hydrogen の安全性とセキュリティの報告は数日中に公開する」と書かれており、2026年11月13日の時点では、モデルカードに要約の表があるだけです。
まとめ: Gemini 4 Hydrogen のベンチマークは「強い分野がはっきりしたモデル」と読む
- Google の表(2026年11月12日公開)では、10行のうち7行で Hydrogen が Claude Sonnet 5.5・GPT-6.1 Terra を上回った。強いのは図表の読み取り(MKA・Chartography)、ツールを使う事務(AutomationBench・Agents' Last Exam・Vending-Bench 2)、難しい推論(HLE-Diamond)
- Terminal-Bench 4.1・OSWorld-2.1・Terminal-Bench-Science では Sonnet 5.5 が上。特に画面操作は同じ条件で測った比較で約6点の差
- Hydrogen の数字は原則 xhigh で測った値(Terminal-Bench は high)。他社の数字は自己申告やランキングから引いたもので、条件は行ごとに違う
- xhigh は考える量が大きく増えうる。私たちの1回ずつの試行では、high の約6倍の出力費になった
- 選ぶときは、仕事に近い行を2〜3本に絞り、誰が測ったかを確かめ、最後は自分の仕事の10件で段を変えて試す
ベンチマークは、どのモデルを試すかを絞るための地図です。株式会社Fyveでは、こうした公式の数字と自社の試行を突き合わせながら、仕事ごとに合うモデルと設定を選んでいます。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。