GPT-6.1 Terraのベンチマーク|公式の数値と読み方

「GPT-6.1 Terraのベンチマークを見ると Astra と同じと書いてあるけれど、本当に上位のモデルを使わなくてよいのか」「数字が多すぎて、どれを見て決めればいいのか分からない」——新しいモデルが出るたびに、ベンチマークの表を前にこう迷う方は多いはずです。
結論から言うと、GPT-6.1 Terraの公式の数値でいちばん強いのは、ソフトウェアを使う仕事を測る Agents' Last Exam での「点数あたりの費用」です。effort(推論の強さ)を medium にしたとき、点数は GPT-6 Astra と同じ 57.6% で、1件あたりの費用は約17分の1でした。一方で、コマンドラインのコーディング(Terminal-Bench 4.0)では、Terra を最大の effort にしても GPT-6.1 Sol の medium に届きません。得意と不得意がはっきり分かれたモデルです。
株式会社Fyveは、中小企業のAI導入を支援しながら、自社でも OpenAI と Anthropic のモデルを仕事に合わせて使い分けています。この記事では、2026年10月26日(米国時間)の発表で示された公式の数値を評価ごとに並べ、外部の評価機関の結果と分けて読み方を整理します。あわせて、Terra に発表の図そのものを読ませて、公表値どおりに読めるかを手元で確かめた結果も載せます。
GPT-6.1 Terra が何で、前の世代から何が変わったかの全体像は、次の記事にまとめています。
GPT-6.1 Terraのベンチマーク:公式の数値の一覧
OpenAI は発表で、6つの評価の結果を図で示しました。どの評価も effort を変えて何点も測っており、同じモデルでも設定によって点数が大きく変わります。まず、Terra の medium と max、比べる相手の max を1枚の表にまとめます。
評価(何を測るか) | Terra medium | Terra max | GPT-5.6 Terra max | GPT-6.1 Sol max | GPT-6 Astra max | Claude(max) |
|---|---|---|---|---|---|---|
Agents' Last Exam v1(ソフトを使う仕事) | 57.6% | 60.0% | 50.7% | 58.6% | 59.3% | Opus 5.5:63.2% |
MMMU-Pro(図や画像を読む) | 84.6% | 85.5% | 81.7% | 86.3% | 86.7% | 図に無し |
OSWorld 2.1 offline(デスクトップの操作) | 66.7% | 74.2% | 57.1% | 78.0% | 80.9% | Sonnet 5.5:83.9% |
誤りを誘いやすい質問での誤り率(低いほど良い) | 10.1% | 4.3% | 22.3% | 4.4% | 4.2% | 図に無し |
Terminal-Bench 4.0(コマンドラインのコーディング) | 35.8% | 50.3% | 21.5% | 55.9% | 58.2% | Sonnet 5.5:70.6% |
Terminal-Bench-Science 0.1(研究用のコーディング) | 34.3% | 58.3% | 図に無し | 57.0% | 68.1% | Opus 5.5(予備の構成あり):63.3% |
出典について正直に書いておきます。OpenAI の発表ページ(openai.com)は、私たちの環境からは読み込みが拒否されて直接開けませんでした。そのため、表の値は次の2つで確かめています。
- Agents' Last Exam:OpenAI の開発者フォーラムの告知に載っている発表の図そのものを開き、上の値と一致することを目で確かめました
- それ以外の5つ:発表の図の値を書き写した Kingy AI の記事の値です。Terminal-Bench 4.0 の 50.3% と 21.5%、誤り率の数字は Interesting Engineering と 9to5Mac も同じ値を伝えています。MMMU-Pro と OSWorld の細かい値は、私たちは公式の図で確かめられていません
どの数字も OpenAI 自身が測ったものです(2026年10月27日時点)。外部の評価機関の結果は、後の節で分けて扱います。
Agents' Last Exam:GPT-6.1 Terraの主張の中心
Agents' Last Exam は、仕事で使うソフトウェアを操作して、最後まで成果物を作れるかを測る評価です。OpenAI は例として、建築の図面から3Dモデルを作る仕事や、映像の修復チームのためにカットごとの記録を作る仕事を挙げています。表計算や文書作成の単純な問題集ではなく、複数のアプリをまたいで手順を進める力を見る評価です。
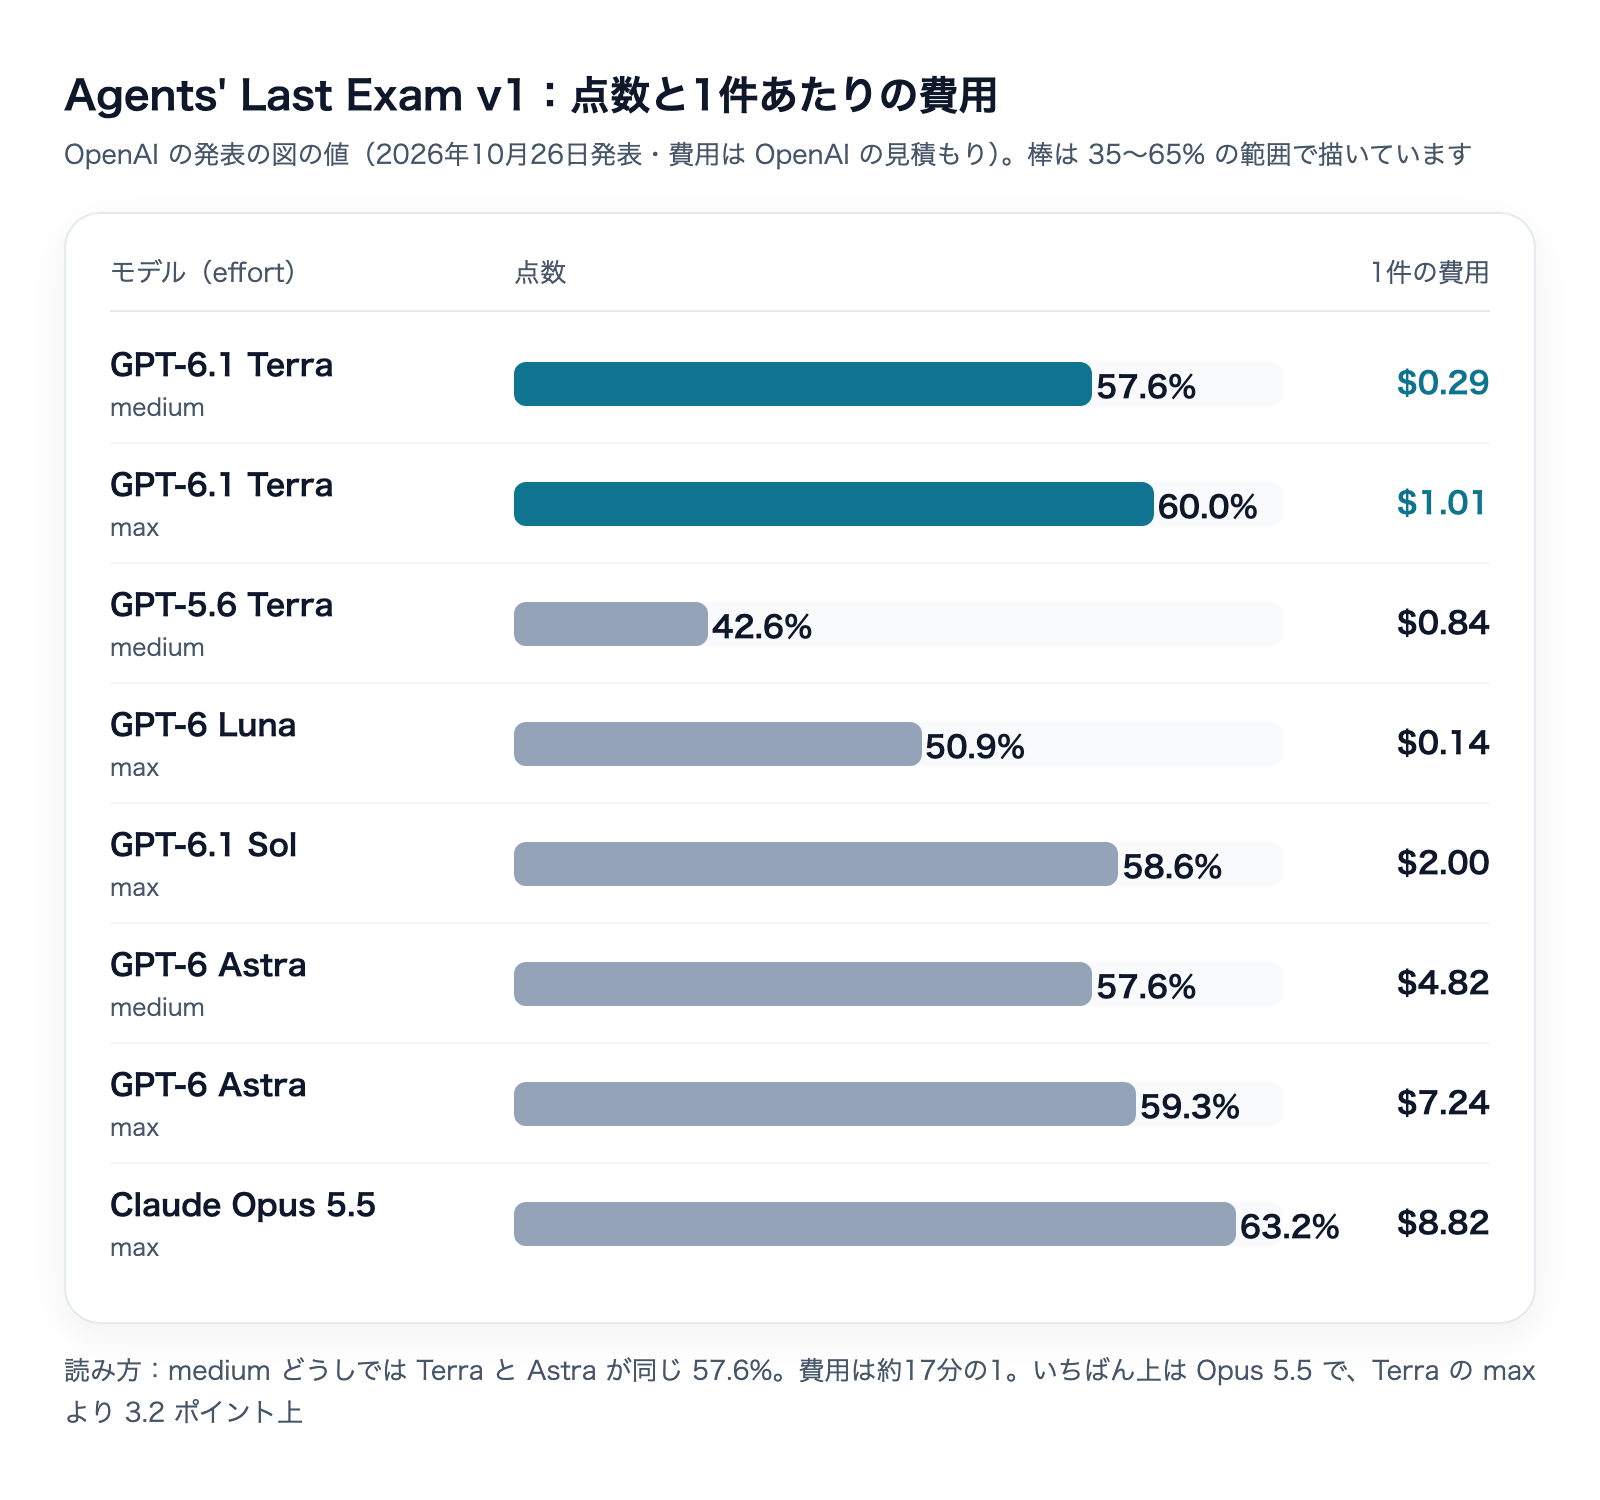
OpenAI の発表の要点は2つです。1つは、medium どうしで GPT-5.6 Terra より15ポイント高いこと。もう1つは、GPT-6 Astra と同じ水準を、トークンの単価10分の1で出していることです。
「Astra と同じ」は medium どうしの比較
図の値を見ると、Terra の medium は 57.6%、Astra の medium も 57.6% で、たしかに並んでいます。1件あたりの費用は Terra が $0.29、Astra が $4.82 です。割り算すると約17分の1になります。
ただし、max どうしで比べると話は少し変わります。Terra の max は 60.0%、Astra の max は 59.3% で、Terra がわずかに上です。差は0.7ポイントしかないので、どちらが上と言える差ではありません。「同じくらいの点数を、ずっと安く出す」と読むのが正確です。
GPT-5.6 Terra からの伸び
前の世代の GPT-5.6 Terra は、medium で 42.6%(1件 $0.84)でした。新しい Terra は medium で 57.6%(1件 $0.29)なので、15ポイント上がって費用は約3分の1になっています。前の世代の max(50.7%)を、新しい Terra は medium の時点で超えています。
Claude Opus 5.5 とは3.2ポイント差
この図でいちばん点数が高いのは Claude Opus 5.5 の 63.2%(1件 $8.82)です。Terra の max(60.0%・$1.01)より3.2ポイント上で、費用は約8.7倍です。OpenAI の図なので、Claude 側の測り方が Anthropic の発表と同じとは限りません。それでも、OpenAI 自身が自社の新モデルより上の点数を図に載せている点は覚えておく価値があります。
Claude との使い分けは、点数よりも仕事の中身で決めたほうが安全です。その整理は次の記事に書きました。
「3倍以上速い」の読み方
OpenAI は、この評価で Terra が Astra と GPT-6.1 Sol より平均で3倍以上速く仕事を終えると発表しています。これは長い手順を踏む仕事での話です。私たちが Codex CLI で短い分類の指示を Terra と Sol に3回ずつ出したときは、起動を含めて Terra が約4.1秒、Sol が約5.0秒で、3倍の差は出ませんでした。短い仕事では、モデルの速さよりも起動や通信の時間のほうが大きいからです。速さの差が効くのは、何十もの手順を続ける仕事だと考えてください。
画面を読む・操作する:MMMU-ProとOSWorld 2.1
OpenAI は Terra を「画面に映っているものを理解し、アプリをまたいで操作するモデル」と紹介しています。その裏付けになるのが、画像を読む MMMU-Pro と、デスクトップを操作する OSWorld 2.1 の2つです。
MMMU-Pro:上位モデルとの差は1ポイント前後
MMMU-Pro は、図・表・写真が入った問題を解く評価です。Terra の max は 85.5% で、Sol の max(86.3%)、Astra の max(86.7%)との差は約1ポイントです。medium でも 84.6% あります。Interesting Engineering も、Terra はどの effort でも GPT-5.6 Terra を上回り、Astra と Sol に近い点数だったと伝えています。
図面の比較や、商品写真とカタログの照合のような仕事は、上位のモデルでなくても十分に試す価値がある、と読めます。OpenAI の開発者向けの手引きも、Terra の用途として「商品写真とカタログの照合」「技術図面の比較」「アプリの画面での操作」を挙げています。
OSWorld 2.1:前の世代より大きく伸びたが、いちばん上ではない
OSWorld 2.1 は、デスクトップのアプリを何段階も操作して仕事を終えられるかを測ります。Terra の medium(66.7%)は、前の世代の max(57.1%)を上回りました。一方、Terra の max(74.2%)は、Sol(78.0%)、Astra(80.9%)、Claude Sonnet 5.5(83.9%)より下です。
ここで1つ注意したいのは費用です。Kingy AI の書き写しによると、OSWorld の max での1件あたりの費用は Terra が $1.19、Sol が $1.15 で、Terra のほうがわずかに高くなっています。トークンの単価は Terra が半分でも、仕事を終えるまでに多くのトークンや手順を使えば、1件の費用は逆転します。「単価が安いモデル=1件が安いモデル」とは限りません。
手元で確かめたこと:Terra に発表の図を読ませる
画像を読む力を手元で1つ確かめるため、Terra に Agents' Last Exam の発表の図(画像)を渡して、4つの点の値を読み取らせました。条件は次のとおりです。
- 2026年10月27日、ChatGPT アカウントでサインインした Codex CLI 0.164.0、effort は medium
- 図には数値のラベルが付いていない。点の位置を軸の目盛りから読む必要がある
- 同じ指示で3回
読ませた点 | 公表値 | 1回目 | 2回目 | 3回目 |
|---|---|---|---|---|
GPT-6.1 Terra(max) | 60.0%・$1.01 | 60.1%・$1.00 | 60.0%・$1.00 | 60.1%・$1.00 |
Claude Opus 5.5(max) | 63.2%・$8.82 | 63.2%・$8.80 | 63.2%・$8.79 | 63.2%・$8.81 |
GPT-6 Astra(max) | 59.3%・$7.24 | 59.4%・$7.23 | 59.3%・$7.22 | 59.4%・$7.23 |
GPT-5.6 Terra(max) | 50.7% | 50.7%・$3.57 | 50.8%・$3.57 | 50.8%・$3.57 |
3回とも、点数のずれは0.1ポイント以内、費用のずれは3セント以内でした。1回の応答は5〜7秒、使ったトークンは約6,600です(Codex 自身の指示を含む)。目盛りの間を読む仕事なので、0.1ポイントのずれは人が読んでも出る範囲です。
この確認から言えるのは、「すっきりしたグラフの値を読む」程度の仕事なら Terra の medium で足りそうだ、ということまでです。細かい文字が詰まった図面や、読み違えると困る書類では、この結果を根拠にしないでください。
コーディング:Terminal-Bench 4.0では上位に届かない
Terminal-Bench 4.0 は、コマンドラインで動くコーディングのエージェントが、実際の問題を解けるかを測る評価です。例として、読み込みのたびにレイアウトがずれるWebページを直す問題が挙がっています。
Terra の max は 50.3% で、前の世代(21.5%)の2倍以上です。伸びは大きいものの、上位のモデルと比べると差が残ります。
- Terra は effort を上げるほど点数が伸びる:low 24.8% → medium 35.8% → max 50.3%(Kingy AI の書き写し)
- Sol は medium の時点で 52.7%。Terra の max より上で、1件の費用も Sol の medium($1.02)のほうが Terra の max($1.84)より安い
- Claude Sonnet 5.5 の max は 70.6%(1件 $10.44)
つまり、難しいコーディングでは「Terra の effort を最大にする」より「Sol を medium で使う」ほうが、点数も費用も有利という結果です。OpenAI 自身も、込み入ったコーディングには GPT-6.1 Sol か GPT-6 Astra を選ぶよう案内しています。
Sol との使い分けは、次の記事で詳しく書きました。
研究用のコーディングを測る Terminal-Bench-Science 0.1 では、Terra の max(58.3%)が Sol の max(57.0%)をわずかに上回りました。ただ、差は1.3ポイントです。測り直したときのぶれの幅が示されていないので、「研究用なら Terra が上」とまでは言えません。
事実の誤り:誤り率は下がったが、読み方に注意
OpenAI は、誤りを誘いやすい質問を集めた社内の評価で、Terra の誤りが大きく減ったと発表しています。effort を low にしたとき、何らかの事実の誤りを含む回答の割合が、GPT-5.6 Terra の 53.6% から 16.7% に下がりました。max では 22.3% から 4.3% で、Sol(4.4%)や Astra(4.2%)とほぼ同じです。
この数字を「Terra の答えは4.3%しか間違えない」と読むのは誤りです。OpenAI のシステムカードには次のように書かれています。
- 問題は、利用者が「事実の誤りがある」と報告した ChatGPT の会話から作っている(個人が分からない形に加工したもの)
- 誤りが起きやすい場面だけを集めているので、ふだんの利用での誤りの率よりずっと高く出る。実際の利用での誤り率として読まないでほしい
- 評価を作り直したので、以前のシステムカードの数字とは比べられない。古いモデルも作り直した評価で測り直した
外部の評価でも、誤りは減っています。Artificial Analysis の AA-Omniscience(分からない問いに当て推量で答えてしまう割合を測る評価)では、GPT-5.6 Terra の 88% から 38% に下がり、正答率も2ポイント上がりました。ただし、こちらも測り方が違うので、OpenAI の誤り率と並べて比べることはできません。
どちらの数字も、「前より調べ物を任せやすくなった」とは言えても、「確認しなくてよくなった」とは言えません。Terra の知識は2026年6月1日までなので、それより後の出来事は、検索や資料を渡して答えさせる必要があります。
外部の評価:Artificial Analysisでは上位に届かない
ここまでの数字はすべて OpenAI 自身が測ったものです。外部の評価機関 Artificial Analysis は、10の評価を合わせた総合指標(Intelligence Index)を公開しています。2026年10月26日時点の結果は次のとおりです。
モデル(effort) | 総合指標 | 1件あたりの費用(Artificial Analysis の計算) |
|---|---|---|
Claude Opus 5.5(max・予備の構成あり) | 58 | $5.98 |
Claude Sonnet 5.5(max・予備の構成あり) | 56 | $5.46 |
GPT-6 Astra(max) | 53 | $3.26 |
GPT-6.1 Sol(max) | 52 | $0.72 |
GPT-6.1 Terra(max) | 48 | $0.40 |
GPT-6.1 Sol(medium) | 48 | $0.21 |
GPT-6.1 Terra(medium) | 41 | $0.10 |
(値は Kingy AI が10月26日に Artificial Analysis の一覧から書き写したもの。Artificial Analysis 自身の記事でも、Terra の max は Sol の max より4ポイント低いと書かれています)
読み取れることは3つです。
- 前の世代からは伸びた:Artificial Analysis によると、max で GPT-5.6 Terra より6ポイント高く、1件の費用は $1.40 から $0.40 に下がりました。low と medium では伸びがさらに大きく、7〜13ポイントです
- 総合では上位に届かない:Terra の max(48)は、Sol の max(52)や Astra の max(53)より下です。OpenAI の図で「Astra と同じ」だったのは Agents' Last Exam という1つの評価での話です
- 同じ点数なら Sol の medium のほうが安い:Sol の medium も48で、費用は $0.21。Terra の max($0.40)の約半分です。「Terra はいつでも安い」とは言えません
コーディングでも、Artificial Analysis の Coding Agent Index v2.0 で Terra は48、Sol は54、GPT-6 Luna は31でした。Terminal-Bench 4.0 では約20ポイント伸びて、max で Sol に迫ったとしています。OpenAI の図より差が小さく出ているのは、測る仕組み(エージェントの枠組みや手順の上限)が違うためです。
なお、Artificial Analysis の総合指標は英語の文字だけの評価が中心で、画像の理解は別に測っています。Terra が画像を読む評価で Astra に近く、総合指標では下にいるのは矛盾ではありません。
GPT-6.1 Terraのベンチマークの読み方:5つの確認
ここまでの数字を、モデル選びに使うときの注意としてまとめます。前の世代の GPT-6 Astra のベンチマークを整理したときも、同じ落とし穴がありました。
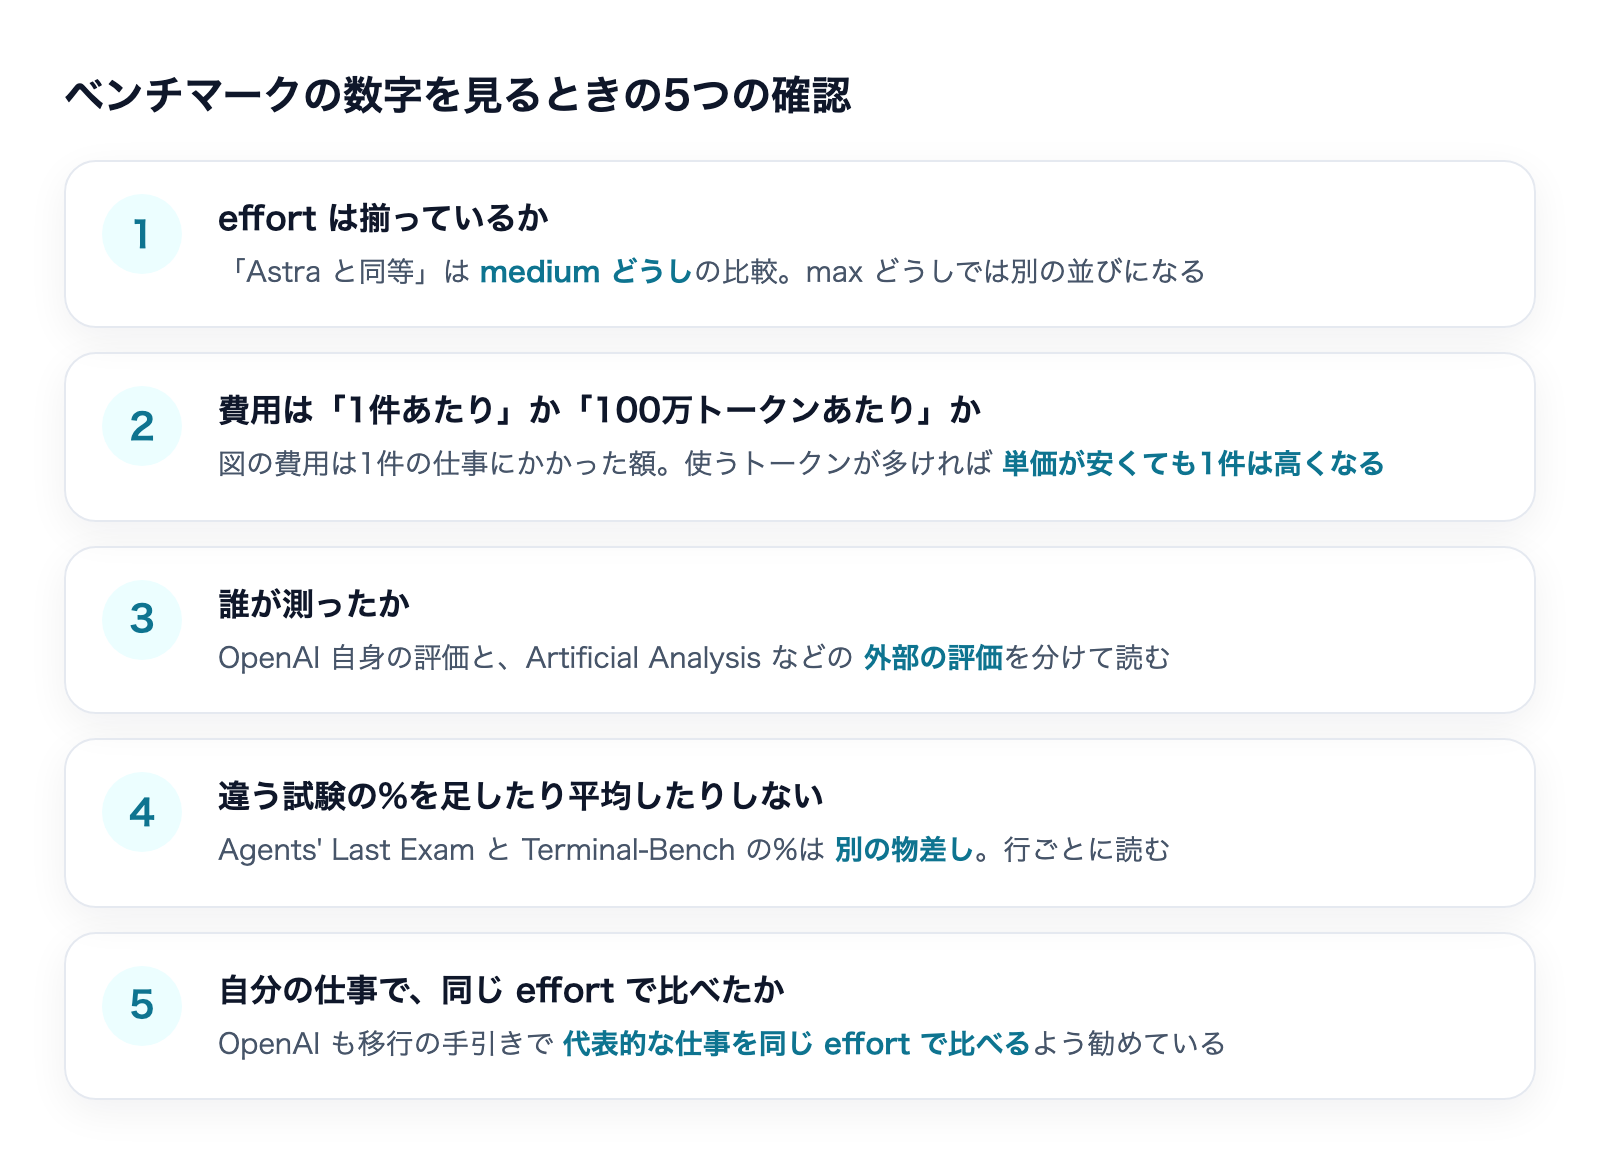
1. effort は揃っているか
同じモデルでも、effort で点数は大きく変わります。Terminal-Bench 4.0 では、Terra の low(24.8%)と max(50.3%)で2倍の差がありました。発表の見出しの数字が、どの effort どうしの比較なのかを必ず確かめてください。「Astra と同じ」は medium どうし、「Opus 5.5 の9分の1の費用」は max どうしの話です。
effort の各段の意味と、手元で6段を比べた結果は次の記事にあります。
2. 費用は「1件あたり」か「100万トークンあたり」か
発表の図の費用は、1件の仕事を終えるまでにかかった額の見積もりです。モデルの料金表に載る「100万トークンあたりの単価」とは別物です。OSWorld の例のように、単価が半分でも1件の費用が逆転することがあります。
3. 誰が測ったか
発表の数字は、会社が自社のモデルを測ったものです。評価の選び方や、比べる相手の設定も会社が決めています。外部の評価機関の結果と分けて読み、両方で同じ傾向が出ているところ(前の世代からの伸び、誤りの減少)を信頼の目安にします。
4. 違う試験の%を足したり平均したりしない
Agents' Last Exam の 60% と Terminal-Bench の 50% は、別の物差しの数字です。平均して「Terra は55点のモデル」とは言えません。評価ごとに、自分の仕事に近いものだけを見ます。
5. 自分の仕事で、同じ effort で比べたか
OpenAI も開発者向けの手引きで、GPT-5.6 Terra から移るときは、代表的な画像や仕事を使って、同じ effort で両方のモデルを比べるよう勧めています。ベンチマークは候補を絞るための材料で、最後に決めるのは自分の仕事での結果です。
前の世代のときの整理は、次の記事にあります。
私たちが数字から決めたこと
この一式の記事を書くあいだに、私たちは Terra を手元で何度か動かしました。分類の指示を Terra と Sol に3回ずつ出したときは、答えは同じでした。effort の6段を3回ずつ比べたときは、none だけが3回とも間違え、medium と max は3回とも正しく答えました。今回の図の読み取りも、medium で公表値どおりに読めました。
こうした結果と公式の数値を合わせて、私たちは次のように使い分けを決めています。
仕事 | 最初に試す設定 | 根拠にした数字 |
|---|---|---|
画面や図・写真を読んで整理する | Terra の medium | MMMU-Pro で上位と約1ポイント差・手元の図の読み取り |
アプリをまたぐ定型の作業 | Terra の medium | Agents' Last Exam で Astra と同点・費用は約17分の1 |
込み入ったコーディング | Sol の medium | Terminal-Bench 4.0 で Sol の medium が Terra の max を上回る |
調べ物のまとめ | Terra の medium+資料を渡す | 誤り率は下がったが、知識は2026年6月1日まで |
この表は「最初に試す設定」であって、決定ではありません。中小企業のお客様にモデルを提案するときも、まず代表的な仕事を5〜10件選んで、同じ effort で2つのモデルに出し、結果と費用を並べてから決めるようにしています。ベンチマークで候補を2つに絞り、自分の仕事で1つに決める、という順番です。
まとめ:GPT-6.1 Terraのベンチマークは「得意が偏ったモデル」を示している
- いちばん強い数字は Agents' Last Exam。medium どうしで GPT-6 Astra と同じ 57.6%、1件の費用は約17分の1
- 画像を読む MMMU-Pro は上位のモデルと約1ポイント差。手元でも、発表の図の値を0.1ポイント以内で読めた
- コーディングの Terminal-Bench 4.0 は、Terra の max でも Sol の medium に届かない。難しいコーディングは Sol から
- 誤り率は大きく下がったが、誤りが起きやすい質問だけを集めた評価なので、ふだんの誤り率ではない
- 外部の総合指標では Terra の max は48で、Sol の max(52)より下。同じ48なら Sol の medium のほうが安い
数字はすべて2026年10月27日時点のもので、評価機関の一覧は今後も更新されます。料金やプランの扱いは変わることがあるので、使う前に OpenAI の公式のモデルページ(developers.openai.com)で最新の情報を確かめてください。
株式会社Fyveは、こうした数字の読み方も含めて、どの仕事にどのモデルを当てるかを中小企業の現場と一緒に決めています。
Codexを使い始める前に、「絶対に」見直してほしい5つのこと
学習の設定・確認なしの操作・戻せる状態など。Codexにそのまま貼れる頼み方つき(全9ページ)
Codexは便利な一方で、設定ひとつで「聞かずに動く」ようになります。この資料を作るために自分の設定を開いたら、本番のデータベースを書き換える操作が、覚えのないうちに確認なしで動く状態になっていました。使い始める前に見直してほしい5つを、Codexにそのまま貼れる頼み方と一緒にまとめました。
- 仕事の画面や資料を、AIの学習に使わせない設定
- 取り返しのつかない操作が確認なしになっていないか、Codexに調べさせる頼み方
- AGENTS.mdのいちばん上に書く「絶対にしないこと」の例
- 失敗しても戻せる状態で始める方法と、使えなくなったAIの指定の直し方
メールアドレス登録で他にも様々な資料を閲覧できます
 +9
PDF 18点・合計468ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。