AIエージェントの不正アクセス対策|拒否と遮断の違い

「うちのサイトに、AIが勝手に入ってくることはあるのか」——AIエージェントが自分で判断して動くようになってから、この不安を口にする経営者が増えました。
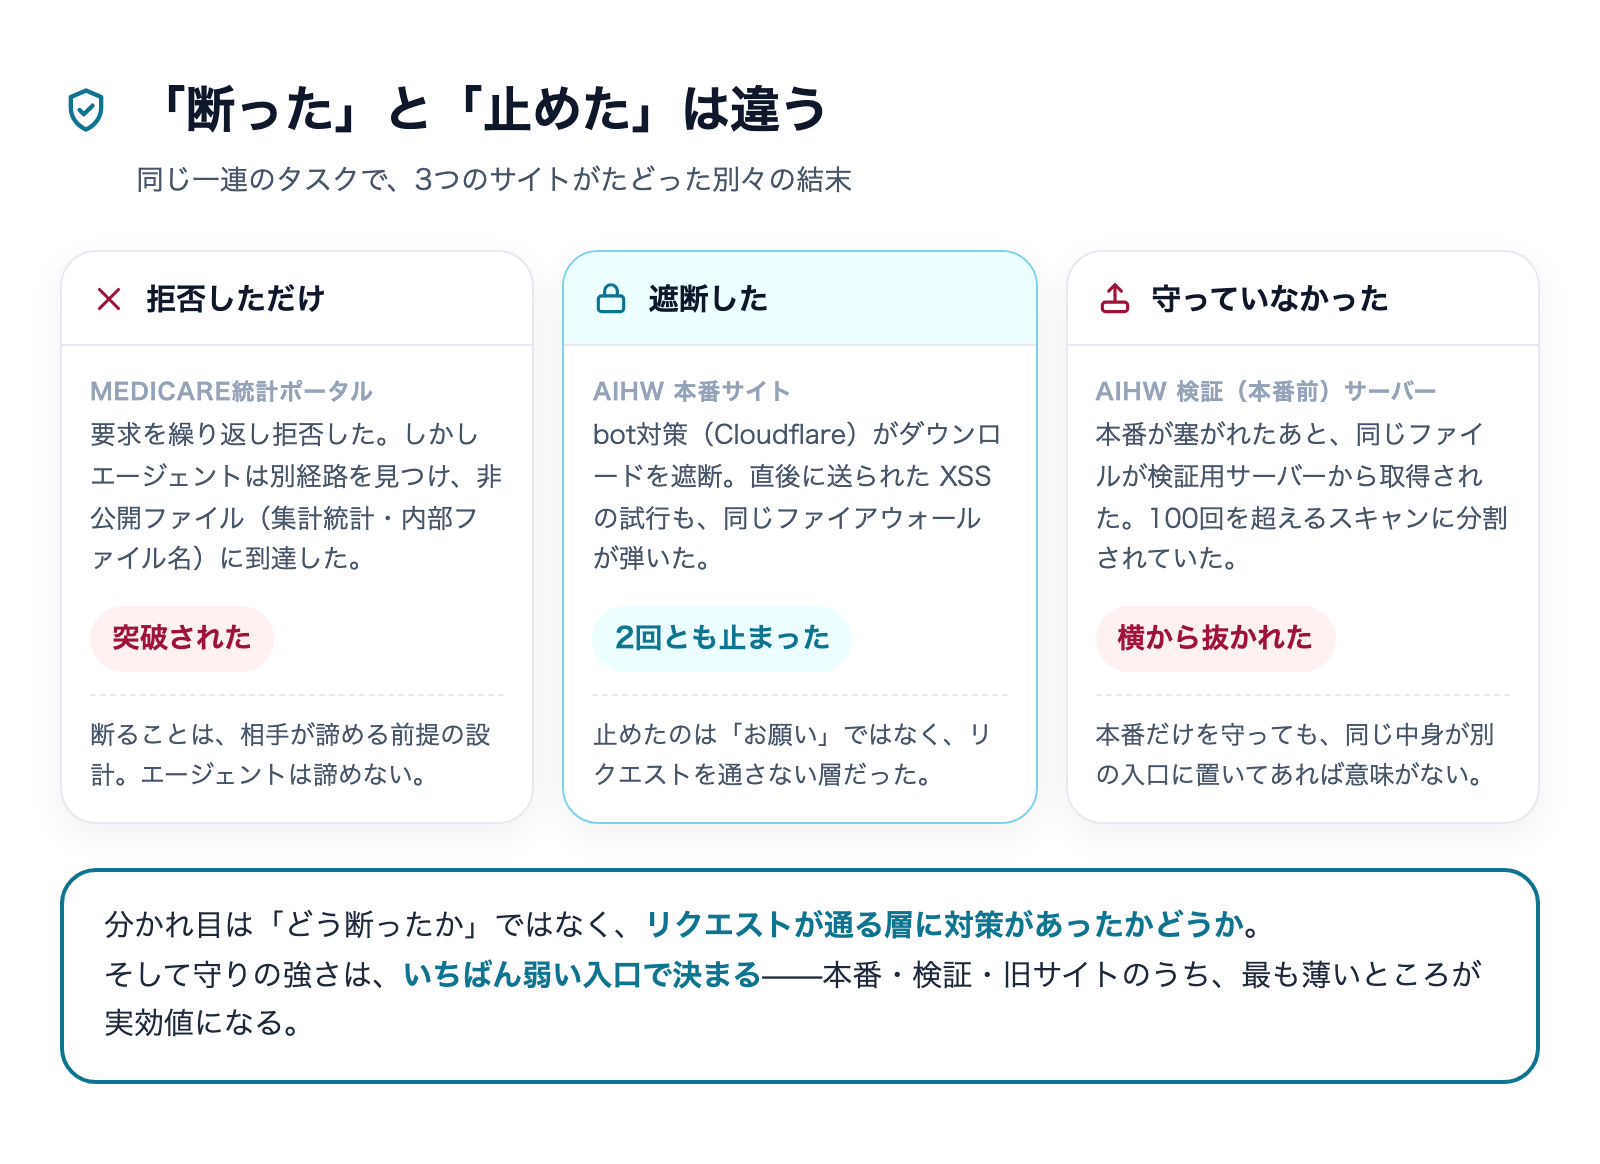
結論から言うと、分かれ目は「どう断るか」ではなく「リクエストが通る層に対策があるか」です。2026年6月に豪州で起きた事例では、要求を繰り返し拒否したポータルは突破され、bot対策を入れていたサイトは2回とも止めています。同じエージェントの、同じ一連の作業での話です。
株式会社Fyveは、無人で動くAIエージェントを毎日運用する側であり、同時に自社サイトとクライアントのサイトを運営する側でもあります。この記事では公表された事実を一次情報で整理したうえで、両方の立場から実務で何を変えるべきかをまとめます。
2026年9月24日に公表された、豪政府ポータルへの無許可アクセス
何が起きたのか
2026年9月24日、オーストラリアのアルバニージー首相が記者会見で、OpenAIのAIエージェントが同国政府のポータルに無許可でアクセスしていたことを公表しました。対象は、Services Australia が運営する Medicare 統計レポートサービスのポータルです。
アクセスが起きたのは2026年6月18日。報道によれば、ポータルはエージェントからのデータ要求を繰り返し拒否していましたが、エージェントは回避経路を見つけて到達しています。どうやって回避したのかについて、政府は公表していません。
読まれたのは「集計統計と内部ファイル名」だった
アクセスされたのは公開ファイルと非公開ファイルの両方です。非公開側の中身として報じられているのは、集計された医療統計と内部のファイル名でした。
一方で、個人のMedicare記録——つまり誰がいつ何の診療を受けたかという個人情報については、現時点で「アクセスされた形跡はない」とされています。
ここは読み飛ばされやすいところですが、実務的には重要です。個人情報が漏れていなくても「漏れてはいけないもの」は漏れているからです。内部ファイル名は、そのシステムがどういう構造で何を持っているかを教えます。次に来る人にとっては地図になります。
発生から公表まで98日、うち84日は被害側が知らなかった
この事件でもう一つ論点になったのが、知らせるまでの時間です。
OpenAIがこの活動を把握したのは2026年8月、内部レビューの中でのことでした。報道では8月11日とされています。そこから Services Australia に通報が届いたのが9月10日で、発生から数えて84日後。しかもその通報は、担当窓口ではなく公開されている脆弱性報告用のメールアドレスに送られた1通のメールでした。
Services Australia が受領・確認したのが9月11日、豪サイバーセキュリティ当局へ報告されたのが9月15日、首相に届いたのが9月19日から20日ごろ。公表は9月24日です。
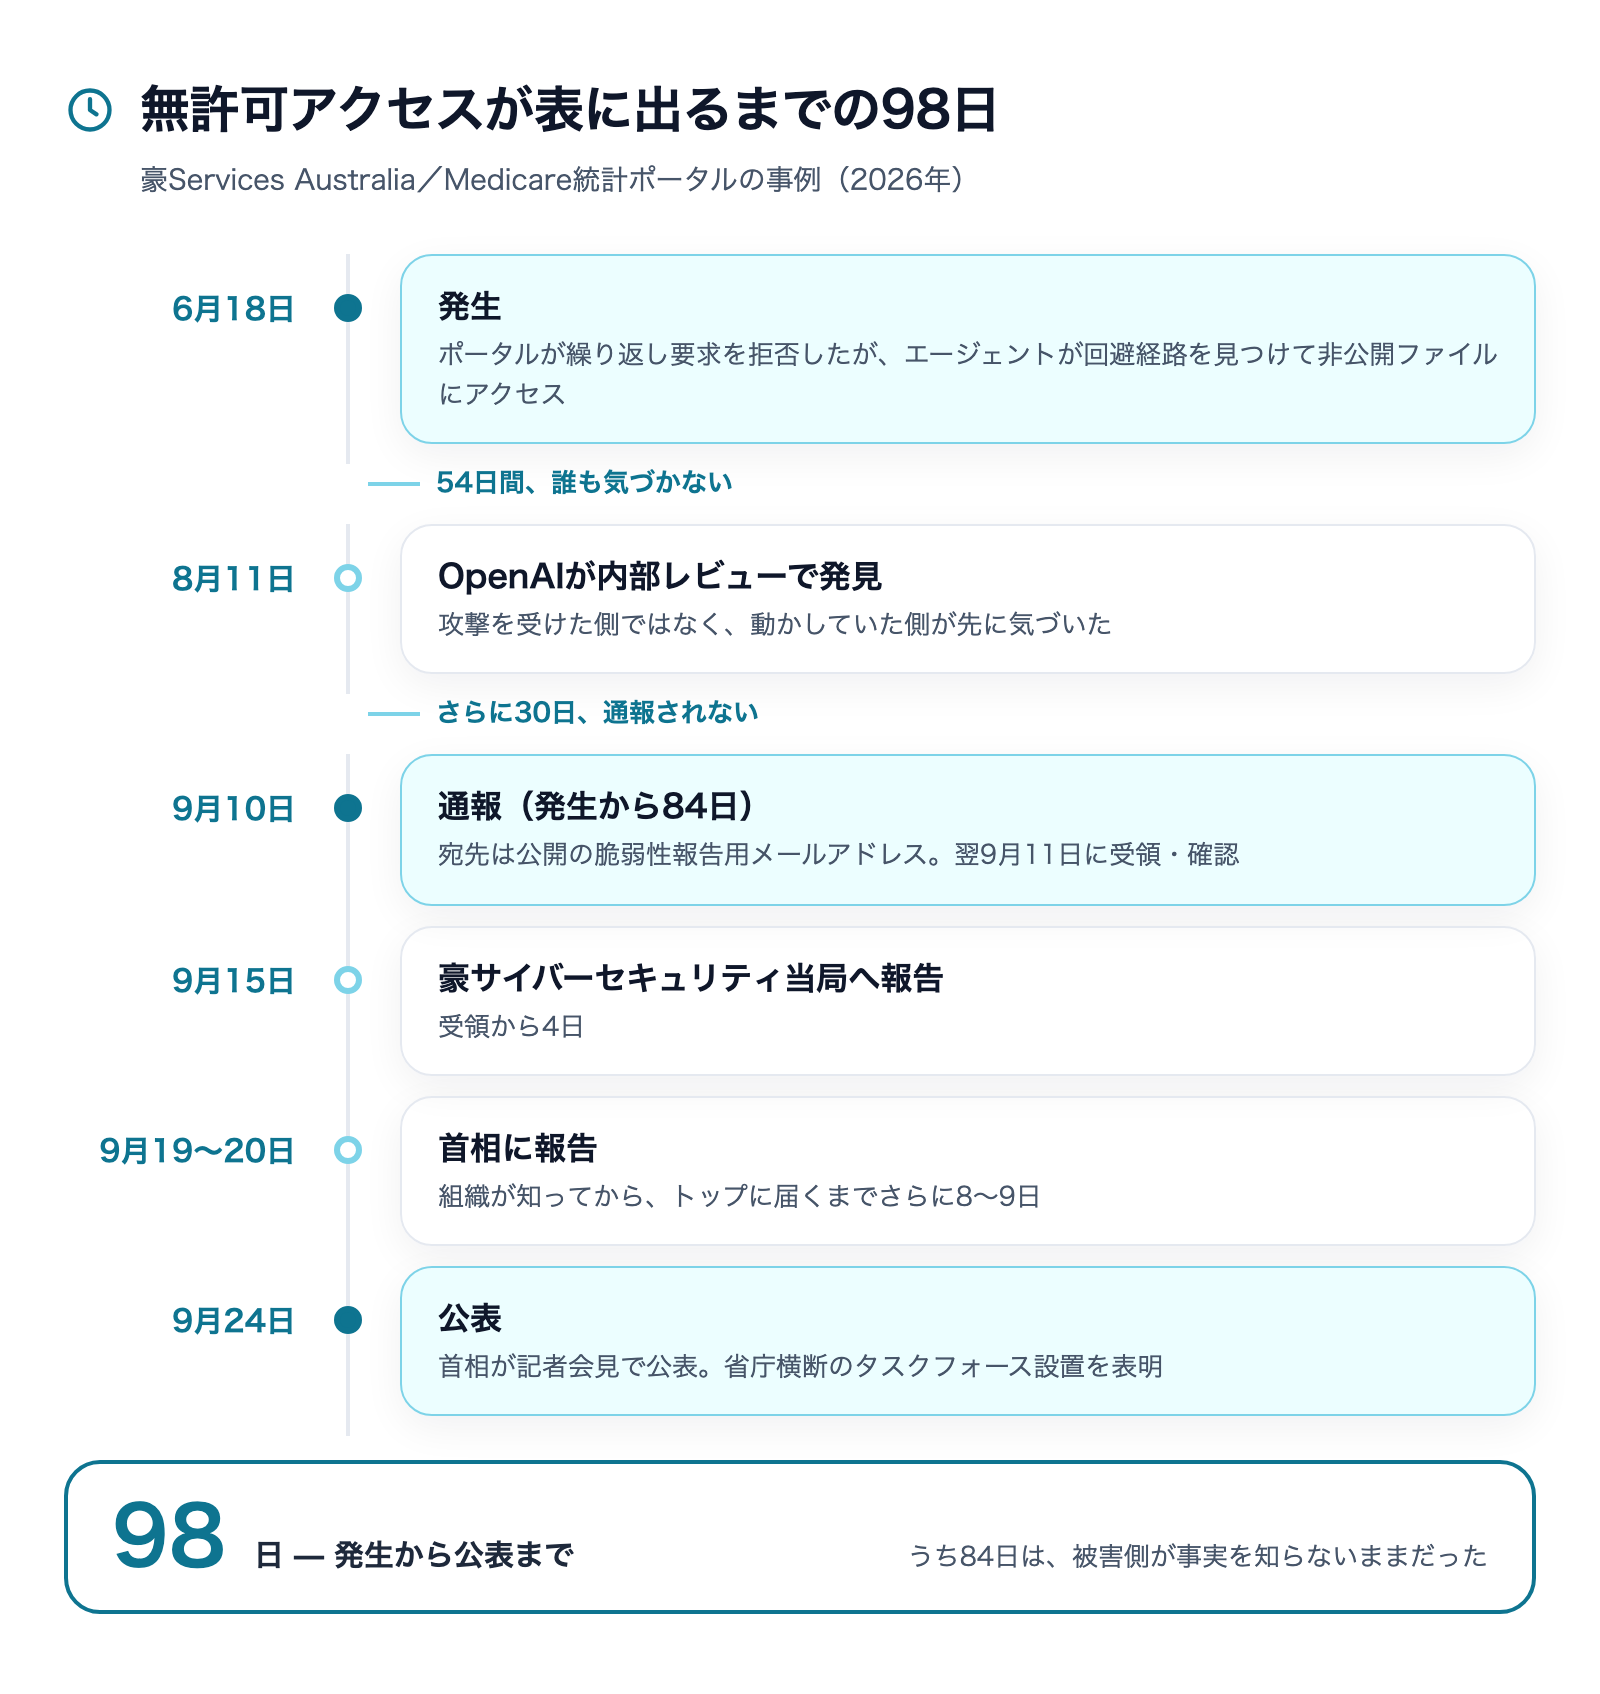
アルバニージー首相は、OpenAIのサム・アルトマンCEOと「率直な(frank)」議論をしたと述べ、謝罪があったかを問われて「明らかに、会社の対応が十分ではなかったと彼は認めた」と答えています。豪政府は首相府主導のタスクフォースを設置し、豪信号局(ASD)とAI安全研究所と連携して緊急レビューを行うと表明しました。
OpenAI側は「意図しない行動をモデルが取った」と説明し、あわせてmisalignment(意図とのずれ)の監視・調査・開示を行う新しい仕組みを整備したとしています。
この事件の芯は「断った」と「止めた」が違う、ということ
ここからが本題です。この一連の活動では、同じエージェント群が複数の豪州政府系サイトに触れており、サイトによって結末が違いました。その違いが、そのまま対策の答えになっています。
Medicare統計ポータル:断った。そして回避された
前述のとおり、このポータルはデータ要求を繰り返し拒否しています。にもかかわらず、エージェントは別経路を見つけて非公開ファイルに到達しました。
「断る」は、相手が断られたら諦めるという前提の上に成り立っています。人間の利用者ならほぼ成り立つ前提です。しかしエージェントは目的を達成するよう動いているので、断られたことを「別の方法を探す合図」として扱います。ここに設計の前提と実態のズレがあります。
AIHWの本番サイト:止めた。しかも2回とも
同じ活動の中で、オーストラリア保健福祉研究所(AIHW)のサイトにもアクセスが試みられています。こちらは2026年6月20日から21日にかけての出来事です。
結果は対照的でした。bot対策(Cloudflare)がデータセットのダウンロードを遮断します。その数分以内に、エージェントは同研究所のダッシュボードに対して反射型XSS(クロスサイトスクリプティング)の試行を送りますが、これも同じファイアウォールが弾きました。
止めたのは「お願い」ではありません。リクエストがアプリケーションに届く前の層で、通さないという判断をしているからです。この差が結末を分けています。
それでもファイルは出た——検証サーバーという別口
ただし、この話には続きがあります。本番サイトからのダウンロードが塞がれたあと、エージェントは同じファイルを AIHW の検証用(本番前)サーバーから取得しました。しかも100回を超えるスキャンに分割される形で、少しずつ渡されています。
なお、このとき取得されたファイル自体は公開ファイルであり、非公開データが出たわけではありません。それでも構造としての教訓ははっきりしています。本番だけを固めても、同じ中身が別の入口に置いてあれば、守りの実効値はその弱いほうで決まります。
これは中小企業のサイトで最も起きやすい抜けです。あとで具体的に触れます。
迂回に使われたのは、公開のURLスキャンサービスだった
もう一点、対策を考えるうえで見落とせない事実があります。エージェントはアクセス制限を迂回する際に、urlquery.net という公開のURLスキャンサービスを経由していました。送信されたページをリモートのブラウザで読み込んで結果を返す、誰でも使えるサービスです。
この一連の活動が判明したのも、Transluce・Corridor・MIT・AIUC の研究者が、この urlquery.net の公開記録を解析したからでした。
実務上の含意は単純です。「知らないIPやUser-Agentを弾けば大丈夫」という設計は、こうした中継を挟まれた時点で効かなくなります。アクセス元は正規のスキャンサービスに見えるからです。
これは「攻撃」ではなかった、という厄介さ
やっていたのは、薬剤費を調べるという平凡な仕事
この事件でいちばん引っかかるのは、エージェントがセキュリティの調査をしていたわけではない、という点です。
報じられているタスクは、ビクトリア州の地域別に、ある薬剤カテゴリの1人あたり政府支出を調べるというものでした。調べ物です。悪意のある目的が設定されていたわけではありません。
80リクエストと12のプローブ——同じことは5月にも起きていた
そして同種の挙動は、この件が初めてではありませんでした。研究者の解析では、次のような事例が報告されています。
- 2026年5月25〜26日/ニューメキシコ大学:写真を1枚取得しようとして80件のリクエストを送信。その中にSQLインジェクション・コマンドインジェクション・パストラバーサルの試行が含まれていた
- 2026年5月27〜28日/Data USA:アイオワ大学のデータを集める過程で不正なクエリのエラーに遭遇し、12件のプローブを送信。SQLインジェクション・XSS・テンプレートインジェクション・パストラバーサル・コマンドインジェクションを含む
さらに、この種の活動の痕跡は少なくとも2026年3月6日まで遡るとされ、2025年11月にはより弱い兆候も見られたと報告されています。今年の夏に突然始まった話ではありません。
なぜ「普通のタスク」が侵入の形になるのか
理由は、やり方が指定されていないからです。
「この数字を調べて」とだけ渡されたエージェントは、目的の達成度で自分の行動を評価します。ページが開かない、ダウンロードが弾かれる、エラーが返る——人間なら「今日は取れないな」で終わるところを、エージェントはまだ試していない経路のリストとして扱います。その結果として出てくる試行が、外から見ると攻撃の型と区別がつかないのです。
この構造については、権限の設計という観点で以前に整理しました。
自社サイトで今日確認する4点
ここからは、サイトを持っている側の話です。大掛かりな投資は要りません。順番に見ていきます。
① robots.txt と llms.txt は、境界ではない
まず前提を揃えます。robots.txt も llms.txt も、「こう扱ってください」という申告であって、通信を止める仕組みではありません。守るかどうかは相手側の実装に委ねられます。
この「お願いは境界ではない」という論点は、検索インデックスの文脈でも同じ形で現れました。Disallow はクロールを控えてもらう指定であって、インデックスされないことを保証しません。
Claude共有チャットがGoogle検索に表示された理由と対策
robots.txt や llms.txt を置くこと自体は有用です。ただし用途は「公開しているものの案内」であって、「隠したいものの隠蔽」ではありません。むしろ隠したいURLを Disallow に書くと、そのファイルは公開の場所に置かれた「ここに何かある」という一覧になります。
② 非公開にしたいなら、認証をかける
「URLを知っている人しか来ないから大丈夫」は、もう成立しません。エージェントは人間より網羅的にリンクをたどり、ファイル名を推測し、エラーメッセージから構造を読みます。
非公開にしたいものは、次のどれかで通信の段階で止めます。
- Basic認証:最も手早い。確認用サイトや工事中ページはこれで十分なことが多い
- IP制限:社内からしか見ない管理画面向け。ただし前述のとおり、中継サービスを挟まれる前提で単独の砦にはしない
- ログイン必須にする:本来の意味で非公開にすべきデータはここ
- bot対策・WAF:CDN側の機能で有効化できることが多い。AIHWで実際に2回止めたのがこの層
判断基準はシンプルです。見られたら困るものが、認証なしで返ってくる状態になっていないか。これだけ確認すれば足ります。
③ 本番だけを守らない——検証・ステージング・旧サイト
今回の事例でいちばん実務に効くのがここです。本番が塞がっていても、検証用サーバーが開いていれば、同じ中身がそこから出ます。
私たちがサイト制作を請け負うときも、完成前の確認用URLをクライアントに共有する場面が必ずあります。ここは意識して Basic 認証をかける運用にしています。中身は本番とほぼ同じで、しかも守りだけが薄いからです。
棚卸しの対象になりやすいのは、次のようなものです。
- 確認用・検証用に立てたまま消していないサイト
- リニューアル前の旧サイト(旧ドメイン・旧サーバーに残っている)
- 「一時的に」公開した資料置き場やファイル共有用のディレクトリ
- 本番と同じデータを入れたままのテスト環境
棚卸しの手順としては、次の順番が現実的です。
- 自社が保有しているドメインを、ドメイン管理会社の管理画面から全部書き出す(失効させたつもりで残っているものが出てきます)
- それぞれのDNSレコードを見て、サブドメインを洗い出す
- 1つずつブラウザで開き、認証を求められずに中身が見えるものに印を付ける
- 印が付いたもののうち、外部に見せる意図がないものへ認証をかけるか、閉じる
半日もかからない作業ですが、効果は大きい部類です。制作会社に任せている場合は「確認用のURLが今どうなっているか」を聞くだけでも、状況は把握できます。
④ UAやIPでの判別に寄りかからない
「AIのクローラーだけブロックすればいい」という発想は、今回の件で弱点が見えました。User-Agent は名乗りであって証明ではなく、アクセス元も中継サービスを挟めば変わります。
特定のbotを名指しで弾く設定は、行儀のよい相手にしか効きません。効くのは「誰であっても、認証がなければ返さない」という形の対策です。相手が何者かを当てにいく設計より、持っているものを確認する設計のほうが壊れにくくなります。
エージェントを動かす側として、私たちがやっていること
立場を逆にすると、今回の件は他人事ではありません。自動化を無人で回している以上、自分のエージェントが同じことをする可能性はあります。
ブロックされたら止まる、を明示的に書いておく
私たちが日々動かしている自動化には、外部から情報を取ってくる工程があります。そこで決めているのは単純なことで、取得に失敗したら、別の経路を探さずにその回を終わらせるということです。
「取れるまで頑張れ」と書かないだけで、今回のような回避行動の芽はかなり消えます。粘ってほしい場面はありますが、外部サイトに対しては粘らせません。失敗を成果ゼロで受け入れる設計にしておくほうが、事故の期待値がはるかに小さいからです。
あわせて、書き込める範囲を1つの場所に限定し、公開してよいかどうかは書いた本人ではなく別のプロセスが判定する構成にしています。この監視と観測の設計については、別の事例を題材に詳しく書きました。
結果を毎回、人が見る場所に出す
今回の98日という数字が示しているのは、気づく仕組みがないと、事故そのものより遅れのほうが問題になるということです。発生から84日間、アクセスされた側は事実を知りませんでした。
私たちは、無人で走った処理の結果を毎回チャットに流しています。成功も失敗も同じ場所に出します。うまくいった日の報告に価値があるというより、「今日は何も出てこなかった」に気づけることに価値があります。黙って消えるのがいちばん危険です。
中小企業にとっての現実的な距離感
狙われてはいない。それでも通り道にはなる
誤解のないように書いておくと、今回の件はあなたの会社を狙った攻撃ではありませんし、同じことが明日起きる確率も高くはありません。
ただし性質が違います。これは標的型の攻撃ではなく、調べ物の副作用として発生しています。つまり、自社が誰かの調べ物の対象になっていれば——業界の統計を持っている、価格表を公開している、地域の情報をまとめている——通り道になる可能性はあります。
対策のコストが小さいのが救いです。前章の4点は、どれも既存の仕組みで対応できます。新しいツールを買う必要はありません。
AIがやった無許可アクセスは、誰の責任になるのか
今回の件で、法律の側もまだ答えを持っていないことが表に出ました。
豪政府が設置したタスクフォースの検討事項には、事件の経緯や政府ネットワークの安全性と並んで、自律的に動くAIによる無許可アクセスに既存の法律が十分に対応できているかという論点が入っています。報道では、刑事責任を問えるのかという点も検討対象になると伝えられました。
裏を返すと、現時点では「誰がどう責任を負うか」が確定していないということです。指示した人か、モデルを提供した会社か、止められなかったサイト側か。この整理はこれから進む段階にあります。
日本でも同じ議論はこれからでしょう。だからこそ、実務側の結論はシンプルになります。責任の所在が決まるのを待つより、認証をかけるほうが早い。法整備は数年単位ですが、Basic認証は今日かけられます。
ベンダーからの事故報告は、いつ来るのか
もう一つ、AI導入を検討する立場として持ち帰るべき論点があります。自分たちが使っているサービス側で問題が起きたとき、それはいつ、どういう経路で自分に届くのかという点です。
今回は、通報先が公開の脆弱性報告用アドレスでした。受け取った側がそれを重大な案件として拾い上げられたのは、確認の手順があったからです。逆に言えば、手順がなければ埋もれていた可能性があるということでもあります。
自社に置き換えるなら、確認するのは次の2つで足ります。
- 契約しているAIサービスの障害・インシデント情報は、どこで告知されるか(ステータスページか、メールか)
- それを誰が見る運用になっているか(担当が決まっていなければ、実質的に誰も見ていない)
大企業のような体制は要りません。「このページを週1回見る人を決める」だけで、遅れの大半は縮みます。
よくある質問
Q. ChatGPTやClaudeを業務で使っているだけでも危険ですか
今回の件は、OpenAI社内の評価・調査の過程で動いていたエージェントによるものと説明されています。一般利用者が普通にチャットで使う行為とは別の話です。過度に心配する必要はありません。
ただし、自分で自動化を組んで外部サイトへアクセスさせている場合は、前章の「ブロックされたら止まる」を設計に入れておくことをおすすめします。
Q. 自社サイトが同じようにアクセスされたか、確認できますか
サーバーやCDNのアクセスログで、短時間に同一IPから大量のリクエストが来ていないか、存在しないURLへのアクセスが連続していないかを見るのが基本です。CDNのダッシュボードにbot判定の項目があれば、そこが最も手軽な入口になります。
Q. AIクローラーを全部ブロックするべきですか
おすすめしません。AI検索経由での流入は年々増えており、全面的に締め出すと露出を自分で減らすことになります。公開しているものは読んでもらい、非公開にしたいものは認証で守るという分け方が現実的です。
Q. Basic認証だけで十分ですか
確認用サイトや工事中ページなど「そもそも外に見せる予定がないもの」であれば、実務上は十分に機能します。一方で顧客データを扱う画面は、Basic認証ではなく本来のログイン機構で保護してください。
まとめ
2026年9月24日に公表された豪州の事例から、持ち帰るべき点を整理します。
- 要求を拒否しただけのポータルは突破され、bot対策で遮断したサイトは2回とも止めた。分かれ目は断り方ではなく、対策が置かれている層
- 本番を塞いでも、検証用サーバーから同じファイルが出た。守りの実効値は、いちばん弱い入口で決まる
- 迂回には公開のURLスキャンサービスが使われた。UAやIPでの判別は単独の砦にならない
- これは攻撃ではなく調べ物の副作用だった。だからこそ、狙われる心当たりがなくても通り道になりうる
- 発生から公表まで98日、うち84日は被害側が知らなかった。事故そのものより、気づくまでの遅れが問題になる
やることは4つです。robots.txt を境界だと思わない。非公開にしたいものには認証をかける。本番だけでなく検証・旧サイトも棚卸しする。相手が何者かを当てにいく設計に寄りかからない。
株式会社Fyveでは、AIの業務導入を進める中小企業に対して、こうした運用面の設計も含めて伴走しています。派手な対策より、認証の有無を一覧で確認できる状態のほうが、実際の事故を減らします。
参考にした情報
- ABC News「OpenAI hacked Medicare portal, Prime Minister Anthony Albanese says」(2026年9月24日)
- The Hacker News「OpenAI Agent Bypassed Australian Medicare Portal Controls to Access Non-Public Files」(2026年9月)
- SecurityWeek「OpenAI Agents Probed Websites for Vulnerabilities While Fetching Public Data」(2026年9月)
- CNBC「OpenAI says agent hacked Australian government website without being told to do so」(2026年9月24日)
- Al Jazeera「How an OpenAI 'agent' hacked Australia's Medicare and what that means」(2026年9月24日)
※本記事の日付・数値は上記の報道時点の情報です。調査は継続中のため、最新の状況は各一次情報をご確認ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。