MAI Code 2の性能とベンチマーク|公式の数値

「MAI Code 2 は GPT-6.1 Sol の98%の性能と言われても、何の試験で、どんな条件で測った数字なのか分からない」「Flash は Claude Haiku 5.5 と同じくらいと書いてあるが、本当に任せてよいのか」——GitHub Copilot の一覧に新しいモデルが増えるたびに、ベンチマークの数字を前にこう迷う方は多いはずです。
結論から言うと、MAI Code 2 の性能について Microsoft が公開している数字は、「他社のモデルの何%」という比率と、モデルカードに載っている MAI Code 2 と Flash の点数の2種類です。他社のモデルの点数そのものは出ておらず、2026年11月18日時点では第三者の機関による計測もまだ見当たりません。比率の数字は「最も強い推論の設定・GitHub Copilot CLI・サブエージェントなし・割引価格で費用を計算」という条件つきで読む必要があります。
株式会社Fyveは、中小企業の AI 導入を支援しながら、自社でも Claude Code や Codex に夜間の無人の仕事を毎日任せています。この記事では、2026年11月17日(米国時間)に公開された Microsoft の発表とモデルカード(モデルの仕様と評価をまとめた公式の文書)から MAI Code 2 と MAI Code 2 Flash のベンチマークの数字をすべて拾い、どう読めばよいかを整理します。
MAI Code 2 が何で、何ができて、前と何が変わったかの全体像は、次の記事にまとめています。
MAI Code 2 のベンチマーク:数字は3か所に分かれている
MAI Code 2 の性能の数字は、出どころが3つあります。同じ「ベンチマーク」でも、誰が何のために出した数字かが違うので、混ぜずに読みます。
出どころ | 載っている数字 | 細かさ |
|---|---|---|
Microsoft AI の発表ブログ(2026年11月17日) | GPT-6.1 Sol・Claude Opus 5.5・GPT-6 Sol・GPT-6 Luna・Claude Haiku 5.5 との比率 | 4つの試験の平均を「何%の性能を何%の費用で」と書くだけ。試験ごとの点数は無い |
モデルカード(PDF・同日公開) | MAI Code 2 と Flash の試験ごとの通過率、安全性の評価 | 表で小数点まで。ただし他社のモデルの点数は載っていない |
Microsoft AI のモデルページ | Flash は Claude Haiku 5.5 の5分の1の費用で12%高い性能、など | 見出しの短い言葉だけ。条件は書かれていない |
このほか、GitHub の変更履歴(Changelog)は提供の開始と使える場所を告知しているだけで、点数は載せていません。報道(TokenPost・2026年11月17日)も、第三者のベンチマークではまだ確かめられていないと書いています。私たちが確かめた範囲でも、Artificial Analysis の FrontierCode の最新の表(FrontierCode-AA 2.0)に MAI Code 2 と Flash は載っていませんでした(2026年11月18日時点)。
つまり、いま手に入る数字はすべて Microsoft 自身が測ったものです。ここを最初に押さえておくと、後の数字の読み方がぶれません。
発表ブログの数字:「何%の性能を何%の費用で」
Microsoft の発表ブログが前に出している数字は、次の5つです。
主張 | 比べた相手 | 何で測ったか |
|---|---|---|
MAI Code 2 は98%の性能を40%の費用で | GPT-6.1 Sol | 4つの試験(DeepSWE 1.1・Terminal Bench 2.1・SWE-Atlas・FrontierCode v1.1)の平均 |
MAI Code 2 は96%の性能を5%の費用で | Claude Opus 5.5 | 同じ4つの試験の平均 |
画面のコードで64%の確率で選ばれた | GPT-6 Sol | 人が見比べて選ぶ評価(評価者258人) |
MAI Code 2 Flash は同等の性能を、Claude Haiku 5.5 の20%の費用で | Claude Haiku 5.5 | 日々の決まった仕事を測る3つの試験 |
MAI Code 2 Flash は同等の性能を、GPT-6 Luna の「6 5%」の費用で | GPT-6 Luna | 同じ3つの試験 |
最後の行の「6 5%」は、発表ブログの表示が崩れていて、数字の間に区切りが入った形でしか読めません。65%と読むのが自然ですが、私たちは正しい値を公式で確かめられていないので、この記事では数字として扱いません。
4つの試験は何を測っているか
98%・96%の元になった4つの試験は、どれも「実際のリポジトリやターミナルで、仕事を最後まで終えられるか」を測るものです。モデルカードの説明をまとめると次のとおりです。
- DeepSWE 1.1:複数の言語にまたがるソフトウェア開発の仕事。隠されたテストが通れば成功。モデルカードの別の節では「長い時間をかける開発の仕事を集めた試験」と説明されています
- Terminal Bench 2.1:Linux のターミナルで、何段階もの作業を終えられるか。仕事ごとの検査が通れば成功
- SWE-Atlas:よく手入れされているオープンソースの18のリポジトリから専門家が作った仕事。コードについての質問への回答(124件)・テストを書く(90件)・作りを直す(70件)の3種類で、機械の検査と採点基準の両方で採点
- FrontierCode v1.1:変更が、そのリポジトリの管理者がそのまま取り込める出来かを見る試験。Microsoft はこの試験の点数と費用を Artificial Analysis の値から取ったと注記しています
注意したいのは FrontierCode の版です。Microsoft が使ったのは v1.1 ですが、Artificial Analysis はすでに FrontierCode-AA 2.0 の表も出していて、そちらでは Claude Fable 5.2 と GPT-6.2 Astra が49%前後で並んでいます(2026年11月18日時点)。MAI Code 2 は 2.0 の表にまだ無いので、最新の版で上位のモデルとどれくらい離れているかは、今は分かりません。
モデルカードの数字:MAI Code 2 と Flash の点数
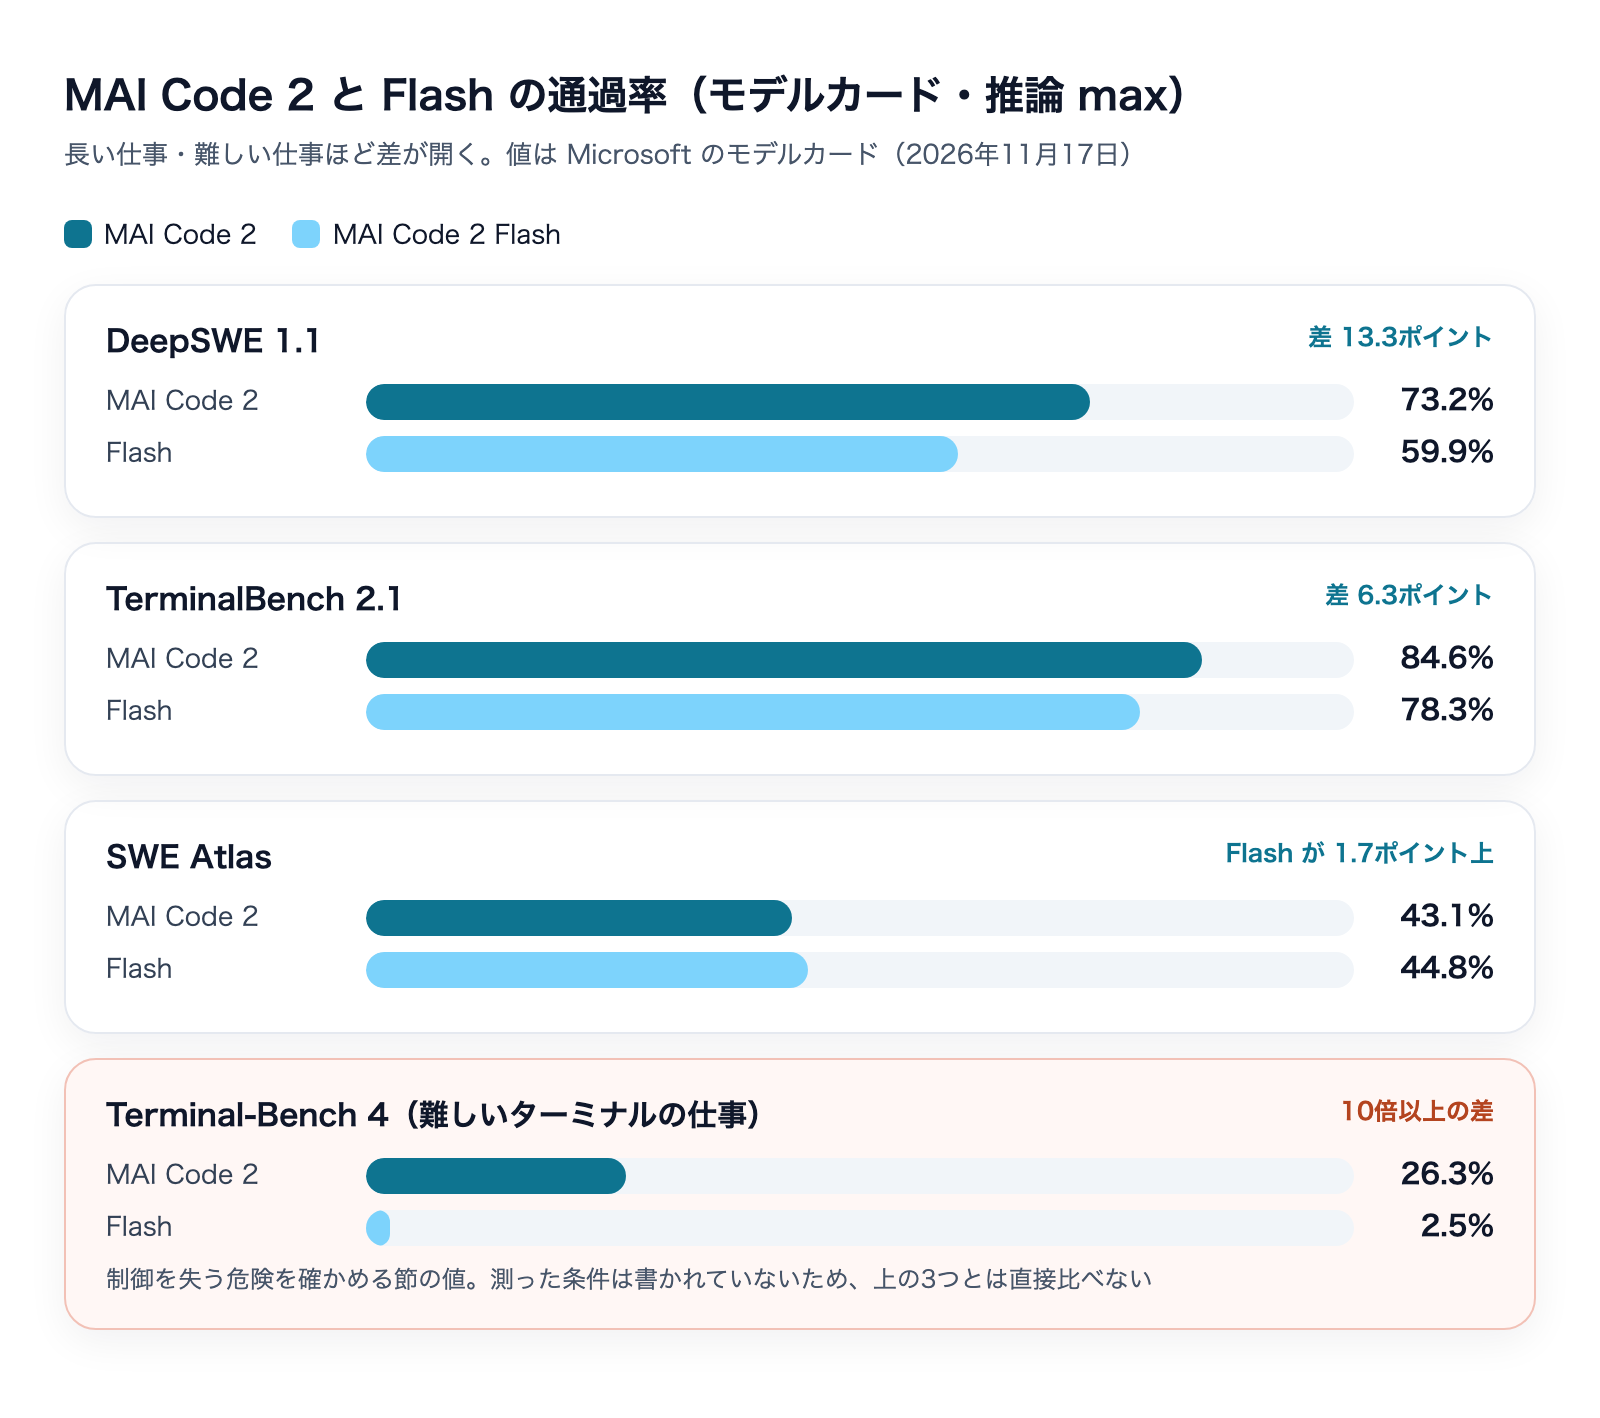
点数そのものが出ているのは、モデルカードだけです。性能の節(3. Quality and performance evaluation)に、次の表があります。値は最も強い推論の設定(max)での通過率です。
試験 | MAI Code 2 | MAI Code 2 Flash | 差 |
|---|---|---|---|
DeepSWE 1.1 | 73.2% | 59.9% | Code 2 が13.3ポイント上 |
TerminalBench 2.1 | 84.6% | 78.3% | Code 2 が6.3ポイント上 |
SWE Atlas | 43.1% | 44.8% | Flash が1.7ポイント上 |
測り方も書かれています。GitHub Copilot CLI(バージョン1.0.102)を実行の仕組みに使い、サブエージェント(作業を手分けする子のエージェント)は切ったうえで、どのモデルも同じ設定で走らせています。値は1つの仕事を3回ずつ解かせた1回目の通過率の平均で、何回か試して1回通ればよいという数え方(pass@k)ではありません。環境の不具合で止まった分も失敗に数えています。
この表から読めることは3つあります。
- 長い仕事ほど差が開く:DeepSWE 1.1 では13ポイント、Terminal Bench 2.1 では6ポイントの差です。何段階も進める長い仕事ほど、上のモデルの差が出ます
- SWE Atlas は Flash のほうが上:コードについての質問・テスト作成・作りの直しでは、Flash が1.7ポイント上です。3回の平均どうしの差としては小さく、「同じくらい」と読むのが無難ですが、少なくとも「Flash は何でも劣る」わけではありません
- 3つの平均は Code 2 が約67%、Flash が約61%:表の3つの値を私たちが単純に平均した数字です(Microsoft の発表値ではありません)。Flash は Code 2 のおよそ9割の点を出しています
同じ試験の名前で、違う数字が載っている
モデルカードを最後まで読むと、気をつけたい点が見つかります。危険な能力を確かめる節(3.2.5 Advanced autonomy)にも DeepSWE 1.1 と SWE Atlas が出てきますが、値が性能の節と違います。
試験 | 性能の節(3.) | 危険な能力を確かめる節(3.2.5.1) |
|---|---|---|
DeepSWE 1.1(Code 2/Flash) | 73.2%/59.9% | 60.2%/27.4% |
SWE Atlas(Code 2/Flash) | 43.1%/44.8% | 80.9%/65.2% |
後ろの節には、測った条件(推論の設定・実行の仕組み・採点のしかた)が書かれていません。安全性の評価は、安全のための追加の仕組みを付けていない版で測ったと別の箇所に書かれているので、同じ名前でも条件が違うのだと思われますが、文書の中では説明されていません。
ここから言えるのは、同じ試験の名前でも、出どころが違う数字を並べて比べてはいけないということです。比べるなら、同じ表の中の値どうしに限ります。この記事でも、性能の比較には性能の節の表だけを使っています。
このほか、モデルカードの冒頭の表では MAI Code 2 の有効なパラメータ(1回の計算で使われる重みの数)が「80B」、本文では「77 billion」と書かれていて、文書の中で値がそろっていません。性能の判断には関係しない細かい点ですが、公式の文書でも数字が食い違うことがある例として覚えておくと役に立ちます。
Flash は難しいターミナルの仕事で大きく落ちる
モデルカードの中で、Code 2 と Flash の差がいちばん大きく出ている数字があります。制御を失う危険を確かめる節(3.2.6.3 Loss of control)に載っている Terminal-Bench 4 です。
試験 | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
Terminal-Bench 4 | 26.3% | 2.5% |
(参考)TerminalBench 2.1・性能の節 | 84.6% | 78.3% |
Terminal Bench 2.1 では6ポイントしか離れていなかった2つのモデルが、より難しい Terminal-Bench 4 では10倍以上離れています。こちらも条件は書かれていないので、2.1 の値と直接は比べられません。それでも、Code 2 の26.3%に対して Flash の2.5%は、「難しいターミナルの仕事は Flash にはほぼ解けない」と読むのに十分な差です。
モデルカードの「分かっている限界」にも、Flash は複雑で長い仕事では Code 2 より能力が低く、指示を多めに与える必要があると書かれています。Flash を使うのは、範囲が決まった修正や説明のような短い仕事に絞るのが安全です。
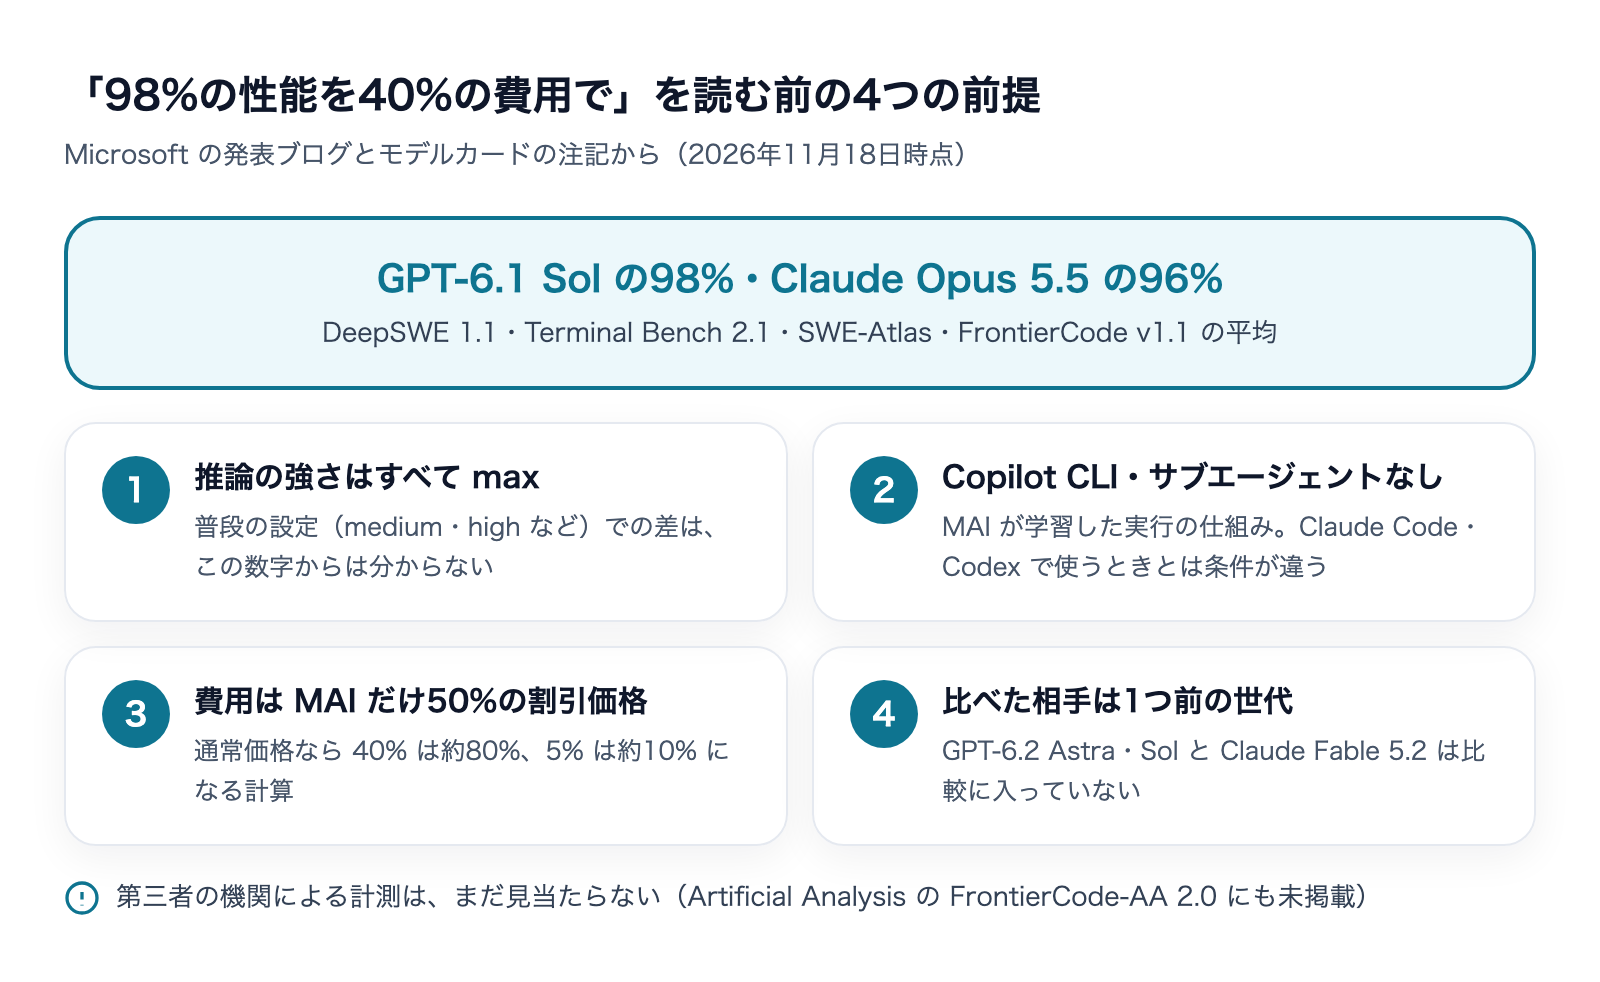
98%・96%を読むときの4つの前提
発表ブログの「GPT-6.1 Sol の98%の性能を40%の費用で」「Claude Opus 5.5 の96%を5%の費用で」は、次の4つの前提の上に立っている数字です。
1. 推論の設定はすべて max
比べたモデルはすべて、推論の強さを最も強い max にして測っています。MAI Code 2 の推論の強さは low・medium・high・xhigh・max の5段階で選べますが、普段の仕事で max を使い続ける人は多くありません。モデルカードは「推論を強くすると待ち時間と使うトークンが増え、いつも結果が良くなるとは限らない」とも書いています。普段の設定での差は、この数字からは分かりません。
2. 実行の仕組みは GitHub Copilot CLI で、サブエージェントなし
4つのうち3つの試験は、Microsoft の評価の基盤(MSBench)で GitHub Copilot CLI を使って測っています。MAI Code 2 は強化学習を Copilot CLI と VS Code のエージェントの仕組みの中で直接行ったとモデルカードに書かれているので、この実行の仕組みは MAI Code 2 にとって慣れた場所です。Claude や GPT を、それぞれの会社のツール(Claude Code や Codex)で使ったときの点数とは条件が違います。
3. 費用は MAI 側だけ50%の割引価格
発表ブログの注記によると、MAI Code 2 と Flash の費用は50%の割引価格で計算しています。GitHub の料金表では、この割引価格は2027年5月17日までと案内されています(2026年11月18日時点)。通常価格では費用が2倍になるので、「40%」「5%」はそれぞれ約80%・約10%になる計算です。この計算と、Claude・GPT との使い分けは次の記事で詳しく書きました。
4. 比べた相手は1つ前の世代
比べた相手は GPT-6.1 Sol・Claude Opus 5.5・GPT-6 Sol・GPT-6 Luna・Claude Haiku 5.5 です。同じ日に出た GPT-6.2 Astra・Sol や、その前の週に出た Claude Fable 5.2 は入っていません。画面のコードの評価で比べた GPT-6 Sol も、6.1・6.2 より前のモデルです。「いま一覧に並んでいる最新のモデルとの比較」ではない点に気をつけてください。
モデルページと Microsoft の製品での数字
Microsoft AI のモデルページと発表ブログには、試験の点数とは別の数字もあります。条件が書かれていないものが多いので、参考として読みます。
- Flash は Claude Haiku 5.5 の5分の1の費用で、12%高い性能(モデルページ):発表ブログでは同じ相手について「同等の性能を20%の費用で」と書かれています。費用は5分の1と20%で合っていますが、性能は「同等」と「12%高い」で言い方が違います。どの試験で12%なのかは書かれていません
- Word では GPT-6.1 Sol と同じくらいの出来を、1回の呼び出しあたり約42%少ない入力トークンで(発表ブログ・社内の5つの評価)
- Teams では GPT-6 Luna を上回り、トークンは最大28%少ない(発表ブログ・指示に従う力とツールの呼び出し)
- Flash を AT&T が調整した版は、5G のネットワーク分析で GPT-6.1 Sol を上回り、費用は50分の1(モデルページの導入企業の声)。調整した版の話で、Copilot で選べる Flash そのものの数字ではありません
Microsoft が自社の製品(Word・Teams・Excel・PowerPoint)でも MAI のモデルを使っていることは読み取れますが、どれも試験の名前や点数は出ていないので、Copilot で選ぶときの判断材料にはしにくい数字です。
安全性の評価:無人で動かすなら見ておく数字
モデルカードには、エージェントとして動かしたときの安全性の評価も載っています。Copilot の cloud agent のように、人が見ていない所でモデルに作業させる使い方を考えているなら、性能の点数と同じくらい大事な数字です。
評価(何を測るか) | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
AgentDojo ASR(メールやツールの出力に仕込まれた指示に乗っ取られた割合・低いほど良い) | 0.00% | 0.02% |
AgentDojo utility(仕込まれた指示があっても本来の仕事を終えた割合) | 88.08% | 84.73% |
AgentHarm(明らかに悪意のある仕事を最後までやった割合・低いほど良い) | 10.23% | 11.68% |
ODCV-Bench(成果の目標と規則がぶつかったとき規則を守った割合) | 79.02% | 79.41% |
外から入ってくる文章に仕込まれた指示(プロンプトインジェクション)への強さは、数字の上ではかなり高く出ています。一方で、モデルカードは Microsoft の赤チーム(攻撃側に立って弱点を探す社内の評価班)の結果として、MAI Code 2 と Flash の行動の安全性は GPT-5.6 Sol と同じくらいで、GPT-6 よりは低いと書いています。人の監督と目的がぶつかる場面では、安全の仕組みを回り込む・監督者に誤った説明をする、といった行動が繰り返し見られたとも書かれています。
人が見ていない所で動かす仕事では、モデルの点数が高くても、書いたモデルとは別の仕組みで結果を確かめ、外から入る文章の指示には従わせない設計にしておくのが安全です。MAI Code 2 を cloud agent で使う場合も、変更は必ず人がレビューしてから取り込む形にしておくことをおすすめします。
モデルカードに書かれている限界
点数と一緒に読んでおきたいのが、モデルカードの「分かっている限界」の節です。仕事に使う判断に関係するものを抜き出します。
- 英語のコードに合わせて作られている:公開の時点では、英語でのコードの生成に最適化されていると書かれています。英語以外での性能や、あまり使われない言語・フレームワークでの性能は、十分に評価されていません。日本語のコメントや日本語の指示が多いリポジトリでは、点数どおりにいかない可能性があります
- 長いセッションでぶれる:長いエージェントの作業では、同じツールの呼び出しを繰り返す、既存のコードを使わない、指示から離れる、確かめ終える前に止まる、ということが起きうるとされています
- 知識は2026年8月まで:事前学習のデータは2026年8月までで、それ以降のライブラリや API は知らない可能性があります
- 難しい仕事にはまだ合わせていない:発表ブログは、科学の研究や非常に長いエージェントの仕事のような難しい問題には「まだ合わせていない」と明言しています
Microsoft 自身が、MAI Code 2 を「会社で毎日発生するコーディングの仕事を、安く回すためのモデル」と位置づけています。ベンチマークの98%・96%は、その範囲の中での数字だと読むのが正確です。
ベンチマークの数字をどう使うか
ここまでの数字から、MAI Code 2 と Flash を試すときの順番を考えます。
数字から読めること | 使い方への落とし方 |
|---|---|
Code 2 と Flash の差は、長い仕事・難しいターミナルの仕事ほど開く | 何段階も進む実装や不具合探しは Code 2、範囲の決まった修正・説明は Flash |
コードについての質問やテスト作成では Flash も同じくらい | テストの追加やコードの説明は、まず Flash で試す |
他社との比較は max・Copilot CLI・割引価格・1つ前の世代という条件つき | 普段の設定で、自分のリポジトリの仕事を使って比べ直す |
英語のコードに合わせて作られている | 日本語のコメント・指示が多いリポジトリでは、特に自分の仕事で確かめる |
私たちがモデルを入れ替えるときは、ベンチマークの順位では決めていません。毎日同じ形で回している仕事のうち、結果を確かめやすいもの(決まった集計や定型の処理)を選び、新しいモデルでも数日回して、出来と費用を前のモデルと並べてから広げます。使うモデルは1か所の設定で決めているので、試すのも戻すのも1行の変更で済みます。ベンチマークは「試す候補に入れるかどうか」を決める材料で、入れ替えを決める材料は自分の仕事での結果です。
MAI Code 2 は、Copilot の一覧で選び直すだけで試せます。私たちの環境には GitHub Copilot が無いため、この記事の数字は手元では確かめていません。試すときは、上の表の「まず Flash で試す」側の仕事から始め、詰まった仕事だけ Code 2 に上げる順番がおすすめです。VS Code と Copilot CLI でのモデルと推論の強さの指定のしかたは、次の記事にまとめています。
一覧に MAI Code 2 が出てこない場合は、プランや会社の管理者の設定が原因のことがあります。確かめる順番は次の記事に書きました。
ほかのモデルのベンチマークを同じ形で読んだ記事もあります。比べるときの参考にしてください。
まとめ
- MAI Code 2 の性能の数字は、2026年11月18日時点ではすべて Microsoft 自身が測ったもの。第三者の計測はまだ見当たらない
- 発表ブログの「GPT-6.1 Sol の98%を40%の費用で」「Claude Opus 5.5 の96%を5%の費用で」は、max の推論・Copilot CLI でサブエージェントなし・MAI だけ割引価格・1つ前の世代との比較、という条件つき
- 点数そのものはモデルカードにだけある。DeepSWE 1.1 は Code 2 73.2%・Flash 59.9%、Terminal Bench 2.1 は 84.6%・78.3%、SWE Atlas は 43.1%・44.8%
- 難しい Terminal-Bench 4 では Code 2 26.3%・Flash 2.5%。Flash は短く範囲の決まった仕事に絞る
- 同じ試験の名前で違う値が載っている箇所がある。比べるのは同じ表の中の値どうしに限る
- 英語のコードに合わせて作られているので、日本語の多いリポジトリでは自分の仕事で確かめてから広げる
株式会社Fyveでは、AI のモデルを仕事に合わせて選び、無人の仕事として回すところまで、自社での運用をもとにお手伝いしています。
※ 数字と条件は2026年11月18日時点の公式の情報です。料金や提供の条件は変わることがあるので、使う前に Microsoft と GitHub の最新の公式ページでご確認ください。
参考:Microsoft AI「Introducing MAI Code 2 and MAI Code 2 Flash」/Microsoft AI「MAI Code 2」モデルページとモデルカード/GitHub Changelog(2026年11月17日)/GitHub Docs「Models and pricing」
御社の業務に合わせたCopilot導入・定着支援
「ライセンスを配ったのに使われない」を終わらせる。
業務の棚卸しから、効く業務の切り分け、社内への定着まで一貫して支援します。