GPT-6.2のベンチマーク|公式の数値と読み方

「GPT-6.2 Astra のベンチマークは前より上がったらしいけれど、どの数字を信じて、何を基準に選べばいいのか」「OpenAI の図と外部の評価で、順位が違って見える」——新しいモデルが出るたびに、ベンチマークの表を前にこう迷う方は多いはずです。
結論から言うと、GPT-6.2 のベンチマークでいちばん大きく変わったのは点数ではなく「1件あたりの費用」です。ソフトウェアを使う仕事を測る Agents' Last Exam では、GPT-6.2 Astra が前の GPT-6 Astra より5.2ポイント高く、費用は3分の1以下でした。一方で、外部の総合指標では Claude Fable 5.2 が上で、コーディングのエージェントの外部指標は GPT-6 Astra から横ばいです。上がった所と上がっていない所が、はっきり分かれています。
株式会社Fyveは、中小企業のAI導入を支援しながら、自社でも OpenAI と Anthropic のモデルを仕事に合わせて使い分けています。この記事では、2026年11月17日(米国時間)の発表で示された数字を「OpenAI の発表の図」「システムカード」「外部の評価機関」の3つに分けて並べ、それぞれの読み方を整理します。あわせて、Sol と Astra を同じ問題・同じ effort で解かせ、費用の差を手元で確かめた結果も載せます。
GPT-6.2 Astra・Sol が何で、前の世代から何が変わったかの全体像は、次の記事にまとめています。
GPT-6.2のベンチマーク:3種類の数字がある
GPT-6.2 の数字は、出どころが3つあります。同じ「ベンチマーク」でも、誰が・何のために測ったかが違うので、混ぜずに読む必要があります。
出どころ | 何のための数字か | 数字の細かさ |
|---|---|---|
OpenAI の発表の図 | 新しいモデルの強みを示す(OpenAI 自身が測定) | 図だけ。本文には「◯ポイント上」の差しか書かれていない |
システムカード(Deployment Safety Hub) | 危険な能力がどこまで伸びたかを確かめる安全性の評価 | 表で小数点まで公開 |
外部の評価機関(Artificial Analysis・Epoch AI・Vals AI など) | 各社のモデルを同じ条件で並べる | 指数や順位。機関ごとに条件が違う |
出典について正直に書いておきます。OpenAI の発表ページ(openai.com)は、私たちの環境からは読み込みが拒否されて直接開けませんでした。そのため、発表の図の点数そのものは、OpenAI の開発者フォーラムの告知(本文に差が書かれている)と、図の値を読み取った報道(OfficeChai)を突き合わせて確かめています。図から読み取った値は概算なので、この記事では「約」を付けます。システムカードは OpenAI のサイトで直接読みました(2026年11月18日時点)。
Agents' Last Exam:点数より費用の差が大きい
Agents' Last Exam は、仕事で使うソフトウェアを操作して、最後まで成果物を作れるかを測る評価です。単純な問題集ではなく、複数のアプリをまたいで手順を進める力を見ます。OpenAI が GPT-6.2 の主張の中心に置いた評価です。
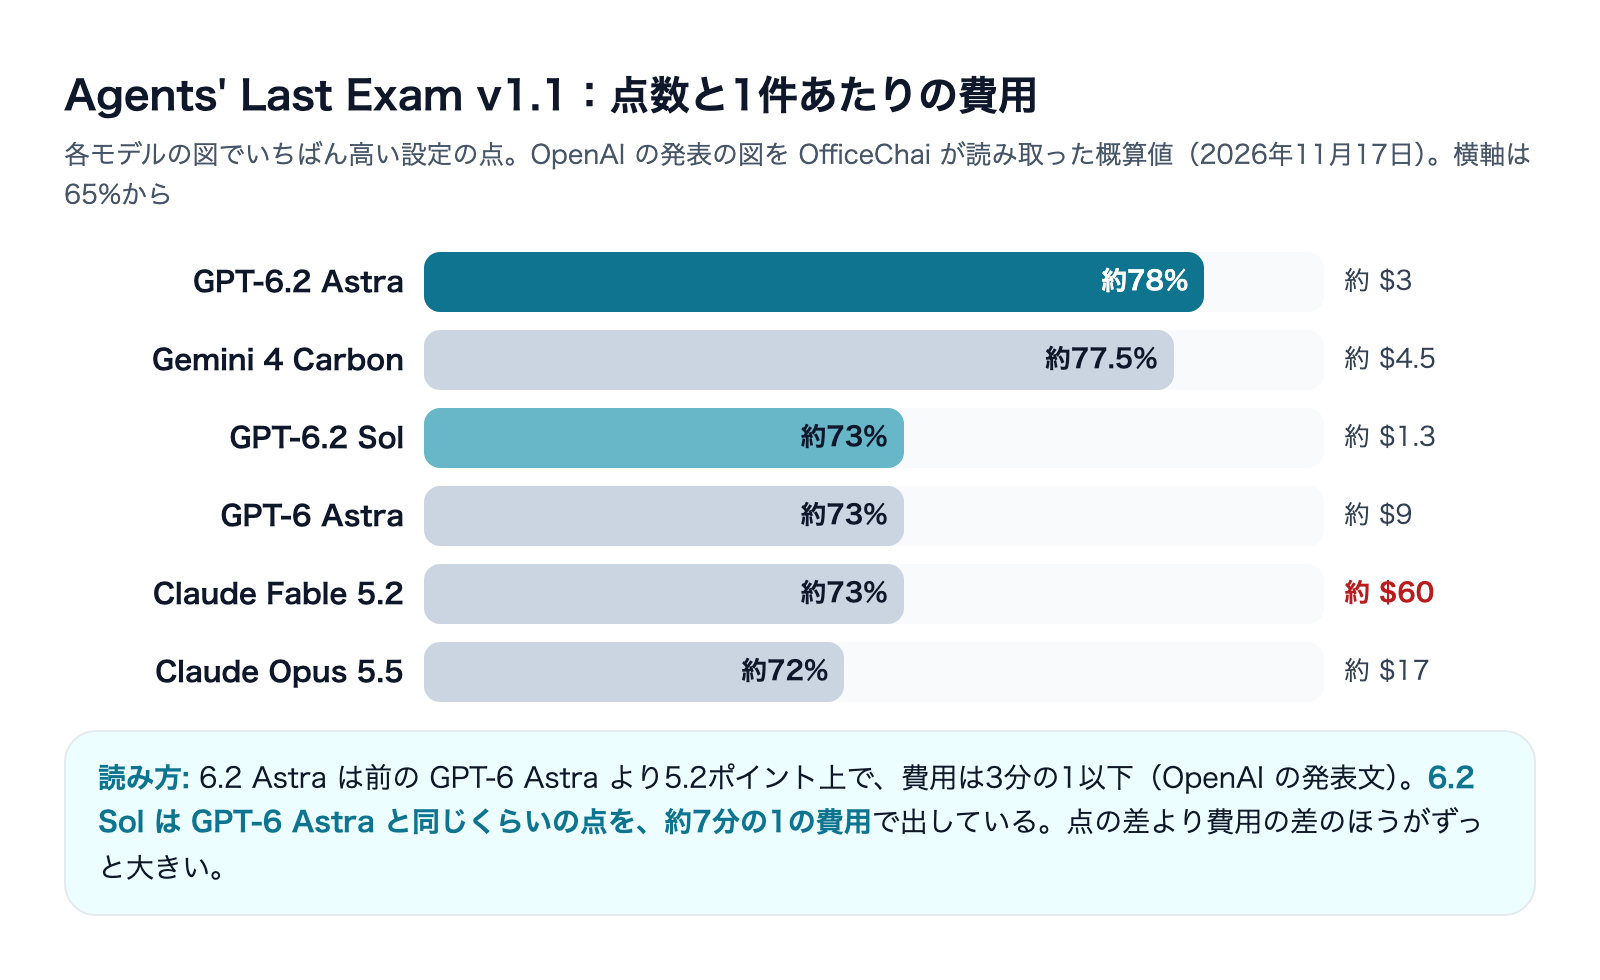
OpenAI の告知が本文で書いているのは、次の1点です。effort(推論の強さ)を xhigh にした GPT-6.2 Astra は、max にした GPT-6 Astra より5.2ポイント高く、1件あたりの費用は半分未満。The Decoder と Digital Trends は、同じ比較を「費用は3分の1以下」と伝えています。
モデル(図でいちばん高い設定) | 点数(概算) | 1件あたりの費用(概算) |
|---|---|---|
GPT-6.2 Astra | 約78% | 約$3 |
Gemini 4 Carbon | 約77.5% | 約$4.5 |
GPT-6.2 Sol | 約73% | 約$1.3 |
GPT-6 Astra | 約73% | 約$9 |
Claude Fable 5.2 | 約73% | 約$60 |
Claude Opus 5.5 | 約72% | 約$17 |
表の値は OfficeChai が発表の図から読み取ったものです。Astra と GPT-6 Astra の差(約78%と約73%で約5ポイント)は、OpenAI の告知の「5.2ポイント」と合います。The Decoder が伝える「Fable 5.2 より5.5ポイント上で、費用は約5%」も、約$3と約$60の比と合います。
Sol が GPT-6 Astra に並んだ意味
この図でいちばん実務に効くのは、Astra の伸びより Sol の位置です。Sol は約73%で、前の旗艦の GPT-6 Astra と同じくらいの点を、約7分の1の費用で出しています。トークンの単価は Sol が Astra の4分の1(入力$2・出力$10 と 入力$8・出力$40、100万トークンあたり)なので、単価の差以上に1件の費用が下がっています。
Artificial Analysis も、Sol は GPT-6 Astra と同じ総合指数を、1件あたり約15%の費用で出したと評価しています(後の節で扱います)。2つの出どころが、同じ向きのことを言っています。
Gemini 4 Carbon との差は0.5ポイント
Astra の約78%に対して、Gemini 4 Carbon は約77.5%です。図から読んだ概算どうしの0.5ポイント差なので、どちらが上と言える差ではありません。費用も約$3と約$4.5で、大きくは離れていません。「Agents' Last Exam では Astra が1位」と読むより、「上位2つが並んでいる」と読むのが正確です。

コーディング:FrontierCode 2.0 と Terminal-Bench-Science
コーディングの数字は、OpenAI の発表と外部の評価で印象が分かれます。先に OpenAI の発表、次に外部の評価の順で見ます。
FrontierCode 2.0:Sol が Astra に0.5ポイント差
FrontierCode 2.0 は、Cognition が作った評価で、実際のコードベースへの変更が、メンテナーがそのまま取り込める出来かを測ります。OpenAI の告知によると、Sol と Astra をどちらも max の effort にしたとき、Sol は Astra に約0.5ポイント差まで迫り、費用は約5分の1でした。
点数そのものは、告知の本文にも報道にもありません。The Decoder は、この図でいちばん高い点を出したのは Claude Fable 5.2 で、ただし1件あたりの費用は数倍だったと伝えています。つまり、FrontierCode 2.0 の図が示しているのは「GPT-6.2 が1位」ではなく、「Sol なら Astra とほぼ同じ出来を、ずっと安く出せる」ということです。
Terminal-Bench-Science 0.1:研究用のコーディングは9ポイント上
Terminal-Bench-Science 0.1 は、研究の現場で使うコードをコマンドラインで書いて動かす力を測る評価です。OpenAI の告知と Digital Trends によると、Astra は GPT-6 Astra より9ポイント高く、費用は3分の1以下でした。OfficeChai が図から読んだ値は、Astra 約77%(約$7)、Sol 約68%(約$2)、GPT-6 Astra 約68%(約$24)、Claude Fable 5.2 約73%(約$45・別の実行の仕組みでの値)です。
ここでも Sol は GPT-6 Astra と同じくらいの点で、費用は約12分の1です。
外部のコーディング指標は横ばい
一方、Artificial Analysis が Codex の実行の仕組みで測った Coding Agent Index では、Astra は GPT-6 Astra から変わらず、Sol は GPT-6.1 Sol から3ポイント下がりました。下がった主な理由は、コードベースについての質問に答える SWE-Atlas-QnA で14ポイント落ちたことだと The Decoder は伝えています。Vals AI のコマンドラインのコーディング評価(Terminal-Bench 4)でも、Astra は5位、Sol は7位で、1位ではありません。
コーディングに限って言えば、「GPT-6.2 で大きく賢くなった」とは読めません。読めるのは「同じくらいの出来を、前より安く出せる」までです。Codex で日常のコーディングに使うなら、まず Sol を試し、足りない所だけ Astra に上げる順番が合っています。Codex での指定の仕方は次の記事に書きました。
専門職の仕事:GDPval-v2・Harvey LAB-AA・BenchCAD
OpenAI は、コーディング以外の専門職の仕事でも数字を出しています。ここが今回いちばん差が大きく出た領域です。
- GDPval-v2(さまざまな職種の実務の成果物を、専門家が評価する):Astra は前のモデルより6.2ポイント上で、出力トークンは22%少ない(The Decoder・Digital Trends)
- Harvey LAB-AA v1.1(法務の実務):Astra 約15%(約$6)、Sol 約11%(約$2)、GPT-6 Astra 約9%、Claude Fable 5.2 約7%(約$40)。The Decoder は「Fable 5.2 の2倍以上の通過率を、約6分の1の費用で」と伝えています
- BenchCAD 2.1 Core(設計図面の作業):Astra 約83%(約$5.5)、Claude Fable 5.2 約84%(約$51)、Sol 約73%、GPT-6 Astra 約63%
Harvey LAB-AA は通過率そのものが15%前後と低く、「法務の仕事を任せられる」水準ではありません。伸び率が大きく見えても、元の点が低い評価では、仕事に使えるかどうかは別に確かめる必要があります。BenchCAD は Astra と Fable 5.2 がほぼ同点で、費用は約9分の1です。
なお、OfficeChai の記事は本文で BenchCAD の Fable 5.2 を「約74%・$23」と書いており、表の「約84%・$51」と食い違っています。図の別の設定の点を指している可能性がありますが、私たちは図そのものを確かめられていません。BenchCAD の Fable 5.2 の値は参考程度にしてください。
システムカードの数値:小数点まで出ている評価
OpenAI は発表と同じ2026年11月17日に、GPT-6.2 のシステムカードを公開しました。目的は危険な能力(生物・化学、サイバー攻撃、AI の自己改良)がどこまで伸びたかを確かめることですが、評価の中身は「難しい仕事をどこまでこなせるか」なので、能力の目安としても読めます。発表の図と違い、値は表で小数点まで出ています。
評価(何を測るか) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
GPQA Diamond(大学院レベルの理科の問題・ツールなし) | 97.0% | 96.0% | 96.0% |
MLE-Bench Revised(機械学習のコンペ・参照の順位の平均) | 96.06 | 91.38 | 93.80 |
Internal Research Debugging(研究コードの不具合探し) | 81.85% | 74.66% | 78.05% |
KernelGen 1P(GPU の計算の部品を書く) | 76.92% | 74.71% | 66.72% |
SEC-Bench Pro(脆弱性の再現) | 86.75% | 88.34% | 85.4% |
ExploitBench Internal Port(攻撃コードの作成・安全策を外した状態) | 53.5% | 50.5% | 31.5% |
HealthBench Professional(医療の専門家向けの回答) | 66.3 | 65.9 | 64.7 |
MentalHealthBench(メンタルヘルスの相談への対応・max) | 53.3% | 50.9% | 58.7% |
この表から読めることは3つあります。
- 理科の知識問題はほぼ頭打ち:GPQA Diamond は3モデルとも96〜97%で、差がほとんどありません。この評価でモデルを選び分けることはもうできません
- Sol が Astra を上回る評価もある:SEC-Bench Pro(脆弱性の再現)では Sol が88.34%で、Astra の86.75%(max)より上です。「Astra のほうが常に上」ではありません
- 下がった評価もある:MentalHealthBench は、GPT-6.2 の2モデルとも GPT-6 Astra(58.7%)と GPT-6.1 Sol(57.9%)より下で、システムカードは相談の深刻さのどの段階でも前のモデルより低かったと書いています。相談窓口のような使い方を考えているなら、この点は確かめてから使うべきです
サイバーの評価の伸び(ExploitBench Internal Port で22ポイント)は、OpenAI が「サイバーで最も能力の高いモデル」と書いた根拠です。その分、サイバー攻撃につながる支援には安全策を強めて提供すると説明しています。
外部の評価:総合では Claude Fable 5.2 が上
OpenAI 以外が測った数字も見ておきます。各機関の測り方が違うので、機関をまたいで点数を比べることはできません。順位と、同じ機関の中での差を見ます。
評価機関・指標 | 結果 |
|---|---|
Artificial Analysis Intelligence Index(9つの試験の総合・100点満点) | Claude Fable 5.2 65/GPT-6.2 Astra 62/Gemini 4 Carbon 60/Claude Opus 5.5 59/GPT-6.2 Sol 57/GPT-6 Astra 57 |
Artificial Analysis AA-3D(3D の体験づくり・人の判定の Elo) | GPT-6.2 Astra 1,318/Claude Fable 5.2 1,271/GPT-6.2 Sol 1,259 |
Artificial Analysis AA-Omniscience のハルシネーション率(max・低いほど良い) | GPT-6.2 Astra 59%/GPT-6.2 Sol 55% |
Epoch AI Capabilities Index | GPT-6.2 Astra 174(Claude Fable 5.2 と同点)/GPT-6 Astra 169 |
Epoch AI FrontierMath Erdős(未解決級の数学の問題) | GPT-6.2 Astra 68問中7問(これまでの最高は GPT-6.1 Sol の3問) |
Vals AI Index(1件あたりの費用) | GPT-6.2 Astra 7位($10.68)/GPT-6.2 Sol 9位($3.18)/GPT-6 Astra($21.28) |
総合指数では Claude Fable 5.2 が3ポイント上で、Decrypt も「独立した試験では Astra は Fable 5.2 に次ぐ2位」と伝えています。OpenAI の発表の図では Astra が Fable 5.2 を上回る評価が並んでいましたが、それは OpenAI が選んだ評価での話です。外部の総合指数で見ると、GPT-6.2 Astra は「いちばん賢いモデル」ではなく「上位に入るモデルを、ずっと安く使える」位置です。
ハルシネーション率(知らないことを知っているように答える割合)は、Sol のほうが Astra より低い値でした。事実の正確さが大事な調べものでは、上位のモデルのほうが常に安全とは限りません。
Claude との使い分けを点数ではなく仕事の中身で決める考え方は、次の記事に書きました。
ベンチマークの読み方:4つの確認
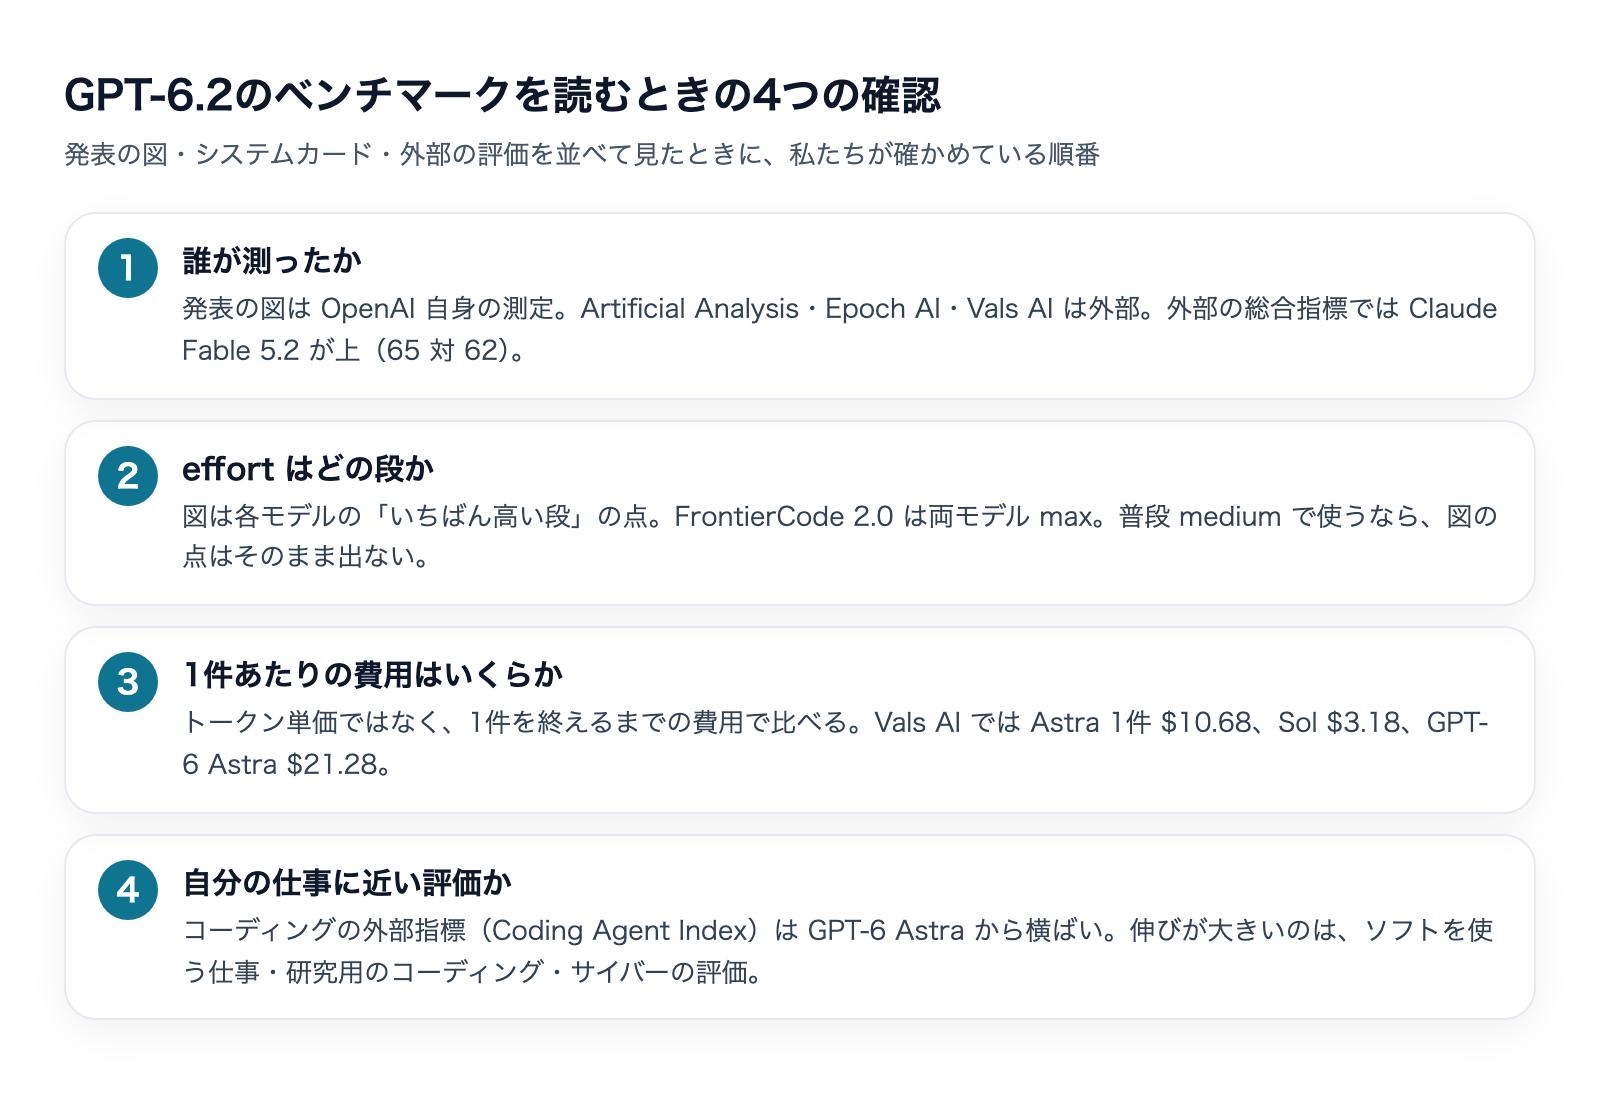
ここまでの数字を、自分の仕事のモデル選びに使うときは、次の4つを順に確かめています。
1. 誰が測ったか
発表の図は OpenAI 自身の測定で、評価の選び方も OpenAI が決めています。どの会社の発表も、自社のモデルが強く見える評価を前に出します。外部の総合指数で Fable 5.2 が上だったように、出どころを変えると順位が入れ替わることがあります。
2. effort はどの段か
発表の図は、各モデルの「いちばん高い段」の点を並べています。FrontierCode 2.0 は Sol も Astra も max、Agents' Last Exam の比較は Astra が xhigh・GPT-6 Astra が max でした。普段 medium で使うなら、図の点はそのままは出ません。段ごとの違いと選び方は、次の記事にまとめています。
3. 1件あたりの費用はいくらか
GPT-6.2 の数字でいちばん大きく動いたのは、点数ではなく1件あたりの費用です。トークンの単価だけを見ると Astra は前より20%安いだけですが、1件の費用は3分の1以下になっています。少ないトークンで仕事を終えるようになったためです。モデルを比べるときは、単価ではなく「1件を終えるまでの費用」で比べてください。
4. 自分の仕事に近い評価か
伸びが大きいのは、ソフトウェアを使う仕事・研究用のコーディング・専門職の成果物・サイバーの評価です。日常のコーディングの外部指標は横ばいでした。自分の仕事に近い評価がどれかを先に決めてから、その評価の数字を見るのが安全です。
手元で確かめたこと:Sol と Astra を max で解かせた費用
FrontierCode 2.0 の「Sol は Astra とほぼ同じ出来を約5分の1の費用で」という主張を、小さな問題で1つ確かめました。条件は次のとおりです。
- 2026年11月18日、ChatGPT アカウント(Plus)でサインインした Codex CLI 0.169.0、読み取りだけの設定
- 問題:重みに比例して割り勘する20行ほどの Python の関数。仕様(docstring)と食い違う不具合を、私たちが4つ仕込んだもの(端数の丸め方・端数を配る順番・キャッシュのキーに重みが無い・キャッシュの辞書をそのまま返す)
- 同じ指示文で、Sol と Astra をどちらも effort max で1回ずつ
- 費用は、Codex が出したトークン数に API の単価を掛けた目安(Plus の利用枠の中で動かしたので、実際には請求されていません)
GPT-6.2 Sol(max) | GPT-6.2 Astra(max) | |
|---|---|---|
かかった時間 | 355秒 | 397秒 |
仕込んだ4つの不具合 | 4/4 | 4/4 |
それ以外に挙げた問題 | 9件(仕様にない重みが分母に入る、など) | 6件(仕様にない重みが分母に入る、など) |
入力トークン(うちキャッシュ) | 92,645(65,792) | 118,894(80,384) |
出力トークン(うち推論) | 12,780(10,041) | 12,586(10,549) |
API 単価で換算した費用 | 約$0.19 | 約$0.84 |
どちらも仕込んだ4つを全部見つけ、仕込んでいない5つ目(仕様にない人の重みが分母に入る)も両方が挙げました。出来に差は見えません。一方、API の単価で換算した費用は Sol が約$0.19、Astra が約$0.84で、Sol は Astra の約4.5分の1でした。出力トークンはほぼ同じで、差はほとんど単価の差(4倍)から来ています。発表の「約5分の1」と近い比になりました。
時間は Sol が355秒、Astra が397秒で、max ではどちらも6分前後かかりました。どちらもファイルを読んだあと、自分で Python を動かして、不具合が本当に起きるかを確かめてから答えています。max は、このくらいの大きさの問題には重すぎる段です。普段の不具合探しなら、medium か high で足ります。
1問だけの試験なので、ここから言えるのは傾向までです。それでも、「Sol で足りるかを先に試す」という読み方は、手元の小さな問題でも当てはまりました。同じ問題を medium・high で解かせた比較は、次の記事に載せています。
前の世代・Claude のベンチマークと並べて読むとき
前の世代や Claude の数字と並べて読みたいときは、それぞれの発表時の記事が参考になります。ただし、評価の版(Agents' Last Exam の v1 と v1.1 など)や測った時期が違うと、点数をそのまま比べることはできません。並べるときは、同じ図に載っている値どうしだけを比べてください。
Claude Fable 5.2のベンチマーク|数値と読み方
まとめ:GPT-6.2のベンチマークは「同じ出来を安く」と読む
- Agents' Last Exam では、GPT-6.2 Astra が GPT-6 Astra より5.2ポイント上で、1件あたりの費用は3分の1以下
- GPT-6.2 Sol は、前の旗艦の GPT-6 Astra と同じくらいの点を、約7分の1の費用で出している
- FrontierCode 2.0 では Sol が Astra に0.5ポイント差、費用は約5分の1
- システムカードでは、理科の知識問題(GPQA Diamond)はほぼ頭打ち。脆弱性の再現では Sol が Astra より上、メンタルヘルスの評価は前より下がった
- 外部の総合指数では Claude Fable 5.2 が上(65 対 62)。外部のコーディング指標は GPT-6 Astra から横ばい
数字を見てモデルを選ぶときは、誰が測ったか・effort の段・1件あたりの費用・自分の仕事に近い評価か、の4つを確かめてください。私たちは、まず Sol で足りるかを試し、足りない仕事だけ Astra や Claude に上げる順番で使っています。株式会社Fyveでは、こうした数字の読み方も含めて、仕事に合うモデルの選び方を整理するお手伝いをしています。
※ この記事の数字は、2026年11月18日時点で公開されている OpenAI の告知・システムカードと各報道・評価機関の発表にもとづきます。図から読み取った値は概算です。最新の値は OpenAI の発表と各評価機関のページで確認してください。
Codexを使い始める前に、「絶対に」見直してほしい5つのこと
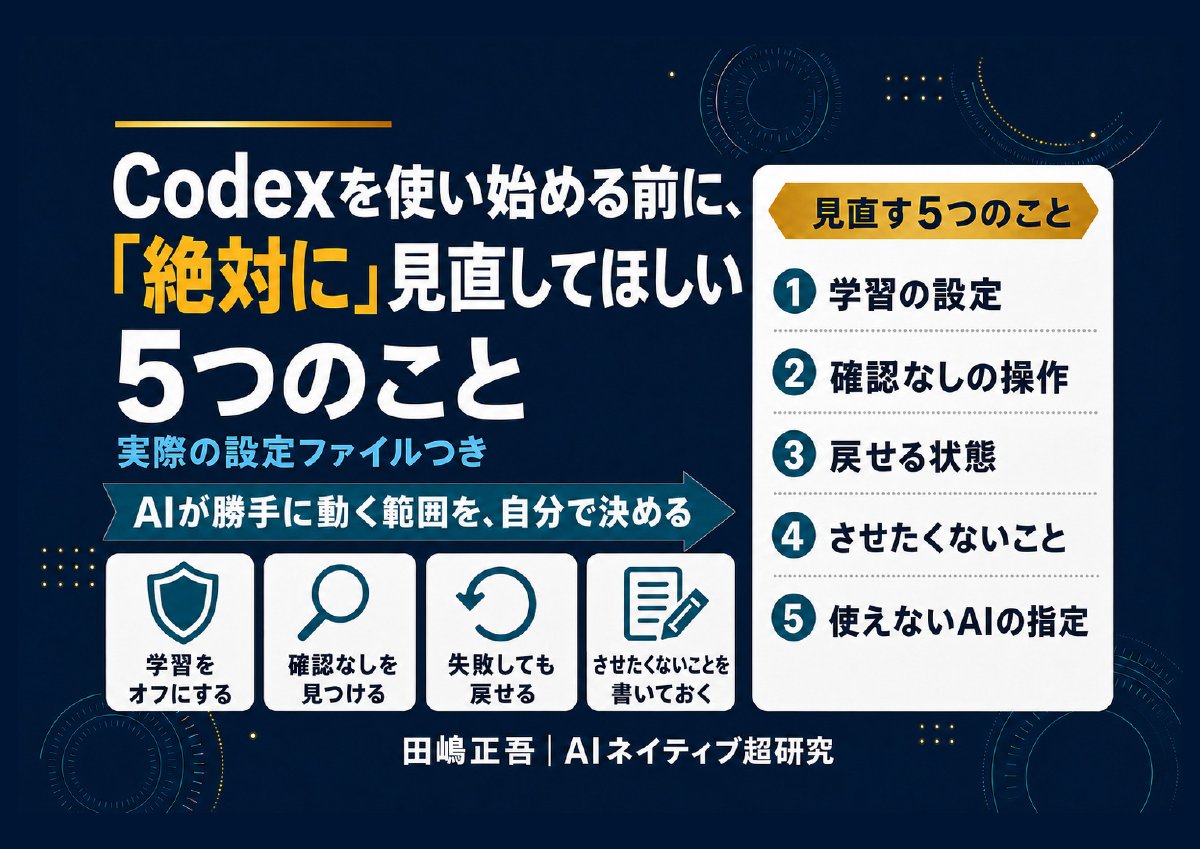
学習の設定・確認なしの操作・戻せる状態など。Codexにそのまま貼れる頼み方つき(全9ページ)
Codexは便利な一方で、設定ひとつで「聞かずに動く」ようになります。この資料を作るために自分の設定を開いたら、本番のデータベースを書き換える操作が、覚えのないうちに確認なしで動く状態になっていました。使い始める前に見直してほしい5つを、Codexにそのまま貼れる頼み方と一緒にまとめました。
- 仕事の画面や資料を、AIの学習に使わせない設定
- 取り返しのつかない操作が確認なしになっていないか、Codexに調べさせる頼み方
- AGENTS.mdのいちばん上に書く「絶対にしないこと」の例
- 失敗しても戻せる状態で始める方法と、使えなくなったAIの指定の直し方
メールアドレス登録で他にも様々な資料を閲覧できます








 +14
PDF 23点・合計550ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。