GPT-6.2 AstraとClaude|使い分けと実測

「GPT-6.2 Astra と Claude の Fable 5.2 は、どちらが上なのか」「料金が同じなら、どちらを契約すればいいのか」「Codex と Claude Code のどちらで仕事を回すべきか」——1週間あいだを空けて2社の旗艦モデルが出そろい、この迷いを抱える方が増えています。
結論から言うと、GPT-6.2 Astra と Claude Fable 5.2 は、APIの基本の単価が入力$8・出力$40で同じで、私たちの試験では同じ不具合を同じ数だけ見つけました。差が出るのは「27.2万トークンを超える長い入力」「キャッシュ」「使う道具とプラン」です。長い資料を丸ごと読ませる仕事は Fable 5.2 が安く、Codex と ChatGPT で仕事が回っているなら Astra のままで困りません。
株式会社Fyveは、中小企業の AI 導入を支援しながら、自社でも Codex と Claude Code の両方を毎日の仕事に使っています。この記事では、両社の公式の資料で確かめた数字と、GPT-6.2 の発表の当日(日本時間の2026年11月18日)に同じ問題を両方に解かせた結果をもとに、どちらにどの仕事を渡すかを整理します。
GPT-6.2 Astra と Claude Fable 5.2 の使い分け(先に結論)
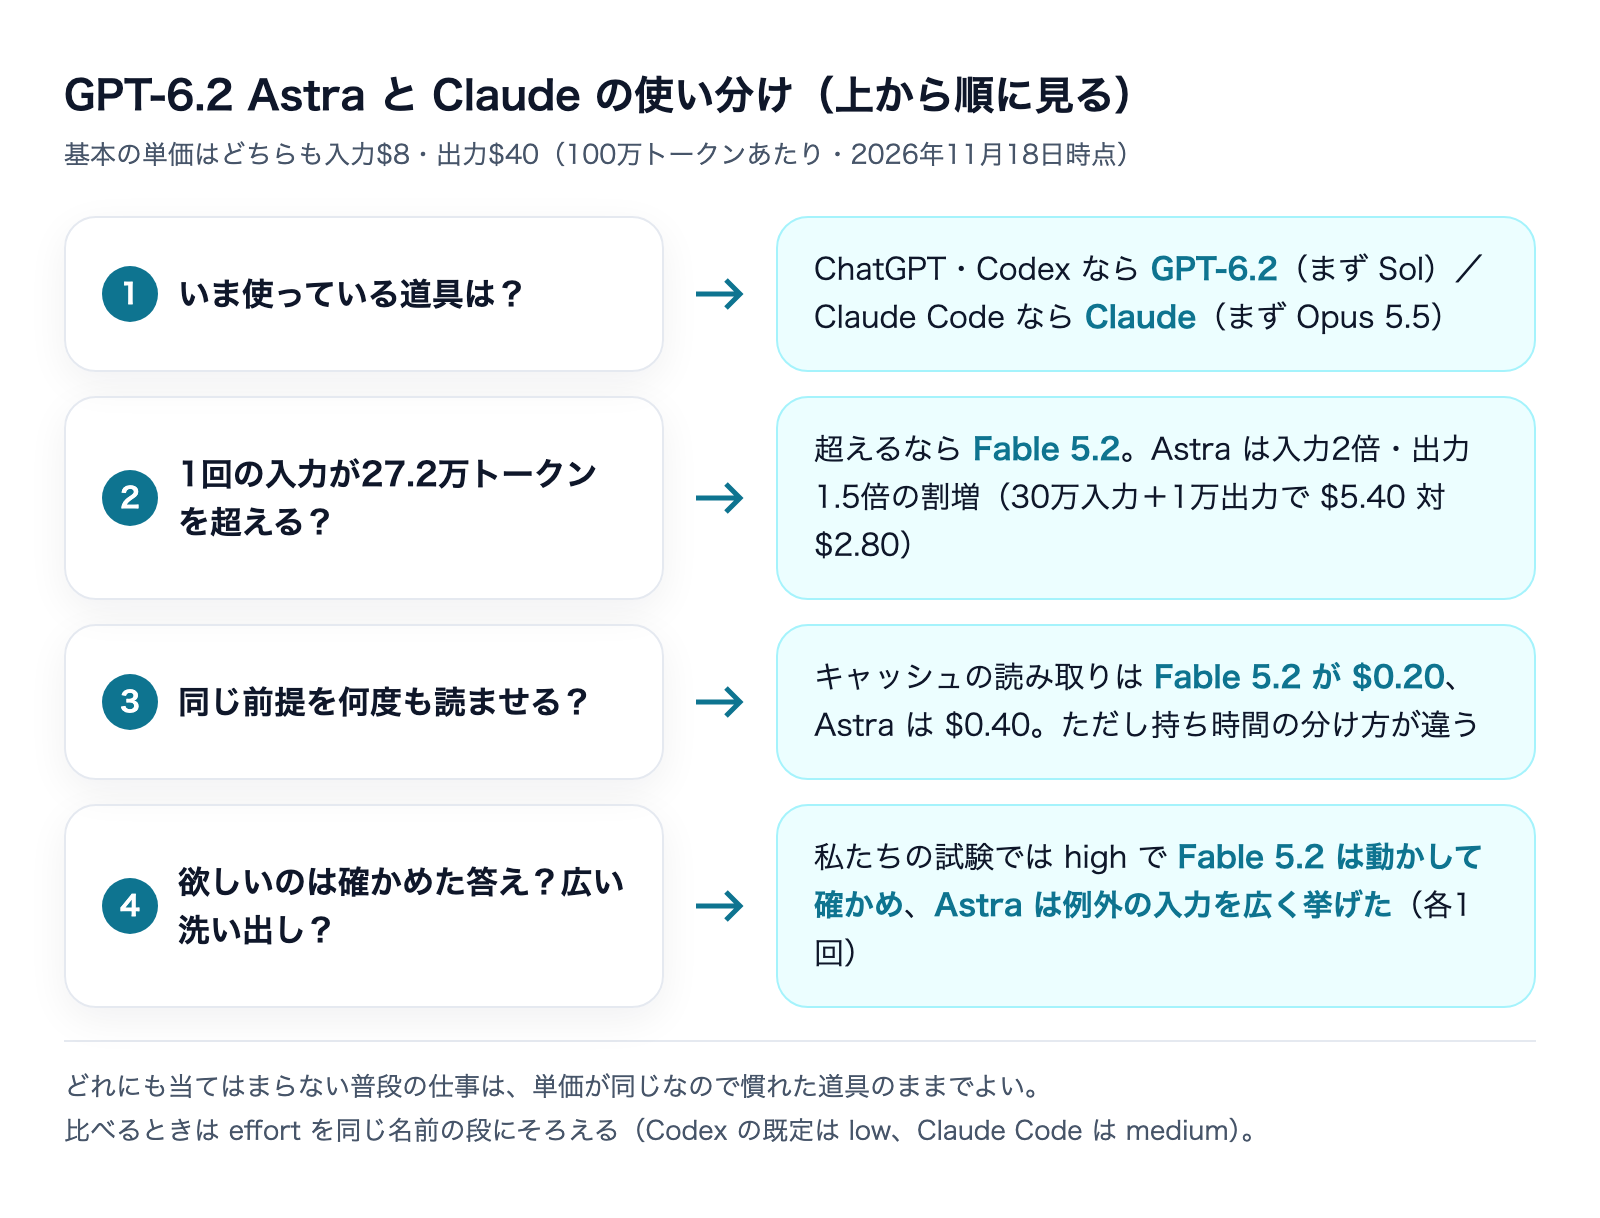
先に、私たちの判断を表にまとめます。根拠はこのあとの節で1つずつ示します。
状況 | 渡す先 | 理由 |
|---|---|---|
すでに ChatGPT(Plus 以上)と Codex で仕事が回っている | GPT-6.2 Astra(まず Sol で足りるか試す) | 追加の契約が要らない。単価は Fable 5.2 と同じ |
すでに Claude Code で仕事が回っている | まず Claude Opus 5.5、足りないときだけ Fable 5.2 | Anthropic 自身が「まず Opus 5.5」と案内している。Opus 5.5 の単価は Fable 5.2 の半分 |
27.2万トークンを超える資料・コードを一度に読ませる | Claude Fable 5.2 | Astra はその長さを超えると入力が2倍・出力が1.5倍になる。Fable 5.2 は100万トークンまで同じ単価 |
同じ前提(長い指示・資料)を何度も読み直させる | Claude Fable 5.2 | キャッシュの読み取りが $0.20 で、Astra($0.40)の半分 |
とにかく速く返してほしい(対話しながらの作業) | どちらも「速いモード」がある | Astra は Ultrafast(Pro など)、Fable 5.2 は fast mode(単価2倍)。プランと予算で選ぶ |
どちらか片方の結果だけでは不安な重要な変更 | 両方に同じ問題を出す | 同じ単価なので、2社に読ませて食い違いを見るほうが安全 |
「どちらが賢いか」で選ぶより、「今の道具とプランのまま使えるか」「入力が長いか」で選ぶほうが、外れが少ないというのが私たちの見立てです。
GPT-6.2 Astra と Claude Fable 5.2 を公式の数字で比べる
両方のモデルの基本の数字を、各社の公式のページで確かめて並べました。金額はすべて米ドル・100万トークンあたりで、2026年11月18日時点の値です。契約や開発の前には、OpenAI と Anthropic の最新の価格ページで確認してください。
項目 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
発表 | 2026年11月17日(米国時間) | 2026年11月9日(米国時間) |
API のモデル名 |
|
|
入力 | $8 | $8 |
出力 | $40 | $40 |
キャッシュの読み取り | $0.40 | $0.20 |
キャッシュの書き込み | $10(30分)/$20(12時間) | $10(5分)/$16(1時間) |
長い入力の割増 | 入力が27.2万トークンを超えると、そのリクエスト全体で入力とキャッシュが2倍、出力が1.5倍 | なし(100万トークンまで同じ単価) |
コンテキスト | 1,050,000(入力は最大922,000) | 100万 |
最大出力 | 128,000 | 12.8万 |
知識の締切 | 2026年5月18日 | 2026年6月 |
速いモード | Ultrafast(標準の最大4.5倍の速さ・使用量を多く使う) | fast mode(生成が最大2.5倍・入力$16・出力$80) |
推論の強さ(effort) | API は none を受け付けない。Codex では low〜ultra の6段 | low・medium・high・xhigh・max の5段。API の既定は high、Claude のアプリと Claude Code は medium |
主な使い道 | ChatGPT Work・Codex(Plus・Pro・Enterprise・Edu)、OpenAI API | Claude のアプリ・Claude Code、Claude API、AWS・Google Cloud・Microsoft Foundry |
いちばん目を引くのは、基本の単価が入力・出力とも同じ点です。前の世代の GPT-6 Astra は入力$10・出力$50、Fable 5.1 も同じ$10・$50だったので、2社とも同じ幅で値を下げた形になりました。
差が出るのは「長い入力」と「キャッシュ」
単価が同じでも、使い方によって請求額は変わります。わかりやすい例を2つ計算しました(キャッシュなし・1回の呼び出し)。
- 10万トークンを読ませて1万トークン書かせる: どちらも入力$0.80+出力$0.40で $1.20。差はありません
- 30万トークンを読ませて1万トークン書かせる: Fable 5.2 は入力$2.40+出力$0.40で $2.80。Astra は27.2万トークンを超えるため、入力が$16、出力が$60の扱いになり、$4.80+$0.60で $5.40。約1.9倍です
契約書の束や、リポジトリ全体を一度に読ませるような仕事では、この割増が効いてきます。逆に、1回の入力が数万トークンに収まる普段のコーディングや文書作成なら、単価の差はほぼ出ません。
もう1つはキャッシュです。同じ長い指示や資料を何度も読ませる仕組み(社内の規程を前提にした問い合わせ対応など)では、読み取りの単価が半分の Fable 5.2 のほうが安くなります。ただし、キャッシュの持ち時間は Astra が30分・12時間、Fable 5.2 が5分・1時間と分け方が違うため、呼び出しの間隔によっては結果が逆になることもあります。

公式のベンチマークに、直接の比較は無い
「どちらが上か」を公式の数字で確かめようとすると、困ったことに気づきます。GPT-6.2 Astra と Fable 5.2 を同じ表に並べた公式の数字は、2026年11月18日時点でどちらの会社からも出ていません。
- Anthropic の Fable 5.2 の発表(11月9日)は、比べる相手が1つ前の GPT-6 Astra です。GPT-6.2 はまだ出ていませんでした
- OpenAI の GPT-6.2 の発表(11月17日)は、自社の GPT-6 Astra との比較が中心です。Agents' Last Exam で、xhigh の GPT-6.2 Astra が max の GPT-6 Astra を5.2ポイント上回り、1タスクの費用は半分未満、としています
- 報道(9to5Google)は「OpenAI は GPT-6.2 が Anthropic の最新のモデルとおおむね同じ水準で、しばしばずっと安いと示している」と伝えていますが、点数そのものは載せていません
参考までに1つだけ数字を引くと、Anthropic の表では、実際のコードベースへの変更を測る FrontierCode 2.0 で、Fable 5.2(xhigh)が49.1%、前の世代の GPT-6 Astra が42.8%でした。ただしこれは GPT-6.2 の前の数字です。GPT-6.2 Astra がこの差をどこまで縮めたかは、公式の数字ではまだ言えません。
各社の表の読み方と、Fable 5.2 側の数字の一覧は、ベンチマークの記事で扱っています。
Claude Fable 5.2のベンチマーク|数値と読み方
公式の数字で決着がつかないなら、自分の仕事に近い問題で試すしかありません。そこで私たちは、同じ問題を両方に解かせてみました。
GPT-6.2 Astra と Claude に同じ不具合探しを解かせた実測
試したのは、私たちが GPT-6.2 の Sol と Astra を比べたときに使ったのと同じ問題です。重み付きの割り勘の関数(20行)に、説明文(docstring)と食い違う不具合を4つ仕込みました。
- 1円未満を「切り捨て」と書いてあるのに、既定の丸め(偶数丸め)で切り上がる人が出る
- 端数を「重みの大きい人から」配ると書いてあるのに、小さい人から配っている
- 「同じ引数なら結果を使い回す」のに、使い回しのキーに重みが入っていない
- 使い回す結果をそのまま返すので、呼び出した側が書き換えると次の結果が壊れる
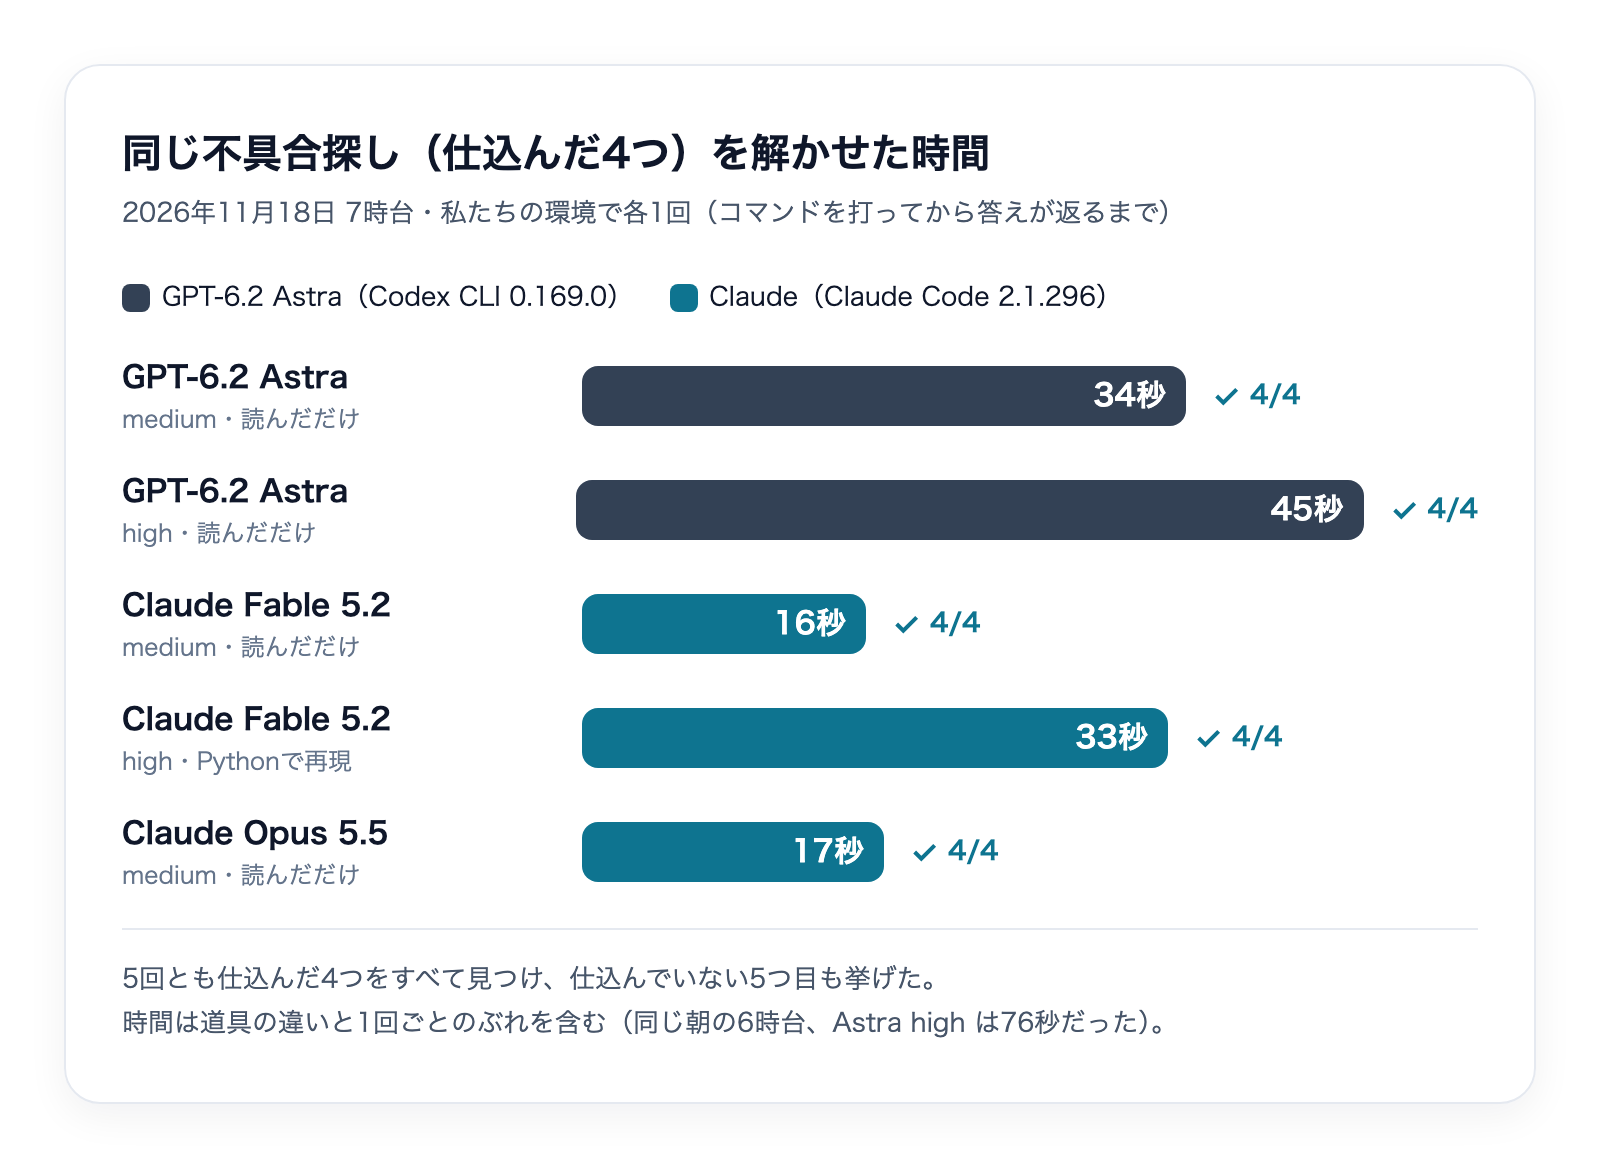
出した指示は全員同じで、「ledger.py を読み、docstring どおりに動かない不具合をすべて挙げ、それぞれ1行で理由と修正を書いてください。ファイルは書き換えないこと」です。GPT-6.2 Astra は Codex CLI 0.169.0(ChatGPT Plus のアカウント・読み取り専用)、Claude の2モデルは Claude Code 2.1.296(ファイルを読むことと Python の実行だけを許可)で、2026年11月18日の朝7時台に各1回動かしました。
モデル・effort | 道具 | かかった時間 | 仕込んだ4つ | 自分でコードを動かしたか |
|---|---|---|---|---|
GPT-6.2 Astra・medium | Codex | 34秒 | 4/4 | 読んだだけ |
GPT-6.2 Astra・high | Codex | 45秒 | 4/4 | 読んだだけ |
Claude Fable 5.2・medium | Claude Code | 16秒 | 4/4 | 読んだだけ |
Claude Fable 5.2・high | Claude Code | 33秒 | 4/4 | Python で5件すべてを再現 |
Claude Opus 5.5・medium | Claude Code | 17秒 | 4/4 | 読んだだけ |
(時間は、コマンドを打ってから答えが返るまでを手元で測った値です。)
見つけた不具合は全員同じだった
5回とも、仕込んだ4つをすべて見つけました。さらに5回とも、仕込んでいない5つ目(参加者でない人の重みまで分母に入り、全員の取り分が小さくなる)も挙げています。正しさの面では、この問題で差はつきませんでした。
違ったのは、答えの作り方です。
- Fable 5.2(high)は、Python を自分で動かして5件すべてを再現し、「200円を3人で割ると全員67円、合計201円になる」のように実際の数字を添えて返しました。手元の Python が 3.9 で、型の書き方のせいで読み込みに失敗することまで指摘しています
- GPT-6.2 Astraは、medium・high とも読むだけで、空の参加者・同じ名前の重複・重みの合計が0・1円未満の端数など、説明文が決めていない入力の扱いを足しました。medium で3項目、high で6項目と、段を上げると挙げる範囲が広がりました
- Fable 5.2(medium)も読むだけで、同じ名前の重複・重みの合計が0などの入力を4項目足しています。high に上げると、項目を増やすかわりに実際に動かして確かめる方向に時間を使いました
- Opus 5.5(medium)は、Fable 5.2 の medium とほぼ同じ時間・同じ5件で、修正のコードも同じ書き方でした
つまり、段を上げたときに、Fable 5.2 は「確かめてから言う」方向に、Astra は「起こりうる穴を広く挙げる」方向に時間を使いました。どちらが良いかは仕事によります。直す箇所を確実に知りたいなら前者、仕様の抜けを洗い出したいなら後者が役に立ちます。
時間の差は「道具」の差も含んでいる
この試験では、Claude の2モデルのほうが短い時間で返しました。ただし、ここから「Fable 5.2 のほうが速い」とは言えません。理由は3つあります。
- 道具が違う: Codex と Claude Code では、モデルに渡す前の準備やファイルの読み方が違います。測ったのは「道具込みの時間」です
- 1回ごとのぶれが大きい: 同じ朝の6時台に、同じ問題を GPT-6.2 Astra(high)に解かせたときは76秒かかり、そのときは自分で Python を動かして確かめていました。今回の45秒とは30秒以上違います
- トークンの数え方が違う: Codex が表示する使用量と、Claude Code が返す使用量は、数える範囲が違います。Claude Code の数字には道具自身の長い前置きの読み込みが入るため、同じ物差しで並べられません
各1回の試験なので、数字は「この問題ではこうだった」という参考です。自分の仕事で選ぶときは、普段の課題を3〜5問用意して、両方に同じ条件で出すことをおすすめします。
どの仕事を GPT-6.2 Astra に、どれを Claude に渡すか
ここまでの数字と試験から、仕事の種類ごとの渡し先を考えます。前提として、2つは「どちらかが圧倒的に上」という関係ではありません。単価が同じなので、決め手は周りの条件です。
今使っている道具とプランを優先する
いちばん大きいのは、すでに契約している道具です。ChatGPT の Plus 以上を契約していれば、GPT-6.2 Astra は ChatGPT Work と Codex でそのまま選べます。Codex での指定の仕方は、別の記事で手順を書いています。
一方、Claude の Pro や Team の標準の席では、Fable 5.2 を週の上限の50%まで使えたのは発売の週(2026年11月16日まで)だけでした。いまは、使用量クレジットをオンにしている場合にそこから支払う形です。Claude Code で毎日 Fable 5.2 を回すなら、プランごとに使える量を先に確かめてください。
Claude Fable 5.2のプラン|各プランで使える量
Claude 側は「まず Opus 5.5」
Claude を使う場合、Anthropic は多くのコーディングと知的作業について「まず Claude Opus 5.5 から始め、足りなければ Fable に上げる」と案内しています。Opus 5.5 の単価は入力$4・出力$20で、Fable 5.2 と GPT-6.2 Astra の半分です。私たちの試験でも、Opus 5.5 の medium は Fable 5.2 の medium と同じ5件を同じくらいの時間で返しました。
つまり「GPT-6.2 Astra と Claude のどちらか」を比べるとき、Claude 側の相手は必ずしも Fable 5.2 ではありません。普段の仕事なら Opus 5.5 と比べるほうが、費用の面では公平です。Fable 5.2 と Opus 5.5 の分け方は、こちらで扱っています。
Claude Fable 5.2 vs Opus 5.5の選び方
同じように、OpenAI 側にも半額以下の選択肢があります。GPT-6.2 Sol は入力$2・出力$10で、OpenAI は実際のコードベースへの変更で Sol が Astra に迫り、費用は約5分の1だとしています。
長い入力は Fable 5.2、広い洗い出しは Astra
- Fable 5.2 に向く仕事: 27.2万トークンを超える資料やコードを一度に読ませる仕事、同じ前提を何度も読ませる仕組み、直す箇所を実際に動かして確かめてほしいレビュー
- GPT-6.2 Astra に向く仕事: ChatGPT と Codex の中で完結する開発、仕様の抜けや例外の入力を広く洗い出したい場面、ChatGPT Work でチームと同じ画面で使いたい場面
- どちらでもよい仕事: 1回の入力が数万トークンに収まる普段のコーディング・文書作成。ここは単価が同じなので、慣れた道具で構いません
effort を揃えて比べる
比べるときに見落としやすいのが effort(推論の強さ)です。Fable 5.2 は API の既定が high、Claude Code の既定が medium です。GPT-6.2 は、Codex の一覧での既定が low でした。何も指定せずに比べると、段の違う同士を比べることになります。比べるときは、両方に同じ名前の段(medium どうし、high どうし)を明示してください。GPT-6.2 の各段の意味は別の記事にまとめています。
私たちの使い方:2社を分けて置いている
私たちは、どちらか1社に寄せていません。仕事の種類で置き場所を分けています。
- 夜間の無人の仕事は、文章を書く仕事を Claude Code(Opus 5.5)、画像づくりやモデルの試験を Codex と分けて回しています。新しいモデルの届き方も会社ごとに違い、GPT-6.2 の発表の当日は、私たちの Codex に新しいモデルが届くまで約40分かかりました
- 公開する前の確認は、書いたときの文脈と切り離した別のプロセスに読ませています。同じ単価の2社のモデルが並んだいま、「確かめる側」を別の会社のモデルにするのも、費用を大きく増やさずにできる選択肢になりました
- 普段の仕事は、Claude 側は Opus 5.5、OpenAI 側は Sol から始め、足りないときだけ Fable 5.2 や Astra に上げます。旗艦を常用すると、単価が2〜4倍になるからです
GPT-6.2 が届くまでの経過は、こちらに残しています。
GPT-6.2 が出る前に、1つ前の GPT-6 Astra と Fable 5.2 を比べた記事もあります。今回の結果と並べると、2社の差が版ごとにどう動いたかが見えます。
GPT-6.2 Astra と Claude についてよくある質問
GPT-6.2 Astra と Fable 5.2 は、どちらが性能が上ですか?
2026年11月18日時点で、2つを同じ表に並べた公式の数字はありません。私たちの不具合探しの試験では、どちらも仕込んだ4つをすべて見つけ、差はつきませんでした。答えの作り方(実際に動かして確かめるか、穴を広く挙げるか)に違いがありました。
料金はどちらが安いですか?
API の基本の単価は、どちらも入力$8・出力$40(100万トークンあたり)で同じです。入力が27.2万トークンを超えると GPT-6.2 Astra に割増がかかり、キャッシュの読み取りも Fable 5.2 が半額なので、長い入力や同じ前提の読み直しが多い使い方では Fable 5.2 のほうが安くなります。
Codex で Claude のモデルは使えますか? Claude Code で GPT-6.2 は使えますか?
この記事の試験では、Astra を Codex で、Fable 5.2 と Opus 5.5 を Claude Code で動かしました。各社のモデルは、その会社の道具で使うのがいちばん手間がかかりません。両方を使い分けたい場合は、2つの道具を並べて使うのが素直です。
乗り換えたほうがいいですか?
今の道具で仕事が回っているなら、乗り換える必要は小さいと考えます。単価が同じで、試験の正しさにも差が出なかったためです。長い入力が多い、キャッシュを多く使う、といった条件に当てはまるときだけ、もう片方を試す価値があります。
まとめ
- GPT-6.2 Astra と Claude Fable 5.2 は、API の基本の単価が入力$8・出力$40で同じ(2026年11月18日時点)
- 差が出るのは、27.2万トークンを超える入力(Astra は割増・Fable 5.2 はなし)と、キャッシュの読み取り(Fable 5.2 が半額)
- 2つを並べた公式のベンチマークはまだ無い。私たちの試験では、どちらも仕込んだ不具合を4つすべて見つけた
- Fable 5.2 は動かして確かめる寄り、Astra は穴を広く挙げる寄り。時間の差は道具の差と1回ごとのぶれを含むので、決め手にしない
- 普段の仕事は Claude なら Opus 5.5、OpenAI なら Sol から始め、足りないときだけ旗艦に上げる
株式会社Fyveは、2社のモデルを並べて使い分ける形を、自社の仕事で試しながら整えています。どちらを選ぶかで迷ったら、普段の課題を数問用意して、同じ条件で両方に解かせるところから始めてみてください。
Codexを使い始める前に、「絶対に」見直してほしい5つのこと
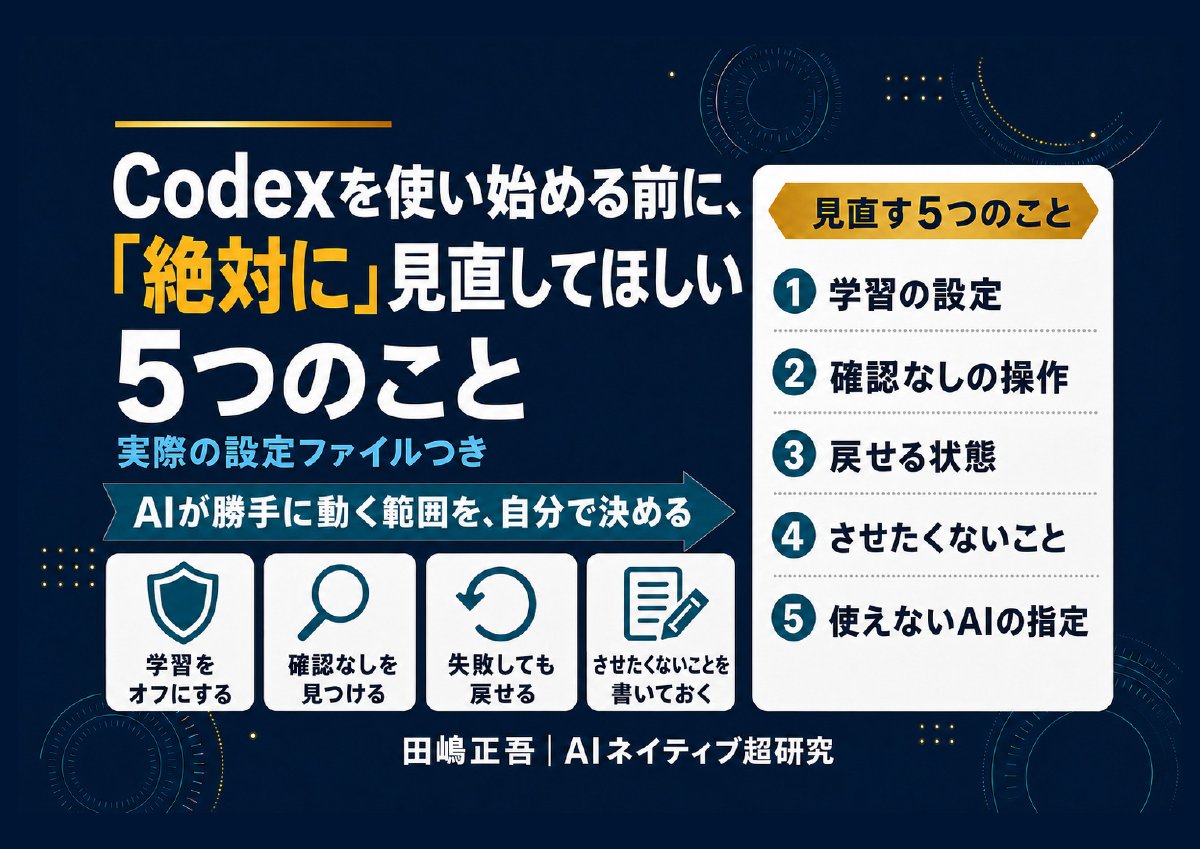
学習の設定・確認なしの操作・戻せる状態など。Codexにそのまま貼れる頼み方つき(全9ページ)
Codexは便利な一方で、設定ひとつで「聞かずに動く」ようになります。この資料を作るために自分の設定を開いたら、本番のデータベースを書き換える操作が、覚えのないうちに確認なしで動く状態になっていました。使い始める前に見直してほしい5つを、Codexにそのまま貼れる頼み方と一緒にまとめました。
- 仕事の画面や資料を、AIの学習に使わせない設定
- 取り返しのつかない操作が確認なしになっていないか、Codexに調べさせる頼み方
- AGENTS.mdのいちばん上に書く「絶対にしないこと」の例
- 失敗しても戻せる状態で始める方法と、使えなくなったAIの指定の直し方
メールアドレス登録で他にも様々な資料を閲覧できます








 +14
PDF 23点・合計550ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。