Claude Fable 5.2のベンチマーク|数値と読み方

「Claude Fable 5.2のベンチマークは、どれくらい上がったのか」「表に数字がたくさん並んでいるけれど、どこを見ればいいのか分からない」——新しいモデルの発表を開いたとき、多くの人がここで手が止まります。
結論から言うと、Claude Fable 5.2のベンチマークは、Fable 5.2自身の数字が載っている11項目のうち9項目で表の最高値です。ただし数字はすべてAnthropic自身の測定で、各モデルの最高のeffort(考える深さの設定)での値です。実務の判断に役立つのは、点数の高さよりも「effortを下げたFable 5.2が、最高effortのOpus 5.5に並ぶときの費用」の数字のほうです。
株式会社Fyveは中小企業のAI活用を支援しており、私たちも毎日Claude Codeで仕事を回しています。この記事では、発表の表を「何を測っているか」つきで全部並べ、表の注記・費用をそろえた比較・前の発表の表との食い違いまで含めて、Fable 5.2の数字の読み方を整理します。
先に結論:Fable 5.2のベンチマークから読み取れる4つのこと
Claude Fable 5.2は2026年11月9日(米国時間・日本時間11月10日)に発表されました。Anthropicは発表ページに、ベンチマーク(AIの能力を同じ試験で測り、点数を並べたもの)の表を載せています。この表から言えることは、次の4つです。
- Fable 5.2自身の数字がある11項目のうち、9項目で表の最高値。業務の自動化(AutomationBench)はGemini 4 Carbonが上、知識労働(AA-Briefcase)は採点の方法によってOpus 5.5が上
- 表の3項目はFable 5.2ではなくMythos 5.2の数字。サイバーセキュリティとたんぱく質の設計の行で、一般に使えるFable 5.2の成績ではない
- 実務で効くのは「費用をそろえた比較」。effortを下げたFable 5.2が、最高effortのOpus 5.5と同じ点数を、半分から10分の1未満の費用で出したと発表されている
- 2026年11月10日時点で、第三者による測り直しは見つからない。報道もAnthropicの発表値をそのまま伝えている段階
以下、表の全体を見てから、この4点を順に掘り下げます。
Claude Fable 5.2の公式ベンチマーク一覧(全14項目)
Anthropicの発表ページの表を、そのまま並べます。比較相手の数値も、Anthropicの表に載っているものです。「—」は表に数値が載っていない項目、括弧の中は表の注記です。
ベンチマーク | 何を測るか | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
FrontierCode 2.0 | エージェントによるコーディング | 49.1%(xhigh) | 32.4%(xhigh) | 45.5% | 42.8% | 41.1%(medium) |
FrontierSWE v2 | エージェントによるコーディング | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
AutomationBench | 業務の自動化 | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
Terminal-Bench-Science 0.1 | 科学の調査をエージェントで進める | 74.6%(Mythos 5.2は75.3%) | 52.6% | 58.7% | 68.1% | 64.8% |
CyScenarioBench | サイバーセキュリティ | 76.3%(Mythos 5.2) | 61.7%(Mythos 5.1) | 67.6%(安全対策なし) | 61%(GPT-6 Cyber) | — |
CVE Rediscovery | 公開済みの脆弱性を見つけ直す | 89.6%(Mythos 5.2) | 78.3%(Mythos 5.1) | 81.3%(安全対策なし) | — | — |
De novo binder design(24時間) | たんぱく質の設計 | 85.1%(Mythos 5.2) | 79.1%(Mythos 5.1) | 82.6%(安全対策なし) | — | — |
WANDR(緩い採点) | 大量の情報を集める検索 | 82.1% | 68.7% | 72.3% | — | — |
OSWorld 2.1(オフライン版の一部) | パソコンの画面操作 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
RoboDojo Sim | カメラ映像から2本腕のロボットを動かす(シミュレーション) | 64.9% | 27.6% | 39.4% | 29.8% | — |
AA-Briefcase v1.1(採点表) | 知識労働 | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
AA-Briefcase v1.1(Elo) | 知識労働(対戦形式の相対評価) | 1785 | 1669 | 1800 | 1569 | 1611 |
Remote Labor Index | 実際の在宅の仕事を任せる | 41.3%(high) | 17.9% | 21.3% | 20.8% | — |
Humanity's Last Exam(ツールあり) | 専門家級の難問の推論 | 74.2% | 65.6% | 67.7% | 57.2% | — |
Chartography(ツールなし) | 図表の読み取り | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
太字は各行の最高値です。AA-Briefcaseは同じ試験を2つの採点方法で出しているため、行を分けました。表のほかに、発表の本文にはハードウェアの設計を測るBenchCAD 2.1の数字もあり、最高のeffortでFable 5.2が83.5点(100点満点)、Opus 5.5が65.3点、Fable 5.1が44.4点です。
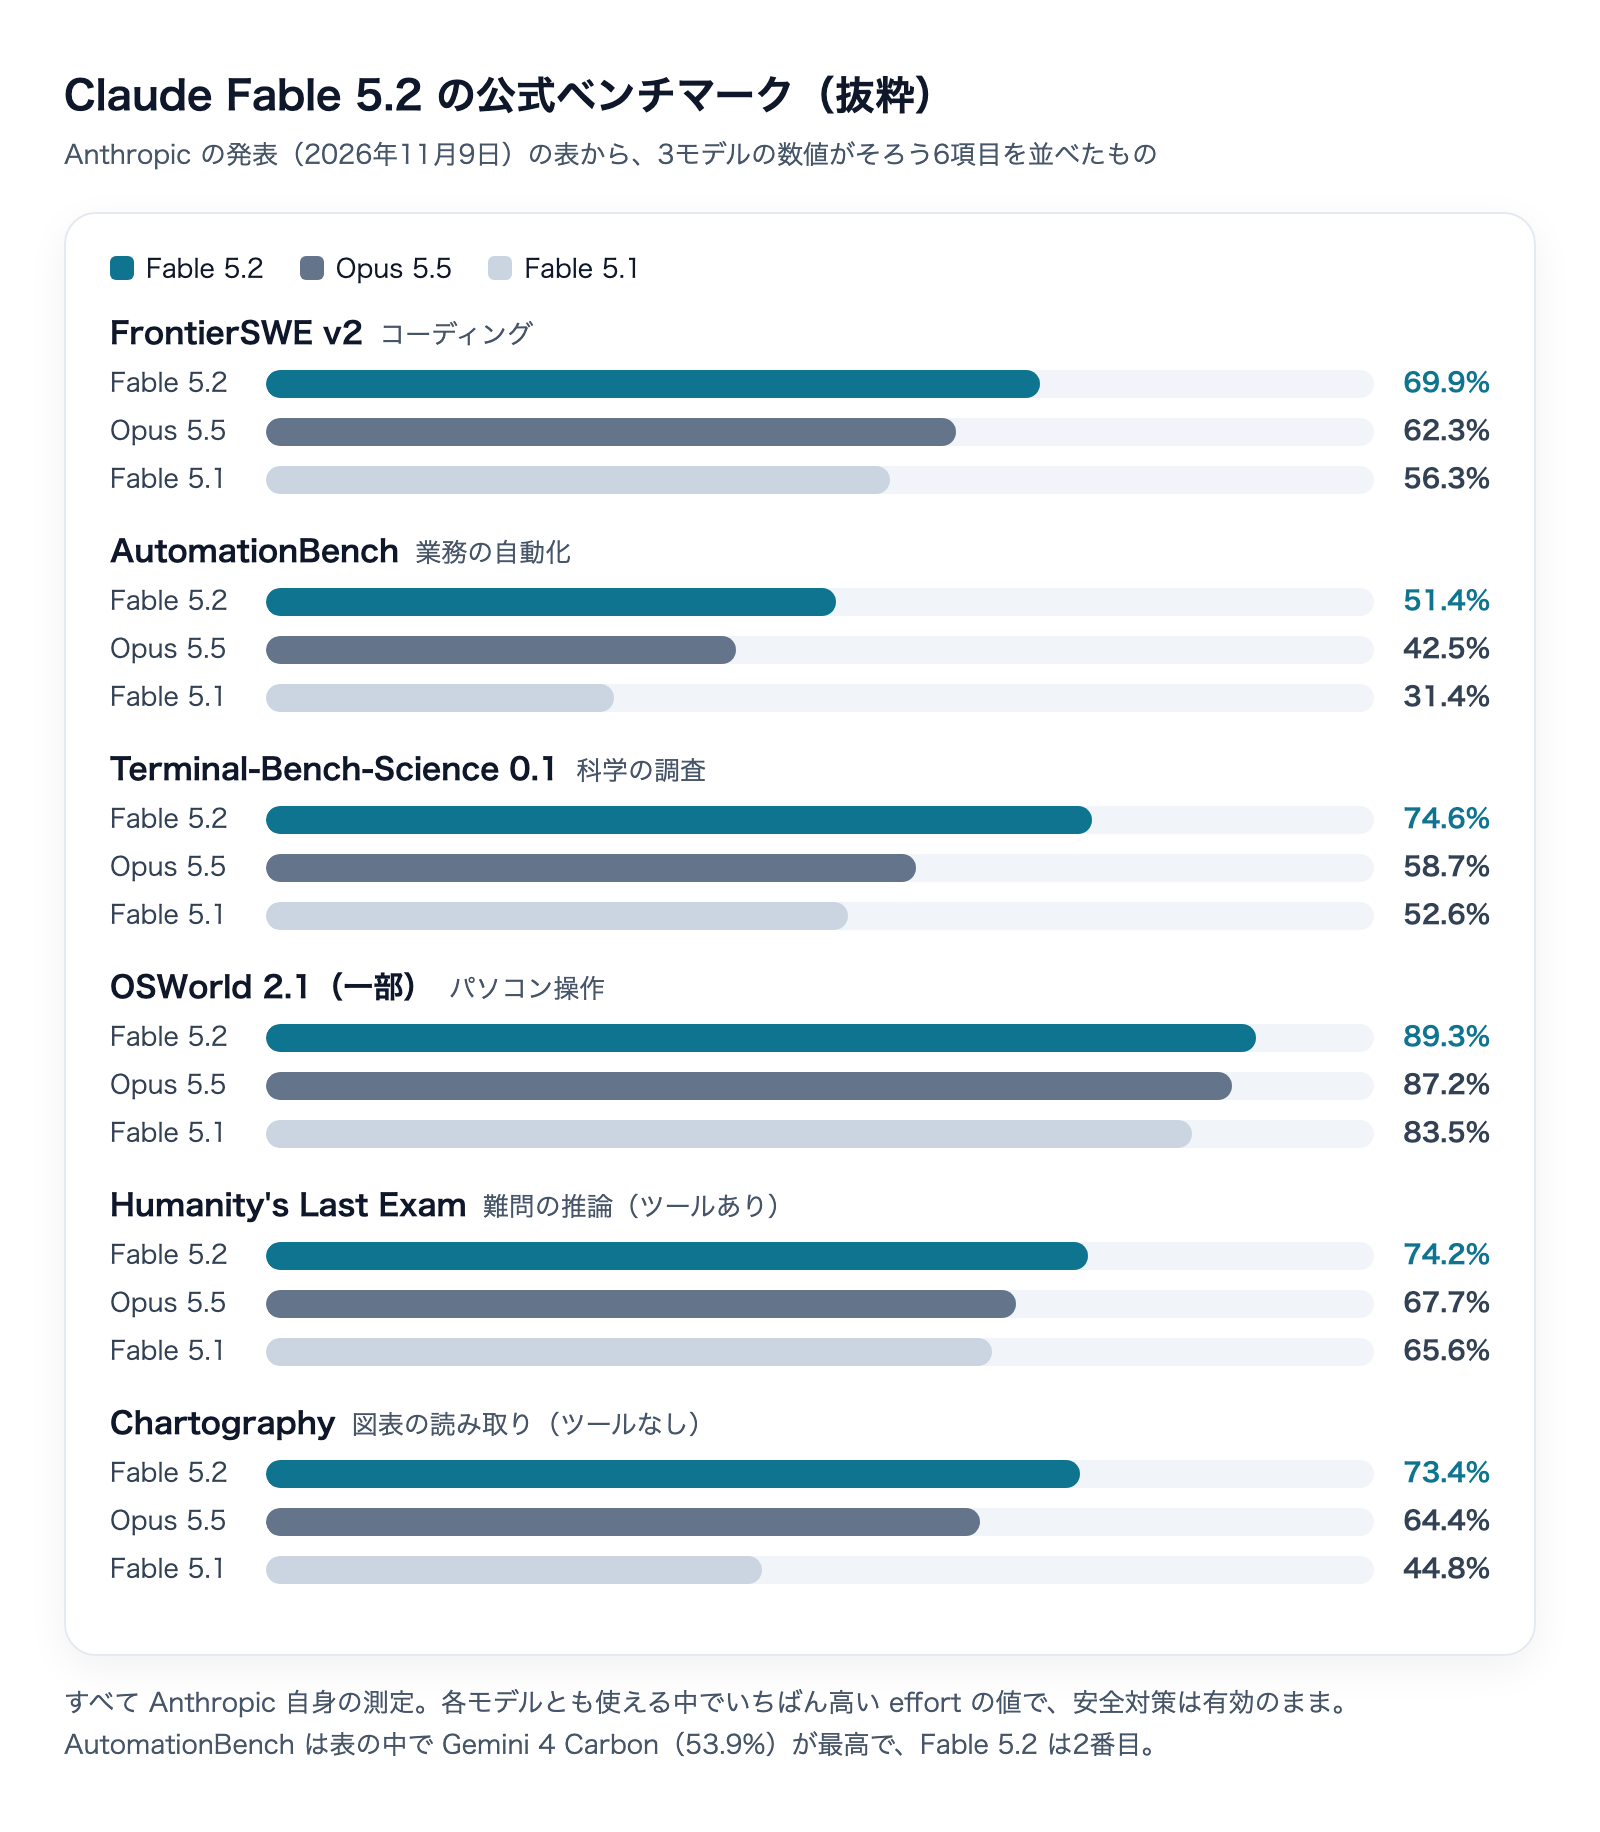
この表を見て「Fable 5.2がほぼ全部で1位」で止めると、読み違える場面があります。測っている仕事の中身、注記、数字の出どころの3つを分けて読むと、同じ表から得られる情報が大きく変わります。

各ベンチマークは何を測っているのか
14項目は、測っている仕事で大きく4つに分けられます。自分の仕事に近い行がどれかを先に決めておくと、表の読み方がぶれません。
コーディング(FrontierCode 2.0/FrontierSWE v2)
FrontierCode 2.0は、AIが書いたコードの変更を、オープンソースの管理者が取り込むかどうかで採点する試験です。テストが通るかだけでなく「人がレビューして受け入れる品質か」まで見るので、Claude Codeで実際の開発を任せる使い方に近い行です。Fable 5.2はxhighで49.1%で、Anthropicは「これまでに試した公開済みのモデルの中で最高」と書いています。
FrontierSWE v2もエージェントによるコーディングの試験で、Fable 5.2は69.9%です。2番目のGPT-6 Astra(65.5%)との差は4.4ポイント、Opus 5.5(62.3%)との差は7.6ポイントです。
業務と知識労働(AutomationBench/AA-Briefcase/Remote Labor Index)
AutomationBenchは業務の流れを自動で進める力を測ります。Fable 5.2は51.4%で、Fable 5.1(31.4%)から20ポイント伸びていますが、表の最高値はGemini 4 Carbonの53.9%です。この表でFable 5.2が他社に負けている、はっきりした1行です。
AA-Briefcaseは資料づくりのような知識労働の試験で、採点表で付けた点数(%)と、対戦の勝ち負けから計算するElo(相対的な強さの指標)の2つが載っています。採点表ではFable 5.2が66.1%で最高ですが、EloではOpus 5.5の1800がFable 5.2の1785を上回っています。差は15で、ほぼ並んでいると読むのが自然です。
Remote Labor Indexは、在宅で人に頼むような実際の仕事をAIに任せる試験です。Fable 5.2はhighで41.3%で、Opus 5.5(21.3%)の約2倍です。この表の中で、Opus 5.5との開きがいちばん大きい行の1つです。
調べものと推論(WANDR/Humanity's Last Exam/Terminal-Bench-Science)
WANDRは、大量の情報を集めてくる検索の仕事を測ります。Anthropicの3モデルだけの比較で、Fable 5.2は82.1%です。Humanity's Last Examは専門家級の難問への推論を、ツールを使える条件で測ります。Fable 5.2は74.2%で、Opus 5.5より6.5ポイント高い結果です。Terminal-Bench-Scienceは科学の調査をターミナル(コマンドを打つ黒い画面)上で進める力で、Fable 5.2は74.6%です。
画面・図表・ロボット(OSWorld/Chartography/RoboDojo)
OSWorld 2.1はパソコンの画面操作で、Fable 5.2は89.3%、Opus 5.5は87.2%と、差は2.1ポイントです。日常の画面操作をAIに任せる用途なら、Opus 5.5でも大きくは変わらないと読めます。Chartographyは図表の読み取りで、ツールを使わない条件です。Fable 5.2は73.4%ですが、Gemini 4 Carbon(72.5%)とGPT-6 Astra(71.0%)もすぐ近くにいます。RoboDojo Simは、カメラの映像を見てシミュレーションの中のロボットを動かす試験で、Fable 5.2は64.9%と、2番目のOpus 5.5(39.4%)を大きく引き離しています。
読み方1:数字は「いちばん高いeffort」での値
表の下には「各モデルとも、注記がない限り使える中でいちばん高いeffortの値」と書かれています。Fable 5.2のeffortはlow・medium・high・xhigh・maxの5段で、表の数字はほとんどがmaxです。ところが、Claudeのアプリと Claude Codeの既定はmediumです。つまり、普段の設定のまま使って表と同じ点数が出るわけではありません。
注記のある行は、条件がほかと違います。
- FrontierCode 2.0:Fable 5.2とFable 5.1はxhigh、Gemini 4 Carbonはmediumでの値
- Remote Labor Index:Fable 5.2はhighでの値
- RoboDojo Sim:Anthropicの社内で測った値
Gemini 4 Carbonの41.1%はmediumの値なので、最高のeffortで測った他社の数字と並べて「Geminiが下」と読むのは早計です。逆に、Fable 5.2のRemote Labor Indexの41.3%はhighの値なので、maxならもう少し上がる可能性があります。注記は、数字の一部として読むのが安全です。
また、Fable 5.2・Fable 5.1・Opus 5.5の数字は、注記がない限り、安全対策(危ない依頼を止める仕組み)を有効にしたまま測った値です。一般のプランやAPIで使うときと同じ側の条件です。effortごとの使い分けは、別の記事で実測つきで整理しています。
読み方2:3つの行はFable 5.2の数字ではない
CyScenarioBench・CVE Rediscovery・De novo binder designの3行は、Fable 5.2の列にMythos 5.2の数字が入っています。Mythos 5.2はFable 5.2と同じ中身のモデルから、サイバーセキュリティと生物学の安全対策を外したもので、審査を通った組織だけが使えます。一般の有料プランやAPIで使えるFable 5.2で、この点数が出るわけではありません。
比較相手の列も条件がそろっていません。Opus 5.5の列は「安全対策なし」の値、GPT-6 Astraの列はサイバー専用のGPT-6 Cyberの値です。さらにCyScenarioBenchには「各社の点数は、それぞれ別の課題で測ったもの」という注記があります。課題が違う以上、この行で各社を横に並べて比べることはできません。
Fable 5.2を普段の仕事に使うか決めるときは、この3行を外して読むのが正確です。外すと、Fable 5.2自身の数字がある行は11項目(AA-Briefcaseを1項目と数える)になり、そのうち9項目で最高値、という最初の結論になります。
読み方3:本当に見るべきは「費用をそろえた比較」
点数の表とは別に、発表には「点数と1問あたりの費用」を並べた図があり、Anthropicはそのうち4つの図の説明で、effortを下げたFable 5.2と最高effortのOpus 5.5を比べています。
ベンチマーク | Fable 5.2のeffort | 結果 | 1問あたりの費用 |
|---|---|---|---|
FrontierCode 2.0 | high | 45.3%(Opus 5.5の最高は45.5%) | Opus 5.5の約半分 |
WANDR | medium | Opus 5.5の最高点に並ぶ | Opus 5.5の約40% |
Humanity's Last Exam | low | Opus 5.5の最高点に並ぶ | Opus 5.5の10分の1未満 |
Chartography | medium | 66.4%(Opus 5.5のmaxは64.4%) | Opus 5.5の10分の1未満 |
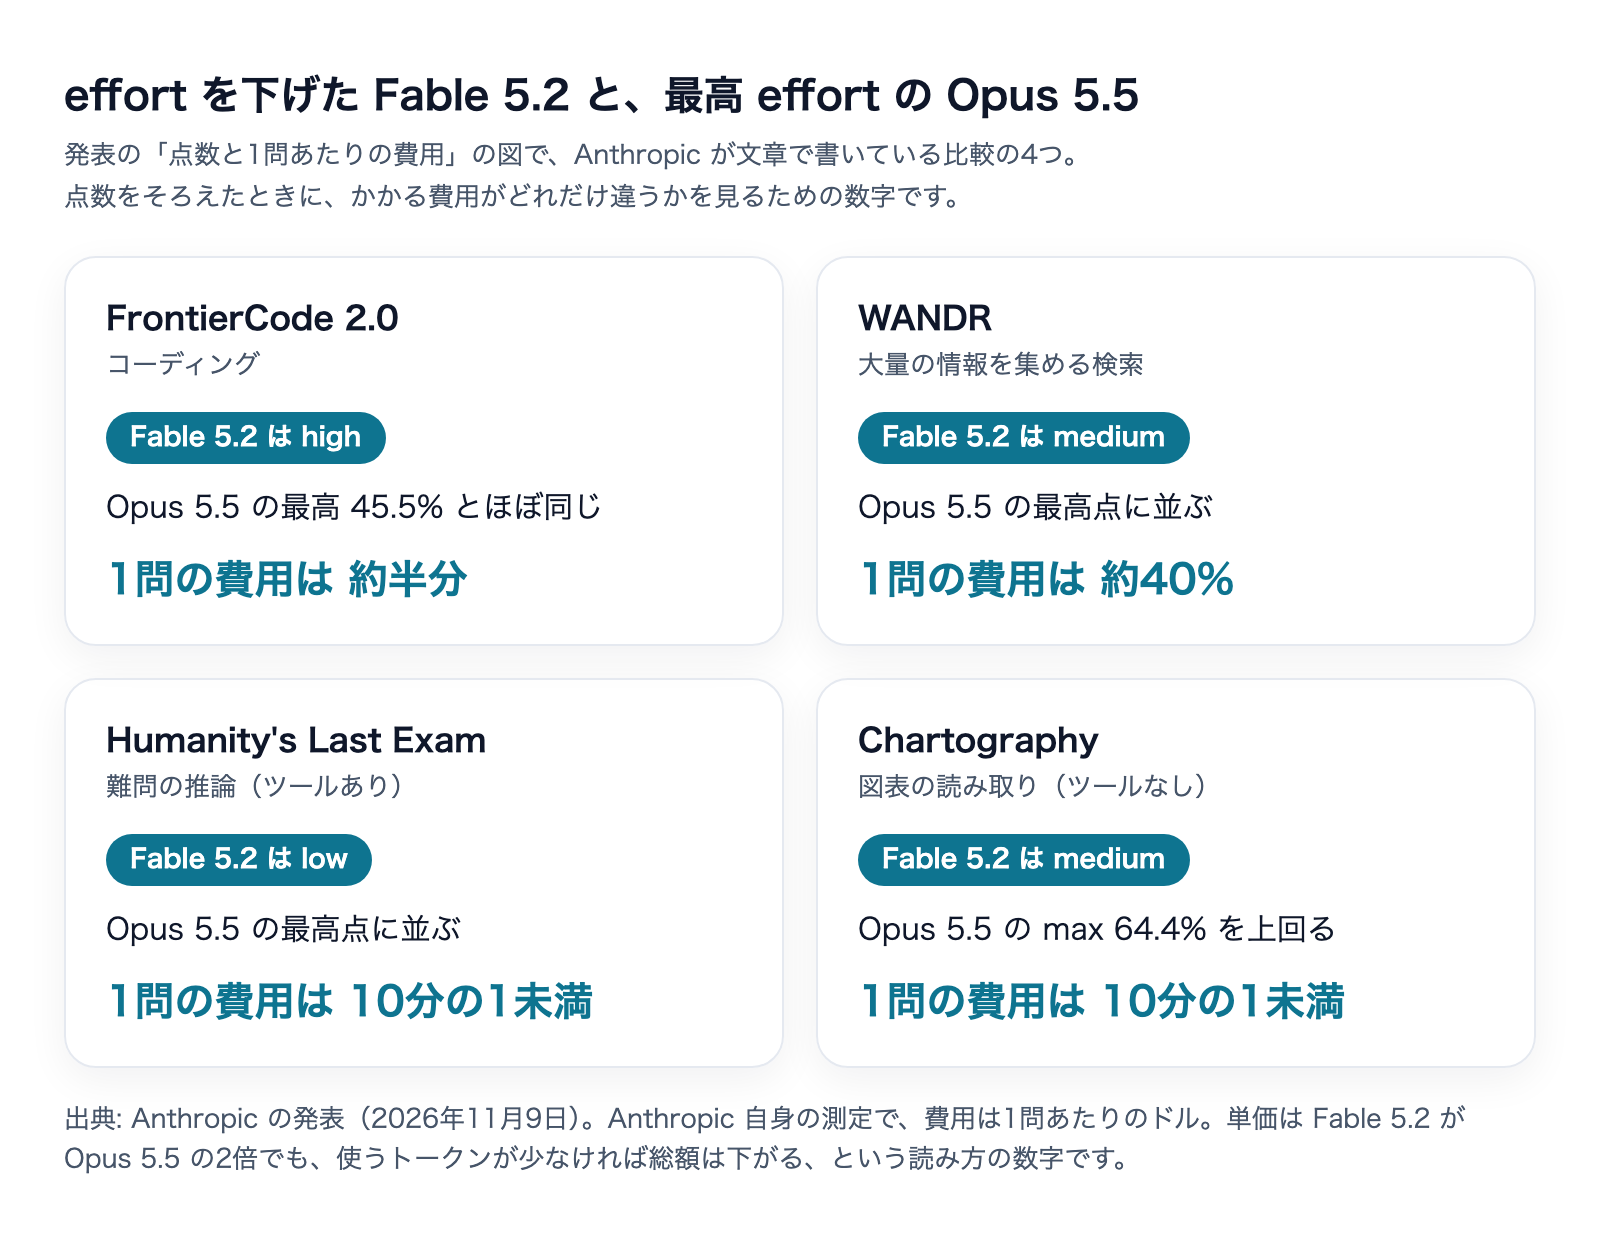
Fable 5.2の単価はOpus 5.5より高いのに、1問あたりの費用は下がる、という結果です。effortを下げると考える量(使うトークン)が減り、単価の差より減り方のほうが大きい、という読み方になります。FrontierCode 2.0では、GPT-6 Astraの最高点(42.8%)とほぼ同じ費用で、Fable 5.2のhighは45.3%とも書かれています。
私がこの比較を重く見るのは、点数の差より実際の判断に近いからです。業務でAIを使うとき、問いは「どちらが賢いか」より「同じ仕事をいくらで終えられるか」になります。表の最高値どうしの比較は、お金と時間をいくらでもかけてよい場合の上限の話です。
ただし、これもAnthropic自身の測定で、費用は試験の問題で測ったものです。自分の仕事で同じ比率になるかは分かりません。どの仕事をOpus 5.5とFable 5.2のどちらに任せるかの具体的な分け方は、こちらで扱っています。
読み方4:同じモデルでも、発表の表が変わると数字が変わる
今回の表を、2026年9月のOpus 5.5の発表の表と並べると、同じモデルの数字が変わっている行があります。
項目 | 9月のOpus 5.5の発表 | 11月のFable 5.2の発表 |
|---|---|---|
AutomationBench・Opus 5.5 | 40.0% | 42.5% |
Terminal-Bench-Science 0.1・GPT-6 Astra | 64.6% | 68.1% |
OSWorld 2.1・Opus 5.5 | 81.8%(一部) | 87.2%(オフライン版の一部) |
Chartography・Opus 5.5 | 89.0%(ツールあり) | 64.4%(ツールなし) |
FrontierCode・Opus 5.5 | 54.4%(v1.1) | 45.5%(2.0) |
下の3行は、条件や試験の版が変わっているので、数字が違うのは当然です。OSWorldは測る範囲が「オフライン版の一部」になり、Chartographyはツールの有無が逆になり、FrontierCodeは版が2.0に上がっています。版や条件が変われば、問題も採点も変わります。
上の2行は、試験の名前も版も同じなのに数字が違います。9月の表では、AutomationBenchは外部の会社(Zapier)が測った値で、安全対策で止められた分を失敗として数えた、という注記がありました。今回の表にはその注記がありません。数字が変わった理由は、発表のページからは分かりません。
この表から引き出せる教訓は1つで、数字を比べるのは同じ表の中だけにすることです。9月の記事で見たOpus 5.5の点数と、今回のFable 5.2の点数を並べて「何ポイント差」と読むのは成り立ちません。今回の表の中のOpus 5.5の列と比べれば、同じ版・同じ条件の数字です。
Anthropic自身も、9月のOpus 5.5の発表で「この水準の能力では、ベンチマークの差は実際の違いの手がかりとして当てにならなくなってきた」と書き、自社の利用ではOpus 5.5とFable 5.1の差は点数ほど大きくない、と認めていました。
読み方5:すべてAnthropicの発表値で、各社の表は自社が強く出る
この表の数字は、比較相手の分も含めて、すべてAnthropicが発表したものです。TechCrunchとMacRumorsはどちらも発表と同じ11月9日に記事を出していますが、伝えているのは発表の内容で、第三者が測り直した数字ではありません。TechCrunchは、Fable 5.2とMythos 5.2の性能の主張がAnthropic自身の発表と System Card(モデルの説明書)によるものだと明記しています。2026年11月10日時点で、Artificial Analysisのような独立した評価の機関がFable 5.2を測った数字は、私が探した範囲では見つかりませんでした。
各社の発表の表は、どれも自社のモデルが強く出る項目と条件で作られます。9月のOpenAIのGPT-6 Astraの発表の表では、Fable 5.1と比べた多くの項目でAstraが上でした。同じHumanity's Last ExamのFable 5.1の数字も、Anthropicの表では65.6%、OpenAIの表では65.0%と、測った側によって違います。どちらかが間違っているという話ではなく、測る条件が少しずつ違う、ということです。
もう1つ、今回の発表には珍しい但し書きがあります。Anthropicは、Fable 5.2とMythos 5.2が「試験されているのではないか」と口にする回数が、これまでのどのモデルより多いと書いています。これは安全性の評価についての話ですが、試験の場と実際の仕事で振る舞いが変わりうる、という意味では、能力の数字を読むときにも頭の片隅に置いておく価値があります。
手元で測った:同じ問題をFable 5.2とOpus 5.5に3回ずつ
表の数字を自分の環境で確かめる最小の方法として、2026年11月10日に、答えが1つに決まる問題をFable 5.2とOpus 5.5に3回ずつ解かせました。条件は次のとおりです。
- 道具:Claude Code 2.1.296(
claude -p)。モデルは--model claude-fable-5-2と--model claude-opus-5-5 - effort:どちらも
--effort medium(Claude Codeの既定と同じ) - 問題:「1から10000までの整数のうち、各桁の数字の和が素数になるものはいくつか」。ツールは使わせず、答えの数字だけを最後に書かせる(正解は3010)
モデル | 正解 | 出力トークン(3回) | 中央値 | 処理時間(3回) |
|---|---|---|---|---|
Fable 5.2 | 3回とも正解 | 823/863/905 | 863 | 7.8秒/7.9秒/9.0秒 |
Opus 5.5 | 3回とも正解 | 998/1,050/1,137 | 1,050 | 9.5秒/9.5秒/10.6秒 |
この問題では、Fable 5.2のほうが3回とも出力が少なく、速く終わりました。出力トークンの中央値で約2割少ない計算です。「mediumでも少ないトークンで解ける」という発表の方向とは合っています。
ただし、言えるのはここまでです。易しい問題で両方とも全問正解なので、賢さの差は測れていません。回数も3回ずつで、問題も1種類です。また、使ったClaude Codeは Fable 5.2 が追加される前の版で、「このモデルを知らない」という警告が出たうえで動いています。費用は単価が違う(出力の単価はFable 5.2がOpus 5.5の2倍)ので、トークンが2割少なくても、この問題では1回あたりの費用はFable 5.2のほうが高くなります。単価と月の費用は料金の記事にまとめています。
自分の仕事で測る手順:表は「どこで試すか」を決める材料
ここまでをまとめると、ベンチマークの表は「どの仕事で試す価値があるか」を決める材料で、乗り換えの判断は自分の仕事で測って決める、という順番になります。手順は次の5つです。
- 表の中で自分の仕事に近い行を選ぶ:開発ならFrontierCode・FrontierSWE、資料づくりならAA-Briefcase、調べものならWANDR、画面操作ならOSWorld
- その行に当たる実際の作業を1〜3個選ぶ:正しいかどうかを自分で判定できる作業にする
- 今のモデルとFable 5.2に、同じ作業を3回以上ずつ投げる:1回だけだと、たまたまの差で結論が逆になりうる
- effortを下げた条件も入れる:発表の費用の比較はlow〜highのFable 5.2で出ている。最高effortどうしだけを比べると、いちばん効く使い方を見落とす
- 正しさ・出力トークン・時間を記録し、中央値と幅で見る:トークンに単価を掛ければ1回あたりの費用になる
Claude Codeを使っているなら、この計測自体をClaude Codeに頼めます。たとえば「この作業を claude -p で、claude-opus-5-5 と claude-fable-5-2 に3回ずつ投げて。--output-format json で結果を取り、正しさ・出力トークン・処理時間を表にして中央値も出して。Fable 5.2はlowとmediumの2条件で」と頼めば十分です。
Fable 5.2をClaude Codeで指定する方法と、古い版での注意点は、こちらにまとめています。
まとめ:Fable 5.2のベンチマークは「effortを下げたときの費用」で読む
Claude Fable 5.2のベンチマークを読むときの要点を、もう一度まとめます。
- Fable 5.2自身の数字がある11項目のうち9項目で表の最高値。AutomationBenchはGemini 4 Carbon、AA-BriefcaseのEloはOpus 5.5が上
- サイバーセキュリティとたんぱく質の設計の3行はMythos 5.2の数字で、一般に使えるFable 5.2の成績ではない
- 表の数字は最高effortの値。Claude Codeの既定はmediumで、表と同じ条件ではない
- 実務の判断に近いのは、effortを下げたFable 5.2が最高effortのOpus 5.5に並ぶときの費用(約半分〜10分の1未満)
- 前の発表の表とは、同じモデルでも数字が変わる行がある。比べるのは同じ表の中だけ
- すべてAnthropicの発表値で、2026年11月10日時点で第三者の測り直しは見つからない
株式会社Fyveでは、新しいモデルが出るたびに、表の数字をそのまま信じるのではなく、自分たちの仕事で測ってから使い方を決めています。Fable 5.2も、まずは自分の作業1つで、effortを下げた条件から試してみてください。
発表の原文:Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic)
Fable 5、賢いけど高い。を解決する。

最上位モデルを、コストを抑えて使いこなす設計図(全29ページ)
Fable 5は強力ですが、何でも任せるとトークンをただ溶かします。1人会社を丸ごとAIで回している実運用から、「どの仕事をFable 5に任せ、どれを安いモデルに回すか」の配置を全部公開します。
- Fable 5に任せる仕事/安いモデルに回す仕事の線引き
- モデル別トークン消費の実測比較
- そのままコピペできるCLAUDE.md設定
- 1人会社の全業務×モデル対応表
メールアドレス登録で他にも様々な資料を閲覧できます
 +10
PDF 19点・合計499ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。