GPT-6.2のeffort|Astra・Solの段の選び方

「GPT-6.2 の effort は low から ultra まであるが、どれを選べばいいのか」「Codex で何も指定しないと、どの段で動いているのか」「xhigh や max に上げれば、答えは良くなるのか」——GPT-6.2 Astra と Sol に乗り換えるとき、この迷いは必ず出てきます。
結論から言うと、GPT-6.2 の effort は、普段の仕事なら medium を明示して始め、「コードを実際に動かして確かめてほしい」仕事だけ high に上げるのが基本です。xhigh・max・ultra は、評価で差が見えた仕事だけに使います。私たちが同じ不具合探しを8通りの組み合わせで解かせたところ、見つけた不具合はすべて同じで、xhigh 以上はトークンが medium の4.5〜5.6倍に増えました。
株式会社Fyveは、中小企業の AI 導入を支援しながら、自社でも Codex を夜間の無人の仕事に毎日使っています。この記事では、OpenAI の公式のドキュメントで確かめた各段の意味と、発表の当日(日本時間の2026年11月18日)に私たちの環境で測った結果をもとに、GPT-6.2 Astra・Sol の effort の選び方を整理します。
GPT-6.2 の effort は low から ultra までの6段
effort(推論の強さ)は、モデルが答えを返す前に、内部でどれだけ考えるかを決める設定です。強くするほど難しい問題に強くなる代わりに、答えが返るまでの時間と、使うトークンが増えます。
GPT-6.2 Astra と GPT-6.2 Sol は、OpenAI が2026年11月17日(米国時間)に発表したモデルです。Astra は最上位、Sol は日常の仕事向けという位置づけで、ChatGPT Work・Codex・API で同時に使えるようになりました。effort の段は、どちらのモデルも同じです。
Codex CLI 0.169.0 が OpenAI から受け取って手元に保存するモデルの一覧(2026年11月18日時点)では、2つのモデルとも次の6段が並び、既定は low でした。説明の列は、OpenAI の推論のガイド(Reasoning models)と、一覧に付いている英語の説明を、私たちが日本語に置き換えたものです。
段 | OpenAI の説明 | 向いている仕事 |
|---|---|---|
low(Codex の既定) | 軽めに考えて速く返す。ツールを何度も呼ぶ仕事で、速さと費用を優先する | 決まった形の修正・読むだけで済む確認・量の多い仕事 |
medium | 速さと考える深さの釣り合いを取る。多くの仕事の既定として勧められている | 迷ったときの出発点・普段のコーディング |
high | 難しい推論や込み入ったデバッグのための段 | 失敗すると高くつく仕事・動かして確かめてほしい仕事 |
xhigh | 深い調査や長く走らせる仕事のための段。評価で効果がはっきり見えたときだけ使うよう書かれている | high で足りないことが分かった仕事 |
max | いちばん複雑な課題のための最大の推論 | xhigh でも足りなかった仕事 |
ultra | 最大の推論に加えて、作業を自動で振り分ける | 分けて並べて進められる大きな仕事 |
押さえておきたいのは、この6段が「性能を切り替えるスイッチ」ではなく、「時間と費用をどこまで払うかのダイヤル」だという点です。OpenAI のガイドも、effort を品質を取り戻す主な手段ではなく、調整のつまみとして扱うよう勧めています。指示の書き方や渡す情報が悪いまま段だけ上げても、答えはあまり良くなりません。
none は使えない
前の世代の GPT-6.1 Terra には、考えずに即答させる none の段がありました。GPT-6.2 では Astra・Sol ともに使えません。OpenAI のモデルページ(2026年11月18日時点)には、2つのモデルとも「API は reasoning effort を none にしたリクエストを拒否する」と書かれています。
分類や決まった形への変換のように、考えなくてよい大量の仕事を none で安く回していた場合は、GPT-6.2 に替えるとそのままでは動きません。その仕事は low で回すか、none が使える Terra に残すかを決めてください。Terra の段の選び方は、前の世代で次の記事にまとめました。
使う場所で、段の名前と既定が違う
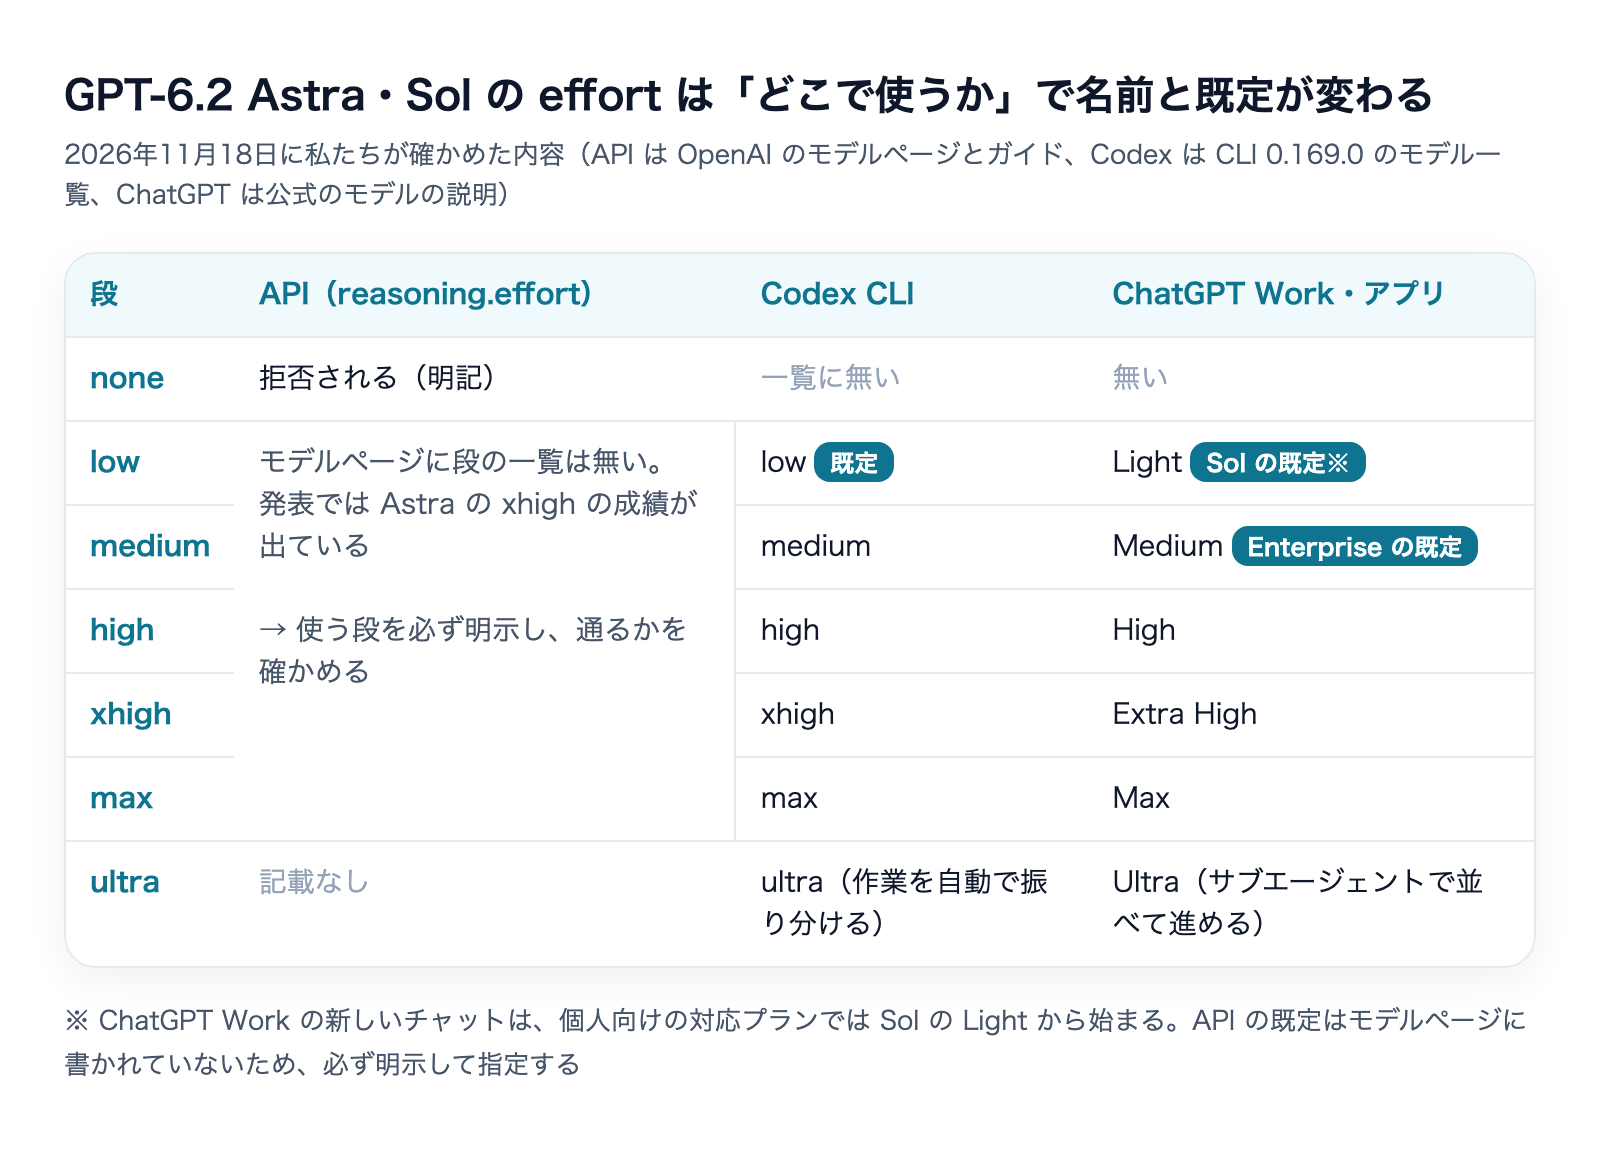
GPT-6.2 の effort がややこしいのは、API・Codex・ChatGPT Work で、段の名前と「何も指定しないときの段」が少しずつ違うためです。私たちが2026年11月18日に確かめた内容を、1枚にまとめました。
ChatGPT Work では Light から Ultra の名前になる
ChatGPT の公式のモデルの説明では、段は Light・Medium・High・Extra High・Max・Ultra の名前で並びます。Light はデスクトップのアプリ・Work の Web 版・IDE の拡張機能での呼び名で、CLI では Low と表示されます。中身は同じ段です。
既定については、Astra・Sol とも「使っている画面が選んだ段から始める」とされています。Work の新しいチャットは、個人向けの対応プランでは Sol の Light から、モデルを有効にした Enterprise のワークスペースでは Medium から始まります。同じ Sol でも、個人の契約と会社の契約で、最初に考える量が違うということです。
Max がデスクトップのアプリに出てこないときは、アプリの設定を確かめるよう案内されています。Ultra はスライダーに出てこないことがあり、その場合は Settings の Configuration にある「Ultra in model picker slider」を有効にします。
Codex は何も指定しないと、表示が「none」になった
Codex CLI 0.169.0 で、モデルだけを -m gpt-6.2-sol と指定し、段を指定せずに動かしたところ、起動時の表示は reasoning effort: none でした。それでもエラーにはならず、答えは普通に返ってきています。モデルの一覧の既定は low なので、この表示は「CLI が段を送っていない」という意味だと私たちは読んでいますが、実際にどの段で考えたのかは、この表示からは分かりません。
実務での結論は単純で、段は毎回明示してください。設定ファイルに書くか、-c model_reasoning_effort="medium" のように起動時に渡せば、表示もその段になります。Codex での書き方(設定ファイル・プロファイル・Ultrafast の指定)は、次の記事にまとめています。この記事では書き方ではなく、どの段を選ぶかを扱います。
API の既定は、モデルページに書かれていない
API については、2つのモデルのページにも推論のガイドにも、GPT-6.2 の既定の段と、選べる段の一覧が書かれていません(2026年11月18日時点)。ガイドが既定を明記しているのは、GPT-6.1 Sol や GPT-6 Luna などの medium です。発表では Astra の xhigh の成績が出ているので、xhigh が使えることは分かりますが、それ以外の段は、使う前に自分のリクエストで通るかを確かめてください。
前の世代から API の既定に頼って書いていたコードは、GPT-6.2 に替えるときに、段を明示する形へ書き換えておくのが安全です。

8通りの組み合わせで、同じ不具合探しを解かせた
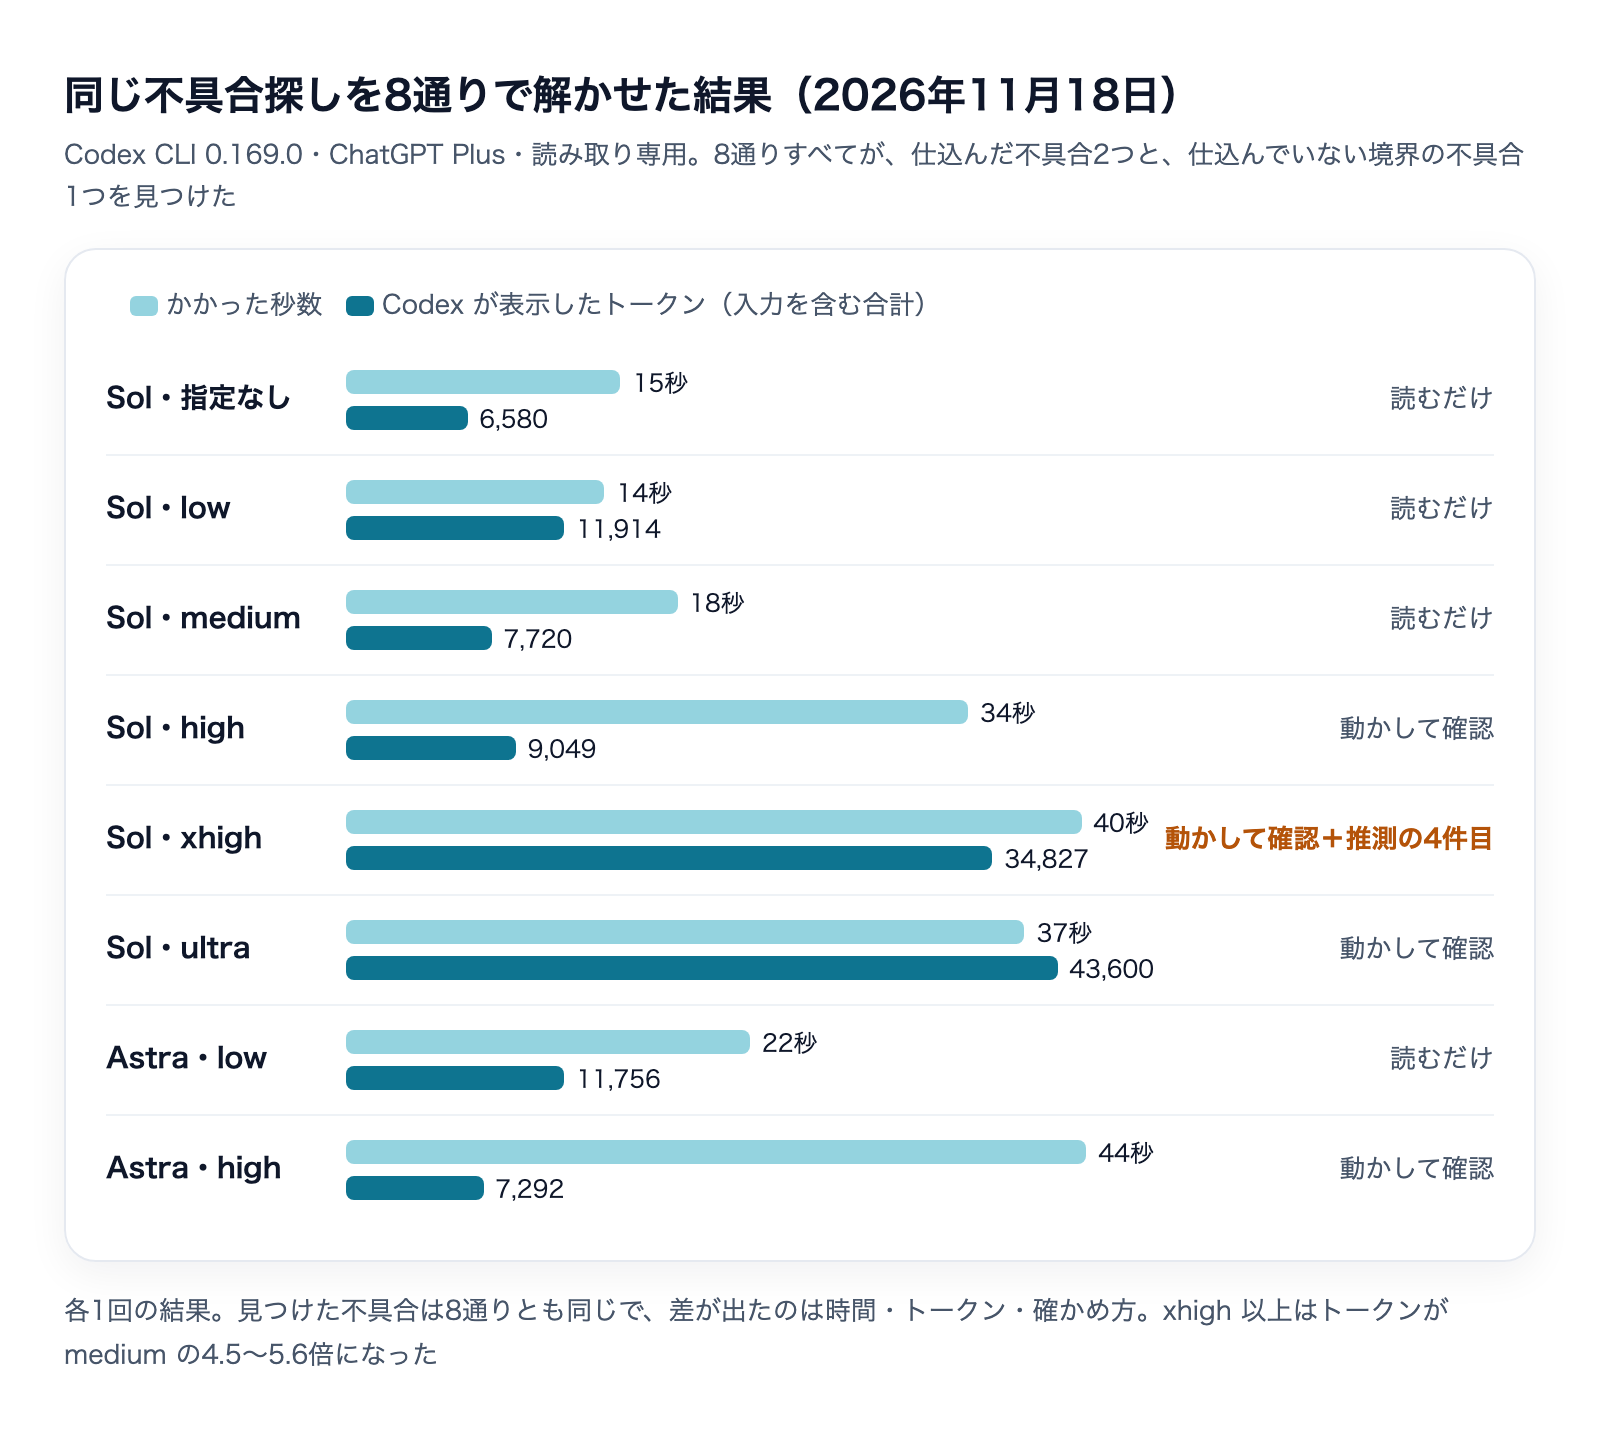
ドキュメントの説明だけでは、段ごとの差がどのくらいかは分かりません。そこで発表の当日、私たちの環境で、答えの決まっている問題を Sol の6通りと Astra の2通り、合わせて8通りで解かせました。
- 道具:Codex CLI 0.169.0(ChatGPT Plus のアカウントでサインイン)の
codex exec。読み取り専用で動かし、段は-c model_reasoning_effortで指定 - 問題:営業日の計算をする Python の小さなファイル(関数3つ・27行)を渡し、「docstring と実装が食い違う不具合をすべて挙げる。ファイルは書き換えない」と依頼
- 仕込んだ不具合:①0営業日後を求めたとき、開始日が土日でも次の月曜に進まない ②月末までの営業日数を数えるとき、土曜も営業日に数えてしまう
- 時間:コマンドを打ってから返事が終わるまで(CLI の起動を含む)。トークンは Codex が最後に表示する合計(入力を含む)
モデル・段 | かかった時間 | トークン | 見つけた不具合 | 確かめ方 |
|---|---|---|---|---|
Sol・指定なし | 15秒 | 6,580 | 3つ | 読むだけ |
Sol・low | 14秒 | 11,914 | 3つ | 読むだけ |
Sol・medium | 18秒 | 7,720 | 3つ | 読むだけ |
Sol・high | 34秒 | 9,049 | 3つ | Python を動かして確認 |
Sol・xhigh | 40秒 | 34,827 | 3つ+推測の1件 | Python を動かして確認 |
Sol・ultra | 37秒 | 43,600 | 3つ | Python を動かして確認 |
Astra・low | 22秒 | 11,756 | 3つ | 読むだけ |
Astra・high | 44秒 | 7,292 | 3つ | Python を動かして確認 |
「3つ」の内訳は、仕込んだ2つと、仕込んでいなかった1つです。月末を求める関数は、西暦9999年12月の日付を渡すと、翌年の日付を作ろうとして Python の日付の上限を超え、エラーで止まります。私たちは意図して入れていませんでしたが、実際に起きる不具合で、8通りすべてがこれを見つけました。
分かったこと1:この大きさの仕事では、段で答えは変わらなかった
見つけた不具合は、Sol の low でも Astra の high でも同じでした。27行のファイルを読んで食い違いを探す程度の仕事なら、Codex の既定の low で十分に足ります。段を上げて得られたのは、正しさではなく、次に書く「確かめ方」の違いだけでした。
Sol と Astra を比べた記事でも、易しい問題では Sol を medium から high に上げても答えは同じで、時間が5秒延びただけでした。小さな仕事で段を上げても、払う時間と使用量が増えるだけになりやすいということです。
分かったこと2:high から、自分でコードを動かして確かめ始めた
low と medium は、ファイルを読んで答えを書いただけでした。high・xhigh・ultra と Astra の high は、どれも答える前に Python を自分で動かし、土日の日付や9999年12月を実際に渡して、エラーや誤った値が出ることを確かめてから答えています。
この差は、読む側にとって意味があります。読むだけの答えは「たぶんこうなる」という推論で、動かした答えは「こう渡すとこうなった」という記録です。レビューの結果をそのまま人に渡す仕事や、外れたときに手戻りが大きい仕事では、high に上げる理由になります。時間は Sol で18秒から34秒に延びましたが、トークンは7,720から9,049と2割ほどしか増えていません。
分かったこと3:xhigh は、頼んでいない推測を1件足した
xhigh だけが4件目として「負の数を渡すと、さかのぼるべきところで開始日をそのまま返す」を挙げました。docstring には負の数の扱いが書かれておらず、これは不具合というより「こう解釈するなら不具合」という推測です。答えの中でも「営業日のずれとして解釈すると」と前置きしていました。
考える量を増やすと、書かれていない仕様まで推し量って指摘が増えることがあります。それが役に立つ場面もありますが、レビューの指摘をそのまま課題として起こす使い方では、確かめる手間が増えます。xhigh 以上を常用しないほうがよい理由の1つです。
分かったこと4:ultra は、小さな仕事では分けなかった
ultra は「作業を自動で振り分ける」段ですが、この問題では仕事を分けた様子は記録に残っておらず、1本の流れで読んで、動かして、答えていました。それでもトークンは43,600と8通りで最も多く、medium の約5.6倍です。ultra は、分けて並べて進められる大きな仕事のための段で、小さな仕事に使うと考える量だけが増えると見てよさそうです。
なお、Sol の low(11,914)が medium(7,720)よりトークンが多いなど、段の順に並ばない結果も出ています。各1回の試験なので、細かな大小ではなく、xhigh 以上で大きく跳ねるという傾向だけを読んでください。
GPT-6.2 の effort の選び方
ドキュメントと実測を合わせると、GPT-6.2 の段は次のように選ぶのが私たちの結論です。
こんなとき | モデルと段 | 理由 |
|---|---|---|
普段のコーディング・迷ったとき | Sol・medium | ガイドが多くの仕事の既定として勧める段。Codex の既定の low より1段上で、時間の増え方は小さい |
読むだけで済む小さな修正・量の多い仕事 | Sol・low | 今回の試験では low でも見つけた不具合は同じだった |
レビューの結果を人に渡す・外れると手戻りが大きい | Sol・high | 自分で動かして確かめてから答えるようになる。トークンの増え方は2割ほど |
Sol の high で失敗が見えた | Astra・high、または Sol・xhigh | 段を上げるか、モデルを替えるかを、同じ仕事で比べて決める |
長く走らせる調査・評価で差が見えた仕事 | xhigh・max | ガイドも、評価で効果が見えたときだけ使うよう書いている |
分けて並べて進められる大きな仕事 | ultra | 小さな仕事では分けず、トークンだけが増えた |
段を上げるか、Astra に替えるか
Sol の high で足りないときは、Sol の段を上げるか、Astra に替えるかの2つの道があります。OpenAI の発表では、Agents' Last Exam という試験で、GPT-6.2 Astra の xhigh が前の世代の GPT-6 Astra の max を5.2ポイント上回り、1つの課題あたりの費用は半分未満だったとされています。新しいモデルの低い段が、古いモデルの高い段を上回ることがある、ということです。
一方で、API の単価は Astra が Sol の4倍です。今回の試験でも、Astra の high は Sol の high より10秒遅く、答えは同じでした。私たちは、まず Sol で段を上げ、それでも外れる仕事だけ Astra に回す順にしています。モデルの使い分けそのものは、次の記事で詳しく比べています。
xhigh と max の違い
OpenAI のガイドでは、xhigh は深い調査や長く走らせる非同期の仕事のための段で、max は「いちばん複雑な課題のための最大の推論」です。ChatGPT の説明では、Max は「選んだモデルに、1つの課題についてより長く考える時間を与える」段とされています。
ガイドは、今 xhigh を使っているなら max で結果が良くなるかを試すよう勧めています。逆に言えば、max は xhigh で足りないと分かってから試す段で、最初から選ぶ段ではありません。今回の小さな問題では max は試していませんが、xhigh の時点で答えは変わらず、トークンだけが増えていました。
API で effort を指定するとき
API で使う場合は、Responses API では reasoning.effort、Chat Completions では reasoning_effort で段を指定します。OpenAI のガイドは推論のモデルには Responses API を勧めています。
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "medium"},
    input="次の関数の docstring と実装の食い違いを挙げてください: ..."
)
print(response.output_text)
print(response.usage.output_tokens_details.reasoning_tokens)先に書いたとおり、"none" を渡すと拒否されます。既定もモデルページに書かれていないので、reasoning は省略せずに書いてください。ガイドによると、GPT-6 以降の対応するモデルでは、会話の途中で configuration_update という項目を送って段を変えることもできます。
推論のトークンは出力として数えられる
最後の行の reasoning_tokens が、その呼び出しで内部の推論に使ったトークン数です。中身は返ってきませんが、OpenAI のガイドによると、推論のトークンは出力のトークンとして課金されます。出力の単価は、モデルページ(2026年11月18日時点・Standard)で100万トークンあたり、Sol が10ドル、Astra が40ドルです。
計算を簡単にすると、推論のトークンが1回あたり1万増えるごとに、Sol で0.1ドル、Astra で0.4ドル増えます。今回の試験の xhigh のように、段を1つ上げただけでトークンが数倍になることがあるので、量の多い仕事では段の選び方がそのまま月の費用の差になります。単価や速さの設定ごとの倍率は変わることがあるので、使う前に OpenAI のモデルページで最新の値を確かめてください。
出力の上限を小さくしすぎない
段を上げるときに見落としやすいのが、出力の上限(max_output_tokens)です。ガイドによると、この上限には目に見える答えだけでなく、推論のトークンも含まれます。上限に届くと、答えが出ないまま status が incomplete で返ることがあります。ガイドは、試し始めの段階では推論と答えの分として少なくとも25,000トークンを空けておくよう勧めています。
よくある質問
Codex で ultra を選んでも、サブエージェントが動かない
今回の試験のように仕事が小さいと、ultra でも分けずに1本で進めることがあります。分けて並べられる大きさの仕事で試してください。ChatGPT のデスクトップのアプリで Ultra が選べないときは、Settings の Configuration で「Ultra in model picker slider」を有効にします。
GPT-6.2 が段の一覧に出てこない
effort の前に、モデル自体がアカウントに届いていない可能性があります。私たちの環境では、発表の直後は Codex で GPT-6.2 を指定するとエラーになり、約40分後に届きました。確認の手順は次の記事にまとめています。
前の世代の max や ultra との違いは
Codex の一覧の6段(low〜ultra)と既定の low は、GPT-6.1 Terra のときと同じ並びです。ultra の考え方は、前の世代で出たときに次の記事で整理しました。

まとめ:GPT-6.2 の effort は medium を明示して始める
- GPT-6.2 Astra・Sol の effort は、Codex では low・medium・high・xhigh・max・ultra の6段で、既定は low。ChatGPT Work では Light〜Ultra の名前になる
- API は none を拒否する。既定の段はモデルページに書かれていないので、段は必ず明示する
- 小さな不具合探しでは、8通りすべてが同じ不具合を見つけた。high からは自分でコードを動かして確かめるようになった
- xhigh と ultra は、トークンが medium の4.5〜5.6倍。xhigh は頼んでいない推測の指摘を1件足した
- 普段は Sol の medium、外れると困る仕事は high、それでも足りない仕事だけ xhigh 以上か Astra に回す
段の選び方は、仕事の大きさと「外れたときにどれだけ困るか」で決まります。株式会社Fyveでは、自社の無人の仕事でも段を明示し、トークンの記録を見ながら仕事ごとに段を決めています。
Codexを使い始める前に、「絶対に」見直してほしい5つのこと
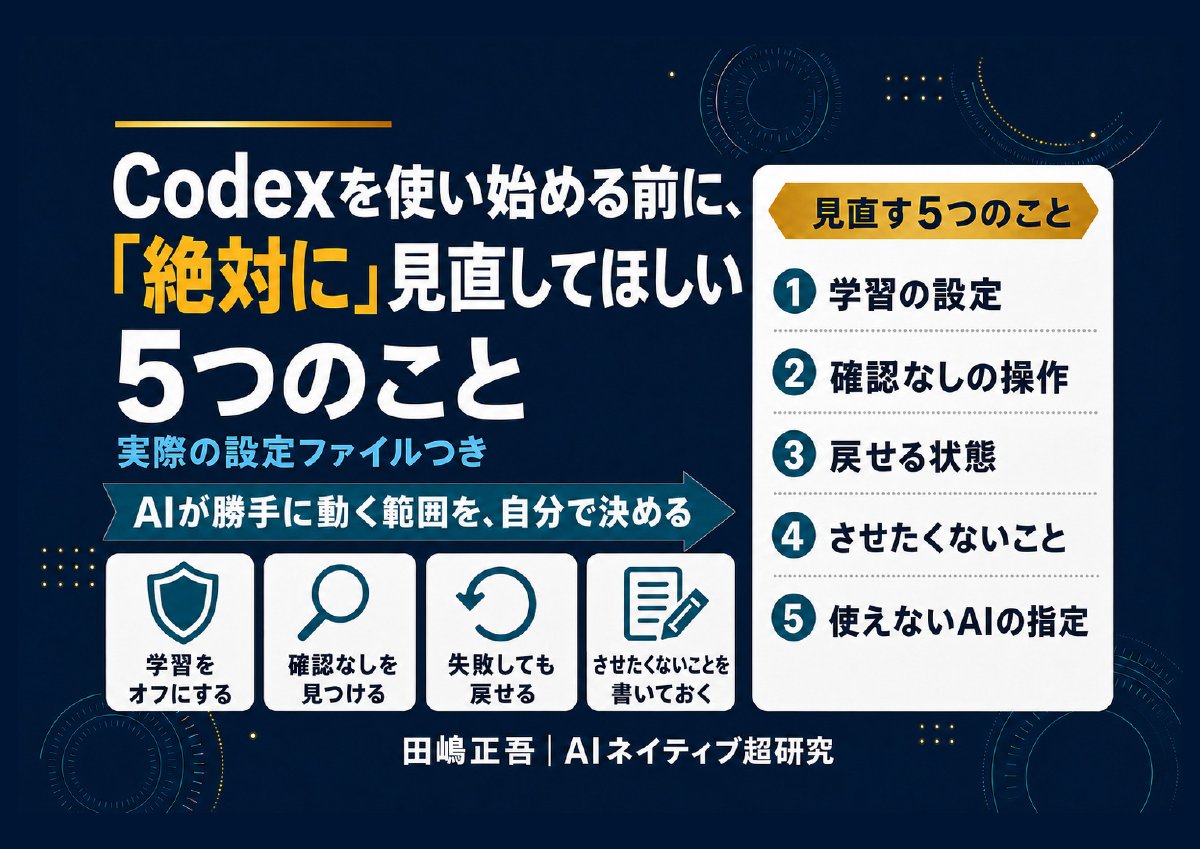
学習の設定・確認なしの操作・戻せる状態など。Codexにそのまま貼れる頼み方つき(全9ページ)
Codexは便利な一方で、設定ひとつで「聞かずに動く」ようになります。この資料を作るために自分の設定を開いたら、本番のデータベースを書き換える操作が、覚えのないうちに確認なしで動く状態になっていました。使い始める前に見直してほしい5つを、Codexにそのまま貼れる頼み方と一緒にまとめました。
- 仕事の画面や資料を、AIの学習に使わせない設定
- 取り返しのつかない操作が確認なしになっていないか、Codexに調べさせる頼み方
- AGENTS.mdのいちばん上に書く「絶対にしないこと」の例
- 失敗しても戻せる状態で始める方法と、使えなくなったAIの指定の直し方
メールアドレス登録で他にも様々な資料を閲覧できます








 +14
PDF 23点・合計550ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。