GPT-6.1 Terraのeffort|6段の選び方と実測

「GPT-6.1 Terra の effort は6段もあるが、どれを選べばいいのか」「none にすれば速くて安いなら、それで足りるのではないか」「max は本当に必要なのか」——新しいモデルの設定を決めるとき、この迷いは必ず出てきます。
結論から言うと、GPT-6.1 Terra の effort は迷ったら medium(API の既定)から始め、量が多い仕事だけ low に下げ、失敗が見えた仕事だけ high 以上に上げるのが基本です。none は分類や定型の変換のような「考えなくてよい仕事」専用で、数え上げのような少しでも考える仕事に使うと外れます。私たちの試験でも、none だけが3回とも誤答でした。
株式会社Fyveは、中小企業の AI 導入を支援しながら、自社でも Codex を夜間の無人の仕事に毎日使っています。この記事では、OpenAI の公式のドキュメントで確かめた各段の意味と、発表の翌日(2026年10月27日)に私たちの環境で6段を同じ問題で比べた結果をもとに、effort の使い分けを整理します。
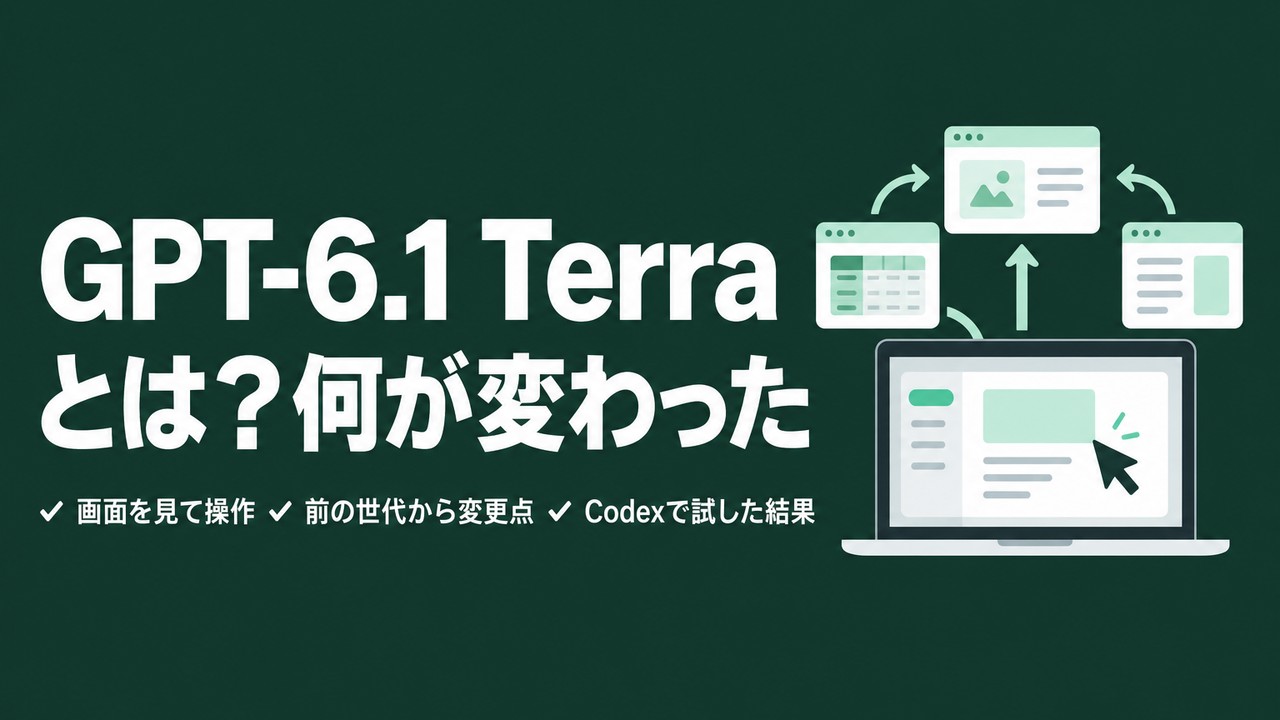
GPT-6.1 Terra の effort は none から max までの6段
effort(推論の強さ)は、モデルが答えを返す前に、内部でどれだけ考えるかを決める設定です。強くするほど難しい問題に強くなる代わりに、答えが返るまでの時間と、課金されるトークンが増えます。
GPT-6.1 Terra は、OpenAI が2026年10月26日(米国時間)に発表したモデルです。API のモデルページ(2026年10月27日時点)では、effort に選べる値は次の6つで、既定は medium です。
段 | OpenAI のドキュメントでの位置づけ | 向いている仕事 |
|---|---|---|
none | 考える工程が要らず、待ち時間を最優先する仕事 | 分類・音声の応答・決まった形への変換 |
low | 待ち時間を少しだけ増やして、効率よく考える | ツールを何度も呼ぶ仕事・費用を抑えたい大量の仕事 |
medium(既定) | 品質と安定性が大事なとき。多くの仕事の既定 | 迷ったときの出発点・普段の業務 |
high | 難しい推論・込み入ったデバッグ・深い計画 | 失敗すると高くつく仕事 |
xhigh | 深い調査・長く走らせるエージェントの仕事 | 評価で効果がはっきり見えた仕事だけ |
max | いちばん複雑な課題のための最大の推論 | xhigh で足りなかった仕事 |
「OpenAI のドキュメントでの位置づけ」の列は、OpenAI の推論のガイド(Reasoning models)に書かれている説明を、私たちが日本語に置き換えたものです。モデルのページ自体には、各段の説明は書かれていません。
押さえておきたいのは、この6段が「性能を切り替えるスイッチ」ではなく、「時間と費用をどこまで払うかのダイヤル」だという点です。OpenAI のガイドも、effort を品質を上げる主な手段としてではなく、調整のつまみとして扱うよう勧めています。指示の書き方や渡す情報が悪いまま effort だけ上げても、答えはあまり良くなりません。
Sol・Astra には無い none が使える
同じガイドによると、上位の GPT-6.1 Sol は none と minimal のどちらにも対応していません。GPT-6 Astra も、none を指定すると400のエラーを返します。つまり、OpenAI の上位の2つのモデルと違って、GPT-6.1 Terra では「考えずに即答させる」使い方ができます。
なお、OpenAI の開発者フォーラムでは、発表の当日に利用者から「Terra では none を指定すると temperature と top_p(答えのばらつきを調整する設定)が使える。Sol では使えなかった」という報告が出ています。私たちはこの点を手元で確かめていないので、使う前に自分の環境で試してください。
Sol との使い分けそのものは、次の記事で詳しく比べています。
API と Codex で、選べる段と既定が違う
effort の話がややこしくなるのは、API と Codex で中身が少し違うためです。私たちが2026年10月27日に確かめた内容を並べると、次のとおりです。
API(モデルページ) | Codex(モデルの一覧) | |
|---|---|---|
選べる段 | none・low・medium・high・xhigh・max | low・medium・high・xhigh・max・ultra |
既定 | medium | low |
none | あり | 一覧には無い(指定すると通る) |
ultra | 無い | あり(作業を自動で振り分ける) |
Codex の列は、Codex CLI 0.164.0 が OpenAI から受け取って手元に保存するモデルの一覧(~/.codex/models_cache.json)で確かめた値です。一覧の中で ultra だけは「Maximum reasoning with automatic task delegation(最大の推論に加えて、作業を自動で振り分ける)」と説明されていて、ほかの段とは性質が違います。考える量を増やす段ではなく、仕事を分けて並べて進める段だと読むのが自然です。ultra の考え方は、前の世代で出たときに次の記事で整理しました。
実務で効いてくるのは既定の違いです。API で「何も指定しなければ medium」に慣れていると、Codex で何も指定しないまま Terra に替えたとき、一覧の上では low で動くことになります。前の GPT-5.6 Terra は Codex の一覧でも既定が medium だったので、乗り換えただけで考える量が減る可能性があります。
Codex の設定ファイルや -c での effort の書き方は、次の記事にまとめています。この記事では、書き方ではなく「どの段を選ぶか」を扱います。
API での effort の指定の仕方
API で使う場合は、Responses API と Chat Completions で書き方が違います。OpenAI のガイドは Responses API を勧めていて、ツール(Web 検索・ファイル検索・computer use など)を呼ばせるなら Responses API が必須です。
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "low"},
    input="次の問い合わせを「請求」「技術」「その他」に分けてください: ..."
)
print(response.output_text)
print(response.usage.output_tokens_details.reasoning_tokens)
Chat Completions では、同じ指定を reasoning_effort="low" という引数で渡します。どちらも、書かなければ既定の medium になります。
最後の行の reasoning_tokens が、その呼び出しで内部の推論に使ったトークン数です。effort を変えたときに費用がどれだけ動くかは、この数字を見るのがいちばん確実です。
max_output_tokens を小さくしすぎない
effort を上げるときに見落としやすいのが、出力の上限(max_output_tokens)です。OpenAI のガイドによると、この上限には目に見える答えだけでなく、内部の推論のトークンも含まれます。上限に届くと、答えが1文字も出ないまま status が incomplete、理由が max_output_tokens で返ることがあります。
ガイドは、試し始めの段階では推論と答えの分として少なくとも25,000トークンを空けておくよう勧めています。high 以上に上げたとたんに空の答えが返るようになったら、まずここを疑ってください。
effort を上げると費用はどう動くか
推論に使ったトークンは API の返事には中身が出てきませんが、OpenAI のガイドによると、出力のトークンとして課金されます。GPT-6.1 Terra の出力の単価は、モデルページ(2026年10月27日時点・Standard)で100万トークンあたり5ドルです。
計算を簡単にすると、推論のトークンが1回あたり1,000増えるごとに、0.005ドル増えます。1日1,000回呼ぶ仕事なら、1日あたり5ドルの差です。1回あたりの差は小さく見えても、量の多い仕事では effort の段がそのまま月の費用の差になります。
単価や割引の条件は変わることがあるので、使う前に OpenAI のモデルページで最新の値を確かめてください。料金の全体像は、この記事では扱いません。
6段を同じ問題で比べてみた(2026年10月27日)
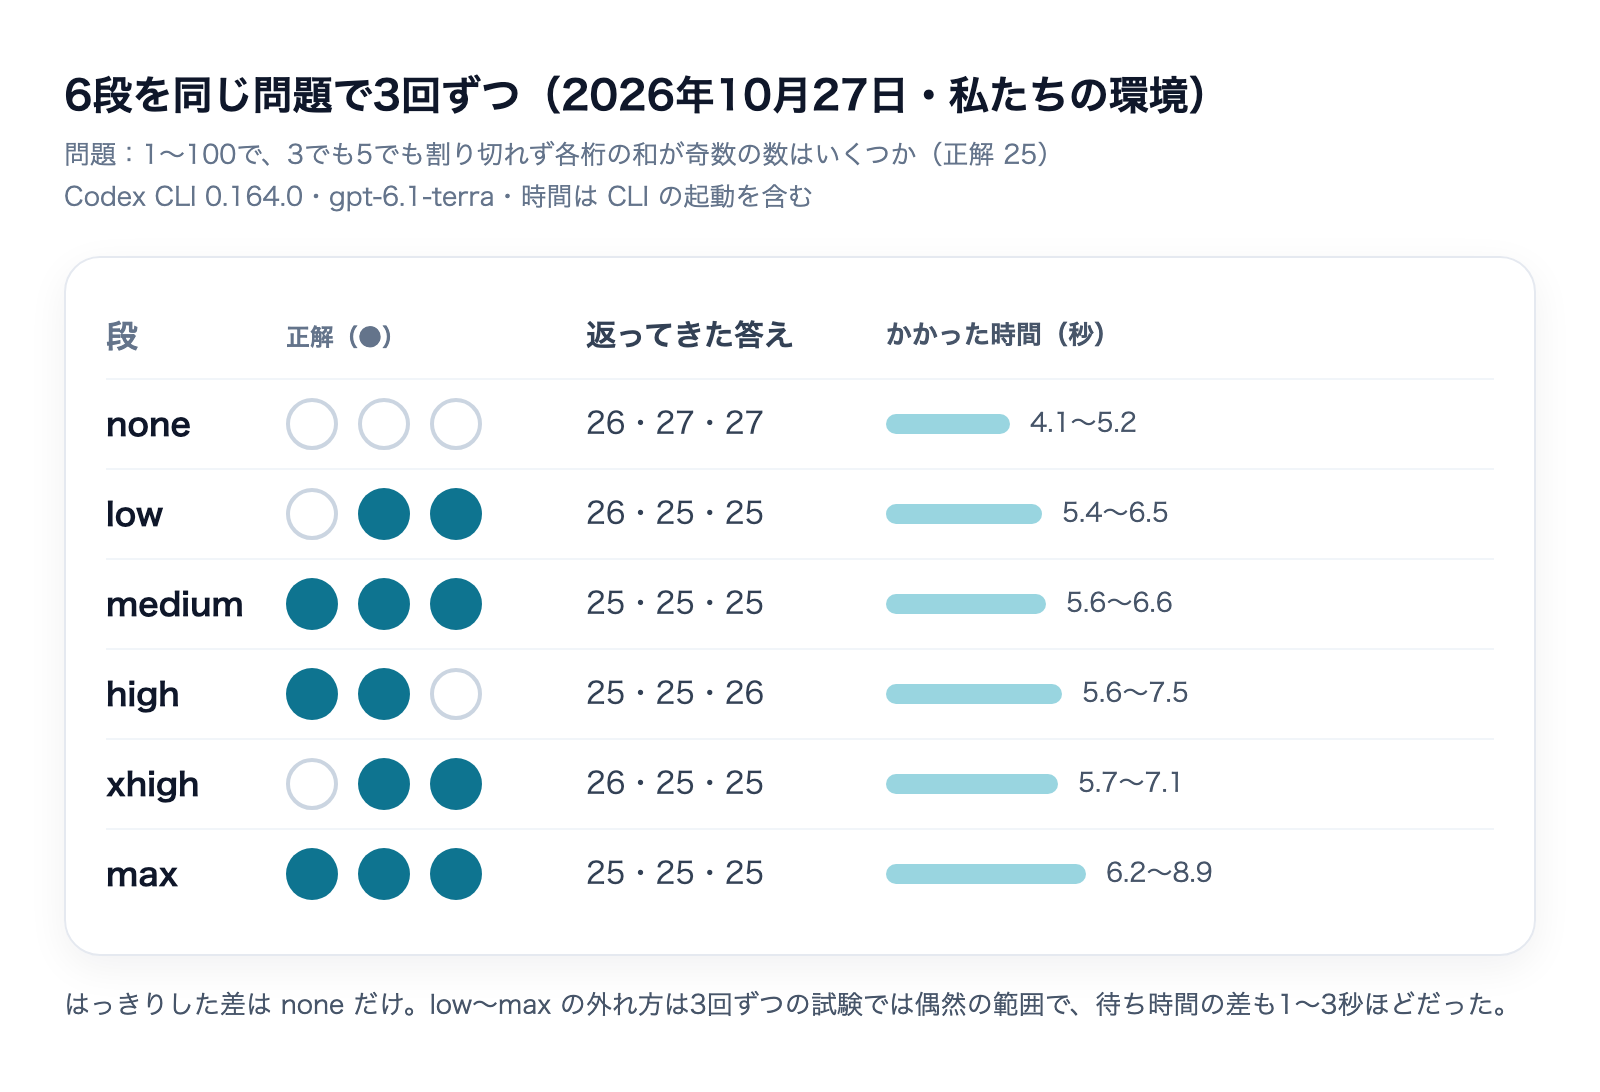
ドキュメントの説明だけでは、段ごとの差がどのくらいかは分かりません。そこで発表の翌日、私たちの環境で、答えが1つに決まる問題を6段それぞれ3回ずつ解かせました。
- 道具:Codex CLI 0.164.0(ChatGPT のアカウントでサインイン)の
codex exec。モデルはgpt-6.1-terra、段は-c model_reasoning_effortで指定 - 問題:「1から100までの整数のうち、3でも5でも割り切れず、各桁の数字の和が奇数になるものはいくつか。道具は使わず、答えの数字だけを返す」
- 正しい答え:25(プログラムで数えて確かめた値)
- 時間:コマンドを打ってから返事が終わるまで(CLI の起動を含む)
段 | 正解の回数 | 返ってきた答え | かかった時間 |
|---|---|---|---|
none | 0/3 | 26・27・27 | 4.1〜5.2秒 |
low | 2/3 | 26・25・25 | 5.4〜6.5秒 |
medium | 3/3 | 25・25・25 | 5.6〜6.6秒 |
high | 2/3 | 25・25・26 | 5.6〜7.5秒 |
xhigh | 2/3 | 26・25・25 | 5.7〜7.1秒 |
max | 3/3 | 25・25・25 | 6.2〜8.9秒 |
結果から言えること・言えないこと
はっきり言えるのは、none だけが3回とも外れたことです。数え上げは、100個の数を条件で1つずつふるい分ける、少しだけ考える仕事です。none は「考える工程が要らない仕事」向けという OpenAI の説明どおり、この程度の仕事でも答えがずれました。Codex のモデルの一覧には none が無いので、指定が効いているかを心配していましたが、none だけ答えが一貫して外れたことから、指定はサーバー側で効いていると私たちは見ています。
一方で、low から max の間では、段を上げるほど正解が増えるという並びにはなりませんでした。high と xhigh でも1回ずつ外れています。各段3回だけの試験なので、この差は偶然の範囲だと考えるのが妥当です。この程度の問題なら、low より上はどの段でもおおむね解ける、というのが私たちの読みです。
時間は、none がいちばん短く、max がいちばん長い傾向でしたが、差は1回あたり1〜3秒ほどでした。CLI の起動にかかる時間が大半を占めているので、短い仕事では段による待ち時間の差はほとんど体感できません。差が大きく出るのは、ツールを何度も呼ぶ長い仕事のはずですが、そこはまだ試していません。
なお、Codex が最後に表示する「tokens used」の数も記録しましたが、同じ段でも151から17,175まで大きくぶれました。Codex 自身の指示の分や、前の呼び出しの使い回し(キャッシュ)の分が混ざる数字なので、段ごとの推論の量の比較には使えません。推論の量を比べたいなら、API の reasoning_tokens を見てください。
仕事別:GPT-6.1 Terra の effort の選び方
ここまでのドキュメントの説明と試験の結果をまとめると、仕事ごとの選び方は次のようになります。
none:考えなくてよい仕事だけに使う
問い合わせを決まった分類に振り分ける、文章を決まった形の JSON に直す、音声で即答する、といった仕事が向いています。計算・数え上げ・条件の組み合わせを含む仕事には使わないでください。私たちの試験のように、答えがもっともらしいのに少しだけずれる、という外れ方をします。none を使うなら、答えを機械で検算できる仕事に限るのが安全です。
low:量の多い仕事と、ツールを何度も呼ぶ仕事
同じ種類の作業を何百回も流す仕事や、ツールを何度も呼びながら進める仕事では、まず low を試す価値があります。1回あたりの推論が少ないぶん、費用と待ち時間を抑えられます。ただし私たちの試験でも low は3回に1回外れたので、間違えたときに困る仕事なら、medium と比べてから決めてください。Codex で何も指定しないと、一覧の上ではこの low が既定になる点も忘れないでください。
medium:迷ったらここから始める
API の既定で、OpenAI のガイドも多くの仕事の既定として勧めている段です。私たちの試験でも3回とも正解でした。新しく GPT-6.1 Terra を組み込むときは、まず medium で動かし、そこから下げられるか、上げる必要があるかを見るのが近道です。
high:失敗すると高くつく仕事
込み入ったバグの原因探し、手順の多い計画づくり、間違えるとやり直しの手間が大きい仕事が向いています。OpenAI のガイドは、high を使う前に medium と high の両方を自分の仕事で比べるよう勧めています。差が見えないなら、medium のままで十分です。
xhigh と max:効果を確かめてから使う
xhigh は深い調査や長時間のエージェントの仕事向け、max はいちばん難しい課題向けです。OpenAI のガイドは、xhigh は評価で待ち時間と費用に見合う効果がはっきり見えたときだけ使い、max は xhigh を使っている仕事で試してみるよう書いています。「とりあえず max」は、多くの仕事では時間と費用を払うだけで終わります。
前の世代の GPT-6 Astra のときも、公式のベンチマークの数字は effort をいちばん高くした状態で測られたものだと書かれていました。発表の数字を見て「普段の設定でもこの性能が出る」と思わないことも大事です。Astra のときに整理した内容は、次の記事にあります。
自分の仕事で段を決める手順
effort の正解は仕事によって違うので、最後は自分の仕事で確かめるしかありません。私たちは次の順番で決めています。
- 答え合わせできる例を10〜20個そろえる:実際の仕事から、正しい答えが分かっている例を選ぶ。人が見て正しいと判断できるものでもよい
- medium で全部流す:正解の数・かかった時間・
reasoning_tokensを記録する - low(量が多い仕事なら none も)で同じ例を流す:正解の数が落ちなければ、下げた段を採用する
- medium で外れた例だけ high で流し直す:high で直るなら、その種類の仕事だけ high にする
- 決めた段を設定に明示する:既定に任せない。API なら呼び出しのコードに、Codex なら設定ファイルに書く
5番目を省かないことが大事です。既定の値は API と Codex で違ううえ、モデルが替わるたびに変わることがあります。私たちが Codex を無人の仕事に使うときも、effort は必ず設定ファイルに書くようにしています。書いておけば、起動時の表示にもその値が出るので、どの段で動いたかを後からログで確かめられます。
もう1つ、試験は1回ではなく、各段で少なくとも数回ずつ流してください。私たちの試験のように、同じ段・同じ問題でも答えがぶれることがあります。1回だけの比較で「high のほうが賢い」と決めると、偶然の差を拾うことになります。
まとめ:GPT-6.1 Terra の effort の決め方
- effort は none・low・medium・high・xhigh・max の6段(API)。既定は medium
- Codex の一覧では既定が low で、none の代わりに ultra(作業を自動で振り分ける段)がある
- none は上位の GPT-6.1 Sol・GPT-6 Astra では使えない段。ただし数え上げのような少し考える仕事では外れる(私たちの試験で3回とも誤答)
- low〜max の差は、短い問題では3回ずつの試験では見えなかった。待ち時間の差も1〜3秒ほど
- 推論のトークンは出力として課金される(100万トークンあたり5ドル・2026年10月27日時点)。量の多い仕事ほど段の差が費用に効く
- 上げるときは
max_output_tokensも一緒に見直す - 迷ったら medium から始め、自分の仕事の例で下げられるか・上げる必要があるかを確かめ、決めた段を必ず明示する
新しいモデルが出たときに大事なのは、いちばん強い設定を探すことより、自分の仕事にとって「ここまでで十分」という段を早く見つけることです。株式会社Fyveでは、こうした設定の決め方を自社の仕事で先に試し、その結果をもとに導入の支援をしています。
Codexを使い始める前に、「絶対に」見直してほしい5つのこと
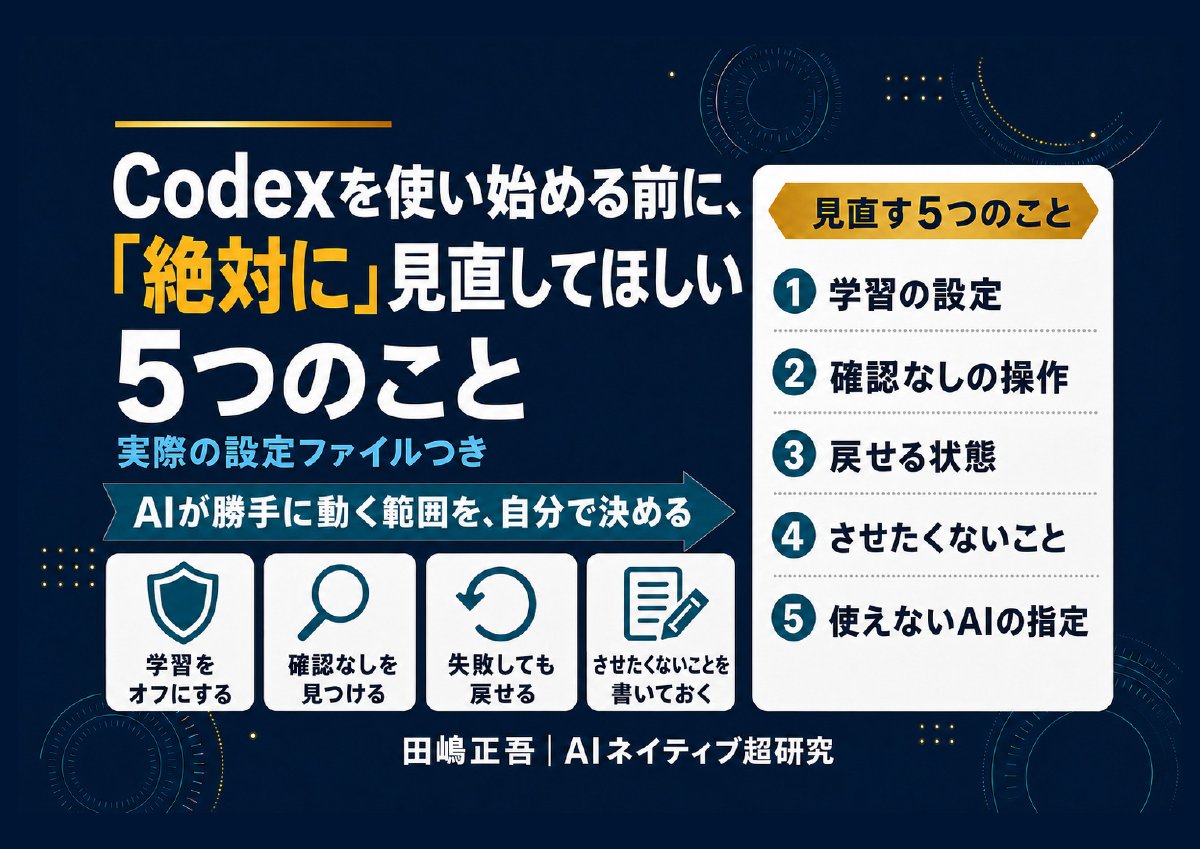
学習の設定・確認なしの操作・戻せる状態など。Codexにそのまま貼れる頼み方つき(全9ページ)
Codexは便利な一方で、設定ひとつで「聞かずに動く」ようになります。この資料を作るために自分の設定を開いたら、本番のデータベースを書き換える操作が、覚えのないうちに確認なしで動く状態になっていました。使い始める前に見直してほしい5つを、Codexにそのまま貼れる頼み方と一緒にまとめました。
- 仕事の画面や資料を、AIの学習に使わせない設定
- 取り返しのつかない操作が確認なしになっていないか、Codexに調べさせる頼み方
- AGENTS.mdのいちばん上に書く「絶対にしないこと」の例
- 失敗しても戻せる状態で始める方法と、使えなくなったAIの指定の直し方
メールアドレス登録で他にも様々な資料を閲覧できます
 +9
PDF 18点・合計468ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。