GPT-6 Astraの新しい思考レベル「max」とは

「思考レベルをどこまで上げればいいのか」「max にすれば一番賢いなら、いつも max にしておけばいいのではないか」——GPT-6 Astraを触り始めると、この迷いに必ずぶつかります。
結論から言うと、effort(思考の深さ)は性能を切り替えるスイッチというより、費用と応答時間を調整するダイヤルとして使うものです。GPT-6 Astraでは low・medium・high・xhigh に加えて、新たに max が加わりました。さらに手元のCodexで確認したところ、その上に ultra という段階が実在し、全6段階でした。日常の作業を毎回maxで回すと、費用も待ち時間もそのぶん膨らみます。中小企業がAIを日々の業務に組み込むときも、このダイヤルの合わせ方ひとつで月々の負担が大きく変わります。
株式会社Fyveは中小企業向けにAI業務効率化を手がけており、私たちも新しいモデルが出るたびに手元のCodex環境で挙動を確かめています。この記事では、OpenAI公式が発表した事実と、私たちが実際に手元で確かめたことを分けながら、effortの使い分け方を整理します。
GPT-6 Astraのeffortは6段階――「max」の上に「ultra」がある
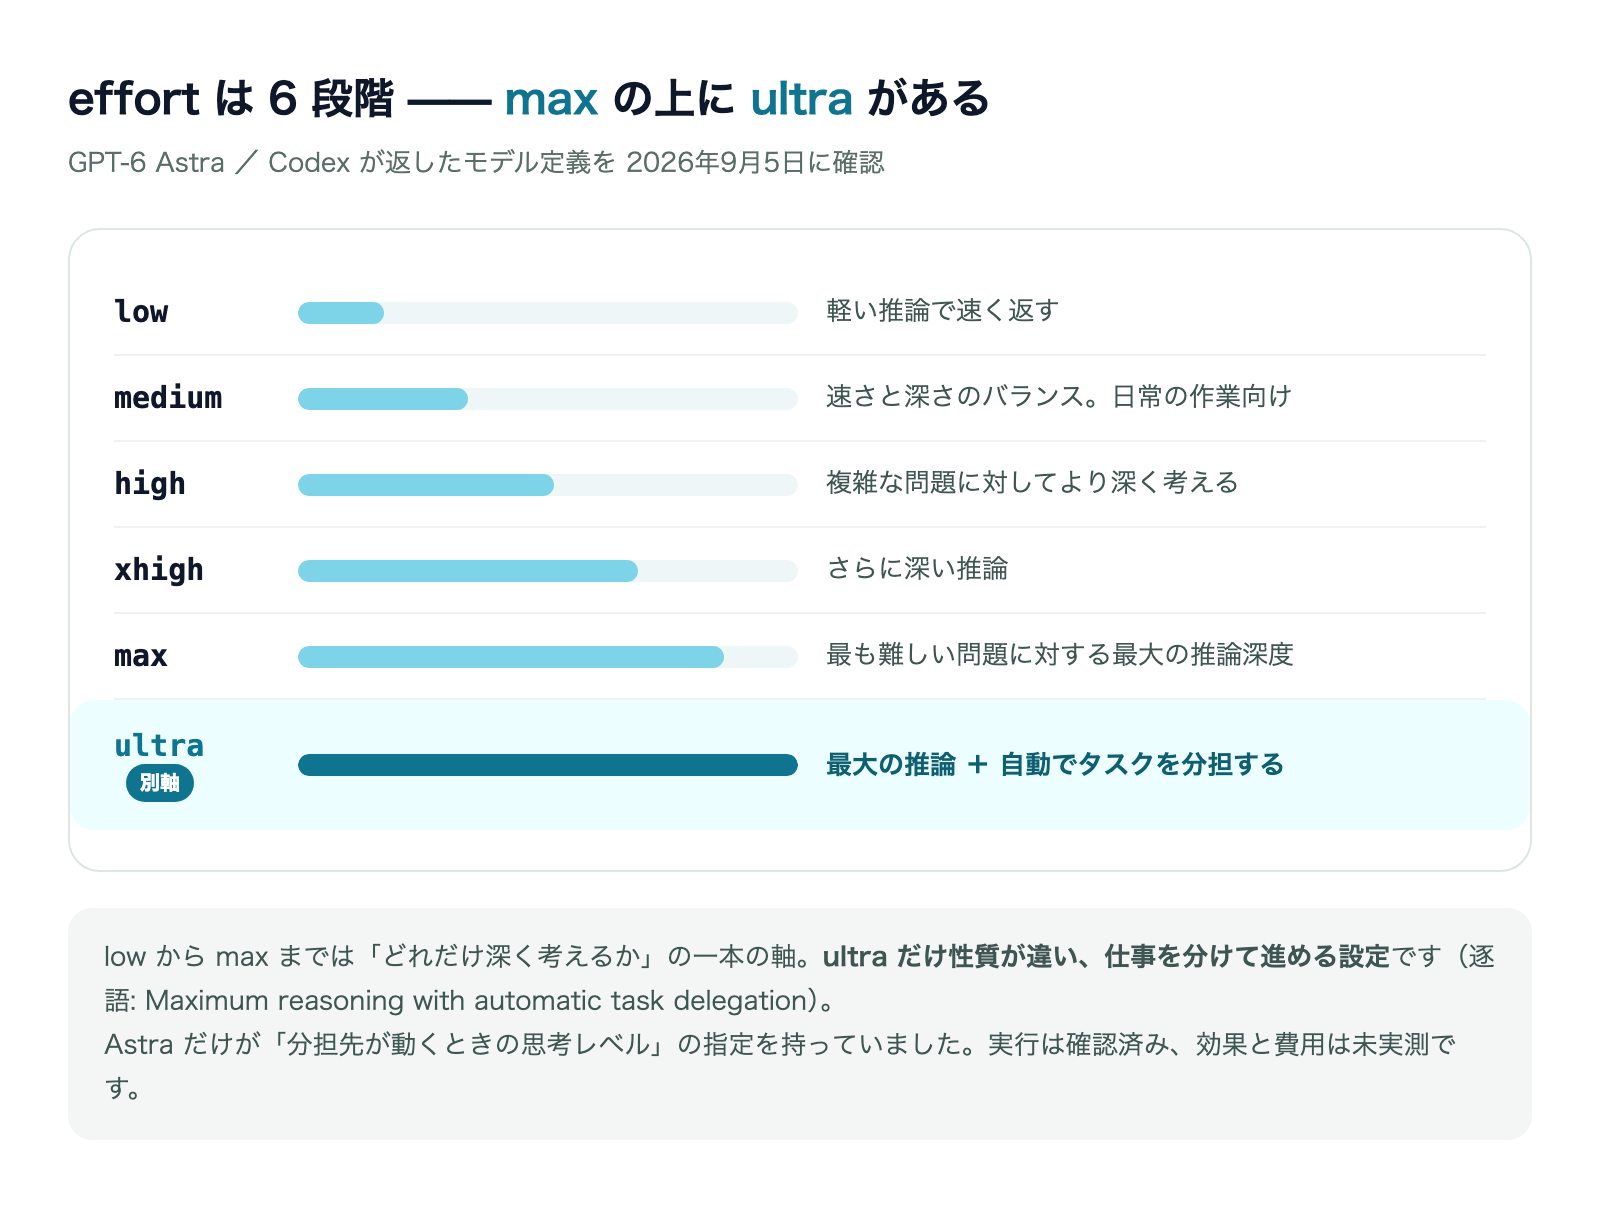
GPT-6 Astra(公開日2026年9月3日・米国時間)のAPI仕様では、effort(思考の深さ)に low ・ medium ・ high ・ xhigh ・ max が案内されています。max が新設され、いちばん上に一段追加された形です。
ただし、私たちが2026年9月5日にCodexで確認したモデル定義には、その上に ultra がありました。定義に書かれていた説明文は、他の段階とは性質が違います。
effort | 説明(逐語) |
|---|---|
| Fast responses with lighter reasoning |
| Balances speed and reasoning depth for everyday tasks |
| Greater reasoning depth for complex problems |
| Extra high reasoning depth for complex problems |
| Maximum reasoning depth for the hardest problems |
| Maximum reasoning with automatic task delegation |
lowからmaxまでは「どれだけ深く考えるか」という一本の軸です。ところがultraだけ、automatic task delegation——自動でタスクを分担すると書かれています。もっと考えるのではなく、仕事を分けて進める、という別の軸です。
裏づけになる記述もモデル定義にありました。Astraにはmulti_agent_versionという項目に加えて、分担先が動くときの思考レベルを指定する項目が入っています。手元で確認できた範囲では、この分担先の指定を持っていたのはAstraだけでした。
ultraは手元で実行し、正常に応答が返ることを確認しています。ただし何をどう分担しているのか、費用が何倍になるのかまでは今回確認できていません。「maxが最上位」という前提で設計している場合は、その上にもう一段あることだけ先に押さえておいてください。
effortは、モデルが回答を返す前にどれだけ深く考えるかを決めるパラメータです。レベルが上がるほど、モデルは内部でより多くの思考ステップを踏んでから答えを返します。
GPT-6 Astraはweb検索・コードインタプリタ・パソコン操作(computer use)など複数のツールを呼び出しながら回答をまとめる場面が増えています。ツールを何度も呼び出し、結果を踏まえて判断し直すような複雑な作業ほど内部の思考ステップが積み重なりやすく、effortの違いが体感に出やすくなります。逆に、ツールを使わない一問一答であれば、effortを上げても差は小さくなりがちです。
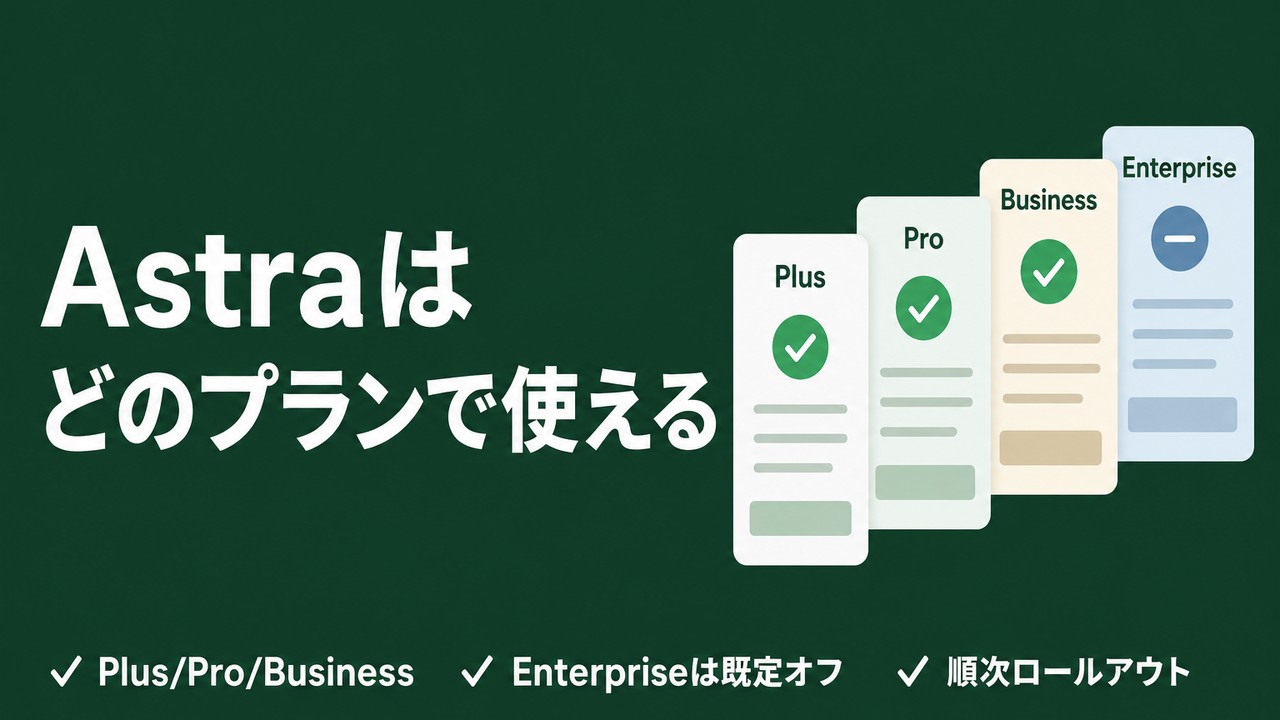
提供状況にも触れておくと、GPT-6 AstraはChatGPTのPlus・Pro・Business・Enterprise、OpenAI API、AWS(Amazon Bedrock)へ数日かけて順次展開される予定です。そのうえでPro・Business・Enterpriseだけは、より高いeffortで動く上位版「GPT-6 Astra Pro」も選べます。Enterpriseは既定でオフになっており、管理者がワークスペース単位で有効化する必要があります。プランごとに何が使えるかの詳細は、こちらにまとめています。
公式ベンチマークの高スコアは、原則「max」で測定されている
GPT-6 Astraの発表で並ぶ数字は、どれも印象的です。たとえばARC-AGI-3は99.9%(Opus 5は30.2%、Solは7.8%)、FrontierMath Tier 4 (v2)は97.6%(Fable 5.1・Fable 5はいずれも87.8%)と、前世代やライバルモデルを大きく引き離しています。
ただし、OpenAI自身が明記している前提があります。公式ベンチマークは原則すべて、effortをいちばん高く設定した状態で測定されたものです。スコアは上がるが、その分レイテンシとトークン消費も膨らむ、とOpenAIは書いています。
これが意味するのは、発表された数字が「自分がいつも使っている設定」の性能ではなく、「effortを振り切ったときの上限性能」だということです。日常的にmediumやhighで使っている限り、発表どおりの結果が毎回出るとは限りません。ベンチマークの数字を見るときは、まず「これは何effortでの測定か」を疑う癖をつけておくと、期待値のずれを防げます。
しかもmax相当で測っても、Astraが常に一番というわけではありません。ツール使用時のHumanity's Last Examでは、Astraは57.2%にとどまり、Fable 5.1(65.0%)・Fable 5(63.8%)・Opus 5(63.6%)のいずれにも届いていません。この項目は、発表本文では触れられていない数字です。
総合的な指標でも同じことが起きています。第三者機関Artificial Analysisの Intelligence Index(v4.1.1)では、Astraは61.2で、Fable 5(62.1)・Opus 5(63.1)・Fable 5.1(65.7)をいずれも下回っています。公式発表の勝敗と、独立系の集計の勝敗は、同じ「effortを高く振った」条件で測っても一致しません。effortを最大にすれば無条件に最強になる、と考えないほうがいいという裏付けです。
effortは性能スイッチではなく、コスト調整の主手段
GPT-6 Astraの料金(2026年9月4日時点・API・100万トークンあたり)は次のとおりです。
区分 | 入力 | 出力 |
|---|---|---|
Standard | $10.00 | $50.00 |
キャッシュ読み取り | $1.00(入力の10%) | — |
キャッシュ書き込み | $12.50 | — |
Batch / Flex | $5.00 | $25.00(Standardの50%) |
Fastモード | $20.00 | $100.00(Standardの2倍) |
この表を見て気づくのは、effortのレベルごとに単価表が分かれているわけではないという点です。lowで回してもmaxで回しても、1トークンあたりの単価は変わりません。
では何が変わるのか。effortを上げると、モデルが答えを出すまでに使う思考のステップが増え、結果として消費するトークンの量が増えます。OpenAIが「スコアは上がるがレイテンシとトークン消費も膨らむ」と明記しているとおり、費用と待ち時間は、単価ではなくトークンの消費量を通じて伸びる構造です。ChatGPTの有料プランで使う場合も、思考が深いやり取りほど既存のサブスク枠を早く消費し、枠を超えた分はクレジット購入が必要になります。
なお、272,000トークンを超える長いプロンプトには入力2倍・出力1.5倍の倍率がかかり、地域を指定した処理には10%が上乗せされます。応答速度を優先するFastモードは、effort(思考の深さ)とは別の軸で、標準の2倍の単価で処理を早めるモードです。「深く考えるmax」と「速く返すFast」は別物なので、混同しないようにしてください。最大出力は128,000トークンが上限なので、effortをどれだけ上げてもここで頭打ちになります。
たとえるなら、社内のベテラン担当者に「今回はじっくり検討してから返事してほしい」と頼むか、「いつもどおりのスピード感で構わない」と頼むかの違いに近いものです。じっくり検討を頼むほど、担当者が使う時間(=トークン消費)が増え、そのぶん結果を受け取るまでの時間と費用が伸びる——effortが調整しているのはこの部分です。
月あたりの費用を具体的に計算したい場合は、こちらの記事にモデル別の計算例をまとめています。
業務でのeffort使い分け――普段はlowかmedium、maxは出番を選ぶ
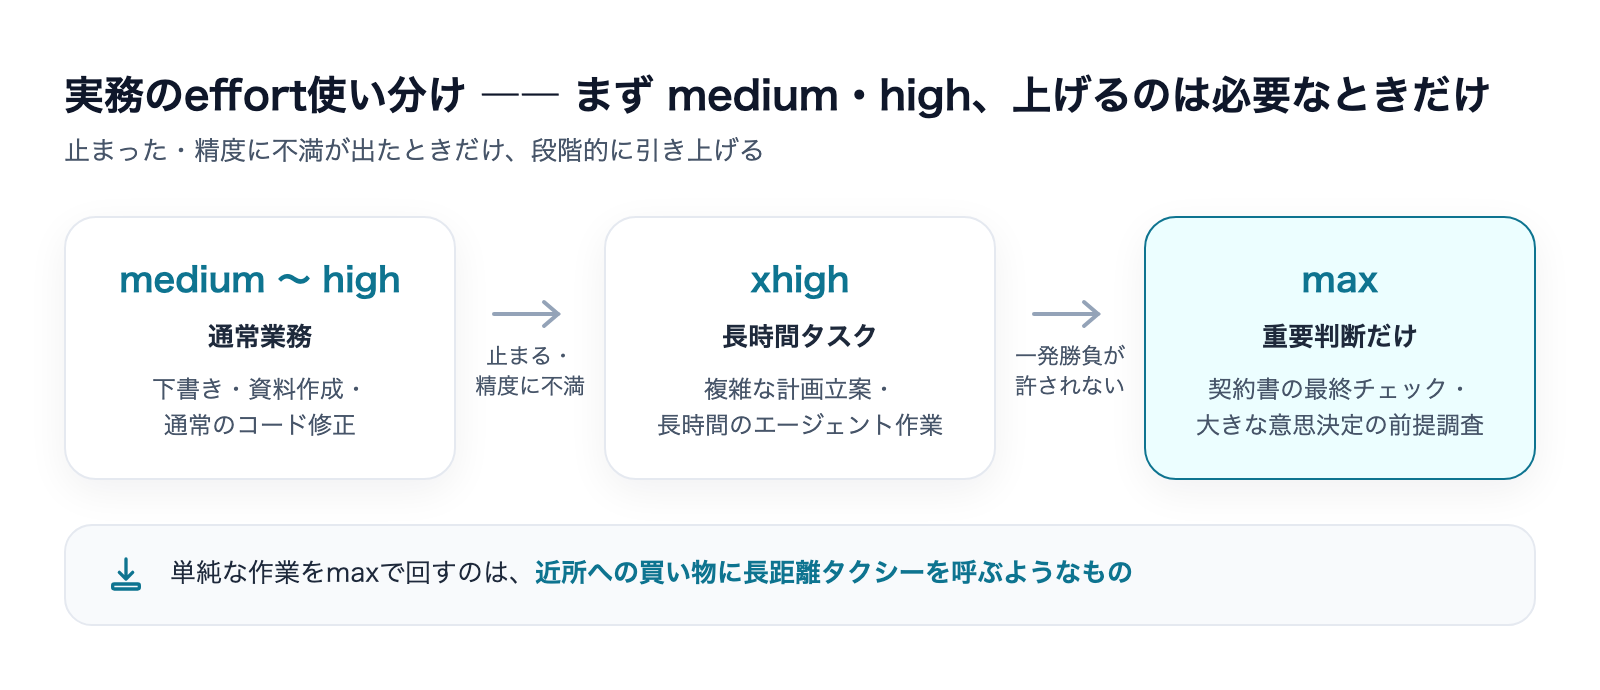
非エンジニアが実務でeffortを選ぶときの目安を、作業のタイプ別に整理します。まずは早見表で全体像をつかみ、下の詳細で判断の理由を確認してください。
effort | 費用・待ち時間の目安 | 向いている作業 |
|---|---|---|
low | 最も低い | 誤字脱字の確認、定型文の生成 |
medium | 低い〜標準 | 通常の下書き、軽微な修正 |
high | 標準〜やや高い | 資料の作り込み、まとまったコード修正 |
xhigh | 高い | 長時間のエージェント作業、複雑な計画立案 |
max | 最も高い | 一発勝負の重要判断(日常使いは非推奨) |
ultra | 未実測 | 自動でタスクを分担する設定。効果と費用は未検証 |
- 定型的な確認・簡単な文面チェック(low):誤字脱字の確認、短いメールの下書き、決まった形式への当てはめなど、判断の余地が少ない作業。深く考えさせる必要がないので、低いeffortで十分です
- 日常の資料作成・軽微な修正(medium〜high):提案書の下書き、業務フローの整理、通常のコード修正など、普段の仕事の大半はこの帯で回せます。多くの利用チャネルの既定値もこのあたりに設定されています
- 込み入った意思決定・長時間のエージェント作業(xhigh):複数の条件が絡む判断、長い文脈を踏まえた計画立案、時間のかかる自動処理など、途中で止まらず最後までやり切ってほしい作業に向きます
- 一発勝負で失敗が許されない場面だけ(max):重要な契約書の最終チェック、大きな意思決定の前提になる調査など、「多少時間と費用がかかっても、出せる中でいちばん確度の高い答えが欲しい」ときに限定して使う位置づけです。日常業務の既定値にする設定ではありません
まずmediumかhighから始め、途中で止まったり答えの精度に不満が出たりしたときだけxhigh・maxへ上げる、という順番のほうが費用を無駄にしません。逆に、単純な作業をmaxで回すのは、近所への買い物に長距離タクシーを呼ぶようなものです。
Claude Fable 5.1にも同じ考え方のeffort設定があり、私たちが実測した結果は「普段はlow、見せる仕事だけhigh」という使い分けに落ち着いています。effortの考え方そのものはモデルをまたいで共通するので、あわせて読むと判断の軸がぶれません。
Fable 5.1のeffort設定|lowとhighの使い分け
手元で確かめた――古いCLIは新しいeffortを解釈できずに壊れる
ここまでは公式発表の話です。ここからは、私たちの環境で実際に確かめたことです。effortの新設は、モデルの性能以前に手元のツールを壊すという形で最初に表れました。
環境はmacOS 25.5.0、認証はAPIキーではなくChatGPTアカウント認証です。2026年9月4日時点のCodex CLIは0.137.0でした。この状態では、モデル一覧の取得自体が次のエラーで失敗します。
ERROR codex_models_manager::manager: failed to refresh available models:
failed to decode models response: unknown variant `max`,
expected one of `none`, `minimal`, `low`, `medium`, `high`, `xhigh`読み解くと、CLI側がeffortの値をnone・minimal・low・medium・high・xhighの6種類しか知らず、maxという新しい値が返ってきた時点でデコードに失敗し、一覧の取得そのものが止まっていました。新しいeffortレベルが追加されたことで、それを知らない古いCLIが壊れるという実例です。「Astraが一覧に出てこない」という症状の正体は、多くの場合これです。
対処はCLIの更新1行でした。手元では0.137.0から0.153.4へ上がり、モデル一覧の取得もAstraの実行も通るようになりました。
npm install -g @openai/codex@latest
更新後のCLIが取得したモデル定義に、この記事の前半で挙げた6段階のeffortが入っていました。ultraの存在は、CLIを更新して初めて見えたものです。
あわせて、認証方式についても訂正しておきます。9月4日時点では、ChatGPTアカウント認証でAstraを指定するとThe 'gpt-6-astra' model is not supported when using Codex with a ChatGPT account.というエラーで弾かれていました。ところが9月5日、同じ環境・同じ認証方式のまま、エラーはThe 'gpt-6-astra' model requires a newer version of Codex.に変わり、CLIを更新すると正常に動きました。認証方式による制限が外れ、バージョンの条件だけが残った形です。「ChatGPTアカウント認証では使えない」という情報は、2026年9月5日時点では当てはまりません。
切り分けの手順はこちらにまとめています。
公式のモデル仕様を確認したい方はこちらです。
よくある質問
「アストラ」のmaxはどのプランでも使えますか
ChatGPTのPlus・Pro・Business・Enterprise、OpenAI API、AWS(Amazon Bedrock)へ数日かけて順次展開される予定です。Enterpriseは既定でオフのため、管理者がワークスペース単位で有効化する必要があります。ChatGPTの無料プランについては、発表に記載がありません。
GPT-6のeffortを上げれば、必ず回答の質は上がりますか
上がりやすい傾向はありますが、保証ではありません。第三者機関の集計では、effortを最大まで振った条件で測っても、GPT-6 Astraが他モデルを下回る項目が実在します。effortは「上限に近づける」操作であって、常に最強の結果を約束するものではないと捉えておくのが安全です。
まとめ——GPT-6 Astraのeffort設定チェックリスト
- effortはlow・medium・high・xhigh・max・ultraの6段階。公式仕様ではmaxが新設と案内されているが、手元のCodexではその上にultraが存在した
ultraは「深く考える」ではなく「自動でタスクを分担する」設定。実行は確認したが、効果と費用は未実測- Pro・Business・Enterpriseプランでは、より高いeffortで動く上位版「GPT-6 Astra Pro」が使える(Enterpriseは既定オフ)
- 公式ベンチマークは原則effortを最大まで振った状態で測定されたもの。日常の設定と同じ結果が出るとは限らない
- そのeffortで測っても常に最強ではない。HLE(ツール使用)ではAstraの57.2%がFable 5.1・Fable 5・Opus 5に届かず、独立系Intelligence Index(61.2)でもFable 5(62.1)・Opus 5(63.1)・Fable 5.1(65.7)を下回る
- 1トークンあたりの単価はeffortで変わらない。費用と待ち時間は、effortが引き上げる思考トークンの消費量を通じて伸びる
- 最大出力は128,000トークンが上限。272,000トークン超の入力には2倍、出力には1.5倍の倍率がかかる
- 実務の目安は普段はmedium〜high、xhighは長時間タスク、maxは一発勝負の場面だけ
- 古いCLI(0.137.0)は
maxを解釈できずモデル一覧の取得自体に失敗する。npm install -g @openai/codex@latestで0.153.4へ更新して解決した - 「ChatGPTアカウント認証では使えない」は2026年9月5日に解消済み。アカウント認証のままで動く
GPT-6 Astra全体の概要——何ができて、どのプランで使えるのかは、こちらの完全ガイドにまとめています。
Astra と Fable 5.1、ベンチマークでは分からない「使い分け」。
同じ5課題を両方に投げた10本の実測(全53ページ)
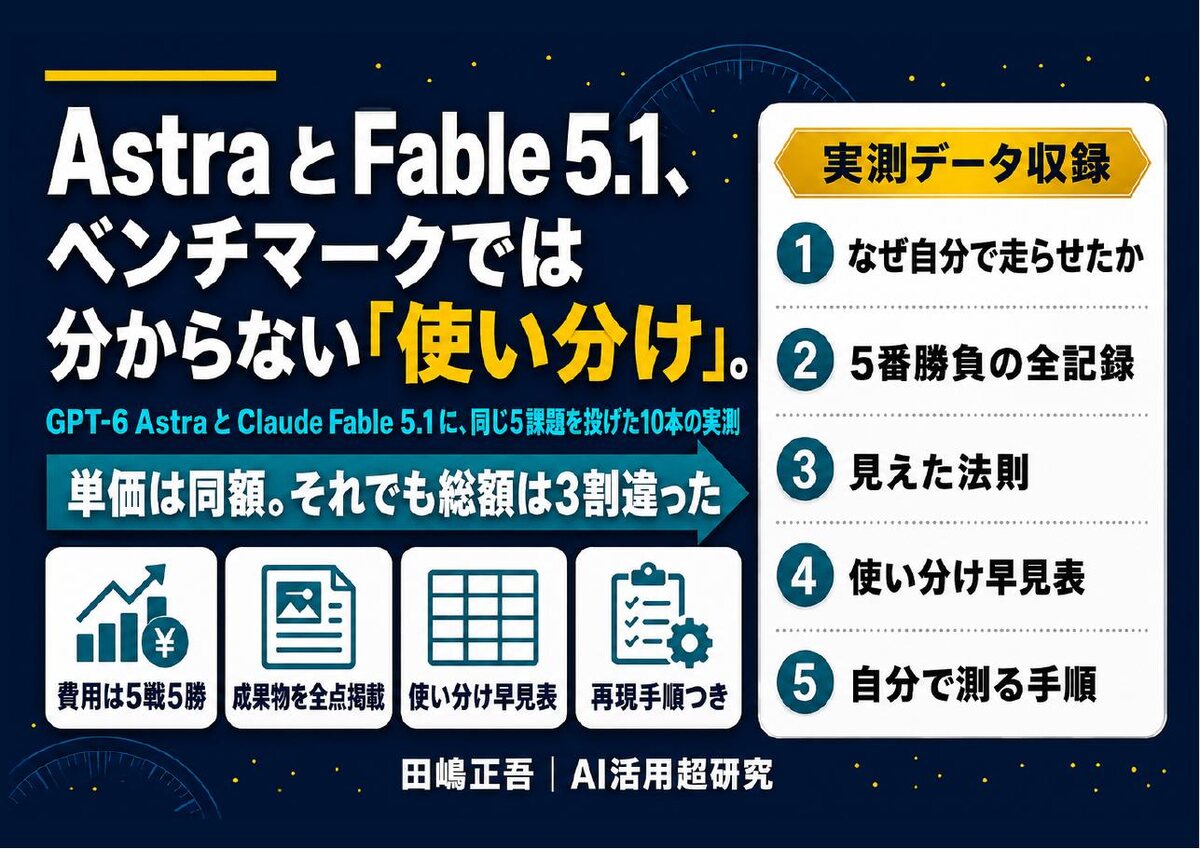
GPT-6 Astra と Claude Fable 5.1 は入出力の単価が完全に同額です。だから費用の差は、そのまま使ったトークン量の差になります。同じ5つの仕事を両方に投げたら、5課題すべてでAstraが安く合計30%差。一方で時間は31%遅い。正解率も要件充足も同点だったので、選ぶ基準は品質ではありませんでした。
- LP・CSV集計・スライド10枚・3D商品ページ・請求書の5課題を、時間と費用まで全件掲載
- 成果物そのものを左右で並置(ページ全体・区画ごと・スマホ幅・回した3D)
- 3D課題だけ順位が逆転した理由——Astraは袋の曲面を数式で起こしていた
- 待てるか/くり返すか/そのまま出すか——3つの質問で決める早見表つき
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。