claude plugin evalとは|スキルの効果を測る

「スキルを作ったけれど、これは本当に効いているのだろうか」——自分の手順をAIに覚えさせたあと、誰もが一度はこの疑問に行き当たります。
結論から言うと、2026年9月に追加された claude plugin eval がこの問いに点数で答えます。プラグインを読み込んだ場合と読み込まない場合の両方を走らせ、その差を出すコマンドです。高い点が出ても、無しで同じ点なら効いていない——そう機械が言い切ってくれます。
株式会社Fyveは、日々の業務手順をスキルとして組み、無人で動く定型ジョブに載せて運用しています。この記事では公式ドキュメントの仕様と、私が自分の端末で叩いて分かった食い違いの両方を書きます。
claude plugin evalとは|スキルの効果を点数で出すコマンド
claude plugin eval は、プラグインに同梱した「評価ケース」を実行し、採点結果をJSONとHTMLレポートで出すコマンドです。公式のCHANGELOGには、2.1.269 の追加項目として次のように書かれています。
Added
claude plugin eval: run a plugin's eval suite against Claude Code and get scored, reproducible results (JSON + HTML report)
「scored(採点された)」と「reproducible(再現可能な)」の2語が要点です。手で試して「良くなった気がする」で終わらせず、同じ手順を何度も回して数字にする、という設計になっています。
公式ドキュメント「Test plugins with evals」によれば、1つのケースはプロンプト(利用者が打ちそうな依頼文)と採点役(grader)の組で構成されます。実行のたびに、Claude Codeは対象プラグインだけを読み込んだ新しい非対話セッションを起動し、そのプロンプトを投げ、終わったところで採点役が最終応答・実行記録・生成されたファイルを見て合否を付けます。
3つの前提条件
ドキュメントが挙げる前提は3つです。
- Claude Code v2.1.269 以降(このバージョンの確認方法には後述の落とし穴があります)
plugin.jsonまたは.claude-plugin/plugin.jsonを持つプラグインのディレクトリ(スキルディレクトリ形式のプラグインも対象)- 普段のClaude Codeと同じ認証とモデル提供元。評価の実行も、採点役の判定も、あなたの認証情報でモデルを呼ぶため、プラン側の利用枠かAPIの請求に乗ります
3つめは見落とされやすい点です。評価は「無料の検査ツール」ではなく、モデルを何度も呼ぶ作業です。コマンドが表示する費用も、ドキュメントの記述では定価ベースの概算値です。
なぜ「使っているか」だけでは足りないのか
私がこのコマンドを待っていたのは、自分の手元に測れていない軸が1つ残っていたからです。
業務手順をスキルにして数を増やしていくと、まず困るのは「使っていないものが積み上がる」ことでした。これは棚卸しのコマンドで解決できます。どのスキルが呼ばれていないか、そこにいくら掛かっているかは数字で出ます。
次に困るのは「書いたとおりに動くか」です。これも確認する手段があります。実際に動かして挙動を見るやり方です。
ただ、この2つを揃えても答えが出ない問いが残ります。「そのスキルは、無くても同じ結果だったのではないか」です。
呼ばれている(使用頻度)。動く(動作確認)。それでも、スキルを外しても同じ答えが返ってくるなら、その手順は仕事をしていません。指示書に書いた内容が、もともとモデルが普通にやることと重なっていた、というのはよくある話です。
この3つめの軸を、claude plugin eval は既定で測ります。それが次に説明する「プラグイン無しの対照」です。
 読者特典・無料ダウンロードClaude Codeを「素のまま」使うな無料でダウンロード →
中心は採点ではなく「プラグイン無し」との差分
このコマンドで一番重要な機能は、点数そのものではありません。対照実験(ablation)です。
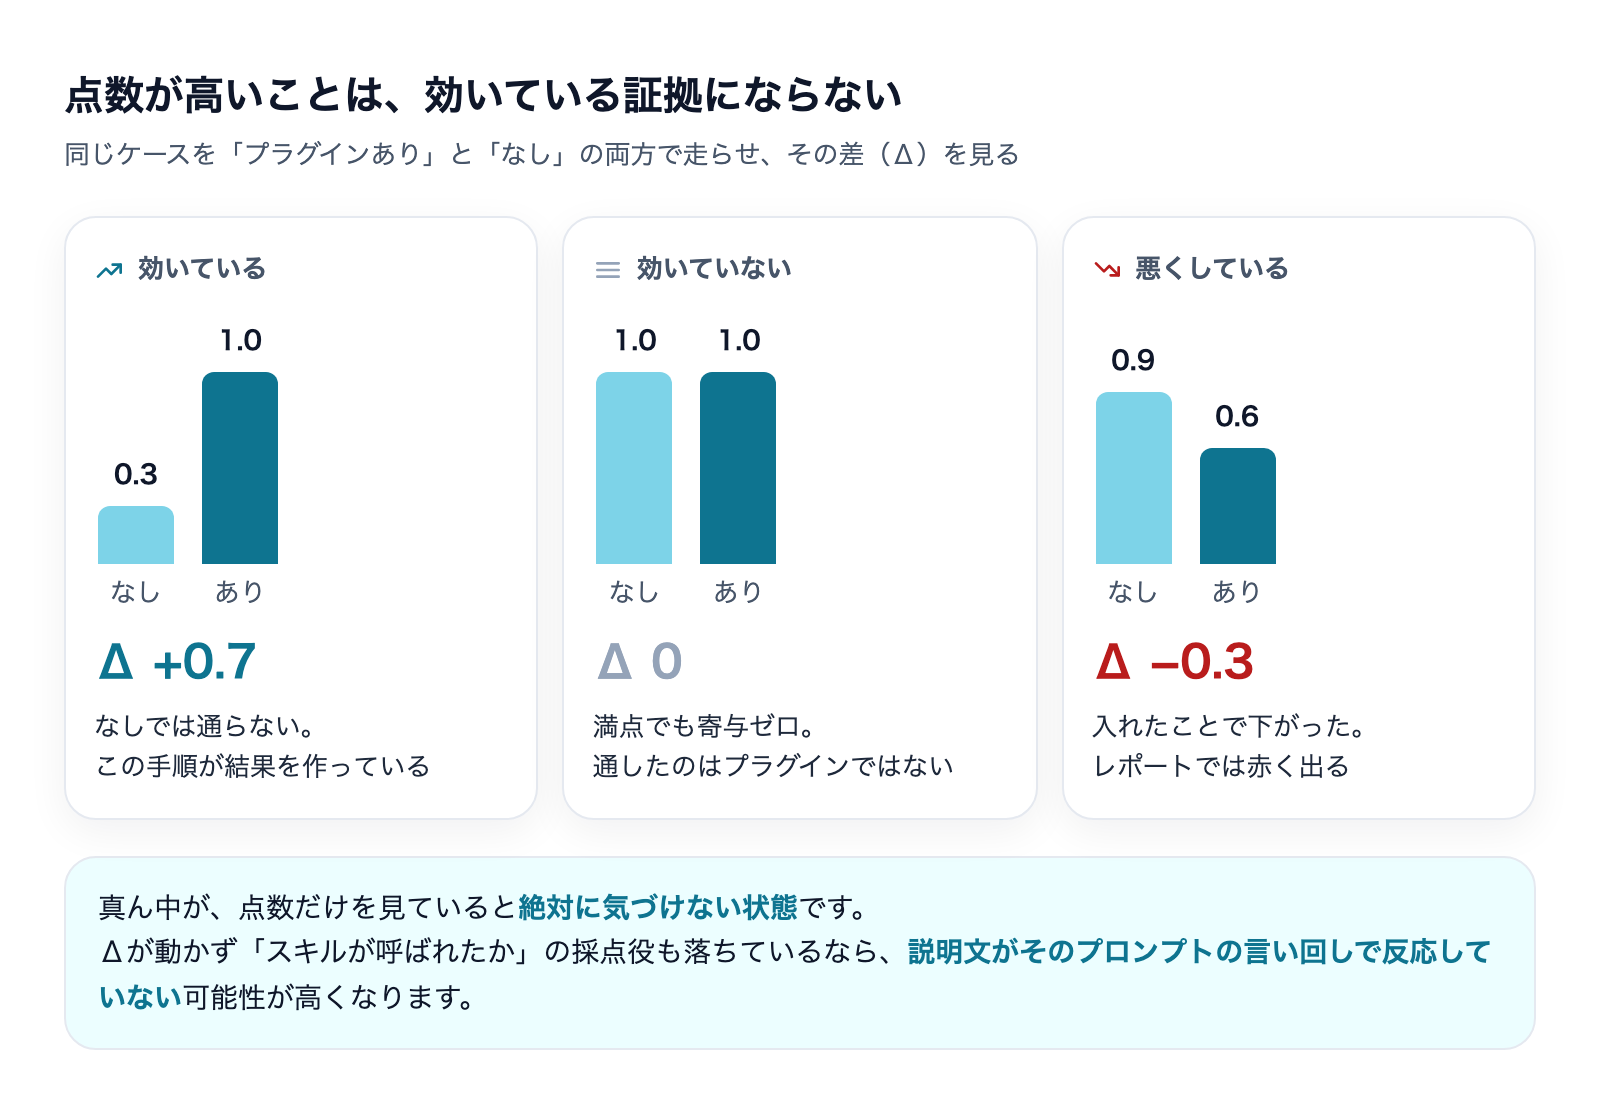
ドキュメントは理由をはっきり書いています。高い点が出たこと自体は、プラグインが助けたことを意味しない。プラグインが無くてもClaudeが同じようにできたかもしれないからです。そこで各ケースの実行は、既定でプラグインを読み込まない状態でも同じ回数だけ繰り返され、2つの点数が出ます。
- WITH: 対象プラグインを読み込んで走らせたときの点数
- W/OUT: 何も読み込まずに走らせたときの点数(ベースライン)
- Δ(デルタ): その差。これがプラグインの寄与分
ドキュメントの表現を借りれば、あるケースが有りでも無しでも1.0なら、そのケースを通したのはプラグインではないということになります。
この2本立ては --ablation で制御します。プラグインとして解決できた対象なら既定が with-without、ファイルパスを直接指定した場合は none です。つまりプラグイン名で指定すれば、何もしなくても対照が付いてきます。
実務上の効き目が大きいのは、Δがほぼゼロだったときの読み方です。ドキュメントのトラブルシュートには、プラグインは読み込まれているのにΔが動かず、しかも「スキルが呼ばれたか」を見る採点役が落ちている場合について、こう書かれています——それは多くの場合ほんとうの発見で、スキルの description がそのプロンプトの言い回しで反応していない。説明文を直して同じ評価をもう一度回せ、と。
スキルが発火していなかった、という失敗はログを眺めていても気づきにくいものです。それを点数の差として突きつけてくるのが、このコマンドの実質的な価値だと考えています。
手元で使えるか確かめる|版番号ではなく --help を叩く
ここからは、私が自分の端末で実際に確認して分かったことです。公式ドキュメントが案内する確認方法が、私の環境では機能の有無と一致しませんでした。
ドキュメントは前提条件の欄で「v2.1.269 以降。claude --version で確認し、claude update で更新してください」と案内しています。素直な手順です。
ところが私の端末では、claude --version が返したのは 2.1.209 でした。前提を満たしていません。それにもかかわらず claude plugin eval --help は終了コード0で、オプション一式を最後まで表示しました。
原因は特定していないので断定はしません。ただ、実務上の結論ははっきりしています。版番号は、その機能が使えることの証拠になりません。確かめたいなら、そのコマンドの --help を実際に叩くのが一番早く、かつ確実です。
# 使えるかどうかは、これ1行で分かる
claude plugin eval --help
ドキュメントと手元で、オプション一覧もずれていた
同じ食い違いは、もう一段細かいところにも出ました。公式リファレンスのオプション表に載っているのに、私の端末の --help には出てこなかったものがあります。
-j, --concurrency(同時に走らせるセッション数)--trust-plugin(初回の信頼確認を飛ばす。CI向け)--mocks(MCPサーバーの擬似応答)--eval-dir(ケースを置くディレクトリの変更)--no-publish(レポートを手元だけに留める)
逆に、手元の --help にあってリファレンスの表に無いものもありました(--no-scaffold、--output-dir など。ただし表の下の本文では触れられています)。細かい差ですが、--judge-model の既定値も、手元は haiku と具体名で表示され、ドキュメントは「小さく速いモデル」と書き方が違いました。
これは矛盾というより、ドキュメントはある版を説明していて、手元は別の版だという当たり前のことが見えているだけです。だからこそ、実際に使えるオプションは手元の --help が正だと考えたほうが安全です。記事や他人の設定例をそのまま貼って動かないときは、まずここを疑ってください。
配布の「タグ」が3つあり、別々の速度で動いている
版番号がずれる背景として、配布側の事情も確認しました。パッケージレジストリのタグを見ると、同じパッケージに複数の入口があります。私が確認した時点の値は次のとおりです(2026年9月15日時点)。
タグ | 版 | 公開日時(UTC) |
|---|---|---|
| 2.1.236 | 2026-08-19 |
| 2.1.270 | 2026-09-12 |
| 2.1.271 | 2026-09-14 |
問題の claude plugin eval が入った 2.1.269 の公開は 2026年9月11日18時12分(UTC)でした。ここで見ておきたいのは、stable が34版ぶん後ろにいるという点です。安定版の入口から入れている人は、新機能が公式に発表されても手元にまだ届いていない状態が続きます。
そしてもう1つ。ドキュメントのトラブルシュートには 「plugin eval is currently unavailable」——Anthropic側でコマンドをサーバー側から止めているという項目があります。手元で何をしても戻らない、とも書かれています。つまり機能の可否は、手元の版だけで決まっていません。版番号の突き合わせに時間を使うより、叩いて確かめたほうが早い理由がここにもあります。
最初の1件を作る手順|4ステップ
ここからは実際の作り方です。ドキュメントが推奨しているのは、ケースを自分で書くのではなくClaudeに書かせる経路です。
ステップ1: プラグインのルートで init を走らせる
# plugin.json のあるディレクトリで
claude plugin eval initターミナルで実行すると、プラグインを読んだうえでケースと採点役を提案し、試し打ちしてからファイルを書く聞き取り形式が始まります。端末が無い場合や --bare <名前> を付けた場合は、空のテンプレートだけを書き出します。
# 空のテンプレートだけ欲しいとき
claude plugin eval init --bare first-case
できるのはこの形です。
evals/first-case/
├── prompt.md            # Claudeに送るプロンプトと実行条件
└── graders/
    └── criteria.md      # 採点役1つ
ステップ2: プロンプトを「利用者の言い方」で書く
prompt.md の本文が、毎回Claudeに送られる依頼文です。ここで大事なのは、スキル名を名指ししないこと。ドキュメントも「利用者が打つであろう言い回しで書け」と明記しています。スキル名を書いてしまうと、説明文が反応するかどうかという肝心な部分を検査できなくなります。
---
max_turns: 10
allowed_tools: [Read, Glob, Grep, Skill]
---

この変更のコミットメッセージを書いて: getUser を fetchUser に改名し、呼び出し3箇所を更新した。
frontmatterで実行条件を指定します。主なものは次のとおりです。
項目 | 既定 | 意味 |
|---|---|---|
| 3 | 1つの腕あたりの実行回数(1〜50) |
| 10 | ターン上限(最大200)。到達すると実行エラー扱いになり点が下がるため、余裕を持たせる |
| 300 | 1回あたりの実時間上限(最大3600) |
| なし | 使わせる道具。読み取り系はここに書けば許可される |
| 直近の親 | 検査対象のプラグイン。自動検出が外れたら |
1つ注意点があります。各実行は空の作業ディレクトリから始まります。作業に必要な材料はプロンプトの中に書き込むか、後述の準備スクリプトで用意する必要があります。
ステップ3: 採点役を2つ以上置く
graders/ の下の1ファイルが採点役1つです。ドキュメントが薦めている組み合わせは、「中身が正しいか」と「自分のスキルが働いたか」の2本立てです。
中身の評価は、判定モデルに渡す合否基準を文章で書きます。
---
type: llm
---

PASS if 正しい応答に含まれるべき内容がある。
FAIL if 間違い・不足のある応答になっている。
もう1つは、そのスキルが実際に呼ばれたかを見る採点役です。
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?あなたのスキル名"'
---この2本目があるから、Δがゼロだったときに「そもそも発火していなかった」と切り分けられます。入れておくことを強く薦めます。
ステップ4: 走らせて、レポートを読む
# 現在地のプラグインを評価する
claude plugin eval

# 特定のケースだけ/合格ラインを下げて
claude plugin eval --case first-case --threshold 0.8
実行のたびに評価ディレクトリの下に results/<timestamp>/ が作られ、aggregate-result.json と report.html が置かれます。results/ は .gitignore に入れておくようドキュメントが指示しています。
採点役6種|何を見て合否を決めるか
採点役には6つの型があります。文章の判定をモデルに任せるものと、機械的に判定するものが混在しているのが特徴です。
型 | 合格の条件 |
|---|---|
| 正規表現が対象に見つかる。 |
| 指定した道具の呼び出し回数が |
| 2つの道具が両方呼ばれ、順序が指定どおり |
| 実行中に作られたファイルがパターンに一致する |
| 判定モデルが基準に照らして3票中2票以上でPASSを投じる |
| 判定モデルが「参照用の記録と同等以上」と判断する |
採点役が何を見るかは target(llm では focus)で切り替えます。既定は last_message=最終応答のテキストだけです。ここを知らないと空振りします。
last_message: 最終応答(既定)trace: セッション全体のJSON。1行1メッセージ。引用符が\"の形で入る点に注意files: 作られたファイルのパス一覧。中身ではない{ source: file, path: ... }: 特定ファイルの中身。画像なら判定モデルに画像として見せられるmock_calls: 擬似サーバーへの呼び出しとその応答
ドキュメントのトラブルシュートが挙げている失敗例が的確なので引いておきます。全部0点になるときは、ファイルの中身を見るつもりで files(パス一覧)を採点対象にしているのが典型だそうです。さらに file_exists は実行中に新規作成されたファイルしか数えません。準備スクリプトが作ったファイルや、Claudeが編集しただけのファイルは見えません。
重み付けも指定できます。weight で採点役ごとの比重を変えられ、arm に with-only を指定すれば2本立ての採点から外せます。スキル発火の確認用採点役は、性質上プラグイン無しの腕では必ず落ちるため、この扱いが要ります。
結果の読み方|Δ・しきい値・終了コード
点数の決まり方
点の付け方は素直です。1回の実行の点=通った採点役の割合(重みがあれば加重)、ケースの点=その平均。平均を取るのは、実行を既定で3回繰り返すからです。ドキュメントはその理由を「非決定的なエージェントを1回走らせても、ほとんど何も分からない」と説明しています。
合格ラインは --threshold で、既定は 1.0。つまり既定では全部の採点役が毎回通ることを要求します。実際の運用では、最初から1.0で回すと赤ばかりになるので、現状の水準を測ってから線を引くほうが進みます。
HTMLレポート
report.html は外部への通信を一切しない単体のファイルで、ディスクから直接開けます。CIの成果物として添付できる、というのが設計意図です。上から順に、スイート全体の判定、ケースごとのΔと点数、各実行の採点役の合否が並びます。
読むときに効くのが、Δがマイナスのケースは左端が赤くなるという表示です。スクロールしていて劣化(プラグインを入れたせいで悪くなった箇所)が目に飛び込んでくる作りになっています。落ちた採点役は最初から開いた状態で表示され、llm 型なら判定モデルの投票内容と根拠まで見えます。
CIで落とすための数字
aggregate-result.json は schemaVersion: 1 の付いた文書で、機械が読む前提で設計されています。判定に使う主なフィールドは次のとおりです。
フィールド | 意味 |
|---|---|
| スイート全体の平均点 |
| ケース横断の平均Δ |
| しきい値を満たしたケース数と総数 |
| そのケースのΔ |
| 途中で終わったか。この値が真のものは推移グラフに混ぜない |
終了コードも決まっています。0=全ケースが合格/1=不合格のケースがある、読み込みに失敗した、信頼されていないディレクトリ/2=部分実行/130=中断/143=停止。--threshold と組み合わせれば、手順が劣化したときにCIを落とせます。
新しいフィールドは既存の名前を変えずに追加される、と明言されているので、判定スクリプトは知らないフィールドを無視する書き方にしておくのが作法です。
費用と時間の見積もり|呼び出しは倍になる
ここは先に計算しておいたほうがいい部分です。対照実験は同じ回数をもう一度走らせるので、素朴に考えるより呼び出しが増えます。
ドキュメントの説明に沿って数えると、1回の評価でだいたい次のようになります。
- ケース数 × 実行回数 のエージェント実行(プラグイン有り)
- 同じだけのエージェント実行(プラグイン無しの対照)
- 加えて、
llmまたはbaselineの採点役1つにつき、1実行あたり3回の短い判定呼び出し
ケース3件・既定の3回・llm 採点役1つという控えめな構成でも、エージェント実行は 3×3×2=18回、判定呼び出しがさらに 18×3=54回という規模になります。「軽く試す」つもりで --runs を上げると、すぐ効いてきます。
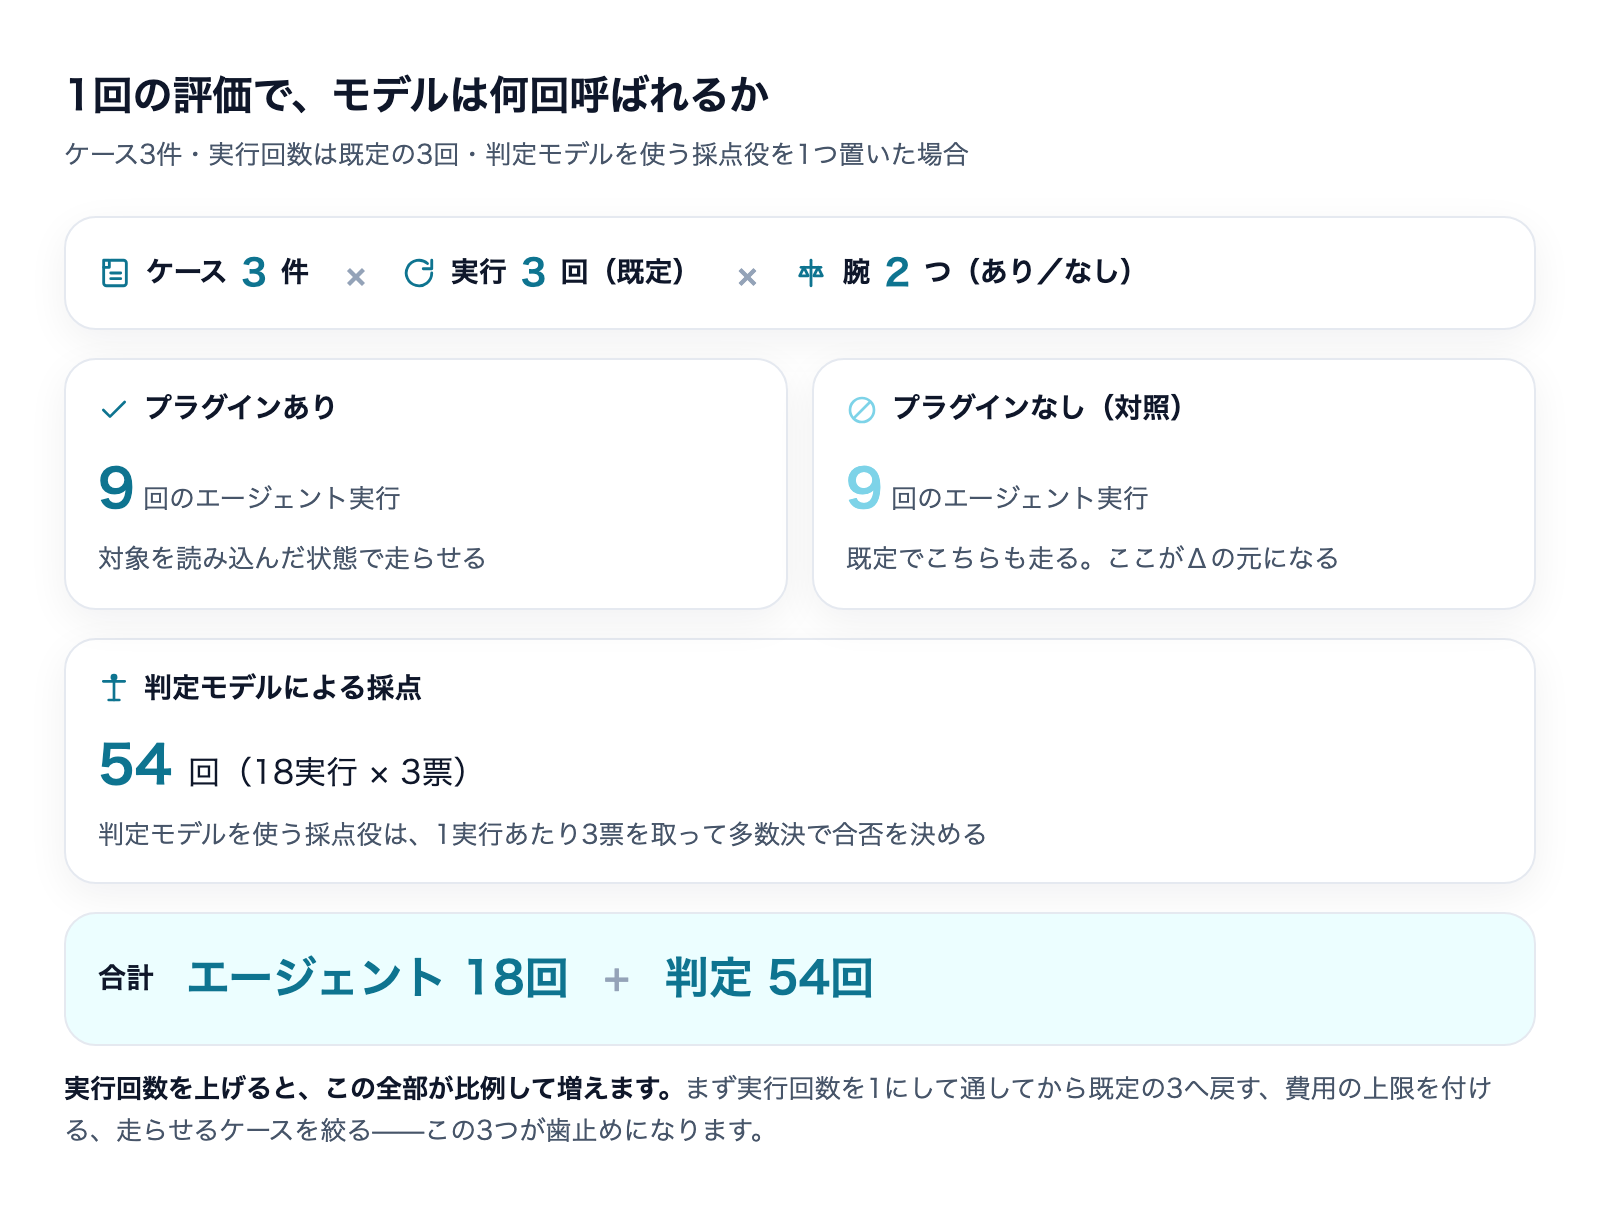
歯止めの仕組みも用意されています。
--max-cost-usd: 上限に達したら次の実行に進まず、終了コード2で部分結果を返す--runs: 実行回数を一時的に下げる(まず1で通してから3に戻す、という使い方ができます)--case/--tag: 走らせるケースを絞る--ablation none: 対照を切って半分にする(ただしΔが出なくなるので、常用はおすすめしません)
費用上限に引っかかった実行は、有料の判定役だけ飛ばして無料の採点役で点が付くという挙動になります。結果のJSONには skippedPaidGraders が立つので、その実行の点は他と比べられないと判断してください。数字を並べるとき、ここを混ぜると推移が嘘になります。
実行前に知っておくべき安全面
評価は、対象プラグインのスキルとフックを読み込み、あなたの権限で、あなたの端末で走ります。ドキュメントはこれを「claude --plugin-dir を指すのと同じ信頼判断だ」と表現しています。信頼できるプラグインだけを対象にしてください。
特に --scaffold は意識して扱う必要があります。これはケースに付属する準備スクリプト(Bash)を走らせる指定で、作者が書いたシェルスクリプトを自分の権限で実行することになります。既定はオフです。私の端末の --help にも「自分で書いたケースにだけ使え」という趣旨の注意書きが出ていました。他人のプラグインを評価するときに、ここを反射的に付けないようにしてください。
あわせて、ドキュメントが明記している重要な限定があります。実行時の隔離は、検査されるエージェントが届く範囲を制限するものであって、プラグイン自身のコードに対する境界ではありません。そして評価に合格したからといって、そのプラグインが安全だということにはなりません。評価は品質の物差しであって、安全性の審査ではない、という切り分けです。
うまくいかないときの原因
ドキュメントのトラブルシュートから、実際に踏みやすいものを整理します。
症状 | 原因と対処 |
|---|---|
「early access」と言われる | 手元の版が一般提供より前。更新して、新しいセッションでやり直す |
「currently unavailable」と言われる | 提供側がサーバー側で止めている。手元では戻せない。時間を空ける |
W/OUT の列が出ない/Δが出ない | ケースに対してプラグインが解決できていない。 |
Δがほぼゼロで、スキル発火の採点役が落ちる | 多くの場合これは本当の発見。スキルの |
正しい成果物ができているのに全部0点 | 採点対象が |
目視できる文字列に正規表現が当たらない | 既定の対象は |
信頼されていないと言われて止まる | 初回の確認を出せない状況( |
途中で利用上限に当たる | 実行回数と対照で呼び出しが増えている。 |
上から2つめは、覚えておく価値があります。手元をいくら直しても直らない種類の不調があると分かっていれば、無駄な調査を切り上げられます。
どの手順から測るか|全部にevalを付けない
最後に、運用としての線引きです。これは私の判断で、ドキュメントに書いてあることではありません。
評価にはモデルの呼び出し費用と、ケースを書く手間がかかります。手元のスキル全部に評価を付けるのは、費用の面でも保守の面でも現実的ではありません。私は次の順で優先しています。
- 1. 人手を挟まずに動いているもの。定期実行や無人のジョブに載っている手順は、壊れても誰も気づきません。壊れたことが数週間後の結果でしか分からない類のものが最優先です
- 2. 説明文で発火させているもの。呼び出し方がモデルの判断に委ねられている手順は、言い回しの変化や更新で静かに反応しなくなります。Δと発火の採点役は、まさにここを見張ります
- 3. 直近で作り直したもの。手順を整理した直後は「良くなったはず」という感覚だけが残ります。作り直しの前後で同じ評価を回すと、感覚が数字になります
逆に、手で起動して結果をその場で目視する手順には要りません。人が見ているなら、劣化はその場で気づけるからです。評価が効くのは「間違っていても誰も気づかない場所」であって、丁寧さの証明のために付けるものではない、と考えています。
スキルを持ち運べる形にまとめる話、置くだけで読み込ませる話は、それぞれ別に書いています。
Agent Plugins 1.0とは|業務スキルを持ち運ぶ
よくある質問
スキル1つでも使えますか
使えます。対象にできるのは、プラグインのディレクトリ、prompt.md や case.yaml の単体ファイル、インストール済みプラグインの名前、スキルディレクトリ形式のプラグインです。ただしファイルパスを直接指定した場合、対照は既定でオフになります。Δが欲しいなら名前で指定してください。
費用はどれくらいかかりますか
構成によるため一概には言えません。仕組みとしては「ケース数 × 実行回数 × 2(対照)」のエージェント実行と、判定役の呼び出しが積み上がります。--max-cost-usd で上限を付け、まず --runs 1 で通してから既定の3に戻すのが安全です。なおコマンドが表示する費用は定価ベースの概算で、請求の実額ではありません。
評価に合格すれば、そのプラグインは安全だと言えますか
言えません。ドキュメントが明確に否定しています。評価の隔離は検査対象のエージェントが届く範囲を制限するもので、プラグイン自身のコードに対する境界ではありません。安全性は別の話として判断してください。
チームで回すとき、レポートはどこに出ますか
report.html は評価ディレクトリの下に必ず残ります。加えて、claude.ai のサブスクリプションでサインインしていて条件を満たす場合は、非公開の成果物として公開され、URLが表示されます。手元だけに留めたいなら --no-publish です(このオプションが手元の --help に出るかは、前述のとおり版によります)。
ケースは手で書くべきですか
ドキュメントは claude plugin eval init の聞き取り形式を推奨しています。プラグインを読んだうえでケースと採点役を提案し、試し打ちまでしてから書き出すためです。手で書くなら --bare で空のテンプレートから始められますが、最初の1件は生成させて、中身を直すほうが早いと思います。
「2.1.269以降が必要」と書いてあるのに、古い版で動きました
私の環境でも同じことが起きました。原因は特定していませんが、実務上はclaude plugin eval --help が応答するかどうかで判断してください。逆に、版が新しくても提供側がサーバー側で止めていれば使えません。版番号は手がかりであって、証拠ではありません。
まとめ|「効いているか」は感覚ではなく差分で出す
claude plugin eval で押さえておくべき点を、最後に整理します。
- 中心機能は採点ではなく対照実験。WITH と W/OUT の差(Δ)が、そのプラグインの寄与分
- Δがゼロなら、通したのはプラグインではない。高得点そのものは何も証明しない
- スキル発火を見る採点役(
tool_used: Skill)を必ず入れる。Δが動かない原因の切り分けができる - 既定は runs 3・threshold 1.0・対象は最終応答。この3つを知らないと結果を読み違える
- 呼び出しは対照で倍になる。
--max-cost-usdと--runsで歯止めをかける - 使えるかどうかは
--helpで確かめる。版番号は証拠にならない(私の環境では実際に一致しませんでした) - 合格は安全性の保証ではない。信頼できるプラグインだけを対象にする
手順をAIに覚えさせる作業は、書いた時点では誰も効果を知りません。私はこれまで「使っているか」と「動くか」までは数字にできていましたが、「効いているか」だけは感覚のままでした。その最後の1軸に、ようやく機械の答えが返ってくるようになったというのが、このコマンドに対する私の評価です。
株式会社Fyveでは、中小企業のAI活用について、こうした道具の選び方から日々の運用設計までご相談を承っています。
※本記事の仕様は2026年9月15日時点の公式ドキュメントおよび公式CHANGELOGに基づき、あわせて筆者の端末での実行結果を記載しています。コマンドの挙動とオプションは版によって変わるため、実際に使う際は手元の claude plugin eval --help で確認してください。
Claude Codeを「素のまま」使うな
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます
 +4
PDF 13点・合計358ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。