Claude Fable 5.2のeffort|5段の選び方

「Fable 5.2のeffortは、5段のどれにすればいいのか」「5.1と同じ設定のままで大丈夫か」——新しいモデルに切り替えた直後、誰もがこの迷いを抱えます。
結論から言うと、Claude Fable 5.2のeffortはまず high から始め、品質が落ちないと確かめた仕事だけ medium・low に下げるのが公式の答えです。xhigh は長い難題で伸びを確かめた所だけ、max は上限を測るときだけ。そして、5.1で決めた段をそのまま持ち越さないことが大事です。
株式会社Fyveは中小企業のAI活用を支援しており、記事づくりなど社内の無人の仕事もClaude Codeで回しています。この記事では、公式ドキュメントの記載(2026年11月10日時点)と、同じ問題を5段すべてで解かせた手元の実測をもとに、Fable 5.2のeffortの選び方を整理します。
Claude Fable 5.2のeffortとは
effortは、モデルがひとつの返答にどれだけ手間をかけるかを決める設定です。Anthropicは2026年11月9日(日本時間11月10日)にClaude Fable 5.2を発表し、公式ドキュメントではlow・medium・high・xhigh・max の5段すべてに対応すると書いています。
Fable 5.2では、考える処理(Adaptive Thinking)が常にオンで、切ることができません。どれだけ考えるかをモデル自身が決め、その決め方をeffortで寄せる仕組みです。公式ドキュメントは「思考の深さ・待ち時間・費用を動かす主なつまみはeffort」と説明しています。
押さえておきたい性質は次の3つです。
- effortは返答のすべてのトークンに効く:考える部分だけでなく、本文の説明やツール呼び出しの数・引数にも効きます。低い段ほど、ツール呼び出しはまとめられて少なくなります
- 厳密な上限ではない:公式は「振る舞いの合図であって、トークンの厳しい予算ではない」としています。低い段でも、十分に難しい問題なら考えます。ただ、同じ問題でも高い段より考える量が減ります
- 返答の長さはほとんど変わらない:Fable 5.2では、effortを変えても返答の長さはほぼ変わらないと書かれています。短く答えさせたい・口調を変えたいときは、effortではなく指示文で伝えます
3つめは意外と見落とされます。「lowにすれば短い返事になる」と考えて下げても、文章量はさほど変わらず、考える量だけが減ります。
effortの既定値は使う場所で違う
何も指定しないときの段は、使う場所によって違います。Anthropicの発表とAPIのドキュメントを合わせると、次のとおりです。
使う場所 | Fable 5.2の既定 | 参考: Fable 5.1の既定 |
|---|---|---|
Claude API(Messages API) | high | high |
Claudeのアプリ | medium | medium |
Claude Code | medium | high |
APIで effort を省いたリクエストは high で動きます。公式ドキュメントには「既定と同じ値を明示しても、省いたときとまったく同じ振る舞いになる」とあります。
差が出るのはClaude Codeです。Fable 5.1のときは high が既定でしたが、Fable 5.2では medium から始まります。5.1から移って「前より考えが浅い」と感じたら、モデルではなく既定の段が1つ下がっている可能性があります。Claude Codeでの段の変え方(/effort・起動時の指定・設定ファイル・昔の書き方が効かない点)は、次の記事にまとめています。

5段の選び方(公式の目安)
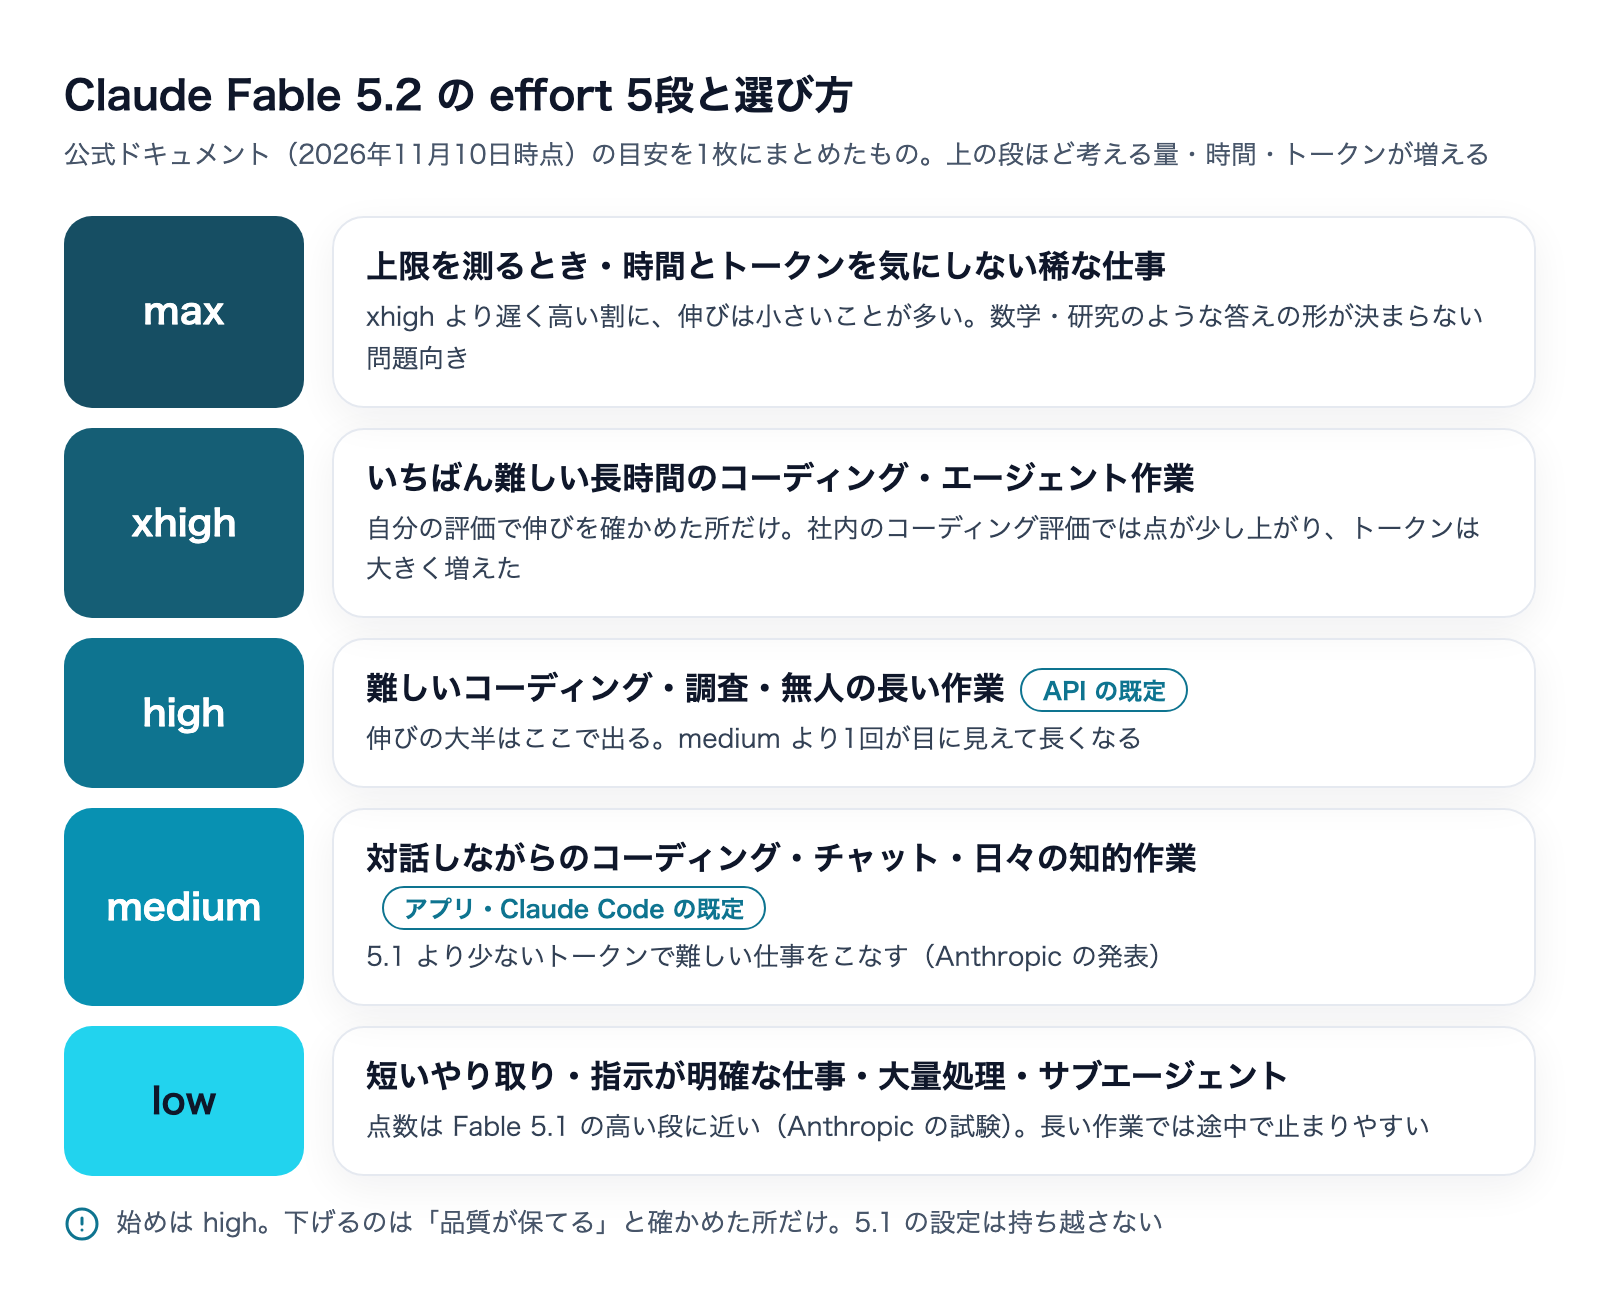
Anthropicは、Fable 5.2向けの書き方ガイド(Prompting Claude Fable 5.2)で、仕事の種類ごとに段の目安を出しています。要点を表にまとめます。
段 | 向いている仕事(公式の目安) | 気をつけること |
|---|---|---|
low | 短いやり取り、指示がはっきりした仕事、大量処理、速く賢いサブエージェント | 長い作業では途中で止まりやすい |
medium | 対話しながらのコーディング、チャット、日々の知的作業 | low と同じく、長い作業では途中で止まりやすい |
high | 難しいコーディング、調査、エージェント作業、人が見ていない長い作業 | medium より1回が目に見えて長くなる。あいさつにも考えてから答える |
xhigh | いちばん難しい長時間のコーディング・エージェント作業(伸びを測って確かめた所だけ) | 社内のコーディング評価では、点は少し上がり、トークンは大きく増えた |
max | 上限を測るとき、時間とトークンを気にしない稀な仕事。数学・研究のような答えの形が決まらない問題 | xhigh より遅くて高く、伸びは小さいことが多い |
表の中でいちばん大事なのは、公式の次の一文です。
Most of the gain in capability is already present at high, and above it, gains are uneven and depend on the task.(伸びの大半は high の時点で出ている。それより上の伸びはまちまちで、仕事による)
同じガイドは、medium から high に上げると、Anthropicが追っているコーディングと知的作業の評価のほとんどで点が上がったとも書いています。つまり「medium と high の間には差がある。high より上は、確かめないと差があるか分からない」というのが公式の見立てです。
low でも 5.1 の高い段に近い
Fable 5.2の low は、ただの「手抜きモード」ではありません。Anthropicの試験では、low での点数が Fable 5.1 の高い段の点数に近かったとされています。また発表では、medium の Fable 5.2 は難しい仕事を 5.1 より少ないトークンでこなすと書かれています。
発表には、effortの段をそろえずに費用で比べた結果も載っています。たとえば、Fable 5.2 の high は、あるコーディング評価で Opus 5.5 の最高段とほぼ同じ点を、1課題あたり約半分の費用で出しました。また別の評価では、Fable 5.2 の low が Opus 5.5 の最高点に並び、費用は10分の1未満でした。Fable 5.2は、低い段でも十分に戦える、ということです。どちらのモデルを選ぶかの話は、次の記事で詳しく比べています。
実測:同じ問題を5段すべてで解かせた
公式の目安が手元でどう出るかを確かめるため、2026年11月10日に、社内の無人ジョブ用のMac(Claude Code 2.1.296)で、Fable 5.2 に同じ問題を5段すべてで解かせました。非対話モード(claude -p)に --model claude-fable-5-2 --effort <段> を付け、各段1回ずつ実行しています。
問題は、答えを機械で確かめられる計算問題を2つと、あいさつ1つです。
- 問題A(やさしい):1〜1000の整数のうち、3または5で割り切れ、かつ7では割り切れないものはいくつか(正解401)
- 問題B(少し手間がかかる):1〜1000の整数のうち、各桁の数字の和が素数になるものをすべて足すといくつか(正解162948・道具は使わせない)
- あいさつ:「こんにちは」
結果:5段とも正解、跳ねたのは max だけ
段 | 問題A 出力トークン | 問題A 時間 | 問題B 出力トークン | 問題B 時間 |
|---|---|---|---|---|
low | 3 | 2.0秒 | 431 | 4.6秒 |
medium | 3 | 1.4秒 | 434 | 5.1秒 |
high | 112 | 2.1秒 | 677 | 6.5秒 |
xhigh | 107 | 2.2秒 | 729 | 6.6秒 |
max | 273 | 3.2秒 | 1,678 | 14.4秒 |
出力トークンは、考えた分も含んだ数です(Claude Codeが返す使用量の値)。時間はClaude Codeが返す処理時間です。
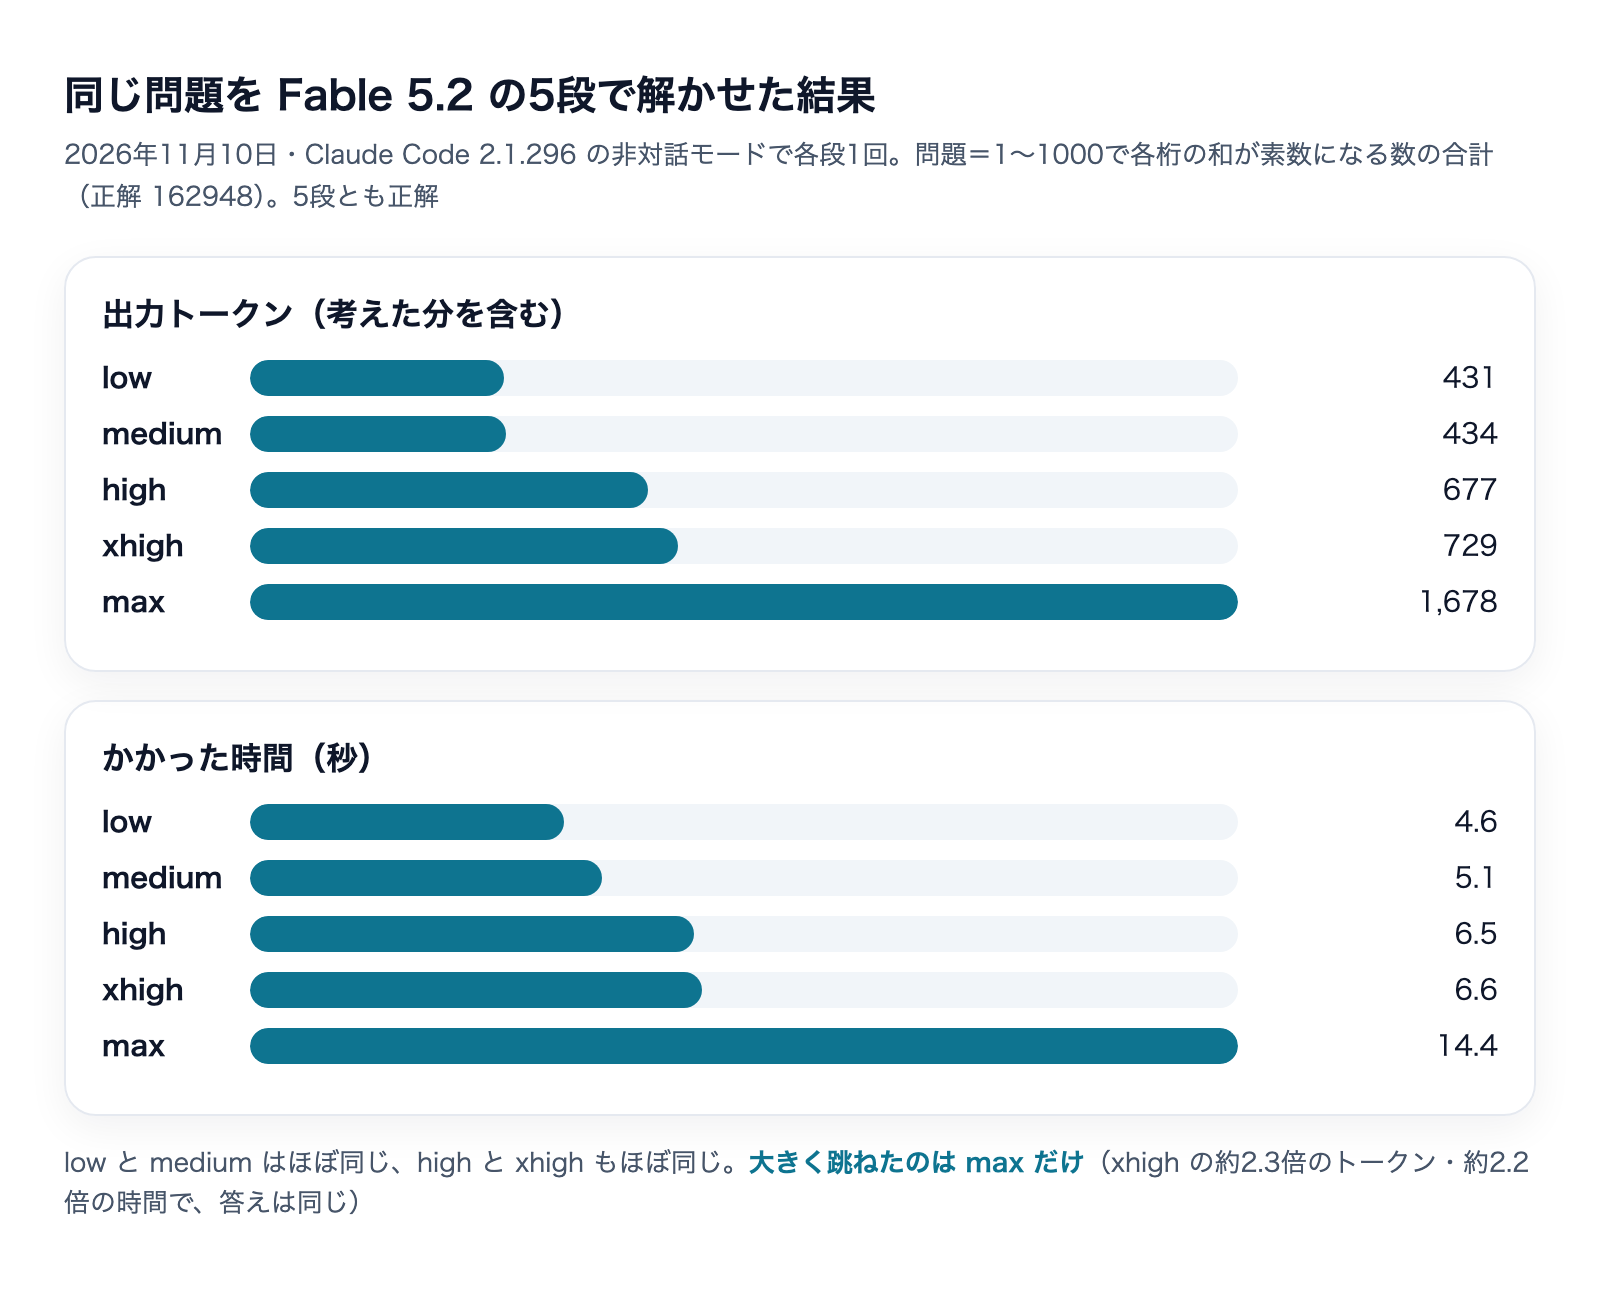
読み取れることは3つあります。
- やさしい問題では、low と medium は考えずに答えた:問題Aの出力は3トークンで、答えの数字だけです。公式の「低い段では、簡単な問題なら考えるのをまるごと飛ばすことがある」という説明どおりでした。high より上では100トークン前後を考えに使っています
- 段は2つずつ組になって動いた:問題Bでは、low と medium がほぼ同じ(431と434)、high と xhigh もほぼ同じ(677と729)でした。1段上げるたびに少しずつ増えるのではなく、medium→high で1段増えています
- max だけが大きく跳ねた:問題Bの max は xhigh の約2.3倍のトークンと約2.2倍の時間を使い、答えは同じでした。公式の「max は遅くて高く、伸びは小さいことが多い」を、小さな問題でもそのまま見た形です
あいさつでは、high でも考えなかった
公式のガイドには「high 以上では、あいさつへの返事も含めて、ほぼすべての返事の前に考える」とあります。ところが手元では、「こんにちは」に対して low と high のどちらも出力は22トークンで、返事の文も同じでした。考えた跡は見えませんでした。
理由は確かめられていません。各段1回だけの実行で、しかも手元のClaude Codeは2.1.296と古く、Fable 5.2 をモデル一覧に持っていない版です(実行のたびに「このモデルは一覧に無い」という警告が出ます)。公式が「ほぼすべて」と書いている以上、これを根拠に「high でもあいさつでは考えない」とは言えません。ただ、「high にすると簡単なやり取りまで必ず遅くなる」と決めつける必要もない、とは言えそうです。
この実測の限界
- 各段1回だけで、同じ条件をくり返したときのブレは測っていません。数字は「桁と傾向」として読んでください
- 短い計算問題なので、エージェント作業やコーディングのような長い仕事での差は表していません。公式が「high で伸びの大半が出る」と言っているのは、主に長い仕事の評価です
- Claude Codeを通した実行で、APIを直接呼んだ結果ではありません
5.1のeffort設定を持ち越さない理由
公式ドキュメントは、Fable 5.2 では5.1で調整した段を持ち越さず、測り直すよう求めています。理由は次の3つです。
同じ段でも、考える量がモデルごとに違う
段の並び順はモデル間でそろっていますが、各段の裏にある考える量はモデルごとに違う、と書かれています。5.1の high と 5.2 の high は同じ量ではありません。5.1で「この仕事は low で足りた」と確かめていても、5.2では測り直しが必要です。
前の世代でどう使い分けていたかは、Fable 5.1のeffortの記事で実測しています。5.1では high のまま使うと時間とコストが大きく伸びた、という結果でした。
「考えずに答えて」が効かなくなった
Fable 5.1は「考え込まずに直接答えて」のような指示によく従いました。Fable 5.2では、Anthropicの試験で、この種の指示を入れても medium 以上では考えるのを止めませんでした。公式は、この行を消して、代わりにeffortを下げるよう案内しています。
システムプロンプトやスキルに「考えすぎないで」と書いて速さを稼いでいた人は、5.2ではその行が効いていないと考えたほうが安全です。
プロンプトに書いたトークン予算が使い方を変える
作業の途中で「このタスクはあと何トークン使える」とプロンプトに書き込む仕組みを使っている場合、その数字の大きさでFable 5.2の使う量が変わります。high と xhigh のコーディング課題では、大きな予算の記載を消したほうが費用が下がり、成績は同じだった、と公式は書いています(APIの task budgets 機能の話ではありません)。
low・medium で長い作業をさせるときの注意
段を下げると、長い作業の途中で止まりやすくなります。公式のガイドは、Fable 5.2 が長い多段の仕事で、終わる前に「残りはこれです」と並べて止まったり、「続けますか」と聞いて止まったりすることがあり、low と medium で起きやすいと書いています。
対策として、公式は「やるべき仕事が残っているうちは止まらない。ふつうのエラーや待ち時間は原因を調べて乗り越える。意図的に置かれた制約には触れずに報告する」という趣旨の文をシステムプロンプトに足す案を出しています。Anthropicがコーディング製品の記録を medium で再生した試験では、この文で「やれる仕事を残して終わった回」がおよそ半分に減り、出力トークンは約30%増えました。
つまり、段を下げて節約した分の一部は、止まらせない指示で使い戻すことになります。無人で長く回す仕事なら、最初から high にしておくほうが素直な場合もあります。
high 以上で気をつけること
max_tokens は大きめにする
APIでは、max_tokens が出力全体(考える部分と返答の合計)の上限になります。公式は、high 以上では max_tokens を大きく取るよう書いています。上げた段で考える量が増えたのに上限が小さいままだと、返答の途中で切れます。Fable 5.2 の1回の出力の上限は12万8,000トークンです。
max は「上限を測る段」と割り切る
公式は max を、モデルの天井を測るときと、時間とトークンを気にしない稀な仕事のための段としています。max では、トークンの費用を気にせず能力を優先するため、xhigh より遅く高くなり、伸びは小さいことが多いとされます。日常の仕事の既定を max にする理由は、公式の記述からは見当たりません。
サブエージェントに注意(xhigh・max)
公式によると、xhigh や max では、Fable 5.2 がサブエージェントを使って自分の仕事を見直すことがあり、これは5.1では見られなかった動きです。サブエージェントはセッションの費用の大きな割合を占めることがあるため、使っているツールがサブエージェントを何のモデルで動かすかを確かめておくよう案内されています。Claude Codeのサブエージェントで段を指定する方法は、次の記事で扱っています。
APIでeffortを指定する
Messages APIでは、リクエストの output_config.effort に段の名前を入れます。ベータのヘッダーは要りません。
{
  "model": "claude-fable-5-2",
  "max_tokens": 32000,
  "output_config": { "effort": "medium" },
  "messages": [
    { "role": "user", "content": "この仕様書の矛盾点を3つ挙げてください" }
  ]
}
Fable 5.2で気をつける点が2つあります。公式の概要ページによると、考える処理は常にオンで切れないので、考える量はeffortで動かします。また temperature・top_p・top_k は送らないよう書かれています(値によっては400エラーになります)。adaptive は考え方のモードの名前で、effortの値ではない点にも注意してください。
会話の途中で段を変える(ベータ)
Fable 5.2 は、会話の途中で段を変える「メッセージごとのeffort」(ベータ)にClaude APIで対応しています。anthropic-beta: mid-conversation-output-config-2026-07-01 のヘッダーを付け、会話の中に中身が空の system メッセージを置いて、そこに新しい段を書きます。
"messages": [
  { "role": "user", "content": "移行計画を3段階で立ててください" },
  { "role": "assistant", "content": "1. ... 2. ... 3. ..." },
  { "role": "system", "content": [], "output_config": { "effort": "low" } },
  { "role": "user", "content": "今の計画を1文でまとめてください" }
]
この書き方なら、それより前の部分が変わらないので、プロンプトキャッシュが生きたままです。一方、次のリクエストで一番上の effort を書き換える方法では、キャッシュが最初からやり直しになります。
公式のガイドは、この仕組みを使って「計画と手直しは medium で進め、人が見ていない長い部分だけ段を上げる」ような混ぜ方を例に挙げています。対応している提供先はドキュメントで一覧になっており、Claude APIのほか、Google CloudのClaudeモデル(Google管理・Anthropic管理の両方)などが載っています(2026年11月10日時点)。
私たちの使い分け
公式の目安と手元の実測を合わせて、私たちは次のように使い分けることにしました。
仕事 | 段 | 理由 |
|---|---|---|
質問への回答・短い書き直し・分類 | low | やさしい問題は考えずに答え、速い。5.1の高い段に近い点が出る |
対話しながらの調べもの・コードの手直し | medium | Claude Codeの既定のまま。人が見ているので、途中で止まっても指示を足せる |
人が見ていない長い仕事(記事づくり・一括の作業) | high | 伸びの大半はここで出る。low・medium の「途中で止まる」を避けられる |
大きな設計判断・長い難題 | high から始め、差が出たときだけ xhigh | xhigh の伸びは仕事による。確かめてから上げる |
日常の仕事 | max は使わない | 実測でも、同じ答えに倍以上のトークンと時間を使った |
迷ったときの順番は、公式の移行手順と同じです。まず high を明示して自分の仕事で試し、次に medium と xhigh でも試して、品質と時間・費用を並べて決めます。effortは仕事ごとに決めるもので、1つの値に固定するものではありません。
Opus 5.5 で既定が medium になったときの考え方は、次の記事に書いています。Claude Code では Fable 5.2 も medium から始まるので、同じ考え方が使えます。
よくある質問
Fable 5.2のeffortの既定はいくつですか?
Claude APIでは high、Claudeのアプリと Claude Code では medium です(2026年11月10日時点)。Fable 5.1 の Claude Code の既定は high だったので、Claude Code では1段下がっています。
effortを下げると返答は短くなりますか?
ほとんど変わりません。Fable 5.2 では、effortは考える量と時間・トークンを動かしますが、返答の長さはほぼ変わらないと公式に書かれています。長さや口調は指示文で伝えます。
max にすれば一番いい答えが出ますか?
出ることもありますが、伸びは小さいことが多く、時間とトークンは xhigh より増えます。公式は max を上限を測るときと稀な仕事のための段としています。手元の小さな問題でも、max は xhigh の約2.3倍のトークンを使って同じ答えでした。
考える処理を切ることはできますか?
できません。Fable 5.2 では考える処理が常にオンです。考える量を減らしたいときは、effortを low か medium に下げます。「考えずに答えて」という指示は、medium 以上では効かなかったと公式の試験で報告されています。
会話の途中で段を変えるとキャッシュは消えますか?
メッセージごとのeffort(ベータ)を使えば消えません。リクエストの一番上の値を書き換える方法では、キャッシュが最初からやり直しになります。
まとめ
- Claude Fable 5.2 のeffortは low・medium・high・xhigh・max の5段。考える処理は常にオンで、effortが主なつまみ
- 既定は API が high、アプリと Claude Code が medium。Claude Code は 5.1 の high から1段下がった
- 公式の答えは「high から始め、品質が保てると確かめた所だけ下げる。xhigh は測って伸びた所だけ、max は上限を測るときだけ」
- 手元の実測では5段とも正解。low と medium、high と xhigh がそれぞれ近く、max だけが2倍強の時間とトークンを使った
- 5.1 の段や「考えずに答えて」の指示は持ち越さない。段を下げた長い仕事では、止まらせない指示を足す
effortは、同じモデルの中で費用と速さと深さを動かせる、いちばん手軽な設定です。株式会社Fyveでも、仕事ごとに段を決めて記録を取りながら、Fable 5.2 の使いどころを確かめていきます。
※ 本記事の仕様・既定値は2026年11月10日時点の公式情報にもとづきます。最新の内容は Anthropic の公式ドキュメントでご確認ください。
Fable 5、賢いけど高い。を解決する。

最上位モデルを、コストを抑えて使いこなす設計図(全29ページ)
Fable 5は強力ですが、何でも任せるとトークンをただ溶かします。1人会社を丸ごとAIで回している実運用から、「どの仕事をFable 5に任せ、どれを安いモデルに回すか」の配置を全部公開します。
- Fable 5に任せる仕事/安いモデルに回す仕事の線引き
- モデル別トークン消費の実測比較
- そのままコピペできるCLAUDE.md設定
- 1人会社の全業務×モデル対応表
メールアドレス登録で他にも様々な資料を閲覧できます
 +10
PDF 19点・合計499ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。