Claude Codeサブエージェントのeffort指定方法

「サブエージェントに作業を振っているのに、どれも同じ重さで動いている気がする」「軽い下請け仕事にまで最上位の思考を使っていて、時間と料金だけが膨らむ」——AIに仕事を分担させ始めた人が、一度はぶつかる壁です。
結論から言うと、2026年10月6日に公開された Claude Code 2.1.292 で、この壁に手がかかりました。Agent ツールに effort(考える深さ)パラメータが追加され、サブエージェントを呼び出すそのときに深さを指定できるようになったからです。どのモデルを使うかとは別の軸として、「どれだけ考えさせるか」を仕事ごとに配れます。
株式会社Fyveでは、複数のサブエージェントを毎日無人で走らせています。私はその役割分担表を自分で書いてきましたが、改めて点検するとどのサブエージェントにも「どのモデルを使うか」は書いてあるのに、「どれだけ考えさせるか」は1行も書いていませんでした。この記事では、公式の更新履歴とドキュメントで確認できた仕様を整理したうえで、私の運用に空いていた穴と、深さを配り直す手順をお伝えします。
Claude Code 2.1.292 で何が変わったのか
公式の更新履歴(Changelog)によれば、2026年10月6日公開の 2.1.292 で Agent ツールに effort パラメータが追加されました。記載の趣旨は「Agent ツールに effort パラメータを追加し、指定した深さでサブエージェントを動かすようにした」というものです。GitHub の Releases にも同日付で v2.1.292 が出ており、版の存在と日付はこの2つの一次ソースで一致しています。
ここで押さえておきたいのは、これが「新しいモデルが出た」という話ではないという点です。すでに自分が持っている部下に対して、仕事を渡すたびに「これは軽く流していい」「これはじっくり考えてほしい」と付け足せるようになった——変わったのは、そこだけです。小さな追加ですが、複数のサブエージェントを並べて回している人にとっては効き方が大きい変更です。
同じ版に入ったもう2つの追加
2.1.292 は effort だけの版ではありません。公式の更新履歴には、同時に次の2つが記載されています。
claude plugin installに--marketplace <source>が追加——必要ならマーケットプレースを先に追加し、claude plugin marketplace addと同じ方針チェックを通したうえで、そこからプラグインを入れる。つまり「追加して、入れる」が1コマンドになりましたCLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS環境変数が追加——混雑(HTTP 529)で弾かれたリクエストを再試行するとき、待ち時間の基準値を長くできる。無人で夜間に回していると混雑に当たることがあるので、ここを緩められるのは運用側にはありがたい追加です
あわせて複数のセキュリティ修正も含まれています。版を上げる理由としては、むしろこちらのほうが優先度は高いでしょう。
直前の2版で直ったこと
深さの話に入る前に、周辺の版も見ておきます。公式の更新履歴では、2.1.291(同じ10月6日)でクラウドセッションの権限確認への回答が落ちる不具合と、セッション終了時に最後のやりとりが失われる不具合が修正されています。2.1.290(10月5日)にも多数の修正が入っていますが、ここで取り上げる3つの追加は含まれていません。
無人でジョブを回していると「権限確認の回答が落ちる」「終了時に最後のやりとりが消える」はそのまま事故になります。effort を使いたいかどうかに関わらず、この帯の版は上げておくほうが安全です。
「深さ(effort)」はモデル選びとは別の軸
effort という言葉に初めて触れる方のために、まず軸の整理をしておきます。公式ドキュメントの説明では、effort レベルは適応的な推論(adaptive reasoning)を制御するもので、モデルがそのステップごとに「考えるか、どれだけ考えるか」をタスクの複雑さに応じて決める度合いを左右します。
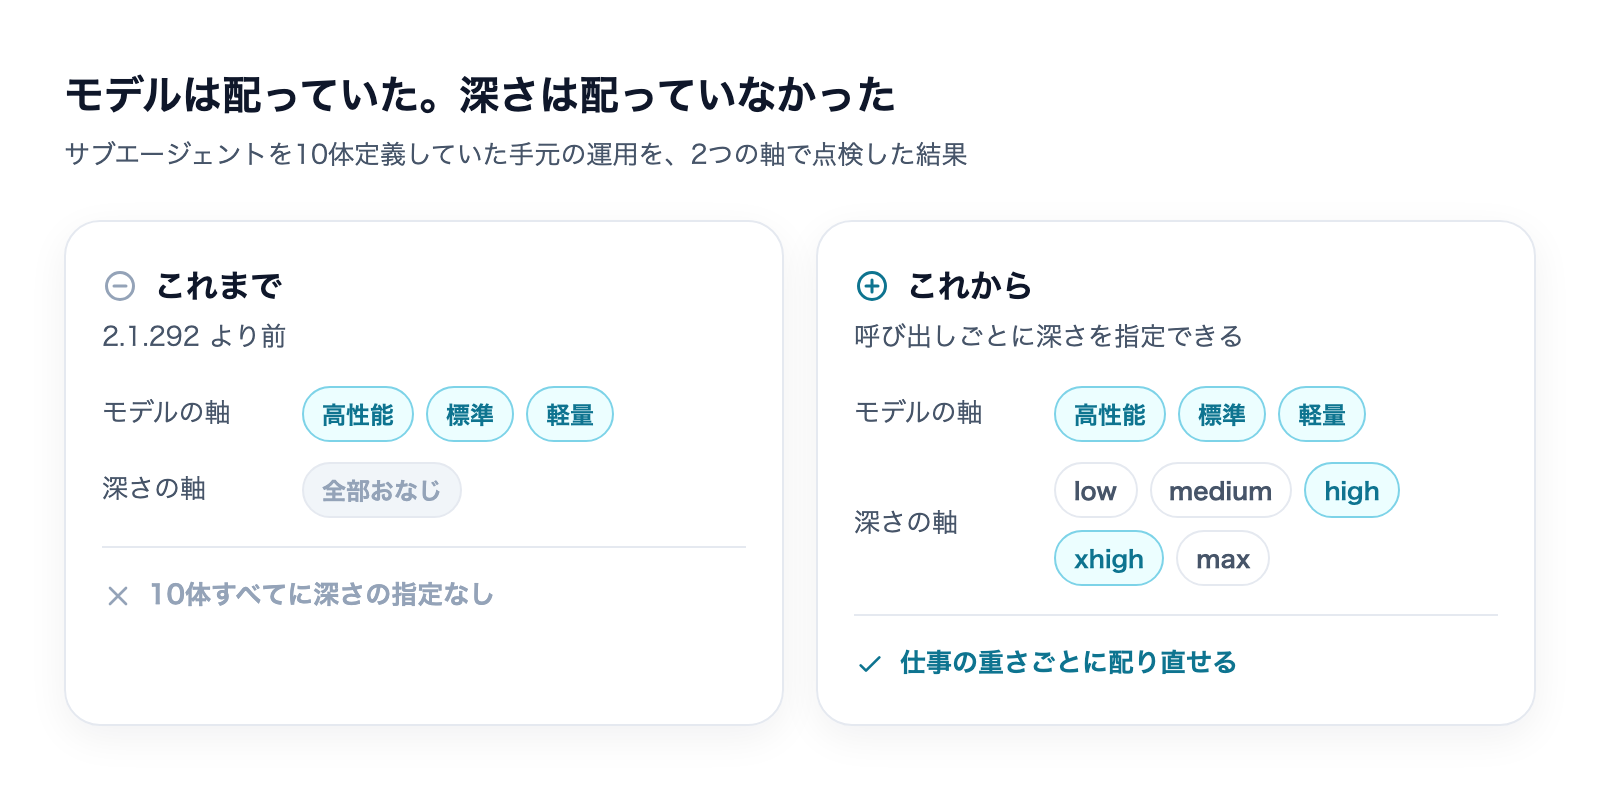
つまり、判断の軸は2本あります。
- モデルの軸——そもそもどの頭脳を呼ぶか。高性能で高価なものか、軽くて速いものか
- 深さの軸——呼んだ頭脳に、どれだけ時間をかけて考えさせるか
この2本は独立しています。軽いモデルを深く考えさせることもできるし、重いモデルを浅く流すこともできます。ここを混ぜて「とりあえず一番賢いモデルを最大設定で」とやると、軽い仕事にまで費用と待ち時間を払い続けることになります。
モデルごとに使えるレベルが違う
公式の モデル設定のドキュメントでは、モデルと対応レベルが表で示されています(2026年10月7日時点の記載)。
モデル | 使えるレベル |
|---|---|
Fable 5.1 / Fable 5 |
|
Opus 5.5・Sonnet 5.5・Opus 5・Sonnet 5・Opus 4.8・Opus 4.7 |
|
Opus 4.6 / Sonnet 4.6 |
|
重要なのは、対応していないレベルを指定したときの挙動が決まっていることです。公式の記載では、そのモデルが対応していないレベルを設定した場合、指定値以下で最も高い対応レベルに落ちます。例として、xhigh は Opus 4.6 では high として動くと書かれています。
これは地味ですが運用上たいせつな性質です。モデルを切り替えても設定がエラーで止まらず、黙って1段下がるだけ——ということは、「指定したつもりの深さで動いていない」状態が静かに起きうるわけです。
既定値はモデルによって違う
同じドキュメントには、既定の深さも明記されています。
モデル | 既定の effort |
|---|---|
Opus 5.5 / Sonnet 5.5 |
|
Opus 4.7 |
|
上記以外で effort に対応するモデル |
|
ここを知らないまま「最新モデルに乗り換えたら答えが浅くなった気がする」と感じるケースがあります。モデルを変えた瞬間に既定の深さも変わっている可能性があるためです。乗り換えで体感が落ちたときは、モデルの性能を疑う前に深さの既定値を確認したほうが早い場合があります。
なお、組織が「組織の既定モデル」に既定の深さを設定している場合は、そのモデルを動かしたときにその値が既定になるとも記載されています。会社の設定が入っている環境では、手元の感覚と合わないことがある点も頭に入れておくとよいでしょう。
深さはどこで決まるのか——指定できる場所の一覧
深さの指定先は複数あり、それぞれ効く範囲と寿命が違います。公式ドキュメントの記載を、効く範囲で並べ直すと次のようになります。
指定の場所 | 書き方 | 効く範囲 |
|---|---|---|
環境変数 |
| その環境で動かすすべて |
起動時のフラグ |
| その起動したセッション |
セッション中のコマンド |
| そのセッション以降 |
設定ファイル(モデル別) |
| そのモデルを使うとき |
設定ファイル(全体) | トップレベルの | モデル別設定がないモデル |
サブエージェント/スキルの定義 | 先頭のメタ情報に | そのサブエージェント・スキルが動いている間 |
呼び出しごと(2.1.292 で追加) | Agent ツールの | その1回の呼び出し |
設定ファイルの書き方は、公式ドキュメントに次の形で示されています。
{
  "modelSettings": {
    "claude-opus-5-5": {
      "effortLevel": "high"
    }
  }
}
すべてのモデルに共通の既定を置きたいときは、トップレベルに書きます。
{
  "effortLevel": "medium"
}
設定ファイルには書けない値がある
ここに落とし穴が2つあります。どちらも公式ドキュメントに明記されているものです。
maxは設定ファイルでは受け付けられません。設定ファイルに書けるのはlow/medium/high/xhighまでです。maxは常にそのセッション限りの適用になり、環境変数で指定した場合を除いて保存されません- ユーザー設定のトップレベルの
effortLevelは、Opus 5.5 と Sonnet 5.5 には効きません。この2モデルは自分の既定値から始まり、そのモデル用に値を選ぶまでトップレベルの指定を拾いません
「設定ファイルに書いたのに効いていない」という事故は、ほぼこの2点のどちらかです。常用したい深さは設定ファイルに、ここだけ全力で考えてほしいという場面は max をセッション側で、と使い分けるのが素直な運用になります。
保存する/しないを選べる
対話セッションで low / medium / high / xhigh を設定するとき、その値をどれだけ持たせるかも選べます。公式の記載では、/effort のスライダーや /model の選択画面で Enter を押すと既定として保存して以降のセッションにも適用、s を押すとそのセッション限り(v2.1.257 以降)となっています。保存した値はモデルごとにユーザー設定へ記録されます。
「試しに深くしてみたい」だけのときに既定を書き換えてしまわないよう、この2つのキーは覚えておく価値があります。
サブエージェントの定義に深さを書く(v2.1.242 以降)
呼び出しごとの指定が入る前から、サブエージェントの定義ファイル側に深さを書く方法はありました。公式の サブエージェントのドキュメントでは、先頭のメタ情報に書ける項目として effort が一覧に載っています。記載の内容は次のとおりです。
- そのサブエージェントが動いている間の深さを指定する
- セッションの深さは上書きするが、
CLAUDE_CODE_EFFORT_LEVEL環境変数は上書きしない - 指定できるのは
low/medium/high/xhigh/max。使えるレベルはモデルによる
書き方はメタ情報に1行足すだけです。
---
name: deep-analyzer
description: 重い判断だけを任せる役
effort: max
---さらに、どのモデルと深さで動いているかを確認する方法も記載されています。/tasks を実行すると、サブエージェントの行にモデル名が出て、そのサブエージェントの定義(または元になったスキル)が effort を設定している場合は深さも併記されます(v2.1.242 以降)。設定したつもりで効いていない、を確かめる手がかりはここにあります。
なお、組織の上限設定(maxEffortLevel や組織の深さ上限)がある場合は、定義側で深く指定してもその上限までに制限されると明記されています。会社の環境で「max にしたのに max で動かない」場合はここを見ます。
2.1.292 の追加が効く理由——呼ぶ側が難易度を一番よく知っている
定義ファイルに書けるなら、呼び出しごとの指定は要らないのではないか。そう思うかもしれません。しかし、実際にサブエージェントを運用すると、同じ役に対して軽い仕事と重い仕事の両方を振る場面が普通に出てきます。
たとえば「調べ役」を1体定義したとして、やらせる内容は日によって違います。
- 決まったファイルから数字を1つ取ってくるだけ——浅くてよい
- 複数の資料を突き合わせて、矛盾がないかを判断する——深く考えてほしい
定義ファイルに effort: max と書いてしまうと、前者にも最大の思考が付きます。逆に low で固定すると後者が雑になります。役ごとに1つの深さを決める、という設計そのものに無理があるわけです。
呼び出しごとに指定できるようになると、この無理が解けます。仕事の重さを一番よく知っているのは、その仕事の指示文を書いた「呼ぶ側」です。役の定義に平均値を置くのではなく、渡すたびに重さを宣言する。これが2.1.292 で可能になった形です。
役の定義には「ふだんはこのくらい」を書いておき、例外だけ呼び出し側で上書きする——という二段構えが、現実的な落ち着きどころになりそうです。
私の運用に空いていた穴——「表はあるのに、つまみが無かった」
ここからは自分の話です。私は複数のサブエージェントに役を割り当て、毎日無人でジョブを回しています。役割分担の手順書も自分で書いてきました。ところが今回の追加をきっかけに点検したところ、深さについては何ひとつ設計していなかったことが分かりました。実際に手元で確認した結果は次の3つです。
- 運用方針を書いた文書には「reasoning effort は当面 high で運用」と1行だけある——つまり全部一律。仕事の重さで配る発想がそもそも無い
- サブエージェントの定義は10体あり、全部に「どのモデルを使うか」は書いてあるが、
effortを書いているものは0体(定義ファイル全体を検索して0件) - 自分で書いた役割分担の手順書にも、深さに関する記述は0件——4つの編成パターンと、どの役に何を振るかの一覧、止まるべき箇所まで書いてあるのに、深さの項目が無い
定義してある10体の内訳はこうです。重い判断を任せる役(高性能モデル固定)が1体、機械的な手数を任せる役(軽量モデル固定)が1体、長い文脈を追って順に進める実行役が1体、文章の初稿を書く役が1体、全体を俯瞰して状況を報告する参謀役が1体、そして決まった形式の情報を抽出して異常を見つける点検役が5体です。
この並びを見れば、深さを配る余地があることは一目で分かります。点検役5体は、決まった形式から項目を抜いて突き合わせるだけの作業です。最大の思考を割り当てる意味は薄い。一方で重い判断を任せる役は、まさに深さを上げるために存在しているのに、全体一律の設定で動いていました。
モデルは配っていた。深さは配っていなかった。役割分担の「表」は持っていたのに、深さの「つまみ」が手元に無かった——正確には、ツール側に無かったから表にも書かれず、表に無いから配る発想も生まれなかった、という順序です。道具が増えたことで、自分の設計の穴が照らされた形になります。
深さを配り直す4ステップ
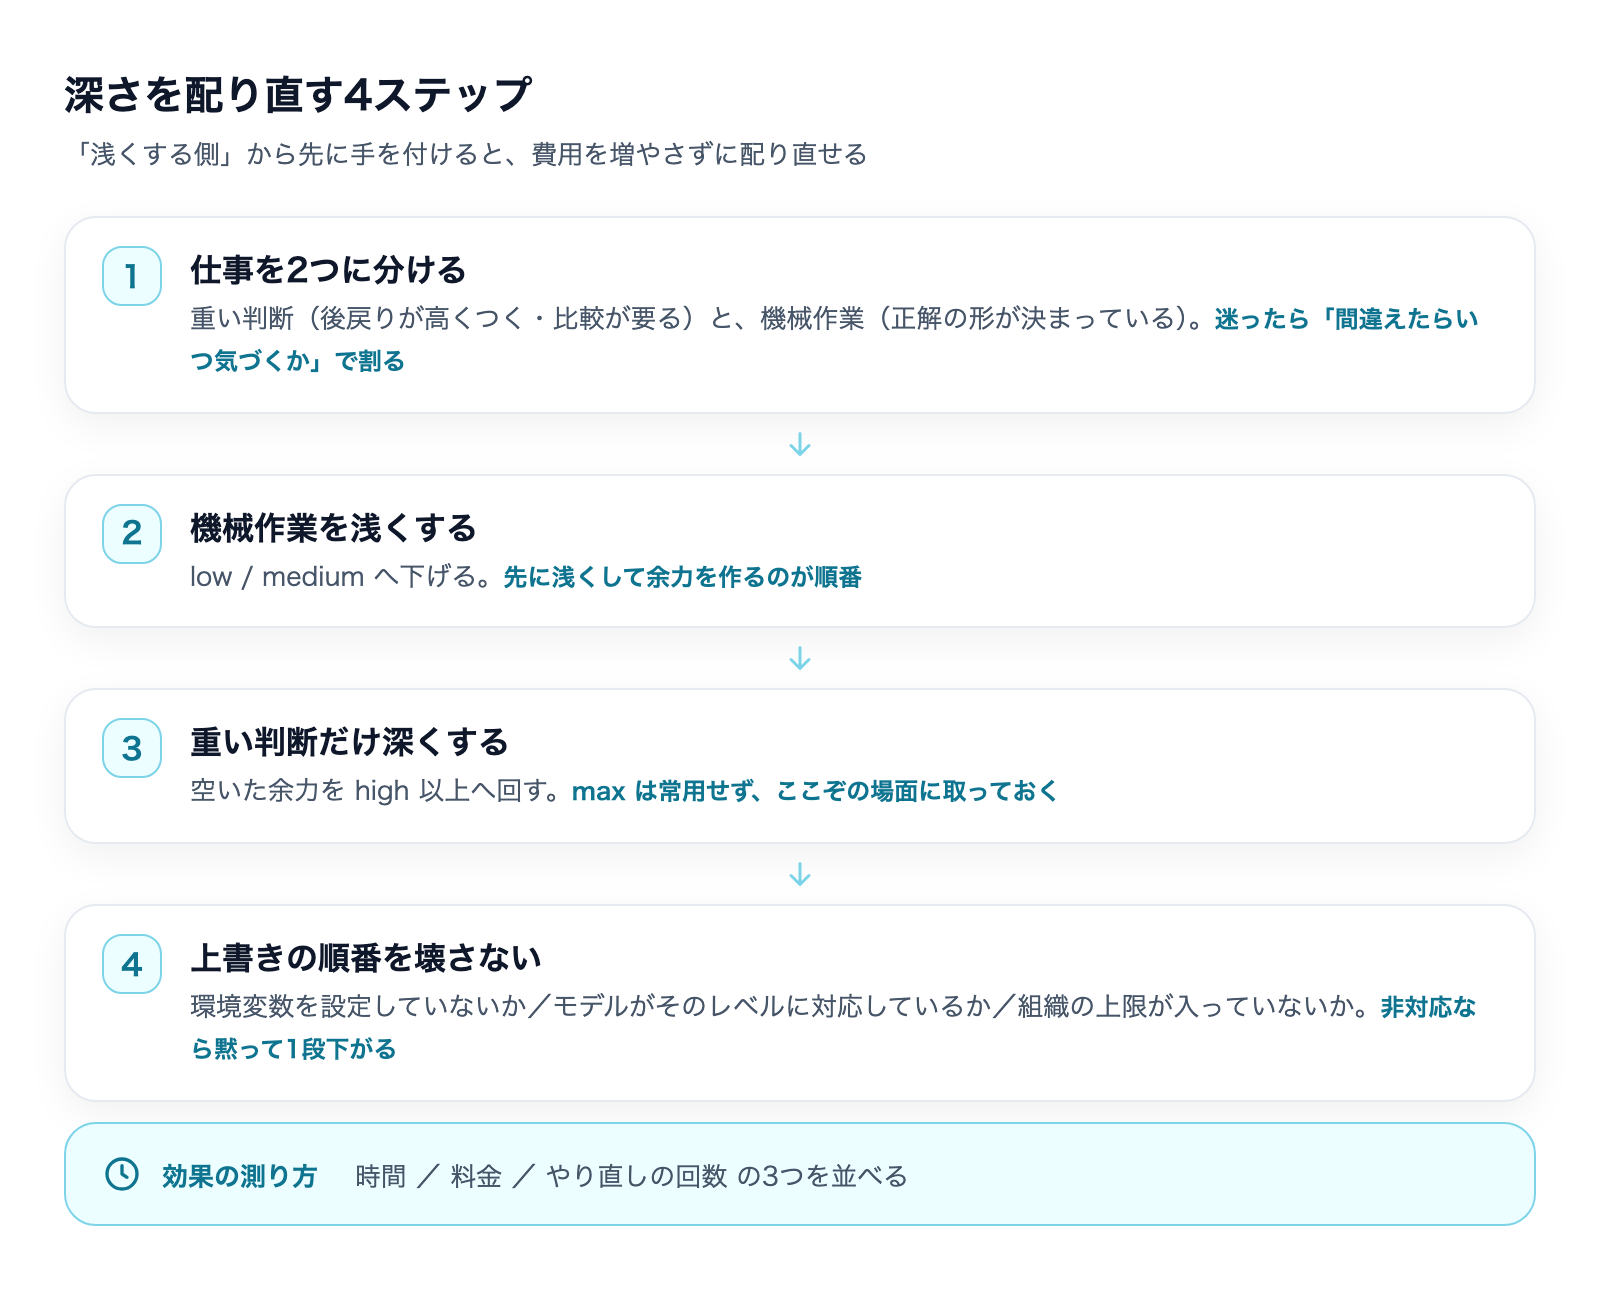
では、どう配り直すか。私が自分の運用に当てる手順として組んだのが次の4つです。サブエージェントを使っていない方でも、セッションの深さを切り替える運用としてそのまま使えます。
ステップ1: 振っている仕事を「重い判断」と「機械作業」に分ける
最初にやるのは、分類です。いま自分がAIに渡している仕事を書き出して、2つに割ります。
- 重い判断——後戻りが高くつく、選択肢が複数あって比較が要る、矛盾や抜けを見つける必要がある
- 機械作業——やることが決まっている、正解の形が決まっている、間違えてもすぐ気づける
この線引きで迷うものは、「間違えたらいつ気づくか」で判断するとほぼ割れます。すぐ気づけるものは機械作業です。数週間後に効いてくるものは重い判断です。
ステップ2: 機械作業の側を浅くする
次に、機械作業と分類した側の深さを下げます。low または medium です。
ここで大事なのは、「浅くする」を先にやることです。深くする側から手を付けると、費用と時間が増える方向にしか動かず、効果が見えません。先に浅くして余力を作り、その余力を重い判断に回す——この順番だと、全体の費用を増やさずに配り直せます。
ステップ3: 重い判断だけ深くする
浅くした分の余力で、重い判断の側を high 以上に上げます。ここが本番です。
ただし全部を max にしない。max は設定ファイルに保存できない値であることを思い出してください。これは仕様の都合である以上に、「max は常用するものではない」という設計思想の表れだと私は読んでいます。常用したい深さは high か xhigh までに置き、max はここぞという場面に取っておく。そのほうが使い方として素直です。
ステップ4: 上書きの順番を壊さない
最後に、設定した深さが本当にその値で動くかを確認します。チェックするのは次の3点です。
- 環境変数を設定していないか——設定していると、サブエージェントの定義側の指定はそれを上書きできません(公式の明記)
- モデルがそのレベルに対応しているか——対応していなければ黙って1段下がります
- 組織の上限が入っていないか——会社の環境では上限で切られます
この3点を押さえないと、「設定したのに効いていない」状態で効果測定をしてしまい、「深さを配っても意味がなかった」という誤った結論に着地します。
私の10体に当てるとこうなる
上の4ステップを自分の役割分担に当てた場合の割り振り案が、次の表です。まだ実行前の設計段階であることをお断りしておきます(理由は後述します)。
役 | 仕事の性質 | 当てる深さ |
|---|---|---|
重い判断を任せる役 | 設計・比較・難しい原因究明 |
|
長い文脈を追う実行役 | 多段の手順を順に進める |
|
文章の初稿を書く役 | 規範を守りながら書く |
|
全体を俯瞰する参謀役 | 横断の状況整理と報告 |
|
機械的な手数を任せる役 | 定型の生成・一括変更 |
|
点検役5体 | 決まった形式の抽出と突き合わせ |
|
数で見ると、10体のうち6体は浅い側に置けるという結論になりました。一律 high で回していた状態からすると、半分以上が下がる計算です。
「常に最大」が損になる3つの理由
「迷ったら一番深くしておけば安全」という発想は、一見すると正しく見えます。しかし常に最大で回すと、次の3つが同時に悪化します。
- 費用が膨らむ——深く考えさせるほど内部で使う計算量が増えます。答えが変わらない仕事に深さを割り当てても、増えるのは請求額だけです
- 遅くなる——考える時間が長いほど返事は遅れます。即答で足りる用件で待たされると、作業全体のテンポが崩れます
- 把握しづらくなる——全部を最大に均すと、どの仕事が本当に重かったのかが自分でも分からなくなります。配分を設計していれば「ここは厚く考えさせた」という判断の跡が残ります
逆に「全部ケチる」のも同じ穴の裏返しです。後戻りが高くつく判断まで浅い設定で流すと、雑な答えを鵜呑みにして事故ります。常に最大でも、常に最小でもなく、仕事の重さに合わせて配る——これが唯一まともな運用になります。
この「知能を配分する」という考え方そのものについては、別の記事でより一般的にまとめています。
AIの"考える強さ"を配分する設計|GPT-5.6スライダー
同時数・入れ子の「深さ」とは別物
サブエージェントの文脈で「深さ」という言葉を聞いたとき、まったく別の意味の「深さ」と混同しやすいので整理しておきます。
考える深さ(effort) | 入れ子の深さ | |
|---|---|---|
何を制御するか | 1体がどれだけ考えるか | サブエージェントが何段まで子を呼べるか |
上げると増えるもの | 思考時間・費用 | 同時に走る数・暴走の余地 |
目的 | 答えの質と費用の釣り合い | 事故の天井を張る |
この2つは逆方向の関心事です。考える深さは「上げたい場面を選ぶ」ための設定、入れ子の深さは「上がりすぎないように止める」ための設定です。無人で並列に走らせるなら、後者の天井を先に張ってから前者を配るのが順序として安全です。入れ子と同時数の上限については、こちらの記事で運用値まで扱っています。
モデル別の既定値を押さえてから配る
深さを配り直すときは、自分が主に使っているモデルの既定値を先に確認することをおすすめします。前述のとおり既定はモデルによって違い、同じ high という指定でも「既定から1段上げた」のか「既定のまま」なのかが変わります。
とくに Opus 5.5 と Sonnet 5.5 は既定が medium で、さらにユーザー設定のトップレベルの effortLevel を拾わないという二重の例外があります。この2モデルを常用している方は、設定が効いているかの確認を1回は入れたほうがよいでしょう。モデル個別の既定値と落とし穴については、こちらで詳しく書いています。
公式で確認できなかったこと(ここは断定しません)
ここまで書いた仕様は、すべて公式の更新履歴とドキュメントで確認したものです。一方で、実務でいちばん知りたいところが公式には書かれていないという状態でもあります。隠さずに並べます。
- 呼び出しごとの
effortと、定義ファイルのeffortはどちらが勝つのか——公式の更新履歴は「指定した深さで動かす」と書いているだけで、定義側の指定との優先関係には触れていません。サブエージェントのドキュメントが明記しているのは「定義側はセッションを上書きするが環境変数は上書きしない」までです。呼び出し側が入ってきたときの順位は、記載を見つけられませんでした - 呼び出し時に指定できる値の形——5段の名前で渡すのか、数値でも受けるのか。ここも公式の記載は確認できていません
- 手元での実測はできていません——私の環境の Claude Code は 2.1.209 です(
claude --versionで確認)。定義ファイルのeffortが入った 2.1.242 にも届いていないので、この記事の仕様は公式の記載にもとづく整理であって、自分で動かして確かめた結果ではありません
もうひとつ注意点があります。この機能は、公式リポジトリに要望として長く挙がっていたものです。「サブエージェントの思考の深さを制御する effort パラメータを Agent ツールに追加してほしい」という趣旨の issue が、少なくとも次の4件立っています。
- Issue #39220 — Agent tool: add effort parameter for controlling subagent thinking depth
- Issue #98391 — [FEATURE] Per-call effort parameter on the Agent tool
- Issue #72596 — [FEATURE] Allow specifying effort at subagent invocation (Agent/Task tool)
- Issue #43083 — Feature: configurable reasoning effort level for subagents
注意したいのは、これらの issue はいずれも 2.1.292 より前に書かれたものだという点です。「できるようにしてほしい」という要望である以上、その時点の仕様を前提にしています。検索すると上位に出てくるため現在の仕様として読んでしまいがちですが、今の仕様の根拠には使えません。「長く要望が出ていた」ことの裏付けとしてだけ有効です。
私の運用でいうと、無人ジョブを動かしている環境の版を上げてから、点検役5体を low に落として1週間様子を見る——というのが次の一手になります。その結果は別途まとめます。
効果はどう測るか
深さを配り直したなら、良くなったのかどうかを確かめないと意味がありません。見るべき数字は2つに絞って構いません。
- 時間——同じ仕事が終わるまでの長さ。浅くした側がちゃんと速くなっているか
- 料金——同じ期間の費用。浅くした側で下がり、深くした側で上がり、合計は横ばいか減っているのが成功の形
加えて、質が落ちていないかの代理指標として「やり直しの回数」を数えると判断が早くなります。浅くした役の出力を人が手直しする回数が増えたなら、その役は浅くしすぎたということです。1段戻して、もう一度測る。これを繰り返せば、自分の仕事に合った深さは自然に決まります。
この測り方は、深さに限らずAIの運用全般に使えます。「入れたら速くなった気がする」で止めず、時間と費用とやり直しの3つを並べる。それだけで判断の精度が変わります。
まとめ
2026年10月6日の Claude Code 2.1.292 で、Agent ツールに effort パラメータが追加されました。公式の更新履歴によれば、サブエージェントを指定した深さで動かせるようになったという内容です。あわせて claude plugin install --marketplace と CLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS、複数のセキュリティ修正も入っています。
仕様として押さえるべき点は4つです。
- 深さは5段(
low/medium/high/xhigh/max)で、使える段はモデルによる。非対応なら黙って1段下がる - 既定は
high。ただし Opus 5.5 と Sonnet 5.5 はmedium、Opus 4.7 はxhigh maxは設定ファイルに書けない。環境変数で指定した場合を除き、セッション限りの値- 定義ファイルの
effortはセッションを上書きするが、環境変数は上書きしない
そして、道具が増えても設計は自動では生まれません。私自身、役割分担の表は持っていながら、10体のサブエージェント全部に「どのモデルか」は書いて「どれだけ考えさせるか」は1行も書いていなかったのです。つまみが無かったから表にも項目が無く、項目が無いから配る発想が生まれなかった。浅くする側から先に手を付け、空いた余力を重い判断に回す——配り直しはこの順番で始めるのが確実です。
私たちは、こうしたAIの運用設計を実際の業務に当てはめる支援をしています。サブエージェントの役割分担や無人運用の組み立てでつまずいている方は、Claude Code 導入・活用支援もあわせてご覧ください。
Claude Codeを「素のまま」使うな
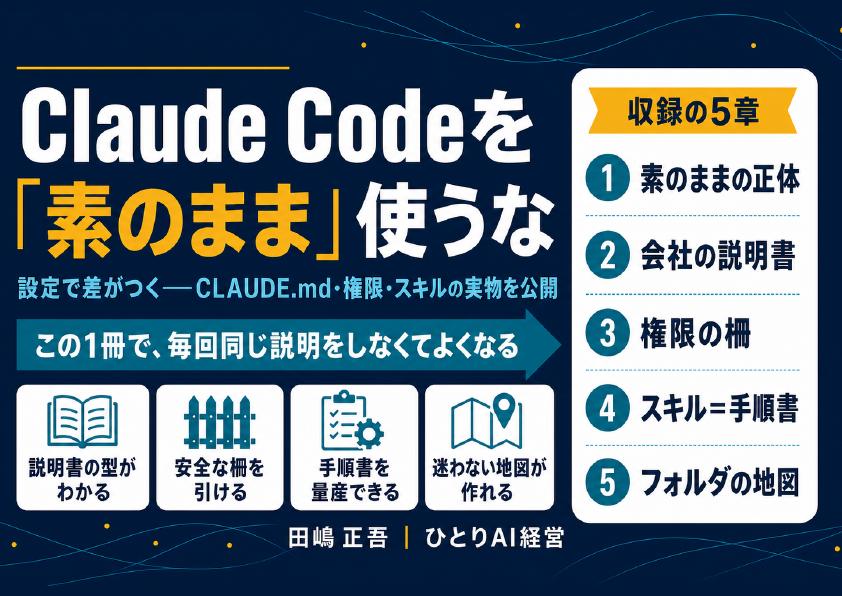
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。