ナビエ・ストークス問題をAIが解いた?|答え合わせができる仕事

「AIがナビエ・ストークス問題を解いたらしい。それで、うちの仕事は何か変わるのか」——AIが数学の未解決問題を解いたというニュースを見たとき、経営者が最初に思うのはこれだと思います。
結論から言うと、今回いちばん効いたのは10,000体という台数ではありません。答えが正しいかどうかを機械で確かめられる形に、問題を置けたことです。そしてこの条件は、日々の業務のほとんどでは揃いません。
株式会社Fyveは、記事の執筆から公開までを無人のAIジョブとして毎日走らせています。この記事では、発表された内容を一次資料で整理したうえで、「答え合わせの装置がある仕事」と「ない仕事」の線引きを、実際に自社で壊れた例まで含めてお伝えします。
何が発表されたのか|ナビエストークス問題とミレニアム懸賞問題
まず事実関係を押さえます。ここを曖昧にしたまま示唆だけを語ると、あとで足元が崩れます。
発表の概要
OpenAIは2026年9月8日、ナビエ・ストークス方程式の「存在と滑らかさ」に関する問題の解決を発表しました(発表日はNatureのニュース記事の記載に拠ります)。同社の公開ページによると、証明を生み出したのは未公開の社内モデルで、同社は「GPT‑6 Astraよりも大幅に高性能」と説明しています。
このモデルは2026年8月28日から訓練が始まっており、発表時点でも訓練は継続中だとされています。つまり今回の成果は、一般に提供されている製品で再現できるものではありません。ここは最初に押さえておく必要があります。
2026年9月時点で一般提供されていたフラッグシップモデルのGPT‑6 Astraそのものについては、別の記事で変更点と料金を整理しています。
GPT-6 Astraとは|何ができるモデルなのか【完全ガイド】
ミレニアム懸賞問題とは何か
ミレニアム懸賞問題は、クレイ数学研究所が2000年に選んだ7つの難問です。Natureの記事によれば、解決には100万米ドルの賞金が懸けられており、今回の対象を含めて6問が未解決の状態でした。
ナビエ・ストークス方程式は、流体の運動をニュートンの運動方程式にもとづいて記述するものです。OpenAIの公開ページは、この式が航空機の設計・気象予報・血流の研究に使われていると説明しています。式そのものは19世紀に作られ、1934年に「一般化された意味での解は存在する」ことが示されましたが、その解が常に滑らかであり続けるかは未解決のまま、およそ90年が経っていました。
何が示されたのか
示されたのは「滑らかさが常に保たれる」ではなく、その逆です。同社の公開ページによると、はじめ静止していた滑らかな流体に滑らかな力を加えると、有限の時間のうちに速度が上限なく増大する「特異点」が生じうることを、解析的な証明とLeanによる形式化の両方で示したとしています。
その解は渦です。内側へ螺旋を描きながらスパゲッティのように引き伸ばされ、中心部が縮みながら加速していく。それでいてエネルギーは有限のまま保たれる、という形になっています。
実在の流体は無限の速さでは動けません。したがってこの結果は、流体そのものの性質というより、「この方程式が現実を写せなくなる場合がある」ことを意味します。
なぜ「反証」が解決になるのか
ここは誤解されやすいところなので補足します。「未解決問題を解いた」と聞くと、多くの人は「滑らかさは保たれる」と証明されたのだろうと想像します。実際は逆でした。
OpenAIの公開ページによると、公式の定式化には4つの版があり、同社は版「A」「B」を証明に至る形、版「C」「D」を反証に至る形と説明したうえで、それぞれ別のグループのエージェントに割り当てています。そして今回示されたのは「C」(および「D」)のほうです。
懸賞問題は「どちらであるかを決着させること」が課題なので、反証側で決着しても解決になります。むしろ実務的な含意はこちらのほうが大きい。広く使われている方程式に、現実を写せなくなる場合があると分かったということだからです。
賞金は請求しないと明言している
見落とされやすい点ですが、OpenAIは公開ページで「この結果でミレニアム賞を請求するつもりはない」と明記しています。発表の目的は賞金ではなく、自社のAIモデルの進歩状況を報告することにある、という立て付けです。
公開された数字を並べる|10,000体・88時間・1,300億トークン
今回は珍しく、投入量の数字が具体的に公開されました。引用の単位になる数字なので、出所つきで並べておきます。以下はすべてOpenAIの公開ページの記載です。
項目 | 公開されている値 |
|---|---|
ナビエ・ストークスを解いたグループの規模 | 約10,000体の同時稼働エージェント |
着手から到達まで | 約88時間(2026年9月1日着手 → 9月5日到達) |
Lean形式化と検証にかかった追加時間 | 17時間(GPT‑6 Astraが実施) |
ナビエ・ストークス分のやりとり | 約270万メッセージ/約1,300億出力トークン |
全問題を通じた総量 | 約490万メッセージ/約3,000億出力トークン |
エージェントはグループに分割され、グループの中でだけ互いに通信できるようになっていました。全体が1つの巨大な会議室になっていたわけではありません。
桁を実感に直す
約1,300億の出力トークンという量は、あくまで私の目安の換算ですが、仮に1トークンを日本語の1文字と数えると約1,300億文字にあたります(実際の文字数は言語やモデルで変わります)。1本1万字の記事に換算すれば約1,300万本ぶんです。これを約88時間のあいだに生成したことになります。
ここで大事なのは「すごい」ではなく、この規模が前提の成果だと理解しておくことです。手元のサブスクリプションで同じことが起きるわけではありません。
途中でモデルを差し替えている
もう1つ、再現性を考えるうえで重要な記載があります。同社の公開ページには「取り組みの途中で、さらに訓練の進んだ版の社内モデルが利用可能になったため、エージェントをそのモデルに更新した」とあります。
つまり88時間のあいだ、走っていたモデルは同一ではありません。これは「同じ条件でもう一度やれば同じ結果になる」タイプの実験ではない、ということです。
業務でも同じことが起きます。モデルが更新されると、昨日まで通っていた手順が今日は通らない。だからこそ、出力そのものを信頼するのではなく、出力を検査する仕組みのほうを固定しておく必要があります。ここは次の節につながる話です。
実は先に解けたのは「易しいほうの問題」だった
今回の経緯でいちばん実務的な示唆があるのは、ここだと考えています。
OpenAIの説明によると、同社はミレニアム懸賞問題そのものに加えて、「もっと易しい」問題群も一緒にエージェントへ投げていました。そのうちの1つが、ナビエ・ストークス方程式から粘性の項を取り除いた極限であるオイラー方程式の正則性問題です。
そして、そちらが先に解けました。公開ページには「約100体のエージェントが約50時間かけて」この問題(外力を加えない版)を解決した、と記載されています。同社の研究者が記者会見で述べた数として1,000体という数字も報じられていますが、ここでは公開ページ側の記載を採ります。
重要なのは順番です。オイラーの解決を見たあとで、同社はナビエ・ストークスが最も見込みのある問題だと判断し、他のミレニアム問題からエージェントを引き上げて資源を集中させました。そのうえで、オイラーの解決内容をエージェントへのプロンプトに含めています。
つまり本命に一直線で投下したのではなく、隣の易しい問題を混ぜて投げたことが、本命への手がかりになったという順序です。これは規模に関係なく再現できる考え方です。
今回効いた4つの段取り
台数の話を脇に置くと、公開された手順には再利用できる型が4つあります。
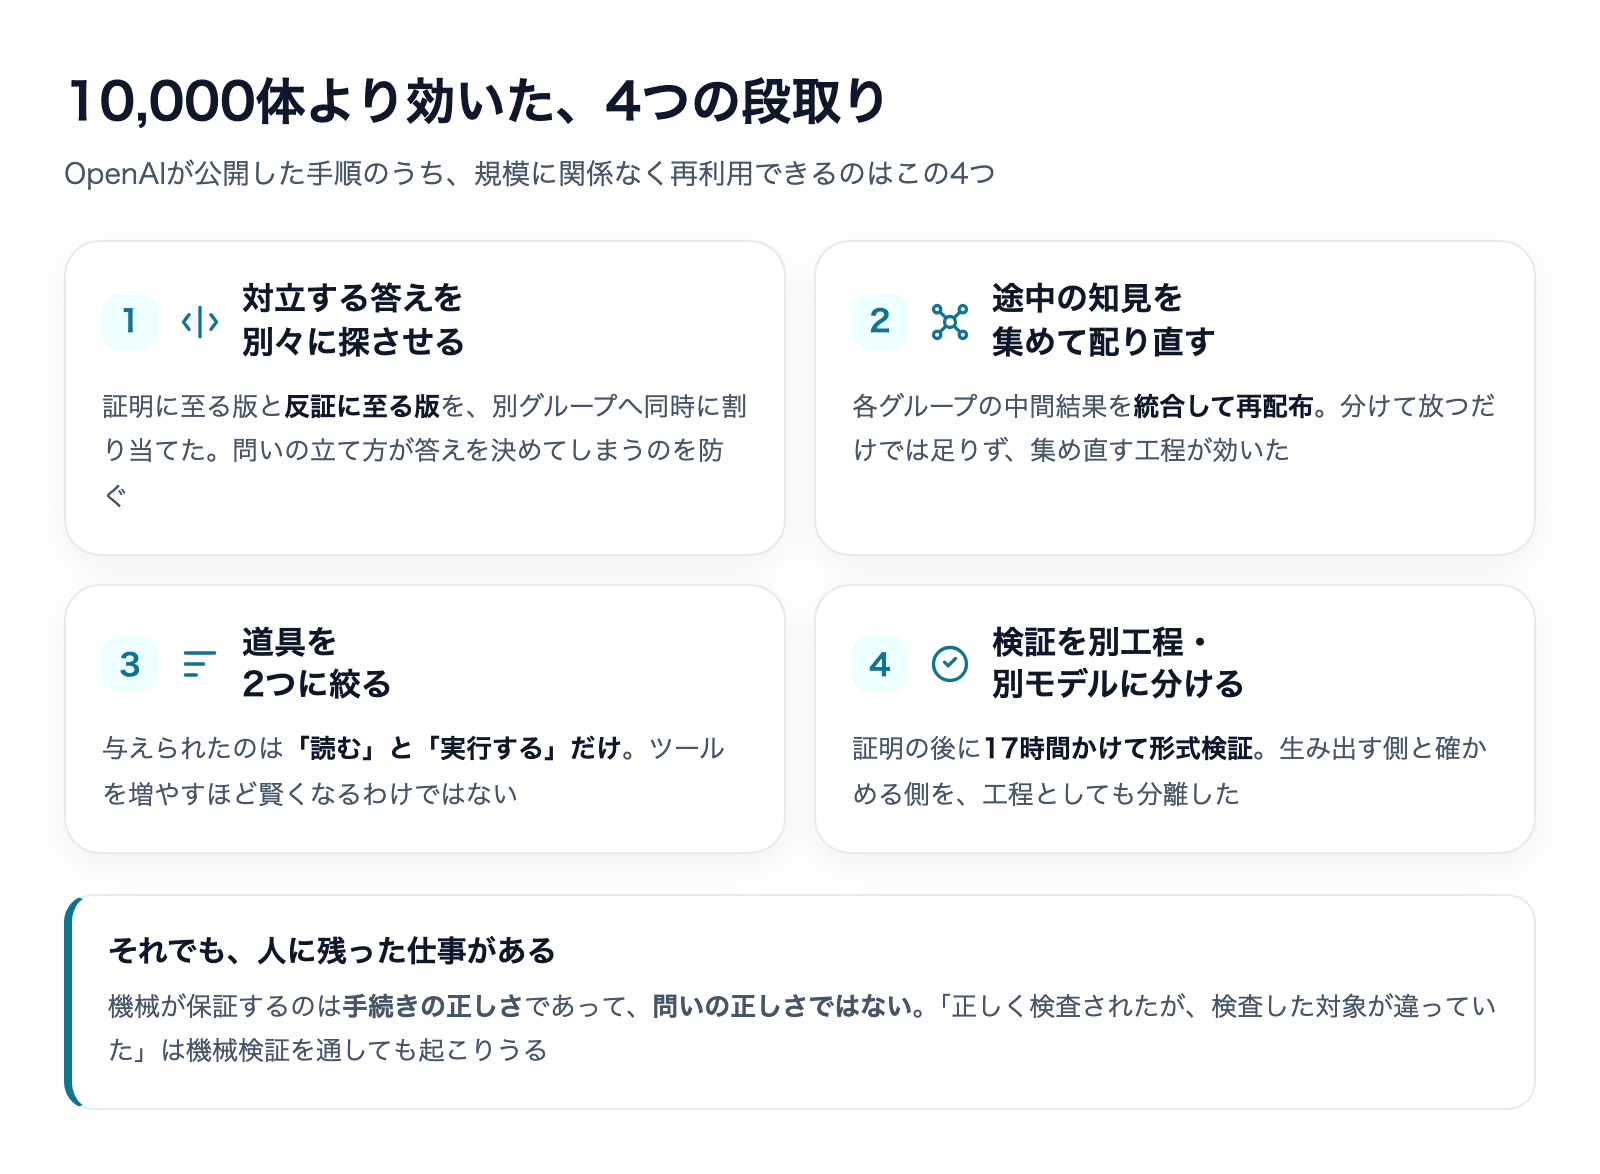
① 対立する答えを、別グループに同時に探させた
OpenAIは問題文の変種を用意し、証明にたどり着く形(版「A」「B」)と、反証にたどり着く形(版「C」「D」)を、それぞれ別のグループに与えました。どちらが正しいか分からない問いに対して、両方の結論を別々の担当に探させたわけです。
実務でこれをやらないと何が起きるか。AIに「この施策は有効ですか」と聞けば、たいてい有効だという答えが返ってきます。問いの立て方が答えを決めているからです。「有効である理由」と「有効でない理由」を別のセッションに集めさせて、後から突き合わせるほうが、判断材料としてははるかに使えます。
② 途中の知見を集めて、配り直した
各グループには多様なアプローチを探らせたうえで、しばらくしてからCodexを使って各グループの有用な知見を統合し、それを踏まえた追加のプロンプトを配り直しています。解を見つけたグループは、この方法で誘導されたものだと公開ページには書かれています。
並列化というと「分けて放つ」ところだけが注目されがちですが、実際に効いたのは集めて配り直す工程があったことのほうです。並列化そのものが割に合う条件は、別の記事で扱っています。
③ 道具を2つに絞っていた
見落とされがちですが、10,000体のエージェントに与えられていた道具は「キャッシュされたインターネットを読む」と「コードを実行する」の2つだけでした。無数のツールを繋いだのではありません。
これは中小企業がAIを導入するときの現実的な指針になります。ツールを増やすほど賢くなるわけではない。今回の成果は、道具の少なさではなく、投下量と段取りで出ています。社内で「まずどのSaaSと連携させるか」を議論しているなら、その前に「読む」と「実行する」に相当する最小の2つが揃っているかを見たほうが早い、ということです。
④ 検証を別工程・別モデルに分けた
そして4つ目。証明が出たあと、Lean形式化と検証には別途17時間がかけられ、その作業はGPT‑6 Astraが担当しています。つまり生み出した側と確かめる側が、工程としてもモデルとしても分けられています。
この4つ目が、この記事の本題です。
いちばん効いたのは「答え合わせができた」こと
ここが今回の核心だと考えています。
Leanとは何をするものか
Leanは証明支援系と呼ばれるプログラミング言語で、数学の証明を機械が形式的に検査できる形で書くためのものです。人が読んで納得するのではなく、機械が論理の各ステップを検査して通す。ここを通ったという事実が、「たしかに正しい」と言える根拠になっています。
Quanta Magazineの記事も、今回の結果がLeanで形式的に検査されたことが、数学者たちがこれを正しいと考える根拠になっていると説明しています。
それでも人に残った仕事がある
ただし、同誌はきわめて重要な留保をつけています。人間がやらなければならない決定的な検証として残っているのは、「Leanで真だと示された命題が、そもそも数学者が示そうとしていた問題と論理的に同じものかどうか」の確認だ、というものです。
この一文は、業務にAIを入れるすべての人にとって効きます。
機械が保証してくれるのは手続きの正しさであって、問いの正しさではありません。「正しく検査されたが、検査した対象が間違っていた」は、機械検証を通しても起こりうる。だから検証を自動化したあとに残る人の仕事は、作業の再チェックではなく「何を検証しているのかの確認」に移ります。
この構造は、自社の無人運用とまったく同じだった
ここからは私たちの実運用の話です。規模はまるで違いますが、構造は同じでした。
目視では見分けられなかった404リンク
私たちは記事の中で自社の他記事へリンクを貼ります。以前はそのリンク先を、AIが記事の内容から推測して書いていました。
結果として、存在しないURLへのリンクが22本たまりました。この22本のリンクが指していたURLは12個で、そのうち9個は一度も公開されたことがないURLでした。リンク先が後から変わったのではなく、参照するたびに、それらしいURLが創作されていたということです。
厄介だったのは、創作されたURLのほうが実在のURLより説明的で、もっともらしく見えたことです。目視のレビューでは原理的に見分けられませんでした。人が丁寧に見るほど「ちゃんとしている」と判定してしまう類の誤りです。
機械が確かめられることと、人が見ること
そこで、リンク先が実在するかどうかを推測ではなくAPIを叩いて確認する手順に変えました。実在しなければ公開しない。実在確認を入れて以降、この種の誤りは、検査の段階で止められるようになりました。
ただし機械が確かめているのは「そのURLが存在するか」だけです。「そのリンクが読者にとって適切か」は、機械には判定できません。ナビエ・ストークスの件で、Leanが通っても「何を証明したのか」の確認が人に残ったのと、まったく同じ分け方です。
書いた側と、確かめる側を分ける
もう1つ、今回の発表と同じ形にしていることがあります。記事を書いたAIと、公開してよいかを判定するAIを、別のプロセスに分けていることです。
判定する側には記事の本文と判定基準だけを渡し、執筆時のやりとりは渡しません。同じ文脈を持ったまま自己採点させると、自分の書いたものはたいてい通ってしまうからです。加えて、判定できなかった場合は公開しないという向きに倒しています。迷ったら出さない、という設計です。
チェックを何本も足すのではなく、1本にして観点で割るという考え方については、別記事で詳しく書いています。

無人でAIを走らせるときの監視の設計そのものは、こちらにまとめています。
答え合わせの装置がある仕事・ない仕事
ここまでを踏まえると、「AIにどこまで任せるか」の判断軸が1つ立ちます。その仕事に、答え合わせの手段があるかです。賢さではなく、確かめ方の有無で決まります。
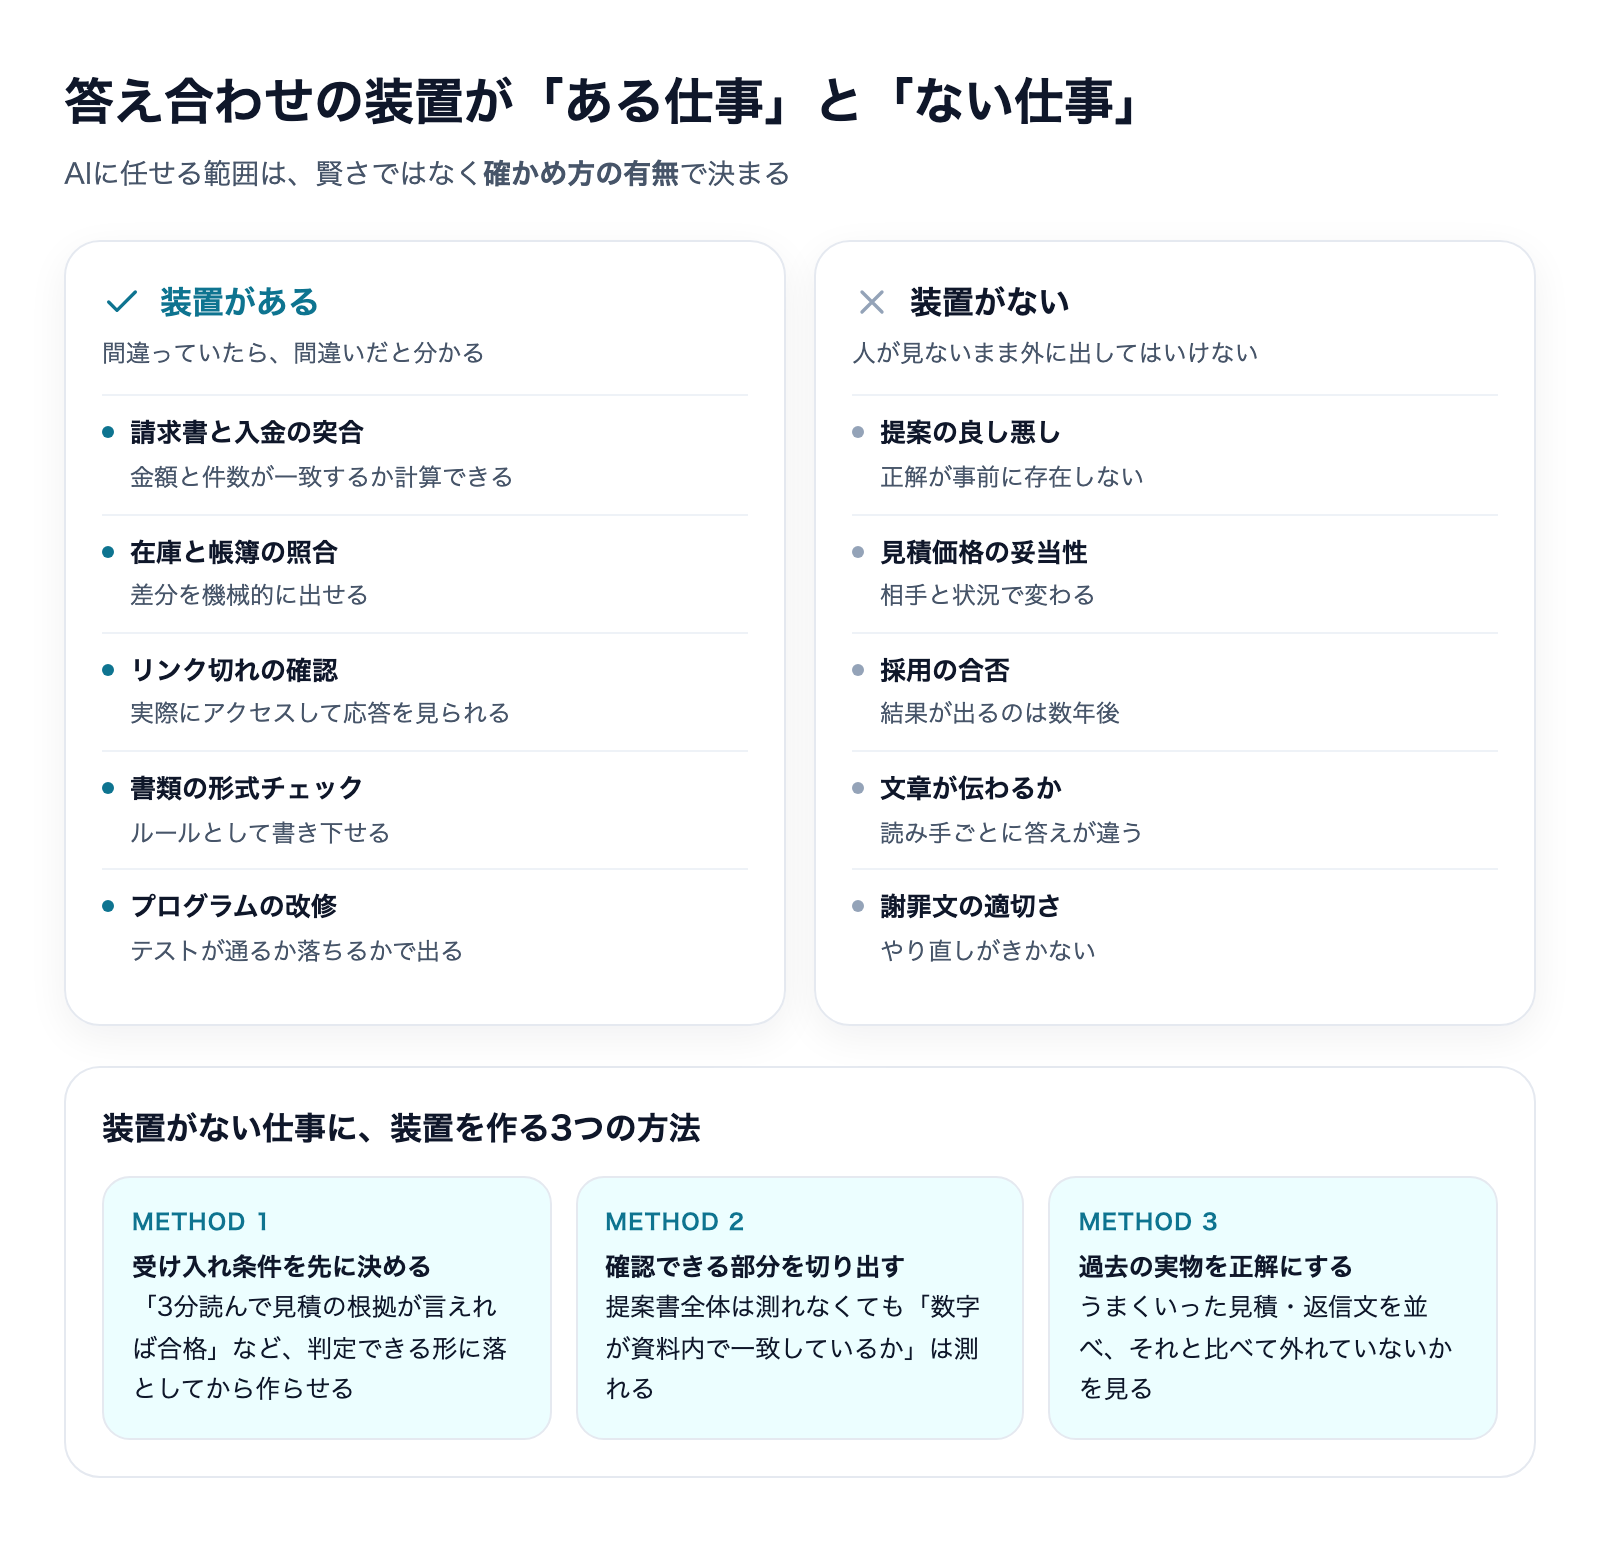
装置がある仕事
業務 | 答え合わせの手段 |
|---|---|
請求書と入金の突合 | 金額と件数が一致するかを計算できる |
在庫データと帳簿の照合 | 差分を機械的に出せる |
Webサイトのリンク切れ確認 | 実際にアクセスして応答を見られる |
書類の形式チェック(必須項目・桁・日付) | ルールとして書き下せる |
プログラムの改修 | テストを書けば通るか落ちるかが出る |
この列に該当する仕事は、AIに任せる範囲を広げやすい領域です。出力が間違っていても、間違っていることが分かるからです。
装置がない仕事
業務 | なぜ答え合わせできないか |
|---|---|
提案内容の良し悪しの判断 | 正解が事前に存在しない |
見積価格の妥当性 | 妥当かどうかは相手と状況で変わる |
採用の合否 | 結果が出るのが数年後で、比較対象も取れない |
文章が読み手に伝わるか | 読み手ごとに答えが違う |
顧客への謝罪文の適切さ | やり直しがきかない |
こちらは、AIに下書きを作らせる価値はあっても、人が見ないまま外に出してはいけない領域です。今回のニュースを根拠に「AIは数学の難問を解いたのだから経営判断も任せられる」と考えるのは、この列を無視することになります。
装置がない仕事に、装置を作る方法
とはいえ、この線引きは固定ではありません。装置がない仕事にも、部分的になら作れます。
- 受け入れ条件を先に文章で決める——「この資料は、3分読んで見積の根拠が言えれば合格」のように、判定できる形に落としてから作らせる
- 確認できる部分だけ切り出す——提案書全体の良し悪しは測れなくても、「数字が資料内で一致しているか」は測れる
- 過去の実物を正解データにする——うまくいった過去の見積・返信文を並べ、それと比べて外れていないかを見る
ナビエ・ストークスの件で本当にすごかったのは、解きたかった問題をLeanで検査できる形に落とし込めたことです。同じ工夫が、規模を下げれば自社の業務でもできます。
このニュースから読み取ってはいけないこと
最後に、外しやすい読み方を4つ挙げます。
① 実用的な帰結がすぐ来るわけではない
Quanta Magazineは、特異点の形成に関する今回の数学的結果には直ちに実用上の帰結はないと説明しています。この方程式は、流体をいくらでも細かく拡大して見られるものとして扱っていますが、実在の流体は分子や原子でできていて、そうではないためです。
気象予報や航空機設計の精度が来月から変わる、という話ではありません。
② 1社だけの飛躍として読むと外す
Natureの記事によると、同じ時期に別のチームも近い領域で成果を出しています。大学と企業に所属する数学者のチームが、粘性のない場合の解を9月7日に公開しており、その際にはAnthropicとOpenAI双方のモデルが使われたとされています。また同じ日に、大規模言語モデルではなく物理法則を組み込んだニューラルネットワークを用いた別チームの結果も公開されました。
複数の手法が同時期に同じ山に届いたという読み方のほうが、実態に近いと考えられます。特定の1社の製品を選ぶ理由として、このニュースを使うのは筋が違います。
③ 検証はまだ終わっていない
Leanによる形式的な検査は通っていますが、前述のとおり「検査した命題が解きたかった問題と同じか」の確認は人の仕事として残っています。Quanta Magazineも、誰が何をいつ行ったかの経緯を整理し、今回の証明の数学的な意義を理解するには時間がかかるだろうと書いています。
2026年11月7日時点でも、クレイ数学研究所の公式ページでは、ナビエ・ストークス方程式は「Active problems(進行中の問題)」の欄に載っています。同研究所の賞の規則では、提案された解が、認められた媒体に発表されていること、発表から少なくとも2年が過ぎていること、数学界で広く受け入れられていること、の3つがそろわないと審査の対象になりません。OpenAIが賞を請求しないと明記しているとはいえ、少なくとも賞の面では、今回の結果はこれから時間をかけて確かめられる段階にあります。
④ 使ったAIの提供元に、自分の作業が渡る経路がある
そしてもう1つ、業務利用者にとって直接効く論点があります。
Quanta Magazineによると、並行して同種の問題に取り組んでいた数学者側のニューヨーク大学のバックマスター氏の声明は、自分たちの進捗がOpenAI側に渡った可能性を示唆しているように読めます。彼らは作業の一部にOpenAIのモデルを使っていました。
OpenAI側は公開ページで、相手方が公開するまでその内容を一切見ていない、この問題を解くために特定のユーザーデータにアクセスしたことはないと明確に否定しています。ただし同じ段落で、可能性は低いとしつつ、相手方の製品利用から得られた非識別化データが自社モデルの改善に寄与した可能性は排除できないとも書いています。
この応酬の当否を私が判定することはできません。しかし構造として言えることは1つあります。業務でAIを使う以上、入力した内容が提供側のモデル改善に使われるかどうかは、善意ではなく契約とプラン設定で決まるということです。
自社の機密や顧客情報を扱うなら、ここは確認すべき項目です。データを残さない契約形態については、確認点をまとめた記事があります。
中小企業が今日からできる3つのこと
ニュースを踏まえて、規模を問わず実行できることを3つに絞ります。
① 手持ちの業務を「答え合わせできるか」で仕分ける
いま抱えている定型業務を紙に書き出し、それぞれに「間違っていたとき、どうやって気づけるか」を1行で書き添えてください。書けない業務は、AIに任せる範囲を広げてはいけない業務です。この仕分けだけで、導入すべき順番がほぼ決まります。
② 対立する結論を、別々に出させる
AIに判断材料を作らせるときは、1回で答えを出させないでください。「やるべき理由」と「やめるべき理由」を、別のやりとりで作らせて並べる。今回OpenAIが証明側と反証側を別グループに割り当てたのと同じ考え方で、これは無料の範囲でも今日できます。
③ 作った側と、確かめる側を分ける
AIに作らせたものを、同じAIに同じ会話の中で確認させないでください。新しいセッションを開き、成果物と判定基準だけを渡して見せる。これだけで、見逃しはかなり減ります。私たちが記事の公開判定でやっているのも、突き詰めればこれだけです。
まとめ
今回の発表で最も再利用できるのは、10,000体という数字でも88時間という速さでもありません。解きたかった問題を、機械が検査できる形に落とし込めたことです。
そして、そこまでやってなお、「検査した対象が正しいか」の確認は人に残りました。ここが、AI導入で最後まで残る仕事の正体だと考えています。
自社の業務を見渡して、答え合わせの装置がある仕事から順に任せていく。装置がない仕事には、まず装置を作るところから考える。派手なニュースから持ち帰るものとしては地味ですが、これが最も外れにくい進め方です。私たちは、こうした線引きの設計から日々の運用までを伴走しています。
参考にした情報
- OpenAI「On the Navier–Stokes Millennium Prize Problem」(2026年9月8日公開)
- Nature「OpenAI claims huge maths breakthrough on a famed 'Millennium Problem'」(2026年9月8日)
- Quanta Magazine「AI Has Solved One of Math's $1 Million Millennium Prize Problems」(2026年9月8日)
- クレイ数学研究所「The Millennium Prize Problems」(2026年11月7日に確認)
- クレイ数学研究所「Rules for the Millennium Prizes」(2026年11月7日に確認)
※本記事の数値・経緯は上記の公開情報にもとづく2026年9月9日時点の内容です(クレイ数学研究所の掲載状況のみ、2026年11月7日に確認して追記しました)。最新の状況は各社の公式発表をご確認ください。
AIを使う会社と、使わない会社。
その差は、開き始めています。
ここ数年でAIは急速に進化し、正しく導入できている企業とそうでない企業とでは、業務効率や人件費に大きな差が生まれ始めています。「AI導入に興味はあるが、実際に何ができて、どこから手をつければいいか分からない」——そんな方は、まずこの無料プレゼントに目を通してみてください。