natural-japaneseとは|AIの日本語を直す使い方

「AIに書かせた報告書や記事の日本語が、どこか不自然で読みにくい。natural-japanese というスキルで直せるのか」——AIで仕事の文章を作るようになると、多くの人がこの壁に当たります。
結論から言うと、natural-japanese は、AIが書いた仕事の日本語を「元に無い事実を足さずに」読みやすく直す Agent Skill です。疑わしい箇所は付属のスクリプトが機械で見つけ、直すかどうかはAIが文脈を見て決めます。書き換えずに0〜100の点数だけを返す使い方もあります。
株式会社Fyveは、AIに下書きさせた文章を毎日のように公開しており、AIっぽい言い回しを直すための辞書を自分たちで作って運用しています。この記事では、natural-japanese の入れ方・使い方・最近の版で変わったことを公式の README とリリースノートから整理し、自分たちの運用から見た使いどころを添えます。なお、私たちは natural-japanese を手元の環境にはまだ入れていません。「使ってみた」結果ではない点をご了承ください。
natural-japaneseとは|AIの日本語を直すAgent Skill
natural-japanese は、GitHub の coji/natural-japanese で公開されているスキルです。Claude Code をはじめ、Cursor や Codex などのコーディングエージェントに読み込ませて使います。ライセンスは MIT で、2026年10月28日時点の最新版は v1.6.3(2026年10月27日公開)、GitHub のスター数は1,978でした。
リポジトリの説明は「仕事の日本語を、読みやすくわかりやすく書く・直すための Agent Skill」です。README によると、対象は議事録・レポート・技術記事・PR(変更依頼)の説明文など、仕事で使う文書です。SKILL.md(スキルの本体の説明書)には、調査レポート・社内ガイド・リサーチメモ・企画書・メール・スライド構成、さらに note やブログの執筆まで対象として書かれています。新しく書くときにも、すでにある文章を直すときにも使えます。
README は「直すとこうなる」の例として、次の3つを挙げています。
- 何のことか分からない言い回しを、ふだんの言葉に直す:「まだ決着していない行」を「チェックインも取り消しもされていない行」のように、指しているものが分かる言い方にする
- 元に無いことを足さない。確信の度合いも変えない:同じメモから調査レポートを書かせたとき、スキルなしでは未検証の見立てを「強く疑われます」と書いたが、スキルありでは「どちらも未検証である」とメモのとおりに書いた
- 太字を重ねない:5種類の文書を5つのモデルに書かせたところ、太字はスキルなしの25本で551か所、スキルありの25本で13か所だった(作者の測定)
いちばん大事な規則は「元に無い内容を足さない」
SKILL.md の冒頭に置かれている規則は、文章をきれいにすることではありません。「既存の文書を直すときは、元の文書に書かれていない事実・数値・人名・日付・条件・評価・意見・方針を足さない」という規則です。
理由として、直した文書を読んだ人は、そこに書かれていることを書き手が言ったこととして受け取るから、と説明されています。次のような変更も「足す」に当たると明記されています。
- 「次回また相談する」を「合意した」にするなど、確信の度合いを変える(逆に、断定を推定に弱めるのも同じ)
- 「これには何度も助けられた」のような、書き手の経験や見解を書き足す
- 「理由は3つある」のような、元に無い数の枠組みを足す
- 元の数値や表の値を書き換える(誤りに見えても書き換えず、ユーザーに伝える)
AIに「読みやすくして」と頼むと、それらしい結論や担当者・期日まで書き足してくることがあります。議事録や報告書でこれが起きると、言っていないことを言ったことにしてしまいます。natural-japanese は、この事故を防ぐことを最優先にした作りです。直したあとは、付属の newfacts.py で、直した文書にだけある数値・固有名詞を一覧にして確かめる手順まで組み込まれています。
見つけるのは機械、直すかどうかはAIが決める
もう1つの特徴は、役割の分け方です。疑わしい箇所は付属の lint.py が形態素解析(文を単語に区切って品詞を調べる処理。ここでは SudachiPy を使用)で見つけ、直すかどうかはエージェントが文脈を見て決めます。README は理由を「AI は自分の書き癖に気づきにくいので、検出を機械に任せています」と書いています。
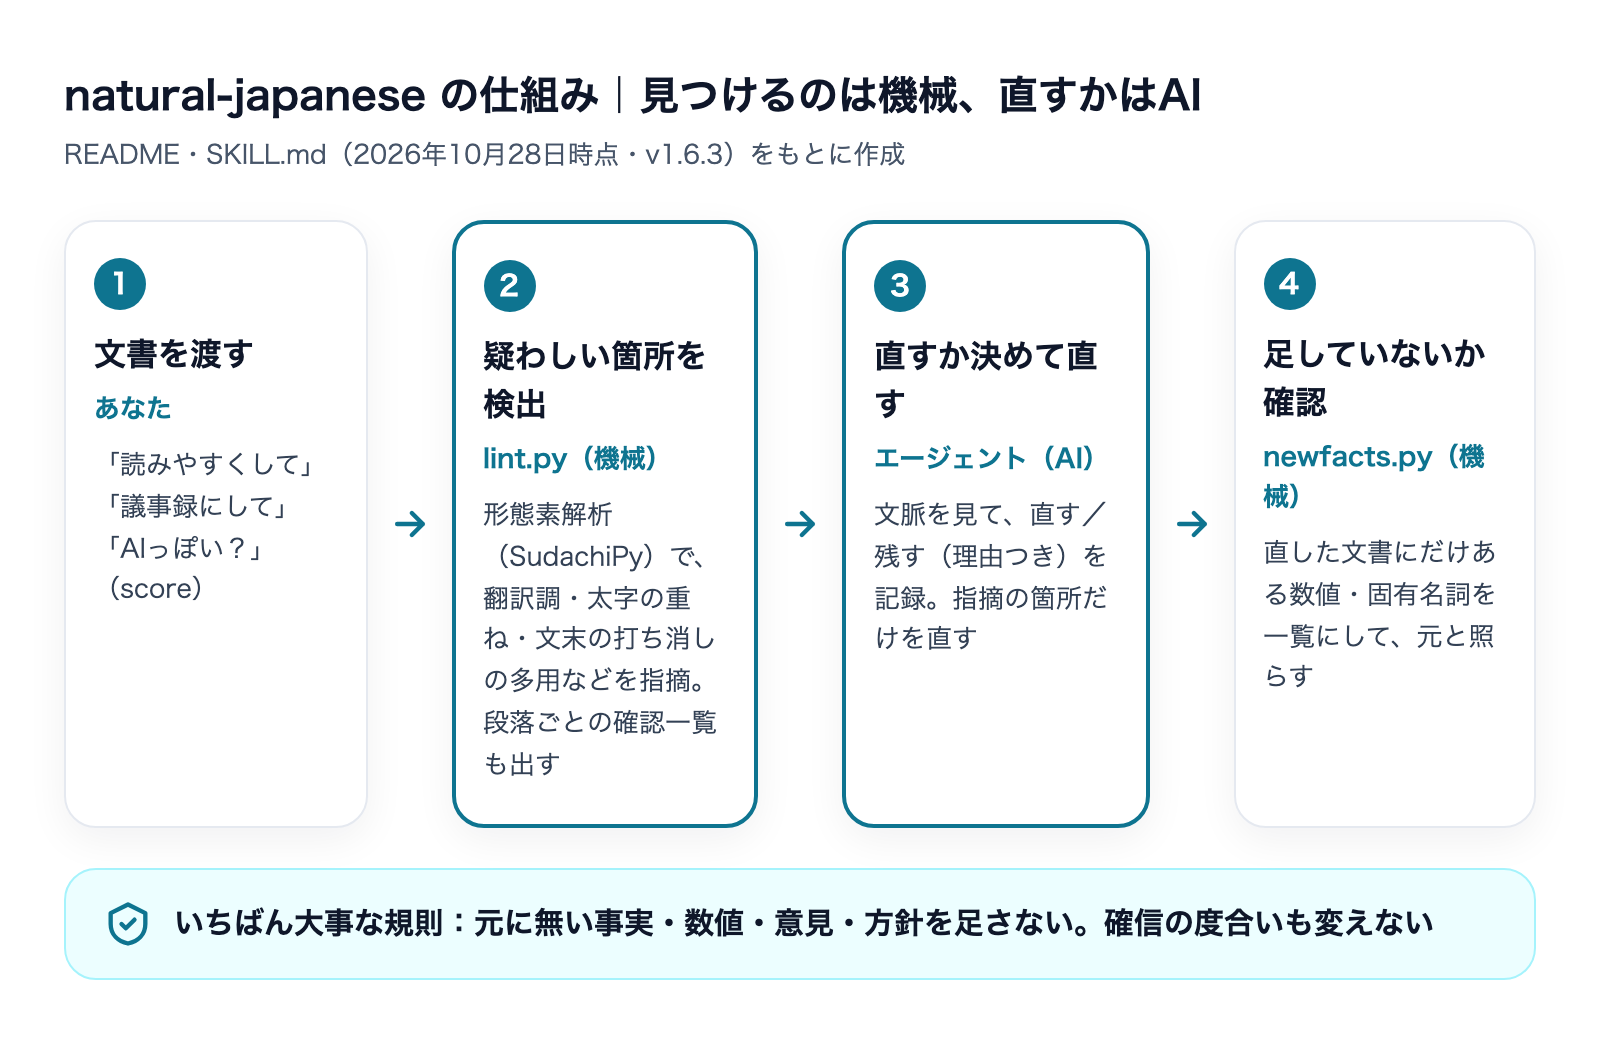
付属の検査スクリプトは、lint.py のほかに、見出しと段落の先頭文を抜き出す outline.py、専門用語の初出と説明の有無を出す terms.py、段落ごとの確認用の一覧を出す paragraphs.py、場所のたとえや機械の処理に当てた動詞の候補を出す calques.py などがあります。どれも uv(Python の実行環境を管理する道具)があれば、スキルを通さずに単体でも実行できると README にあります。
natural-japaneseの入れ方|環境別の手順
README に書かれている入れ方を、使う環境ごとに整理します。コマンドは2026年10月28日時点の README の記載です。入れる前に、最新の README を確認してください。
1. npx skills add(README が最初に挙げる方法)
ターミナルで次を実行します。
npx skills add coji/natural-japanese
入れたあとは、エージェントに「読みやすくして」「議事録にして」「AI っぽいところを直して」のように頼むだけで動く、と README は説明しています。
2. Claude Code のプラグインとして入れる
Claude Code の中で、次の2行を順に実行します。
/plugin marketplace add coji/natural-japanese/plugin install natural-japanese@natural-japanese
3. Codex・ChatGPT など(AGENTS.md を経由して使う)
npx openskills install coji/natural-japanesenpx openskills sync
4. Cursor
README によると、Cursor Marketplace での公開は審査待ちです。公開前に試す場合は、リポジトリの中身を ~/.cursor/plugins/local/natural-japanese にコピーしてから Cursor を再起動する手順が書かれています。v1.6.3 のリリースノートにも「Cursor Marketplace 用の Agent Plugin manifest を追加」とあります。
5. 手動で入れる
Releases から natural-japanese.skill をダウンロードし、エージェントのスキルディレクトリに展開します。
なお、検査スクリプトは uv で動きます。SKILL.md には、uv が使えない環境(Claude.ai など)では references/manual-checklist.md の手順で同じ観点を目で確かめる、と書かれています。機械の検査が走らない分、見逃しは増えると考えておくのが安全です。
natural-japaneseの使い方|3つの呼び出し方
SKILL.md には、引数つきで呼び出したときの解釈が3通り書かれています。自然な言葉で頼んでも、同じように振り分けられます。
呼び出し方 | 何をするか | 自然な言葉での頼み方の例 |
|---|---|---|
| 書く・直す(既定)。新しく書くのか直すのかは対象から判断 | 「この報告書を読みやすくして」 |
| 素材から新しく書く | 「このメモから議事録を書いて」 |
| 書き換えずに、点数と理由だけを返す | 「この文章、AIっぽい?」 |
クイックとフルの使い分け
直す・書くときは、手間の違う2つのモードがあります。
- クイック(既定):日常の文書向け。サブエージェント(作業を分担する別のAI)を使わずにその場で終える。所要時間の目安は会議メモ程度で30秒前後、1万字級でも3分程度
- フル:「しっかり」「時間をかけていい」と頼んだとき、社外・経営向けなど誤りの影響が大きい文書、1万字を超える文書に使う。目安は短い文書で7分前後、1万字級で15〜20分
クイックでも、lint.py は文書が短くても必ず1回実行し、段落ごとの確認も最後まで書き出す決まりです。迷ったらクイックで仕上げ、「フルで見直すこともできる」と添える、と SKILL.md にあります。また、effort(モデルが推論にかける量の設定)を下げると手順を省きやすくなるため、選べる環境では high を使うよう、README と SKILL.md の両方に書かれています。
score の点数はどう出るか
score は、文書を一切書き換えずに、自然さの点数(0〜100、高いほど自然=AI臭が薄い)と理由を返す使い方です。点数の出し方は references/diagnose.md に書かれていて、2層になっています。
- 機械の点数:100点から、
lint.pyの指摘を文書の長さで割り戻して減点する。重大1件が警告2件、情報16件に当たる重み付けで、下限は20点 - 判断による調整(±15点):full と exp のときだけ。どの節も同じ組み立て、根拠のない箇条書きの羅列、確信の度合いが書き分けられていない、などの構成の癖で減点する
点数は、90〜100が「自然」、70〜89が「軽微」、50〜69が「要修正」、0〜49が「濃厚」の4段階で伝えられます。exp は実験的な検出器(semantic.py)まで使い、初回に約1GBのモデルをダウンロードします。
注意したいのは、diagnose.md 自身が「スコアは判断を含む目安であり、同じ文書でも数点は揺れる。CI のゲートに使う数値ではない」と書いている点です。点数で公開の可否を機械的に決める使い方は、作者の想定の外です。
自分の文体を覚えさせる(style-profile.md)
プロジェクトのルートなどに style-profile.md があれば、natural-japanese はそれを読み、視点・語彙・リズムの癖を踏まえて書きます。「自分の文体を学ばせたい」と頼んだときだけ、過去の文章3〜5本から特徴を抜き出してこのファイルを書き出します。
SKILL.md の書き方で目を引くのは、ユーザーが「自分はこの言い方を使わない」と言ったときの扱いです。一般の規則に広げず、出典と適用範囲を添えてプロファイルに記録し、単語全体を禁じずに指摘された組み合わせだけを記録する、と書かれています。誰にでも当てはまる直しと、その人だけの好みを混ぜない設計です。この点は、後半で私たちの運用と並べて説明します。
最近の版で変わったこと|v1.6.0〜v1.6.3
natural-japanese は、10月に入ってから版の更新が続いています。各リリースノートに書かれた変更と、作者が確かめた結果を表にまとめます(日付は日本時間)。
版(公開日) | 主な変更 | 作者が確かめたこと |
|---|---|---|
v1.6.0(10月16日) | 書く力は最新モデルに任せ、苦手なところだけを直す方針に作り直した。素材に無い数字・断定を書き足さない、 | 作者が直すべきとした23件のうち、v1.5.2 は2〜3件、v1.6.0 は平均12件を直した |
v1.6.1(10月22日) | 「効く」「届く」「動く」のような、何が起きるのか分からない短い言葉を、具体的な言い方に直すように。Claude Opus 5.5 向けに調整 | インフラ担当宛ての文書で、通じない言葉15か所のうち v1.6.0 は0か所、v1.6.1 は10か所を直した |
v1.6.2(10月24日) | SKILL.md の中で食い違っていた指示をそろえ、直しすぎを減らした | 手を入れてはいけない40か所に手を入れた数が、v1.6.1 の7〜12から5〜7に |
v1.6.3(10月27日) | 「バージョン」「ファイル」のような、ふだん使う外来語を漢語に言い換えないように | ソフトのバージョンを指す「版」が、5本で13か所から0か所に |
流れを見ると、v1.6.1 で「直す力」を上げたあと、v1.6.2 と v1.6.3 では「直しすぎ」を減らす方向に戻しています。v1.6.1 のリリースノートには、手を入れてはいけない箇所に手を入れた数が増えたことが「既知の限界」として正直に書かれています。v1.6.3 のリリースノートでは、和語に開きすぎる癖への直しについて「効果は確かめられていません」と、測れなかったことまで書いています。
同じものでも回によって数が1〜4か所ほど動くので差はばらつきの範囲、という注記もあります。版ごとの数字は、改善の方向を示すものとして読むのがよさそうです。
natural-japaneseの苦手なことと、入れる前の確認
README には「苦手なこと」が2つ明記されています。
- 英語の言い方を1語ずつ訳した熟語や、動作を名詞にまとめた言い回しは、半分ほど見逃す。書いたモデルにも直すモデルにも自然に見えるため
- effort を下げると、手順の一部を省いて見逃しが増える
このほか、入れる前に次の点を確かめておくと安心です。
- 何が手元で動くか:
npxでの導入や uv でのスクリプト実行は、手元のパソコンでプログラムを動かすことです。MIT ライセンスで中身は公開されているので、SKILL.md とスクリプトの一覧に一度目を通してから入れるのが安全です - 機密の文書を扱うか:スキル自体は文書を書き換える手順の説明書ですが、文書はエージェントが使うAIモデルに送られます。社外秘の文書を直させるときは、使っているAIサービスのデータの扱いを先に確認してください
- 作業ファイルの置き場所:SKILL.md には、lint の出力などの中間ファイルを対象の文書と同じ場所に置かず、一時ディレクトリに置いて最後に消す、と書かれています
私たちの運用から見た、AI臭を直す道具の持ち方
ここからは、私たちが自分で作って運用している「AIっぽい言い回しを直す辞書」の経験から、natural-japanese の設計を読み直します。精度を比べた数字は持っていないので、比較はしません。比べるのは、道具の「持ち方」です。
AIっぽさは「誰にでも出る癖」と「その人の癖」に分けて持つ
私たちは、AI臭を直す仕組みを3つに分けて持っています。
- 誰が書いても同じ形で出る癖の辞書:英語の言い回しの直訳や、AIの決まった構文。これは他の人に配っても通用する
- その人の癖:その書き手が使わない語や、書き方の分布。書き手ごとに別に持つ
- 読み直し:「誰が・何を・どうした」の省略や、事実を書いたあとの「だから何か」の言い忘れ。語ではないので辞書には出ず、人が読んで直す
1と2を混ぜないのが肝です。以前、ある書き手が実際に使っている語を「AIっぽい語」として辞書に入れていたことがあり、3語を外しました。2026年9月5日時点で、この辞書は書き手本人の文章190本で誤検知0件です。逆に、一般向けの基準で文の長さのばらつきを判定する方法を試したところ、ある書き手の実際の文章の76%が「AIが書いた」と判定されました。平均から外れた書き手ほど誤検知されるので、私たちはこの判定を使っていません。
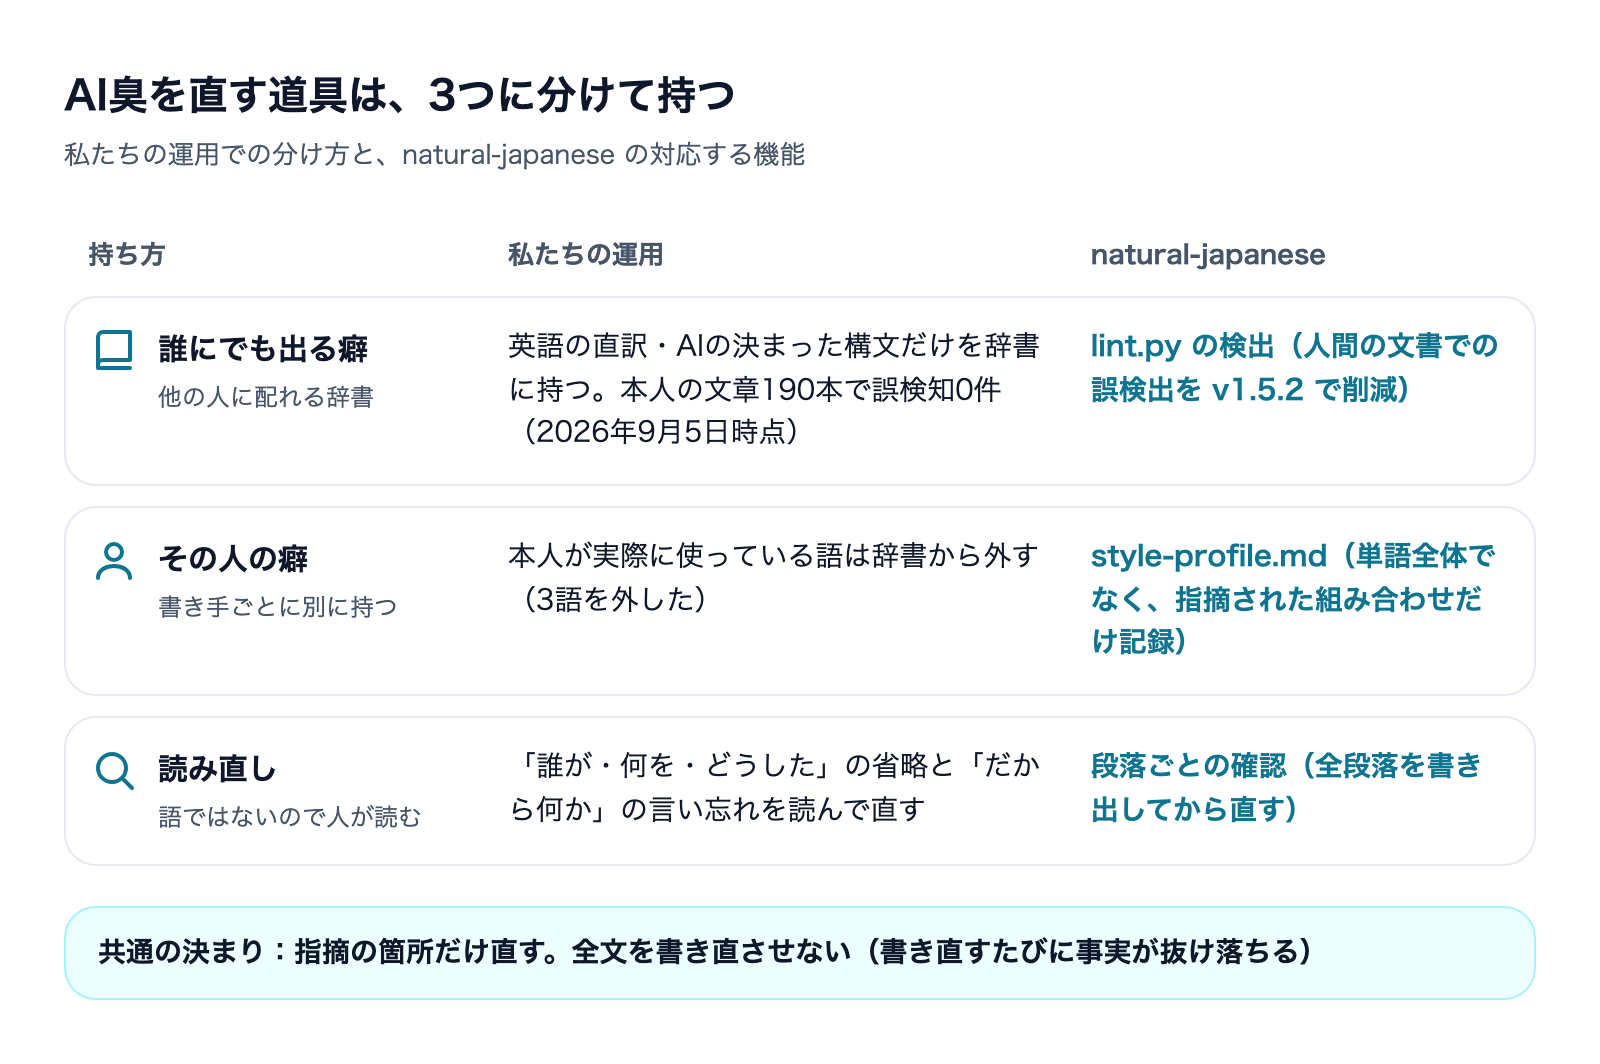
natural-japanese の設計は、この分け方とよく重なります。lint が誰にでも出る癖を拾い、style-profile.md がその人の癖を持ち、段落ごとの書き出しが読み直しに当たります。style-profile.md に「単語全体を禁じず、指摘された組み合わせだけを記録する」と書かれているのは、私たちが3語を外したのと同じ失敗を、最初から避ける作りです。v1.6.3 で「ふだん使う外来語を言い換えない」と決めたのも、誰にでも当てはまる規則に好みを混ぜない、という同じ考えだと読めます。
機械の検出器は、まず自分の文章で誤検知を測る
以前、別の日本語向けスキル yomiyasu の付属の検査を、私たちの書き手の文章に当てたことがあります。2026年10月1日の測定で、本人が書いた文章12本のうち4本、AIの初稿17本のうち5本で指摘が出ました。人の文章とAIの文章を見分けられなかったため、付属の検査は使わず、「意味を変えない」「資料に無いことを足さない」という考え方だけを借りました。
natural-japanese の作者も、この点を測っています。v1.5.2 のリリースノートでは、生成AI以前の人間の文書400本とAIの文書100本に lint をかけ、人間の文書(Qiita の2022年の記事)での1本あたりの指摘を6.56件から0.80件まで減らしたと報告しています。人間の文書で出る指摘はすべて誤検知とみなす、という前提での測定です。
導入を考えるなら、先に自分の文章で確かめるのが確実です。手順は次のとおりです。
- 自分(または自社)が書いた、AIを使っていない過去の文章を5〜10本集める
- 同じ種類の文書をAIに書かせた初稿を5〜10本集める
- 両方に
/natural-japanese scoreをかけ、点数と指摘の数を並べる - 自分の文章に指摘が多く出るなら、その指摘は自分の書き方と衝突している。style-profile.md に記録するか、その指摘は無視すると決める
直させるのは指摘の箇所だけ。全文を書き直させない
私たちが運用で大事にしている決まりは、「指摘された箇所だけ直し、全文を書き直させない」です。AIに全文を書き直させると、書き直すたびに元の事実が少しずつ抜け落ち、文章の中身が薄くなるためです。
natural-japanese も、直す前に段落ごとに問題の箇所を書き出させ、直したか残したかを記録させる手順になっています。全文をまとめて書き直させる作りではありません。もう1つ、私たちは辞書をAIに書かせる「前」には渡さず、書かせた「後」に当てています。生成の前に渡すと、規則そのものが文章の型になってしまうことを確かめたためです。1つの語を禁止すると別の語で同じ癖が出る、ということも何度も起きました。語のリストだけでは追いつかない部分を、natural-japanese が「読み手が何のことか分からない言い回し」として段落ごとに確かめさせているのは、理にかなっていると考えます。
あわせて読みたい記事
同じく、AIが書いた日本語を直すスキルを実際に試した記事です。
AIっぽい言い回しの正体を、私たちの測定から説明した記事です。
AIっぽい文章の正体は英語の直訳|禁止語リストが効かない理由
「AIっぽい文章の特徴」として出回っている説を、実測で確かめた記事です。
まとめ|natural-japaneseを使う前のチェックリスト
natural-japanese は、AIが書いた仕事の日本語を、元に無い事実を足さずに直すことを最優先にした Agent Skill です。検出は機械、判断はAIという分担で、書き換えずに点数だけを見る score も用意されています。10月の4回の更新で、直す力を上げたあと直しすぎを減らす方向に調整されてきました。
使う前に、次の点を確かめてください。
- 自分の環境に合う入れ方を選んだか(npx skills add/Claude Code プラグイン/openskills/Cursor/手動)
- 検査スクリプトを動かす uv が入っているか。無い環境では見逃しが増えると理解しているか
- effort を選べる環境なら high にしているか
- score の点数を、公開の可否を決める機械的な基準にしていないか
- 自分の過去の文章に score をかけ、誤検知の出方を先に見たか
- 自分だけの好みは style-profile.md に分けて記録しているか
- 直したあと、足された数値・固有名詞が無いかを確かめたか
株式会社Fyveでは、AIに下書きさせた文章を人に出す前の点検の仕組みを、自社の発信で日々作り直しています。道具を入れるだけでなく、自分の文章で測ってから使い方を決めることをおすすめします。
Claude Codeを「素のまま」使うな
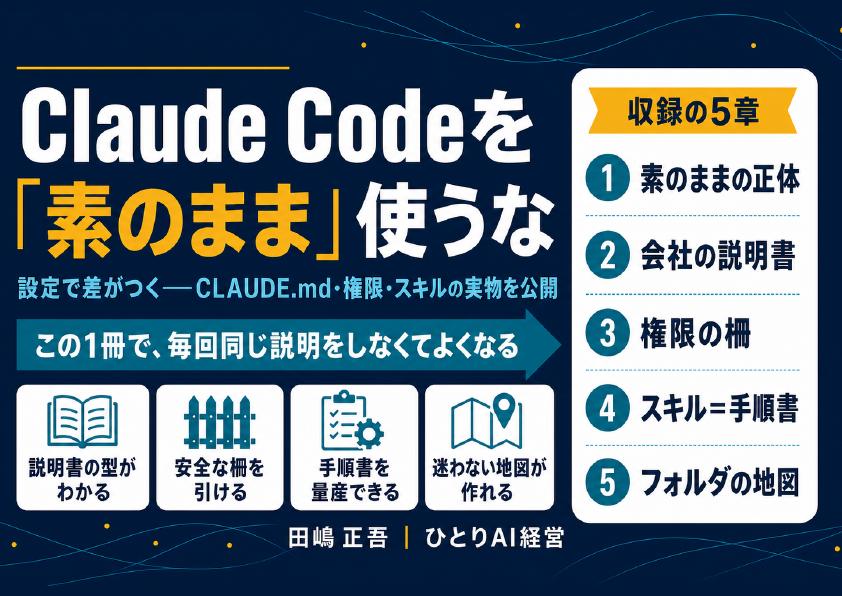
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます
 +10
PDF 19点・合計499ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。