Claude Opus 5.5とFable 5.1の使い分け|上位モデルより強いのは本当か

「Claude Opus 5.5は、2.5倍高い上位モデルのFable 5.1より公式ベンチで全部上らしい」「それならFable 5.1はもう要らないのでは」——新しいOpusが出た翌日、Opus 5.5とFable 5.1のどっちを使うかで手が止まった方は多いはずです。
結論から言うと、大半の仕事はOpus 5.5から始め、難しい推論・長時間のエージェント作業・Opus 5.5のeffortを上げても足りない場面だけFable 5.1に上げるのが、Anthropic公式の案内に沿った使い分けです。Fable 5.1が不要になったわけではなく、「最初に使うモデル」から「上げる先のモデル」へ役割が移った、と捉えると判断がぶれません。
株式会社Fyveは、中小企業のAI活用を月額で伴走支援しています。この記事では、Anthropicの公式発表・公式ドキュメントで確認できた事実だけを使い、単価・速度・既定のeffort・ベンチの差・思考ブロックの互換という5つの軸で、2つのモデルの振り分け方をClaude Codeの手順まで落として整理します。
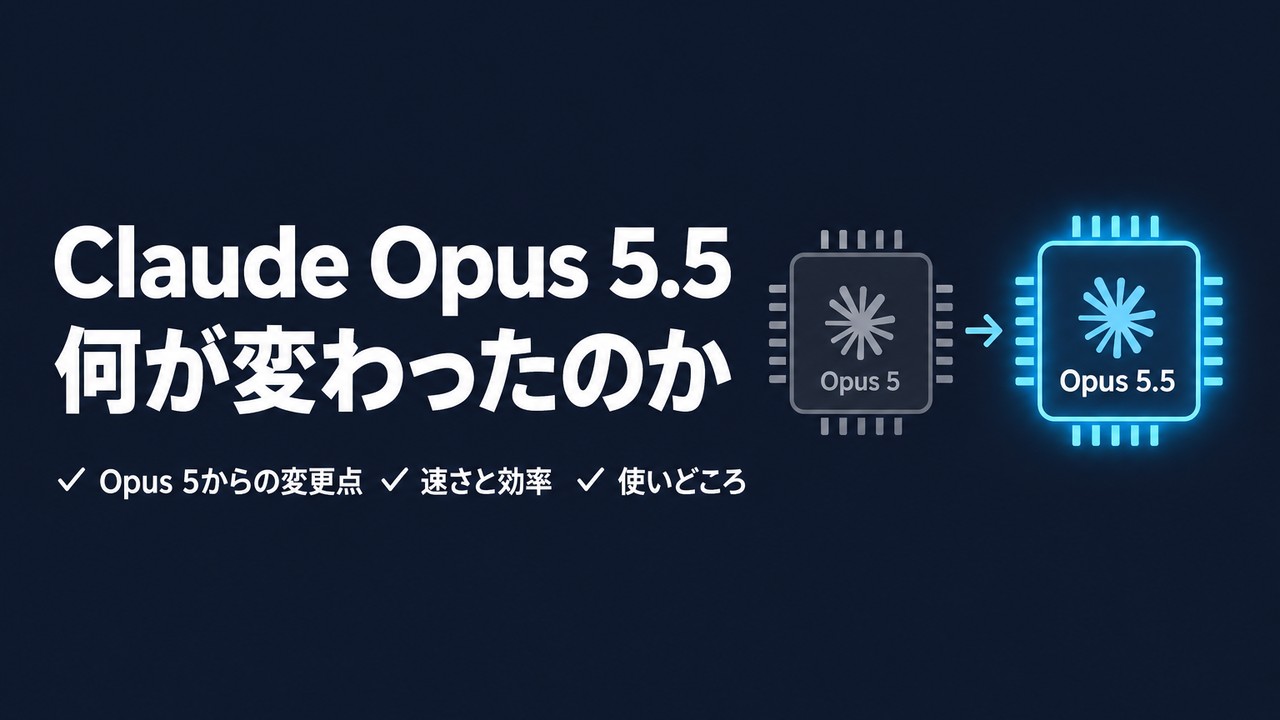
Opus 5.5そのものの全体像(Opus 5から何が変わったか)は、こちらのガイドにまとめています。
Opus 5.5とFable 5.1の違いを1枚で|結論は「Opus 5.5が入口、Fable 5.1が上げる先」
まず、使い分けに関わる項目だけを並べます。料金は2026年9月23日時点のAPI単価(米ドル・100万トークンあたり・税別)です。契約前にAnthropic公式の料金ページで最新の価格を確認してください。
項目 | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
公開日 | 2026年9月22日(米国時間) | 2026年9月1日(現地時間) |
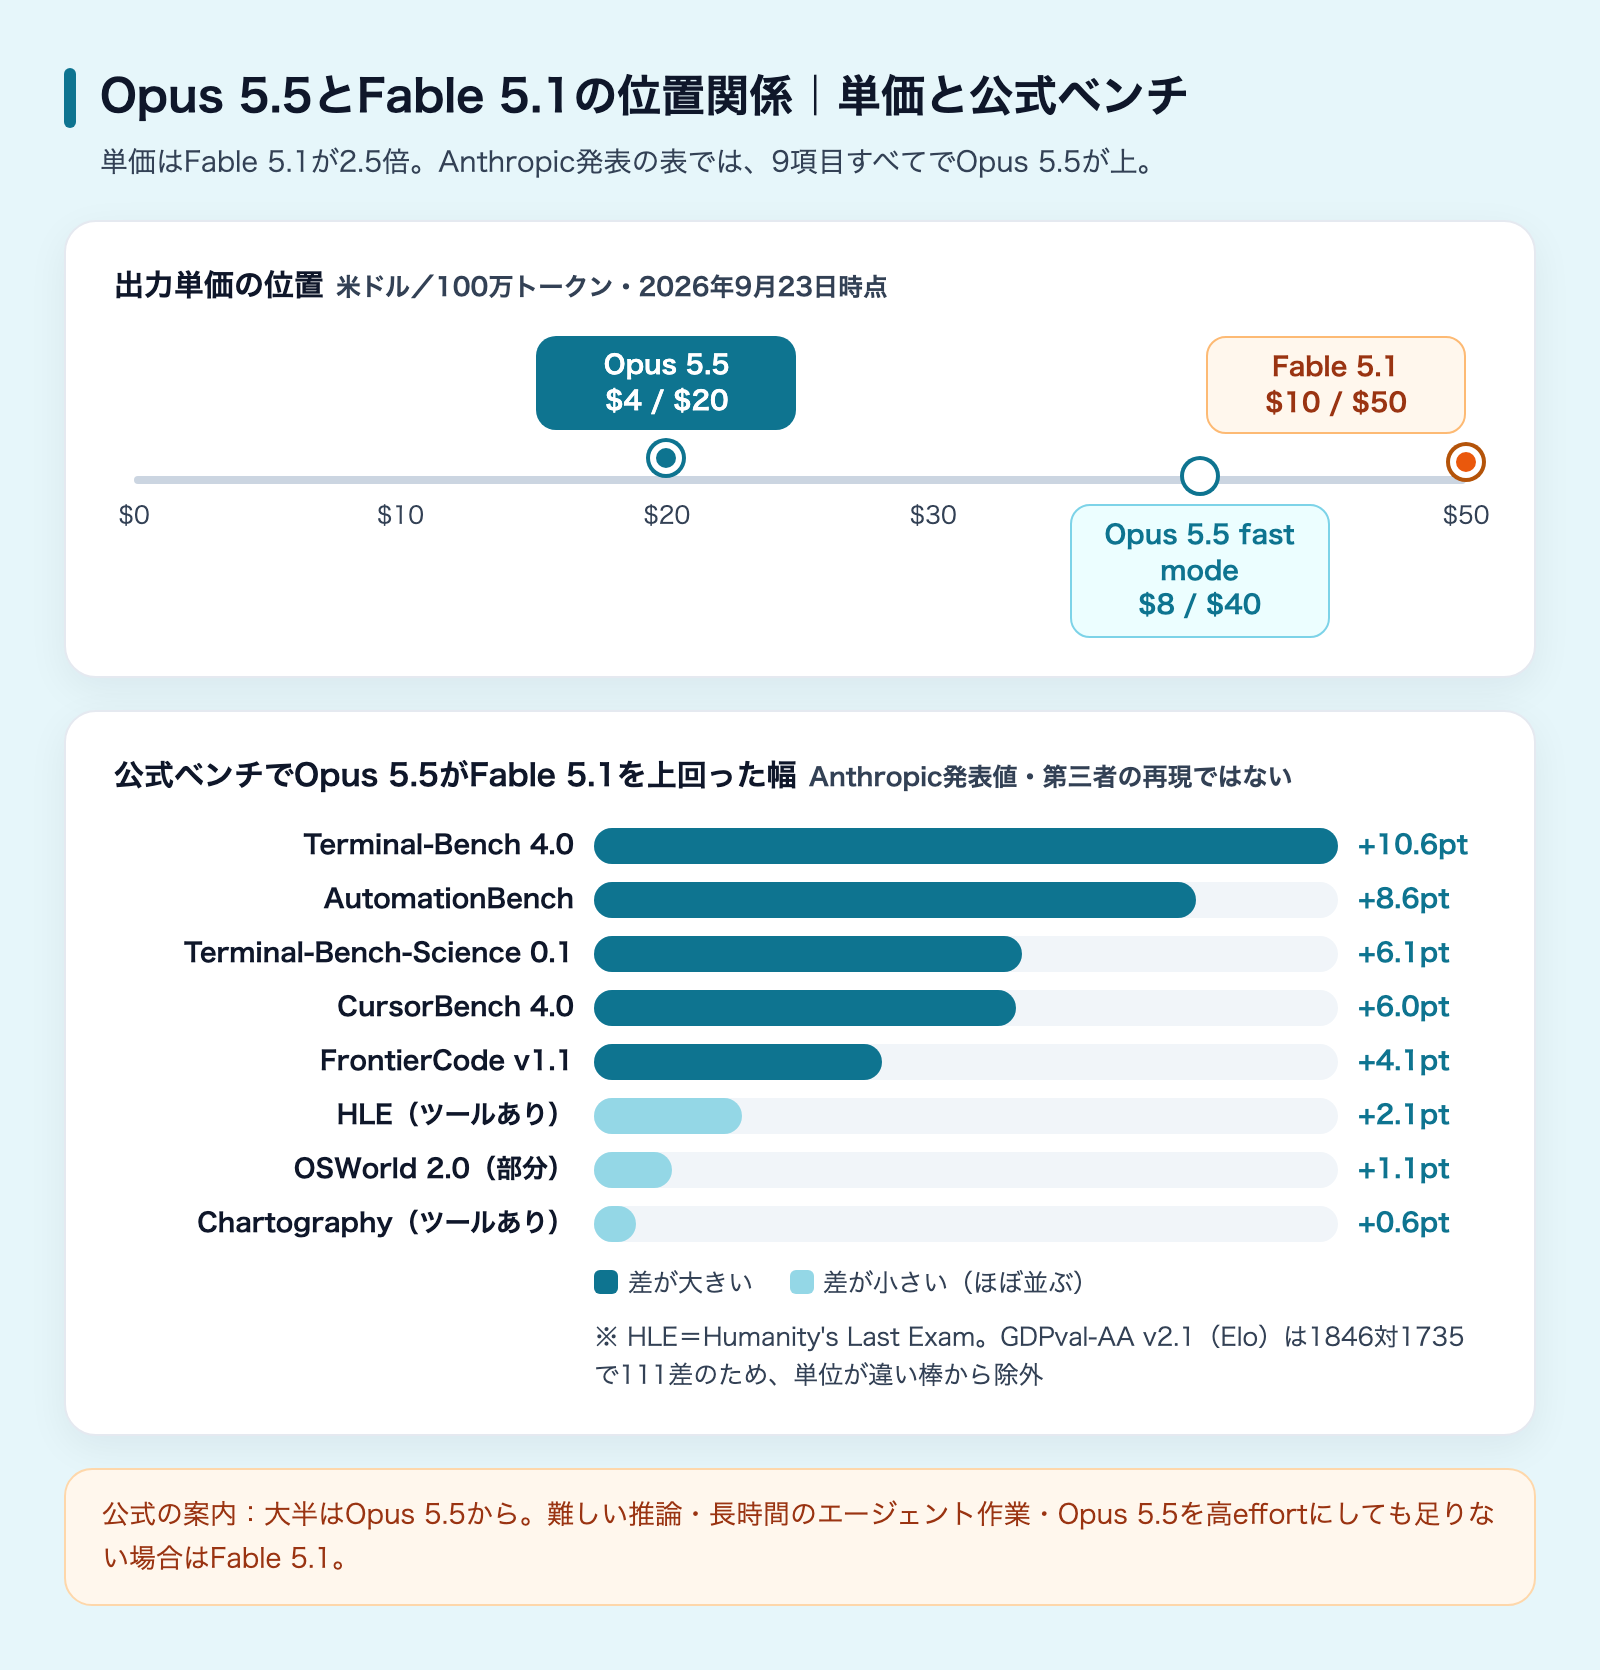
単価(入力/出力) | $4 / $20 | $10 / $50 |
公式の相対レイテンシ表記 | Moderate | Slower |
effortの既定値 | medium | high(APIとClaude Code) |
コンテキスト/最大出力 | 100万トークン/12.8万トークン | 100万トークン/12.8万トークン |
知識カットオフ | 2026年6月 | 2026年6月 |
公式ベンチ(Opus 5.5発表の表) | 掲載9項目すべてで上 | 9項目すべてでOpus 5.5を下回る |
公式の案内 | 迷ったら大半の用途はここから | 難しい推論・長時間のエージェント作業・Opus 5.5を高effortにしても足りない場合 |
この表で押さえたいのは3点です。1つ目は、単価はちょうど2.5倍の差があること。2つ目は、コンテキストの長さと最大出力は同じ(どちらも100万/12.8万トークン)で、扱える量を理由に上位モデルを選ぶ場面はないこと。3つ目は、それでもAnthropicはモデル一覧のページでFable 5.1の出番をはっきり残していることです(公式モデル一覧)。
単価・速度・既定effortの違い|同じ仕事でも条件がそろっていない
単価は2.5倍差|$4/$20と$10/$50
Opus 5.5の単価は入力$4・出力$20、Fable 5.1は入力$10・出力$50です(2026年9月23日時点・100万トークンあたり)。入力も出力も、Fable 5.1がちょうど2.5倍です。
たとえば1回の作業で入力100万トークン・出力20万トークンを使う場合、単価だけで計算すると次のようになります。
- Opus 5.5:入力$4+出力$4=$8
- Fable 5.1:入力$10+出力$10=$20
1ドル=150円で計算すると、1,200円と3,000円の差です。これは「同じトークン数で終わった」と仮定した単純計算で、実際の消費量はモデルやeffortで変わります。それでも、毎日くり返す作業をすべてFable 5.1で回すと、その差がそのまま月額に積み上がることは分かります。
もう1つ目安になるのが、速さを優先するfast modeです。Opus 5.5のfast modeの単価は$8/$40で、これはFable 5.1の通常単価($10/$50)より低い水準です。「急ぐから上位モデルを使う」という発想は、単価の面ではもう成り立ちにくくなっています。
なお、繰り返し読み込むプロンプトを安くするキャッシュ読み取りは、Opus 5.5が$0.20、Fable 5.1が$0.25で、ここは差が小さい項目です。
速さの公式表記はModerateとSlower
Anthropicのモデル一覧では、各モデルの相対的な速さ(レイテンシ)を言葉で示しています。Opus 5.5は「Moderate(中程度)」、Fable 5.1は「Slower(より遅い)」です。
秒数の比較は公式に出ていないため、ここでは「Fable 5.1のほうが返答までに時間がかかる設計」とだけ押さえてください。対話しながら何度も直すような作業では、この差が体感の待ち時間として効いてきます。
既定effortはmediumとhigh|初期設定のまま比べない
effortは、モデルが答える前にどれだけ考えるかの深さを決める設定です。Opus 5.5の既定値はmediumで、選択肢は low/medium/high/xhigh/max の5段階です。一方、Fable 5.1の既定値はAPIとClaude Codeでhighです(claude.aiとClaude Coworkではmedium)。
ここから言えるのは、初期設定のまま2つを比べると、Opus 5.5は一段浅い設定で、Fable 5.1は一段深い設定で動いているということです。どちらかが「遅い」「浅い」と感じたら、まずeffortがそろっているかを確認してください。
比べ方の参考に、私たちの手元の計測を1つ紹介します(Opus 5とOpus 5.5の比較で、Fable 5.1は含みません)。Claude Code v2.1.280で小さなPython関数を書かせる同じ課題を各条件3回実行したところ、この課題では、既定のmediumのOpus 5.5でも所要時間が13.7〜26.6秒とばらつき、1回だけ測ると順位が入れ替わりうる幅でした。Fable 5.1と比べるときも、effortをそろえ、自分の実際の作業で数回ずつ試すのが確実です。
 読者特典・無料ダウンロード最新AI「4モデル」、実務で比べてみた。無料でダウンロード →
公式ベンチは全9項目でOpus 5.5が上|ただし差の大きさは項目で違う
Opus 5.5の発表でAnthropicが示したベンチマーク表には、Fable 5.1の数値も並んでいます。掲載されている9項目すべてで、Opus 5.5がFable 5.1を上回っています(Anthropic公式発表)。これはAnthropic自身の発表値で、第三者の再現ではありません(独立評価の数値は2026年9月23日時点で未公開)。
ベンチマーク | 何を測るか | Opus 5.5 | Fable 5.1 | 差 |
|---|---|---|---|---|
Terminal-Bench 4.0 | ターミナル上のエージェント型コーディング | 66.4% | 55.8% | 10.6pt |
AutomationBench | 業務自動化 | 40.0% | 31.4% | 8.6pt |
Terminal-Bench-Science 0.1 | 科学系のターミナル作業 | 58.7% | 52.6% | 6.1pt |
CursorBench 4.0 | Cursor上のコーディング | 57.8% | 51.8% | 6.0pt |
FrontierCode v1.1 | コーディング | 54.4% | 50.3% | 4.1pt |
GDPval-AA v2.1 | 44職種の実務(Elo) | 1846 | 1735 | 111 |
Humanity's Last Exam(ツールあり) | 難問推論 | 67.7% | 65.6% | 2.1pt |
OSWorld 2.0(部分) | パソコン操作 | 81.8% | 80.7% | 1.1pt |
Chartography(ツールあり) | 図表読解 | 89.0% | 88.4% | 0.6pt |
差が大きい項目|ターミナル作業・業務自動化・実務
差がはっきり開いているのは、Terminal-Bench 4.0(10.6ポイント差)、AutomationBench(8.6ポイント差)、GDPval-AA(Eloで111差)です。コマンドを打ちながらコードを直す作業、決まった業務を自動で流す作業、44職種の実務タスクといった、日々くり返す実働の領域です。
この領域は、単価が2.5倍安いOpus 5.5のほうが発表値でも上です。コストと性能の両方でOpus 5.5に寄せない理由は、表の上からは見当たりません。
差が小さい項目|OSWorld・Chartography・HLE
一方で、Chartography(0.6ポイント差)、OSWorld 2.0(1.1ポイント差)、Humanity's Last Exam(2.1ポイント差)はほぼ並んでいます。図表の読み取り、画面を見ながらのパソコン操作、そして専門家でも難しい問題を集めた推論テストです。
ここで注目したいのが、Humanity's Last Examです。公式がFable 5.1の出番として最初に挙げる「難しい推論」に最も近い項目で、差が小さい部類に入っています。ベンチの数字は平均点なので、Opus 5.5が上でも、個々の難問でどちらが解けるかまでは表から分かりません。公式が「難しい推論はFable 5.1」と案内していることと、表でOpus 5.5が上であることは、矛盾せずに両立します。
この表だけで決めてはいけない理由
表から言えるのは「Anthropicが選んだ9項目の発表値では、Opus 5.5が上」というところまでです。公式が挙げるFable 5.1の3つの場面のうち「長時間のエージェント作業」と「高effortでも足りない場合」は、この9項目の点数に直接は表れません。表は「最初に使うモデル」を決める根拠にはなりますが、「上げる先を捨てる」根拠にはなりません。
なお、同じ表のGPT-6 Astraは業務自動化(AutomationBench)と科学系ターミナル作業(Terminal-Bench-Science)の2項目でOpus 5.5を上回っており、Opus 5.5が全方位で1位ではありません(選び分けはこちら)。
それでもFable 5.1を残す場面|公式が挙げる3つの条件
Anthropicのモデル一覧は、迷ったときの選び方をこう案内しています。「大半の用途は Opus 5.5 から始める。より難しい推論や長時間のエージェント作業、または Opus 5.5 を高effortにしても足りない場合は Fable 5.1」。この3つを、実務に置き換えるとどうなるかを整理します。以下の作業例は、条件を読み替えるための私たちの解釈で、公式が個別に指定したものではありません。
1. より難しい推論が必要なとき
原因がどこにあるか見当がつかない不具合の調査や、前提条件が多く絡み合った設計判断のように、「手を動かす量」より「考え抜く深さ」で結果が決まる作業です。
2. 長時間のエージェント作業
AIに作業を任せ、途中で人が細かく指示を出さずに長く走らせる使い方です。複数のファイルにまたがる大きな改修や、調べて・直して・確かめてを何周もくり返す作業が当てはまります。
3. Opus 5.5のeffortを上げても足りないとき
3つ目の条件は、裏返すと「Fable 5.1に切り替える前に、まずOpus 5.5のeffortを上げる」という順番を示しています。Opus 5.5の既定はmediumなので、high、xhigh、maxと上げる余地があります。effortを上げても、単価は2.5倍安いままです。それでも結果が足りないと分かった時点で、Fable 5.1に上げます。
セキュリティ系の作業は、両モデルで扱いが違う
使い分けで見落としやすいのが、サイバーセキュリティに関わる作業です。Anthropicの発表によると、Opus 5.5ではサイバーセキュリティ系のタスクの大半が、セーフガードによってOpus 4.8に回されます。一方のFable 5.1は、9月の発表で防御目的のソフトウェア脆弱性の特定が利用可能になったと案内されています。
脆弱性の調査やセキュリティレビューを主な用途にする場合は、Opus 5.5で回したつもりが別のモデルで処理されている可能性があります。どちらを使うかは、両モデルの公式の案内を確認したうえで決めてください。
Fable 5.1そのものの変更点や性能は、こちらの完全ガイドで詳しく解説しています。
振り分けを支える仕様|Opus 5.5の思考はFable 5.1に引き継げる
「途中でモデルを切り替えると、それまでの考えが無駄になるのでは」という不安に関わるのが、思考ブロックの扱いです。思考ブロックとは、モデルが答える前に内部で考えた過程を記録した部分のことです。Opus 5.5では、この思考が常にオンで、無効にはできません。
公式の移行ガイドによると、思考ブロックはモデルと会話に紐づき、Opus 5.5の思考ブロックを読めるのはFable 5.1とMythos 5.1だけです。それ以外のモデルに途中で振り替えると、その先は思考なしで続きます(公式移行ガイド)。
ここから、振り分けの運用について2つのことが言えます。
- Opus 5.5で始めて、途中でFable 5.1に上げる流れは、それまでの思考を読める組み合わせです。「足りなかったら上げる」という運用と相性がよい仕様です
- Opus 5.5から、Fable 5.1以外のモデル(たとえば安いモデル)に下ろすと、思考の引き継ぎは切れます
注意点として、これはAPIの仕様として公式ドキュメントに書かれている内容です。Claude Codeの中でモデルを切り替えたときに思考ブロックがどう扱われるかは、公式の記述を私たちは確認できていません。Claude Codeで使う場合は「上げる方向のほうが仕様上の無理がない」という目安として受け取ってください。Fable 5.1からOpus 5.5に戻す方向の扱いも、公式には明記されていません。
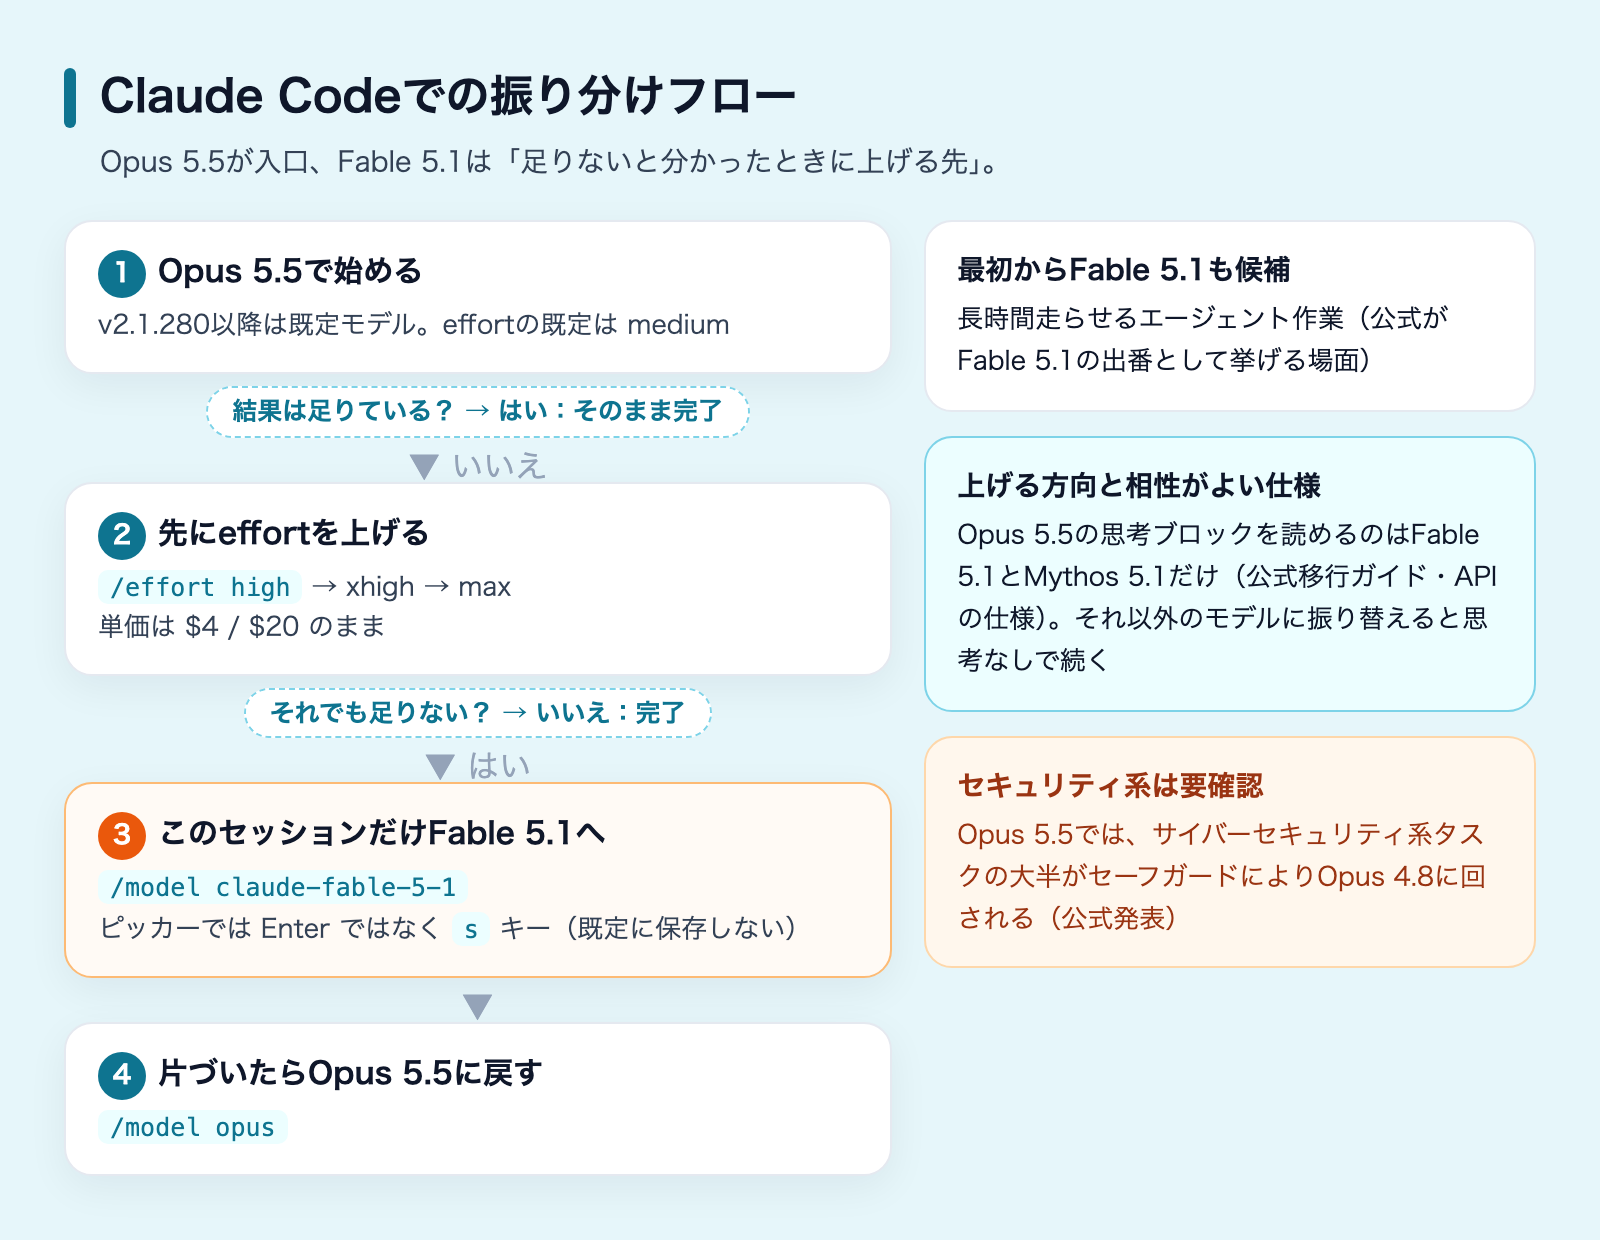
Claude Codeでの使い分け手順|まずOpus 5.5、足りなければFable 5.1へ
ここからは、Claude Codeで実際に振り分ける手順です。Opus 5.5を使うにはClaude Code v2.1.280以降が必要です。
手順1:ふだんはOpus 5.5のまま使う
Claude Code v2.1.280以降では、Pro/Max/Team/Enterprise と Anthropic API の既定モデルがOpus 5.5です。エイリアス(短い呼び名)の opus と default もOpus 5.5を指します。特に設定を変えていなければ、何もしなくてもOpus 5.5で動いています。以前に既定モデルを別のものに保存していた場合は、/model opus で戻せます(Microsoft Foundry経由の場合は既定がSonnet 4.5です)。
手順2:物足りなければ、先にeffortを上げる
答えが浅い、見落としが多いと感じたら、モデルを替える前に /effort high でeffortを上げます。/effort だけならスライダーで選べます。起動時に claude --effort high と指定することもできます。
手順3:それでも足りなければ、そのセッションだけFable 5.1へ上げて戻す
effortを上げても結果が足りない、あるいは最初から長時間走らせる大きな作業だと分かっている場合は、Fable 5.1に切り替えます。
- 作業の途中で切り替える:
/model claude-fable-5-1 - 最初からFable 5.1で起動する:
claude --model claude-fable-5-1
/model のピッカー(一覧から選ぶ画面)を使う場合は、Enterではなく s キーで選ぶと、既定として保存せずこのセッションだけ切り替えられます(v2.1.257以降)。Enterだと既定として保存され、次の作業も高いモデルで始まってしまいます。
難しい部分が片づいたら、/model opus でOpus 5.5に戻します。s キーで切り替えていれば、次のセッションは自動的にOpus 5.5から始まります。
作業ごとの振り分けの目安
公式の案内と上のベンチの差を、作業の種類に当てはめた最初の目安です。
作業の例 | 最初に使う | Fable 5.1に上げる目安 |
|---|---|---|
コードの修正・機能追加・テスト作成 | Opus 5.5 | effortをhigh以上にしても直らないとき |
定型業務の自動化・資料作成・調べ物 | Opus 5.5 | 基本は上げない(発表値でも差が大きい領域) |
図表の読み取り・画面操作の自動化 | Opus 5.5 | 差が小さい領域。結果を見て判断 |
原因不明の不具合調査・込み入った設計判断 | Opus 5.5(高effort) | 一発で詰め切れないと分かった時点 |
長時間走らせる大規模な改修 | 最初からFable 5.1も候補 | 公式が挙げる「長時間のエージェント作業」に該当 |
脆弱性調査・セキュリティレビュー | 両モデルの公式の扱いを確認 | Opus 5.5では大半がOpus 4.8に回る点に注意 |
Opus 5とFable 5のときの使い分けと、何が変わったか
前の世代でも、同じ「OpusかFableか」という問いがありました。当時の私たちの整理は、司令塔と最難関の一発勝負はFable 5、日々の実働の主力はOpus 5という2階建てでした。

今回の組み合わせでは、前提が2つ変わっています。
- 「迫る」から「上回る」へ:Opus 5のときの公式の主張は「Fable 5に半額で迫る」だったが、Opus 5.5の発表の表では掲載9項目すべてでFable 5.1を上回る
- 単価差が2倍から2.5倍に開いた:Opus 5が$5/$25だったのに対し、Opus 5.5は$4/$20。Fable側は$10/$50のまま
その結果、Fable 5.1の役割は「全体を常に仕切る司令塔」から、「Opus 5.5で足りないと分かったときに上げる先」へ寄っています。必要なところで呼ぶ使い方のほうが、公式の案内とも料金とも噛み合います。
まとめ|Opus 5.5から始め、足りないときだけFable 5.1に上げる
- 単価は2.5倍差:Opus 5.5が$4/$20、Fable 5.1が$10/$50(2026年9月23日時点・100万トークンあたり)。Opus 5.5のfast mode($8/$40)でもFable 5.1の通常単価より低い
- 公式ベンチは全9項目でOpus 5.5が上。ただしAnthropicの発表値で、Chartography・OSWorld・Humanity's Last Examの差は0.6〜2.1ポイントと小さい
- Fable 5.1は不要ではない:公式は難しい推論・長時間のエージェント作業・高effortでも足りない場合にFable 5.1を案内している
- 上げる運用と仕様が噛み合う:Opus 5.5の思考ブロックを読めるのはFable 5.1とMythos 5.1だけ(APIの仕様)
- Claude Codeでは:既定のOpus 5.5で始め、
/effortで深さを上げ、足りなければ/modelでsキーを使ってそのセッションだけFable 5.1へ
上位モデルは「常に使うもの」ではなく「必要なときに呼ぶもの」になりました。まずはふだんの作業をOpus 5.5のまま回し、詰まった場面だけFable 5.1に上げてみて、自分の仕事での差を数回ずつ確かめてみてください。
最新AI「4モデル」、実務で比べてみた。
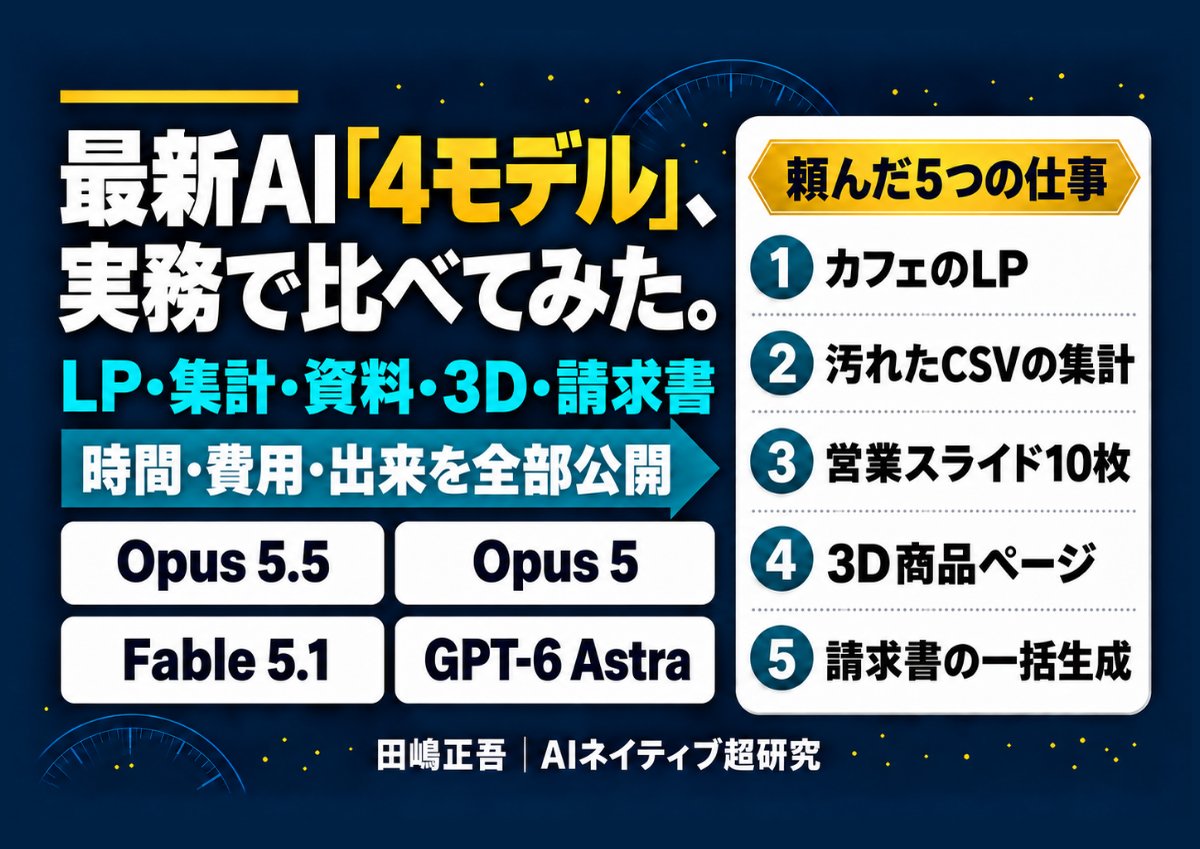
Opus 5.5・Opus 5・Fable 5.1・GPT-6 Astra に同じ5つの仕事を投げた実測(全31ページ)
公式ベンチでは、Opus 5.5 が上位の Fable 5.1 や GPT-6 Astra を多くの項目で上回りました。では実際の仕事ではどうか。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを4モデルに同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は4モデルとも全問正解。差が出たのは、速さと費用と、細かい指示の守り方でした。
- 5つの仕事 × 4モデル=20本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを4つ並べて比較(LP・スライド・回せる3D)
- Opus 5 と同じ作り込みを、Opus 5.5 がどれだけ短く終えたか
- 細かい指示を最後まで守ったのはどれか——仕事別の早見表と判断フローつき
メールアドレス登録で他にも様々な資料を閲覧できます
 +6
PDF 15点・合計400ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。