X APIでいいねを取得する方法|差分取得と料金

「X APIでいいねを取得したいけれど、料金がいくらかかるのか読めない」「毎日取りに行くと同じポストを何度も読んで、お金を払い続けることにならないか」——いいねをブックマーク代わりに使っている人が、手元に一覧を残そうとすると、まずここで迷います。
結論から言うと、自分のいいねは GET /2/users/{id}/liked_tweets で取れ、自分で作った開発者アプリから自分のデータを読む「Owned Reads」に当たるので、2026年11月4日時点で1件 $0.001 です。毎日取るなら、決まった件数を読み直すのではなく「台帳にあるIDに当たるまで読む」差分取得にすると、払う額は新しくいいねした分にほぼ比例します。
株式会社Fyveは、AIを使った業務の自動化を中小企業向けに支援しています。私たちは自分のいいねを毎朝この方法で取り、AIに話題別に分けさせて、記事や発信の種を探す材料にしています。この記事では、エンドポイントの仕様と料金を公式ドキュメントで確かめた内容と、毎朝動かしている手順をそのまま書きます。
X APIでいいねを取得する方法の要点
先に全体を表にまとめます。細かい条件はこの後の節で一つずつ見ていきます。
項目 | 内容(2026年11月4日時点・docs.x.com で確認) |
|---|---|
エンドポイント |
|
認証 | ユーザーとしての認証(OAuth 2.0 のユーザートークン、または OAuth 1.0a) |
必要な権限(OAuth 2.0 のスコープ) |
|
1回に取れる件数 |
|
続きの取得 | 応答の |
回数の上限 | 15分あたり75回(アプリ単位・ユーザー単位とも) |
料金 | 従量課金。自分のアプリで自分のいいねを読む場合は Owned Reads で1件 $0.001 |
月額のプランを契約する形ではなく、Developer Console でクレジットを買っておき、リクエストのたびに差し引かれる仕組みです。公式の料金ページは「サブスクリプションなし、使った分だけ払う」と説明しています。
liked_tweets エンドポイントの仕様
何が返ってくるか
liked_tweets は「指定したユーザーがいいねしたポストの一覧」を返します。返ってくるのはポストの本体(ID・本文など)で、投稿者の名前やいいね数・リポスト数を一緒にほしいときは、追加のパラメータで頼みます。
expansions=author_id:投稿者の情報をincludes.usersに入れて返してもらうuser.fields=username,name:投稿者のユーザー名と表示名- ポストの項目(投稿日時・反応数・言語):
created_at,public_metrics,author_id,lang
公式のリファレンスではポストの項目のパラメータ名が post.fields と書かれています。私のスクリプトは以前からの tweet.fields のままですが、2026年11月4日の朝の実行でも投稿日時と反応数は取れています。新しく書くなら、リファレンスの名前に合わせておくのが無難です。
並び順と続きの取り方
応答には meta.next_token が入っていて、これを次のリクエストの pagination_token に入れると続きが返ります。並び順は公式のリファレンスに明記がありませんが、私の環境では毎回「新しくいいねした順」に返ってきています。後で説明する差分取得は、この並び順を前提にしています。
リファレンスに書かれていない以上、順番が変わる可能性はゼロではありません。私は「既知のIDに当たったら止める」作りに加えて、1回で読む件数に上限(100件)を付けています。順番が崩れても、読み続けて料金が膨らむことはありません。
回数の上限と 429 の扱い
公式のレート制限の表では、GET /2/users/:id/liked_tweets は15分あたり75回です。上限を超えると HTTP 429 が返り、応答ヘッダーの x-rate-limit-reset に、枠が戻る時刻が Unix 時刻で入っています。
毎朝1回、10件ずつ読む使い方なら、この上限に当たることはまずありません。それでも、過去のいいねを全件取り直すときは何十ページも続けて読むので、私のスクリプトは 429 が返ったら x-rate-limit-reset まで待ってから1回だけやり直し、ページの間には1秒の間隔を空けています。
X APIのいいね取得の料金
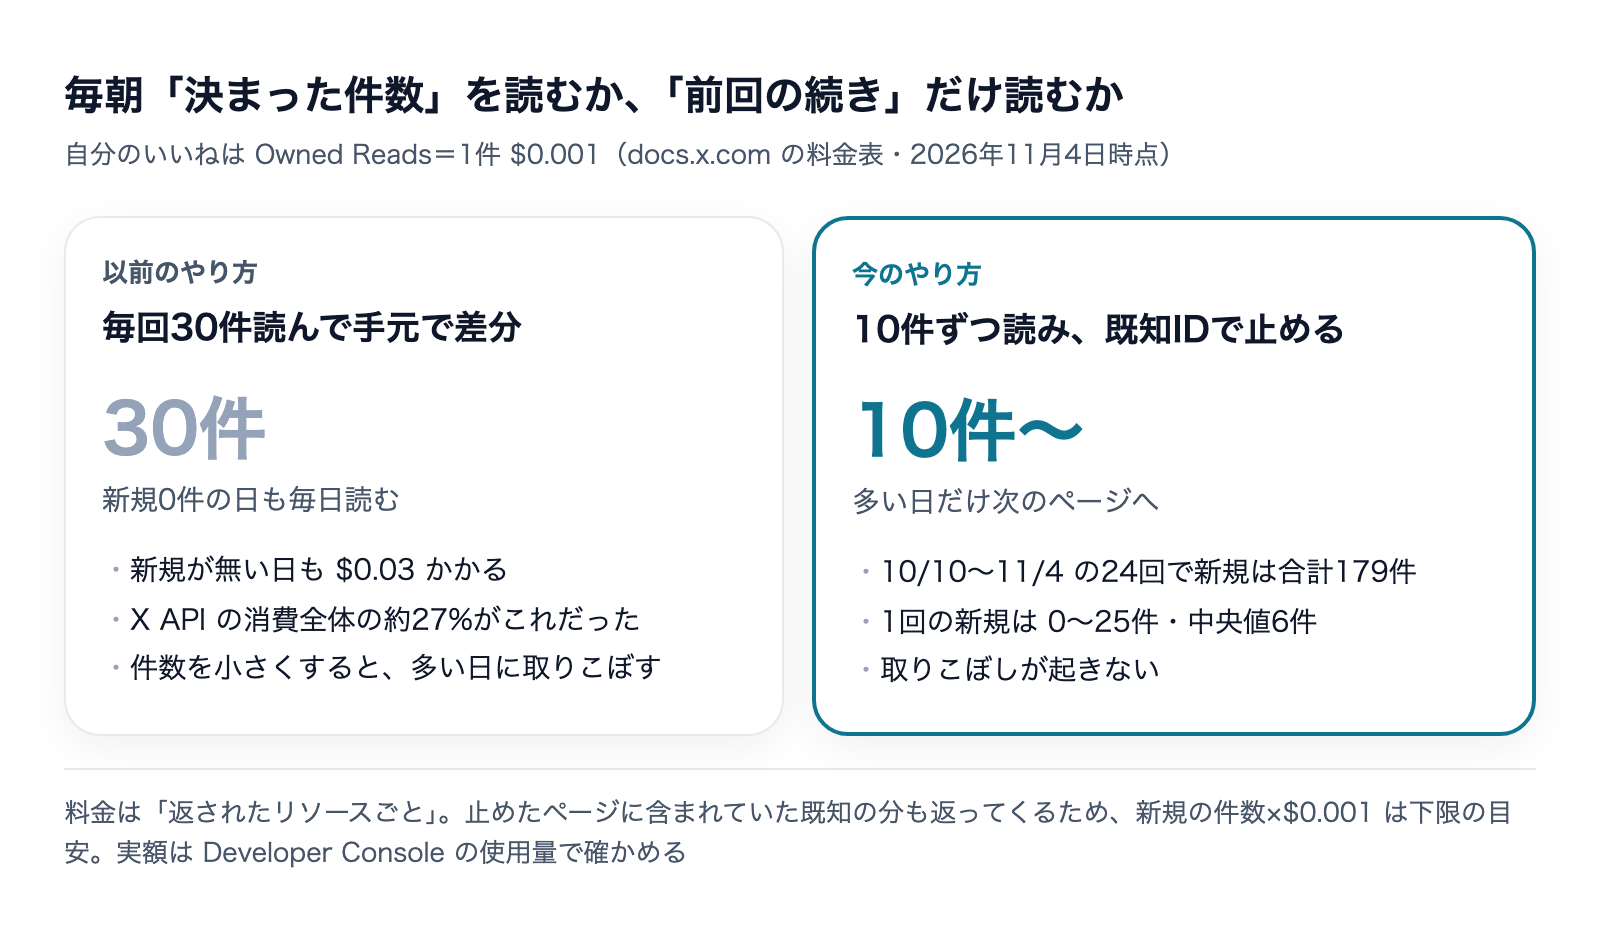
自分のいいねは Owned Reads で1件 $0.001
X API は「返ってきたリソース1件ごと」に課金されます。公式の料金表から、いいねの取得に関係する行を抜き出すと次のとおりです(2026年11月4日時点・料金は米ドル、税の扱いは料金ページに記載がありません)。
区分 | 1件あたり | 当てはまる条件 |
|---|---|---|
Owned Reads | $0.001 | URLの |
Posts: Read | $0.005 | ポストの読み取り(通常) |
User: Read | $0.010 | ユーザー情報の読み取り(通常) |
Owned Reads の対象には、liked_tweets のほかに自分のポスト・メンション・ブックマーク・フォロワー・フォロー中なども並んでいます。条件は「自分のアプリで、自分のデータを読む」ことです。同じ liked_tweets でも、他人のIDを指定した場合は Owned Reads の条件から外れます。料金表には別に「Like: Read」という行もあり、他人のいいね一覧がどの行で数えられるかは料金表だけでは読み切れません。他人のいいねを取るなら、少ない件数で試して使用量を確かめてから広げてください。
ほかに、料金ページには次の決まりも書かれています。
- 24時間の重複排除:同じリソースは、UTC の1日(日本時間の朝9時に切り替わる)の中では1回しか数えない。ただし公式は「緩い保証」としていて、障害時などは例外がありうる
- 月の上限:従量課金のプランは、1回の請求期間あたりポストの読み取り300万件まで
- 使いすぎの防止:Developer Console で支出の上限と自動チャージを設定できる
料金は変わることがあるので、契約前・運用を始める前にX API の公式の料金ページと Developer Console の表示で最新の値を確かめてください。
私の見積もりは実際より小さく出ていた
ここは私自身が書き直した点です。私のスクリプトは実行のたびに「概算コスト」を表示していて、計算は「新しく取れた件数 × $0.001」でした。ところが公式の課金は「返ってきたリソースごと」です。10件ずつ読んで途中で既知のIDに当たった場合、そのページには既知の分も入って返ってきます。
つまり新規が3件の日でも、APIは10件を返しています。2026年10月10日から11月4日までの24回で、新規は合計179件、表示上の概算は $0.179 でした。返ってきたページの件数で数え直すと、多めに見て約320件・$0.32 です。重複排除や、投稿者の情報(expansions)がどう数えられるかで実額は動くので、正確な額は Developer Console の使用量で見ています。どちらにしても、月に1ドルに届かない規模です。
金額は小さいのですが、「スクリプトが出す数字」と「請求される数字」の数え方が違う、という点は覚えておく価値があります。件数を増やす使い方に変えたとき、表示を信じて予算を組むとずれます。
始める前に用意するもの
開発者アプリとキー4つ
X の Developer Console で開発者アプリを作り、クレジットを購入しておきます。私は OAuth 1.0a で認証していて、使うのは次の4つです。
- API Key と API Secret(アプリの鍵)
- Access Token と Access Token Secret(自分のアカウントとしてアプリを使うための鍵)
4つとも同じアプリから発行したものでないと認証が通りません。鍵はスクリプトに直接書かず、環境変数か、git に入れない設定ファイルから読み込みます。
自分のユーザーIDを調べる
liked_tweets のURLにはユーザーIDが要ります。画面に出ている @ から始まるユーザー名ではなく、数字のIDです。認証が通っていれば、GET /2/users/me を1回呼ぶと自分のIDとユーザー名が返ってきます。私のスクリプトは毎回これを最初に呼んで、認証の確認とIDの取得を兼ねています。
401・403 が返ったら確かめる3点
最初に詰まるのはたいてい認証です。401 や 403 が返ったときに、私が順に確かめているのは次の3点です。
- 4つの鍵が同じアプリから出たものか(別のアプリの Access Token を混ぜていないか)
- Access Token が「数字のID-文字列」の形になっているか(自分のアカウントとして発行したものか)
- クレジットの残高が残っているか
3つ目は見落としやすい点です。従量課金なので、残高が尽きると、鍵が正しくても取れなくなります。
いいねを差分で取得する作り方
考え方:既知のIDに当たったら止める
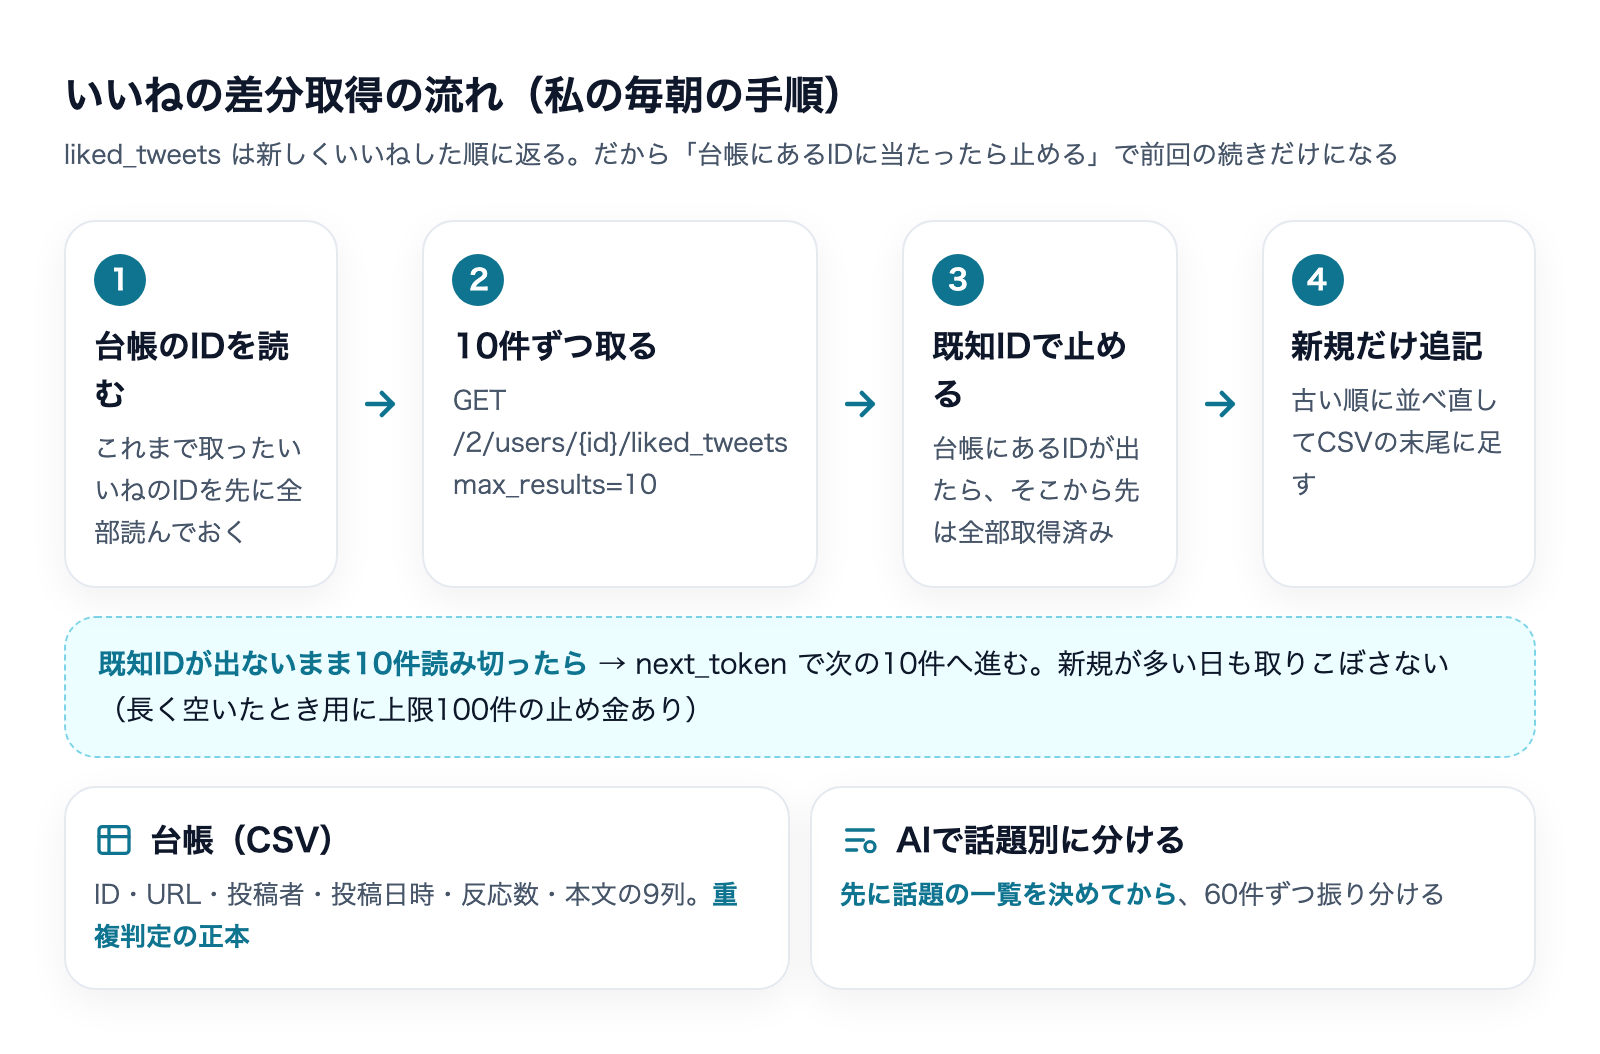
毎日いいねを取るときに一番効くのは、「前回の続きだけ読む」作りです。私の手順は次の4段です。
- 手元の台帳(CSV)から、取得済みのいいねのIDを全部読む
liked_tweetsを10件ずつ読む- 台帳にあるIDが出てきたら、そこで止める(そこから先は全部取得済み)
- 新しく取れた分だけを、古い順に並べ直して台帳の末尾に足す
10件読み切っても既知のIDが出てこない日は、next_token で次の10件へ進みます。新規が多い日も取りこぼしません。
Python のコード(中心部分)
中心は次の関数です。認証には requests_oauthlib の OAuth1 を使っています。
def pull(auth, uid, per_page, known_ids, cap=100):
    """新しくいいねした順に読み、既知のIDに当たったら止める"""
    tweets, users = [], {}
    params = {"max_results": per_page,
              "tweet.fields": "created_at,public_metrics,author_id,lang",
              "expansions": "author_id", "user.fields": "username,name"}
    while True:
        data = get(auth, f"/users/{uid}/liked_tweets", params)
        for u in data.get("includes", {}).get("users", []):
            users[u["id"]] = u
        batch = data.get("data", [])
        for i, t in enumerate(batch):
            if t["id"] in known_ids:      # ここから先は全部取得済み
                tweets.extend(batch[:i])
                return tweets, users
        tweets.extend(batch)
        if len(tweets) >= cap:            # 長く空いたときの止め金
            return tweets, users
        nxt = data.get("meta", {}).get("next_token")
        if not nxt or not batch:
            return tweets, users
        params["pagination_token"] = nxt
        time.sleep(1)
ポイントは、台帳のIDを pull より先に読んでおくことです。台帳を読む前にAPIを叩くと、どこで止めればよいか分からず、結局決まった件数を読むことになります。
なぜ「毎回30件読む」をやめたか
最初の版は、毎朝30件を読んでから手元で差分を取っていました。分かりやすい作りですが、新しいいいねが0件の日も30件分を払います。2026年8月に使用量を見直したとき、X API の消費全体のうち約27%がこの読み直しでした。
では件数を10件に減らせばよいかというと、それも危ないのです。1日に10件より多くいいねした日は、11件目以降を翌日に取れません。翌日も「最新の10件」しか見ないので、その分は永久に台帳に入りません。件数を固定で小さくすると、払いすぎか取りこぼしのどちらかになります。
「知っているIDに当たるまで読む」なら、普段は1ページ(10件)で終わり、多い日だけ次のページへ進みます。安さと取りこぼしの無さを両立できるのは、この作りだけでした。
実際の件数(2026年10月10日〜11月4日)
毎朝の実行記録から、新規に取れた件数を並べると次のとおりです。
項目 | 値 |
|---|---|
実行回数 | 24回 |
新規の合計 | 179件 |
1回あたりの新規 | 0〜25件(中央値6件) |
2ページ目以降に進んだ回 | 7回(新規が10件以上の日) |
台帳の累計 | 743件(11月4日時点) |
新規が0件の日もあれば、25件の日もあります。この振れ幅を見ると、固定の件数ではどちらかに外れることが分かります。
取得したいいねを台帳(CSV)に残す
列の決め方
台帳はCSVにしています。列は次の9つです。
tweet_id:重複判定に使うIDurl:ポストのURL(https://x.com/ユーザー名/status/ID)author・author_name:投稿者のユーザー名と表示名posted_at:ポストの投稿日時likes・reposts・replies:取得した時点の反応数text:本文(改行は空白に置き換える)
注意したいのは、posted_at は「ポストが投稿された日時」で、「自分がいいねした日時」ではないことです。いいねした順番は台帳の行の順番で残しています。APIからは新しい順に返ってくるので、追記する前に並びを逆にして、台帳の下に行くほど新しくなるようにしています。
文字コードは BOM 付き UTF-8
CSVは utf-8-sig(BOM 付きの UTF-8)で書いています。BOM が無いと、Excel でダブルクリックして開いたときに日本語が文字化けすることがあるためです。読み込み側も同じく utf-8-sig で開けば、先頭の BOM が列名に混ざりません。
台帳とは別に、その日に取れた分だけを日付の見出し付きで並べた Markdown のファイルにも追記しています。台帳は機械が重複を判定するため、Markdown は人が朝に目で追うため、と役割を分けています。
AIでいいねを話題別に分ける
先に話題の一覧を決めてから振り分ける
X の上ではいいねを分けられませんが、手元に台帳があればAIに分けさせられます。私は Claude に次の2段で分類させています。
- 全件の本文の冒頭を読ませ、話題の一覧(10〜14個)を先に決めさせる
- 60件ずつに分け、それぞれに話題・タグ(1〜3個)・1行の要約を付けさせる(5本並列)
2026年10月13日の試作では、話題は13個になりました。
なぜ順番が大事か
話題の一覧を先に決めずに「60件ずつ分類して」と頼むと、まとまりごとにAIが違う分け方をします。あるまとまりでは「Claude Code」でまとめたものが、別のまとまりでは「AIエージェント」に入る、ということが起きます。60件ずつ並列に処理するので、まとまり同士は互いの分け方を知りません。
先に全体を見せて一覧を固定し、2段目では「この一覧の中から選ぶ」形にすると、分け方が揃います。2段目の結果に一覧に無い話題が混ざっていないかも、機械で数えて確かめています。
分類の手順で気をつけていること
- 結果をまとまりごとに保存する:途中で失敗しても、済んだまとまりはやり直さない
- JSON が崩れたら2回までやり直す:AIの出力が JSON として読めないことがたまにある
- 話題の一覧は保存して使い回す:毎回作り直すと、日によって分け方が変わる
この分類は、Claude Code を画面なしで1回だけ動かす claude -p で回しています。自分の Mac で自分のために回す仕組みなので、この形で足りています。
毎朝の自動実行と失敗の拾い方
差分取得は、Mac の定期実行の仕組み launchd から毎朝動かしています。取れたいいねは、その朝の情報収集(ニュースの確認や記事の種の整理)の材料の1つとして使います。
無人で動かすときに大事なのは、失敗に気づけることです。私のスクリプトは、認証に失敗したときや 429 以外のエラーが返ったときに、エラーの内容を出して止まります。そのうえで、毎朝の作業記録に「成功・新規◯件・概算◯ドル」を1行残しています。新規0件の日が何日も続いたら、いいねしていないのか、取得が壊れているのかを疑う目安になります。
定期実行の組み方や、画面なしで動かす Claude の失敗の見分け方は、次の記事で詳しく書いています。
よくある質問
過去のいいねを全部取れますか
next_token をたどれば、さかのぼって読めます。私のスクリプトには、差分ではなく全件を読む使い方も入れてあり、台帳をまとめて作り直したいときに使えます。全件を読むと、件数 × $0.001 がそのままかかります。1,000件なら $1 前後が目安です(Owned Reads の場合)。
他人のいいねも同じ料金で取れますか
Owned Reads の条件は「認証したユーザー本人のIDで、そのユーザーがアプリの持ち主」なので、他人のいいねは条件から外れます。どの料金の行が当たるかは料金表から読み切れないため、試すなら件数を絞って使用量を確かめてください。また、他人のデータを集めて使うときは、X の開発者向けの規約に沿っているかを先に確認する必要があります。
ブックマークも同じ方法で取れますか
料金表の Owned Reads の対象には、ブックマーク(/2/users/{id}/bookmarks)も入っています。私はいいねだけで運用していますが、差分取得の考え方はそのまま使えます。必要な権限やパラメータはエンドポイントごとに違うので、公式のリファレンスで確かめてから書いてください。
X の検索APIとは何が違いますか
X の投稿を検索して読む方法は、別の記事で Claude Code から使う形を書いています。検索は「今話題になっていること」を探すのに向き、いいねの取得は「自分が後で見返したいと思ったもの」を残すのに向きます。目的が違うので、私は両方を使い分けています。

まとめ
- 自分のいいねは
GET /2/users/{id}/liked_tweetsで取れる。自分のアプリで自分のデータを読むので Owned Reads、1件 $0.001(2026年11月4日時点) - 毎日取るなら、決まった件数を読み直さず「既知のIDに当たるまで10件ずつ読む」。払いすぎと取りこぼしを両方防げる
- 課金は「返ってきたリソースごと」。新規の件数で出した概算は下限の目安で、実額は Developer Console で見る
- 台帳は BOM 付き UTF-8 のCSV。いいねした順番は行の順番で残す
- AIに分類させるときは、先に話題の一覧を決めてから振り分ける。並列に処理しても分け方が揃う
いいねは、手間をかけずに「後で読みたい」を残せる便利な仕組みです。手元に台帳として残しておけば、半年後にも探せる資料になります。株式会社Fyveでは、こうした小さな自動化を業務の中にどう組み込むかを、実際に動かしながら確かめています。
Claude Codeを「素のまま」使うな
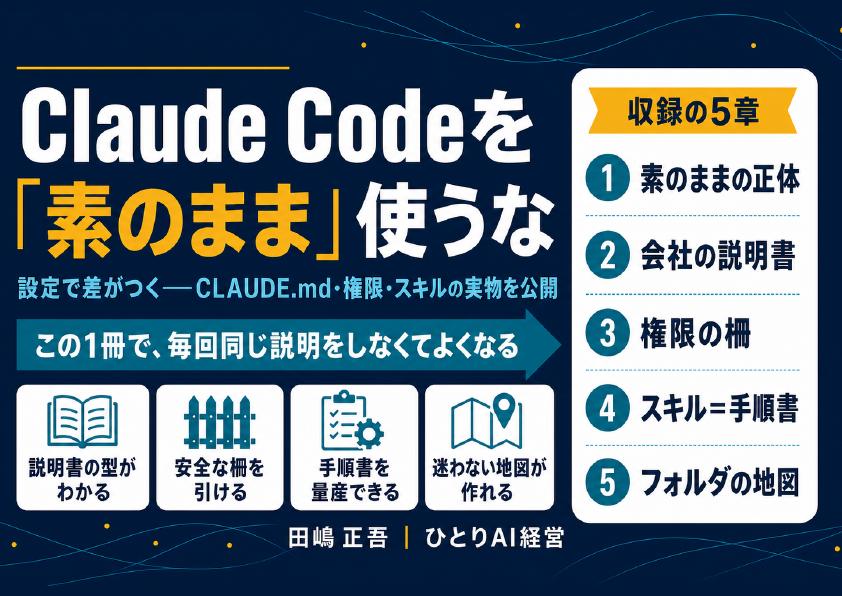
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます
 +10
PDF 19点・合計499ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。